Sie haben eine Pinterest-Pin-URL und möchten Titel, Beschreibung und Speicheranzahl. Sie brauchen keinen Browser, um sie zu scrapen. Eine ausgeloggte Pin-Seite enthält alle drei in einem JSON-LD-Block, plus den Pinner und den ausgehenden Link. Profil- und Board-RSS-Feeds listen Pin-URLs über einfaches HTTP auf.
Aber nichts davon erreicht die Suche. Pinterest baut das Suchraster im Browser auf und legt für ausgeloggte Besucher ein Login-Modal darüber. Die Kacheln, die gerendert werden, haben keine Titel und keine Links.
Dieser Leitfaden erklärt, wie man richtig Pinterest scrapt und alle öffentlichen Daten erhält, die Sie benötigen.
TL;DR
Ein öffentlicher Pin wird über einfaches HTTP geparst, während Keyword-Suche und vollständige Profil-Crawls eine verwaltete API benötigen.
- Die Sperre bei der Suche liest den Kontostatus, nicht einen Bot-Score, daher ändert ein Stealth-Browser nichts.
- Ältere Leitfäden scheitern aus zwei Gründen:
pinWrapperpasst auf nichts, und der Datensatz ist nicht im Redux-Store. - Eine Datacenter-IP erhält die Pin-Seite ohne deren JSON-LD-Block, also von einer Residential-Adresse ausführen.
- Beide kostenlosen Methoden erreichten über die Boards eines Kontos 435 einzigartige Pins, von mehr als 9.000 dort gespeicherten.
Was Sie von Pinterest extrahieren können
Ein Pin-Datensatz enthält Titel, Beschreibung, Bild- oder Video-URLs, Hashtags, eine Kategorie, eine Kommentarzahl und die Profil-URL des Pinners. Profile listen Followerzahlen, Board-Namen und die Pins auf, die ein Nutzer veröffentlicht hat.
Die Schwierigkeit liegt im Zugang, nicht im Datenmodell. Die Pinterest Entwicklerrichtlinien verbieten “jegliche automatisierte Mittel oder Form von Scraping oder Datenextraktion, um Informationen von Pinterest abzurufen”. Die robots-Datei ist eine Positivliste, keine Sperrliste: Sie nennt Hunderte von Crawlern einzeln und gibt User-agent: * ein Disallow: /. Jeder Client, den sie nicht nennt, ist nicht erlaubt.
Sammeln Sie also nur öffentliche Daten, halten Sie die Anfragerate niedrig und melden Sie sich nicht mit einem persönlichen Konto an, um es zu automatisieren. Pinner-Namen und Profil-URLs sind personenbezogene Daten gemäß GDPR, und dieselben Richtlinien verbieten die Nutzung von Pinterest-Material zum Training von KI-Modellen. Für alles darüber hinaus konsultieren Sie einen Fachmann.
Was eine Pin-Seite an einfaches HTTP zurückgibt
Für eine Pin-URL, die Sie bereits haben, brauchen Sie keinen Browser. Eine ausgeloggte Pin-Seite bettet einen JSON-LD-SocialMediaPosting-Block ein, und dieser Block ist der Datensatz.
Sie brauchen Python 3 und sonst nichts, um zu starten: json, re und urllib sind alle Standardbibliothek. Der erste pip install kommt später, wenn Sie ein Profil in Board-Feeds umwandeln.
Parsen Sie den Block, und Sie erhalten die Daten des Pins in wenigen Zeilen:
import json, re, urllib.request

UA = ("Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 "
      "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")
BOILERPLATE = "Discover (and save!) your own Pins"

def scrape_pin(url):
    req = urllib.request.Request(url, headers={"User-Agent": UA})
    resp = urllib.request.urlopen(req, timeout=30)
    html = resp.read().decode("utf-8", "ignore")
    block = re.search(
        r'<script[^>]*type="application/ld\+json"[^>]*>(.*?)</script>',
        html, re.S)
    if not block:            # deleted pin: no JSON-LD block on the page
        return None
    data = json.loads(block.group(1))

    # Recipe pins use name/description, everything else headline/articleBody
    description = data.get("articleBody") or data.get("description")
    if description and BOILERPLATE in description:
        description = None   # Pinterest filler text, not the pin's own words

    saves = next((s.get("userInteractionCount")
                  for s in data.get("interactionStatistic") or []), None)
    return {
        "schema": data.get("@type"),
        "title": data.get("headline") or data.get("name"),
        "description": description,
        "pinner": (data.get("author") or {}).get("name"),
        "image": data.get("image"),
        "date": data.get("datePublished"),
        "source_link": (data.get("sharedContent") or {}).get("url"),
        "saves": saves,
    }

if __name__ == "__main__":
    print(json.dumps(scrape_pin(
        "https://www.pinterest.com/pin/99360735523397542/"), indent=2))
Führen Sie es aus, und ein lebender Pin liefert einen vollständigen Datensatz:
{
  "schema": "SocialMediaPosting",
  "title": "12 Bombshell Hair Color Ideas To Try This Summer | Ecemella",
  "description": "A person with long, straight reddish-brown hair wearing a black leather jacket...",
  "pinner": "Sarah Komnick",
  "image": "https://i.pinimg.com/originals/0d/b9/56/0db956e2c07e1580514b1c19587b4152.jpg",
  "date": "2023-05-24T22:32:51.000Z",
  "source_link": "https://www.ecemella.com/summer-hair-color-ideas/",
  "saves": 196
}
All das kommt aus einer einzigen Anfrage.
Der Datensatz befindet sich im JSON-LD-Block, nicht im Redux-Store der Seite. Ein zweites Skript, __PWS_INITIAL_PROPS__, setzt initialReduxState.pins auf ein leeres Objekt. Ein Scraper, der den Store liest, findet nichts. Und ein gelöschter Pin hat überhaupt keinen JSON-LD-Block, daher gibt scrape_pin None zurück, statt einen Teildatensatz.
Pinterest liefert mehr als einen JSON-LD-Typ, und das Ignorieren von schema bricht einen Scraper stillschweigend. Über 105 Pins hinweg lieferten 100 SocialMediaPosting und 5 Recipe, und jeder enthielt einen JSON-LD-Block.
Die 105 stammten aus zwei Quellen: 90 aus den RSS-Feeds von 10 Konten, die überhaupt keine Video-Pins lieferten. Die anderen 15 kamen aus einer Keyword-Suche über die Scraper API, von denen 10 Videos waren. Video-Pins verwenden dasselbe SocialMediaPosting-Schema und werden fehlerfrei geparst.
Die Aufteilung zwischen den beiden Schemata ist vollständig statt teilweise, was es leicht macht, sie zu übersehen. In der 90-Pin-Feed-Stichprobe enthielten alle 85 Social-Posts headline, articleBody, datePublished und sharedContent, und keines der 5 Rezepte enthielt irgendeines davon. Ein Rezept-Pin verwendet stattdessen name und description. Nur headline zu lesen liefert für die gesamte Kategorie nichts und lässt Sie ohne Datum und ohne ausgehenden Link zurück.
Video-Pins haben ein anderes Problem. Ihr JSON-LD-image ist ein .jpg-Standbild, und der Block enthält keine contentUrl, duration oder embedUrl.
Das Video selbst ist ein HLS-Manifest, das HTTP-Live-Streaming-Playlist-Format, auf v1.pinimg.com. Es erscheint im Seiten-HTML statt im strukturierten Block, sodass ein Video-Pin erfolgreich geparst wird und ein Thumbnail zurückgibt. Datensätze aus der Scraper API enthalten direkt video_length und eine Medien-URL, was Video-Pins ohne eine zweite Anfrage identifiziert.
Die Mischung hängt vom Konto ab und kann sich umkehren. Separat untersucht, lieferte der Feed eines Food-Kontos 19 von 25 Pins als Recipe. Ein reiner headline-Parse hätte für drei Viertel davon einen leeren Titel geliefert. Rezept-Pins fügen recipeYield und aggregateRating hinzu, falls diese für Sie nützlich sind.
Bei Rezept-Pins ist die description oft eine Pinterest-Füllzeichenkette statt etwas, das der Pinner geschrieben hat. Der Code gibt None zurück, statt sie als Inhalt zu behandeln.
Was bei hohem Volumen tatsächlich bricht
Pinterest setzt Akamai vor seine Pin-Seiten, aber nichts in den Antworten deutet darauf hin, dass der Bot Manager dort aktiv ist. Zwölf schnelle Anfragen mit dem Standard-urllib-User-Agent lieferten alle 200. Die Antworten setzten nur csrftoken, _pinterest_sess, _auth und _routing_id. Keines der Akamai-Bot-Manager-Cookies erschien, und keine Sensor-Payload wurde ausgeliefert, sodass es keine TLS-Challenge zu lösen gab.
Über sechs Client-Identitäten hinweg lieferte derselbe Pin jedes Mal seinen JSON-LD-Block. Dazu gehörten ein Chrome-User-Agent, curl, Googlebot und ein leerer String. Das Parsen braucht also keinen gefälschten User-Agent.
Das gilt für eine Residential-Adresse. Über fünf Pins hinweg enthielt eine Residential-Anfrage jedes Mal den JSON-LD-Block, eine Datacenter-Anfrage nie. Beide lieferten die richtige Seite, den richtigen Titel und eine ähnliche Anzahl von Skripten.
Pinterest nennt den Unterschied direkt auf der Seite, unter dem context-Objekt in __PWS_DATA__. is_hosting las false auf der Residential-Seite und true auf der Hosting-Seite, mit is_bot false bei beiden. Der Test ist also die Netzwerkreputation, nicht ein Bot-Score.
Führen Sie scrape_pin von einer Cloud-VM aus, lieferte es bei jedem getesteten Pin None, ohne dass die Seite einen Grund nennt. Ein Fingerprinting-Client ändert nicht die Adresse, von der aus Sie laufen.
Ihre Wahl des HTTP-Clients zählt mehr als all das, sobald Sie für Traffic bezahlen. Die Standardbibliothek urllib sendet keinen Accept-Encoding-Header, sodass der Server unkomprimiert antwortet. Das Stdlib-Beispiel lädt etwa 1,13 MB pro Pin herunter.
Die requests-Bibliothek verhandelt standardmäßig gzip und überträgt etwa 183 KB. Ein Browser, der Brotli anbietet, erhält etwa 124 KB. Das ist dieselbe Seite und dieselben Daten, mit einem 9-fachen Unterschied bei den übertragenen Bytes, entschieden durch die Wahl des Clients.
Das zählt, weil Proxys übertragene Bytes abrechnen. Bei 10.000 Pins bewegt das Stdlib-Beispiel 11,3 GB, verglichen mit 1,83 GB für denselben Job über requests. Beim Listenpreis für Residential von 8 $/GB sind das etwa 90 $ statt 15 $. Nutzen Sie die Stdlib-Version, um zu lernen, wie es funktioniert, und wechseln Sie dann zu requests oder curl_cffi für alles, was Sie tatsächlich betreiben.
Die IP-Reputation verschlechtert sich bei hohem Volumen, nicht Ihr TLS-Fingerprint. Rotation durch Residential-Adressen hilft hier also, während ein Fingerprinting-Client meist nicht hilft. Wenn Sie später eine Pinterest-Seite finden, die den Handshake tatsächlich prüft, ist curl_cffi (Bibliotheksdokumentation) der Standardersatz und lässt das Parsen unberührt:
from curl_cffi import requests as cffi   # pip install curl_cffi

resp = cffi.get("https://www.pinterest.com/pin/99360735523397542/",
                impersonate="chrome", timeout=30)
html = resp.text                 # feed this to the same JSON-LD parse
Zwei Grenzen gelten. Es gibt keinen Zugang zu den internen Pinterest-Endpunkten. PinResource lieferte 403 sowohl an einfaches urllib als auch an einen Chrome-imitierenden Client, sodass der Fingerprint dort nicht das Problem ist. Und es kann keine JavaScript-Challenge beantworten, falls eine ausgeliefert wird.
Der offizielle oEmbed-Endpunkt
Pinterest veröffentlicht einen oEmbed-Endpunkt für öffentliche Pins. Das ist hier die leichteste Einzel-Pin-Abfrage, und er antwortet mit JSON statt einer HTML-Seite. Dieser Aufruf nutzt curl, das bei macOS, Linux und Windows 10 und höher enthalten ist. Sie können es auch testen, indem Sie die URL zuerst direkt in einen Browser einfügen:
PIN="https://www.pinterest.com/pin/99360735523397542/"
curl "https://www.pinterest.com/oembed.json?url=$PIN"
Es antwortet mit Zuschreibung, einem Thumbnail und einem fertigen Embed:
{"version":"1.0","type":"rich","provider_name":"Pinterest","title":" ",
 "author_name":"Sarah Komnick",
 "author_url":"https://www.pinterest.com/sarahkomnick/",
 "thumbnail_url":"https://i.pinimg.com/236x/0d/b9/56/0db956e2c07e1580514b1c19587b4152.jpg",
 "thumbnail_width":236,"thumbnail_height":314,
 "html":"<iframe src=\"https://assets.pinterest.com/ext/embed.html?id=99360735523397542\" ...></iframe>"}
Von den Routen, die Sie selbst ausführen, hat diese die geringste Angriffsfläche. oEmbed ist das Standardformat, das Websites veröffentlichen, damit Dritte ihre Inhalte einbetten können. Es ist eine veröffentlichte Schnittstelle, keine interne API.
Es akzeptiert auch Board- und Profil-URLs, nicht nur Pins. Es lieferte für beide einen echten Titel, wo der Pin-Aufruf ihn leer ließ. Eine Beschreibung, eine Speicheranzahl und ein ausgehender Quelllink sind nicht in der Antwort enthalten.
Pinterest liefert für seine Pin-Seiten weiche 404er. Ein gelöschter Pin, eine nicht existierende numerische ID und ein fehlerhafter Slug lieferten alle HTTP 200. Ebenso eine abgeschnittene ID und eine unbenutzte numerische ID, alle ohne JSON-LD-Block. Jede auf response.status aufgebaute Prüfung misst nichts.
Der oEmbed-Endpunkt antwortet stattdessen mit HTTP 400. Das tat er in allen 5 dieser Fälle, während ein lebender Pin 200 lieferte.
Er überträgt im Median 583 Bytes über 19 Pins hinweg, verglichen mit etwa 124 KB für die Seite. Das macht ihn zum günstigen Weg, eine URL-Liste zu filtern, bevor Sie irgendetwas parsen. 80 aufeinanderfolgende Aufrufe ohne Verzögerung lieferten alle 200, ohne Ratenbegrenzung und ohne Latenzänderung.
Pin-URLs ohne das Suchraster entdecken
Sowohl das JSON-LD-Parsen als auch oEmbed brauchen eine Pin-URL, die Sie bereits haben. Woher kommen also die URLs?
Eine Route sieht naheliegend aus und ist es nicht. Die Pinterest-robots-Datei deklarierte 50 Sitemap:-URLs unter /v3_sitemaps/, als sie geprüft wurde. Die Namen beschreiben genau das, was ein Sammler wollen würde: image_pin_sitemap_recent_engagement_tier_1, video_product_pin_sitemap, mehrere Ebenen von Board-Link-Sitemaps. Alle 50 lieferten HTTP 404.
Eine deklarierte Sitemap ist eine Anfrage wert, bevor Sie sich darauf verlassen.
Für ein Profil oder ein Board kommen die URLs aus RSS. Pinterest veröffentlicht weiterhin unauthentifizierte Feeds unter /<username>/feed.rss und /<username>/<board-slug>.rss:
import re, urllib.request
import xml.etree.ElementTree as ET

UA = ("Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 "
      "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")

def list_pins(feed_url):
    req = urllib.request.Request(feed_url, headers={"User-Agent": UA})
    xml = urllib.request.urlopen(req, timeout=30).read()
    pins = []
    for item in ET.fromstring(xml).findall(".//item"):
        desc = item.findtext("description") or ""
        thumb = re.search(r'src="([^"]+)"', desc)
        pins.append({
            "url": item.findtext("link"),
            "published": item.findtext("pubDate"),
            "thumbnail": thumb.group(1) if thumb else None,
        })
    return pins

if __name__ == "__main__":
    feed = list_pins("https://www.pinterest.com/boredpanda/animals.rss")
    print(f"found {len(feed)} pins")
    print(feed[0])
Ein Board-Feed lieferte eine brauchbare Liste echter Pin-URLs:
found 26 pins
{'url': 'https://www.pinterest.com/pin/150307706316766946/',
 'published': 'Thu, 23 Jul 2026 12:14:04 GMT',
 'thumbnail': 'https://i.pinimg.com/236x/18/a4/8b/18a48b04fbe868130b0a2ad14759fe87.jpg'}
Öffnen Sie eine dieser Feed-URLs in einem Browser, ist die Struktur leicht zu lesen. Jedes <item> enthält den Pin-Link, ein Veröffentlichungsdatum und ein Thumbnail in der Beschreibung:
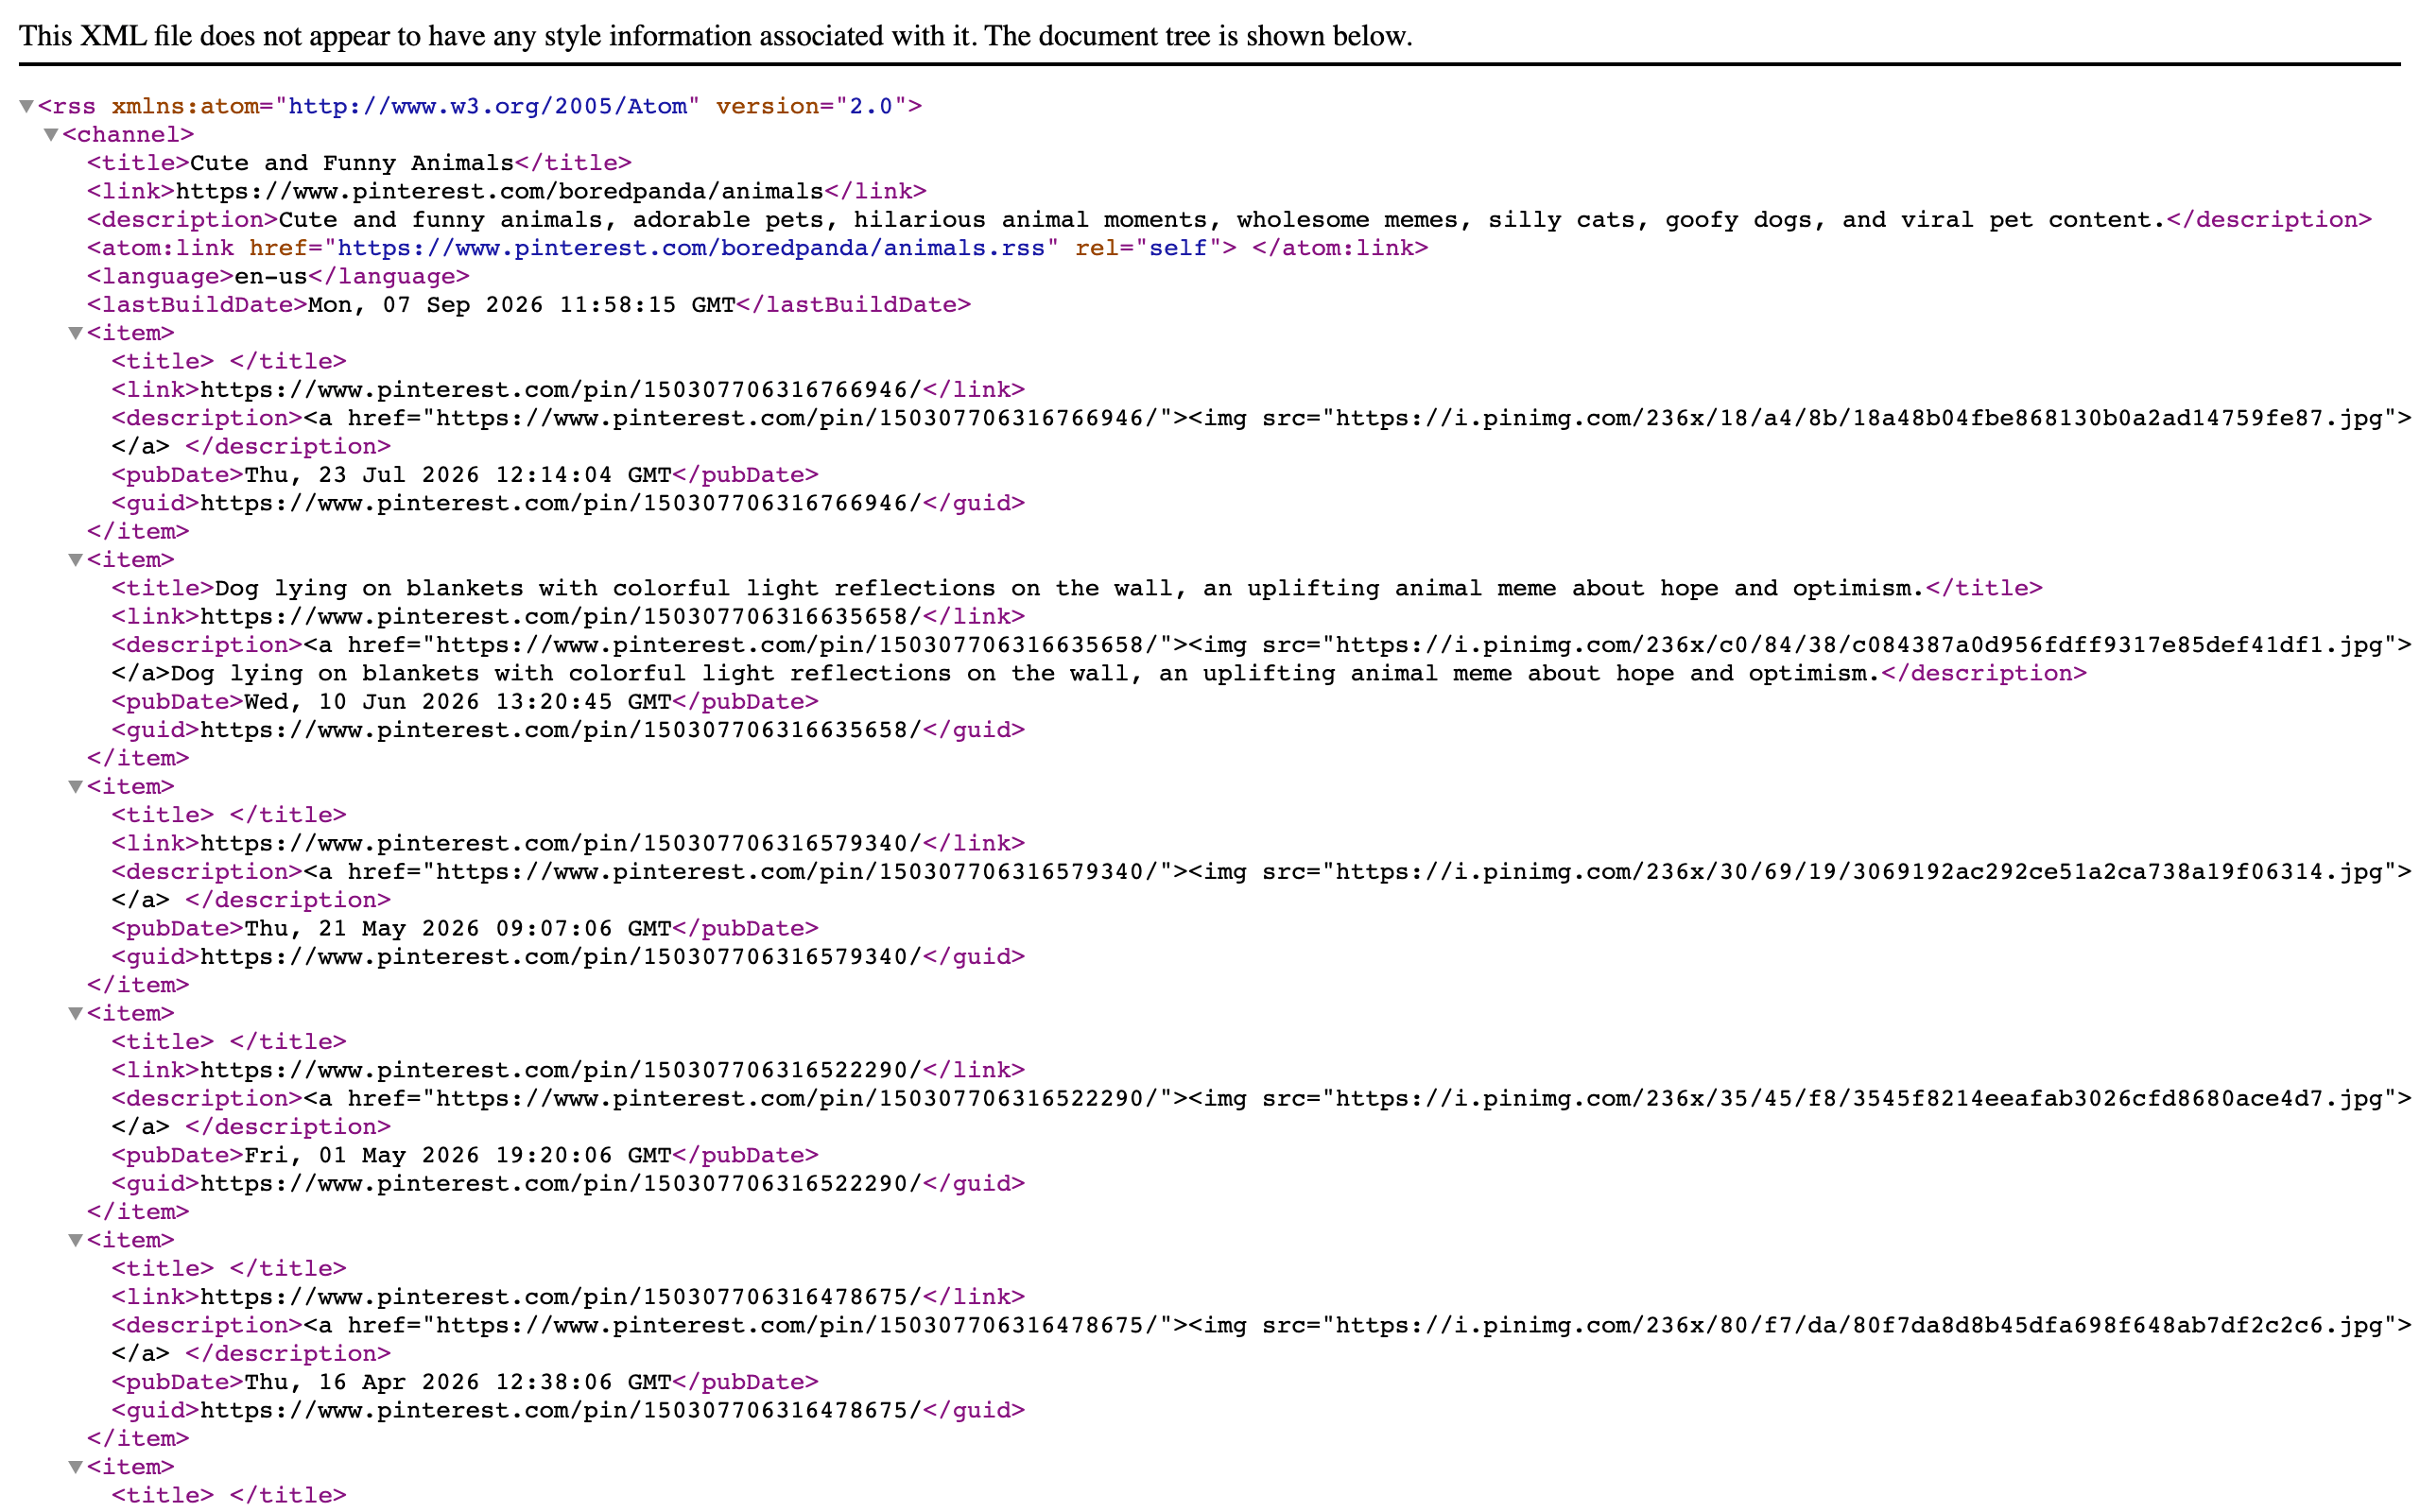
Die leeren <title>-Tags sind der Grund, warum der Feed eine Quelle für URLs statt Metadaten ist. Ein Eintrag in diesem Feed hat einen echten Titel; der Rest ist leer.
Das mit dem Pro-Pin-Parsen zu verketten, ergibt eine vollständige Pipeline, die nie einen Browser lädt. Speichern Sie scrape_pin und list_pins zusammen als pinterest.py, und dies importiert sie unverändert:
import time, json
import xml.etree.ElementTree as ET
from pinterest import scrape_pin, list_pins   # from pinterest.py

def collect_feed(feed_url, delay=0.5):
    records = []
    try:
        pins = list_pins(feed_url)
    except (OSError, ET.ParseError) as err:   # skip a bad feed, keep going
        print(f"skipped feed {feed_url}: {err}")
        return records
    for pin in pins:
        time.sleep(delay)         # before the request, so skips stay polite too
        try:
            record = scrape_pin(pin["url"])
        except (OSError, ValueError) as err:  # transient: keep what you have
            print(f"skipped {pin['url']}: {err}")
            continue
        if record is None:        # deleted pin: the page soft-404s to 200
            continue
        record["url"] = pin["url"]
        record["feed_published"] = pin["published"]
        records.append(record)
    return records

rows = collect_feed("https://www.pinterest.com/foodnetwork/feed.rss")
print(f"{len(rows)} pins enriched")
with open("feed-pins.json", "w") as f:
    json.dump(rows, f, indent=2)
Bei einem Food-Konto druckte es 25 pins enriched in 46 Sekunden. Alle 25 hatten einen Titel, und die Schema-Mischung war 19 Rezepte zu 6 Social-Posts. Feeds waren bei allen 12 getesteten Konten verfügbar, von einzelnen Kreativen bis zu großen Marken. Profil-Feeds lieferten 22 bis 25 Einträge und Board-Feeds 23 bis 26.
Der Feed hat ein festes Limit statt mit dem Board zu wachsen. Ein Board mit fast 6.000 Pins lieferte 24 Einträge, genauso wie ein Board mit 39. Unterhalb dieses Limits erhalten Sie fast alles, was vorhanden ist: ein Board mit 6 Pins lieferte 5.
Ein Profil in eine Reihe von Board-Feeds umwandeln
Ein Konto hat mehr als einen Feed, und die Profilseite listet sie öffentlich auf, mit Namen und Pin-Zahlen und ohne erforderliches Login:
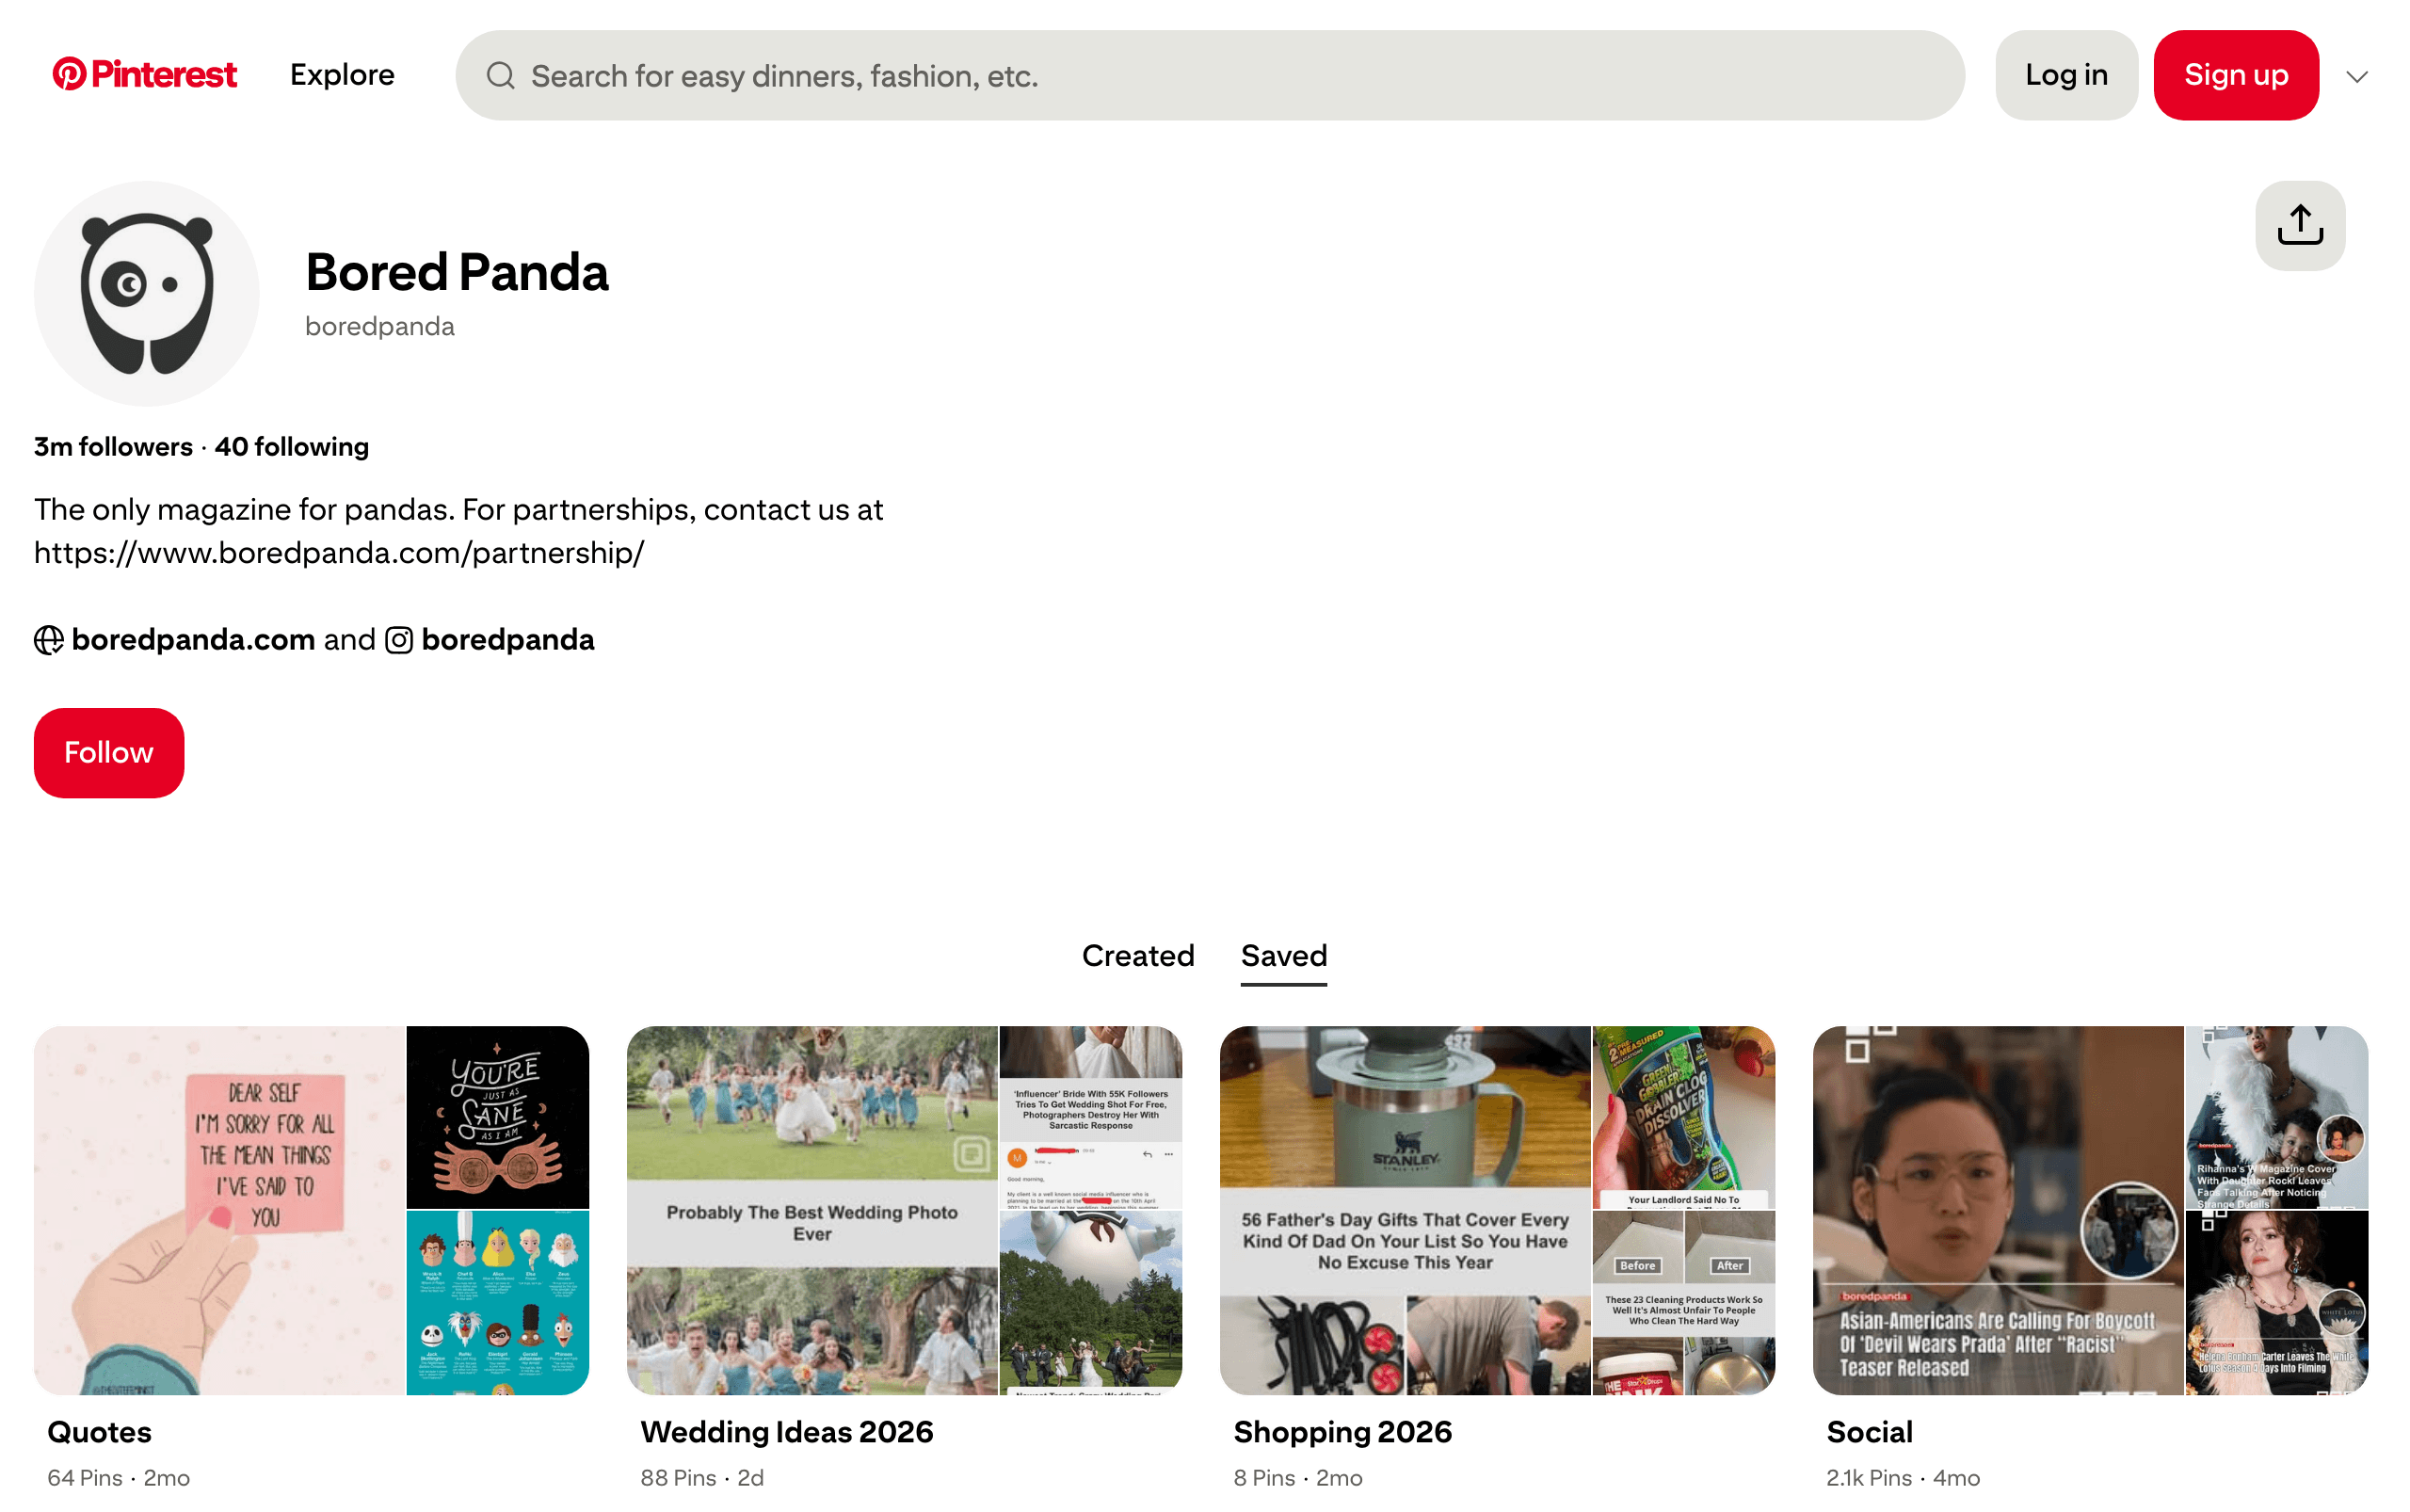
Die Suche erhält ein Login-Modal; ein Profil nicht. Diese Board-Namen sind die Slugs, die list_boards aus dem Seiten-HTML liest. Die Pin-Zahlen verraten, welche Boards das Limit des Feeds erreichen und welche klein genug sind, damit er die meisten davon zurückgibt.
Board-Slugs erscheinen meist im Profil-HTML über einfaches HTTP, sodass ein regulärer Ausdruck einen Kontonamen in eine Reihe von Feed-URLs umwandelt:
import re, requests            # pip install requests

UA = ("Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 "
      "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")
RESERVED = {"pins", "boards", "followers", "following"}   # routes, not boards

def list_boards(handle):
    html = requests.get(f"https://www.pinterest.com/{handle}/",
                        headers={"User-Agent": UA}, timeout=30).text
    found = re.findall(rf'"/{handle}/([A-Za-z0-9][A-Za-z0-9_-]*)/"', html)
    slugs = set(found) - RESERVED
    base = f"https://www.pinterest.com/{handle}"
    return [f"{base}/{s}.rss" for s in sorted(slugs)]

feeds = list_boards("boredpanda")
print(f"{len(feeds)} board feeds")
print(feeds[0])
Ein Konto lieferte neun Board-Feeds:
9 board feeds
https://www.pinterest.com/boredpanda/animal-memes.rss
Neben der Board-Liste bettet das ausgeloggte Profil-HTML einen ProfilePage-JSON-LD-Block ein. Er wurde bei allen 8 getesteten Konten geparst.
Er liefert den Anzeigenamen, den Handle, die Bio, die Avatar-URL und das Erstellungsdatum des Kontos. Ein sameAs-Array verweist auf die anderen Profile des Inhabers, was bei diesen Konten Instagram und die eigene Domain bedeutete. Sechs der 8 enthielten auch eine Followerzahl unter interactionStatistic, wobei die von Etsy über 11 Millionen anzeigte. Das ist dasselbe Parsen wie bei der Pin-Seite, nur auf eine andere URL gerichtet.
Das Durchlaufen aller 9 Board-Feeds mit list_pins lieferte 208 eindeutige Pin-URLs von boredpanda, verglichen mit den 25, die ein einzelner Feed liefert. Kein Pin erschien in zwei Board-Feeds. Jedes getestete Konto listete seine Boards auf diese Weise: 10 von 10, zwischen 8 und 10 Slugs jeweils. Der Feed des ersten Boards lieferte bei allen 10 Einträge.
Diese 9 sind die Boards, die die Profilseite zeigt, nicht die vollständige Menge des Kontos. Der API-Profildatensatz meldet 51 für dasselbe Konto. Einfaches HTTP erreicht 9 von diesen 51, jeweils durch dasselbe 25-Eintrags-Limit.
Der zuvor verwendete animals-Feed ist einer, den es übersieht, sodass ein bereits bekanntes Board immer noch eine direkte Anfrage wert ist. Ein lebendes Profil kann auch überhaupt keine Slugs liefern. Behandeln Sie eine leere Liste als Signal, den Handle zu prüfen, nicht als Beweis, dass das Konto keine Boards hat.
Feed-Titel waren bei allen getesteten Feeds bis auf einen Eintrag leer. Lassen Sie das Pro-Pin-Parsen den Rest liefern.
Zwei Wege über das Feed-Limit hinaus
Der Profile-Scraper in der Scraper API erreicht die Board-Liste aus der anderen Richtung. boards_num meldete 51 Boards für boredpanda, sodass Sie die Größe der Menge kennen, bevor Sie beginnen.
Jeder Eintrag in seinem saved-Array enthält eine saved_collection_url, und diese URL plus .rss lieferte bei allen 6 getesteten Boards einen Feed. Das Array selbst lieferte 10 dieser 51, eine weitere Teilliste.
Entfernen Sie den abschließenden Schrägstrich, bevor Sie anhängen. saved_collection_url endet mit einem, und Pinterest behandelt die beiden resultierenden Formen sehr unterschiedlich. Endet es auf quotes.rss, liefert es einen 13-KB-Feed.
Endet es auf quotes/.rss, liefert es stattdessen HTTP 200 und die HTML-App. Das scheitert in Ihrem XML-Parser mit einem Fehler für ungültiges Token, der auf eine JavaScript-Zeile verweist. Bauen Sie die URL mit saved_collection_url.rstrip("/") + ".rss" auf, dann kann diese Form den Parser nicht erreichen.
Das ältere Widget-Backend unter widgets.pinterest.com/v3/pidgets/ beantwortet ebenfalls unauthentifizierte Anfragen, und bei den meisten Boards lieferte es mehr als RSS. Sein Board-Endpunkt lieferte 50 Pins, wo der Feed desselben Boards 26 lieferte, jeweils mit Beschreibung. Er meldet auch eine Board-weite pin_count, sodass Sie ein Gefühl dafür bekommen, was Ihnen fehlt.
Fünfzig ist ein Limit, keine Seitengröße. page, offset, limit, count und page_size wurden alle ignoriert und lieferten jeweils dieselben 50. Über neun Boards bei boredpanda erreichte das Widget-Backend 362 eindeutige Pins, verglichen mit 208 aus den Board-Feeds. Beide zusammen erreichten 435, von mehr als 9.000, die auf diesen Boards gespeichert sind.
Drei Dinge, bevor Sie sich darauf verlassen. Sein repin_count ist nicht die JSON-LD-Speicheranzahl. Zusammen gelesen, lieferte er beim in diesem Leitfaden durchgängig verwendeten Pin 77, während das JSON-LD 196 lieferte. Nur die JSON-LD-Zahl ist die, die Pinterest als Saves kennzeichnet.
Ausgehende Links variieren je nach Board: 50 von 50 Pins bei einem, 5 von 43 bei einem anderen. Beschreibungen kamen bei fast jedem Pin an. Und es ist nicht immer besser: Bei einem kleinen Board lieferte RSS 9 zu dessen 8. Der Endpunkt ist undokumentiert, hat keine Suche und keine Kompatibilitätsgarantie.
Über diesen fünfzigsten Pin hinaus, oder nach Zeitplan, läuft der Profil-Crawl in der Scraper API über das gesamte Konto als Hintergrundjob. Er liefert für jeden gefundenen Pin einen strukturierten Datensatz.
Die Entdeckung in der Scraper API funktioniert auf Profilebene, also geben Sie die Profil-URL an und filtern die Datensätze nach dem gewünschten Board. Bei zwei getesteten Boards lieferte eine Board-URL das Profil statt des in der Anfrage genannten Boards.
Warum die kostenlosen Methoden bei der Suche aufhören
Rufen Sie eine Suchergebnisseite ab, hat das HTML null JSON-LD-Blöcke. Das Raster wird von späteren Browseranfragen aufgebaut, und diese sind für ausgeloggte Sitzungen gesperrt. Stand September 2026 listet der __PWS_DATA__-Block zehn lop_unauth_lockdown_*-Experimente, darunter _main, _closeup und _search.
Zwei der zehn nennen die in diesem Leitfaden verwendeten Routen: lop_unauth_lockdown_profile und lop_unauth_lockdown_board. Die Sperre für ausgeloggte Nutzer ist ein laufendes Experiment, kein dauerhafter Teil der Website. Behandeln Sie den Zugang zu Profil und Board also als etwas, das es zu beobachten gilt, statt es anzunehmen.
Derselbe Block zeigt, was die Sperre prüft, weil Pinterest seine eigene Sicht auf Ihren Client darin festhält. Unter context enthalten Pin-, Such- und Profilseiten alle dieselben 15 Klassifizierungsfelder. Dazu gehören is_bot, is_proxy, is_vpn, is_tor, is_hosting, is_unauth_botspam_asn und is_authenticated.
Von einer gewöhnlichen Residential-Adresse angefragt, lieferte is_bot "false" und jedes Proxy- und Hosting-Flag lieferte false. Das Suchraster war trotzdem gesperrt. Die Lockdown-Experimente lesen den ausgeloggten Zustand, keinen Bot-Score.
is_hosting trennte die Abrufe, die den JSON-LD eines Pins lieferten, von denen, die ohne ihn ankamen. Lesen Sie also context aus dem <script id="__PWS_DATA__">-Tag auf einer einzelnen Pin-Seite. Das ist der günstigste Weg zu bestätigen, dass die Adresse, von der Sie sammeln, so aussieht, wie erwartet. Tun Sie das, bevor Sie einen Durchlauf verschwenden, indem Sie eine niedrige Datensatzzahl Ihrem Parser zuschreiben.
Es ist undokumentiert und intern, kein Versprechen, das Pinterest gibt, also behandeln Sie es als eine Prüfung, die Sie wiederholen. Das Objekt enthält auch eine unauth_id und das Land und die Region Ihrer IP. Maskieren Sie diese, bevor die Daten Ihre Maschine verlassen.
Diese Prüfung ist das JSON-LD-Parsen, auf das andere Script-Tag gerichtet:
import json, re, urllib.request

UA = ("Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 "
      "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")
FLAGS = ("is_bot", "is_proxy", "is_vpn", "is_tor", "is_hosting",
         "is_unauth_botspam_asn", "is_authenticated")

def how_pinterest_sees_you(url):
    req = urllib.request.Request(url, headers={"User-Agent": UA})
    resp = urllib.request.urlopen(req, timeout=30)
    html = resp.read().decode("utf-8", "ignore")
    block = re.search(
        r'<script id="__PWS_DATA__" type="application/json">(.*?)</script>',
        html, re.S)
    if not block:
        return None
    ctx = json.loads(block.group(1)).get("context") or {}
    # this object also holds unauth_id and your IP geo: don't return those
    return {k: ctx.get(k) for k in FLAGS}

print(how_pinterest_sees_you(
    "https://www.pinterest.com/pin/99360735523397542/"))
Führen Sie es von einer Heimverbindung und von einer Cloud-VM aus, bewegt sich ein Feld:
# residential
{'is_bot': 'false', 'is_proxy': False, 'is_vpn': False, 'is_tor': False,
 'is_hosting': False, 'is_unauth_botspam_asn': False, 'is_authenticated': False}

# same pin, same parse, hosting range
{'is_bot': 'false', 'is_proxy': False, 'is_vpn': False, 'is_tor': False,
 'is_hosting': True, 'is_unauth_botspam_asn': False, 'is_authenticated': False}
is_bot kommt als String "false" an, während die anderen Flags echte Booleans sind, vergleichen Sie es also als String. is_hosting ist das Feld, das sich bewegt, und es entscheidet, ob die Pin-Seite einen JSON-LD-Block enthält.
Die internen JSON-Endpunkte, die ältere Leitfäden aufrufen, sind als Klasse geschlossen, nicht einzeln. PinResource, BoardFeedResource, UserResource, BaseSearchResource und RelatedModulesResource lieferten alle HTTP 403 auf unauthentifizierte Anfragen. Das galt mit oder ohne TLS-Fingerprint, der einem echten Browser entspricht.
Anfragen laufen als CDN über Akamai. Dieselbe Cookie-Prüfung auf Such- und Profilseiten zeigte auch dort keine Bot-Manager-Markierungen.
Warum die offizielle Pinterest-API kein Scraping-Tool ist
Pinterest betreibt tatsächlich eine REST-API, und es ist verlockend, sie zuerst zu versuchen. Sie wird öffentliche Inhalte in keinem nützlichen Umfang sammeln, und der Grund ist der Umfang, nicht die Qualität.
Die API v5 ist für die Verwaltung des eigenen Kontos gebaut: Ihre Boards, Ihre Pins, Ihre Anzeigen, Ihre Analysen. Die org_read-Kategorie gilt für “Abrufen von Nutzerkonten, Boards, Board-Abschnitten oder Pins” für das authentifizierte Konto. Abgesehen von der Partner-Such-Beta liefert kein Endpunkt einen öffentlichen Pin, den Sie nicht besitzen.
Die einzige Keyword-Suche ist GET /v5/search/partner/pins, eine Beta, die “nicht allen Apps zur Verfügung steht” und die Top 10 Pins liefert. Die Daten, die die meisten Scraping-Projekte wollen, öffentliche Pins und Profile anderer Leute, sind über die API nicht erreichbar.
Dieselbe Seite veröffentlicht auch die Ratenlimits. Stand September 2026 erlaubte der Testzugang 1.000 Anfragen pro Tag über alle Endpunkte. Der Standardzugang erlaubte 100 Anfragen pro Sekunde pro Nutzer pro App. Pinterest merkt dort an, dass alle davon “ohne Vorankündigung geändert werden können”.
Für öffentliche Daten von Dritten im großen Umfang ist die offizielle API das falsche Werkzeug. Die Sammlung über die einfachen HTTP-Routen hinaus braucht also Browser-Automatisierung oder einen verwalteten Scraper.
Pinterest mit Playwright scrapen
Die Suche ist die eine Route, die einen Browser zum Rendern der Seite braucht, und Playwright steuert einen von Python aus. Falls Sie es noch nie benutzt haben, hat der Bright-Data-Blog eine längere Playwright-Anleitung, deren API genauso funktioniert.
Wissen Sie, was diese Route liefert, bevor Sie sie installieren: Bild-URLs und sonst nichts, ohne Titel, ohne Beschreibungen und ohne Pin-Links. Wenn das für Ihren Anwendungsfall nicht ausreicht, lesen Sie Wo der Browser-Ansatz versagt und überspringen Sie die Installation.
Installieren Sie die Bibliothek und einen Browser:
pip install playwright
playwright install chromium
Dieses Skript öffnet eine Suchseite, scrollt und liest die Pin-Kacheln. Ein Detail ist zuerst wichtig: Der Kachelselektor hat sich geändert. Ältere Leitfäden zielen auf div[data-test-id='pinWrapper'], was heute auf der ausgeloggten Website auf nichts passt. Das aktuelle ausgeloggte Raster verwendet gated-pin-rep für jede Kachel und gated-pin-image für ihr Bild:
import asyncio, json
from playwright.async_api import async_playwright

BROWSER_UA = ("Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
              "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")

async def scrape_pins(query, scrolls=6):
    url = f"https://www.pinterest.com/search/pins/?q={query}&rs=typed"
    seen = set()
    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=True)
        page = await browser.new_page(user_agent=BROWSER_UA,
                                      viewport={"width": 1280, "height": 900})
        await page.goto(url, wait_until="domcontentloaded")
        for _ in range(scrolls):
            await asyncio.sleep(1.5)
            images = await page.query_selector_all(
                "[data-test-id='gated-pin-image'] img")
            for img in images:
                src = await img.get_attribute("src")
                if src and "/236x/" in src:   # pin thumbnails, not UI images
                    seen.add(src)
            await page.mouse.wheel(0, 4000)
        await browser.close()
    return sorted(seen)

async def main():
    results = await scrape_pins("minimalist%20office")
    print(f"collected {len(results)} thumbnail URLs")
    with open("office-pins.json", "w") as f:
        json.dump(results, f, indent=2)

if __name__ == "__main__":
    asyncio.run(main())
Einen User-Agent zu setzen ist der am häufigsten wiederholte Ratschlag zum Pinterest-Scraping, und er tut nicht, was behauptet wird. Kein Override, ein aktueller Chrome-String, ein zwei Jahre alter Chrome-String und ein wörtliches python-requests/2.32.3 liefern alle HTTP 200 und dieselbe Kachelzahl. Jedes lieferte keine Pin-Links und dasselbe Login-Modal. Behalten Sie trotzdem einen sinnvollen bei, da es nichts kostet und Ihren Traffic ehrlich identifiziert.
Die Menge zählt, weil Pinterest Kachel-Knoten beim Scrollen wiederverwendet. Führen Sie es aus, und eine ausgeloggte Sitzung druckt:
collected 16 thumbnail URLsPlaywright liefert also Thumbnail-URLs aus der Suche, und nichts darüber hinaus.
Das Vollbild von einem Pinterest-Thumbnail bekommen
Die von diesen Durchläufen gelieferten Thumbnails sind 236 Pixel breit. Wenn Sie bereits den JSON-LD oder einen API-Datensatz des Pins haben, ist die Vollbild-URL darin enthalten, und kein Umschreiben ist nötig. Arbeiten Sie stattdessen von einem Thumbnail aus, befindet sich die Vollbilddatei am selben Pfad mit ersetztem Größensegment. Dieser Austausch wird meist als einzeiliger String-Ersatz geschrieben, und das allein scheitert meist.
Über 40 Thumbnails aus lebenden Feeds hinweg funktionierte das Ersetzen von /236x/ durch /originals/ bei Beibehaltung der .jpg-Erweiterung 5 Mal. Es lieferte die anderen 35 Male HTTP 403. Pinterest kodiert neu: Das Thumbnail wird als .jpg ausgeliefert, während das gespeicherte Original oft .png ist. Die Erweiterungen der Reihe nach zu versuchen, funktionierte bei allen 40.
Die Datei, die Sie herunterladen, ist das Foto einer anderen Person, also ist alles, was Sie damit tun, eine Lizenzfrage statt eine Scraping-Frage:
import re, urllib.request

UA = ("Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 "
      "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")

def full_size(thumb_url):
    """Pinterest re-encodes, so the original's extension often differs."""
    base = re.sub(r"/\d+x\d*/", "/originals/", thumb_url).rsplit(".", 1)[0]
    for ext in ("jpg", "png", "webp", "gif"):
        candidate = f"{base}.{ext}"
        req = urllib.request.Request(candidate, method="HEAD",
                                     headers={"User-Agent": UA})
        try:
            if urllib.request.urlopen(req, timeout=15).status == 200:
                return candidate
        except Exception:
            continue
    return None
Ändern Sie die Reihenfolge trotzdem nicht, denn welche Erweiterung funktioniert, variiert je nach Konto. Eine Stichprobe von 40 lieferte 35 Mal .png und 5 Mal .jpg. Eine spätere Stichprobe von 40 über vier Konten hinweg lieferte 19 Mal .webp, 15 Mal .jpg und 6 Mal .png. Dabei war ein Konto vollständig .jpg, ein anderes vollständig .webp, und ein drittes meist .png.
Planen Sie mit etwa zwei HEAD-Anfragen pro Bild: Bei dieser Vier-Konten-Stichprobe lag die Schleife im Durchschnitt bei 2,1 Abfragen, bevor sie die Datei fand.
Wo der Browser-Ansatz versagt
Playwright verpasst den Rest des Datensatzes. Der alt-Text jeder Kachel ist der wörtliche String Pin, sodass die Kacheln keine Titel haben. Keine von ihnen umschließt auch einen /pin/-Link, sodass das Raster Ihnen nichts zum Folgen gibt.
Sie erhalten eine kurze Liste von Bild-URLs und sonst nichts: keine Beschreibungen, kein Pinner, keine Saves, keine Hashtags. Das Laden derselben Suche in einem normalen ausgeloggten Browser zeigt, warum:
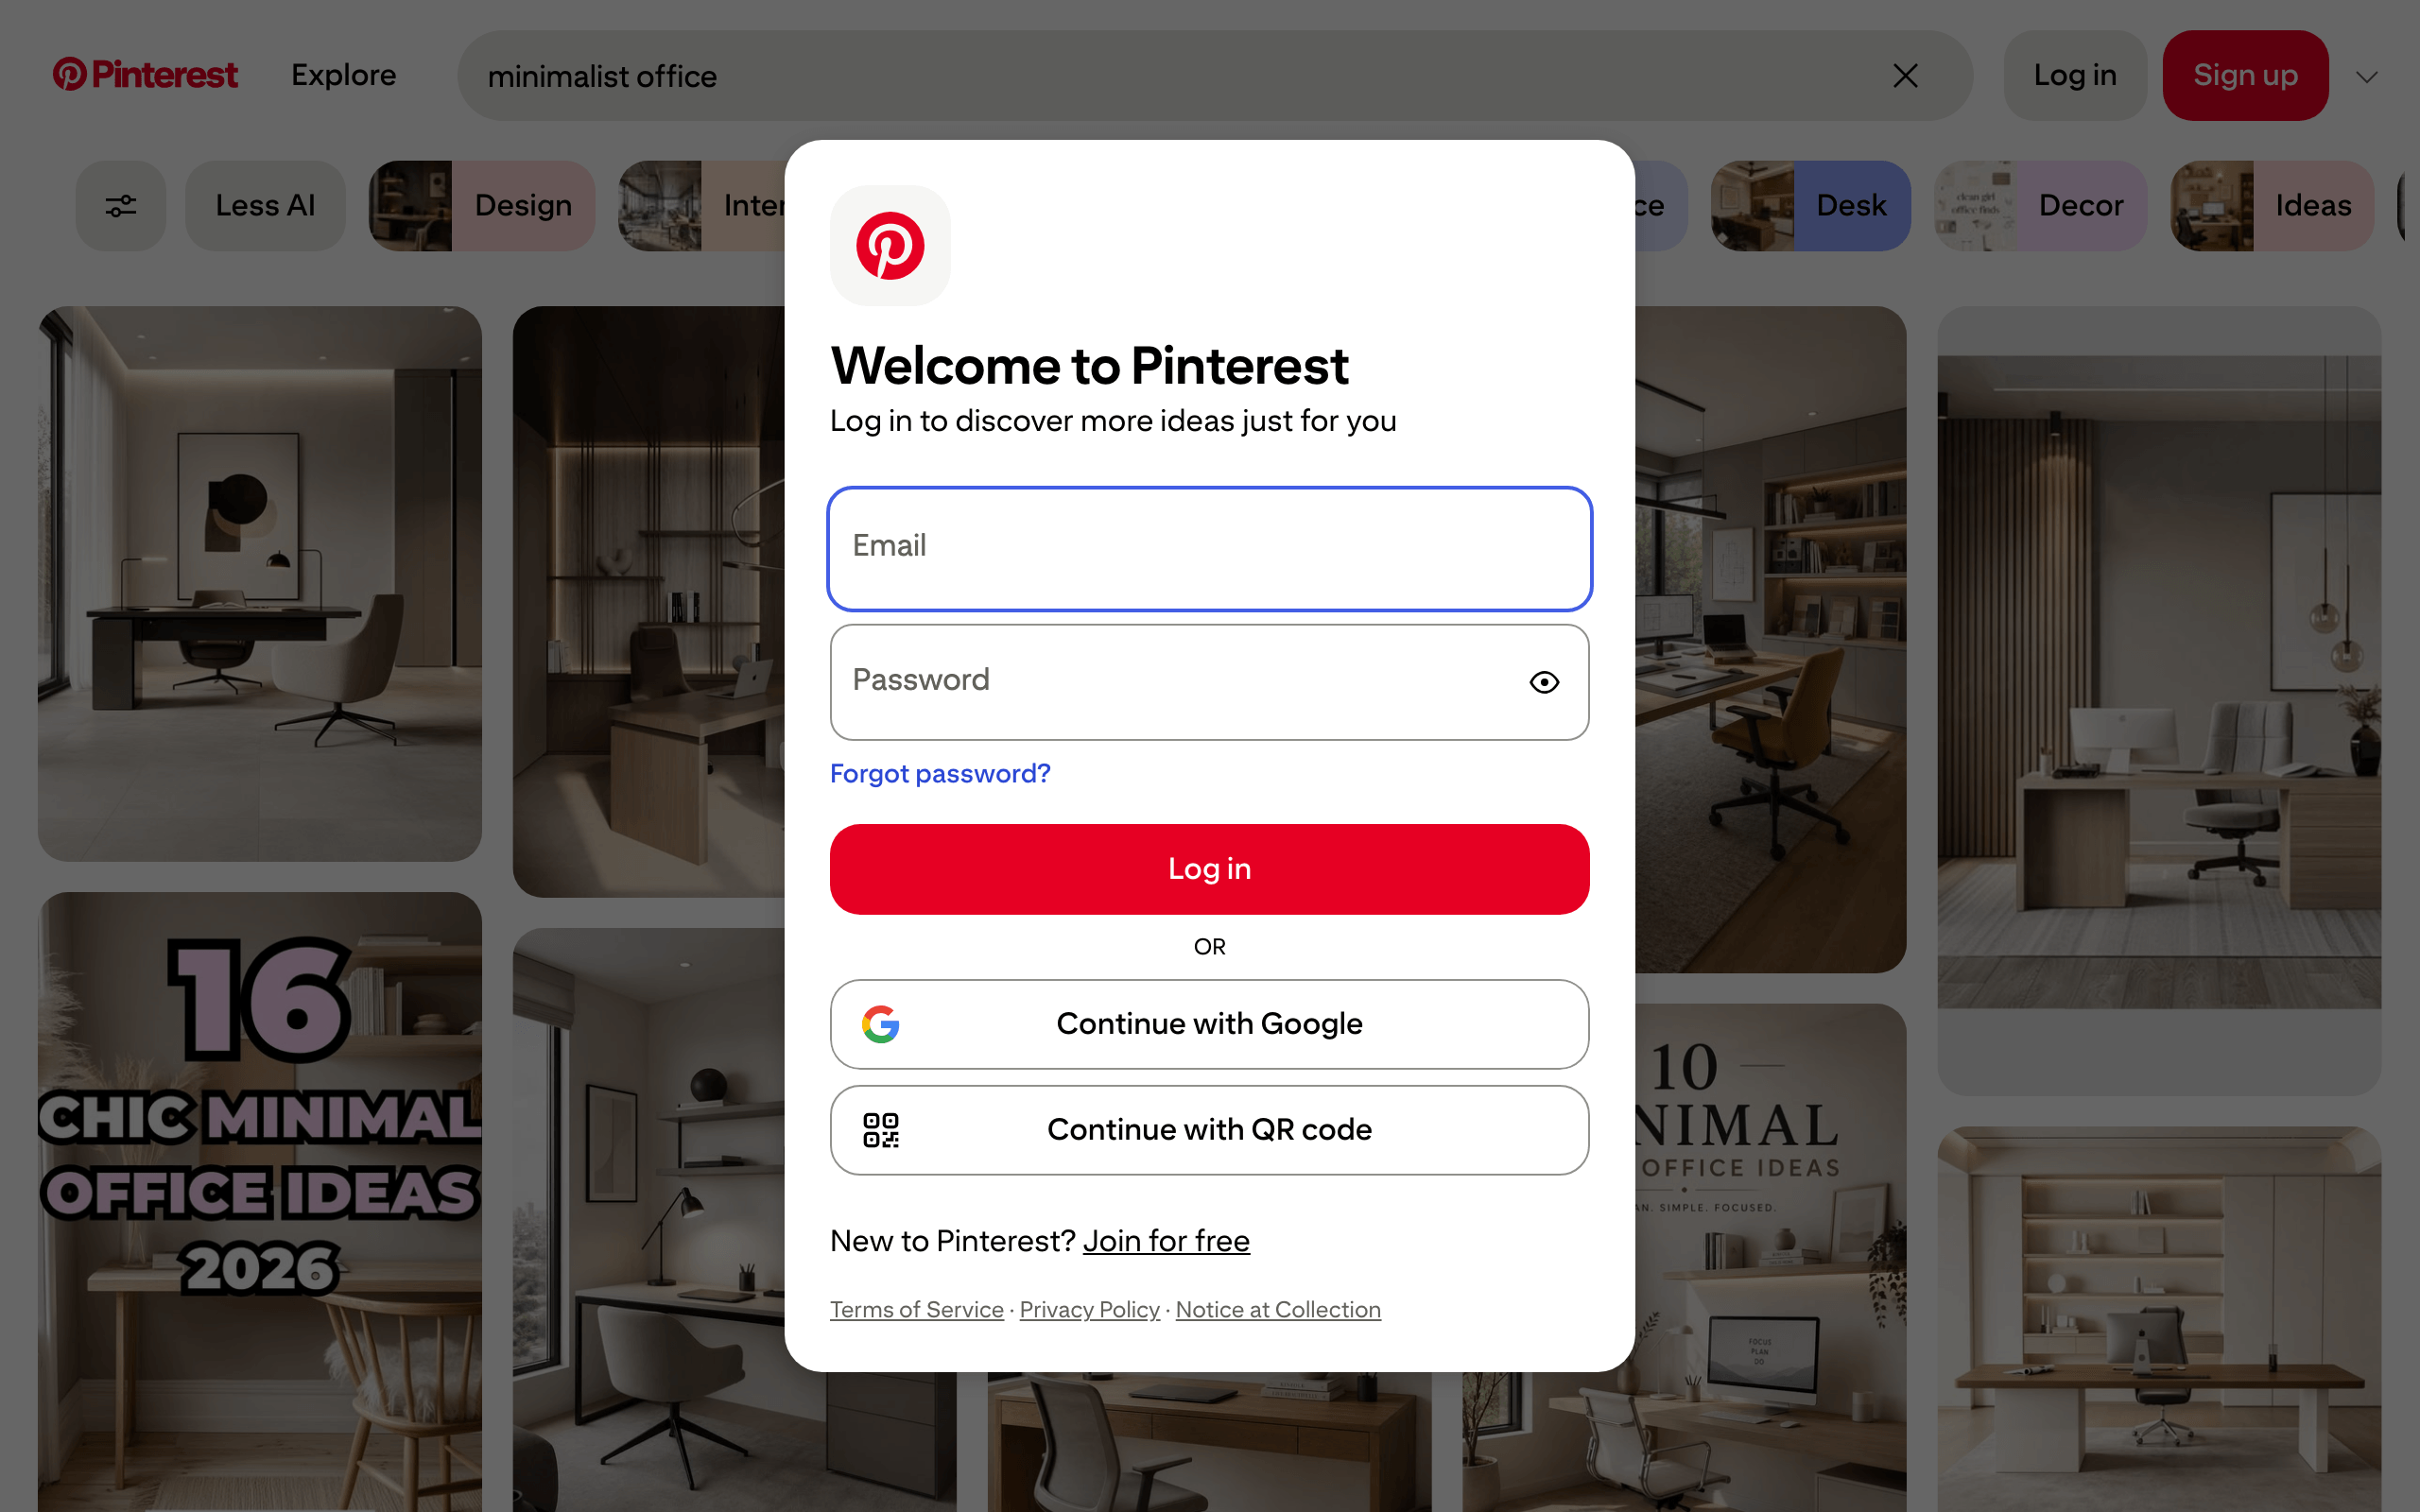
Die Kacheln um das Modal sind dieselben gated-pin-rep-Elemente, die das Skript liest. Jede enthält ein Bild und sonst nichts, weshalb der Durchlauf URLs und keine Titel liefert.
Mehr Scrollen ändert nichts. Das Raster hat nach 3 Scrolls dieselbe Anzahl wie nach 25, und die Menge der Thumbnail-URLs wächst nie darüber hinaus.
Diese Zahl ist innerhalb einer Sitzung stabil und variiert zwischen ihnen. Wiederholte Durchläufe in einer Sitzung lieferten jedes Mal 17 für minimalist office und jedes Mal 15 für fall fashion. Separate Sitzungen zu denselben zwei Suchanfragen lieferten 16, 17 und 18.
Erwarten Sie eine feste Zahl irgendwo im mittleren bis hohen Zehnerbereich. Behandeln Sie die genaue Zahl als sitzungsspezifisch, nicht als verlässliche Größe. Ein Login-Modal verdeckt den Feed und blockiert das unendliche Scrollen, das eine eingeloggte Sitzung erhält, mit einem echten Passwortfeld direkt im DOM.
Warum ein Stealth-Browser das nicht behebt
Der naheliegende nächste Schritt ist ein Stealth-Browser, und das ist die falsche Diagnose für ein gesperrtes Raster. Unverändertes Playwright zeigt tatsächlich Automatisierungssignale auf Protokollebene, am sichtbarsten den Runtime.enable-Aufruf im Chrome-DevTools-Protokoll, und gepatchte Versionen verbergen sie. Patchright ist ein direkter Ersatz für das Playwright-Paket und wurde gebaut, um diese Signale zu verbergen, ohne Ihr Skript anzufassen. Camoufox ist ein separater Firefox-Build statt ein Patch für Playwright.
Auf dieselbe Suchanfrage mit einem rendernden Browser und einem eigenen Proxy-Pool gerichtet, lieferte ein kommerzieller Unblocker die ausgeloggte Seite vollständig. Das bedeutete die Anmeldeaufforderungen, die Kategorie-Buttons, die Filterleiste, und keinen einzigen Pin-Titel oder /pin/-Link.
Führen Sie Patchright parallel zu unverändertem Playwright bei denselben zwei Suchanfragen in einer Sitzung aus, bewegt sich nichts. Beide lieferten 16 Kacheln für minimalist office und 15 für fall fashion. Beide lieferten null /pin/-Links, Pin als Alt-Text jeder Kachel und dasselbe Passwortfeld im DOM.
Eine Kontostatus-Sperre begrenzt den ausgeloggten Feed, nicht ein Bot-Score. Keine Bot-Manager-Cookies erscheinen auf Such- oder Profilseiten. Die zehn lop_unauth_lockdown-Experimente sind in __PWS_DATA__ stand September 2026 aktiv, und die Kachelzahl ist über vier User-Agents hinweg unverändert.
Was es braucht, um weiterzukommen
Um Beschreibungen, Links und Engagement über eine Suche mit dem eigenen Browser zu erreichen, brauchen Sie eine Sitzung, die Pinterest als echten eingeloggten Nutzer behandelt. Das bedeutet, sich anzumelden und Cookies zu halten. Das Automatisieren eines persönlichen Logins verstößt gegen die Nutzungsbedingungen der Plattform, die den Zugriff auf Pinterest-Daten “durch automatisierte Mittel (ohne unsere ausdrückliche vorherige Erlaubnis)” verbieten.
Volumen ist die andere Einschränkung, und bei diesem Ziel ist es IP-Reputation statt Fingerprinting. Rund 250 Anfragen von einer Adresse erzeugten keine Ratenbegrenzung und keine Challenge, sodass das Limit höher ist, als ein erster Versuch vermuten lässt. Kontinuierlicher Betrieb von einer einzigen Adresse ändert das, und das ist das erste von drei Problemen, die ein dauerhafter Scraper bewältigen muss.
Was ein dauerhafter Scraper braucht
Einen Bildschirm voller Thumbnails zu bekommen, ist eine Demo. Tausende vollständiger Pin-Datensätze nach Zeitplan zu sammeln, ist ein Infrastrukturproblem.
- IP-Vielfalt. Residential-Proxys verteilen denselben Job über viele Endkunden-IPs statt eine einzige Datacenter-Adresse. Von den dreien ist dies laut den hier gesammelten Belegen das, wofür es sich zu bezahlen lohnt, und nicht nur im großen Umfang. Eine als Hosting klassifizierte Adresse erhält Pin-Seiten ohne den JSON-LD-Block, sodass das Parsen nur von Endkunden-IPs funktioniert. Rotation zählt darüber hinaus, sobald eine einzelne Adresse kontinuierlich läuft.
- Fingerprint- und Challenge-Handhabung. Ein verwalteter Browser wie die Browser API wurde gebaut, um einen konsistenten echten Fingerprint zu präsentieren. Er beantwortet auch die Challenges, die reines Headless-Chromium unbeantwortet lässt, was eine Pipeline genau in dem Moment braucht, in dem sie auf eine Website trifft, die eine durchsetzt. Die öffentlichen Pinterest-Seiten sind der einfache Fall: keine Bot-Manager-Cookies, keine Sensor-Payload und keine Challenge über sechs Client-Identitäten hinweg.
- Wartung. Selektoren und Sperren ändern sich ohne Vorankündigung, wie der Wechsel von
pinWrapperzugated-pin-repund das Lockdown-Experiment beide zeigen. Scrapling wurde gebaut, um Elemente anhand von Ähnlichkeit wiederzufinden, wenn sich Klassennamen häufig ändern, was bei der Parser-Hälfte des Problems hilft.
Sie können all das selbst bauen, und die allgemeinen Muster, um einen Scraper vor Sperrung zu bewahren, gelten hier genauso wie überall.
Der Kompromiss ist, dass das zu laufender Entwicklungsarbeit wird, kein einmal geschriebenes Skript. Wenn die Wartungskosten den Wert übersteigen, die Pipeline selbst zu besitzen, können Sie sie zu einer verwalteten Scraper-API verlagern.
Pinterest mit der Bright Data Scraper API scrapen
Die Bright Data Pinterest Scraper API verlagert die Browser-, Proxy- und Entsperrungsschicht zu einem verwalteten Dienst. Sie senden eine Pin-URL, ein Keyword oder eine Profil-URL, und sie liefert einen strukturierten Datensatz. Sie ist Teil der Web Scraper API, mit einem monatlichen Freikontingent und danach Pay-as-you-go pro gelieferten Datensatz. Jedes Scraper-API-Beispiel in diesem Leitfaden lief innerhalb dieses Kontingents.
Nutzen Sie hier den Pinterest-Scraper statt eines Allzweck-Unblockers: Er liefert geparste Datensätze statt rohes HTML. Allzweck-Zugriffsmodi sind eine separate Route für jede URL über Websites hinweg. Welche davon verfügbar sind, variiert je nach Konto. Es variiert auch je Zone, der benannten Konfiguration, die Sie für jedes Produkt erstellen.
Bright Data wendet die zuvor in diesem Leitfaden beschriebene robots-Positivliste auf dieser Ebene an. Einer dieser Modi lehnte eine Pinterest-Anfrage genau aus diesem Grund rundweg ab.
Die Einrichtung umfasst zwei Schritte. Das Bright-Data-Konto öffnet sich ohne Karte, und Sie erstellen den API-Schlüssel selbst in Ihren Kontoeinstellungen. Ein neues Konto hat noch keine Schlüssel, daher startet die API-Schlüssel-Tabelle leer:
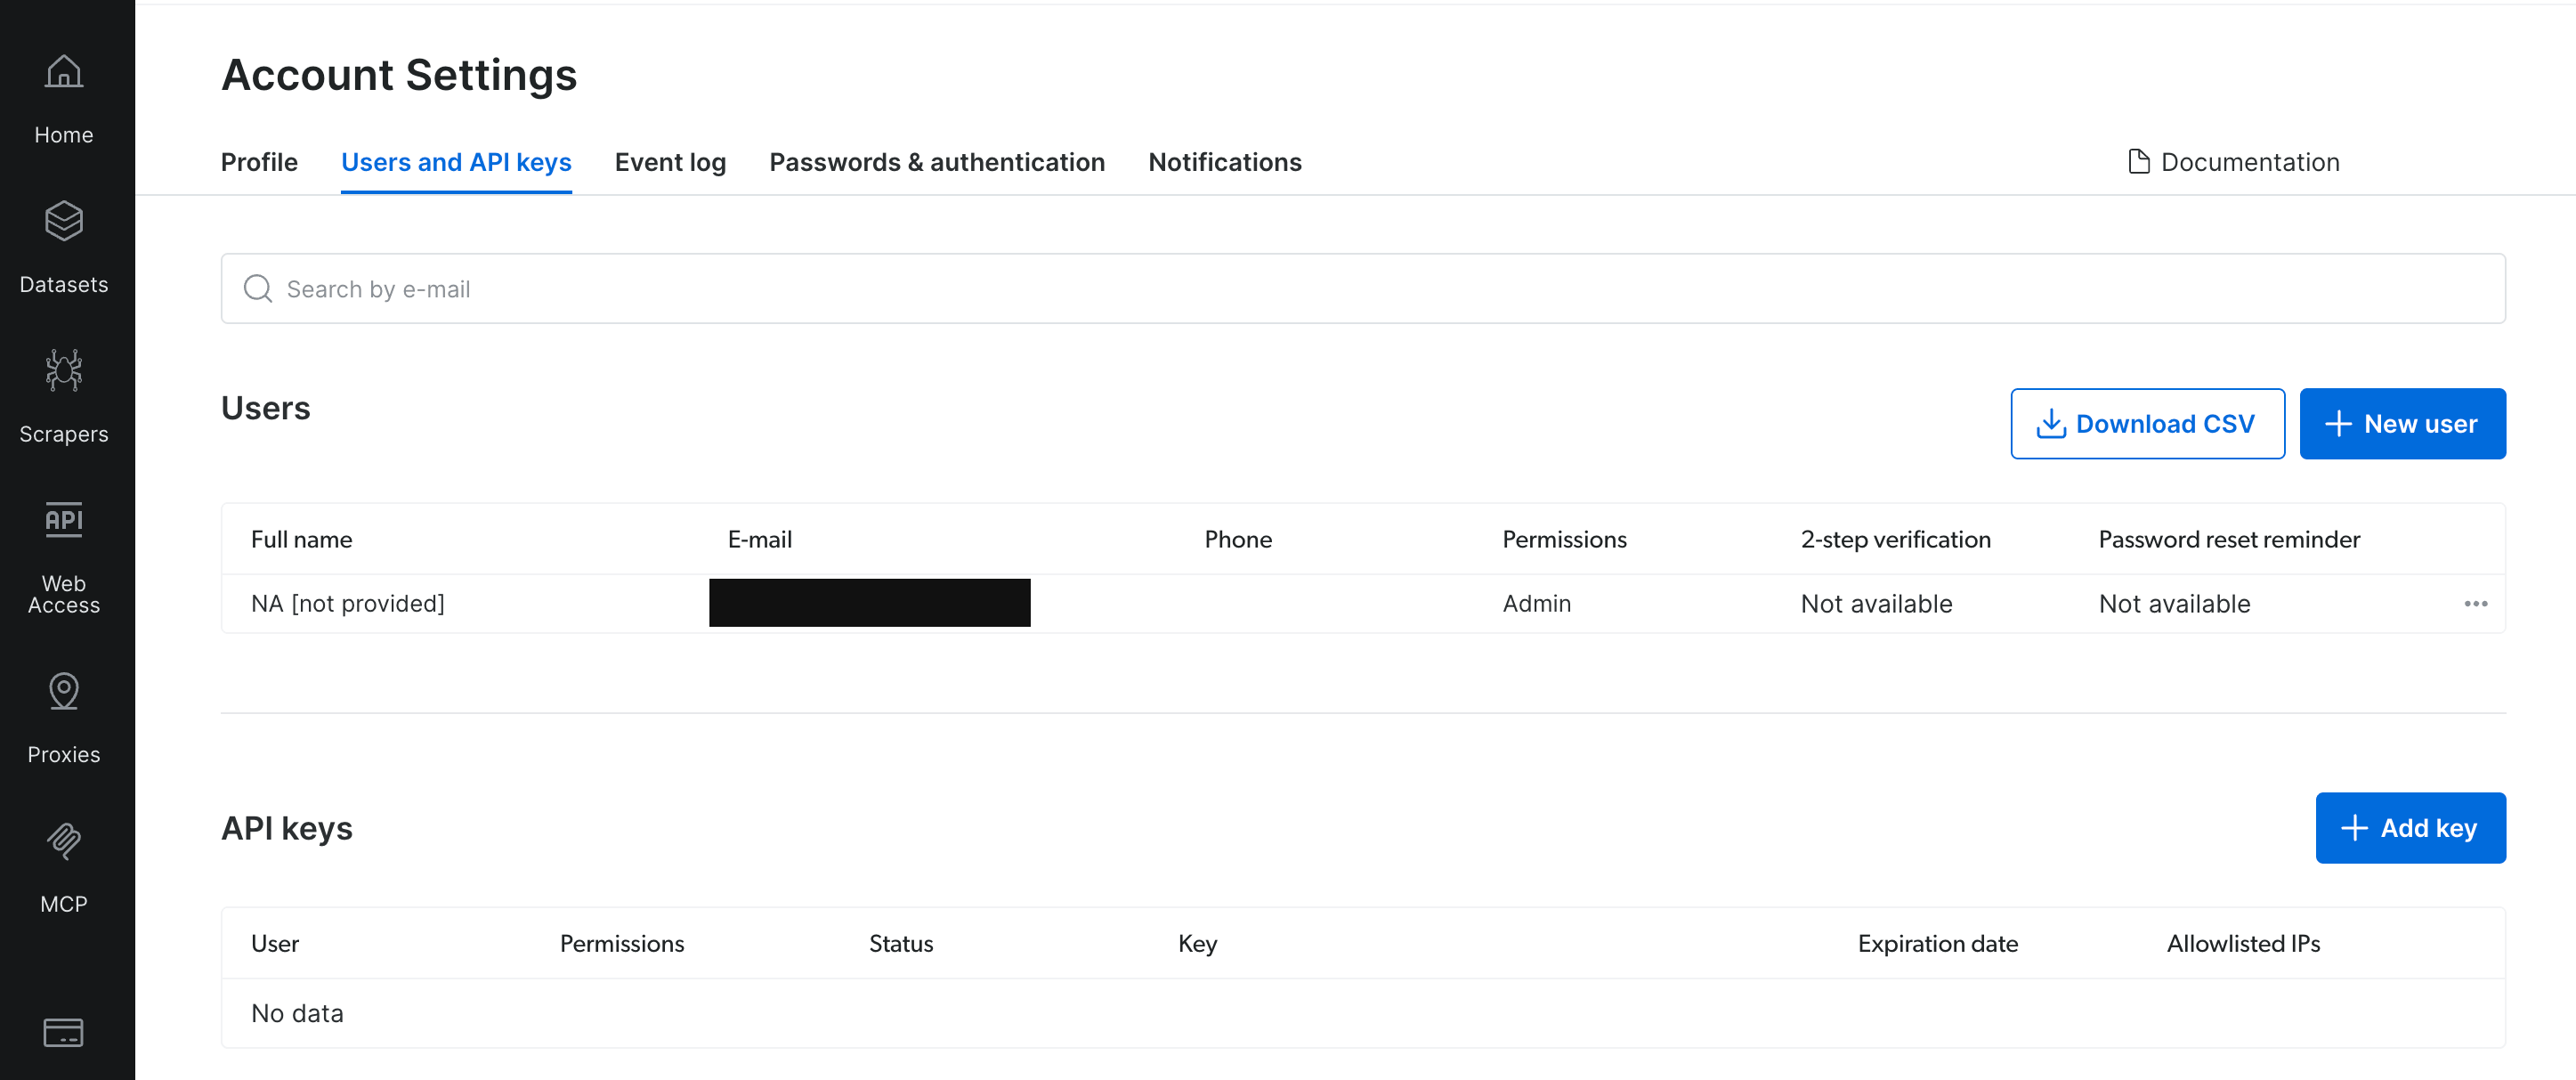
Fügen Sie einen Schlüssel hinzu, und der Dialog fragt nach einem Benutzer, einer Berechtigungsstufe und einem Ablaufdatum.
Wählen Sie die für API-Zugriff vorgesehene Berechtigungsstufe statt Abrechnung oder Verwaltung. Die Bright-Data-Authentifizierungsdokumentation beschreibt sie als diejenige, die “API-Nutzung auf Proxy-/API-Ebene ermöglicht”. Wählen Sie beim Ablaufdatum ein Datum nach Ende Ihres Projekts, damit der Schlüssel nicht mitten im Durchlauf abläuft.
Die Beispiele verwenden das requests-Paket, dasselbe, das zuvor für die Board-Feeds verwendet wurde:
pip install requestsDieses eine Paket ist die gesamte Abhängigkeitsliste. Jeder Sammlungsmodus teilt sich diese Einrichtung, und die Konsole listet sie zusammen auf, sodass Sie sehen können, was jeder tut, bevor Sie etwas schreiben:
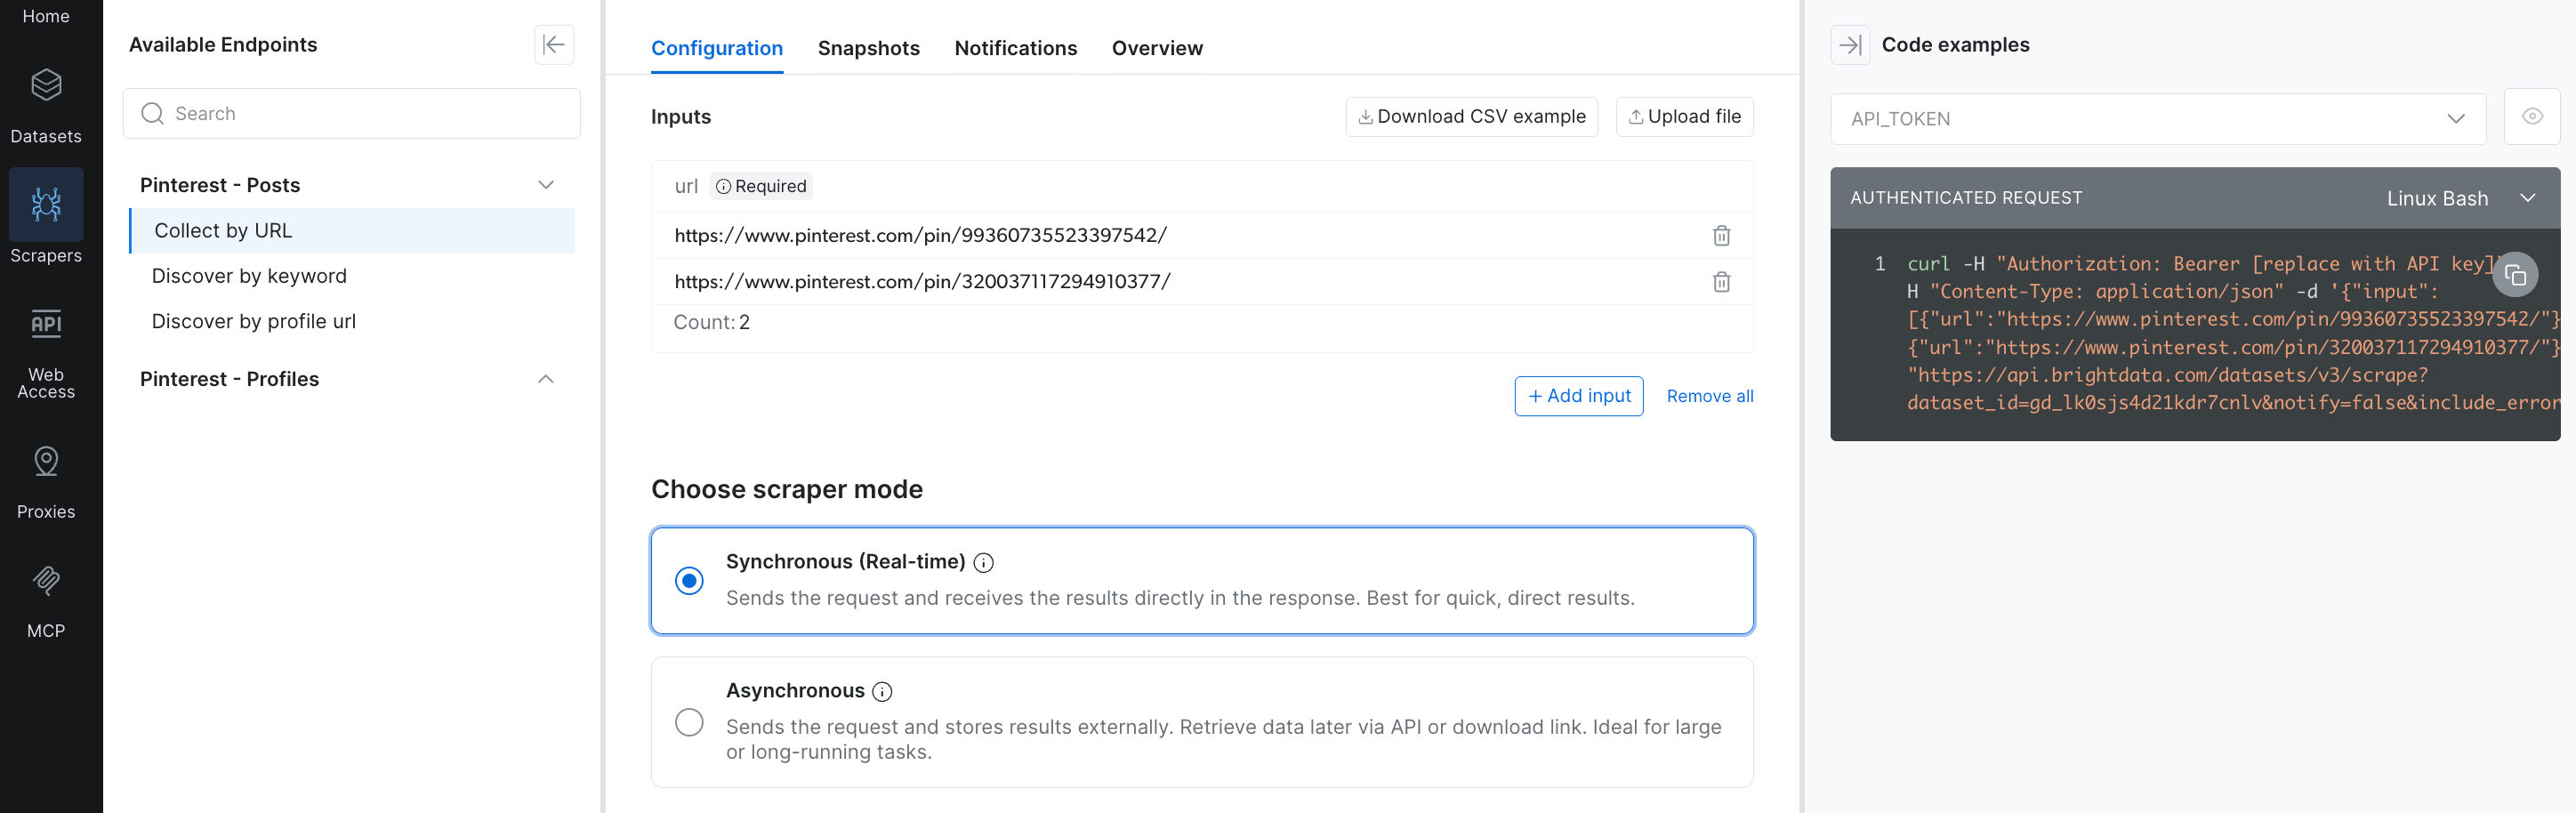
Das Panel listet die Endpunkte dieses Scrapers auf. Die hier verwendeten drei sind Sammeln nach URL, Entdecken nach Keyword und Entdecken nach Profil.
Pins nach URL sammeln
Senden Sie eine oder mehrere Pin-URLs und lesen Sie die Datensätze aus der Antwort. Das Flag include_errors=true lässt die API fehlgeschlagene Eingaben melden, statt sie zu entfernen. Sie filtern die Fehler selbst und sehen im Gegenzug das Ergebnis jeder Eingabe:
import requests

API_KEY = "YOUR_API_KEY"  # create this in your Bright Data account settings
# copy the current dataset ID from the scraper's page
DATASET_ID = "gd_lk0sjs4d21kdr7cnlv"

resp = requests.post(
    "https://api.brightdata.com/datasets/v3/scrape",
    headers={"Authorization": f"Bearer {API_KEY}",
             "Content-Type": "application/json"},
    params={"dataset_id": DATASET_ID, "include_errors": "true"},
    json={"input": [
        {"url": "https://www.pinterest.com/pin/99360735523397542/"},
        {"url": "https://www.pinterest.com/pin/3166662230556591/"},
    ]},
    timeout=60,
)

# an HTTP error raises here, so resp holds records
resp.raise_for_status()
for line in resp.text.strip().splitlines():
    print(line)
Die Antwort ist zeilengetrenntes JSON, ein Objekt pro Eingabe. Die lebende URL lieferte einen Datensatz mit rund zwanzig Feldern, hier auf die relevanten gekürzt. Der entfernte Pin lieferte einen Fehler:
{"url": "https://www.pinterest.com/pin/99360735523397542/", "post_id":
"99360735523397542", "title": "12 Bombshell Hair Color Ideas To Try This
Summer | Ecemella", "content": "Copper Red",
"date_posted": "2023-05-24T22:32:51.000Z", "user_name": "ecemella",
"user_url": "https://www.pinterest.com/ecemella", "likes": 2,
"categories": ["Beauty", "Hair"], "hashtags": ["Casual Fall Outfit
Inspiration", "Fall Fashion Outfit Ideas"], "image_video_url":
"https://i.pinimg.com/originals/0d/b9/56/0db956e2c07e1580514b1c19587b4152.jpg",
"video_length": 0, "post_type": "image", "comments_num": 0}
{"input": {"url": "https://www.pinterest.com/pin/3166662230556591/"},
"error": "Bad input. Page does not exist.", "error_code": "dead_page"}
Der Datensatz stimmt mit dem JSON-LD-Parsen bei Titel, Datum und Bild überein und fügt in einem Aufruf den Pinner-Handle, Kategorien und Hashtags hinzu. Die Speicheranzahl und der ausgehende Quelllink kommen stattdessen aus dem JSON-LD der Pin-Seite.
Die fehlschlagende URL ist eine echte Pin-ID, die Pinterest inzwischen entfernt hat. Die API liefert dafür einen dead_page-Fehler statt eines Absturzes, sodass Sie ihn protokollieren und weitermachen können. Bright Data bepreist die Scraper API pro erfolgreich geliefertem Datensatz, auf dieser Basis sollte ein toter Pin also nicht zur Rechnung beitragen.
Pins werden häufig gelöscht, planen Sie also diesen Fehler in jedem Stapel ein. Gleichen Sie Antworten mit Eingaben über das eigene url– oder input-Feld jedes Objekts ab, nicht über die Position. Über drei identische Durchläufe hinweg kam die Fehlerzeile zweimal zuerst und einmal zweites an.
Der scrape-Endpunkt antwortet meist direkt. Wenn ein Job länger braucht, liefert er eine snapshot_id und eine Noch-in-Bearbeitung-Nachricht, wobei die Datensätze unter dieser ID warten. Prüfen Sie auf eine snapshot_id, bevor Sie die Antwort als Datensätze parsen, egal welchen Modus Sie angefragt haben.
Pins nach Keyword entdecken
Der Entdeckungsmodus ist die Route zur Keyword-Suche, dem einen Bereich, den die Login-Sperre für einfaches HTTP schließt. Das ist der Modus, den Sie nutzen, wenn Sie ein Thema statt einer URL-Liste haben. Fügen Sie type=discover_new und discover_by=keyword hinzu und begrenzen Sie das Volumen pro Keyword mit limit_per_input:
import requests

API_KEY = "YOUR_API_KEY"
# copy the current dataset ID from the scraper's page
DATASET_ID = "gd_lk0sjs4d21kdr7cnlv"

resp = requests.post(
    "https://api.brightdata.com/datasets/v3/scrape",
    headers={"Authorization": f"Bearer {API_KEY}",
             "Content-Type": "application/json"},
    params={"dataset_id": DATASET_ID, "include_errors": "true",
            "type": "discover_new", "discover_by": "keyword"},
    json={"input": [{"keyword": "minimalist office"},
                    {"keyword": "fall fashion"}],
          "limit_per_input": 4},
    timeout=180,
)
# an HTTP error raises here, so resp holds records
resp.raise_for_status()
print(resp.text)
Jedes Keyword liefert bis zu dem von Ihnen gesetzten Limit. Jeder Datensatz fügt ein discovery_input-Feld hinzu, das das findende Keyword nennt. Wo der Pin eine Beschreibung hat, enthält ein content-Feld den vollständigen Text. Ein Datensatz aus dem minimalist office-Durchlauf, mit gekürzter Beschreibung:
{"url": "https://www.pinterest.com/pin/320037117294910377", "title":
"Minimal Cream Office With Ultrawide Monitor, Wood Desk and Natural Window
Light", "content": "A pale wood desk sits beside a bright window with an
ultrawide monitor... #MinimalCreamOffice #PaleWoodWorkspace",
"user_name": "theSetupDistrict", "categories": ["Home Decor"],
"date_posted": "2026-08-25T15:59:51.000Z",
"discovery_input": {"keyword": "minimalist office"}}
Ein Keyword allein reicht also aus, um strukturierte Pin-Datensätze zu erhalten. Die meisten enthalten eine Beschreibung und Kategorien, von denen keine im ausgeloggten Suchraster erscheint.
Ein ganzes Profil mit der asynchronen API crawlen
Jeden Pin auf einem Profil zu crawlen, ist mehr, als eine einzelne Antwort aufnehmen kann, daher läuft die API das als Hintergrundjob. Sie starten den Job, erhalten eine ID und sammeln die Datensätze, wenn er fertig ist. Das Umschalten des Modus in der Konsole zeigt den Unterschied bereits in der Anfrage selbst:
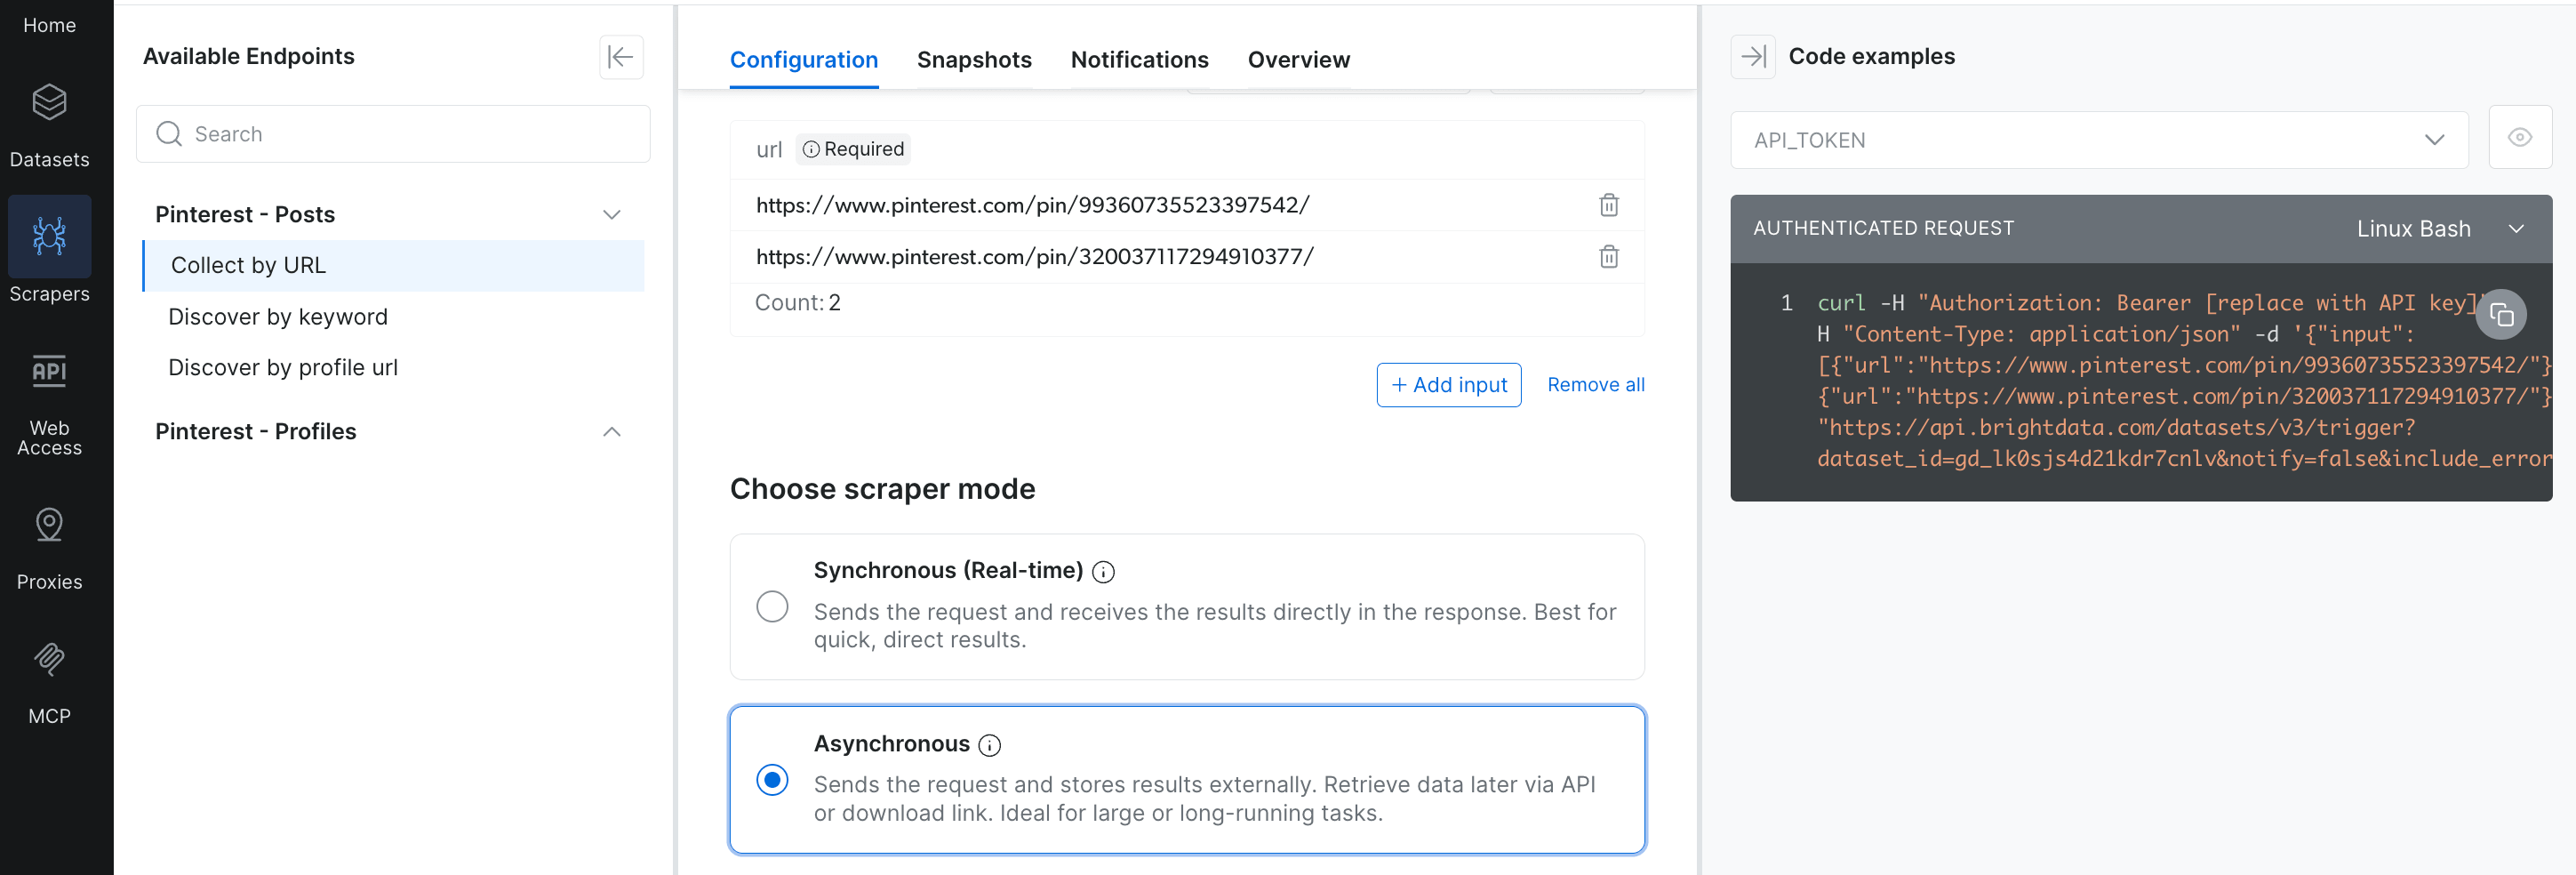
Die Auswahl des asynchronen Modus schreibt den Pfad für Sie um: Der scrape-Endpunkt wird zu trigger. Der Durchlauf liefert dann eine snapshot_id zum Abfragen, statt eine Verbindung offen zu halten.
Nutzen Sie den trigger-Endpunkt, der sofort eine snapshot_id liefert:
import requests

API_KEY = "YOUR_API_KEY"
# copy the current dataset ID from the scraper's page
DATASET_ID = "gd_lk0sjs4d21kdr7cnlv"
HEADERS = {"Authorization": f"Bearer {API_KEY}",
           "Content-Type": "application/json"}

start = requests.post(
    "https://api.brightdata.com/datasets/v3/trigger",
    headers=HEADERS,
    params={"dataset_id": DATASET_ID, "include_errors": "true",
            "type": "discover_new", "discover_by": "profile_url"},
    json={"input": [{"url": "https://www.pinterest.com/boredpanda/",
                     "start_date": "", "end_date": ""}],
          "limit_per_input": 4},
    timeout=60,
)
# an HTTP error raises here, so start.json() holds a real snapshot_id
start.raise_for_status()
snapshot_id = start.json()["snapshot_id"]
print("snapshot:", snapshot_id)
Die leeren start_date und end_date sind optional, und sie leer zu lassen, sammelt ohne Datumsfilter. Fragen Sie dann den Fortschritts-Endpunkt ab, bis der Job bereit ist, und laden Sie den Snapshot herunter. Die Fortschrittsantwort meldet Zahlen und etwaige Fehlercodes, sodass Sie wissen, was Sie bekommen, bevor Sie es abrufen:
import requests, time

API_KEY = "YOUR_API_KEY"
HEADERS = {"Authorization": f"Bearer {API_KEY}",
           "Content-Type": "application/json"}
# printed by the trigger block; keep it to re-download a crashed run
snapshot_id = "sd_..."

progress_url = f"https://api.brightdata.com/datasets/v3/progress/{snapshot_id}"
while True:
    poll = requests.get(progress_url, headers=HEADERS, timeout=30)
    # an HTTP error raises here, so poll.json() is a real progress object
    poll.raise_for_status()
    progress = poll.json()
    if progress["status"] in ("ready", "failed"):
        break
    time.sleep(10)

# records and error_codes say what the run produced; status only says it stopped
codes = progress.get("error_codes") or {}
if progress["status"] == "failed" or not progress.get("records"):
    raise RuntimeError(
        f"{snapshot_id} finished with no records to download: "
        f"{progress['status']}, {codes}")

data = requests.get(
    f"https://api.brightdata.com/datasets/v3/snapshot/{snapshot_id}",
    headers=HEADERS, params={"format": "json"}, timeout=120,
).json()

# include_errors=true reports failed inputs as rows, so filter before counting
records = [row for row in data if not row.get("error_code")]
if codes:
    print(f"skipped {sum(codes.values())} failed inputs: {codes}")
print(f"downloaded {len(records)} records")
Diese Schleife erledigt die Mechanik. Was die Antwort über den Durchlauf aussagt, braucht mehr Sorgfalt.
Die Fortschrittsantwort lesen, bevor Sie herunterladen
Die Fortschrittsantwort enthält errors und error_codes neben status, und alle drei zählen. ready allein bedeutet, dass der Job gestoppt hat, nicht, dass jede Eingabe erfolgreich war. Ein Durchlauf kann mit ready und records: 0 sowie einer von Null verschiedenen errors-Zahl fertig werden.
Eine Schleife, die nur status prüft, druckt downloaded 0 records und macht weiter, als wäre sie erfolgreich gewesen. Bei einem Null-Datensatz-Durchlauf einen Fehler auszulösen, ist die richtige Voreinstellung. Allein bei Fehlern einen Fehler auszulösen, ist es nicht: Ein Crawl, der ein paar entfernte Pins überspringt und trotzdem Datensätze liefert, funktioniert genau wie beabsichtigt.
Der Download braucht dieselbe Sorgfalt, weil include_errors=true fehlgeschlagene Eingaben als Zeilen neben echten Datensätzen in den Snapshot setzt. Die rohe Zeilenzahl kann daher höher sein als die Datensätze, die Sie behalten. Ein Durchlauf, der einen Datensatz meldet, kann drei Zeilen liefern: zwei dead_page-Einträge ohne url und einen vollständigen Pin. Filtern Sie nach error_code, bevor Sie irgendetwas zählen oder speichern.
Ein Profildurchlauf bei boredpanda kommt in etwa 21 Sekunden mit den 4 vom Limit erlaubten Datensätzen zurück, jeder mit seinem discovery_input markiert. Profil-Crawls laufen von Natur aus asynchron, selbst wenn Sie den synchronen scrape-Endpunkt aufrufen.
Ein Keyword- oder Profil-Crawl meldet tote Pins auch als dead_page-Einträge in den Fortschritts-error_codes. Ein Durchlauf, der weniger gültige Datensätze als Ihr Limit liefert, hat meist entfernte Pins gefunden, keinen Fehler in Ihrem Code.
Einen Durchlauf prüfen und den Profildatensatz sammeln
Jeder Durchlauf wird in der Konsole protokolliert, sodass Sie eine Durchlaufhistorie erhalten, ohne eine zu bauen:
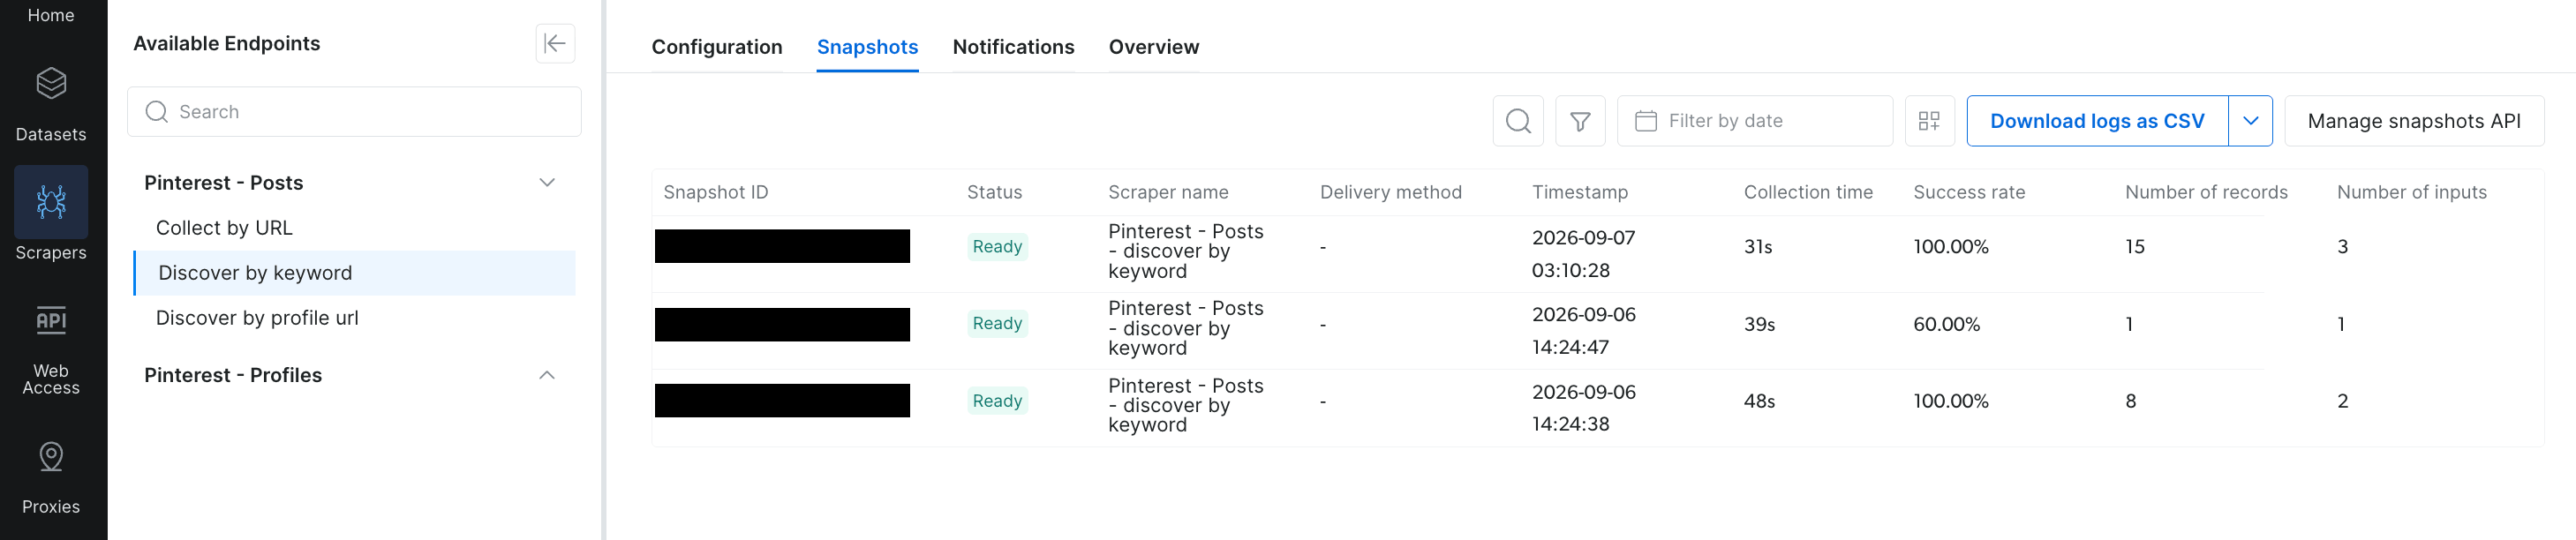
Ein Durchlauf, dessen ID Sie nie protokolliert haben, ist hier noch zum erneuten Herunterladen. Zwei dieser Durchläufe liefen ohne Fehler bei 100 %; der dritte zeigt 60 %, mit zwei entfernten Pins, die in seiner Fehlerspalte protokolliert sind.
Dieser mittlere Durchlauf lieferte einen einzigen Datensatz, weil zwei der gefundenen Pins entfernt worden waren. Die Konsole protokolliert das als dead_page: 2 unter einer Fehlerspalte, die dieser Ausschnitt nicht erreicht. Prüfen Sie diese Spalte bei Ihren eigenen Durchläufen, bevor Sie wenige Datensätze als defekte Anfrage behandeln. Die Erfolgsquote ist die eigene Kennzahl der Konsole für die von einem Crawl besuchten Seiten, lesen Sie sie also zusammen mit den Datensatz- und Fehlerzahlen.
Ein zweiter Scraper liefert den Profildatensatz selbst, neben den Pins, die der Profil-Crawl sammelt. Wechseln Sie die Datensatz-ID zu der auf der Seite des Pinterest-Profile-Scrapers, und senden Sie die Profil-URL ohne discover_by. Für dasselbe Konto lieferte er zum Testzeitpunkt einen follower_count von etwa 3 Millionen und eine boards_num von 51. Er lieferte auch ein saved-Array von Boards mit ihren Pin-Zahlen, 10 der 51.
Dieser Scraper liefert eine snapshot_id statt Inline-Datensätze, fragen Sie ihn also auf dieselbe Weise ab. Er brauchte im Test knapp vier Minuten, verglichen mit den rund zwanzig Sekunden des Pin-Crawls, setzen Sie das Abfrageintervall also in Minuten an.
Was die Datensätze enthalten
Zehn Felder erschienen bei allen 30 getesteten Datensätzen: url, post_id, date_posted, user_name, user_url, post_type, image_video_url, video_length, likes und comments_num. Das waren der stabile Kern zum Testzeitpunkt. Vier weitere sind üblich statt garantiert: title bei 27 der 30, categories bei 24, content bei 22 und hashtags bei 16. Lesen Sie diese zweite Gruppe mit .get() statt direkter Indizierung.
Speicherzahlen sind die Engagement-Zahl, die die meiste Pinterest-Analyse will, und Sie erhalten sie durch einen Zwei-Quellen-Join über post_id. Die API liefert Entdeckung und den strukturierten Datensatz. Das JSON-LD der Pin-Seite liefert die Speicheranzahl, die sie bei 5 der 6 geprüften Pins lieferte.
Prüfen Sie die tatsächlichen Zahlen, bevor Sie darauf eine Kennzahl aufbauen. Das Stichproben von acht aktuellen Pins aus jedem von drei Konten lieferte Mediane von 1, 1 und 2, während einzelne Pins Hunderte erreichten. Der Zähler ist also pro Pin, nicht pro Bild. likes lieferte 0 bei 5 derselben 6, was damit übereinstimmt, dass Pinterest Likes vor Jahren als öffentliche Kennzahl entfernt hat.
Bei denselben 6 Pins stimmten die Titel über die beiden Quellen hinweg jedes Mal überein, und die Daten bei 3 von 6. Pinner-Namen stimmen meist auch überein, aber das ist das Feld, dem man nicht trauen sollte. Der in diesem Leitfaden durchgängig verwendete Pin ist ein Fall, in dem sie sich unterscheiden: Seine oEmbed-Antwort und sein API-Datensatz nennen unterschiedliche Personen.
Der API-Datensatz nennt das Konto hinter der Website, auf die der Pin verlinkt, während JSON-LD und oEmbed die Person nennen, die ihn gespeichert hat. Wenn ein Pin von einem anderen Konto erneut gespeichert wird, können die beiden Quellen unterschiedliche Personen nennen. Verknüpfen Sie die beiden Datensätze über die Pin-URL oder post_id, nie über den Pinner.
Wo sich die Daten unterschieden, lag das date_posted der API am oder nahe dem Tag, an dem der Pin im Feed erschien. Das JSON-LD-datePublished war älter, in einem Fall um mehrere Jahre. Entscheiden Sie, welche Definition Ihre Analyse braucht, bevor Sie beide mischen.
Welche Pinterest-Scraping-Methode sollten Sie verwenden?
Die Wahl hängt davon ab, womit Sie beginnen und wie viel vom Datensatz Sie brauchen:
| Faktor | Einfaches HTTP (JSON-LD, oEmbed, RSS) | Playwright (Eigenbau) | Bright Data Scraper API |
|---|---|---|---|
| Einrichtung | requests und die Standardbibliothek |
Playwright und einen Browser installieren | API-Schlüssel plus requests |
| Gelieferte Daten | Vollständiger Datensatz für einen bekannten Pin, plus ein strukturierter Profildatensatz | Nur Bild-URLs aus Suche oder Profil | Titel, Beschreibung, Pinner, Hashtags, Kategorien, Medien; Saves kommen von der Pin-Seite, verknüpft über post_id |
| Entdeckung | Board-Feeds und das Widget-Backend, keine Suche | Gesperrte Kacheln bei einer Suche | Pins nach URL, Keyword oder vollständigem Profil |
| Sperrung | Eigene IPs, keine TLS-Challenge beobachtet | Sie verwalten Proxys und Wartung | Verwaltete Proxy- und Entsperrungsschicht |
| Wartung | Ihre, wenn sich ein Feed oder der JSON-LD-Block ändert | Ihre, wenn Pinterest Markup oder Sperren ändert | Die des Anbieters, durch dieselben Markup- und Sperränderungen |
| Kosten | Kostenlos von einer IP, 1,24 GB bei 10.000 Pin-Seiten und weit weniger über oEmbed | Kostenlos, plus 43,5 GB Proxy-Traffic bei 10.000 Pins | Ein monatliches Freikontingent, danach Preis pro erfolgreich geliefertem Datensatz |
Einfaches HTTP reicht weiter, als die meisten Leitfäden vermuten lassen. Es liefert jeden genannten lebenden Pin, einen strukturierten Profildatensatz und aktuelle Pins von jedem Board, das ein Konto zeigt. Das Ausführen beider kostenlosen Methoden über jedes Board eines Kontos lieferte 435 eindeutige Pins.
Die Einschränkung ist, wie viel Sie erreichen können, und das ist enger, als es aussieht. Diese 435 sind von mehr als 9.000 Pins, die auf den neun Boards gehalten werden, von denen sie stammen, unter 5 %. Keine kostenlose Methode erreicht die Keyword-Suche, und Playwright fügt nur gesperrte Thumbnails hinzu. Die Scraper API ist für Keyword-Entdeckung, vollständige Profil-Crawls und wiederkehrende Sammlung.
Was jede Methode bei 10.000 Pins kostet
Die Payload-Größe bestimmt die Rechnung, gemessen an den tatsächlich übertragenen Bytes. Die Tabelle geht von einem Client aus, der Kompression aushandelt. Eine Pin-Seite mit etwa 1,13 MB dekomprimiert überträgt mit Brotli rund 124 KB, oder 183 KB mit dem gzip-Header, den requests sendet. Führen Sie stattdessen das Stdlib-Beispiel aus, multipliziert sich jede Zahl in der Pin-Seiten-HTML-Zeile um etwa das 9-fache.
Die Bytes sind hier gemessen; die Tarife nicht. Zwei Tarife bestimmen jeden Dollar in der Tabelle. Beide sind Bright-Data-Listenpreise von September 2026, sodass die Bandbreitenzeilen und die Datensatzzeile dieselbe Basis verwenden:
- Residential-Bandbreite, 8 $/GB. Der Pay-as-you-go-Listenpreis auf der Seite mit Proxy-Netzwerk-Preisen, der beim größten veröffentlichten Verpflichtungsplan sinkt.
- Scraper API, 1,50 $ pro 1.000 gelieferte Datensätze. Der Pay-as-you-go-Listenpreis auf der Preisseite der Web Scraper API, der bei den höheren veröffentlichten Plänen mit dem Volumen sinkt. Dieselbe Seite listet ein monatliches Freikontingent; die Tabelle verwendet den Listenpreis für jeden Datensatz.
Beide Seiten zeigen auch Aktionen, und beide ändern sich, ohne dass sich dieser Beitrag ändert. Lesen Sie die aktuellen Tarife auf diesen beiden Seiten, bevor Sie Kosten schätzen. Setzen Sie, was Ihnen angeboten wird, in die Multiplikation in der letzten Spalte ein.
| Methode | Abgerechnet nach | Übertragene Bytes pro Pin | Volumen für 10.000 | Kosten zu diesen Tarifen |
|---|---|---|---|---|
| RSS-Feed, pro aufgelistetem Pin | Bandbreite | 147 B | 0,0015 GB | × 8 $/GB = 0,01 $ |
| oEmbed-JSON | Bandbreite | 583 B | 0,006 GB | × 8 $/GB = 0,05 $ |
| Pin-Seiten-HTML | Bandbreite | 124 KB | 1,24 GB | × 8 $/GB = 9,92 $ |
| Scraper API | Gelieferte Datensätze | bei jeder Seitengröße gleich | 10.000 Datensätze | × 1,50 $/1k = 15,00 $ |
| Pin-Seite über Playwright | Bandbreite | 4,35 MB | 43,5 GB | × 8 $/GB = 348,00 $ |
Die Zeilen unterscheiden sich darin, was ein Fehlschlag kostet. Ein gelöschter Pin antwortet trotzdem mit HTTP 200 und einer vollständigen Seite, sodass die Bandbreitenzeilen für seine Bytes zahlen. Die Datensatzzeile wird pro geliefertem Datensatz bepreist.
Was die Dollar-Zahlen nicht zeigen
Das Laden desselben Pins in Headless-Chromium lädt 4,35 MB über etwa 180 Antworten herunter. Das ist etwa das 35-fache dessen, was ein einfacher Abruf für denselben Datensatz bewegt.
Etwa 3,1 MB davon sind JavaScript, weshalb der übliche Weg, Bytes zu sparen, kaum hilft. Das Blockieren von Bildern, Schriften und Stylesheets reduziert es auf 3,8 MB und nicht niedriger, weil die Seite ihre Skripte zum Rendern immer noch braucht.
Zeit ist die andere Kostenart. Ein Pin-Seiten-Abruf lief im Median 0,8 bis 1,0 Sekunden über zwei Durchläufe von je 15 Anfragen von einer einzigen Maschine. Vollständige Durchläufe sind langsamer, als dieser Median vermuten lässt.
Drei Durchläufe über einen 25-Pin-Feed mit halbsekündiger Verzögerung endeten bei 21 bis 33 Pins pro Minute. Einzeln ausgeführt sind das 5 bis 8 Stunden für 10.000 Pins. Parallel ausgeführt verkürzt das die Zeit und konzentriert Ihre Anfragerate gleichzeitig auf eine Adresse.
Was die Kostenzahlen tatsächlich vergleichen
oEmbed bewegt 583 Bytes, verglichen mit den 124 KB der Pin-Seite. Eine ganze Seite abzurufen, um einen Autorennamen zu lesen, ist Verschwendung.
Eine verwaltete API kauft zwei Dinge: Reichweite, und dass jemand anderes die Wartung übernimmt. Sie erreicht die Seitentypen über einfaches HTTP hinaus, Keyword-Suche und vollständige Profil-Crawls. Die Ersparnis kommt daher, nicht von übertragenen Bytes.
Auf derselben Basis liegen die Pin-Seiten-Zeile und die Scraper-API-Zeile nahe beieinander, innerhalb etwa des 1,5-fachen. Beide Seiten laufen mit Aktionen, die sie weiter nach unten bewegen. Welche günstiger ist, hängt von Tarifen ab, die weder dieser Beitrag noch Sie kontrollieren.
Der Vergleich mit einem Headless-Browser ist nicht nah. Bei jedem veröffentlichten Tarif auf derselben Proxy-Preisseite kostet 43,5 GB Traffic ein Vielfaches dessen, was 10.000 Datensätze kosten.
Die beiden Zahlen messen nicht dasselbe, lesen Sie also, was jede enthält. Die Traffic-Zeile ist Bandbreite und sonst nichts. Sie schließt Proxy-Plan-Mindestbeträge und die Stunden aus, die für Bau und Wartung der Pipeline aufgewendet werden. Sie geht auch davon aus, dass Sie bereits 10.000 Pin-URLs besitzen, was keine kostenlose Methode in diesem Umfang liefert.
Die Datensatzzahl ist breiter: Sie schließt die Entdeckung ein, die die URL-Liste erzeugte, und ihr Tarif verbessert sich mit dem Volumen. Plan-Mindestbeträge gelten auf beiden Seiten, bestätigen Sie sie also für einen großen Job genauso, wie Sie ein Proxy-Angebot prüfen würden.
Nächste Schritte
Beginnen Sie mit dem leichtesten Werkzeug für die Daten, die Sie brauchen. Wenn Sie die Pin-URLs haben, liefert das JSON-LD-Parsen vollständige Datensätze über einfaches HTTP, und oEmbed allein liefert die Zuschreibung. Wenn Sie einen Kreativen oder ein Board verfolgen, verketten Sie den RSS-Feed mit diesem Parsen, und Sie laden nie einen Browser.
Keyword-Suche und vollständige Profil-Crawls sind die Fälle über diese Routen hinaus. Die Pinterest Scraper API nimmt ein Keyword oder eine Profil-URL und liefert strukturierte Datensätze, mit einem monatlichen Freikontingent zum Testen.
Für alles, was Sie dauerhaft betreiben möchten, setzen Sie von Anfang an drei Standardwerte:
- Behandeln Sie gelöschte Pins bei jedem Stapel. Das bedeutet ein
Noneaus dem JSON-LD-Parsen, oder einendead_page-Eintrag aus der API. - Halten Sie etwa eine halbe Sekunde zwischen Anfragen. Dieses Tempo lief bei 21 bis 33 Pins pro Minute über vollständige Durchläufe und erzeugte über rund 250 Anfragen keine Ratenbegrenzung.
- Protokollieren Sie die
snapshot_idfür asynchrone Jobs. Ein abgestürzter Durchlauf kann dann erneut heruntergeladen werden.
Um über eine einzelne Adresse hinauszugehen, leiten Sie über Residential-Proxys und behalten Sie das Parsen, das Sie bereits haben. Wenn Sie die Daten lieber kaufen als sammeln möchten, ist der Pinterest-Datensatz bereits fertig und zum Herunterladen bereit
FAQ
Kann man Pinterest scrapen?
Ja. Eine Pin-URL liefert meist Titel, Beschreibung, Speicheranzahl, Pinner und ausgehenden Link aus einem JSON-LD-Block über einfaches HTTP, ohne Browser. Profil- und Board-RSS-Feeds listen aktuelle Pin-URLs. Die Keyword-Suche ist die Ausnahme und braucht eine Scraper-API.
Blockiert Pinterest Scraper?
Nein, nicht auf öffentlichen Pin-Seiten von einer Residential-Adresse. Zwölf Anfragen mit dem Standard-urllib-User-Agent lieferten alle HTTP 200, ohne Akamai-Bot-Manager-Cookies. Eine Datacenter-IP ist die Ausnahme: Die Seite liefert trotzdem 200, aber ohne ihren JSON-LD-Block.
Warum funktioniert mein Pinterest-Scraper nicht?
Der Datensatz steckt in einem JSON-LD-Block, nicht im Redux-Store, daher liest initialReduxState.pins leer. Bei Suchrastern passt der alte pinWrapper-Selektor auf nichts, da ausgeloggte Kacheln jetzt gated-pin-rep verwenden. Ein gelöschter Pin antwortet trotzdem mit HTTP 200 ganz ohne JSON-LD-Block.
Hat Pinterest eine öffentliche API?
Ja, aber sie ist auf das eigene Konto beschränkt. Die Pinterest API v5 verwaltet Ihre Boards, Pins und Anzeigen, nicht öffentliche Pins anderer Nutzer. Der Testzugang hat ein tägliches Anfragelimit. Die einzige Keyword-Suche ist eine Beta, die nicht allen Apps zur Verfügung steht und auf die Top 10 Ergebnisse begrenzt ist.
Hat Pinterest einen RSS-Feed?
Ja. Pinterest veröffentlicht unauthentifizierte Feeds unter /<username>/feed.rss und /<username>/<board-slug>.rss. Über 12 Konten hinweg lieferten sie 22 bis 26 aktuelle Einträge, mit Pin-URLs, Zeitstempeln und Thumbnails, aber fast keinen Titeln. Feeds listen nur neue Pins, ohne Keyword-Suche und ohne historische Tiefe.
Wie lade ich Pinterest-Bilder in voller Größe herunter?
Ersetzen Sie das Größensegment in der Thumbnail-URL durch originals, und probieren Sie dann der Reihe nach .jpg, .png, .webp und .gif. Das Beibehalten der eigenen .jpg des Thumbnails lieferte bei 35 von 40 Pins 403, weil Pinterest neu kodiert. Planen Sie mit etwa zwei HEAD-Anfragen pro Bild.
Wie scrape ich ein Pinterest-Board?
Entfernen Sie einen abschließenden Schrägstrich aus der Board-URL und fügen Sie .rss hinzu. Ein abschließender Schrägstrich liefert die HTML-Seite statt des Feeds. Der Feed stoppt bei nahezu 25 Einträgen, egal wie groß das Board ist. Das Widget-Backend unter widgets.pinterest.com/v3/pidgets/ liefert bis zu 50, und darüber hinaus crawlen Sie das gesamte Profil.