Jobbörsen suchen nur nach exakten Wörtern, sodass die richtige Stelle verborgen bleibt, wenn Ihre Formulierung nicht mit der Stellenanzeige übereinstimmt. Semantische Suche gleicht stattdessen nach Bedeutung ab. Wir bauen diese von Grund auf und messen dann, welcher Suchmodus gewinnt, anstatt anzunehmen, dass der komplexeste gewinnt.
TL;DR
Dieser Leitfaden baut eine semantische Jobsuchmaschine über 200 echte LinkedIn-Stellenanzeigen mit Bright Data (Web-Scraping), Cohere (Embeddings + Reranking) und LanceDB (lokaler Vektorspeicher).
- Keyword-Suche gleicht exakte Wörter ab. Vektorsuche gleicht Bedeutungen ab. Eine Anfrage wie “Ingenieur, der an LLMs arbeitet” findet eine “GenAI Developer”-Stelle, die die Keyword-Suche übersieht.
- Die Web Scraper API von Bright Data liefert strukturierte LinkedIn-Jobs als JSON für 0,0015 $ pro Datensatz, ohne HTML-Parsing oder Scraper-Wartung.
- LanceDB läuft lokal und kombiniert Vektorsuche mit SQL-Filtern (Gehalt, Seniorität) in einer Abfrage, plus Volltextsuche und Cohere-Reranking.
- Bei 10 Testanfragen erzielte die Vektorsuche 70 % Precision@3 gegenüber 43 % bei Keyword-Suche. Hybrid + Reranking brachte bei dieser Größenordnung keinen messbaren Vorteil, daher ist bei unter ~10.000 Zeilen die Vektorsuche allein ein vernünftiger Standard.
- Das vollständige Projekt umfasst 9 kleine Dateien, einschließlich eines Eval-Frameworks, und der vollständige Code ist auf GitHub. Der gesamte Durchlauf kostet ~0,34 $.
Das Problem mit der Keyword-Suche
Die Keyword-Suche auf einer Jobbörse tut genau das, was Sie verlangen. Sie gibt Stellenanzeigen zurück, deren Titel oder Beschreibung die wörtlichen Tokens Ihrer Anfrage enthält. Suchen Sie nach “Ingenieur, der an LLMs und Prompt Engineering arbeitet”, verpassen Sie Stellen wie “GenAI Developer”, obwohl diese perfekt passen. Lexikalische Suche gleicht exakte Wörter ab, keine Bedeutungen.
Vektorsuche gleicht nach Bedeutung ab. Jede Stellenbeschreibung wird in ein Embedding umgewandelt (ein hochdimensionaler Vektor, der den semantischen Inhalt erfasst), ebenso Ihre Anfrage. Eine Stelle, deren Vektor nah an dem Ihrer Anfrage liegt, ist eine gute Übereinstimmung in der Bedeutung, auch wenn sie keine gemeinsamen Wörter teilt.
Dies in eine funktionierende Suchmaschine umzuwandeln, erfordert 3 Komponenten:
- Bright Data scrapt 200 echte LinkedIn-Stellenanzeigen in sauberes strukturiertes JSON.
- Cohere wandelt die Beschreibungen in Embeddings um und rerankt die Endergebnisse.
- LanceDB speichert die Embeddings lokal und bedient hybride (Vektor + Volltext) Anfragen mit SQL-artigen Filtern.
Der Stack im Überblick
Was jede Schicht tut und warum wir sie verwenden:
| Schicht | Tool | Warum dieses |
|---|---|---|
| Webdaten | Bright Data Web Scraper API | Vorgefertigter LinkedIn-Scraper gibt strukturiertes JSON mit Gehalt, Seniorität und Standort zurück, ohne HTML-Parsing oder Scraper-Wartung. |
| Embeddings | Cohere embed-english-v3.0 |
Asymmetrische Kodierung (unterschiedliche Eingabetypen für Dokumente vs. Anfragen). Cohere bietet auch embed-v4.0 an, das multimodal ist. Wir verwenden v3 hier für sein englischsprachiges Preis-/Latenzprofil (planen Re-Embedding vor dem End-of-Life von v3). |
| Reranker | Cohere rerank-v3.5 |
Wir fixieren v3.5 für sein Preis-/Latenzprofil. Cohere bietet auch rerank-v4.0 an (-pro für Qualität, -fast für Latenz). |
| Vektorspeicher | LanceDB | Lokal, eingebettet, keine Server. Unterstützt hybride (Vektor + BM25) Suche und SQL-Vorfilter. |
| UI (optional) | Streamlit | Web-UI mit minimalem Code für eine Python-Datenanwendung. |
Dieser Stack läuft aus einem einzigen Python-venv auf Ihrem Laptop. Bright Data und Cohere sind die einzigen beteiligten verwalteten Dienste.
Einrichtung
Das vollständige, ausführbare Projekt ist auf GitHub. Klonen Sie es und installieren Sie die Abhängigkeiten (Python 3.10 oder neuer):
git clone https://github.com/triposat/semantic-job-search.git
cd semantic-job-search
python -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
Kopieren Sie die Beispiel-Env-Datei und fügen Sie Ihre zwei API-Schlüssel hinzu, ein Bright Data-Token und einen Cohere-Schlüssel von dashboard.cohere.com (ein Trial-Schlüssel funktioniert für den gesamten Leitfaden):
cp .env.example .env
# then edit .env with your keys:
#   BRIGHTDATA_API_TOKEN=...
#   COHERE_API_KEY=...
Mit beiden Schlüsseln führen Sie python scrape.py aus, um die Daten abzurufen, und python index.py, um den Index zu erstellen.
Architektur
Das System besteht aus zwei Flows, nicht einem. Ingest erstellt den Index (einmalig oder nach einem Zeitplan ausführen). Query wird bei jeder Suche ausgeführt. Beide verwenden Cohere und LanceDB, aber für unterschiedliche Aufgaben.
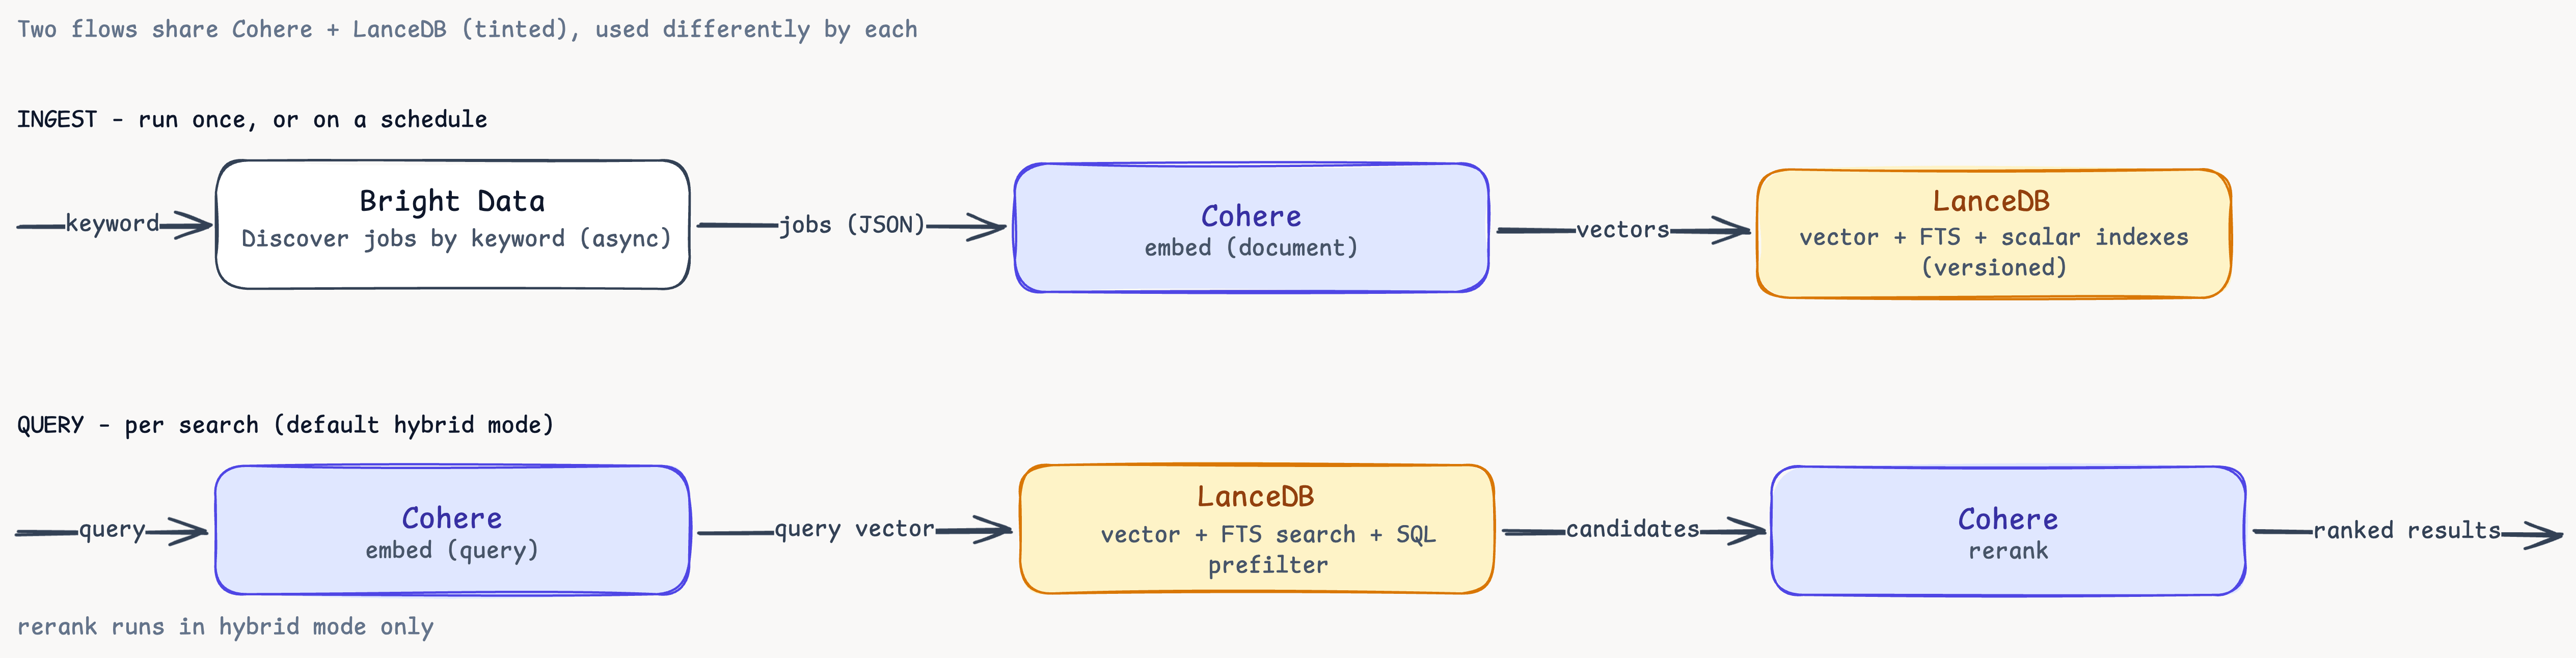
Die zwei Flows nebeneinander. Ingest bettet Dokumente ein und speichert sie. Query bettet den Suchtext ein, führt Vektor- + Volltextsuche mit SQL-Vorfilter durch und rerankt dann. Cohere und LanceDB erscheinen in beiden Flows, erledigen aber unterschiedliche Arbeit, weshalb Reranking den Ingest-Pfad nie berührt.
3 Skripte führen die Pipeline aus: scrape.py, index.py, search.py. 6 weitere Hilfsprogramme: lib.py (gemeinsames Such-Backend), compare.py (Modusvergleich), eval.py (Precision@3), stats.py (Datensatz-Zusammenfassung), versions.py (Snapshot-Browser) und app.py (Streamlit-UI).
LinkedIn mit Bright Data scrapen
LinkedIn ist eine wichtige Quelle für Jobdaten, aber schwer zuverlässig zu scrapen: Rate-Limits, dynamisches Markup und HTML, das sich ohne Ankündigung ändert. Die Web Scraper API gibt sauberes strukturiertes JSON aus vorgefertigten Endpunkten zurück, sodass Sie keine Parser warten müssen.
Den richtigen Endpunkt wählen
Bright Data bietet mehrere LinkedIn-Scraper an:
- Personenprofile → individuelle Mitgliederprofile
- Unternehmensinformationen → Unternehmensseiten
- Stellenanzeigen → Nach URL sammeln → spezifische Job-URLs, die Sie bereits haben
- Stellenanzeigen → Nach Keyword entdecken ← das wollen wir
- Stellenanzeigen → Nach URL entdecken → Jobs aus einer Suchergebnis-URL
- LinkedIn-Posts und Personensuche → andere Entitätstypen
Nach Keyword entdecken ist die richtige Wahl, da wir eine Massenentdeckung von Jobs aus einer Suchanfrage möchten. Ein einziger API-Aufruf gibt bis zu 1.000 strukturierte Stellenanzeigen pro Keyword zurück, einschließlich Titel, Unternehmen, Standort, Senioritätsstufe, Beschäftigungsart, Gehaltsbereich (wo angegeben) und der vollständigen Stellenbeschreibung.
Jeder Scraper hat seine eigene dataset_id. Um eine zu finden, öffnen Sie Bright Datas Scrapers Library, suchen Sie nach der Website (hier linkedin.com) und öffnen Sie sie. Wählen Sie den Endpunkt Stellenanzeigen → Nach Keyword entdecken, und seine dataset_id (gd_lpfll7v5hcqtkxl6l) sowie eine sofort ausführbare Anfrage erscheinen im Code-Beispiele-Panel. Ein gültiges Token ist alles, was scrape.py benötigt, um es aufzurufen.
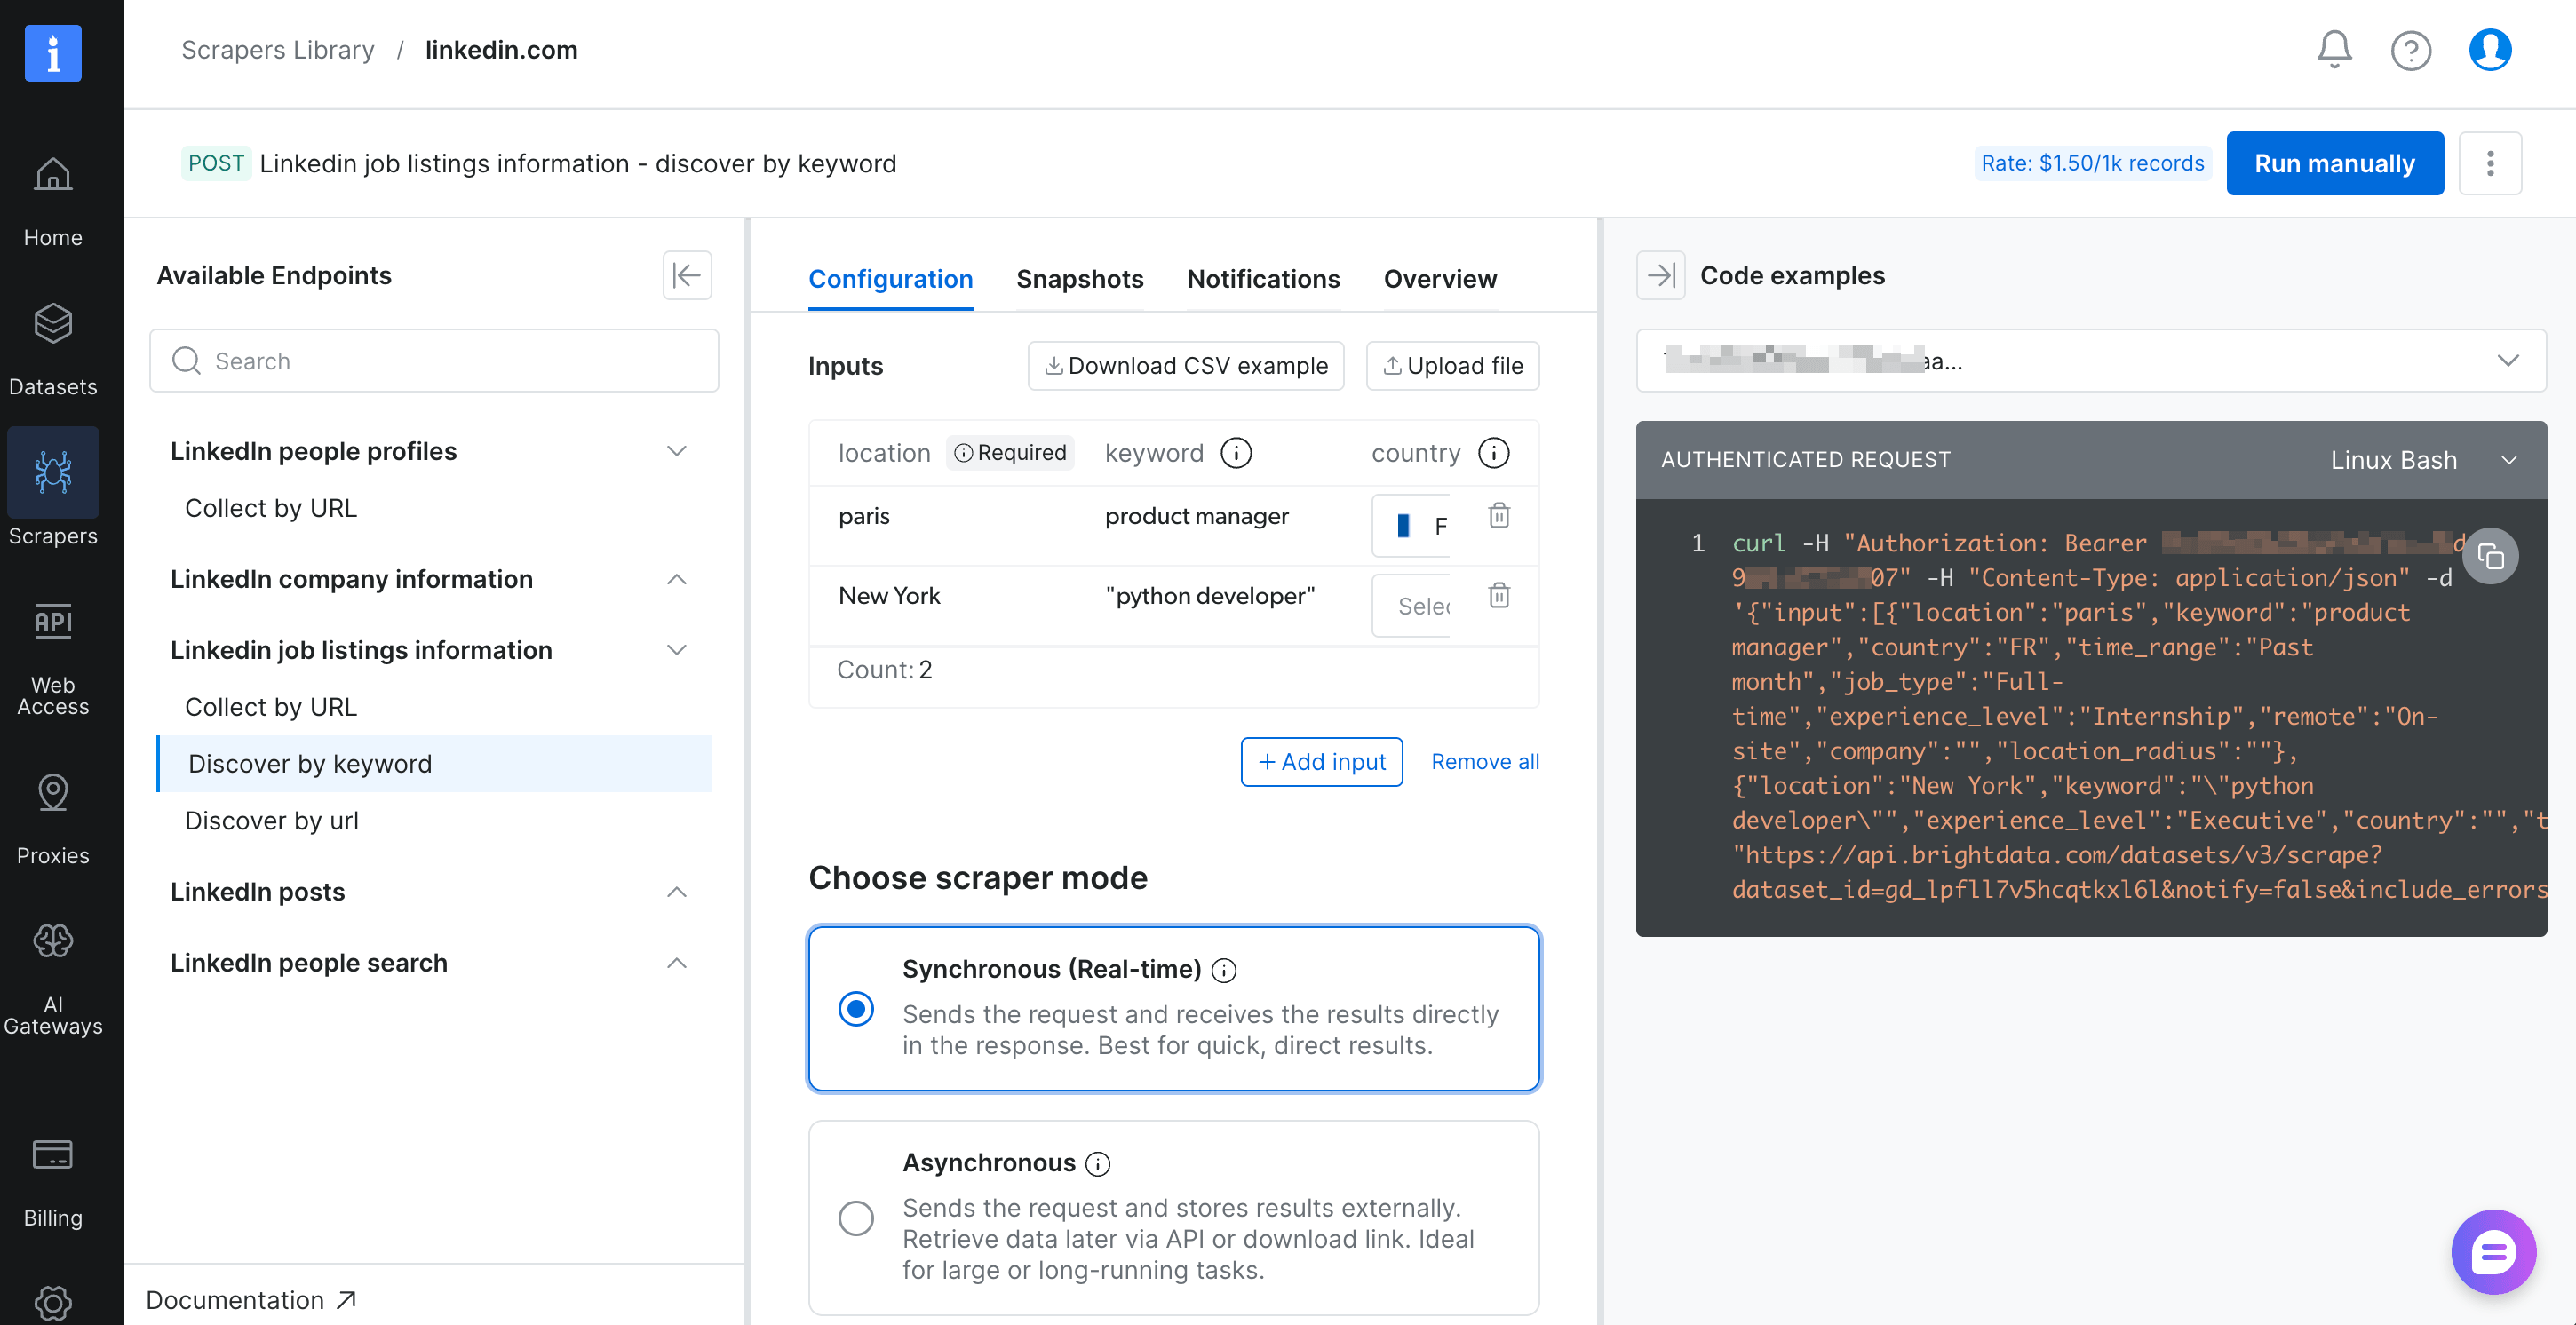
Die Scraper-Seite ‘Nach Keyword entdecken’. Das Code-Beispiele-Panel auf der rechten Seite zeigt die dataset_id.
Synchron vs. asynchron
Bright Data bietet 2 Liefermodi an:
- Synchron (
POST /datasets/v3/scrape) gibt die Daten direkt zurück, am besten für kleine Batches. - Asynchron (
POST /datasets/v3/trigger) gibt eine Snapshot-ID zurück. Sie pollen bis zur Fertigstellung und laden das Ergebnis herunter, am besten für alles Größere.
In unseren Durchläufen betrug die Antwortzeit durchschnittlich ~6 Sekunden pro Eingabe. Bei 2 Keywords mit limit_per_input=100 (200 Jobs insgesamt) muss ein synchroner Aufruf die Verbindung für den gesamten Batch offen halten, was ein Timeout-Risiko birgt. Asynchron ist der sichere Standard.
Kosten mit Pro-Eingabe-Limits kontrollieren
Der Query-Parameter limit_per_input=N begrenzt, wie viele Ergebnisse jede Eingabesuche zurückgibt, was genau der Regler ist, den Sie für vorhersehbare Ausgaben benötigen:
2 keywords × 100 jobs × $0.0015 = $0.30 per runErhöhen Sie es für größere Durchläufe, bis zu 1.000 Jobs pro Keyword.
Der Code
Der Scraper löst einen Snapshot aus, pollt bis zur Bereitschaft und lädt das JSON herunter. Der Kern ist unten (eine Produktionsversion würde Retry/Backoff und umfangreichere Fehlerbehandlung hinzufügen):
# scrape.py
import json, time, sys
from pathlib import Path
import requests
from lib import require_env

BD_TOKEN = require_env("BRIGHTDATA_API_TOKEN")
DATASET_ID = "gd_lpfll7v5hcqtkxl6l"  # LinkedIn jobs - discover by keyword
LIMIT_PER_INPUT = 100

SEARCHES = [
    {"location": "San Francisco", "keyword": "machine learning engineer",
     "country": "US", "time_range": "Past month", "job_type": "Full-time",
     "experience_level": "", "remote": "", "company": "", "location_radius": ""},
    {"location": "New York", "keyword": "python developer",
     "country": "US", "time_range": "Past month", "job_type": "Full-time",
     "experience_level": "", "remote": "", "company": "", "location_radius": ""},
]

API = "https://api.brightdata.com/datasets/v3"
HEADERS = {"Authorization": f"Bearer {BD_TOKEN}", "Content-Type": "application/json"}

def trigger_snapshot() -> str:
    r = requests.post(f"{API}/trigger", headers=HEADERS, json={"input": SEARCHES},
        params={"dataset_id": DATASET_ID, "type": "discover_new",
                "discover_by": "keyword", "include_errors": "true",
                "limit_per_input": str(LIMIT_PER_INPUT)})
    r.raise_for_status()
    return r.json()["snapshot_id"]

def wait_until_ready(snapshot_id: str) -> None:
    while True:
        status = requests.get(f"{API}/progress/{snapshot_id}", headers=HEADERS).json()["status"]
        if status == "ready": return
        if status == "failed": raise RuntimeError("snapshot failed")
        time.sleep(10)

def download(snapshot_id: str) -> list[dict]:
    return requests.get(f"{API}/snapshot/{snapshot_id}",
                        headers=HEADERS, params={"format": "json"}).json()
Ausführen:
$ python scrape.py
→ scraping 2 keyword searches, max 100 jobs each
  estimated max cost: $0.30 (at $0.0015/record × 200 max records)
  triggered snapshot: sd_mojicp6g39xwbwqn2
  status: ready
✓ saved 204 jobs → data/raw_jobs.json
  actual cost: $0.31
Was Sie zurückbekommen
Jeder Job im JSON hat 25+ Felder. Hier sind die wichtigsten:
{
  "job_posting_id": "",
  "job_title": "Associate Machine Learning Engineer",
  "company_name": "ExampleCo",
  "job_location": "San Francisco, CA",
  "job_seniority_level": "Entry level",
  "job_employment_type": "Full-time",
  "job_industries": "Software Development",
  "job_summary": "About ExampleCo. ExampleCo is the career network for the AI economy...",
  "base_salary": {
    "min_amount": 115000,
    "max_amount": 144000,
    "currency": "$",
    "payment_period": "yr"
  },
  "job_posted_date": "2026-04-25T03:41:21.072Z",
  "url": "https://www.linkedin.com/jobs/view/"
}
Das strukturierte base_salary-Feld ermöglicht Gehaltsfilter-Abfragen im nächsten Schritt.
Mit Cohere und LanceDB indexieren
Wir haben 204 rohe Job-Datensätze, 4 davon sind Fehlerzeilen, die wir beim Laden filtern. Jetzt machen wir die verbleibenden 200 semantisch durchsuchbar.
Warum Cohere
Wir haben Cohere den Alternativen vorgezogen (OpenAIs Embedding-Modelle, Voyage AI oder lokale sentence-transformers):
- Asymmetrische Kodierung. Cohere ermöglicht es Ihnen, die Eingabe beim Indexieren als
search_documentoder beim Suchen alssearch_queryzu kennzeichnen. Das Modell kodiert jede Seite unterschiedlich, was besser funktioniert, als beide gleich zu behandeln. - Deklaratives Embedding. LancDBs Registry unterstützt Cohere nativ (wie OpenAI und sentence-transformers), sodass das Embedding beim Einfügen und Abfragen ohne manuelle
embed()-Aufrufe erfolgt. - Die Rerank-API. Es ist ein separates Modell, das eine Anfrage plus eine Kandidatenliste nimmt und die Kandidaten nach tatsächlicher Relevanz neu ordnet. Es ist die zweite Stufe, die das Ranking einer hybriden Pipeline schärfen kann, und wir fügen diese Stufe mit einem einzigen
.rerank()-Aufruf hinzu.
Die LanceDB-Embedding-Registry
Embeddings in LanceDB laufen durch seine Embedding-Registry. Sie deklarieren Ihr Schema einmal, und Embeddings erfolgen automatisch bei jedem Einfügen und jeder Abfrage, jeweils mit dem richtigen input_type.
# index.py
import lancedb
from lancedb.embeddings import get_registry
from lancedb.pydantic import LanceModel, Vector

cohere = get_registry().get("cohere").create(
    name="embed-english-v3.0",
    api_key=COHERE_API_KEY,
)

class Job(LanceModel):
    text: str = cohere.SourceField()              # ← was eingebettet werden soll
    vector: Vector(cohere.ndims()) = cohere.VectorField()  # ← gespeichertes Embedding
    job_id: str
    title: str
    company: str
    location: str
    country_code: str
    seniority: str
    employment_type: str
    job_function: str
    industry: str
    posted_date: str
    apply_url: str
    search_keyword: str
    salary_min_annual: float
    salary_max_annual: float
    salary_currency: str
    salary_display: str
    description_snippet: str
Alles nach vector ist eine einfache gespeicherte Spalte, die für Filterung und Anzeige verwendet wird.
Der Gehalts-Normalisierungstrick
Die meisten Jobs haben Gehälter pro Jahr angegeben, aber einige sind pro Stunde. Damit salary_min_annual >= 200000 konsistent funktioniert, normalisieren wir beim Ingest:
HOURS_PER_YEAR = 2080

def _normalize_salary(base):
    if not base:
        return 0.0, 0.0, "", ""
    lo = float(base.get("min_amount") or 0)
    hi = float(base.get("max_amount") or 0)
    if (base.get("payment_period") or "").lower() == "hr":
        lo *= HOURS_PER_YEAR
        hi *= HOURS_PER_YEAR
    currency = base.get("currency") or ""
    display = f"{currency}{int(lo):,}–{currency}{int(hi):,}/yr" if (lo and hi) else ""
    return lo, hi, currency, display
Wir speichern sowohl die rohen numerischen Werte (für Filter) als auch einen menschenlesbaren Anzeigestring (für die UI).
Inkrementelle Updates mit Upserts
Beim ersten Ausführen von index.py wird die Tabelle erstellt. Jeder nachfolgende Durchlauf ist ein Upsert mit job_id als Schlüssel:
result = (
    table.merge_insert("job_id")
         .when_matched_update_all()       # vorhandene Stellenanzeigen aktualisieren
         .when_not_matched_insert_all()   # neu entdeckte hinzufügen
         .execute(rows)
)
print(f"inserted={result.num_inserted_rows}, updated={result.num_updated_rows}")
Neue Stellenanzeigen aus einem frischen Bright Data-Scrape werden eingefügt, und erneut gepostete Jobs (gleiche job_id) haben ihre Gehälter, Beschreibungen und Zeitstempel aktualisiert. Um veraltete Anzeigen vollständig zu entfernen, fügen Sie .when_not_matched_by_source_delete() hinzu.
Der gesamte Upsert ist eine einzige atomare Transaktion. Da Lance Daten spaltenweise mit Copy-on-Write speichert, ist das erneute Einlesen ein inkrementelles Schreiben und kein vollständiger Tabellenwiederaufbau.
Skalare Indizes für schnelle SQL-Filter
Wenn search.py, where "salary_min_annual >= 200000" ausgeführt wird, wendet LanceDB den Filter vor dem Vektor-Scan an (prefilter=True). Bei 200 Zeilen ist das sofort. Bei 200.000 Zeilen würde der Filter die gesamte Spalte durchlaufen, es sei denn, wir teilen LanceDB mit, wie er sie indexieren soll:
table.create_scalar_index("salary_min_annual", index_type="BTREE",  replace=True)
table.create_scalar_index("seniority",         index_type="BITMAP", replace=True)
table.create_scalar_index("search_keyword",    index_type="BITMAP", replace=True)
table.create_scalar_index("employment_type",   index_type="BITMAP", replace=True)
2 Indextypen decken unsere Anforderungen ab:
- BTREE für sortierbare Spalten mit höherer Kardinalität.
salary_min_annualprofitiert, weil wir Bereichsabfragen möchten (>=,BETWEEN). - BITMAP für Enums mit niedriger Kardinalität.
seniorityhat ~6 verschiedene Werte,employment_typeist fast ausschließlichFull-time, undsearch_keywordist eine unserer 2 Scrape-Eingaben. Jeder unterschiedliche Wert erhält sein eigenes Bitmap. Ein=-Filter wird zu einem einzigen bitweisen AND.
Beide laufen mit replace=True, sodass das erneute Ausführen von index.py sie idempotent neu erstellt. Nach dem Aufruf meldet table.list_indices() alle 5 (die 4 skalaren + den FTS-Index):
text_idx               type=FTS      columns=['text']
salary_min_annual_idx  type=BTree    columns=['salary_min_annual']
seniority_idx          type=Bitmap   columns=['seniority']
search_keyword_idx     type=Bitmap   columns=['search_keyword']
employment_type_idx    type=Bitmap   columns=['employment_type']
Die indizierten Daten inspizieren
Nach dem Ausführen von python index.py fasst unser Begleitskript stats.py zusammen, was in der Datenbank ist:
$ python stats.py

📊 LanceDB · table 'jobs'  ·  200 rows

by source keyword
  machine learning engineer  ████████████████████ 100
  python developer           ████████████████████ 100

by seniority
  Mid-Senior level  ████████████████████ 99
  Entry level       ████████████ 62
  Not Applicable    ████ 20
  Internship        ██ 14
  Associate          4
  Director           1

salary coverage: 43/200 jobs (22%)
  min  $   65,000
  med  $  150,000
  max  $1,000,000

  highest-paying jobs:
    • Quantitative Developer (Python)                  Fintal Partners       $400,000–$1,000,000/yr
    • Machine Learning Engineer                        Mercor                $130,000–$500,000/yr
    • Data Scientist                                   Triumph               $200,000–$400,000/yr
    • Senior Python Developer (Middle Office Tech)     Quantitative Systems  $200,000–$400,000/yr
    • ML Engineer (Infra & Distributed training)       techire ai            $250,000–$400,000/yr

top hiring companies (top 10)
  Turing          ████████████████████ 7
  Handshake       █████████████████ 6
  OpenAI          █████████████████ 6
  Meta            █████████████████ 6
  Jack & Jill     ██████████████ 5
  DataAnnotation  ██████████████ 5
  Catalyst Labs   ███████████ 4
  Notion          ███████████ 4
  LangChain       ███████████ 4
  Uber            ████████ 3
Hybridsuche mit Reranking ausführen
LanceDB unterstützt 3 Suchmodi, und unser lib.py stellt alle 3 hinter einer einzigen Funktion bereit:
# lib.py
from lancedb.rerankers import CohereReranker

reranker = CohereReranker(model_name="rerank-v3.5")  # fixiert; Coheres neueres Modell ist rerank-v4.0

def search(query: str, mode: str = "hybrid", limit: int = 10, where: str | None = None):
    table = _table()
    if mode == "vector":
        q = table.search(query, query_type="vector")
    elif mode == "keyword":
        q = table.search(query, query_type="fts")
    elif mode == "hybrid":
        q = table.search(query, query_type="hybrid").rerank(reranker=reranker)
    if where:
        q = q.where(where, prefilter=True)
    return q.limit(limit).to_pandas()
Drei Teile von search() sind es wert, erklärt zu werden:
query_type="hybrid"kombiniert Vektorähnlichkeit und BM25-Scores aus dem Volltextindex, den wir zur Indexierungszeit erstellt haben (LancDBs natives FTS). Die Vereinigung der Kandidaten wird dann neu gerankt..rerank(reranker)sendet die Kandidatenliste an Coheres Rerank-API und gibt deren Reihenfolge zurück. Wir übergebenmodel_name="rerank-v3.5"explizit, da der LanceDB-Standard älter ist.prefilter=Truewendet die SQL-WHERE-Klausel vor dem Vektor-Scan an, nicht danach. Dies ist schneller (kleinerer Suchraum) und genauer (Sie verlieren keine Ergebnisse durch Abschneiden).
Eine echte Abfrage
Hier sind die Top-2-Ergebnisse für eine Anfrage, die wenige wörtliche Wörter mit einem Jobtitel im Datensatz teilt:
$ python search.py "deep learning model training with GPUs"

  ▸ Training: ML Framework Engineer  ·  score 0.275
    OpenAI — San Francisco, CA
    Entry level · Full-time · 2026-04-22
    "About The Team Training Runtime designs the core distributed
     machine-learning training runtime that powers everything from early
     research experiments to frontier-scale model runs..."

  ▸ Machine Learning Engineer  ·  score 0.138
    Skild AI — San Mateo, CA
    Entry level · Full-time · 2026-04-15
    "Company Overview At Skild AI, we are building the world's first
     general purpose robotic intelligence that is robust and adapts to
     unseen scenarios without failing. We believe massive scale through
     data-driven machine learning..."
Keiner der Jobtitel enthält “GPUs”, aber beide Beschreibungen handeln von verteiltem ML-Training, was die Anfrage fragt. Reine Keyword-Suche würde wahrscheinlich beide verpassen.
Jeder Modus gibt eine andere Art von Score zurück. Der Vektor-Modus gibt Kosinus-Distanz zurück (niedriger = näher), Hybrid+Reranking gibt Coheres Relevanz-Score zurück (0 bis 1, höher = besser), und der Keyword-Modus gibt rohen BM25 zurück (unbegrenzt, höher = mehr Keyword-Überlappung). Die Zahlen sind nicht modusübergreifend vergleichbar, nur innerhalb eines einzigen Modus.
Semantik mit harten Einschränkungen kombinieren
Semantische Ähnlichkeit und SQL-Filter kombinieren sich in LanceDB in einer Abfrage:
$ python search.py "fintech python role with equity" \
    --where "salary_min_annual >= 250000"

  ▸ Quantitative Developer (Python)  ·  score 0.374
    Fintal Partners — New York, United States
    Mid-Senior level · Full-time · $400,000–$1,000,000/yr · 2026-04-22

  ▸ Senior Software Engineer (Python)  ·  score 0.272
    Fintal Partners — New York, NY
    Mid-Senior level · Full-time · $250,000–$400,000/yr · 2026-04-23
Die Vektor-Hälfte gleicht den beschreibenden Teil ab (“fintech python with equity”). Der SQL-Filter erzwingt die numerische Einschränkung (>= $250k). Beide Ergebnisse sind Fintal Partners-Rollen im richtigen Gehaltsband.
Das gleiche Hybrid- + Filter-Muster läuft in der Streamlit-UI, bei einem späteren Scrape (die Live-Anzeigen unterscheiden sich vom CLI-Durchlauf oben):
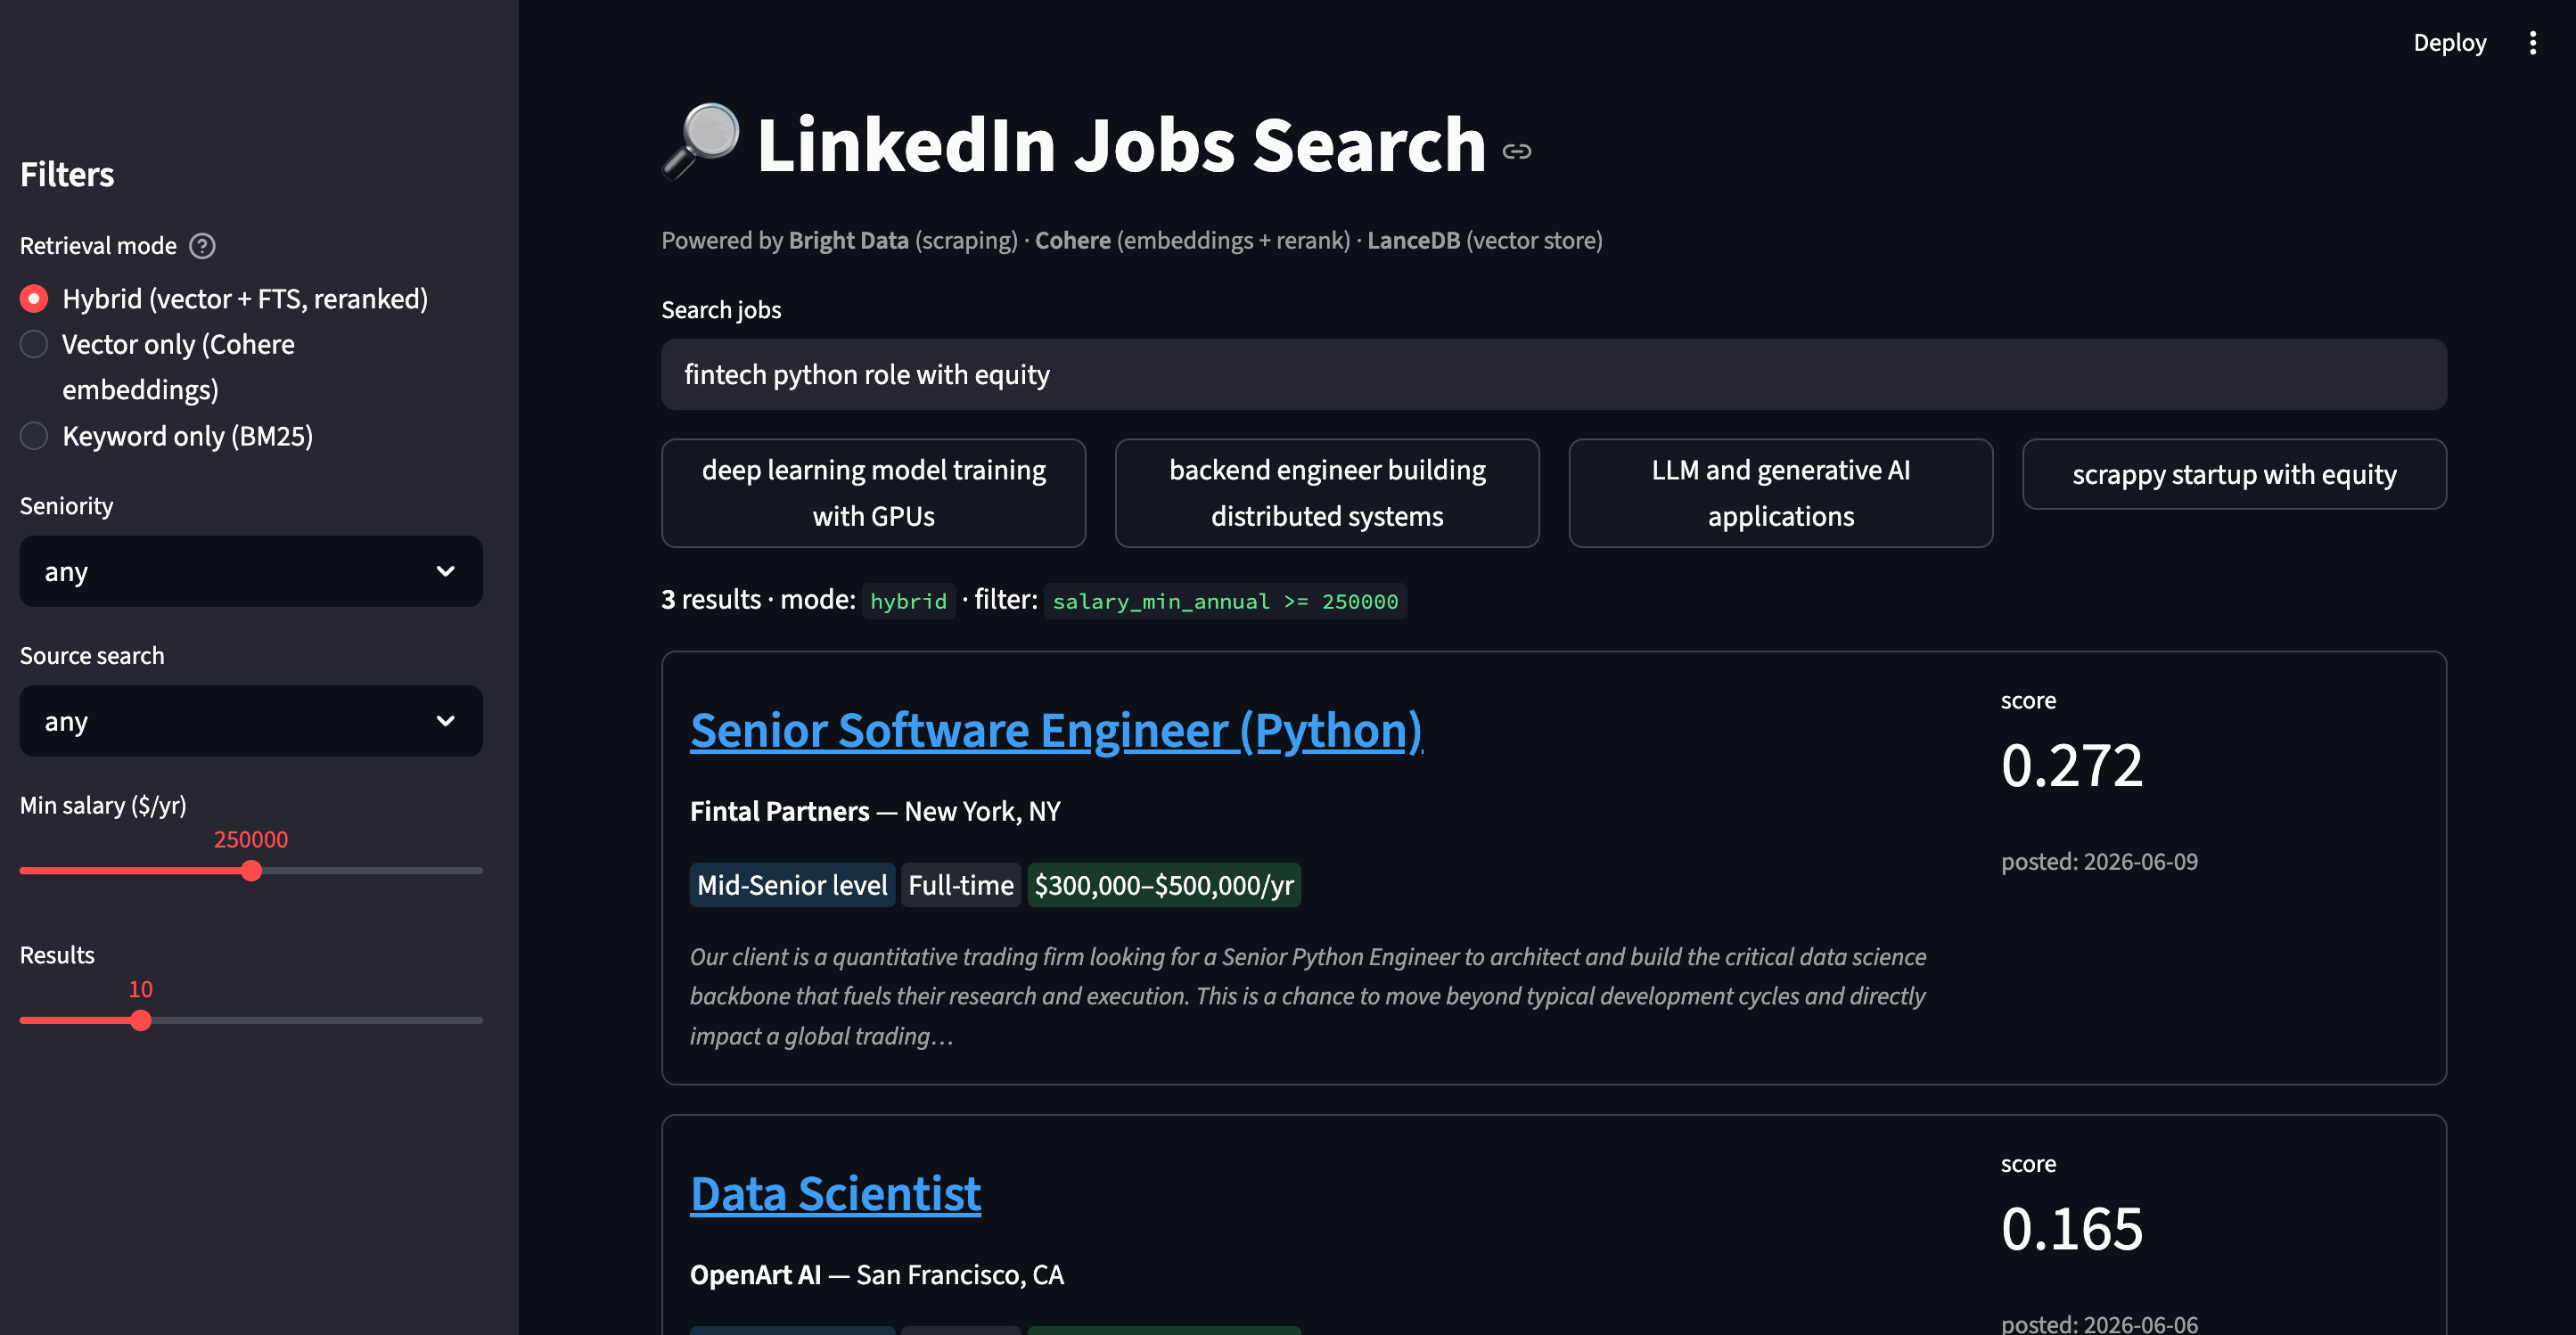 Die Streamlit-App führt eine Hybridsuche aus, wobei der Gehalts-Schieberegler gesetzt ist, bereitgestellt von
app.py. Der Schieberegler erzeugt den salary_min_annual >= 250000-Vorfilter, der im grün-auf-schwarz-Filter-Banner angezeigt wird.
Wo Keyword-, Vektor- und Hybridsuche abweichen
compare.py führt dieselbe Anfrage durch alle 3 Modi und gibt einen Nebeneinander-Bericht aus:
$ python compare.py "engineer working on LLMs and prompt engineering" --top 3

══════════════════════════════════════════════════════════════════════════
  query: engineer working on LLMs and prompt engineering
══════════════════════════════════════════════════════════════════════════

  ── keyword (BM25) ───────────────────────────────────────────────────────
  1. AI/ML Engineer                                          — Careerswift
  2. AI/ML Engineer                                          — Careerswift
  3. Applied AI Engineer                                     — Serval

  ── vector (Cohere) ──────────────────────────────────────────────────────
  1. Senior Software Engineer (Prompt Engineer Python/GenAI)        — Genpact
  2. 15+ Years exp/ Need f2f/ AI/ML Engineer or Python AI Engi...   — Jobs via Dice
  3. ML Engineer (Infra & Distributed training)                     — techire ai

  ── hybrid + rerank ──────────────────────────────────────────────────────
  1. Applied AI Engineer                                     — Serval
  2. Senior Software Engineer (Prompt Engineer Python/GenAI) — Genpact
  3. AI/ML Engineer                                          — Careerswift

  overlap: keyword∩vector=0/3 · hybrid∩vector=1/3 · hybrid∩keyword=2/3
In der Überlappungszeile haben Keyword und Vektor 0 der gleichen Jobs in den Top 3 gefunden. Sie suchen in unterschiedlichen konzeptionellen Räumen.
- Keyword (BM25) findet Anzeigen, in denen die wörtlichen Tokens “LLMs” und “prompt” am häufigsten vorkommen. Es gibt generische KI/ML-Titel zurück.
- Vektor (Cohere) findet die Senior Software Engineer (Prompt Engineer Python/GenAI)-Stelle bei #1, obwohl die Benutzeranfrage “prompt engineering” (Gerundium) sagte und der Titel “Prompt Engineer” (Substantiv) sagt. Es gibt auch eine LLM-fokussierte Anzeige von Jobs via Dice zurück, die eine starke semantische Übereinstimmung ist, aber lexikalisch weit von der Anfrage entfernt.
- Hybrid + Reranking nimmt die Vereinigung, dedupliziert und führt sie durch Cohere Rerank. Die Serval Applied AI Engineer-Rolle ($200k bis $325k) rückt auf #1. Ihre Beschreibung ist dicht mit Prompt-Engineering- und LLM-Agent-Arbeit, aber weder ihr Titel noch ihre top BM25-gewichteten Begriffe hätten die Rolle so hoch gerankt.
Für diese spezifische Anfrage haben Vektor und Hybrid beide besser abgeschnitten als Keyword. Rohe Token-Überlappung rankte die Genpact- und Serval-Ergebnisse unterhalb ihrer semantischen Relevanz. Aber eine einzige Anfrage ist eine Anekdote, kein Beweis. Ob dieses Muster im Allgemeinen gilt, kann nur eine echte Evaluation beantworten.
Qualität mit Precision@3 messen
Um dies richtig zu messen, bewertet eval.py 10 handgeschriebene Anfragen gegen alle 3 Modi und berechnet Precision@3, den Anteil der Top-3-Ergebnisse, der einem transparenten Ground-Truth-Prädikat entspricht.
Die Ground Truth für jede Anfrage ist ein Python-Prädikat, keine magische Zahl, sodass ein Leser entscheiden kann, ob er Ergebnisse genauso bewerten würde.
Für “machine learning engineer bei OpenAI” gilt ein Ergebnis nur als relevant, wenn sein company-Feld “OpenAI” enthält. Für “quantitativer Entwickler bei einer Handelsfirma” ist die Regel breiter. Ein Ergebnis gilt, wenn der Titel “Quant” oder “Trading” enthält, oder das Unternehmen eine bekannte Handelsfirma ist (Fintal Partners, DRW, Hudson River Trading, Tower Research, Mondrian Alpha). Diese Prädikate sind auf den Beispieldatensatz abgestimmt, sodass Ihre Scores bei frischen Jobs abweichen werden. Passen Sie sie an Ihre eigenen Daten an. Die Lücke zwischen den Modi bleibt bestehen, auch wenn die genauen Prozentzahlen nicht übertragen werden.
Ausführen:
$ python eval.py

precision@3 per query (hits/3)
────────────────────────────────────────────────────────────────────────
  query                                          keyword    vector     hybrid
────────────────────────────────────────────────────────────────────────
  machine learning engineer at OpenAI            1.00 (3/3)  1.00 (3/3)  1.00 (3/3)
  founding engineer at AI startup with equity    0.33 (1/3)  0.67 (2/3)  0.67 (2/3)
  prompt engineer working with LLMs              0.00 (0/3)  0.67 (2/3)  0.33 (1/3)
  quantitative developer at trading firm         0.67 (2/3)  1.00 (3/3)  1.00 (3/3)
  computer vision and robotics engineer          1.00 (3/3)  0.67 (2/3)  1.00 (3/3)
  data scientist role                            0.67 (2/3)  1.00 (3/3)  1.00 (3/3)
  distributed training infrastructure for ML     0.33 (1/3)  0.67 (2/3)  0.67 (2/3)
  backend engineer at AI company                 0.33 (1/3)  0.33 (1/3)  0.33 (1/3)
  python developer at fintech                    0.00 (0/3)  0.67 (2/3)  0.33 (1/3)
  high-paying machine learning role with equity  0.00 (0/3)  0.33 (1/3)  0.33 (1/3)
────────────────────────────────────────────────────────────────────────
  AVERAGE (10 queries)                           0.433       0.700       0.667
Die gleichen Zahlen als Diagramm:
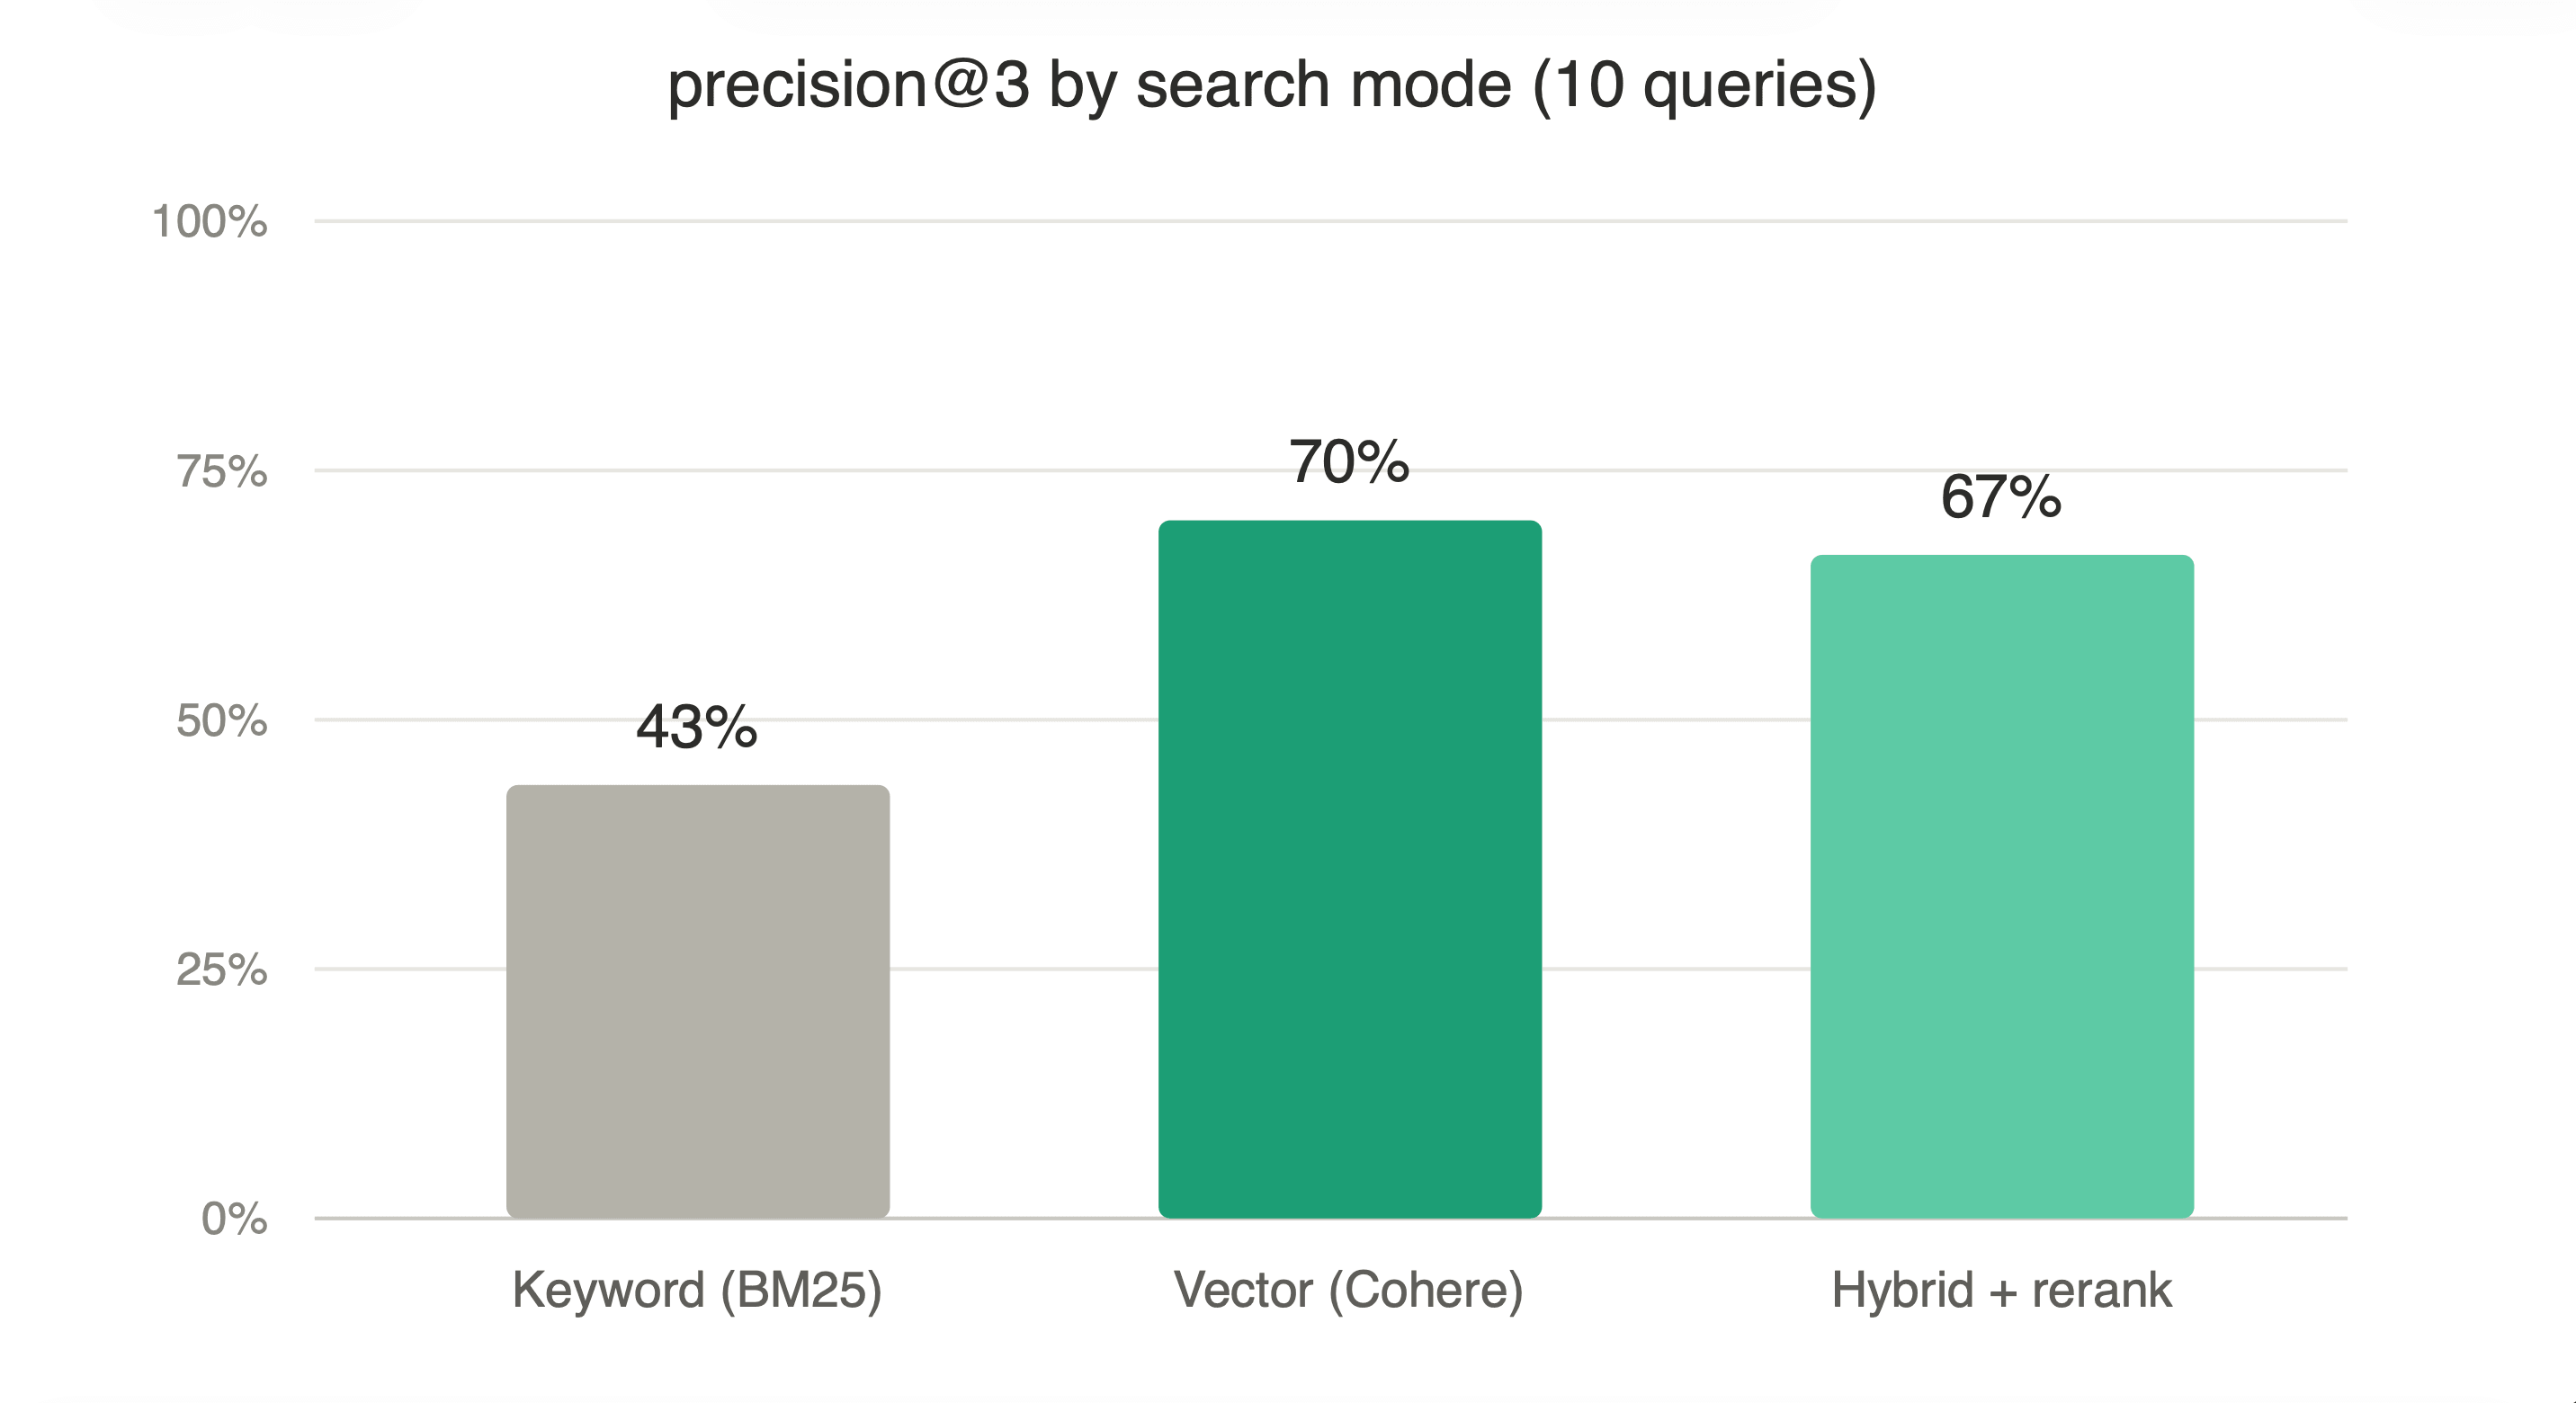
Precision@3 gemittelt über die 10 Eval-Anfragen. Vektor schneidet deutlich besser als Keyword ab, und Hybrid liegt innerhalb weniger Punkte von Vektor.
Was die Zahlen sagen
Aus der Tabelle:
- Vektorsuche schnitt deutlich besser ab als Keyword-Suche mit 70 % vs. 43 % durchschnittlicher Precision@3. Alle 3 Anfragen, bei denen Keyword 0 erzielte (“Prompt Engineer”, “Python-Entwickler bei Fintech”, “hochbezahltes ML mit Equity”), hatten unter Vektor mindestens 1 relevanten Treffer.
- Hybrid + Reranking hat Vektor bei dieser Größe nicht übertroffen. Die Lücke von 67 % vs. 70 % liegt im Rauschen: Der Reranker fügt einen Cohere-Aufruf pro Anfrage hinzu, und die FTS-Hälfte liefert ihm lexikalische Fast-Treffer, die er dann herausfiltern muss.
- Kein Modus ist streng dominiert. “Computer Vision und Robotik” ist die einzige Anfrage, bei der Keyword (1,00) über Vektor (0,67) liegt, weil die relevanten Unternehmen alle wörtliche Robotik-Begriffe in ihren Beschreibungen enthalten.
Wann Hybrid + Reranking aktivieren
Es hängt von einigen Faktoren ab:
- Kandidatenpool-Größe. Bei ein paar hundert Zeilen reicht Vektor allein meist aus. Die 2-stufige Retrieval-Methode von Hybrid benötigt einen größeren Pool (10.000+), bevor der Reranking-Schritt seinen Aufwand wert ist.
- Anfragetyp. Anfragen mit sowohl semantischer Absicht als auch charakteristischen Keywords (ein Markenname, eine spezifische Technologie) profitieren von Hybrid. Rein semantische Anfragen tun es meist nicht.
- Reranker-Qualität. Coheres rerank-v3.5 hat in unserer Evaluation gut abgeschnitten. Wenn Sie einen anderen Reranker einsetzen, führen Sie
eval.pyerneut aus, bevor Sie ihm vertrauen, da ein schwächerer Reranker gute Vektor-Ergebnisse bei einem kleinen Kandidatenpool nach unten sortieren kann.
Führen Sie eval.py mit Ihren eigenen Daten aus, um zu entscheiden. Eine Anfrage hinzuzufügen ist ein String plus ein Ground-Truth-Prädikat.
Hinweis: Die Hybrid-Evaluation läuft problemlos mit einem kostenlosen Cohere-Schlüssel. Das Trial-Rate-Limit sorgt dafür, dass sie ~90s statt ~15s benötigt.
Eine Web-UI mit Streamlit hinzufügen
Streamlit verwandelt dasselbe Such-Backend in eine klickbare Web-App. Der Such- und Render-Kern ist unten:
# app.py
import streamlit as st
from lib import search

mode = st.sidebar.radio("Mode", ["hybrid", "vector", "keyword"])
seniority = st.sidebar.selectbox("Seniority", ["any", "Entry level", "Associate", "Mid-Senior level", "Director", "Internship", "Not Applicable"])
min_salary = st.sidebar.slider("Min salary ($/yr)", 0, 500_000, 0, step=10_000)

query = st.text_input("Search jobs", placeholder="e.g. remote ML engineer...")

if query:
    where_clauses = []
    if seniority != "any":
        where_clauses.append(f"seniority = '{seniority}'")
    if min_salary > 0:
        where_clauses.append(f"salary_min_annual >= {min_salary}")
    where = " AND ".join(where_clauses) or None

    df = search(query, mode=mode, where=where, limit=10)
    for _, row in df.iterrows():
        with st.container(border=True):
            st.markdown(f"### [{row['title']}]({row['apply_url']})")
            st.markdown(f"**{row['company']}** — {row['location']}")
            st.caption(row["description_snippet"] + "…")
Ausführen:
streamlit run app.pySie erhalten eine vollständige Suchseite unter localhost:8501 mit einem Suchfeld, Modusumschalter, Seitenleisten-Filtern für Seniorität, Quell-Keyword und Gehalt sowie Ergebniskarten mit Abzeichen, Scores und Snippet-Vorschauen.
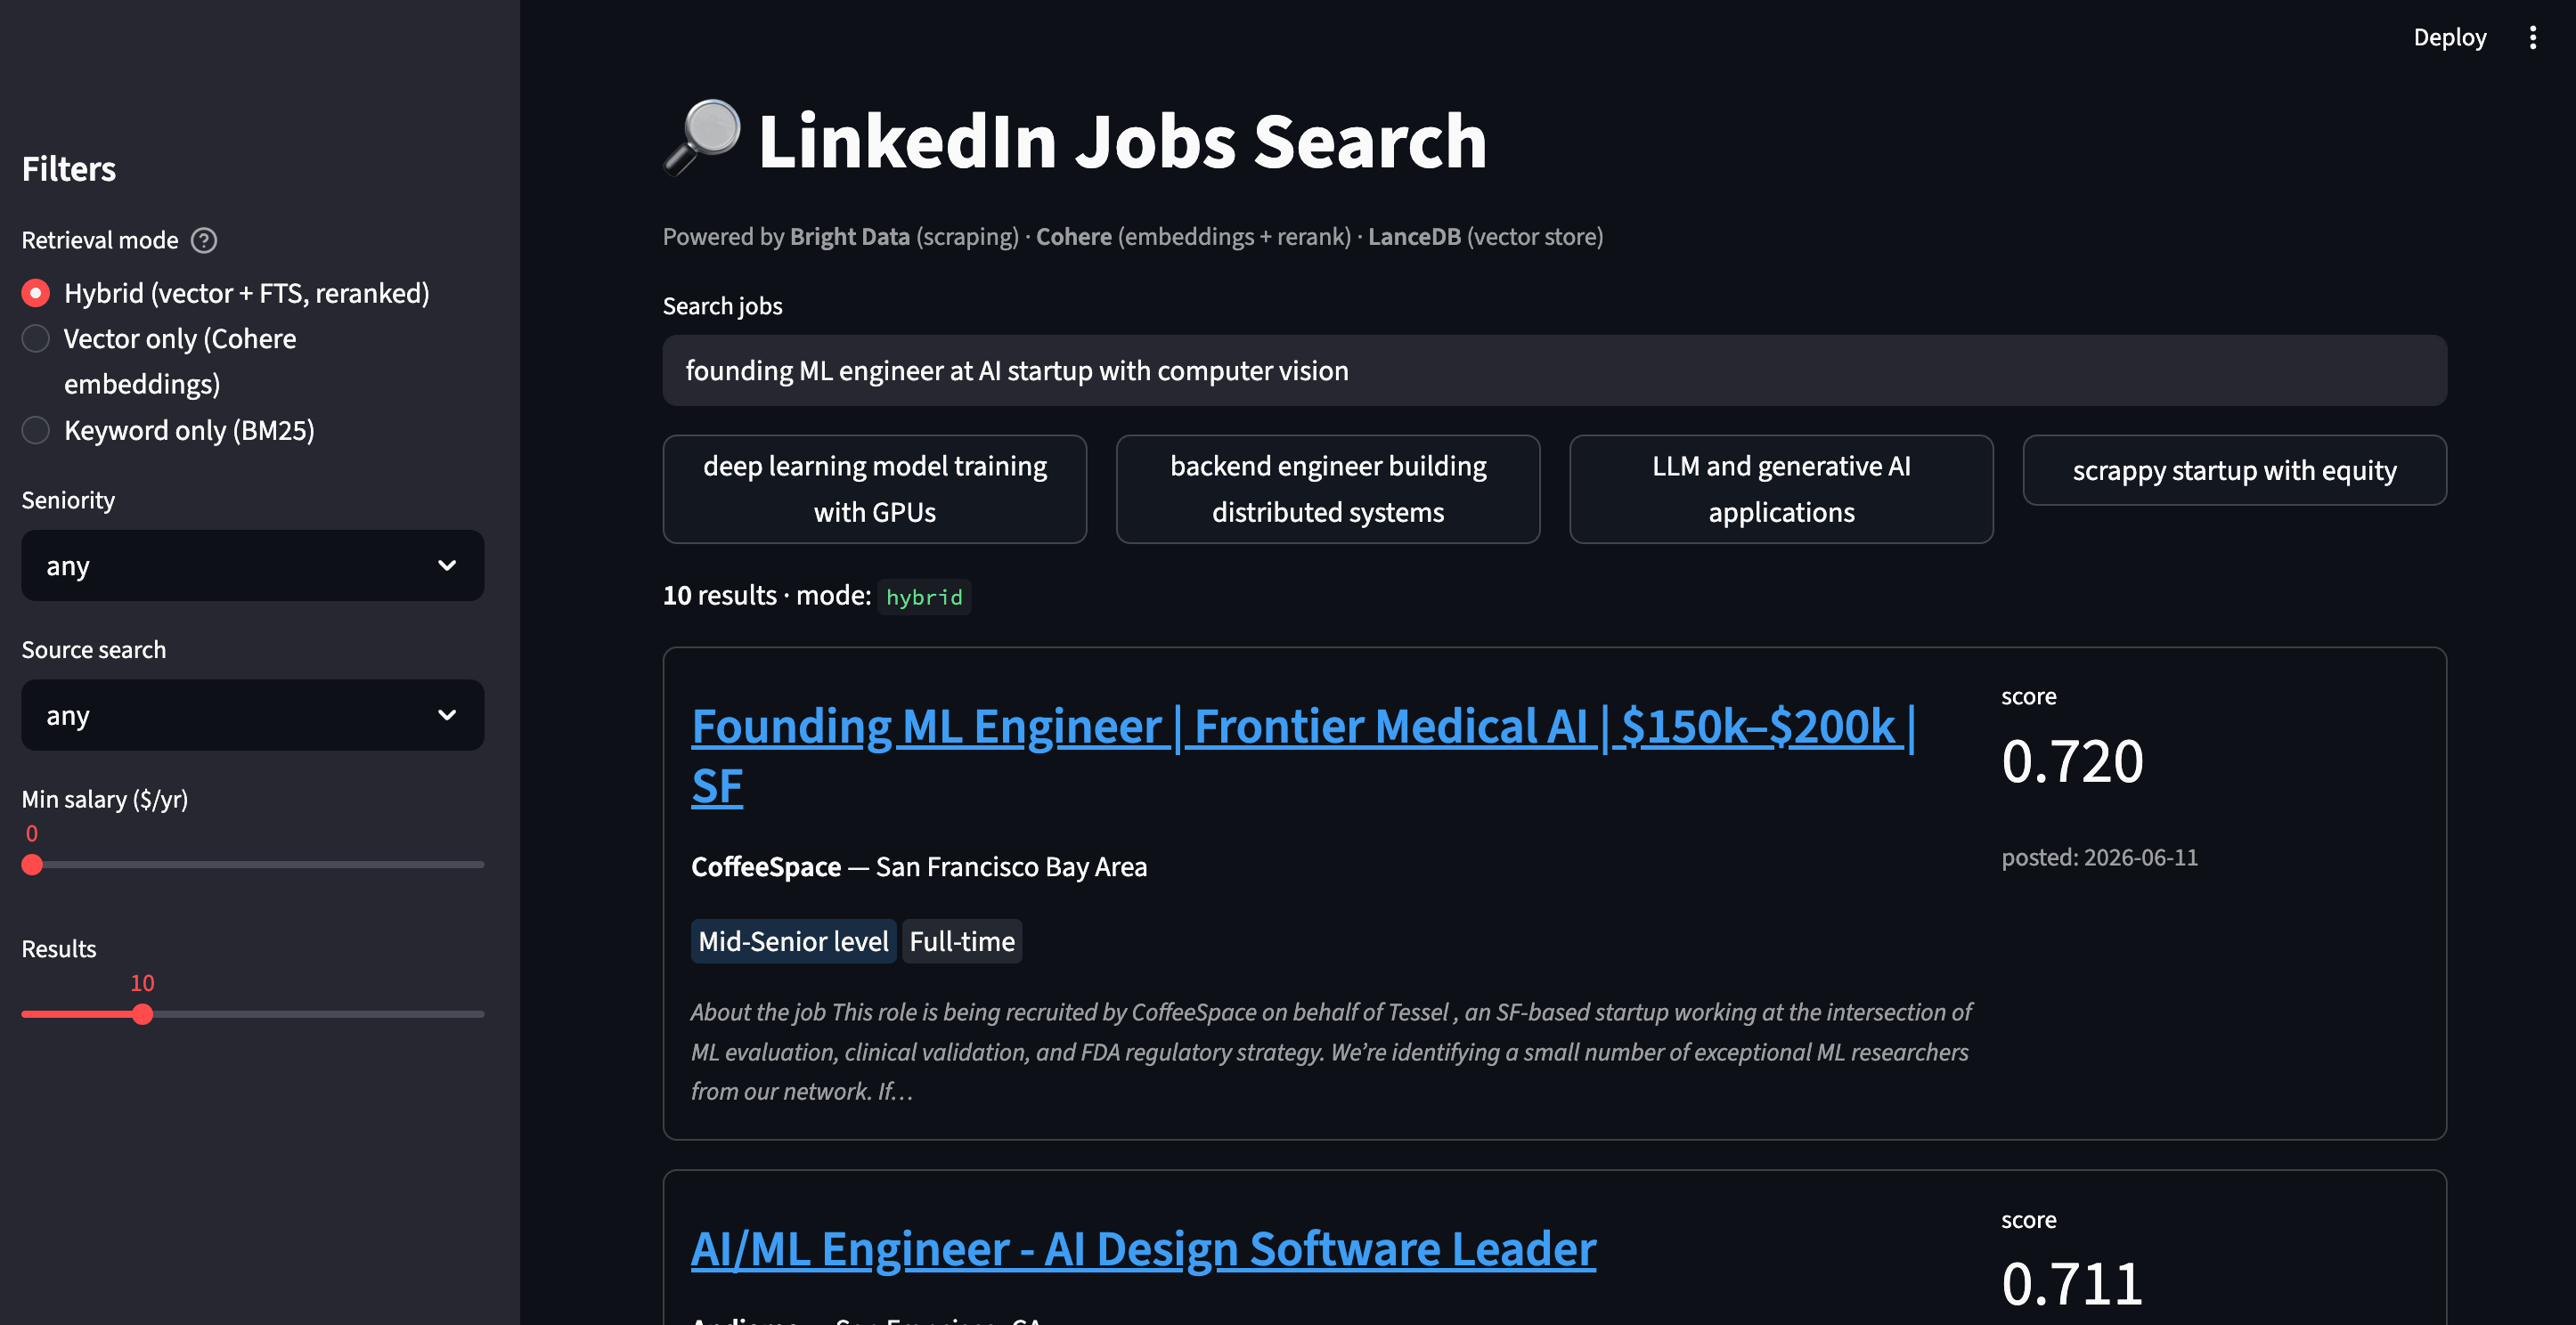
Die Streamlit-App führt eine Hybridsuche aus. Das Score-Abzeichen auf jeder Karte ist Coheres Relevanz-Score, und das Snippet unterhalb der Abzeichen zeigt, warum jedes Ergebnis in die Top 3 gelangt ist.
Kostenlose Zeitreise mit LanceDB
Das deckt Suche und UI ab. LanceDB hat noch ein weiteres Feature, das es wert ist, gezeigt zu werden. Jeder Schreibvorgang in LanceDB erstellt automatisch eine neue Version, ohne zusätzliche Kosten oder Infrastruktur. So funktioniert das zugrunde liegende Lance-Spaltenformat. Um eine Version später leicht zu finden, markiert index.py sie nach jedem Ingest:
table.tags.create(f"ingest-{datetime.now():%Y-%m-%d-%H%M}", table.version)Unser Begleitskript versions.py ermöglicht es Ihnen dann, historische Snapshots zu durchsuchen und zu öffnen. Nach einmaligem Ausführen von python index.py sehen Sie 1 Tag. Nach einem zweiten Ingest (z. B. einer Woche später erneut gescrapt) sehen Sie 2:
$ python versions.py

📊 table 'jobs'  ·  current version: 13  ·  200 rows

🏷  tags (2):
  • ingest-2026-05-20-0905           → version 7
  • ingest-2026-05-20-0906           → version 13  ← current

  travel back with: `python versions.py --tag `

$ python versions.py --tag ingest-2026-05-20-0905

📌 snapshot 'ingest-2026-05-20-0905'  ·  version 7  ·  200 rows
  • Associate Machine Learning Engineer  — Handshake
  • Machine Learning Engineer            — RZR
  • Machine Learning Engineer            — ChatGPT Jobs
Zeitreise ist ein einziger table.checkout(tag_or_version)-Aufruf. Für ein Job-Such-Produkt beantwortet es Fragen wie “welche Stellen wurden letztes Quartal gepostet?” oder “verschiebt sich die Gehaltsverteilung über die Zeit?” ohne eine separate Zeitreihendatenbank. Das ist ein Grund, warum wir LanceDB hier gewählt haben.
Kosten und Skalierung
Für die Demo (200 Jobs, ~5 Beispielanfragen):
| Element | Kosten |
|---|---|
| Bright Data Scrape (204 Datensätze @ $0,0015/Datensatz) | $0,31 |
| Cohere Embeddings (~228k Token gesamt @ $0,10/1M) | ~$0,02 |
| Cohere Reranking (~$0,002/Anfrage, Rerank v3.5 bei $2 / 1k Suchen) | ~$0,01 für 5 Anfragen |
| LanceDB | kostenlos |
Die End-to-End-Demo kostet insgesamt ~$0,34. Diese Preise stammen aus einem Durchlauf von 2026, überprüfen Sie also die aktuellen Tarife der Anbieter.
Skalieren
Die lokale Demo verarbeitet 200 Jobs. Einige Hebel decken den Weg von hier zu einem produktionsskaligen Datensatz ab:
- Mehr Jobs. Ändern Sie
LIMIT_PER_INPUT(max. 1.000 pro Keyword) oder fügen Sie mehr Keyword-Suchen hinzu. 10.000 Jobs kosten ~$15 in Bright Data-Credits. - Mehr Keywords / Standorte. Fügen Sie Einträge zur
SEARCHES-Liste inscrape.pyhinzu. - Geplante Aktualisierung. Der
merge_insert-Upsert, den wir gebaut haben, bedeutet, dass das erneute Ausführen der Pipeline aktualisiert, was sich geändert hat. Bright Data unterstützt geplante Sammlung und Lieferung vom Dashboard. Kombinieren Sie das mit dem Upsert und Sie haben einen sich selbst aktualisierenden Datensatz. - Vektorindex. Ab ~10.000 Zeilen tauschen Sie die Brute-Force-Suche gegen einen HNSW- oder IVF_PQ-Index via
table.create_index(vector_column_name="vector")aus. Er wird standardmäßig auf der CPU erstellt. Für einen GPU-Build übergeben Sieaccelerator="cuda"(oder"mps"auf Apple Silicon) mit PyTorch>2.0. Automatisches GPU-Indexieren ist derzeit ein LanceDB Enterprise-Feature. - Produktions-Vektorspeicher. LanceDB OSS skaliert auf Millionen von Vektoren auf einem einzelnen Knoten. Jenseits von hunderten Millionen Vektoren oder Terabytes an Daten fügen LanceDB Cloud und Enterprise verteiltes Indexieren und Abfrageausführung hinzu (ihre Dokumentation zielt auf ~10 bis 50B Zeilen / ~10 bis 30 TB ab).
Vor all diesen Skalierungsschritten hat die Demo selbst jedoch scharfe Kanten.
8 Bugs und Fallstricke, auf die wir gestoßen sind
Falls es Ihnen die Stunden spart, die sie uns gekostet haben:
list_tables()gibt keine Liste zurück. In LanceDB 0.30 gibt es einListTablesResponse-Objekt zurück, das im REPL iterierbar aussieht, aberif TABLE in db.list_tables()schlägt still fehl. Verwenden Sie stattdessentry: db.open_table(TABLE)und fangen Sie die Ausnahme ab, oder nutzen Sie.tablesauf der Antwort.table.checkout(tag)gibtNonezurück und mutiert den Tabellen-Handle direkt. Es sieht wie ein Bug aus, ist aber keiner. Machen Siet = db.open_table(...); t.checkout(tag); use(t), nichtt = db.open_table(...).checkout(tag).- Der Standard-
CohereReranker()verwendet ein altes Modell (rerank-english-v3.0in den von uns getesteten Versionen). Übergeben Sie ein Modell explizit, entwederrerank-v3.5(was wir hier fixieren) oderrerank-v4.0-profür höhere Qualität. Der Standard warnt Sie nicht. - Verwenden Sie
/trigger+ Polling, nicht/scrape, für echte Batches. Synchron (/scrape) ist für kleine Pulls gebaut. Die Verbindung fürlimit_per_input=100× 2 Keywords (~200 Jobs) offen zu halten, kann ein Timeout auslösen, verwenden Sie also/trigger+ Polling für alles über ~50 Datensätze. - Einige gescrapte Datensätze sind Fehlerzeilen. Von 204 Jobs hatten 4 ein
error-Feld gesetzt statt einesjob_title(zum Beispiel"Crawl aborted on job cancel"). Sie sehen oberflächlich wie normale Datensätze aus, filtern Sie sie also inindex.py, sonst schlägtmerge_insertbei einer leerenjob_idfehl. - Gehälter kommen in 2 Perioden (
yrundhr), aber das Schema-Feld ist dasselbe. Ohne Normalisierung auf jährlich (Stundenlohn mit 2080 multiplizieren) verpasst ein Filter wiesalary_min_annual >= 200000stillschweigend hochbezahlte Stundenverträge und schließt unplausibel niedrige Gehaltsrollen ein. argparse-Hilfsstrings mit rohem%brechen in Python 3.14. Das Schreiben von--where "salary > 200000 AND location LIKE '%SF%'"in Ihrem Hilfstext löstValueError: badly formed help stringaus, weil argparse versucht, es zu formatieren. Escapen Sie als%%oder formulieren Sie das Beispiel um.- Streamlit rendert Text zwischen
$-Zeichen als LaTeX-Mathematik. Ein Gehalt wie$150k,$200k, das mitst.markdownoderst.captionangezeigt wird, wird zu verwirrter Mathematik. Escapen Sie jedes$in Ihren Anzeigestrings (dasapp.pydes Repos tut es mit einem einzeiligenreplace), sonst werden die Gehaltsabzeichen als Kauderwelsch gerendert.
Was Sie als Nächstes bauen können
Das Muster, Bright Data ⟶ Embeddings ⟶ Vektor-DB ⟶ Hybridsuche, lässt sich auf fast jede Domäne verallgemeinern:
| Domäne | Bright Data-Produkt | Was Sie abfragen würden |
|---|---|---|
| Agentischer Web-Zugang | Der Bright Data MCP (Free Tier aktuell 5.000 Anfragen/Monat) | “einem KI-Agenten Live-Such- + Scraping-Tools geben, dann seine Antworten gegen einen LanceDB-gestützten Cache vergangener Ergebnisse erden” |
| Ganze-Site-Korpora | Crawl API | “eine gesamte Dokumentationsseite oder Wissensdatenbank für hybrides Retrieval indexieren” |
| E-Commerce | Web Scraper API (Amazon-Produkte) | “bequeme Laufschuhe unter 100 $ mit 4+ Sternen” |
| Immobilien | Web Scraper API (Zillow / Redfin) | “ruhiges Familienhaus in der Nähe guter Schulen, 3+ Schlafzimmer” |
| Nachrichtenintelligenz | SERP-API + Web Unlocker | “KI-Sicherheitsartikel aus dieser Woche, nach Relevanz für Alignment gerankt” |
| Vertriebsprospektierung | LinkedIn-Unternehmensinformationen | “Series-A-Startups in Healthcare-KI mit Sitz in Europa” |
| Restaurants | Yelp-Datensatz | “gemütliches italienisches Restaurant mit Außensitzplätzen” |
Einige natürliche Erweiterungen dieses genauen Projekts:
- Multimodale Suche. Wechseln Sie zu Cohere
embed-v4.0(nativ multimodal) und betten Sie Unternehmenslogos neben Stellenbeschreibungen ein. - KI-extrahierte Filter. Lassen Sie den Benutzer “Remote-ML-Jobs mit $200k+” eingeben und eine KI
remote=true, salary_min_annual >= 200000automatisch extrahieren. - Gespeicherte Suchen mit E-Mail-Benachrichtigungen. Führen Sie eine Anfrage gegen den neuesten Scrape erneut aus und benachrichtigen Sie bei neuen Treffern.
- Lebenslauf-Matching. Betten Sie einen Lebenslauf ein und suchen Sie Jobs nach Ähnlichkeit zum Kandidaten. Bright Datas LinkedIn-Job-Hunting-KI-Assistent ist ein vollständigeres Beispiel.
- Ein selbstwartender Scraper. Geben Sie einem Agenten Zugang zu Bright Datas MCP, und er kann die Seite inspizieren, den Scraper schreiben und einen Fix versuchen, wenn sich das Layout ändert, anstatt dass Sie
scrape.pymanuell patchen. Bright Datas Scraper Studio verpackt dies als verwaltetes Produkt und verwandelt einen einfachen Prompt in einen selbstheilenden Scraper.
Nächste Schritte
Keyword-Suche verpasste die richtigen Rollen, und Vektorsuche fand sie, auch wenn die Titel nie mit der Anfrage übereinstimmten. In der Evaluation erzielte Vektor 70 % Precision@3 gegenüber 43 % bei Keyword, wobei Hybrid bei dieser Größe keinen Vorteil brachte.
Das vollständige Projekt auf GitHub umfasst 9 kleine Dateien. Um es mit Ihren eigenen Daten zu verwenden, führen Sie zuerst python eval.py aus, da der beste Modus von den Daten abhängt, nicht davon, welcher am komplexesten ist. Entscheiden Sie dann einen Aktualisierungsrhythmus, bei dem merge_insert-Upserts nur das Geänderte aktualisieren und versions.py jeden Ingest als Snapshot speichert. Und bevor davon irgendetwas in Produktion geht, planen Sie eine Schlüsselrotationsroutine, da sowohl BD- als auch Cohere-Schlüssel in .env stehen.
Das gleiche Muster funktioniert für alles, was Bright Data scrapen kann, nicht nur Jobs. Von dort aus haben Sie eine semantische Suchmaschine, die Sie für jeden Datensatz wiederverwenden können, den Sie scrapen.
FAQ
Kann ich das für andere Websites als LinkedIn verwenden?
Ja. Bright Datas Web Scrapers Library deckt hunderte von Websites ab (Amazon, Zillow, Yelp und mehr), jede mit ihrer eigenen dataset_id. Tauschen Sie die DATASET_ID in scrape.py und das to_row()-Mapping in index.py für die neue JSON-Form aus. Die Such- und Indexierungslogik ist datenagnostisch und überträgt sich.
Benötige ich ein bezahltes Cohere-Konto dafür?
Nein, ein Trial-Schlüssel führt die gesamte Demo aus. Coheres Trial-Rerank-Endpunkt ist derzeit auf 10 Aufrufe/Min begrenzt, sodass eval.py einen 429 erhält und automatisch zurückweicht (~90s statt ~15s). Web-Scraping, Indexierung und Ad-hoc-Suche bleiben weit unter den Limits. Upgraden Sie nur, wenn Sie oft über die Evaluation iterieren.
Warum LanceDB, nicht Pinecone, Weaviate oder pgvector?
LanceDB ist eine eingebettete Bibliothek ohne Server, ohne separate Datenbank und ohne Managed-Service-Rechnung. Es unterstützt Hybridsuche und Cohere-Reranking nativ, und jeder Schreibvorgang ist ein Versions-Snapshot. Für eine Single-Machine-Pipeline ohne Ops ist das der geringste Overhead. Die anderen sind leistungsfähig, fügen aber mehr Infrastruktur hinzu.
Wie oft sollte ich den Scraper erneut ausführen?
Einmal täglich passt zu einer aktiven Jobbörse. Bright Data kann geplante Sammlung vom Dashboard aus ausführen, und der merge_insert-Upsert dedupliziert auf der LanceDB-Seite, sodass erneute Durchläufe günstig sind. Anzeigen, die älter als ~30 Tage sind, sind in der Regel geschlossen, sodass alte Snapshots historisch werden, und versions.py hält sie abfragbar.