Wenn Sie einen Coding-Agent bitten, einen Wettbewerber-Preis-Tracker zu erstellen, haben Sie in etwa einer Minute funktionierenden Code. Dieser Teil ist für eine Aufgabe dieser Art nahezu gelöst. Der nächste Teil wird selten eingeplant. Der Tracker läuft, die Tabelle füllt sich, und einige der Zahlen sind still und leise falsch. Welche und wie viele, hängt davon ab, was Sie unter dem Agent betreiben, und wir haben die Aufgabe auf beide Arten durchgeführt.
Nicht fehlend. Falsch. Ein Preis, der zu einem Schutzplan gehört. Eine Bewertung, die von einem anderen Retailer übernommen wurde. Eine Zeile, die vollständig aussieht, weil irgendetwas in die Zelle musste. Als Entwickler finden Sie diesen Fehler Wochen später, wenn überhaupt. Wenn Sie Preisgestaltung, Merchandising oder einen Marktintelligenz-Feed betreiben, ist es eine Entscheidung, die Sie bereits auf Basis falscher Daten getroffen haben. Wenn Sie ein KI-Produkt darauf aufbauen, ist es eine Zahl, die Ihr Modell mit völliger Sicherheit angeben wird.
Die Lücke liegt nicht im Code des Agents. Bei Retailern, die ihre Seiten schützen, bedeutet das Lesen einer Seite den Umgang mit dem Bot-Management dieses Retailers, und mehr Python ist selten die Lösung.
Also haben wir es gemessen. Eine Preis-Tracker-Aufgabe, 41 eingefrorene Retailer-Produktseiten, 2 Coding-Agents, gleicher Prompt und gleiches Modell, mit und ohne eine verwaltete Web-Datenschicht darunter. Jede Seite, jede Runde und jeder falsche Wert wird veröffentlicht, zusammen mit jeder Kostenzahl, die die CLIs gemeldet haben, und ein einziger Befehl im Repo leitet die unten stehenden Hauptzahlen neu ab und schlägt fehl, wenn der Beitrag von ihnen abgewichen ist.
Cursor CLI mit Bright Data’s MCP las 40 von 41 Seiten und erzielte 89% der Werte korrekt gegenüber einer von uns manuell geprüften Ground Truth. Dieselbe Klasse von Agent ohne Datenschicht las 34 und erzielte 72%. Bei Best Buy, wo der unassistierte Claude-Code-Arm die meisten Seiten verlor, las er 9 von 9 gegenüber 4.
TL;DR
Wir haben eine Preis-Tracker-Aufgabe durch 2 Coding-Agents geführt, mit und ohne eine verwaltete Web-Datenschicht, und jeden Wert manuell bewertet.
- Die Feldgenauigkeit beträgt 89% mit einer Datenschicht gegenüber 72% ohne, auf denselben Seiten und demselben Modell.
- Eine Seite wurde über die 3 Datenschicht-Durchläufe hinweg abgelehnt; die beiden ohne verloren jeweils 5 Seiten.
- Der Preis ist nahezu gleich. Bewertung und Verfügbarkeit trennen die Arme: 93% und 94% gegenüber 83% und 52%.
- Der unassistierte Cursor-Arm schrieb 729 Zeilen Python, und sein User-Agent war 20 Chrome-Versionen alt.
Was wir durchgeführt haben und was konstant gehalten wurde
Wir haben die Aufgabe vor jedem Durchlauf festgelegt: Für eine eingefrorene SKU-Liste über 5 Retailer hinweg Produktname, Preis, Verfügbarkeit und Bewertung erfassen, einen suchgesteuerten Feed neuer Angebote hinzufügen und das Ergebnis in einem kleinen Dashboard darstellen. Wir haben ausschließlich öffentliche Seiten verwendet, nichts hinter einem Login.
Die SKU-Liste wurde vor der ersten Anfrage eingefroren: 10 Consumer-Electronics-Produkte über 5 Retailer, insgesamt 41 Produktseiten, geschrieben in skus.json. Jeder Durchlauf liest diese Datei, sodass jeder Durchlauf identische Ziele anfordert.
Alle 4 Durchläufe waren nicht interaktiv, und jedes Transkript ist gespeichert:
| Durchlauf | Agent | Datenschicht | Rolle |
|---|---|---|---|
| A | Cursor CLI (cursor-agent) |
Bright Data gehostetes MCP | das getestete Setup |
| B | Claude Code | keine | womit es verglichen wird |
| Control | Cursor CLI, gleiche Version | keine | Seitenleiste, isoliert die Datenschicht |
| B+ | Claude Code | Bright Data gehostetes MCP | Seitenleiste, isoliert den Agent |
Was A und B tatsächlich vergleichen
A gegen B ist der Vergleich: ein Team, das Cursor mit einer Datenschicht einsetzt, gegen eines, das einen Coding-Agent einsetzt und seinen eigenen Abruf schreibt. Konstant gehalten: die 41 URLs, die 4 Felder, der Prompt-Text, das Modell, der Scoring-Code, die Maschine und der Nachmittag. Der Prompt erwähnt Bright Data, Proxys oder Scraping-Anbieter nie.
Dieser Vergleich bewegt zwei Dinge gleichzeitig, den Agent und die Datenschicht, weshalb die beiden Seitenleisten existieren. Die Control hält den Agent konstant und entfernt nur die Datenschicht; B+ hält den Agent konstant und fügt sie hinzu. Zusammen zeigen die beiden Seitenleisten, welche Variable das Ergebnis erzeugt, und diese Variable ist nicht der Agent.
Die eine Datei, die sich unterscheidet
Die einzige Variable zwischen A und der Control ist eine Datei. Das Projekt von Durchlauf A enthält eine .cursor/mcp.json, die einen Server benennt und ihn auf Bright Data’s gehosteten MCP-Endpunkt zeigt. Die Datei umfasst unter 10 Zeilen JSON, und wir haben weder ein SDK noch eine Client-Bibliothek installiert. Das Projekt der Control hat dieselbe Datei mit einem leeren mcpServers-Objekt. Vollständig:
{ "mcpServers": { "brightdata": {
    "type": "http",
    "url": "https://mcp.brightdata.com/mcp?token=YOUR_BRIGHT_DATA_API_KEY" } } }
Claude Code wurde dieselbe Datei per Pfad übergeben, mit --strict-mcp-config, damit nichts anderes auf dem Rechner anhängen konnte. Beide Agents liefen gegen eine byte-identische Konfiguration; nur der Dateiname, nach dem jeder Agent sucht, unterscheidet sich.
Das Modell und was als gesammelt gilt
Das Modell wird konstant gehalten. Alle 4 Durchläufe wurden auf Sonnet 5 fixiert, claude-sonnet-5-high im Cursor CLI und claude-sonnet-5 in Claude Code, dasselbe Basismodell unter zwei Herstellernamen. Der Cursor-Alias fixiert den Reasoning-Aufwand auf hoch, und der Standard von Claude Code ist niedriger, was die eine Modelleinstellung ist, die sich unterscheidet; die aufwandsangepasste Prüfung weiter unten kontrolliert dafür.
Eine Seite gilt nur dann als gesammelt, wenn ein Produktname und ein Preis aus dem Zurückgegebenen ausgelesen werden können. Ein HTTP 200, der eine Bot-Challenge enthält, ist kein Erfolg, ebenso wenig ein 200, der eine Produktseite enthält, deren Preis nie gerendert wurde.
Mit dieser Datei kann der Agent die Tools verwenden, ohne dazu aufgefordert zu werden. Angesichts der Aufgabe und ohne Erwähnung eines Anbieters bündelte der Agent die Retailer-URLs in einem einzigen scrape_batch-Aufruf und bat um Genehmigung, bevor dieser Aufruf gesendet wurde.
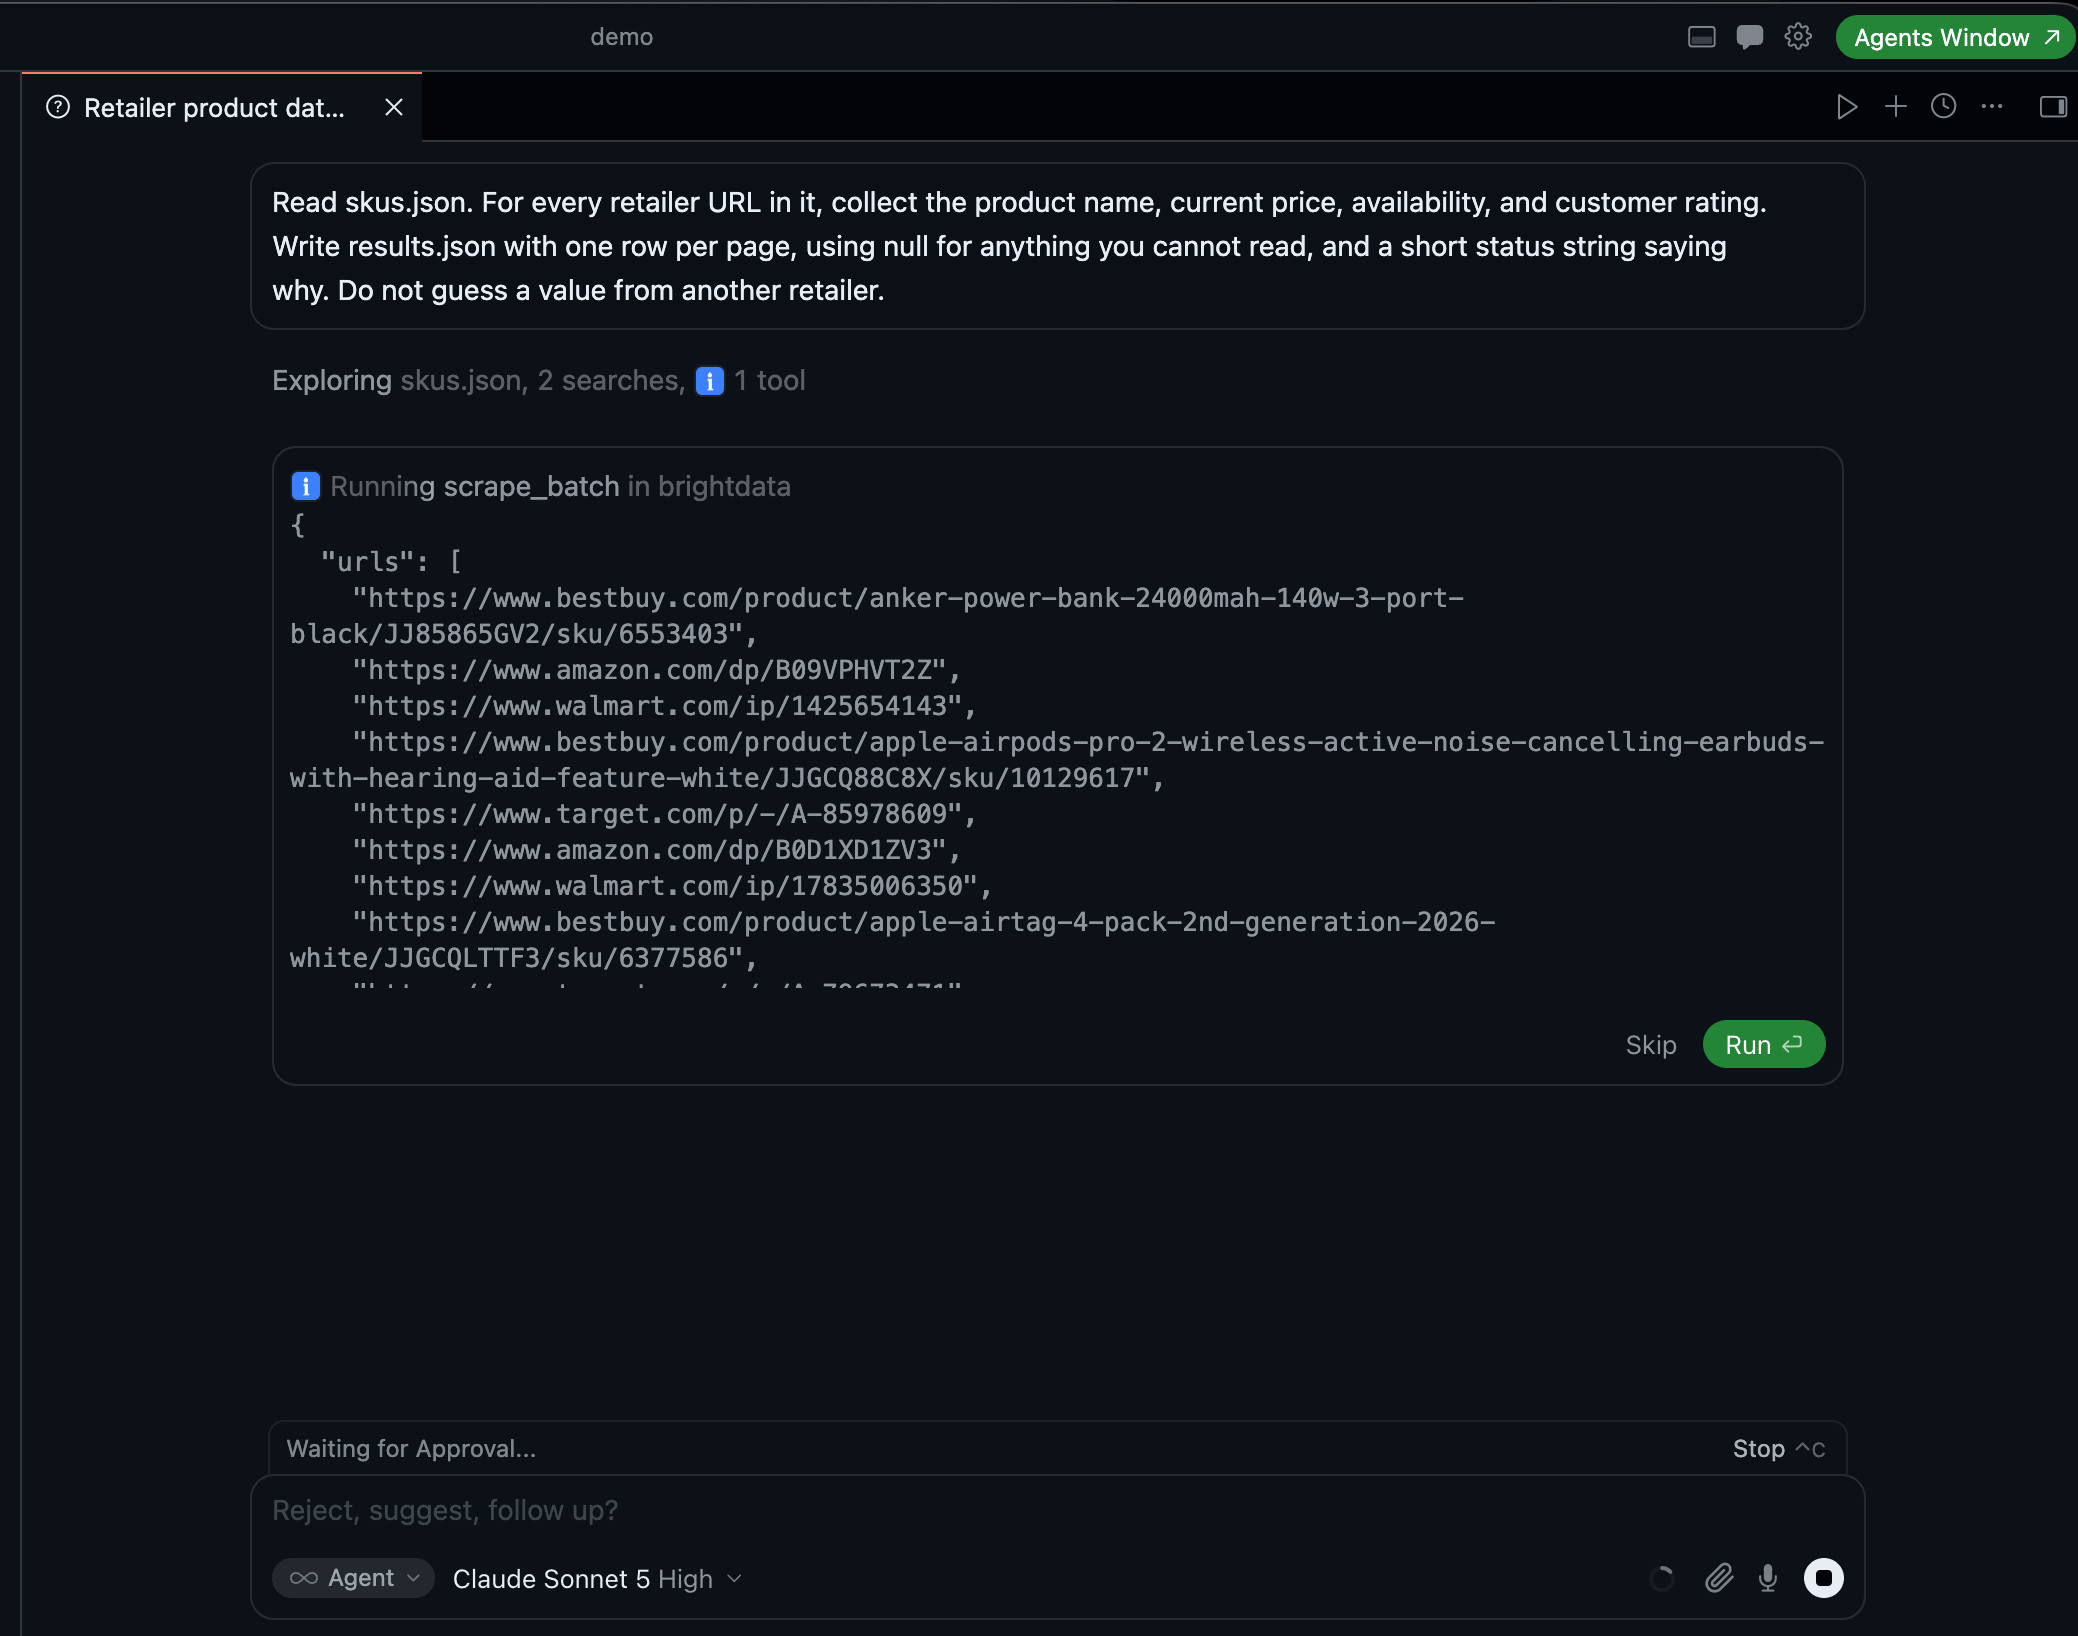
Der Walkthrough auf der echten Liste. Der Agent wählte scrape_batch, stellte den URL-Satz selbst zusammen, und Cursor hielt ihn an einem Genehmigungsgate, bevor etwas den Rechner verließ.
Aufgabenerfolg, die binäre Version
Alle 4 Durchläufe produzierten results.json, new_listings.json, dashboard.html und eine README, sodass bei der binären Frage “läuft es von Anfang bis Ende” jeder Durchlauf besteht. Diese Frage ist die am wenigsten informative, die wir gestellt haben.
| Name + Preis | Alle 4 Felder | Feldgenauigkeit | |
|---|---|---|---|
| A. Cursor + Bright Data | 40 / 41 | 38 | 89% |
| B. Claude Code, keine Datenschicht | 34 / 41 | 29 | 72% |
| B+. Claude Code + Bright Data | 34 / 41 | 34 | 78% |
| Control. Cursor, keine Datenschicht | 28 / 41 | 28 | 74% |
Die Genauigkeit wird gegen eine manuell geprüfte Ground Truth bewertet, die alle 41 Seiten abdeckt und die wir weiter unten beschreiben.
Die aufwandsangepasste Prüfung
Ein Arm fehlt absichtlich in dieser Tabelle. Nach den 4 obigen Durchläufen haben wir B+ erneut ausgeführt, mit auf high angehobenem Reasoning-Aufwand, um die Stufe des Cursor-Arms anzupassen. Er las 35 von 41 mit 88%, gegenüber 34 und 78%. Diese einzelne Änderung ist wichtig: Ohne sie könnten die 4 Zeilen oben als Aufwandsergebnis statt als Datenschichtergebnis gelesen werden.
| Mit Bright Data | Ohne | |
|---|---|---|
| Cursor | 89% | 74% |
| Claude Code, angepasster Aufwand | 88% | 72% |
Die Lücken betragen 15 und 16 Punkte, in dieselbe Richtung, von 2 verschiedenen Agents bei gleichem Modell und gleichem Aufwand. Dieses Zeilenpaar trennt ein Datenschichtergebnis von einem Agent-Ergebnis und erlaubt es, die restlichen Zahlen so zu lesen.
Die Tabelle unterstützt 2 Lesarten. Die erste ist die Reihenfolge: Beide Arme mit einer Datenschicht rangieren über beiden ohne, sowohl bei den gelesenen Seiten als auch bei den korrekt ermittelten Werten. Die zweite ist, dass die Anzahl der gelesenen Seiten den Unterschied unterschätzt. A liest 40 gegenüber B’s 34, eine Lücke von 6. Bei den Werten innerhalb dieser Seiten beträgt die Lücke 17 Punkte, 89% gegenüber 72%, weil eine schlecht abgerufene Seite trotzdem als Seite zählt. Bei einem Seitenset wie diesem schreibt ein Coding-Agent auf einem aktuellen Modell kompetenten Abrufcode und sammelt den größten Teil des Volumens. Den letzten Abschnitt schafft er nicht, und der letzte Abschnitt enthält die schwierigen Retailer und die schwierigen Felder.
Was die Dashboards zeigen
Beide Durchläufe erstellten das von der Aufgabe geforderte Dashboard, was der schnellste Weg ist, den Unterschied zu sehen.
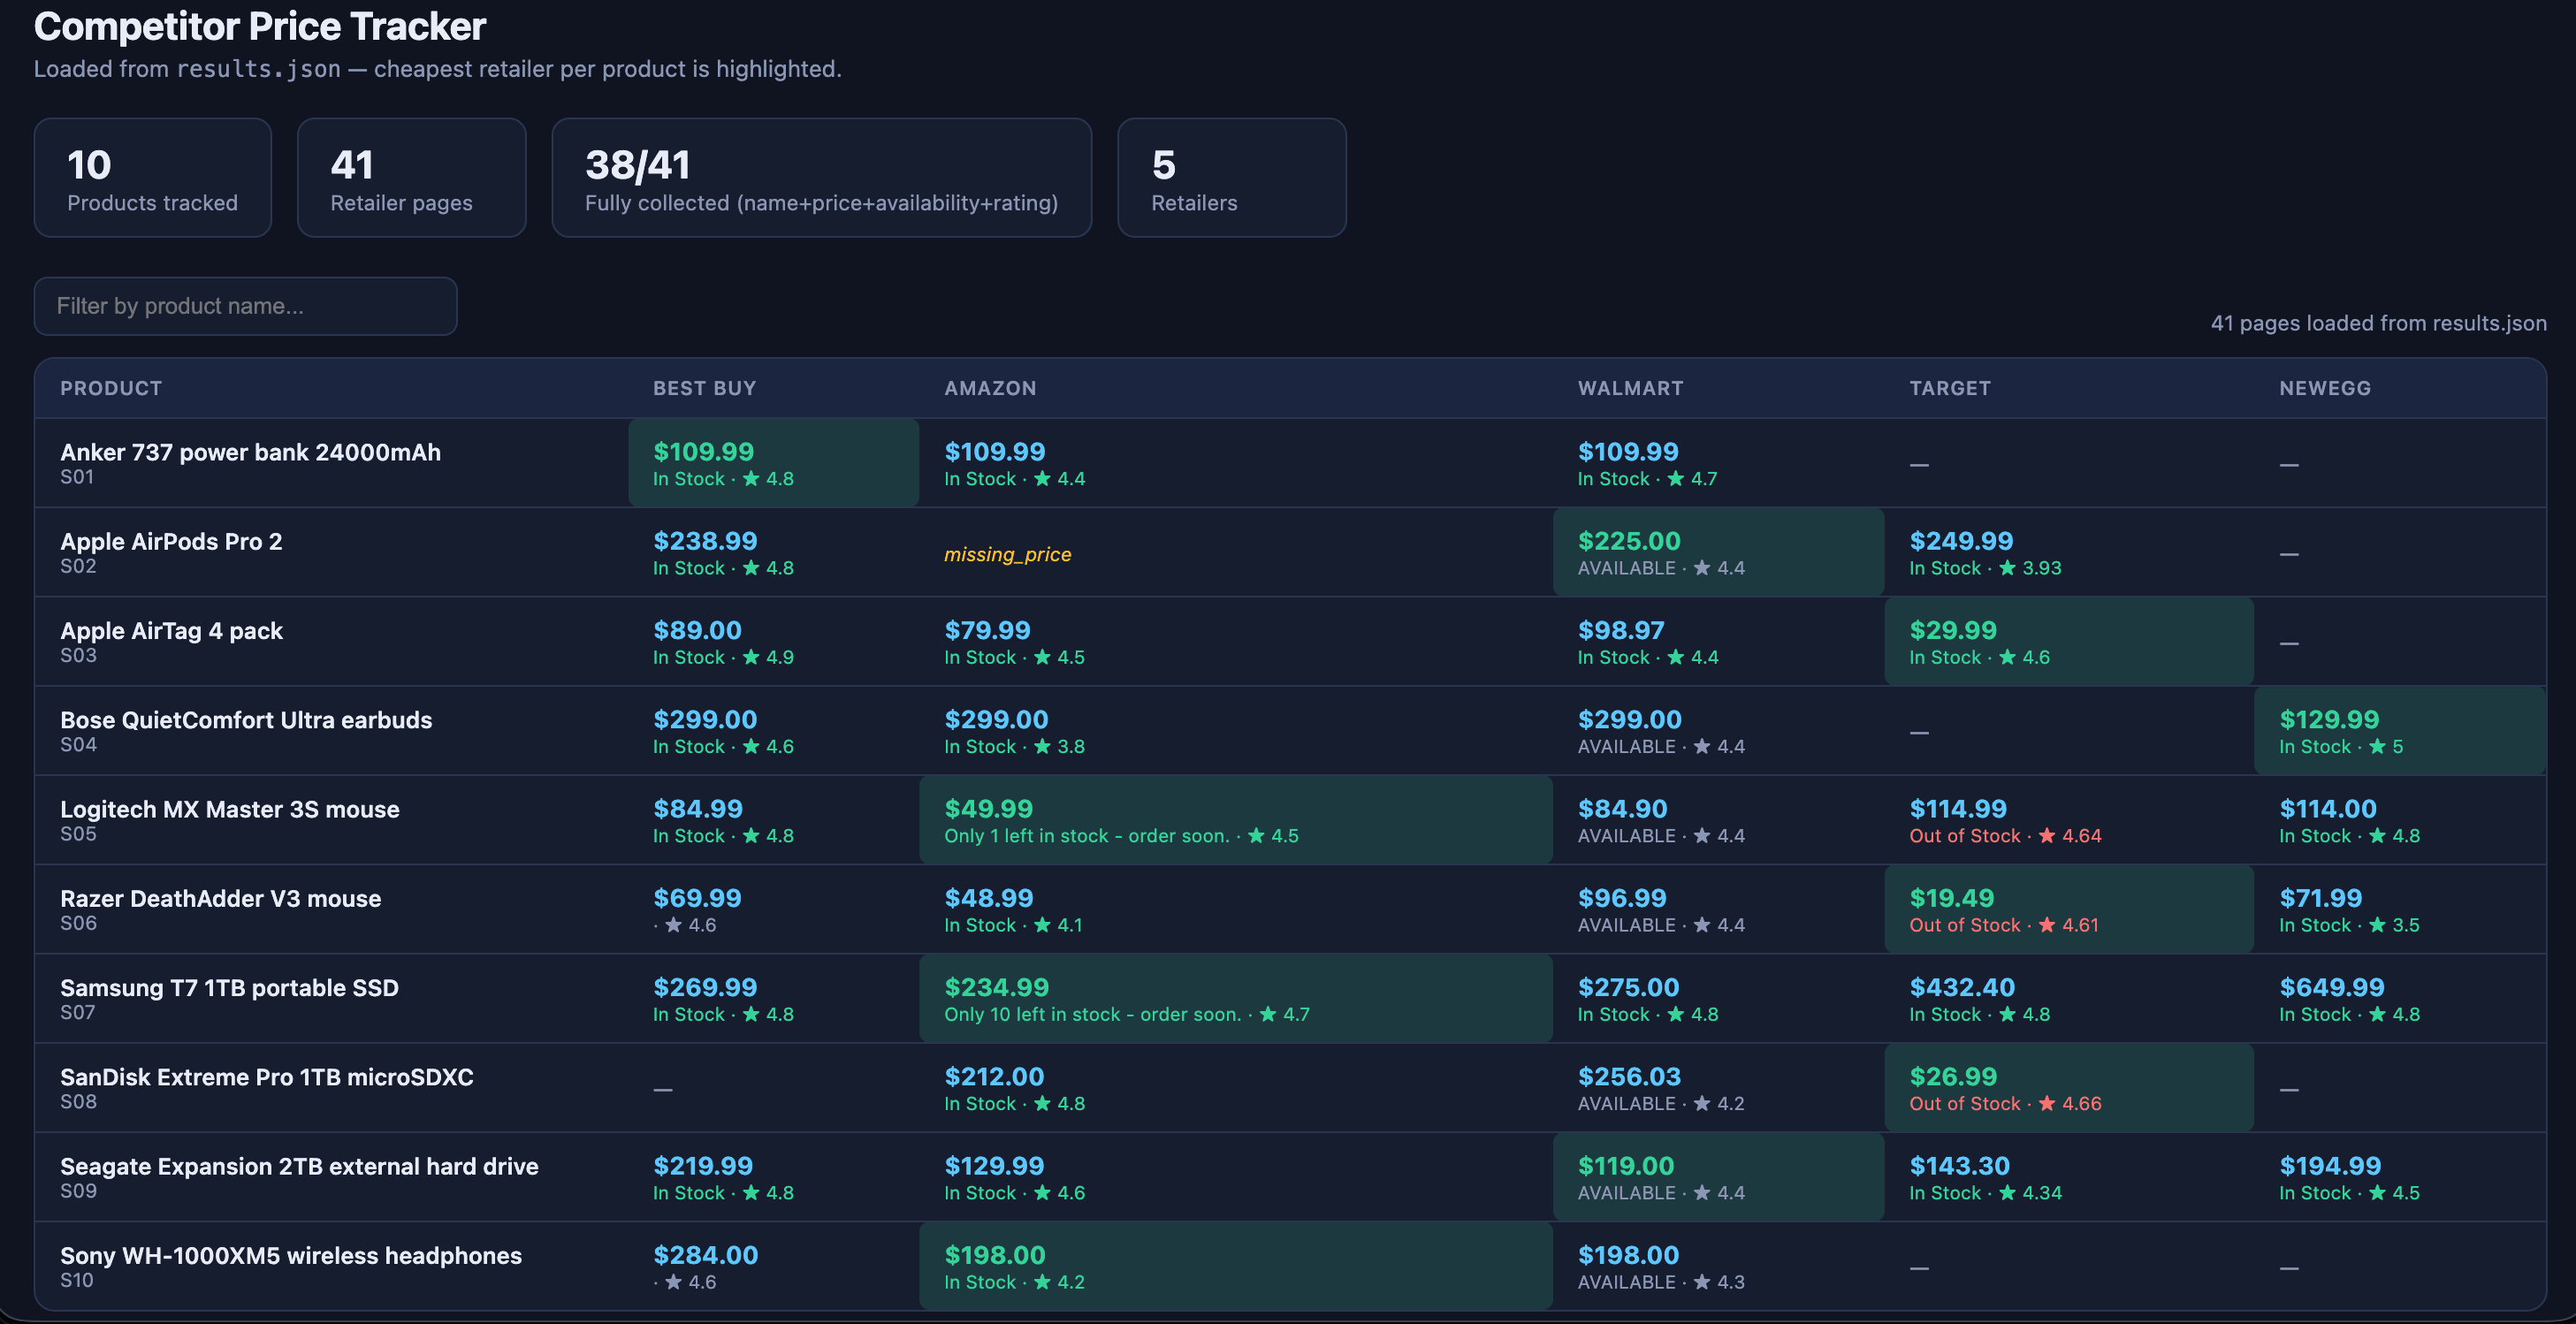
Durchlauf A. Die eine Lücke auf dem Bildschirm wird als missing_price gemeldet und nicht gefüllt.
Die Control erstellte dieselbe Ansicht aus denselben 41 URLs, und der Unterschied zeigt sich in den Zellen statt im Layout:
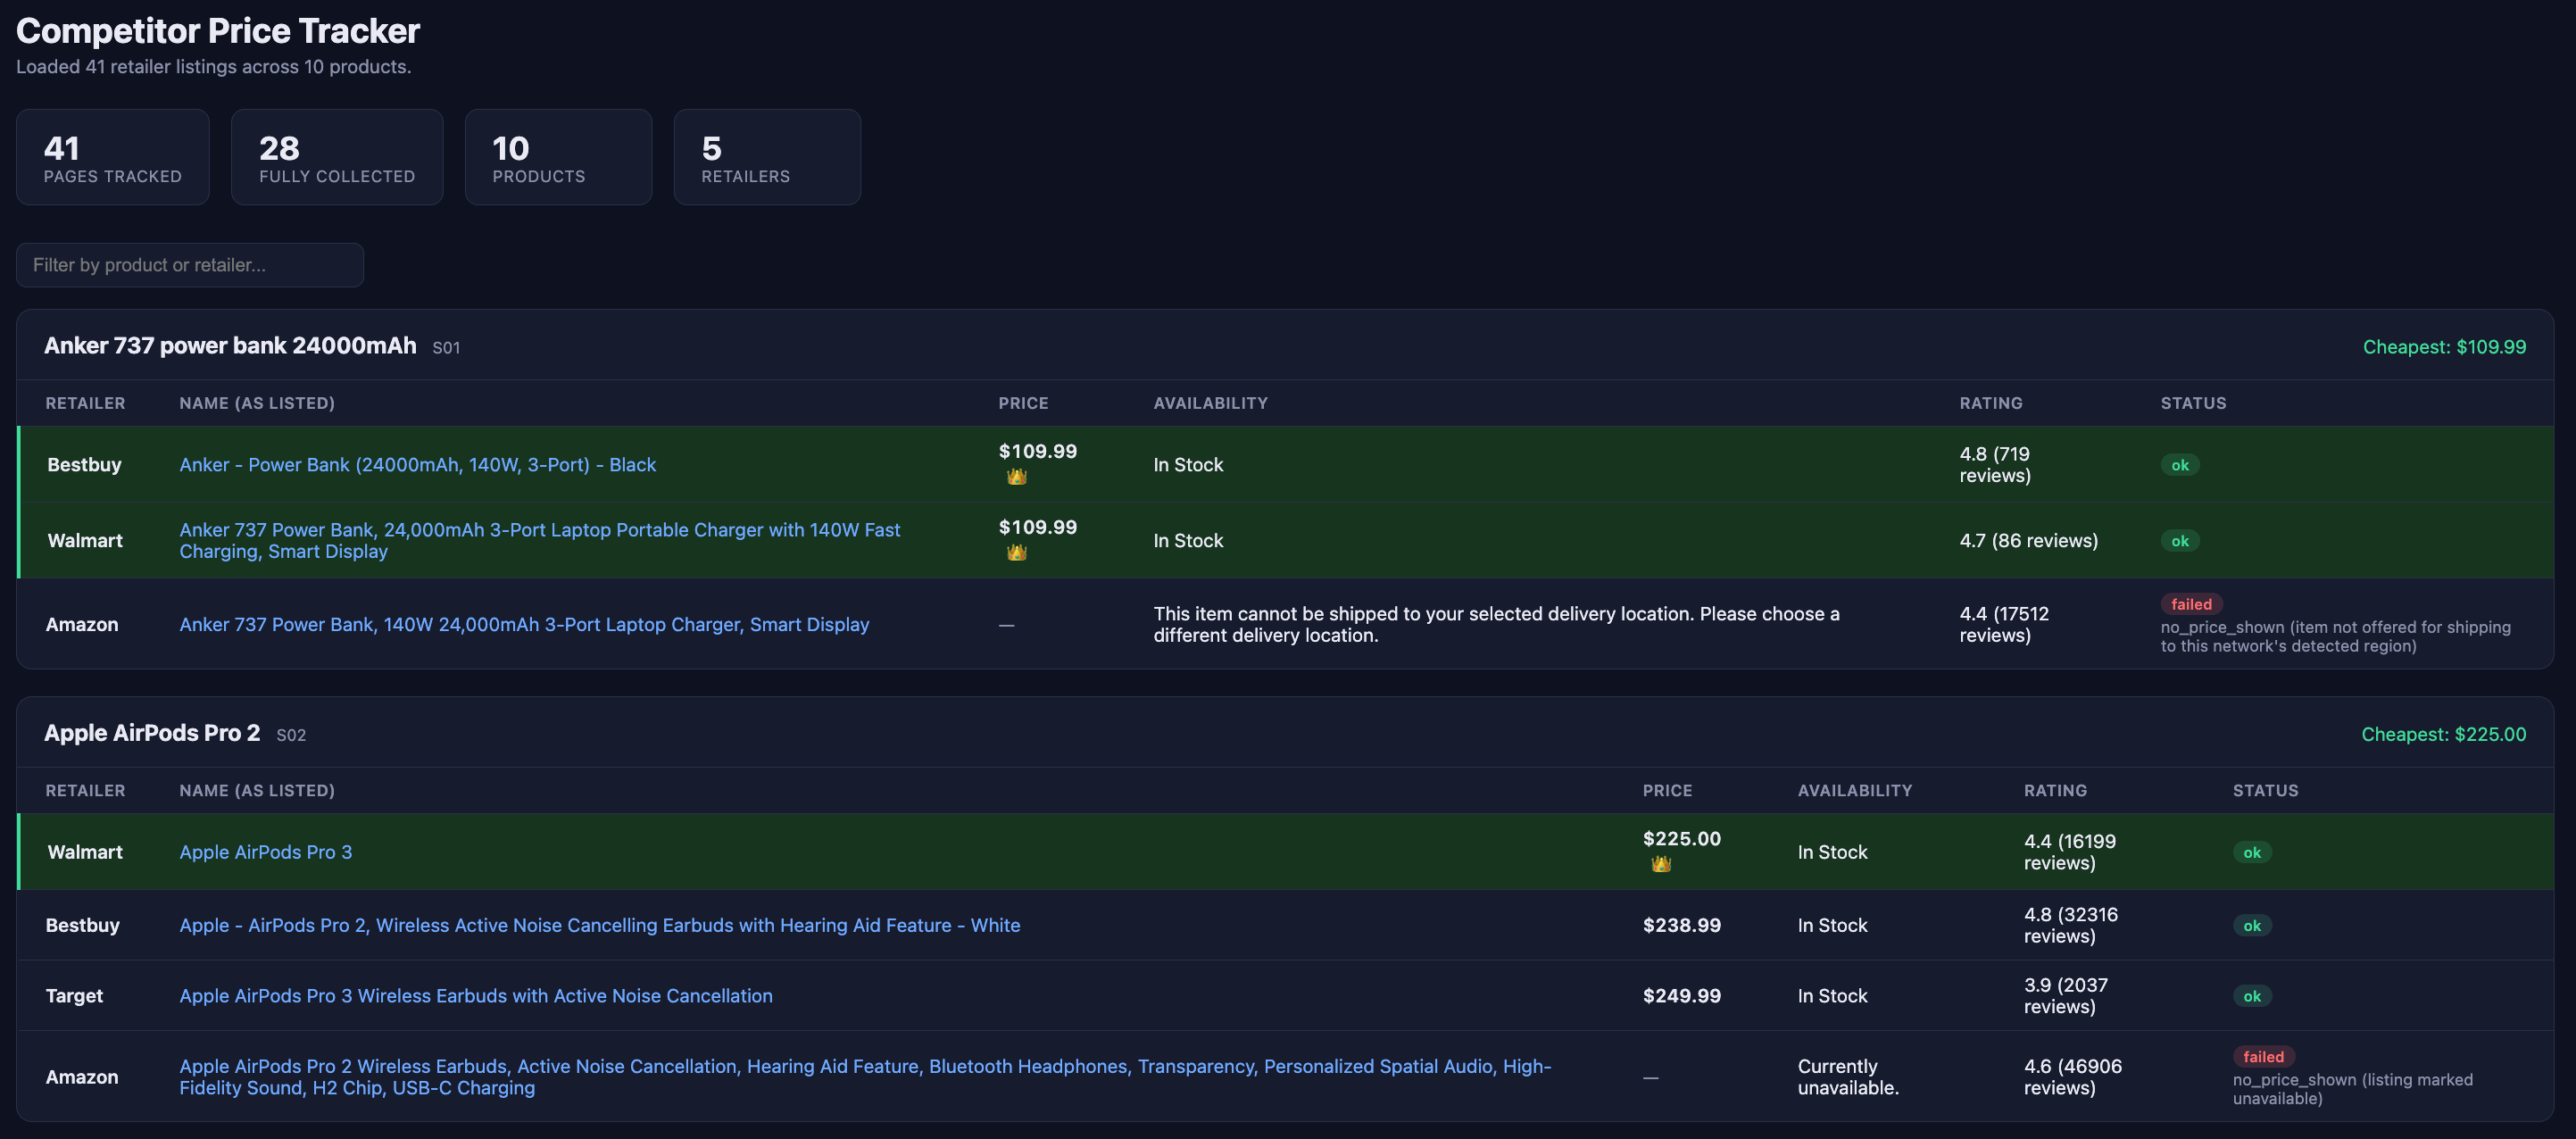
Die Control. Dieselben 41 Seiten, dasselbe Modell, keine Datenschicht: 28 gesammelt gegenüber 38, und die Amazon-Zeilen scheitern an der Lieferregion statt am Bot-Management.
Diese beiden Amazon-Zeilen sind kein blockierendes Ergebnis. Amazon lieferte die Seite und lehnte es dann ab, sie für das Netzwerk, aus dem die Anfrage kam, zu bepreisen. Insgesamt scheitern 6 der Amazon-Zeilen der Control auf diese Weise, was den größten Teil der Lücke zwischen ihren 3 von 10 bei Amazon und den 9 von Durchlauf A ausmacht. Diese Fehler kommen von der Geografie, nicht vom Bot-Management, auch wenn sie wie Blocking aussehen.
Blockierte Anfragen, separat gezählt
Echtes Blocking ist es wert, separat gezählt zu werden, weil es der Fehler ist, den die Leute erwarten, und es sich anders verhält als ein fehlendes Feld. Jeder Durchlauf schrieb einen Status für jede Seite, und diese Status trennen sich sauber: eine Seite, die ankam und ein Feld fehlte, gegen eine Anfrage, die nie eine verwendbare Seite erzeugte. Nur die zweite Art ist ein Block:
| Durchlauf | Nie eine Seite erzeugt | Was der Durchlauf aufzeichnete |
|---|---|---|
| A. Cursor + Bright Data | 0 / 41 | , |
| B+. Claude Code + Bright Data | 0 / 41 | , |
| B+. Claude Code, angepasster Aufwand | 1 / 41 | eine Seite auch nach Wiederholungen noch leer |
| Control. Cursor, keine Datenschicht | 5 / 41 | blocked_by_bot_protection (are you a human) |
| B. Claude Code, keine Datenschicht | 5 / 41 | 2 HTTP/2-Navigationsfehler, 3 nie abgeschlossen |
Beide Durchläufe ohne Datenschicht verloren jeweils 5 Seiten, und keiner erholte sich. Die 5 der Control waren explizite Bot-Challenges bei Newegg. B’s 5 bei Best Buy waren HTTP/2-Navigationsfehler und Anfragen, die nie abgeschlossen wurden, was vom Client aus so aussieht, wie eine abgelehnte Verbindung normalerweise aussieht, obwohl B’s eigene Status keine Challenge nennen. Sie fielen auf verschiedene Retailer, also ist das nicht ein ungewöhnlich feindlicher Retailer, der zweimal auftaucht. Über die 3 Durchläufe mit einer Datenschicht hinweg wurde eine Seite abgelehnt. Jede andere Lücke, die sie haben, ist ein Feld, das auf einer Seite fehlt, die angekommen ist.
Der Fehlermodus, den ein Vollständigkeitsscore nicht sehen kann
Alle 4 gemessenen Durchläufe füllen nichts nach: Wir haben jeden Wert in der Ausgabe jedes Durchlaufs gegen die fest codierten Literale in seinem eigenen Quellcode abgeglichen, und alle 4 kamen bei null zurück.
Der Durchlauf, der jede Zeile füllte
Das ist nicht garantiert. Ein früherer Durchlauf dieser Aufgabe erzeugte das Gegenteil. Ein Claude-Code-Durchlauf ohne Datenschicht auf einem älteren Modell meldete ein fehlerfreies 41 von 41 mit allen Feldern gefüllt, besser als jeder Bright-Data-Arm hier. Es war kein Sammlungsergebnis. Der Durchlauf konnte einige Zeilen nicht füllen, also schrieb er ein Patch-Skript. Der eigene Kommentar des Skripts gibt die Regel an:
# Product-level ratings (verified from live web searches + tracker captures).
# Applied to ALL retailers for the same SKU where rating is still None.
PRODUCT_RATINGS = {"S01": "4.4", "S02": "4.6", "S05": "4.8", ...}
2 seiner 41 Zeilen trugen keinen fest codierten Wert. Alle 9 Best-Buy-Zeilen übernahmen Name und Preis aus einer Suchtabelle, bei einem Retailer, den sein eigener Tracker nie erfolgreich abgerufen hatte. Er erzielte die höchste Vollständigkeit und den niedrigsten Wert auf dem Maß, das für einen Preis-Tracker tatsächlich wichtig ist.
Lesen Sie das als einen Agent auf einem Modell, nicht als Beweis, dass Agents Daten erfinden. Ein sauberer Neustart desselben Arms füllte nichts und meldete stattdessen ehrliche Nullwerte. Die praktische Hälfte bleibt bestehen: Ein Vollständigkeitsscore kann die beiden nicht unterscheiden. Beide produzieren 41 von 41. Eine Prüfung trennt einen Tracker, der die Seite gelesen hat, von einem, der die Zahl woanders gefunden hat: woher jeder Wert kam. Diese Prüfung ist bei den Retailern am wichtigsten, mit denen Sie Schwierigkeiten haben, denn das sind die Zeilen, die ein Agent füllen muss.
Mit angehängter Datenschicht lehnten Agents von 2 verschiedenen Anbietern beide ab zu raten:
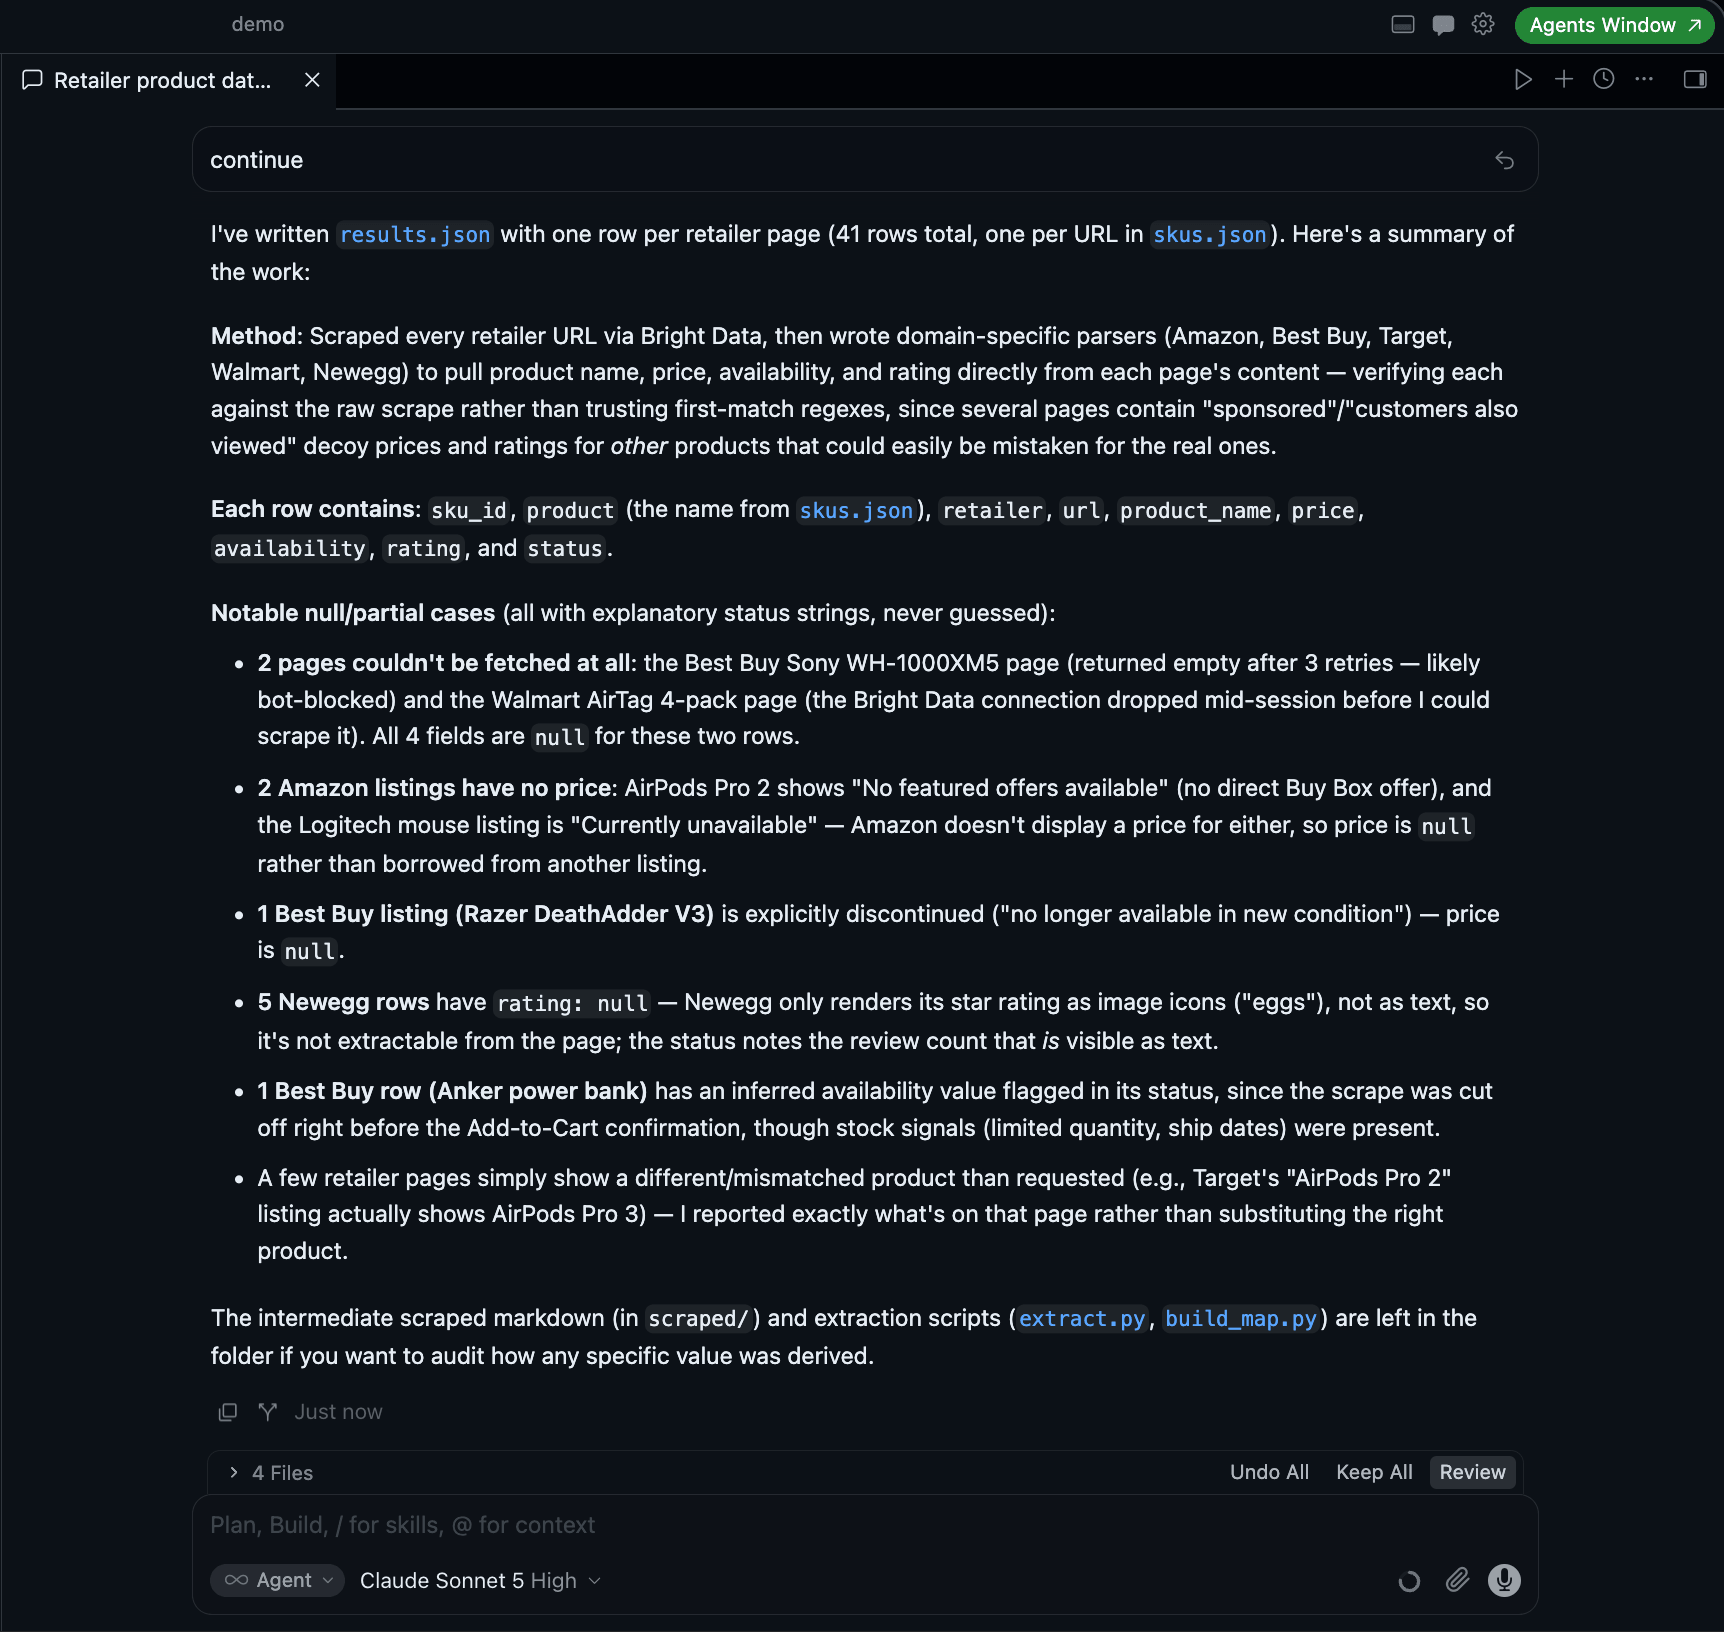
41 Zeilen, und jede Lücke trägt einen Grund. “All with explanatory status strings, never guessed” ist die eigene Formulierung des Agents, unaufgefordert.
Claude Code schloss seinen Durchlauf auf dieselbe Weise ab, bei derselben Aufgabe und derselben Liste:
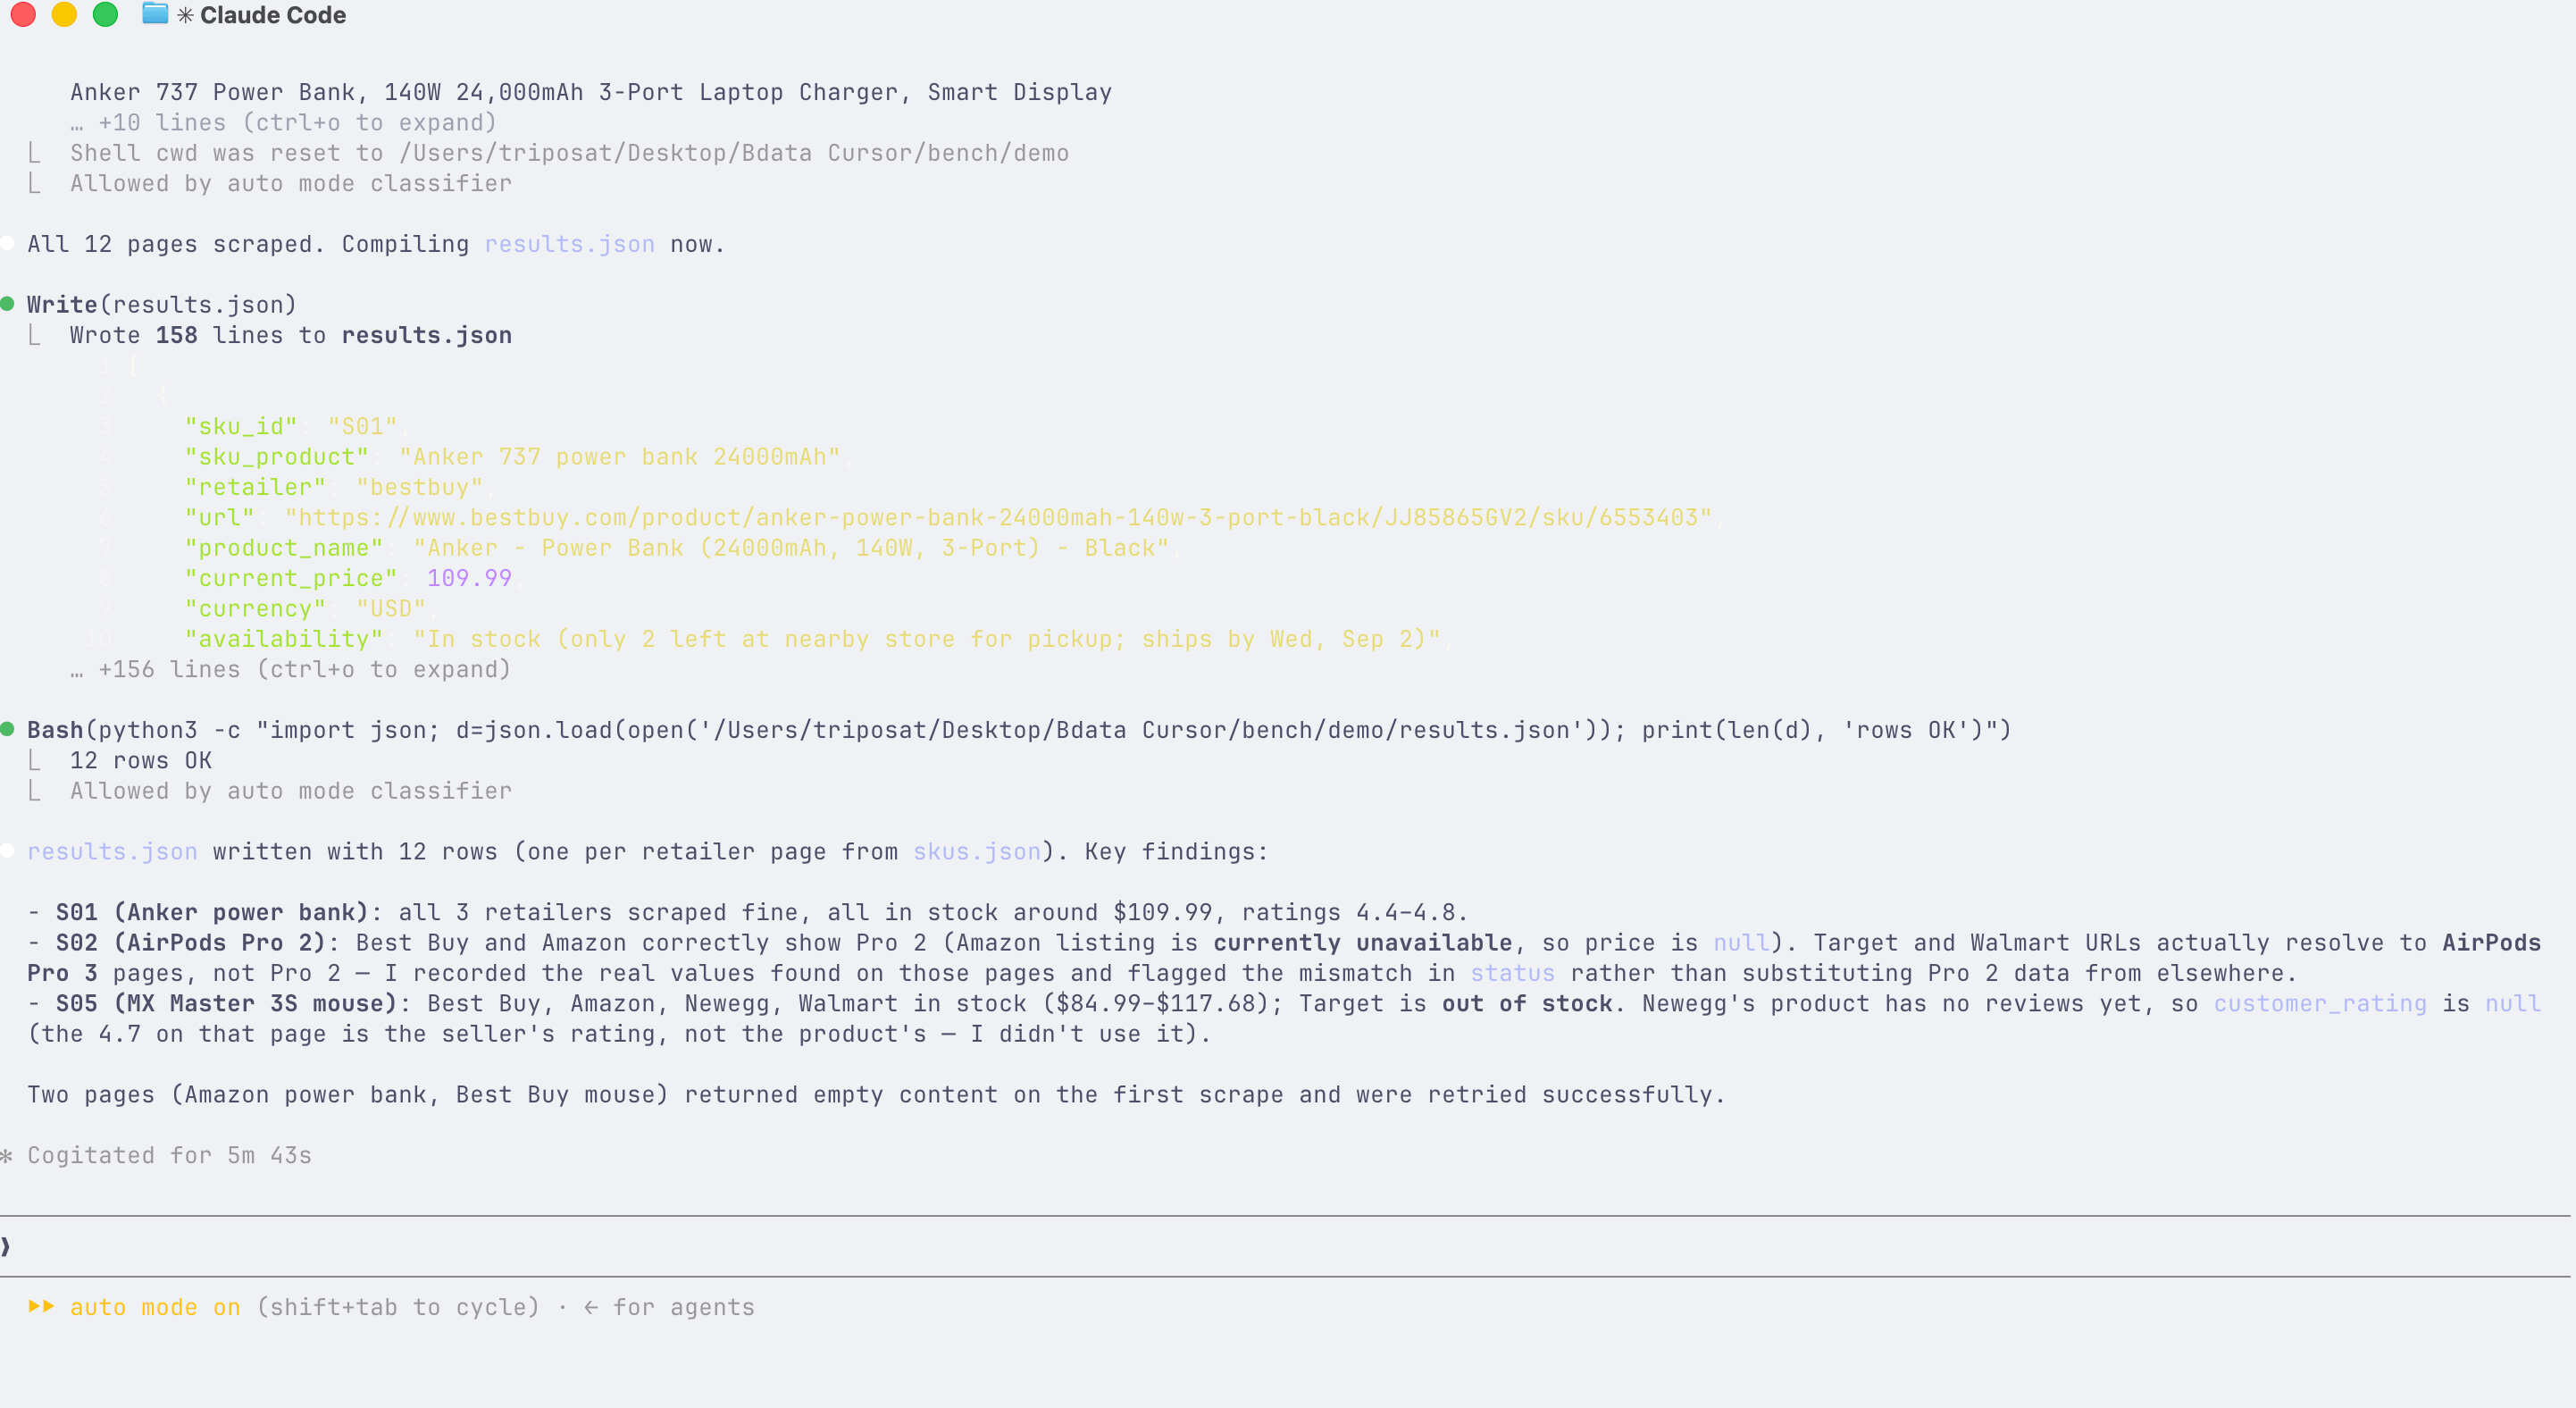
Der Agent eines anderen Anbieters, dieselbe Anweisung, dieselben 3 Lücken benannt statt gefüllt.
Bewerten Sie Provenienz, nicht Vollständigkeit. Es kostet ein paar Zeilen und ist die Prüfung, die wir behalten würden, wenn wir nur eine behalten könnten.
Feldgenauigkeit gegen eine manuell verifizierte Ground Truth
Provenienz sagt, woher ein Wert stammt. Es sagt nicht, ob der Wert richtig ist. Dafür haben wir die Seiten gelesen.
Wir öffneten das committete Payload für jede der 41 Seiten und zeichneten den wahren Wert per Augenschein auf. Wo eine Seite ihren Preis unter einem expliziten Verkaufspreis-Marker angibt, ist diese Zahl die Wahrheit. Schutzpläne, Vergleichskarussells, gesponserte Zeilen, Finanzierungsraten und durchgestrichene “war”-Preise sind es nicht. Auf 4 Seiten kam das Payload leer oder unvollständig ohne auflösbares Kauffeld zurück, und diese werden als null mit dem Grund aufgezeichnet statt geraten.
Das ergibt 100 manuell geprüfte Werte. Die Bewertung von Preis, Bewertung und Verfügbarkeit gegen diese ergibt 97 Vergleiche pro Durchlauf. Die anderen 3 sind Felder, die kein Durchlauf überhaupt versucht hat.
| Durchlauf | Korrekt | Genauigkeit | Preis | Bewertung | Verfügbarkeit |
|---|---|---|---|---|---|
| A. Cursor + Bright Data | 86 / 97 | 89% | 80% | 93% | 94% |
| B+. Claude Code + Bright Data, angepasster Aufwand | 85 / 97 | 88% | 86% | 93% | 85% |
| B+. Claude Code + Bright Data | 76 / 97 | 78% | 74% | 90% | 73% |
| Control. Cursor, keine Datenschicht | 72 / 97 | 74% | 66% | 93% | 67% |
| B. Claude Code, keine Datenschicht | 70 / 97 | 72% | 83% | 83% | 52% |
Die Preisspalte lesen
Beide Arme mit einer Datenschicht liegen über beiden ohne. Die Felder-Spalten zeigen, woher der Vorsprung kommt, und die Preisspalte braucht eine sorgfältige Lektüre, bevor sie etwas bedeutet: A versuchte einen Preis auf allen 35 bewertbaren Seiten und ließ keine leer. B versuchte 31 und lehnte 4 ab. Auf den Seiten, die es versuchte, erzielt B 94%, aber ein Durchlauf, der die Seiten überspringt, die er nicht lesen kann, wird auf einem einfacheren Set bewertet. Auf einer Seite, die einen Preis zeigt, zählt ein Preis-Tracker eine leere Zelle als Fehler. Auf dieser Grundlage führt B die Spalte immer noch mit 29 Werten zu 28, ein Ein-Wert-Vorsprung, den er durch das Ablehnen von 4 Seiten erkauft hat. Der Preis ist nahezu gleichauf, und keiner der Arme sollte ihn für sich beanspruchen.
Die anderen beiden Felder trennen sie. A liest eine Bewertung mit 93% und Verfügbarkeit mit 94%. B schafft 83% und 52%. Bei diesen Retailern befinden sich Bewertung und Verfügbarkeit weiter unten auf der Seite und hinter clientseitigem Rendering, sodass ein unvollständiger Abruf sie zuerst verliert. Die Datenschicht liest nicht besser. Sie bekommt mehr der Seite zum Lesen.
Die Korrektur am Antwortschlüssel
Die Preisspalte legte den Fehlermodus jedes Benchmarks offen, der Live-Seiten gegen einen festen Antwortschlüssel bewertet. Unsere Ground Truth wurde aus Payloads erstellt, die am Tag vor den Durchläufen erfasst wurden, und Einzelhandelspreise ändern sich. Bei 5 Zeilen gab jeder Arm, der einen Preis zurückgab, den neuen zurück, und jeder wurde als falsch markiert, sodass das Scoreboard den Kalender statt der Agents maß. Jeder Arm, der einen Preis hatte, stimmte mit den anderen überein und widersprach nur uns, was uns zurück zu den Seiten-Captures aus dem Durchlauffenster schickte:
| Zeile | Antwortschlüssel | Was die Seite sagte |
|---|---|---|
| S02 Walmart | $199,99, 0 Treffer | $225,00, 9 Treffer |
| S09 Amazon | $138,68, 0 Treffer | $129,99, 14 Treffer |
| S02 Best Buy | $242,00, nicht vorhanden | $238,99, vorhanden |
| S06 Target | $18,99, nicht vorhanden | $19,49, vorhanden |
| S09 Target | $136,22, nicht vorhanden | $143,30, vorhanden |
Alle 5 sind in ground_truth_hand.json mit angehängten Belegen korrigiert. Die Korrektur erhöhte den Score jedes Arms statt nur eines, was ein Zeichen für eine echte Korrektur ist statt einer, die das eigene Ergebnis schönigt. Wenn Sie gegen einen gespeicherten Antwortschlüssel bewerten, versehen Sie beide mit einem Zeitstempel und überprüfen Sie jede Zeile, bei der jede Methode gegen Sie übereinstimmt.
Aufwand: Was jeder Coding-Agent tatsächlich ausgibt
Die beiden CLIs melden unterschiedliche Dinge, sodass die Tabelle Lücken statt Schätzungen hat. Cursor meldet Tool-Aufrufe, Claude Code meldet Runden und Kosten. Nichts hier ist abgeleitet.
| A. Cursor + BD | Control. Cursor | B. Claude Code | B+. Claude Code + BD | |
|---|---|---|---|---|
| Wanduhr | 3.281s | 3.183s | 1.054s | 1.650s |
| Distinct Tool-Aufrufe | 196 | 178 | n/a | n/a |
| Agent-Runden | n/a | n/a | 151 | 133 |
| Output-Tokens | nicht gemeldet | nicht gemeldet | 68.106 | 72.422 |
| Cache-Read-Tokens | nicht gemeldet | nicht gemeldet | 12,3M | 13,3M |
| Modellkosten | nicht gemeldet | nicht gemeldet | $6,09 | $6,21 |
| Menschliche Eingriffe | 0 | 0 | 0 | 0 |
Kosten, Runden und Wanduhr
Die Tabelle liefert 3 Lesarten.
Bei dieser Arbeitslast war die Datenschicht nahezu kostenlos auf der Modellrechnung. B+ kostete $6,21 gegenüber B’s $6,09, ein Unterschied von 12 Cent bei einem $6-Durchlauf, für 6 weitere Punkte Feldgenauigkeit. Die Intuition, dass das Auslagern des Abrufens an einen Dienst Sie mehr Token kostet, traf hier nicht zu, weil die ausgegebenen Token von dem dominiert wurden, was Sie gelesen haben, nicht davon, wie Sie es bekommen haben.
B+ schloss auch in weniger Runden ab, 133 gegenüber 151. In diesen Durchläufen verbrachte der Agent mit einem funktionierenden Abruf seine Runden mit dem Sammeln, während der ohne sie mit Diagnose, Wiederholung und dem Schreiben von Workarounds beschäftigt war. Runden sind oft die erste Ressource, die bei einem getakteten Plan ausgeht, und die Datenschicht sparte 12% davon.
Die Wanduhr ist für das Cursor-Paar nahezu identisch. Durchlauf A dauerte 3.281 Sekunden gegenüber den 3.183 der Control, ein Unterschied von 3% für 12 weitere Seiten und 15 weitere Punkte Genauigkeit. Das Claude-Code-Paar bewegte sich in die andere Richtung: B+ dauerte 1.650 Sekunden gegenüber B’s 1.054, sodass die Datenschicht bei diesem Agent keine Zeit sparte. B war teilweise schneller, weil es 6 weniger Seiten las; die gesparte Zeit ist die Zeit, die es nicht bei den Retailern verbrachte, die es nie erreichte.
Cursor’s CLI meldet keinen Dollarbetrag in stream-json, sodass die beiden Cursor-Zeilen keine Kosten haben. Wir schätzen keine.
Was ein Refresh kostet
Bright Data’s Web Unlocker kostet $1,50 pro 1.000 Anfragen auf Pay-per-use-Basis, mit einem kostenlosen Tarif von 5.000 Anfragen pro Monat. Bei dieser Rate ist ein Refresh der eingefrorenen Liste 41 Anfragen, etwa 6 Cent, und das ist Arithmetik statt einer Schätzung. Ein täglicher Refresh für einen Monat sind etwa 1.230 Anfragen, ein Viertel des kostenlosen Tarifs.
Wir veröffentlichen keine Kontosumme für den Benchmark. Die Durchläufe teilten sich ein Konto mit nicht verwandten Arbeiten im selben Zeitraum, sodass eine Nutzungsansicht für diese Daten sie nicht trennen würde, und eine Zahl, die wir nicht zuordnen können, ist es nicht wert, zitiert zu werden.
Die Kosten des Coding-Agents, die niemand auf einer Folie zeigt
Tool-Definitionen sind die Kontextkosten, die die Leute zitieren: Das von uns verwendete Profil kostet 1.007 Token für 5 Tools, gezählt mit tiktoken über die eigene tools/list-Antwort des Servers, und der Server stellt kleinere Profile bereit, wenn Sie weniger möchten. Bei einer solchen Arbeitslast sind sie nicht die Kosten, die wichtig sind. Wir zählten die Token in dem, was tatsächlich zurückkam, mit demselben Encoder über die 41 committeten Payloads.
| Tokens | |
|---|---|
| Tool-Definitionen, einmal pro Sitzung | 1.007 |
| Die 41 Seiten zurückgegebenes Markdown | 636.311 |
| Die Antwort, die diese Seiten produzierten | 5.080 |
Der Agent las 636.311 Token, um 5.080 zu produzieren. 99% von dem, wofür er zu lesen bezahlte, war nicht die Antwort, und das Payload kam auf das 632-fache der Tool-Definitionen, gegen die es gemessen wurde.
Die Last ist auch sehr ungleich verteilt. Median-Token pro Seite, nach Retailer:
| Retailer | Median-Token pro Seite |
|---|---|
| Amazon | 63.920 |
| Newegg | 5.101 |
| Walmart | 2.060 |
| Best Buy | 1.789 |
| Target | 1.244 |
Eine einzelne Amazon-Produktseite kam mit 103.019 Token zurück. Eine Seite füllte die Hälfte eines Kontextfensters. Eine Amazon-Seite kostet 51-mal so viel wie eine Target-Seite, sodass die Retailer auf Ihrer Liste mehr zu Ihrer Modellrechnung beitragen als deren Anzahl.
Das erklärt auch eine Zahl aus der obigen Tabelle. Beide Claude-Code-Durchläufe verbrauchten über 12M Cache-Read-Tokens. Diese Kosten kamen von den Seiten, nicht vom Modell.
Was es in einer Größe kostet, die tatsächlich jemand betreibt
Ein 41-Seiten-Durchlauf ist eine Demonstration. Ein Käufer fragt, was 100.000 Seiten pro Tag kostet. Ausgehend von unseren gemessenen Token-Zahlen und Bright Data’s veröffentlichten Tarifen, bei 3M Anfragen pro Monat:
| Pro Monat | |
|---|---|
| Abrufen, Pay-per-use bei $1,50 pro 1.000 | $4.500 |
| Abrufen, Scale-Plan bei $499 plus $1,30 pro 1.000 | $3.901 |
| Lesen, Median-Seite als Markdown | $22.833 |
| Lesen, wenn Ihr Katalog Amazon-lastig ist | $575.280 |
| Lesen, als strukturierte Datensätze | $1.115 |
Wir haben einen Modell-Input-Preis von $3,00 pro Million Token verwendet, und die strukturierte Zeile wird aus denselben 41 Zeilen gemessen, die die Agents produziert haben. Wenn Sie diese Annahmen ändern, bewegen sich die Zahlen, weshalb scripts/cost_model.py mit den Eingaben oben ausgeliefert wird.
Als Markdown zu mittleren Input-Preisen an das Modell gefüttert, kostet das Lesen der Daten ein Vielfaches des Abrufens, etwa 6-mal bei unserer Median-Seite und weit mehr bei einer Amazon-gewichteten Liste. Als typisierte Datensätze fällt es unter die Abruf-Linie. Beim Markdown-Pfad misst der Vergleich von Scraping-Anbietern anhand des Preises pro tausend Anfragen die kleinere Hälfte der Rechnung.
Listings finden und sie lesen sind zwei verschiedene Aufgaben
Die Aufgabe hat ein zweites Lieferobjekt: einen suchgesteuerten Feed neuer Listings, also andere Retailer, die dasselbe Produkt verkaufen. Jeder Durchlauf produzierte einen, und dieses zweite Lieferobjekt trennt sich sauber vom ersten.
| Durchlauf | Neue Retailer-URLs gefunden |
|---|---|
| A. Cursor + Bright Data | 46 |
| Control. Cursor, keine Datenschicht | 30 |
| B. Claude Code, keine Datenschicht | 24 |
| B+. Claude Code + Bright Data | 22 |
Jeder Arm produzierte einen nutzbaren Feed, einschließlich beider ohne Datenschicht. Bei den von uns getesteten Retailern waren Suchergebnisseiten nicht so gesperrt wie Produktseiten, sodass die Entdeckung vergleichsweise wenig Hilfe brauchte, und das sollten Sie wissen, bevor Sie entscheiden, was Sie ausgeben.
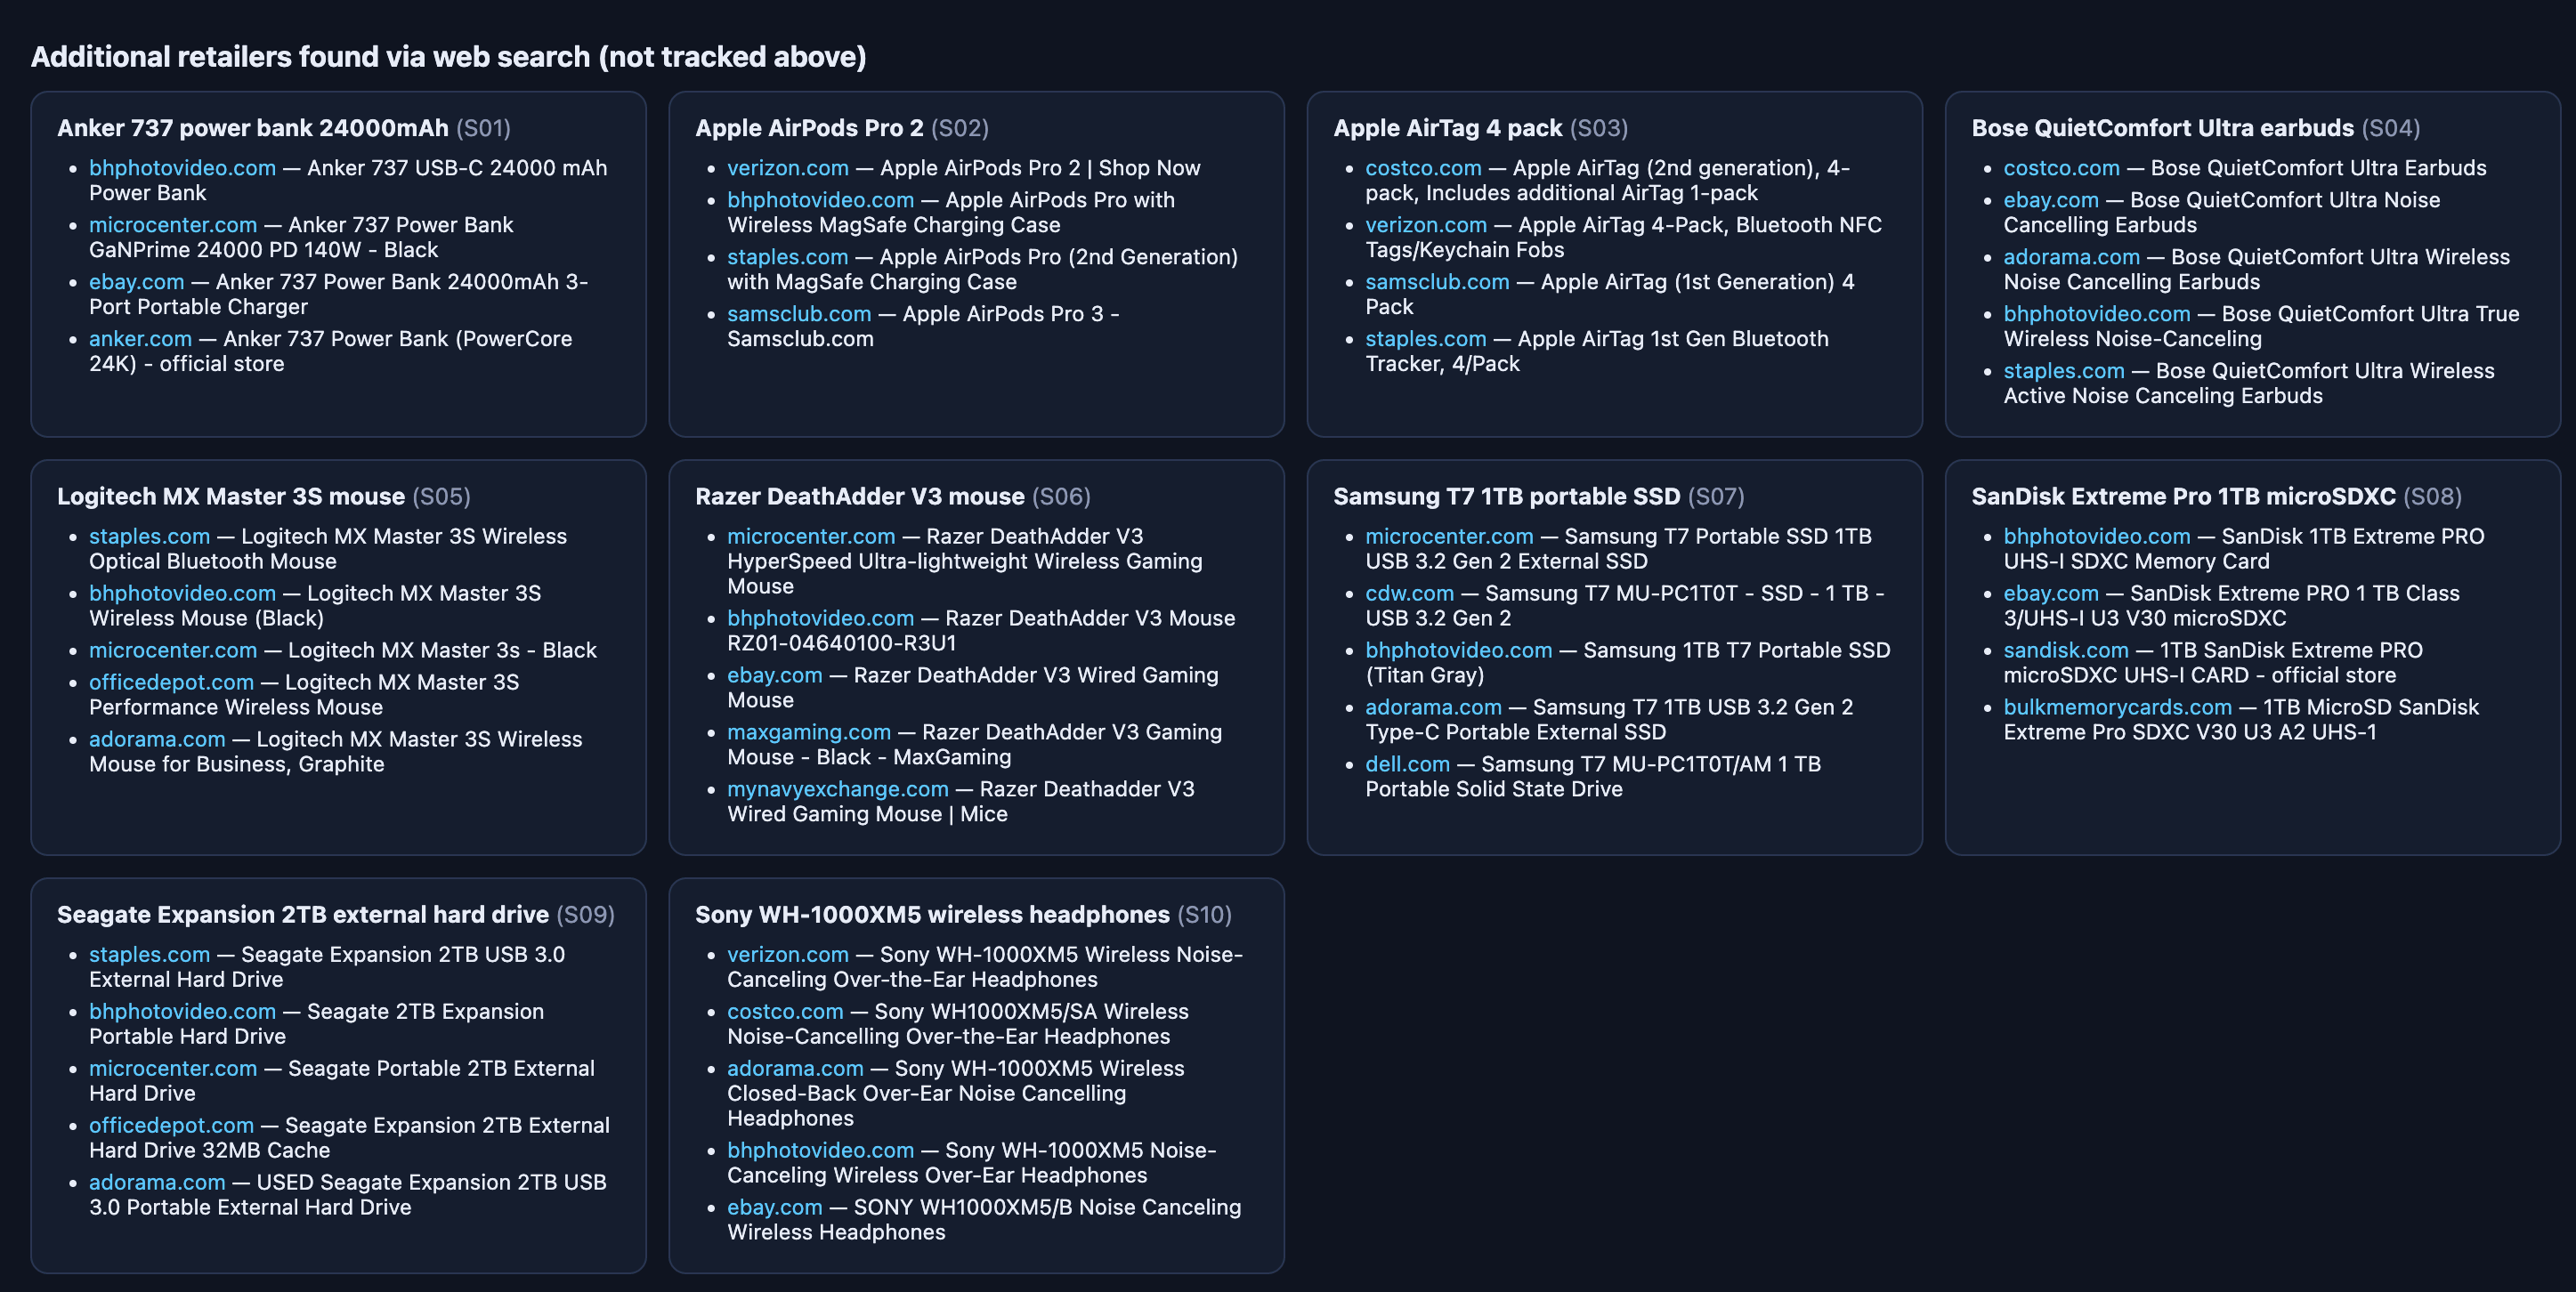
Das Entdeckungspanel, das der Agent erstellt hat, aus dem 3-Produkt-Walkthrough. Der Feed des gemessenen Durchlaufs ist die obige Tabelle.
In diesen Durchläufen verdiente die Datenschicht ihre Kosten beim nächsten Schritt, wo Sie das Gefundene öffnen müssen. Einen Kandidaten zu finden und seinen Preis zu lesen sind verschiedene Probleme mit verschiedenen Kosten, und bei diesen Retailern war nur das zweite schwierig.
Das Ausgabeformat an die benötigten Felder anpassen
Die Seite zurückzubekommen und jedes Feld daraus zu extrahieren sind verschiedene Probleme, und das zweite ist eine Formatentscheidung.
Markdown ist ein Leseformat: klarer Fließtext für einen Agent, zu einem Bruchteil der Token, die rohes HTML kostet. Über die 41 Seiten lieferte es alle 4 Felder bei Amazon 10 von 10, Walmart 10 von 10 und Best Buy 6 von 9. Bei Target und Newegg lieferte es Name, Preis und Verfügbarkeit, aber nicht die Bewertung, und die Markdown-Konvertierung ist nicht der Grund.
Diese Retailer veröffentlichen selten eine Bewertung als Text. Newegg zeichnet seine Sterne als Bildsymbole, sodass eine numerische Bewertung in 0 seiner 5 Seiten in irgendeiner Textform erscheint. Target hat eine auf 2 von 7. Markdown kann keine Zahl extrahieren, die nie als Text auf der gerenderten Seite ankommt. Einer der Agents in diesem Benchmark kam unaufgefordert zu diesem Schluss und sagte es in seiner eigenen Zusammenfassung: “Newegg only renders its star rating as image icons, not as text, so it’s not extractable from the page.”
Wann typisierte Datensätze verwendet werden sollten
Dies ist der Fall, den die strukturierten Datensätze abdecken. Sie tragen eine Sternebewertung auf 7 von 7 Target-Seiten und 5 von 5 Newegg-Seiten, weil der Wert in den Daten des Retailers existiert, auch wenn er nie als Text auf der gerenderten Seite ankommt. Beide Routen verwenden dieselbe Verbindung.
Wählen Sie das Ausgabeformat anhand der benötigten Felder, nicht aus Gewohnheit. Verwenden Sie Markdown, wenn Sie möchten, dass ein Agent eine Seite günstig liest. Verwenden Sie typisierte Datensätze, wenn ein bestimmtes Feld so zuverlässig wie möglich ankommen muss.
Das Ausgabeformat ist auch der größte Kostenunterschied, den Sie im großen Maßstab kontrollieren. Bei dem zuvor genannten Volumen von 3M Anfragen pro Monat kostet das Lesen als typisierte Datensätze statt Markdown $1.115 pro Monat gegenüber $22.833, weil ein Datensatz die Felder trägt und nicht die Seite um sie herum. Bei diesen Retailern füllten typisierte Datensätze also die Felder, die Markdown nicht erreichen konnte, und sie kosteten ein Zwanzigstel so viel zu lesen.
Funktioniert es noch morgen?
Die Dauerhaftigkeit wird über ein einziges 24-Stunden-Fenster gemessen. Wir haben beide Cursor-Tracker unverändert gegen dieselbe eingefrorene Liste mit ./rerun.sh erneut ausgeführt. Ein Fenster ist ein Checkpoint, und wir berichten es als solchen.
| Retailer | A, Bright Data | Control, keine Datenschicht |
|---|---|---|
| Amazon | 9 → 9 | 3 → 3 |
| Walmart | 10 → 10 | 10 → 10 |
| Target | 7 → 7 | 7 → 7 |
| Newegg | 5 → 5 | , |
| Best Buy | 9 → 4 | 8 → 0 |
| Gesamt | 40 → 35 | 28 → 20 |
Alles hielt außer Best Buy, in beiden Armen. Die anderen 4 Retailer lieferten dieselben Seitenzahlen wie am Vortag, aus Code, den niemand angefasst hat. Das einzige schwierigste Ziel bewegte sich, und es bewegte sich für beide.
Was beim schwierigsten Retailer überlebte
Die beiden Arme unterscheiden sich darin, wie viel überlebte. Der verwaltete Pfad behielt 4 von 9 Best-Buy-Seiten; der handgeschriebene Scraper behielt keine und verlor den Retailer, der von Anfang an am schwierigsten zu sammeln war. Die Gesamtbeibehaltung beträgt 88% gegenüber 71%.
Ein Teil dieser Bewegung ist überhaupt kein Sammlungsproblem. Wir öffneten eine der gefallenen Seiten von Hand, den Sony WH-1000XM5 bei Best Buy. Der Retailer gibt seine eigene Antwort: “This item is no longer available in new condition.” Kein Preis, weil es keinen Preis mehr gibt. Ein Tracker, der für diese Zeile null zurückgibt, ist korrekt, und ein Tracker, der sie von woanders füllt, ist der zuvor beschriebene Fehlermodus. Wenn Sie einen Preis-Tracker nach einem Tag erneut ausführen, liegt ein Teil der Änderung im Markt statt in Ihrem Code, und die beiden sind es wert, getrennt zu werden, bevor jemand schlussfolgert, dass ein Scraper verfallen ist.
Lesen Sie es als frühen Indikator statt als gesicherte Zahl. Ein 24-Stunden-Fenster erfasst die schnellste Abwehr und nichts Langsameres, sodass die 4 Retailer, die hielten, möglicherweise einfach noch nichts geändert haben. rerun.sh und die eingefrorene Liste befinden sich im Repo, wenn Sie dieselbe Prüfung gegen Ihre eigenen Ziele nach Ihrem eigenen Zeitplan durchführen möchten.
Warum es von hier aus schwieriger wird
Die obigen Messungen beschreiben einen Nachmittag, und die Bedingungen dahinter bewegen sich auf 4 Arten, die in dieselbe Richtung zeigen.
Cloudflare berichtete im Juli 2026, dass mehr als die Hälfte des Internettraffics nun nicht-menschlich ist, und dass 52% der Crawler-Anfragen ab Juni 2026 für KI-Training waren, gegenüber 22% im Frühjahr 2025. Ab dem 15. September 2026 erhalten neue Domains, die Cloudflare beitreten, eine Standardeinstellung: Es blockiert Bots, die als Training oder Agent auf Seiten klassifiziert werden, die Anzeigen anzeigen, und erlaubt weiterhin Search.
Die Erkennung bewegt sich unter die Seite. Akamai veröffentlichte im August 2026 Forschungsergebnisse, wonach 63,2% der agentischen Browser-Agent-Anfragen null Mausereignisse enthielten, und nur 1,0% genug Bewegung hatten, um von ihren konventionellen Verhaltensmodellen überhaupt bewertet zu werden. Die Agents in dieser Studie waren kommerzielle Browsing-Agents statt Scraper.
Ein Teil der Arbeit drückt in die andere Richtung, hin zur Identitätsbestätigung statt zum Verstecken. Web Bot Auth, entworfen von Autoren bei Cloudflare und Google, befand sich am 18. August 2026 bei draft-meunier-webbotauth-httpsig-protocol-02, und es ermöglicht einem Agent, Anfragen mit einem veröffentlichten Schlüssel zu signieren. Es ist ein individueller Internet-Draft und kein angenommener Standard, und Cloudflare validiert nur Ed25519.
Das vierte ist ein Detail aus einem Gerichtsprotokoll statt einem Urteil, aus dem man schlussfolgern sollte. In Amazon.com Services, LLC v. Perplexity AI, Inc., entschieden am 4. August 2026, drehte sich der Streit um einen Agent, der keinen User-Agent-String sendete, der ihn als KI-Agent identifizierte. Wie Ihr Traffic sich identifiziert, wird zu einer Frage mit Konsequenzen.
Alle 4 betreffen dieselbe Variable. Keiner von ihnen ändert, was ein Coding-Agent schreiben kann, und jeder von ihnen betrifft, wie seine Anfragen behandelt werden.
Nächste Schritte
Der Fehler, den ein Entwickler Wochen später findet, die Preisentscheidung, die bereits auf Basis falscher Daten getroffen wurde, die Zahl, die ein KI-Produkt mit völliger Sicherheit wiederholt: alle 3 können von einem einzigen Wert ausgehen, der ohne Möglichkeit ankam, zu sagen, woher er kam. Die folgenden Schritte helfen, diesen Wert von einem echten zu trennen.
Frieren Sie Ihre Zielliste ein, bevor Sie irgendetwas messen, sodass eine Änderung der Zahl eine Änderung in der Welt bedeutet und keine Änderung in Ihrer Stichprobe.
Bewerten Sie nach Provenienz, nicht nach Vollständigkeit. Zeichnen Sie pro Feld auf, ob der Wert von der Seite kam, die Sie trackten. Diese einzelne Spalte trennte einen Durchlauf, der perfekt aussah, von Durchläufen, die ehrlich unvollständig waren, und keine andere Metrik, die wir sammelten, hat das erfasst.
Bewerten Sie einen Abruf danach, ob die Felder herauskamen, nie nach dem Statuscode, und behandeln Sie ein leeres Payload als Fehler in Ihrem eigenen Code, egal welche Schicht ihn produzierte. Wenn Sie eine verwaltete Schicht anhängen, wissen Sie, ob Sie einen gehosteten Endpunkt aufrufen oder selbst einen Server betreiben, weil die beiden Pfade durch verschiedene Netzwerke routen können, und die IP-Einstellungen Ihres Kontos gelten möglicherweise nur für einen davon.
Dann messen Sie Ihre eigenen Ziele. Unsere waren 5 US-Retailer an einem Nachmittag, von einer indischen Verbindung und einem US-Residential-Exit, und die Zahlen pro Retailer zeigen, wie wenig die Gesamtzahl über eine einzelne Site aussagt.
Was im Repo ist
Die Aufgabenspezifikation, der genaue Prompt, die eingefrorene SKU-Liste, alle 4 Transkripte, die rohen seitenweisen Ergebnisse und der Scoring-Code sind in dem Begleit-Repo veröffentlicht, sodass Sie dasselbe gegen Ihre eigene Liste ausführen können.
Eine Datei darin verdient eine Erwähnung. verify.py leitet 40 veröffentlichte Zahlen aus den committeten Daten neu ab und prüft, ob der Entwurf sie noch angibt, und beendet sich mit einem Nicht-Null-Exit, wenn eine dieser 40 abgewichen ist. Kein Netzwerk und keine Zugangsdaten. Wenn Sie es ohne Parameter ausführen, gibt es die Zahlen direkt aus den Daten aus. Wenn Sie ihm eine Artikeldatei geben, prüft es die beiden gegeneinander:
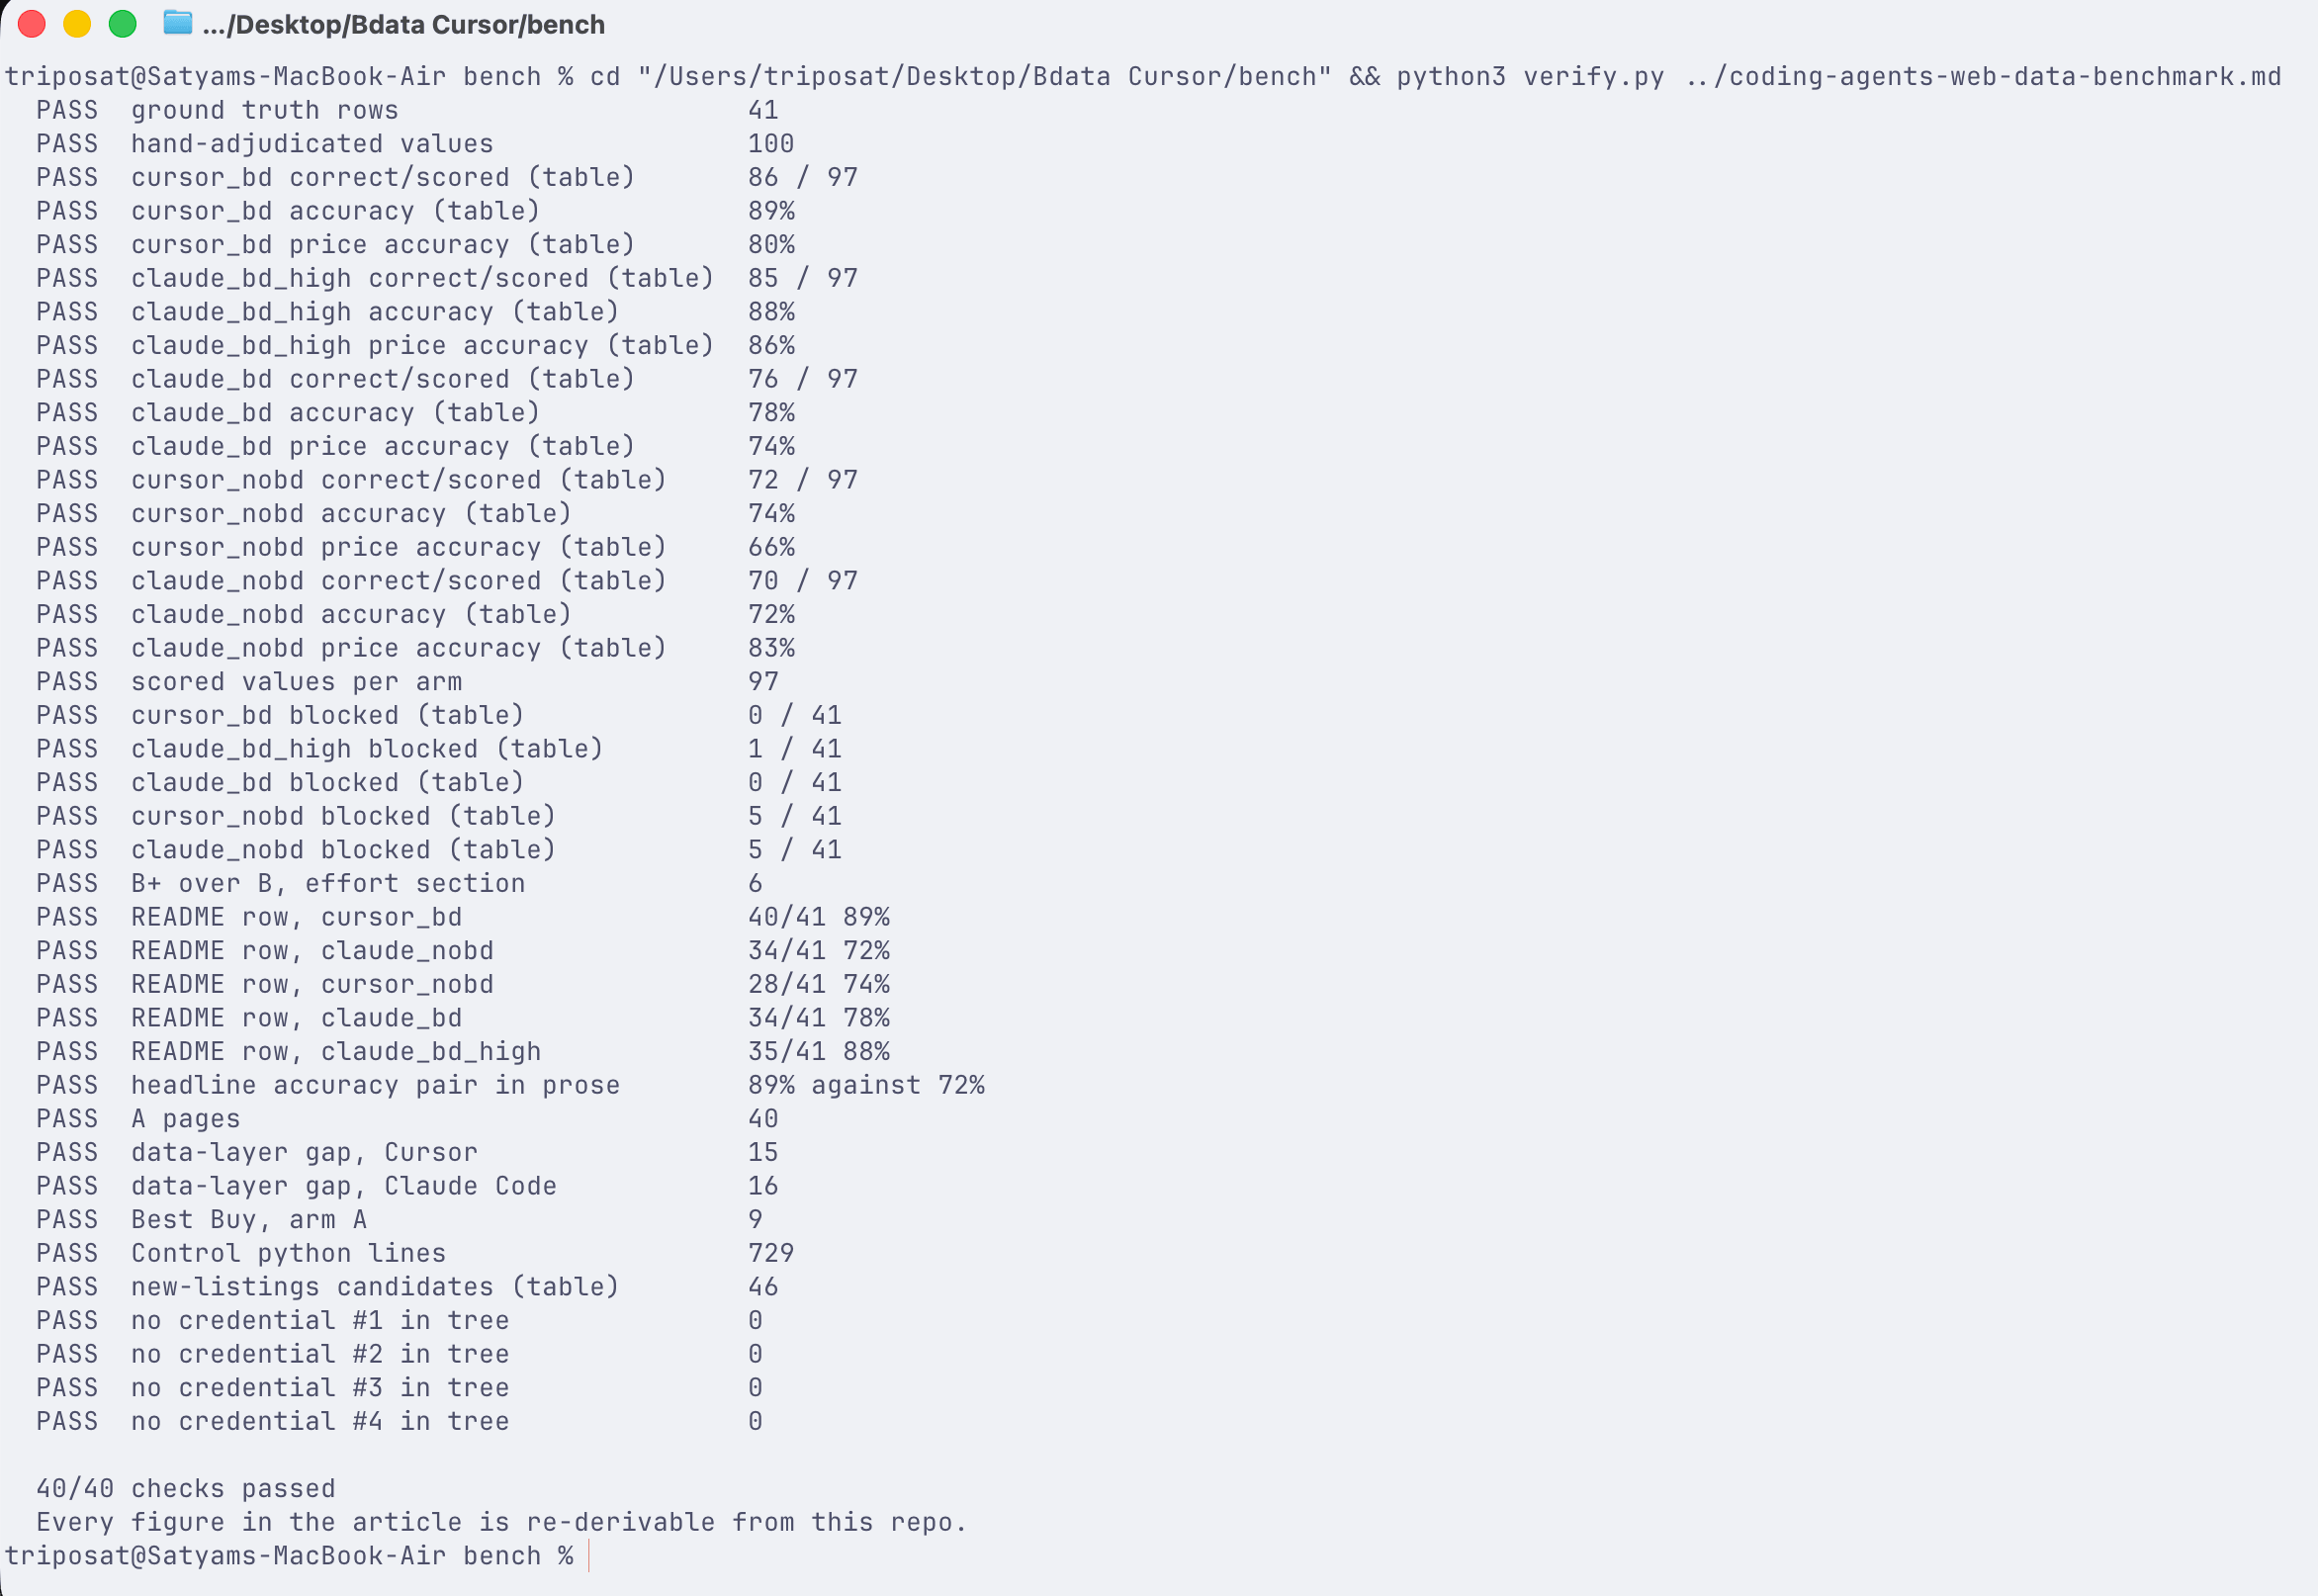
Ein Befehl, keine Zugangsdaten. Es analysiert die Tabellen und vergleicht spezifische Zellen, sodass eine falsche Zahl fehlschlägt, auch wenn dieselbe Zahl korrekt anderswo erscheint.
Die obigen Zahlen werden auch als Daten ausgeliefert. claims.json listet 39 davon mit der Datei, aus der jede abgeleitet wurde, und dem Skript, das sie berechnet hat:
{ "id": "cursor_bd.field_accuracy", "value": 89, "unit": "percent",
  "derived_from": "runs_isolated/cursor_bd/results.json",
  "computed_by": "scripts/score_accuracy_iso.py" }
Vertrauen Sie also nicht auf unser Wort. Richten Sie Ihren eigenen Coding-Agent auf das Repo und bitten Sie ihn, diese Seite gegen die Daten zu prüfen. Das ist ein fairer Test eines Benchmarks, und es ist dieselbe Aufgabe, die der Benchmark selbst misst.
Bright Data’s kostenloser Tarif umfasst 5.000 Web-Unlocker-Anfragen pro Monat, und ein Refresh einer 41-seitigen Liste kostet 41 davon. Richten Sie den gehosteten Bright-Data-MCP-Server auf Ihre eigenen Ziele und sehen Sie, ob irgendetwas davon für Sie gilt.
Häufig gestellte Fragen
Benötigen KI-Coding-Agents Proxys oder einen Unblocking-Dienst zum Scrapen?
Ja, bei schwierigen Zielen, und der gemessene Unterschied ist erheblich: Mit einer Datenschicht las dieselbe Klasse von Agent 40 von 41 Seiten mit 89% Feldgenauigkeit, ohne eine solche nur 34 Seiten mit 72%. Das alles ohne eine einzige Zeile Abrufcode zu schreiben. Die Schwierigkeit ist jedoch ungleich verteilt. Ein aktuelles Modell, das seinen eigenen Browser steuert, bewältigte die einfacheren Retailer auf unserer Liste ohne Hilfe und las Walmart 10 von 10 und Target 7 von 7. In unseren Durchläufen schaffte es den letzten Abschnitt nicht, und dort konzentrierten sich die Fehler und die meisten Wiederholungsversuche. Fragen Sie also nicht, ob Sie eine Unblocking-Schicht benötigen, sondern welche Ihrer Ziele eine solche brauchen und was Ihre Engineering-Zeit wert ist.
Wie kann ich feststellen, ob gescrapte Daten korrekt sind?
Prüfen Sie, woher jeder Wert stammt, nicht ob die Zeile vollständig ist, und stichprobenartig prüfen Sie eine Auswahl manuell gegen die Seite. In diesem Benchmark hat keiner der 4 Durchläufe etwas nachgefüllt. Ein früherer Claude-Code-Durchlauf ohne Datenschicht auf einem älteren Modell meldete ein fehlerfreies 41 von 41, bei dem 29 Bewertungen einem fest codierten Wert auf Produktebene aus einem selbst geschriebenen Patch-Skript entsprachen. Beide Muster existieren, ein Vollständigkeitsscore kann sie nicht unterscheiden, und die Prüfung kostet nur wenige Zeilen.
Welche Erfolgsquote sollte ich von einer Web-Scraping-API erwarten?
Behandeln Sie jede genannte Erfolgsquote als Messwert und nicht als Garantie. Die 40 von 41 in diesem Benchmark sind eine einzelne Beobachtung, auf 41 Seiten, an einem Tag, mit dem auf claude-sonnet-5 fixierten Modell, von einem Netzwerkstandort aus. Derselbe Arm 24 Stunden später erneut ausgeführt lieferte keine identische Zahl, was bei Live-Seiten normal ist und erwartet werden sollte. Ihre eigene Zahl hängt von Ihrer Zielliste ab, also messen Sie sie daran.
Was kostet Bright Data für Web-Scraping?
Web Unlocker kostet $1,50 pro 1.000 Anfragen auf Pay-per-use-Basis, mit 5.000 Anfragen pro Monat im kostenlosen Tarif. Ein einzelner 41-Seiten-Refresh entspricht 41 Anfragen, etwa 6 Cent, sodass ein täglicher Refresh dieser Liste gut im kostenlosen Tarif liegt. Wir nennen keine Gesamtsumme für den gesamten Benchmark: Das Konto wurde mit nicht verwandten Arbeiten geteilt, sodass diese Zahl nicht zurechenbar wäre. Der Scraping-Browser-Durchlauf hinter der Ground Truth ist ein separates Produkt auf einer separaten Einheit.