In diesem Leitfaden erfahren Sie:
- Was Containers as a Service ist und was es für Sie verwaltet.
- Wie CaaS funktioniert und welche Bedeutung Container-Orchestrierung in diesem Modell hat.
- Die wichtigsten Vor- und Nachteile dieses Cloud-Service-Ansatzes.
- Warum CaaS für Web-Datenabruf-Workloads besonders geeignet ist.
- Wie Sie eine skalierbare Web-Datenpipeline mit CaaS und Bright Data aufbauen.
Legen wir los!
CaaS (Containers as a Service) erklärt
Bevor Sie sich ansehen, wie CaaS Web-Datenpipelines und KI-Agenten unterstützen kann, müssen Sie verstehen, was es ist und was es tatsächlich verwaltet.
Was ist CaaS?
CaaS, kurz für Containers as a Service, ist ein Cloud-Service-Modell, das eine verwaltete Umgebung für die Bereitstellung, den Betrieb und die Skalierung containerisierter Anwendungen bietet. Es liegt zwischen Infrastruktur- und Anwendungsebenen-Diensten.
Um zu verstehen, wo CaaS seinen Platz hat, überlegen Sie, was passiert, wenn Sie einen Container erstellen. Ein Container-Image stellt eine portable Einheit Ihrer Anwendung dar, die konsistent in verschiedenen Umgebungen ausgeführt werden kann.
Das Image wird dann verwendet, um laufende Container zu erstellen. Der zuverlässige Betrieb dieser Container in der Produktion erfordert Infrastruktur für Deployment, Netzwerk, Skalierung, Monitoring und Lifecycle-Management.
CaaS überbrückt die Lücke zwischen einem fertigen Container-Image und einer produktionsbereiten Laufzeitumgebung. Anstatt Server manuell zu konfigurieren und einzelne Container zu verwalten, können Sie Ihre Container-Images auf einer CaaS-Plattform bereitstellen, die definiert, wie sie ausgeführt werden sollen, und sie orchestriert.
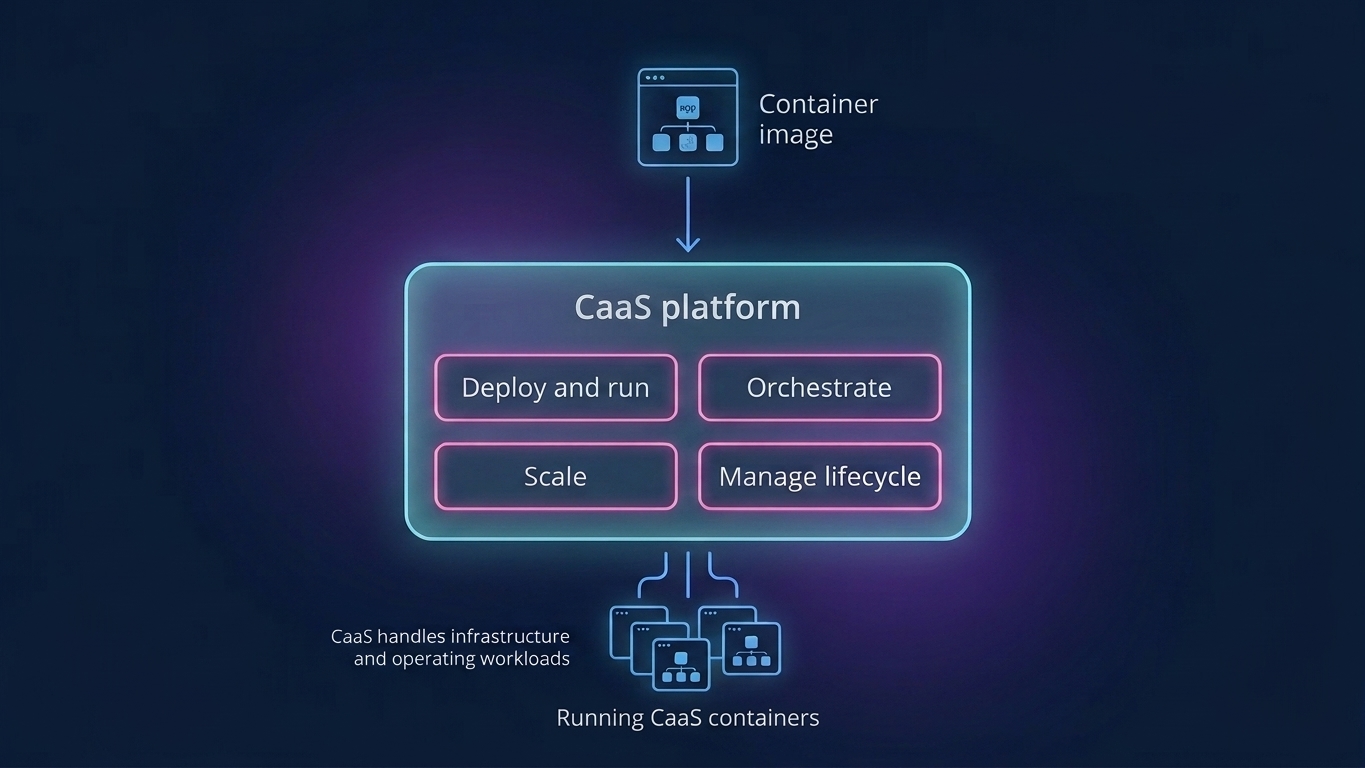
Mit anderen Worten: Dieses Modell ist mehr als nur das Ausführen von Docker auf einer virtuellen Maschine. Mit Docker allein müssen Sie die zugrunde liegende Infrastruktur noch selbst verwalten und Container selbst koordinieren. Eine CaaS-Lösung bietet die zusätzlichen Funktionen, die für den Betrieb containerisierter Workloads in großem Maßstab erforderlich sind.
Was verwaltet CaaS?
Eine CaaS-Plattform übernimmt typischerweise Container-Deployment, Orchestrierung, Skalierung, Netzwerk, Service-Discovery, Health-Checks und Lifecycle-Operationen.
In der Praxis definieren Sie Ihren gewünschten Workload, z. B. wie viele Container-Instanzen ausgeführt werden sollen und welche Ressourcen sie benötigen. Die Plattform übernimmt dann einen Großteil der Ausführung für Sie.
Dieser Ansatz reduziert den Betriebsaufwand und erleichtert den zuverlässigen Betrieb verteilter Anwendungen, insbesondere wenn Workloads häufig skaliert oder geändert werden müssen.
Wie funktioniert CaaS?
Nachdem Sie nun wissen, was CaaS ist, ist es an der Zeit zu verstehen, wie es funktioniert.
Vom Container-Image zum Produktions-Workload
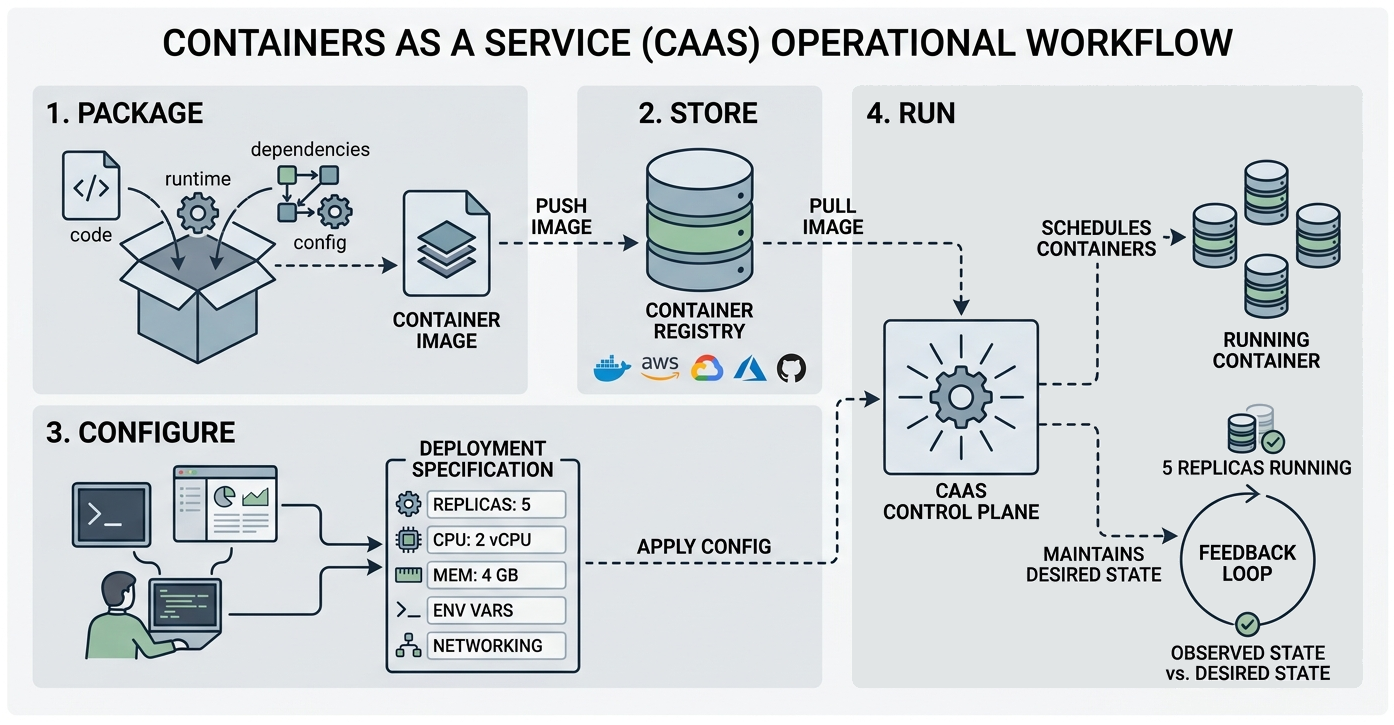
Der erste Schritt bei der Bereitstellung einer Anwendung mit CaaS besteht darin, die Anwendung und alles, was sie zum Ausführen benötigt, in ein Container-Image zu verpacken. Dazu gehören Anwendungscode, Abhängigkeiten, Laufzeitumgebung, Konfiguration und andere erforderliche Komponenten.
Das Image wird in der Regel in einer Container-Registry gespeichert, wie Docker Hub, Amazon ECR, Google Artifact Registry, Azure Container Registry oder der GitHub Container Registry. Eine Registry fungiert als zentrales System zum Speichern, Verwalten und Verteilen von Container-Images. Bei der Bereitstellung einer Anwendung wird das benötigte Image aus der Registry abgerufen und zum Erstellen von Containern verwendet.
Sie legen dann fest, wie die Anwendung ausgeführt werden soll. Je nach CaaS-Lösung kann dies die Anzahl der Container-Instanzen, CPU- und Speicheranforderungen, Netzwerkregeln, Umgebungsvariablen und andere Konfigurationseinstellungen umfassen. Diese Parameter können in der Regel über eine Web-Oberfläche, ein Befehlszeilentool, eine Konfigurationsdatei oder eine API angegeben werden.
Der CaaS-Dienst wandelt diese Konfiguration in einen laufenden Workload um. Er plant Container über die verfügbare zugrunde liegende Infrastruktur und arbeitet kontinuierlich daran, den gewünschten Zustand aufrechtzuerhalten.
Die Rolle der Container-Orchestrierung
Das Ausführen eines einzelnen Containers ist relativ einfach. Wenn eine Anwendung jedoch wächst, müssen Sie möglicherweise Dutzende oder sogar Hunderte von Containern betreiben. In den meisten Fällen müssen diese Container miteinander kommunizieren, basierend auf der Nachfrage skalieren oder sich automatisch erholen, wenn etwas schiefläuft. All dies manuell zu verwalten wird schnell zur Herausforderung.
Hier kommt die Container-Orchestrierung ins Spiel. Orchestrierung automatisiert die Aufgaben, die für den Betrieb und die Koordination mehrerer Container erforderlich sind. Sie kann Container automatisch hinzufügen oder entfernen, wenn sich die Nachfrage ändert, ihren Zustand prüfen, ausgefallene Instanzen ersetzen und es Diensten ermöglichen, sich gegenseitig zu finden und zu kommunizieren.
Kubernetes ist die bekannteste Technologie für Container-Orchestrierung und wird häufig als Grundlage für moderne CaaS-Lösungen genutzt. Es stellt die Mechanismen bereit, die für das Deployment, die Planung, Skalierung und Wartung containerisierter Workloads in einem Cluster von Maschinen erforderlich sind.
Dennoch sollten Sie beachten, dass CaaS und Kubernetes nicht dasselbe sind. Kubernetes ist die bevorzugte Technologie zur Orchestrierung von Containern, während CaaS eine verwaltete Möglichkeit bietet, Container-Infrastruktur zu nutzen, ohne alles selbst betreiben zu müssen.
Vorteile und Herausforderungen von CaaS
Das Containers as a Service-Modell kann die Bereitstellung und den Betrieb containerisierter Anwendungen vereinfachen, bringt aber auch neue Überlegungen mit sich.
Wesentliche Vorteile:
- Anwendungen laufen identisch in Entwicklungs-, Test- und Multi-Cloud-Umgebungen und verhindern Deployment-Fehler durch Konfigurationsabweichungen.
- Automatisierte horizontale Skalierung passt die Container-Anzahl sofort an Traffic-Spitzen an und optimiert den Server-Ressourcenverbrauch.
- Die Auslagerung des Cluster-Managements und der Host-OS-Bereitstellung beseitigt den Wartungsaufwand für interne Engineering-Teams.
- Granulare Komponentenisolierung ermöglicht unabhängiges Deployment, Skalierung und Fehlerwiederherstellung für modulare Microservices-Architekturen.
- Native Integration mit Continuous-Deployment-Pipelines beschleunigt Release-Zyklen durch Automatisierung von Tests und Container-Erstellung.
Wesentliche Herausforderungen:
- Die gemeinsame OS-Kernel-Architektur führt zu Container-Escape-Schwachstellen und vergrößert die Angriffsfläche im Vergleich zu virtuellen Maschinen.
- Komplexe Netzwerk-, Speicher- und Orchestrierungskonfigurationen erfordern steile Lernkurven und spezialisiertes Betriebswissen.
- Anbieterspezifische APIs und proprietäre Orchestrierungs-Tools erschweren die Workload-Migration zwischen verschiedenen Cloud-Anbietern.
CaaS für Web-Daten und KI-Workflows
Erfahren Sie, warum Containers as a Service besonders gut für Web-Datenerfassung und Workflows geeignet ist, die frische Daten für KI-Anwendungen aufbereiten.
Häufige Anwendungsfälle
Eines der beliebtesten Szenarien für CaaS ist der Betrieb von Microservices. Jeder Dienst kann in seinem eigenen Container laufen, sodass Sie einzelne Komponenten unabhängig deployen, aktualisieren und skalieren können.
Das Modell eignet sich auch für die Anwendungsmodernisierung, Continuous Deployment, hybride Infrastruktur und Workloads mit variablen Ressourcenanforderungen. Container bieten konsistente Ausführungsumgebungen, während die CaaS-Schicht die Infrastruktur für deren Betrieb und Skalierung bereitstellt.
Eine weitere natürliche Eignung besteht für jeden Workload, der wiederholte oder parallele Aufgaben beinhaltet. Anstatt alles nacheinander zu verarbeiten, können Sie einzelne Jobs auf mehrere containerisierte Worker verteilen. Dieser Ansatz eignet sich besonders gut für Datenpipelines, bei denen Worker unabhängig voneinander Daten abrufen, transformieren, validieren, anreichern oder verarbeiten können.
CaaS für Web-Datenerfassung
Web-Scraping ist ein gutes Beispiel für einen Workload, der von containerisierter Ausführung profitieren kann. Stellen Sie sich vor, Sie müssen Daten von Tausenden von URLs abrufen. Anstatt sie sequenziell in einer einzigen Anwendung zu verarbeiten, können Sie die URLs auf mehrere containerisierte Worker verteilen.
Jeder Worker kann seine zugewiesenen Aufgaben autonom verarbeiten, sodass Sie die Erfassungskapazität durch das Ausführen weiterer Container erhöhen können. Eine Task-Queue kann diese Architektur weiter verbessern, indem Jobs dynamisch verteilt werden, sobald Worker verfügbar sind.
CaaS für KI-Datenverarbeitungs-Workflows
Die genannte Architektur kann über die Datenerfassung hinaus erweitert werden. Containerisierte Worker können frische Web-Daten abrufen, verarbeiten und anreichern und die resultierenden Informationen in Analyse-Systeme, Datenbanken, RAG-Pipelines oder KI-Anwendungen weiterleiten.
Im Detail könnte eine Queue Tausende von Datenerfassungsaufgaben auf Worker verteilen. Nach der Erfassung könnte ein weiterer Satz von Workern die Ergebnisse bereinigen und strukturieren, bevor sie an einen KI-Agenten oder ein LLM übergeben werden.
Web-Datenerfassung mit CaaS und Bright Data skalieren
CaaS stellt die Ausführungsinfrastruktur für containerisierte Scraping-Worker bereit, löst jedoch nicht die Herausforderungen beim Zugriff auf Websites in großem Maßstab. Browser-Automatisierung, Proxy-Verwaltung, IP-Rotation, Website-Blocking und Anti-Bot-Mechanismen erfordern alle zusätzliche Infrastruktur.
Hier fügt sich Bright Data in die Architektur ein. Die Web-Dateninfrastruktur bietet Zugang zu einem großen Proxy-Netzwerk und verwalteten APIs für Web-Zugang, Suche, Browser-Automatisierung und strukturierte Datenextraktion.
Bright Data wird von einem Proxy-Netzwerk mit mehr als 400 Millionen IPs, unbegrenzter Parallelität, 99,99 % Betriebszeit und einer Erfolgsrate von 99,95 % in seinem Netzwerk unterstützt.
Die Idee besteht darin, die beiden Schichten zu trennen:
- CaaS stellt skalierbare Rechenleistung für Ihre Anwendung bereit.
- Bright Data bringt die Infrastruktur mit, die für den Zugriff auf und die Erfassung von Web-Daten erforderlich ist.
Erfahren Sie mehr darüber, wie Sie CaaS und Bright Data kombinieren, um produktionsreife Datenpipelines und KI-Workflows zu erstellen!
Schritt #1: Die richtige Bright Data API auswählen
Der erste Schritt besteht darin, die Bright Data Produkte auszuwählen, die dem Typ der Daten entsprechen, die Sie erfassen möchten. Dazu gehören:
- Web Scraping API: Extrahieren Sie strukturierte Daten aus über 800 unterstützten Domains mit mehr als 1.500 vorgefertigten Scrapern.
- Web Unlocker API: Inhalte von Webseiten abrufen und dabei viele Zugriffshürden bewältigen, darunter Proxys, Sperren und CAPTCHAs.
- SERP-API: Strukturierte Suchergebnisse von Suchmaschinen wie Google, Bing, Yandex und mehr abrufen.
- Browser API: Verwaltete Browser-Sitzungen für Websites ausführen, die JavaScript-Ausführung, Klicken, Scrollen oder andere Browser-Automatisierung erfordern.
Hinweis: All diese sind im monatlich wiederkehrenden kostenlosen Kontingent von Bright Data enthalten, sodass Sie sie kostenlos nutzen können.
Schritt #2: Einen containerisierten Scraping-Worker erstellen
Nach der Auswahl der geeigneten Web-Daten-API können Sie Ihre Anwendung als Container verpacken. Diese muss lediglich Anfragen an die gewählten Bright Data APIs senden und optional die zurückgegebenen Daten verarbeiten.
Zum Beispiel kann ein Python-Worker die Web Unlocker API verwenden, um LLM-bereiten Markdown-Inhalt von einer Webseite abzurufen:
# worker.py

import os
import requests

def fetch_page(url):
    response = requests.post(
        "https://api.brightdata.com/request",
        headers={
            "Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}",
            "Content-Type": "application/json",
        },
        json={
            "zone": os.environ["BRIGHTDATA_WEB_UNLOCKER_API"], # Replace with your Bright Data Web Unlocker API name
            "url": url,
            "format": "raw",
            "data_format": "markdown",
        },
    )

    response.raise_for_status()

    return response.text
Weitere Hinweise zur Integration finden Sie in der Bright Data Web Unlocker Dokumentation.
Beachten Sie, dass diese Anfrage nichts Docker-spezifisches enthält. Die Anwendung verwendet eine Standard-HTTP-Anfrage über die Python requests-Bibliothek. Damit kann derselbe Code lokal, auf einer virtuellen Maschine oder in einem von einem CaaS-Dienst verwalteten Container ausgeführt werden.
Anschließend können Sie die erforderlichen Abhängigkeiten in einer requirements.txt-Datei auflisten. Diese enthält:
requests==2.34.2Um den Worker zu containerisieren, können Sie dann ein einfaches Dockerfile schreiben:
FROM python:3.14-slim

WORKDIR /app

COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt

COPY . .

CMD ["python", "worker.py"]
Sie müssen auch den Bright Data API-Schlüssel und den Web Unlocker API-Namen separat von Ihrem Anwendungscode bereitstellen. Während der lokalen Entwicklung können Sie eine .env-Datei verwenden:
BRIGHTDATA_API_KEY=<BRIGHTDATA_API_KEY>
BRIGHTDATA_WEB_UNLOCKER_ZONE=<BRIGHTDATA_WEB_UNLOCKER_API>
Für Produktions-Deployments sollten Sie die Secret-Management-Funktionalität Ihres CaaS-Anbieters verwenden, um den API-Schlüssel in den Container einzuspeisen.
Gut gemacht! Auf ähnliche Weise können Sie Anwendungen containerisieren, die andere API-basierte Bright Data Produkte aufrufen.
Schritt #3: Die Arbeit auf Container verteilen
Sobald der Scraping-Worker korrekt funktioniert, kann die Architektur die Anzahl der Worker-Instanzen entsprechend dem Workload skalieren.
Stellen Sie sich nun eine Scraping-Queue mit 100.000 URLs vor. Der CaaS-Dienst kann mehrere Instanzen des Workers ausführen und die Aufgaben unter ihnen verteilen. Wenn der Workload wächst, werden weitere Worker hinzugefügt, um Anfragen gleichzeitig zu verarbeiten. Dies ist wesentlich besser als die sequenzielle Verarbeitung in einer einzigen Anwendung.
Denken Sie daran, dass die Web Unlocker API, wie jedes andere Bright Data Produkt, für die Datenerfassung in großem Maßstab ausgelegt ist. Das bedeutet, dass Sie die Anzahl der containerisierten Worker skalieren können, ohne sich um Parallelitätsprobleme sorgen zu müssen.
Schritt #4: Die zurückgegebenen Daten verarbeiten und verwenden
Die endgültige Architektur sieht so aus:
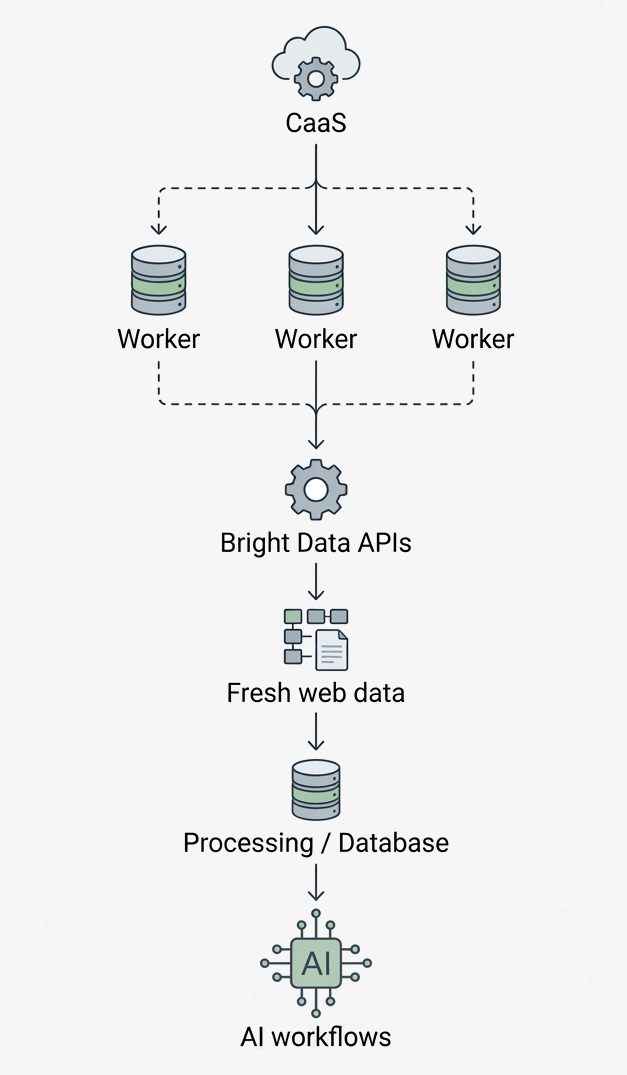
Eine Task-Queue kann zwischen der Anwendung und den Workern sitzen und ermöglicht die dynamische Verteilung von Jobs, sobald Container verfügbar werden. Wenn der Workload steigt, können Sie mehr Worker ausführen. Wenn die Nachfrage sinkt, können Sie sie wieder zurückskalieren.
Dies schafft eine klare Trennung der Verantwortlichkeiten:
- CaaS: Stellt die Rechenumgebung bereit und skaliert die containerisierten Worker.
- Docker: Verpackt die Anwendung und ihre Abhängigkeiten in eine portable Laufzeitumgebung.
- Bright Data: Stellt die spezialisierte Infrastruktur für den Zugriff auf und die Erfassung von Web-Daten in großem Maßstab bereit.
- Ihre Anwendung: Verarbeitet die zurückgegebenen Daten und sendet sie an Datenbanken, ML-basierte Systeme oder KI-Agenten.
Beachten Sie, dass CaaS den Web-Abruf nicht von sich aus einfacher macht. Es macht das Web-Scraping von Anwendungen einfacher zu deployen und zu skalieren. In Kombination mit verwalteter Web-Dateninfrastruktur wie Bright Data können Sie skalierbare Web-Datenpipelines für Analysen und KI aufbauen, ohne jede Schicht des Web-Zugriffs-Stacks selbst verwalten zu müssen. Beeindruckend!
Fazit
In diesem Artikel haben Sie gelernt, wie Sie Containers as a Service (CaaS) verwenden, um skalierbare Web-Datenpipelines und KI-Workflows aufzubauen. Wie hier gezeigt, ermöglicht die Kombination von CaaS mit Bright Data die Skalierung sowohl der Rechen- als auch der Web-Datenschicht Ihrer Architektur.
Diese Integration ermöglicht es Ihnen, die Datenerfassung auf containerisierte Worker zu verteilen, frische Web-Daten über Bright Data APIs abzurufen und die Ergebnisse an nachgelagerte Komponenten weiterzuleiten.
Erstellen Sie ein neues Bright Data-Konto und beginnen Sie, unsere APIs zu nutzen, um skalierbare Daten- und KI-Verarbeitungspipelines aufzubauen!
FAQ
Was ist der Unterschied zwischen CaaS und einer DIY-Container-Infrastruktur?
Bei CaaS verwaltet der Cloud-Anbieter einen Großteil der zugrunde liegenden Infrastruktur und Container-Operationen. Bei einem DIY-Ansatz sind Sie für die Einrichtung, Wartung, Skalierung und Absicherung der Container-Umgebung verantwortlich.
| CaaS | DIY | |
|---|---|---|
| Infrastruktur | Vom Anbieter verwaltet | Vom eigenen Team verwaltet |
| Orchestrierung | Verwaltet oder integriert | Vom eigenen Team eingerichtet und gewartet |
| Skalierung | Integrierte Automatisierung | Selbst konfigurieren und warten |
| Wartung | Geringer | Höher |
| Kontrolle | Weniger Kontrolle auf Infrastrukturebene | Mehr Kontrolle |
| Fachwissen | Weniger erforderlich | Mehr erforderlich |
Kurz gesagt: CaaS reduziert den Betriebsaufwand, während DIY mehr Kontrolle und Anpassungsmöglichkeiten bietet. Erfahren Sie mehr über die Managed vs. DIY-Debatte.
CaaS vs. IaaS vs. PaaS vs. FaaS vs. SaaS: Was ist der Unterschied?
Cloud-Service-Modelle unterscheiden sich hauptsächlich darin, wie viel Infrastruktur- und Anwendungsmanagement dem Benutzer überlassen wird:
| Modell | Was es bietet | Sie verwalten | Anbieter verwaltet | Typische Nutzung |
|---|---|---|---|---|
| IaaS (Infrastructure as a Service) | Virtualisierte Rechenleistung, Speicher und Netzwerk | OS, Middleware, Laufzeit, Anwendungen und Daten | Physische Infrastruktur und Virtualisierung | Benutzerdefinierte Infrastruktur und Anwendungen |
| CaaS (Containers as a Service) | Verwaltete Umgebung für containerisierte Anwendungen | Container-Images, Anwendungen und Konfigurationen | Infrastruktur, Container-Orchestrierung und Skalierung | Containerisierte Anwendungen und Microservices |
| PaaS (Platform as a Service) | Verwaltete Anwendungsplattform und Laufzeit | Anwendungscode und Daten | Infrastruktur, OS, Laufzeit und Plattform | Anwendungsentwicklung und -bereitstellung |
| FaaS (Function as a Service) | Serverlose, ereignisgesteuerte Funktionsausführung | Einzelne Funktionen und ihr Code | Server, Laufzeit, Skalierung und Infrastruktur | Kurzlebige, ereignisgesteuerte Aufgaben |
| SaaS (Software as a Service) | Vollständige, sofort einsatzbereite Software | Konfiguration und Daten | Gesamter Anwendungs-Stack und Infrastruktur | Endbenutzeranwendungen |
CaaS liegt zwischen IaaS und PaaS und gibt Ihnen Kontrolle über containerisierte Anwendungen, während der Anbieter einen Großteil der zugrunde liegenden Infrastruktur und Orchestrierung verwaltet.
Unterstützt Bright Data das CaaS-Cloud-Service-Modell?
Bright Data ergänzt CaaS, indem es die Web-Dateninfrastruktur bereitstellt, die für die Datenerfassung in großem Maßstab benötigt wird, während CaaS die Recheninfrastruktur zum Ausführen und Skalieren Ihrer containerisierten Worker bereitstellt.