Traditionelles Web-Scraping erfordert oft das Schreiben komplexer, zeitaufwändiger Codes, die auf spezifische Website-Layouts zugeschnitten sind und leicht brechen können, wenn sich Seiten ändern. ScrapeGraphAI nutzt große Sprachmodelle (LLMs), um Informationen zu extrahieren und wie ein Mensch zu interpretieren, sodass Sie sich auf die Daten statt auf das Layout konzentrieren können. Die Integration von LLMs mit ScrapeGraphAI verbessert die Datenextraktion, automatisiert die Inhaltsaggregation und ermöglicht Echtzeitanalysen.
In diesem Artikel erfahren Sie, wie Sie ScrapeGraphAI für Web-Scraping verwenden. Aber zuvor stellen wir Ihnen die Lösungen von Bright Data vor, die Ihnen Zeit und Geld sparen können.
Die Web-Scraping-Lösungen von Bright Data
Bright Data bietet eine umfassende Suite von Web-Scraping-Lösungen, optimiert für effiziente, skalierbare und konforme Datenextraktion:
- Web Scraper API
- Gebrauchsfertige Datensätze
- Benutzerdefinierte Datensätze
Diese Lösungen ermöglichen schnelle, präzise und skalierbare Datenerfassung, perfekt für Projekte jeder Größenordnung, von kleinen Anwendungen bis hin zu Anforderungen auf Unternehmensebene.
Implementierung von LLM Web-Scraping mit ScrapeGraphAI
Bevor Sie mit diesem Tutorial beginnen, benötigen Sie folgende Voraussetzungen:
- Python 3.x installiert.
- Ein Ope nAI-Konto. Dieses Tutorial verwendet OpenAI LLMs, um Daten mit ScrapeGraphAI zu scrapen. Obwohl es möglich ist, andere Modelle zu verwenden, wie Anthropic, Google, oder Open-Source-Modelle wie Llama und Mistral AI, verwendet dieses Tutorial GPT-4 aufgrund seiner Beliebtheit und einfachen Einrichtung.
Wenn Sie mit Web-Scraping in Python nicht vertraut sind, schauen Sie sich dieses Web-Scraping-Tutorial an, um zu beginnen.
Richten Sie Ihre Umgebung ein
Das Erste, was Sie tun müssen, ist eine virtuelle Umgebung zu erstellen. Öffnen Sie Ihr Terminal und navigieren Sie zu Ihrem Projektverzeichnis:
python -m venv venv
Aktivieren Sie dann die virtuelle Umgebung. Unter macOS und Linux können Sie dies mit folgendem Befehl tun:
source venv/bin/activate
Unter Windows können Sie diesen Befehl verwenden:
venvScriptsactivate
Sobald Sie die virtuelle Umgebung aktiviert haben, müssen Sie ScrapeGraphAI und seine Abhängigkeiten installieren:
pip install scrapegraphai
playwright install
Der playwright install Befehl richtet die notwendigen Browser für Chromium, Firefox und WebKit ein.
Um Umgebungsvariablen sicher zu verwalten, installieren Sie python-dotenv:
pip install python-dotenv
Es ist wichtig, sensible Informationen wie API-Schlüssel zu schützen. Es wird empfohlen, Umgebungsvariablen in einer .env Datei zu speichern, um sie von den Codedateien getrennt zu halten.
Erstellen Sie eine neue Datei namens .env im Projektverzeichnis und fügen Sie folgende Zeile mit Ihrem OpenAI-Schlüssel hinzu:
OPENAI_API_KEY="your-openai-api-key"
Diese Datei sollte nicht in Versionskontrollsysteme wie Git übernommen werden. Um dies zu verhindern, fügen Sie .env zu Ihrer .gitignore Datei hinzu.
Daten scrapen mit ScrapeGraphAI
In diesem Tutorial beginnen Sie damit, Produktdaten von Books to Scrape zu scrapen, einer Demo-Website speziell zum Üben von Web-Scraping-Techniken. Diese Website simuliert einen Online-Buchladen und bietet eine Vielzahl von Büchern in verschiedenen Genres, komplett mit Preisen, Bewertungen und Verfügbarkeitsstatus:
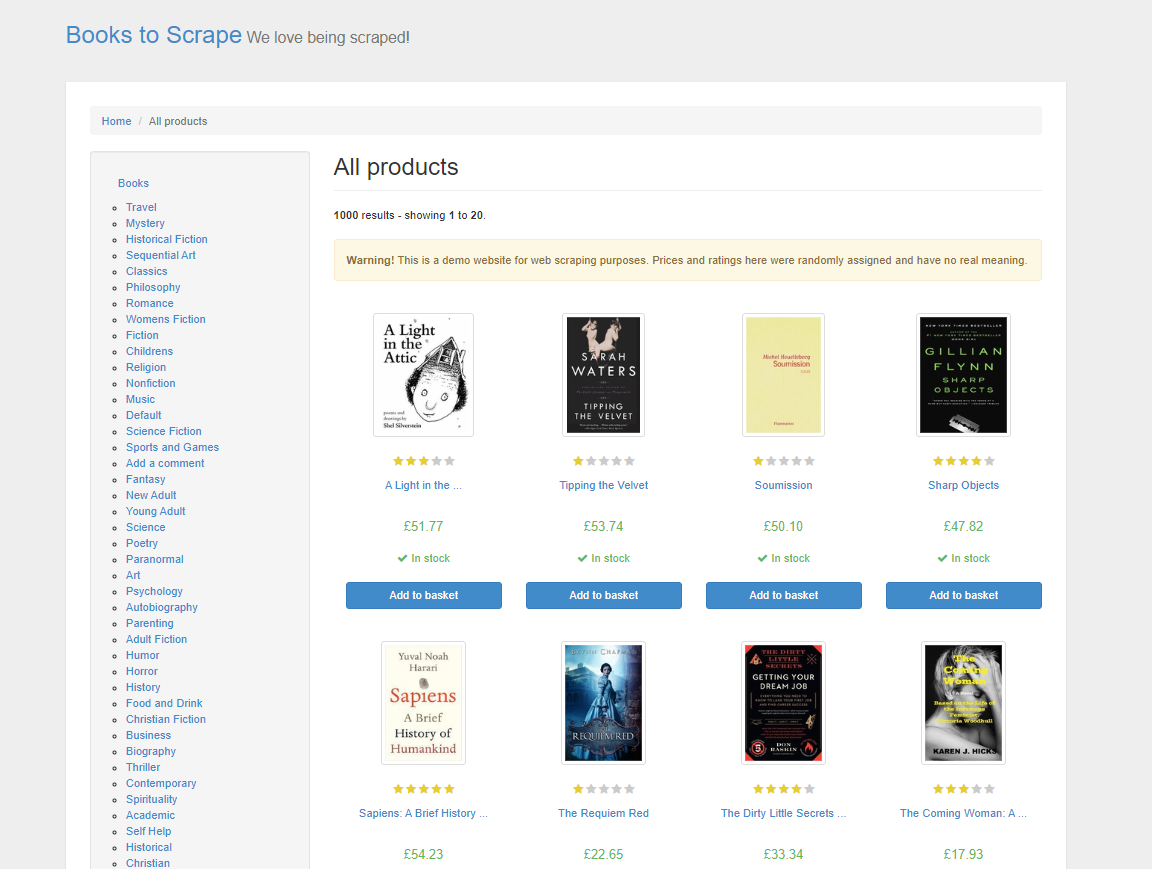
Beim traditionellen HTML-Web-Scraping müssten Sie das HTML der Seite analysieren und manuell Elemente und Tags überprüfen, um die gewünschten Daten zu finden. Dieser Prozess ist zeitaufwändig und erfordert ein solides Verständnis von Webstrukturen. Mit ScrapeGraphAI müssen Sie nur die gewünschten Daten mit einem Prompt angeben, und das LLM ist intelligent genug, um sie zu extrahieren.
ScrapeGraphAI bietet verschiedene Arten von Graphen für unterschiedliche Scraping-Anforderungen. Diese Graphen definieren, wie der Scraping-Prozess strukturiert ist und was er erreichen soll. Hier ist ein kurzer Überblick über einige der verschiedenen Graphen:
- SmartScraperGraph ist ein Single-Page-Scraper, bei dem Sie einen Prompt und eine URL oder lokale Datei angeben. Er nutzt ein LLM, um die von Ihnen angegebenen Informationen zu extrahieren.
- SearchGraph ist ein Multi-Page-Scraper, der Informationen aus Suchmaschinenergebnissen basierend auf Ihrem Prompt extrahiert.
- SpeechGraph erweitert SmartScraperGraph um eine Text-zu-Sprache-Funktion, die eine Audiodatei des extrahierten Inhalts erzeugt.
- ScriptCreatorGraph nimmt einen Prompt und eine URL entgegen und gibt, anstatt Ergebnisse zu generieren, ein Python-Skript aus, das in der Lage ist, die angegebene URL zu scrapen.
Wenn diese Graphen nicht genau Ihren Anforderungen entsprechen, ermöglicht ScrapeGraphAI auch die Erstellung benutzerdefinierter Graphen, indem Sie verschiedene Knoten kombinieren und den Scraping-Prozess an Ihre spezifischen Anforderungen anpassen.
Neben der Wahl des richtigen Graphentyps müssen Sie auch Ihren Scraper richtig konfigurieren, insbesondere in Bezug auf Prompt und Modellauswahl. Der Prompt leitet das LLM dabei an, genau zu verstehen, welche Daten extrahiert werden sollen – stellen Sie sicher, dass er klar und eindeutig ist. Darüber hinaus bestimmt die Wahl des richtigen LLM-Modells, wie gut der Scraper den Inhalt der Website verarbeitet und interpretiert. Sie können auch andere Optionen wie Proxys konfigurieren, um ein reibungsloseres Scraping von geobeschränkten Inhalten zu gewährleisten, sowie den Headless-Modus, um den Prozess effizient und schnell zu halten. Die richtige Konfiguration bestimmt letztendlich, wie präzise und relevant die gescrapten Daten sein werden.
Schreiben Sie den Scraper-Code
Um den Scraper-Code zu schreiben, erstellen Sie eine neue Datei namens app.py und fügen Sie folgende Codezeilen hinzu:
from dotenv import load_dotenv
import os
from scrapegraphai.graphs import SmartScraperGraph

# Load environment variables from .env file
load_dotenv()

# Access the OpenAI API key
OPENAI_API_KEY = os.getenv('OPENAI_API_KEY')

# Configuration for ScrapeGraphAI
graph_config = {
    "llm": {
        "api_key": OPENAI_API_KEY,
        "model": "openai/gpt-4o-mini",
 }
}

# Define the prompt and source
prompt = "Extract the title, price and availability of all books on this page."
source = "http://books.toscrape.com/"

# Create the scraper graph
smart_scraper_graph = SmartScraperGraph(
 prompt=prompt,
 source=source,
 config=graph_config
)

# Run the scraper
result = smart_scraper_graph.run()

# Output the results
print(result)
Dieser Code importiert wesentliche Module wie os und dotenv für die Handhabung von Umgebungsvariablen sowie die SmartScraperGraph Klasse von ScrapeGraphAI, die für das Scraping verwendet wird. Anschließend werden die Umgebungsvariablen über dotenv geladen, um sensible Daten wie API-Schlüssel sicher zu halten. Als Nächstes erstellt der Code eine LLM-Konfiguration für das Scraping, die angibt, welches Modell und welchen API-Schlüssel verwendet werden soll. Diese Konfiguration wird zusammen mit der Website-URL und dem Scraping-Prompt verwendet, um Ihr SmartScraperGraph zu definieren, das mit der run() Methode ausgeführt wird und den Prozess zum Sammeln der angegebenen Daten auslöst.
Um diesen Code auszuführen, öffnen Sie Ihr Terminal und führen Sie python app.py aus. Ihre Ausgabe sollte so aussehen:
{
    "books": [
        {
            "title": "A Light in the Attic",
            "price": "£51.77",
            "availability": "In stock"
        },
        {
            "title": "Tipping the Velvet",
            "price": "£53.74",
            "availability": "In stock"
        }, ...
       ]
}
Hinweis: Wenn beim Ausführen des Codes Probleme auftreten, müssen Sie möglicherweise das
grpcioPaket manuell installieren, das eine zugrunde liegende Abhängigkeit von ScrapeGraphAI ist. Sie können dies mit folgendem Befehl tun:
pip install grpcio
Obwohl ScrapeGraphAI den Teil der Datenextraktion beim Web-Scraping vereinfacht, gibt es immer noch einige häufige Herausforderungen, wie CAPTCHAs und IP-Sperren, mit denen Sie umgehen können müssen.
Um das Browsing-Verhalten nachzuahmen, können Sie zeitlich gesteuerte Verzögerungen in Ihren Code einbauen. Sie können auch rotierende Proxys nutzen, um der Erkennung zu entgehen. Darüber hinaus können CAPTCHA-Lösungsdienste wie Bright Data’s CAPTCHA-Lösung oder Anti Captcha in Ihren Scraper integriert werden, um CAPTCHAs automatisch für Sie zu lösen.
Bitte beachten Sie: Stellen Sie immer sicher, dass Sie die Nutzungsbedingungen einer Website einhalten. Scraping für den persönlichen Gebrauch ist oft akzeptabel, aber die Weiterverbreitung von Daten kann rechtliche Konsequenzen haben.
Verwendung von Proxys mit ScrapeGraphAI
Mit ScrapeGraphAI können Sie einen Proxy-Dienst einrichten, um IP-Sperren zu vermeiden und auf geobeschränkte Inhalte zuzugreifen. Sie können einen kostenlosen Proxy-Dienst verwenden oder Ihren eigenen benutzerdefinierten Proxy-Server konfigurieren.
Um einen kostenlosen Proxy-Dienst zu verwenden, fügen Sie Folgendes zu Ihrer graph_config hinzu:
graph_config = {
    "llm": {
        "api_key": OPENAI_API_KEY,
        "model": "openai/gpt-4o-mini",
 },
    "loader_kwargs": {
        "proxy": {
            "server": "broker",
            "criteria": {
                "anonymous": True,
                "secure": True,
                "countryset": {"US"},
                "timeout": 10.0,
                "max_tries": 3
 },
 },
 }
}
Diese Konfiguration weist ScrapeGraphAI an, einen kostenlosen Proxy-Dienst zu verwenden, der Ihren Kriterien entspricht.
Um einen benutzerdefinierten Proxy-Server von einem Anbieter wie Bright Data zu verwenden, ändern Sie Ihre graph_config wie folgt und fügen Sie Ihre Server-URL, Ihren Benutzernamen und Ihr Passwort ein:
graph_config = {
    "llm": {
        "api_key": OPENAI_API_KEY,
        "model": "openai/gpt-4o-mini",
 },
    "loader_kwargs": {
        "proxy": {
            "server": "http://your_proxy_server:port",
            "username": "your_username",
            "password": "your_password",
 },
 }
}
Die Verwendung eines benutzerdefinierten Proxy-Servers bietet mehrere Vorteile, insbesondere für umfangreiches Web-Scraping. Er gibt Ihnen Kontrolle über den Standort des Proxys und ermöglicht Ihnen das Scrapen geobeschränkter Inhalte. Darüber hinaus sind benutzerdefinierte Proxys zuverlässiger und sicherer als kostenlose Proxys, wodurch die Wahrscheinlichkeit verringert wird, dass Ihre IP gesperrt oder ratenbegrenzt wird.
Daten bereinigen und vorbereiten
Nach dem Scrapen der Daten müssen Sie diese bereinigen und vorverarbeiten, insbesondere wenn Sie planen, sie in ein KI-Modell einzuspeisen. Saubere Daten stellen sicher, dass Ihre Modelle aus genauen und konsistenten Informationen lernen, was sich direkt auf ihre Leistung und Zuverlässigkeit auswirkt. Die Datenbereinigung umfasst typischerweise die Behandlung fehlender Werte, die Korrektur von Datentypen, die Normalisierung von Text und das Entfernen von Duplikaten.
Hier ist ein Beispiel, wie Sie die zuvor gescrapten Daten mit pandas bereinigen können:
import pandas as pd

# Convert the result to a DataFrame
df = pd.DataFrame(result["books"])

# Remove currency symbols and convert prices to float
df['price'] = df['price'].str.replace('£', '').astype(float)

# Standardize availability text
df['availability'] = df['availability'].str.strip().str.lower()

# Handle missing values if any
df.dropna(inplace=True)

# Preview the cleaned data
print(df.head())
Dieser Code bereinigt die Daten, indem er das Währungssymbol aus den Buchpreisen entfernt, den Verfügbarkeitsstatus durch Umwandlung in Kleinbuchstaben standardisiert und fehlende Werte behandelt.
Bevor Sie den Code ausführen, müssen Sie die pandas Bibliothek zur Datenmanipulation installieren:
pip install pandas
Um den Code auszuführen, öffnen Sie Ihr Terminal und führen Sie python app.py aus. Ihre Ausgabe sollte so aussehen:
                                   title  price availability
0                   A Light in the Attic  51.77     in stock
1                     Tipping the Velvet  53.74     in stock
2                             Soumission  50.10     in stock
3                          Sharp Objects  47.82     in stock
4  Sapiens: A Brief History of Humankind  54.23     in stock
Dies ist nur ein Beispiel dafür, wie Sie gescrapte Daten bereinigen können – der Bereinigungsprozess variiert je nach Daten und dem trainierten LLM-Anwendungsfall. Wenn Sie Ihre Daten bereinigen, stellen Sie sicher, dass Ihre Sprachmodelle gut strukturierte und aussagekräftige Eingaben erhalten. Wenn Sie mehr darüber erfahren möchten, wie Sie Daten für KI-Projekte nutzen können, informieren Sie sich über Daten für KI.
Der gesamte Code für dieses Tutorial ist in diesem GitHub-Repo verfügbar.
Fazit
ScrapeGraphAI nutzt LLMs, um einen adaptiven Ansatz für Web-Scraping zu bieten, der sich an Änderungen der Website-Strukturen anpasst und Daten intelligent extrahiert. Die Skalierung von Web-Scraping bringt jedoch Herausforderungen mit sich, wie das Sperren von IPs, das Lösen von CAPTCHAs und die Aufrechterhaltung der rechtlichen Konformität.
Um diese Herausforderungen zu bewältigen, bietet Bright Data eine umfassende Suite von Web-Scraping-Lösungen, die auf KI- und maschinelle Lernprojekte zugeschnitten sind. Dazu gehören die Bright Data Web Scraper APIs, Proxy-Dienste und Serverless Scraping. Darüber hinaus bietet Bright Data auch gebrauchsfertige Datensätze, die mit Daten von über hundert beliebten Websites gefüllt sind.
Starten Sie noch heute!