Für die Preisüberwachung bedeutet das Scrapen von Target-Produkten im großen Maßstab, Ladenpreise und Bestände aus internen JSON-APIs statt aus Seiten-HTML zu lesen.
In unseren Tests kostete eine Packung mit 31 Tide-Pods 9,99 $ in Cedar Rapids und 12,69 $ in Chicago zur gleichen Zeit. Manche Antworten sahen gültig aus, enthielten aber einen Online-Preis oder die Preisspanne eines übergeordneten Produkts. Von US-IPs aus gelang nur 1 von 112 Produkt-API-Aufrufen mit curl und Python-Clients mit Standardeinstellungen.
Dieser Leitfaden zeigt Ihnen, wie Sie diese Preise sammeln, fehlerhafte Antworten erkennen und entscheiden, ob Sie einen Scraper bauen oder einen Target Price Scraper verwenden sollten.
Kurzfassung
- Preise nach Store-ID anfragen. Postleitzahlen auf Store-IDs abbilden, dann Targets Produkt-API mit dessen öffentlichem API-Schlüssel aufrufen.
- Standort und Variante jedes Preises prüfen. Standort 3991 markiert einen Online-Preis, und ein übergeordnetes Produkt kann eine Spanne zurückgeben, also 1 Zeile pro Variante speichern.
- Blockierungen in Antwortinhalten finden. Blockierte Aufrufe gaben HTTP 435 zurück, manchmal als gültiges JSON.
- Tool nach Art der Standortverfolgung wählen. Für Postleitzahlen entsprach Bright Datas Target Scraper API unserem Scraper in 20 von 20 Prüfungen. Für Store-IDs oder kanalspezifische Bestände Ihren Code auf der Web Unlocker API ausführen.
Wie Target Produktdaten bereitstellt
In unseren Tests konnte ein Scraper Preise, Bestände und Produktdetails von 3 Target-Hosts lesen. Das Seiten-HTML der Produktseite war die einzige Quelle ohne Preis. Target identifiziert jedes Produkt durch eine TCIN (Target.com Item Number), die Zahl nach A- in einer Produkt-URL.
Alle 3 Hosts lagen hinter Targets Fastly-CDN. Bei den Hosts www und redsky konnte die Bot-Prüfung von HUMAN Security eine Anfrage blockieren und statt Daten eine Blockierungsantwort zurückgeben:
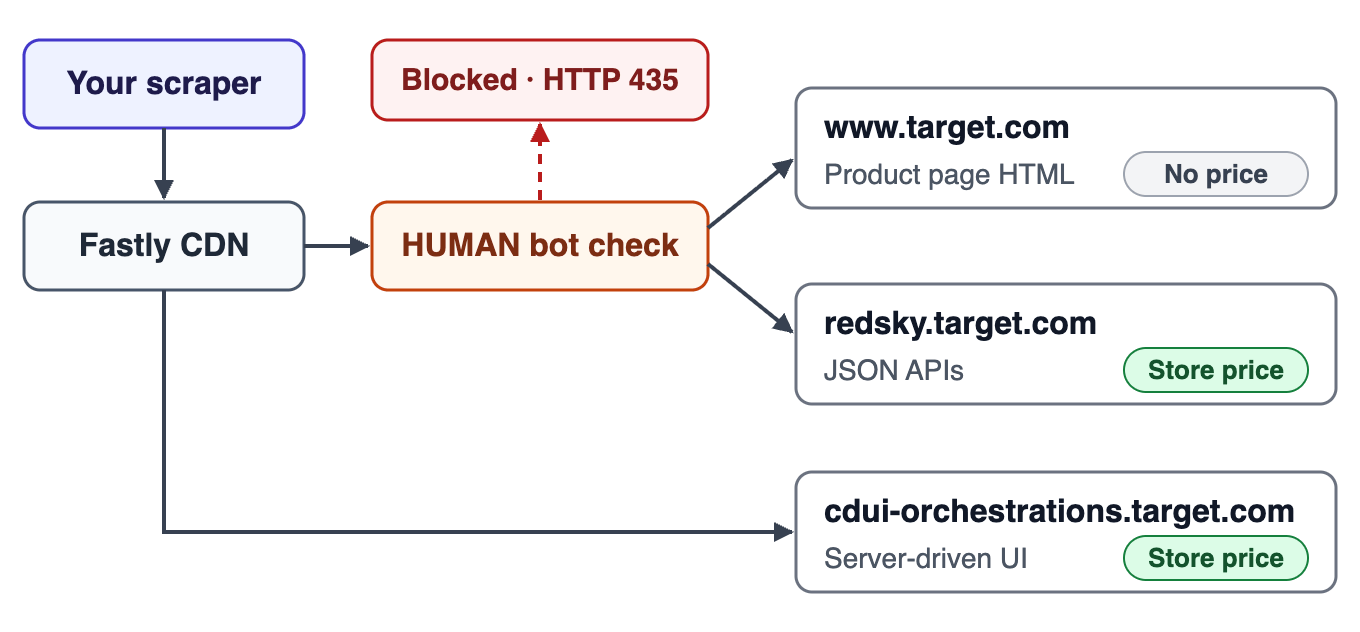
In unseren Tests hatte das Seiten-HTML keinen Preis, während die JSON-APIs und serverseitig gesteuerten UI-Module den Ladenpreis hatten.
Das Seiten-HTML hatte keinen Preis
Die Produktseite war eine Next.js-Anwendung. Ihr __NEXT_DATA__-Skript enthielt Titel, Beschreibung, Bilder und eine Bewertungsübersicht, aber keinen Preis. Die Seiten-Props enthielten isProductDetailServerSideRenderPriceEnabled: false in jeder Seite, die wir mit curl abgerufen haben, unabhängig davon, ob der User-Agent curl, python-requests, Chrome oder HeadlessChrome war. Wenn diese Flagge true wird, kann das HTML Preise enthalten, also prüfen Sie die Flagge vor dem Parsen des HTML.
Dieselben Props kennzeichneten jeden Besucher mit Flaggen isBot, isAiAgent und isSeoPhantom. Anfragen, die vorgaben, ein Suchmaschinen-Crawler wie Googlebot zu sein, erhielten eine andere, zwischengespeicherte Seite mit schema.org JSON-LD und einem gerenderten Preis.
Dieser Preis gehörte zu einem einzigen Standardstandort. Suchmaschinen veröffentlichen, wie man ihre Crawler per Reverse-DNS verifiziert, damit eine Website einen gefälschten Crawler erkennen kann. Verwenden Sie für Ladenpreise die untenstehenden JSON-APIs statt dieser Seite.
Preise und Bestände stammten aus JSON-APIs
Targets Aggregations-API auf redsky.target.com gibt Preise pro Laden zurück. Jeder Endpunkt, den wir aufgerufen haben, erforderte einen key-Parameter. Ohne den Schlüssel gab die API 401 mit "no API key found in request" zurück.
Der Schlüssel ist ein öffentlicher API-Schlüssel, kein Geheimnis. Er erschien 28-mal auf jeder Produktseite, die wir gespeichert haben, außer auf der zwischengespeicherten Seite, die Crawler erhielten. Lesen Sie ihn von einer Target-Seite, etwa der Startseite, statt ihn fest zu codieren.
Bei unserer Prüfung untersagte die robots.txt des API-Hosts jeden Crawler, während die robots.txt der Hauptseite Produktseiten erlaubte.
Diese 4 Endpunkte reichten für jede von uns getestete Produktdatenaufgabe aus:
| Endpunkt | Was er zurückgibt | Grenzen und Fehler in unseren Tests |
|---|---|---|
pdp_client_v1 |
Produkt, Preis bei 1 store_id, und jede Variante der Produktfamilie |
404 für eine TCIN, die nicht mehr existiert |
plp_search_v2 |
Suchergebnisse für ein Schlüsselwort oder eine UPC-Barcode-Nummer | count bis zu 28, offset bis zu 1.199 |
nearby_stores_v1 |
Store-IDs in der Nähe einer Postleitzahl | Keine |
product_fulfillment_v1 |
Versand, Abholung und Bestand im Laden am angefragten Laden, manchmal mit einem nahegelegenen Laden | Keine |
Diese Anfrage holt den Preis eines Kartons Parmalat UHT-Milch im Chelsea-Laden in New York, Laden 3412, mit curl und jq:
KEY=$(curl -s https://www.target.com/ \
  | grep -oE '[0-9a-f]{40}' | sort | uniq -c | sort -rn \
  | head -1 | awk '{print $2}')

REDSKY=https://redsky.target.com/redsky_aggregations/v1/web
Q="key=$KEY&tcin=15078349"
Q="$Q&store_id=3412&pricing_store_id=3412"
Q="$Q&channel=WEB&page=%2Fp%2FA-15078349"
curl -s "$REDSKY/pdp_client_v1?$Q" \
  | jq '.data.product.children[]
        | select(.tcin=="15078349") | .price'
Das Feld location_id in der Antwort zeigt, zu welchem Laden der Preis gehört:
{
  "current_retail": 3.89,
  "display_was_now": false,
  "formatted_current_price": "$3.89",
  "formatted_current_price_type": "reg",
  "formatted_unit_price": "$0.12",
  "formatted_unit_price_suffix": "/fluid ounce",
  "reg_retail": 3.89,
  "location_id": 3412,
  "external_system_id": "15078349-3412-3.89-2025080815"
}
Der Preis steht unter children, weil diese TCIN eine Variante eines übergeordneten Produkts ist. Beide curl-Befehle oben funktionierten von unserer Verbindung in Indien aus. Von US-IPs blockierte Targets Bot-Prüfung in unseren Tests fast alle solchen Anfragen. In diesem Fall gab jq einen Parse-Fehler aus, weil die Antwort eine HTML-Blockierungsseite war, kein JSON.
Die Web Unlocker API sendet dieselben Anfragen durch ihre Entsperrungsschicht und gibt Targets JSON zurück. Setzen Sie zuerst die Umgebungsvariablen BRIGHTDATA_API_KEY und UNLOCKER_ZONE, wie der Web Unlocker API Schnellstart zeigt:
unlock() {
  curl -s https://api.brightdata.com/request \
    -H "Authorization: Bearer $BRIGHTDATA_API_KEY" \
    -H "Content-Type: application/json" \
    -d "{\"zone\": \"$UNLOCKER_ZONE\",
         \"url\": \"$1\", \"format\": \"raw\"}"
}

KEY=$(unlock https://www.target.com/ \
  | grep -oE '[0-9a-f]{40}' | sort | uniq -c | sort -rn \
  | head -1 | awk '{print $2}')

REDSKY=https://redsky.target.com/redsky_aggregations/v1/web
Q="key=$KEY&tcin=15078349"
Q="$Q&store_id=3412&pricing_store_id=3412"
Q="$Q&channel=WEB&page=%2Fp%2FA-15078349"
unlock "$REDSKY/pdp_client_v1?$Q" \
  | jq '.data.product.children[]
        | select(.tcin=="15078349") | .price'
Die unlock-Funktion akzeptiert jede Target-URL, einschließlich der untenstehenden Bestandsanfrage.
Die Live-Seite lud serverseitig gesteuerte UI-Module
In unseren Browser-Netzwerkaufzeichnungen rief die Produktseite pdp_client_v1 nicht auf. Ihr Layout stammte aus serverseitig gesteuerten UI-Modulen, Seitenabschnitten, die der Server als Daten sendet, entweder innerhalb von __NEXT_DATA__ oder von cdui-orchestrations.target.com. Ein deferred_enrichment-Aufruf auf www.target.com fügte die standortspezifischen Module hinzu.
Die Antwort von cdui-orchestrations.target.com und die deferred_enrichment-Module enthielten beide Preise. Mit include_data_source_modules=true gab eine Anfrage an cdui-orchestrations.target.com für den Chelsea-Laden denselben Preis und dieselbe Standort-ID wie pdp_client_v1 für 16 von 16 Testprodukten zurück. Ein Endpunkt, den die Produktseite nicht aufrief, wie pdp_client_v1, kann ohne Vorwarnung verschwinden, und die übereinstimmenden cdui-Preise geben Ihnen einen getesteten Fallback.
Warum Target-Scraper im großen Maßstab versagen
Manche Fehler treten bei der ersten Anfrage auf, andere erscheinen nur, wenn eine Aufgabe viele Läden und Produkte umfasst.
Blockierungen hingen von IP und Client ab
In unseren Tests nutzte Target HUMAN Security, einen Bot-Erkennungsdienst, der 2022 mit PerimeterX fusionierte. Jede Produktseite, die wir mit einem Browser- oder HTTP-Client-User-Agent abgerufen haben, lud HUMANs Sensor-Skript von client.px-cloud.net.
In unserem IP- und Client-Test sendeten wir dieselben 16 pdp_client_v1-URLs von jeder IP-Quelle und jedem Client, in über 3 Stunden verteilten Durchläufen. Ein Aufruf galt als erfolgreich, wenn er 200 oder 206 ohne HUMAN-Blockierung im Inhalt zurückgab:
| IP-Quelle | Client | Erfolgreiche Aufrufe |
|---|---|---|
| IPs in Indien | curl | 63 von 64 |
| IPs in den USA | curl oder Python requests, Standard-User-Agent |
1 von 112 |
| Web Unlocker API mit US-Exit-IPs | Ausgewählt von Web Unlocker API | 32 von 32 |
Aus Indien gelang sogar curl. Von US-IPs hing das Ergebnis vom Client ab, und browserähnliche Header ließen mehr Aufrufe durch. Die Web Unlocker API wählt die Header und den Browser-Fingerabdruck für Sie aus und bestand in diesem Test jeden Aufruf.
Der Host cdui-orchestrations.target.com verhielt sich anders, als wir Aufrufe an ihn und an pdp_client_v1 mit Pythons Standard-User-Agent von US-IPs abwechselten. Der cdui-Host antwortete auf alle 8 Aufrufe, während die Bot-Prüfung alle 8 Aufrufe an pdp_client_v1 blockierte. Von unserer Verbindung in Indien aus hatten cdui-Antworten mit Preisen eine mittlere Übertragungsgröße von 80 KB, und pdp_client_v1-Antworten hatten 9 KB. Der cdui-Host vermied in unseren Tests die Blockierung, aber sein Datenformat folgt dem Seitenlayout und kann sich mit jeder Seitenveröffentlichung ändern.
In unseren Tests ließ die Änderung eines einzigen Headers eine funktionierende Konfiguration scheitern, und HUMANs Blockierungsantwort gab keinen Grund an. Ändern Sie jeweils nur eine Variable. Bevor Sie einer Lösung vertrauen, wechseln Sie sie mit der alten Konfiguration ab und führen Sie genug Aufrufe durch, um einen klaren Unterschied zu sehen. Beim Vergleich von TLS-Fingerabdrücken mit einem Fingerabdruck-Echo-Dienst, verwenden Sie JA4 und den HTTP/2-Fingerabdruck, da sich Chrome-ähnliche Handshakes im JA3 zwischen Verbindungen ändern.
HUMAN setzt auch eigene Cookies. Bei unserer Prüfung listete dessen Cookie-Dokumentation eine Lebensdauer von 5,5 Minuten für _px3 und 1 Jahr für _pxvid auf. Dieselbe Seite besagte, dass diese Cookies eine Sitzung aufrechterhalten und helfen, echte Nutzer von Bots zu unterscheiden. Verwenden Sie für die gesamte Sitzung jeden Cookie-Speicher mit der IP und dem Client, der ihn erhalten hat, oder lassen Sie die Web Unlocker API die Cookies verwalten.
Blockierte Aufrufe gaben HTTP 435 in 2 Formaten zurück
Bei unserer Prüfung listete HUMANs Enforcer-Dokumentation 403 und 429 als Blockierungsstatus auf und besagte, jede Website könne die Antwort anpassen. Bei Target gaben blockierte API-Aufrufe stattdessen HTTP 435 zurück, und die Blockierungsantwort hatte 2 Formate.
Unsere curl-Aufrufe forderten kein JSON an und erhielten eine HTML-Herausforderungsseite. Im Browser gerendert, forderte diese Seite den Besucher auf, eine Schaltfläche gedrückt zu halten:
Die Herausforderungsseite, die unsere curl-Aufrufe mit HTTP 435 statt Daten erhielten.
Unsere Python-requests-Aufrufe forderten JSON an und erhielten ein 343-Byte-JSON-Objekt, das mit {"appId" beginnt. Wenn Sie nur auf gültiges JSON prüfen, sieht diese Blockierung wie gültige Daten aus. Beide Formate enthielten die URL von HUMANs Captcha-Skript, und keine normale Antwort in unseren Beispielen enthielt sie:
def is_human_block(body):
    """HUMAN sendet eine Blockierung als HTML-Seite oder kleines JSON-Objekt.

    Beide Formate enthalten die URL seines Captcha-Skripts. Normale Target-
    Seiten tun das nicht.
    """
    return "captcha.px-" in body
Bei einem Satz von 21 Target-Antworten kennzeichnete die Prüfung alle 4 Blockierungen in beiden Formaten und ließ alle 17 normalen durch. Eine einfachere Prüfung auf den String px-captcha hätte eine gerenderte Produktseite gekennzeichnet und die JSON-Blockierung übersehen.
Preise unterschieden sich nach Laden
Bei 8 Läden hatten 12 der 16 geprüften Produkte mehr als einen Preis. Target meldete mehr als 2.000 Läden. Der Endpunkt nearby_stores_v1 bildet eine Postleitzahl auf die nächstgelegenen Store-IDs ab. Für jede von 8 Postleitzahlen sammelten wir in einem einzigen 2-Minuten-Durchlauf Preise für die 16 Produkte am nächstgelegenen Laden.
Eine Teilmenge von 6 Produkten bei 5 der 8 Läden zeigt die Preisunterschiede in US-Dollar. Diese 5 Läden enthalten den niedrigsten und höchsten Preis jedes Produkts:
| Produkt | New York | Chicago | Cedar Rapids | Anchorage | Honolulu |
|---|---|---|---|---|---|
| Parmalat UHT-Vollmilch, 32 fl oz | 3,89 | 3,49 | 3,59 | 4,49 | 3,89 |
| Tide Original Pods, 31 Stück | 11,19 | 12,69 | 9,99 | 10,59 | 10,59 |
| Cheerios, Familiengröße 18 oz | 5,99 | 5,69 | 5,29 | 6,79 | 5,69 |
| Market Pantry Classic Roast, 25,9 oz | 14,69 | 14,19 | 12,89 | 16,99 | 17,59 |
| Starbucks Fall Blend, 10 oz | 14,39 | 13,59 | 12,79 | 14,29 | 13,59 |
| LEGO Creator Space Shuttle 31134 | 7,99 | 7,99 | 7,99 | 7,99 | 7,99 |
Der Market-Pantry-Kaffee hatte die größte Spanne: 17,59 $ in Honolulu waren 36 % höher als 12,89 $ in Cedar Rapids. Selbst ohne Anchorage und Honolulu hatten 11 der 16 Produkte mehr als einen Preis, und die Tide-Pods variierten am meisten, um 27 %.
Preise können sich auch innerhalb eines Tages ändern. Zwischen 2 unserer Durchläufe am selben Tag senkte der Chicago-Laden den Milchpreis von 3,49 $ auf 2,97 $, und pdp_client_v1 kennzeichnete ihn als sale. Legen Sie die Aktualisierungsrate danach fest, wie oft sich Preise in Ihren Kategorien ändern. Behalten Sie den Preistyp, etwa Angebot oder regulär, bei jeder Zeile bei.
Die 4 Produkte mit demselben Preis in jedem Laden waren 2 LEGO-Sets und 2 AirPods-Modelle. Für alle 4 gab die API einen Preis von Standort 3991 zurück, unabhängig davon, welchen Laden wir angefragt haben. Standort 3991 markiert einen Online-Preis, keinen Ladenpreis.
Die Übergabe von 3991 als Store-ID gab 206 mit "Parameter store_id cannot be digital store 3991." im errors-Array zurück. Für unsere Verbindung in Indien setzte Targets Produktseite auch den Laden auf 3991 und die Postleitzahl auf 52404.
Sie können Standort 3991 nutzen, um Anfragen zu sparen. Fragen Sie zuerst jedes Produkt bei 2 Läden an. Wenn beide Antworten Standort 3991 zeigen, sammeln Sie das Produkt einmal pro Aktualisierung statt einmal pro Laden. Für 4 unserer 16 Testprodukte reduzierte diese Regel die Anfragen von 8 auf 1 pro Aktualisierung.
Um Ladenpreise zu sammeln, senden Sie die Produktanfrage mit einer Store-ID über die Web Unlocker API. Die Target Scraper API gibt Preise für die von Ihnen gesendete Postleitzahl zurück.
Übergeordnete Produkte gaben Preisspannen zurück
Target listet jede Variante, etwa eine Packungsgröße, als untergeordnete TCIN unter einem übergeordneten Produkt. Suchergebnisse gaben die untergeordnete TCIN zurück, aber der Produktendpunkt gab das übergeordnete Produkt zurück. Tide-Pods TCIN 87767249 gab das übergeordnete Produkt 79394303 mit dem Preis "$11.19 - $30.99" zurück, und dessen children-Array listete die 31-, 42-, 76- und 112-Packungen auf. Wenn ein Scraper nur den obersten Preis speichert, erfasst er eine Spanne oder deren niedrigsten Wert für ein Produkt mit 4 Preisen.
Die Spanne kann auch Ladenunterschiede verbergen. Auf übergeordneter Ebene zeigte Pampers Swaddlers "$9.99 - $59.99" in allen 8 Läden in einem früheren Durchlauf. Auf Variantenebene kostete die 164er-Packung Größe 1 47,99 $ in New York und 44,99 $ in den anderen 7 Läden.
Eine Anfrage gibt jede Variante der Produktfamilie am angefragten Laden zurück. Wenn Sie 1 TCIN pro Familie senden, bezahlen Sie für 1 Anfrage pro Familie an jedem Laden.
Suche stoppte bei einem Offset von 1.199
Der Suchendpunkt lehnte jeden count über 28 mit "Parameter 'count' cannot be requested with more than 28" ab. Er lehnte auch jeden offset über 1.199 ab, sodass 1 Abfrage etwa 1.227 Ergebnisse zurückgeben konnte. Eine Suche nach “shirts” meldete in unserem Test 131.690 Ergebnisse, sodass ein einzelnes Schlüsselwort etwa 1 % davon zurückgeben könnte.
Bei unserer Prüfung untersagte die robots.txt für www.target.com Suchseiten für alle User-Agents und listete 6 Sitemap-Indizes auf. Der Produkt-Sitemap-Index verwies auf 110 Dateien, die beim Herunterladen 2.504.600 Produkt-URLs auflisteten. Entdecken Sie Produkte über Sitemaps und Kategorieseiten, und nutzen Sie die Such-API für gelegentliche Abfragen wie UPC-zu-TCIN-Auflösung. Mit der UPC als Schlüsselwort gaben beide von uns getesteten UPCs genau 1 Produkt mit seiner TCIN zurück.
Manche Statuscodes waren irreführend
Target gibt 3 Arten von Antworten zurück, die eine eigene Behandlung benötigen, und 2 davon haben einen irreführenden Statuscode:
| Antwort | Was sie bedeutete | Was zu tun ist |
|---|---|---|
206 mit errors-Array |
Teil der Abfrage schlug fehl, Produktdaten waren noch vorhanden | Daten parsen, Fehler protokollieren |
404 mit "No product found with tcin" |
Das Produkt existiert nicht mehr | URL als tot markieren, Wiederholungen überspringen |
435 mit HTML- oder JSON-Inhalt |
Eine HUMAN-Blockierung | Aus dem Inhalt erkennen, diesen Client pausieren und vor Wiederholung warten |
Entfernte Produkte können in jeder Eingabeliste erscheinen, also planen Sie dafür. Ein Produkt in unserer Testliste gab "No product found with tcin 1002219928" zurück.
Bestand hatte 3 Kanäle pro Laden
In unseren Tests meldete der Endpunkt product_fulfillment_v1 Versand, Ladenabholung und Verfügbarkeit im Laden getrennt und gab eine Menge pro Laden an. Diese Anfrage nutzt KEY und REDSKY aus der obigen Produkt-API-Anfrage erneut und prüft die Milch im Chelsea-Laden:
Q="key=$KEY&tcin=15078349&store_id=3412"
Q="$Q&channel=WEB&page=%2Fp%2FA-15078349"
curl -s "$REDSKY/product_fulfillment_v1?$Q" \
  | jq '.data.product.fulfillment | {
      shipping: .shipping_options.availability_status,
      stores: [.store_options[] | {
        store: .location_id,
        units: .location_available_to_promise_quantity,
        pickup: .order_pickup.availability_status,
        in_store: .in_store_only.availability_status
      }]
    }'
Der Chelsea-Laden hatte keine Einheiten und keine Abholung, aber der Versand zeigte die Milch auf Lager, und ein nahegelegener Laden listete 6 Einheiten:
{
  "shipping": "IN_STOCK",
  "stores": [
    {
      "store": "3412",
      "units": 0.0,
      "pickup": "UNAVAILABLE",
      "in_store": "OUT_OF_STOCK"
    },
    {
      "store": "1886",
      "units": 6.0,
      "pickup": "IN_STOCK",
      "in_store": "IN_STOCK"
    }
  ]
}
In einer anderen Anfrage listete der Anchorage-Laden 2 Einheiten derselben Milch. Speichern Sie den Versand-, Abhol- und Ladenstatus für jeden Laden, da ein einzelnes is_available-Flag nicht 3 separate Werte enthalten kann. Nutzen Sie für den Bestand Lese-Endpunkte wie product_fulfillment_v1, die bereits Mengen pro Laden zurückgeben, statt Warenkorb-Anfragen. Ingenieure, die Einzelhandels-APIs reverse-engineeren, berichten ebenfalls, dass Schreib-Endpunkte besser geschützt sind.
Target-Ladenpreise mit der Web Unlocker API scrapen
Die Web Unlocker API leitet jede Anfrage über IPs und Browser-Fingerabdrücke, die sie für jede Website auswählt. Sie kümmert sich auch um Header, Cookies, CAPTCHAs und Wiederholungen und gibt die Antwort der Website zurück. Bot-Erkennungsanbieter aktualisieren ihre Prüfungen häufig, und die Web Unlocker API passt sich für Sie an diese Updates an. Sie behalten die volle Kontrolle über Ihre Parser- und Endpunktlogik.
Erstellen Sie zunächst ein Bright Data-Konto mit einem API-Schlüssel und einer Web Unlocker API-Zone, einer benannten Konfiguration für Anfragen und deren Abrechnung. Sie benötigen außerdem Python und die requests-Bibliothek, und das Skript läuft auf Python 3.13. Die Web Unlocker API ist selbstbedienbar und berechnet nur erfolgreiche Anfragen. Die Web Unlocker API Preisseite listet aktuelle Tarife auf, und die kostenlose Stufe umfasst 5.000 Anfragen pro Monat ohne Kreditkarte.
Das Skript liest Targets API-Schlüssel von dessen Startseite und bildet jede Postleitzahl auf einen Laden ab. Dann holt es den Preis jeder Variante und trennt gültige von abgelehnten Zeilen:
"""Sammelt Target-Preise pro Laden über Bright Datas Web Unlocker API.

Verwendung:
    export BRIGHTDATA_API_KEY=...        # Konto-API-Schlüssel
    export UNLOCKER_ZONE=web_unlocker    # Ihre Web Unlocker API-Zone
    python target_store_prices.py 15078349,87767249 10001,99501
"""
import collections
import html
import json
import os
import re
import sys
import time
from concurrent.futures import ThreadPoolExecutor
from datetime import datetime, timezone
from urllib.parse import urlencode

import requests

API_KEY = os.environ["BRIGHTDATA_API_KEY"]
ZONE = os.environ.get("UNLOCKER_ZONE", "web_unlocker")
REDSKY = "https://redsky.target.com/redsky_aggregations/v1/web/"
ONLINE_STORE = "3991"  # der Standort, den Targets API als digitalen Laden bezeichnet


def is_human_block(body):
    """HUMAN sendet eine Blockierung als HTML-Seite oder kleines JSON-Objekt.

    Beide Formate enthalten die URL seines Captcha-Skripts. Normale Target-
    Seiten tun das nicht.
    """
    return "captcha.px-" in body


def unlock(url, attempts=3):
    """Ruft eine URL über die Web Unlocker API ab und gibt Targets Antwort zurück."""
    status = None
    for attempt in range(attempts):
        try:
            r = requests.post(
                "https://api.brightdata.com/request",
                headers={"Authorization": f"Bearer {API_KEY}"},
                json={"zone": ZONE, "url": url, "format": "raw"},
                timeout=120,
            )
        except requests.RequestException as error:
            status = type(error).__name__
            time.sleep(2 ** attempt)
            continue
        # Web Unlocker API meldet Targets eigenes Ergebnis in den
        # Headern x-brd-status-code und x-brd-error.
        status = int(r.headers.get("x-brd-status-code", r.status_code))
        if is_human_block(r.text):
            status = "blocked"  # eine Blockierung kann mit jedem Statuscode ankommen
        elif status in (200, 206):
            return status, r.text
        elif "404" in r.headers.get("x-brd-error", ""):
            return 404, ""  # tote Produktseite: nicht wiederholen
        time.sleep(2 ** attempt)
    return status, ""


def web_api_key():
    """Liest den Web-API-Schlüssel, den Target in seine eigenen Seiten einbettet."""
    status, page = unlock("https://www.target.com/")
    keys = re.findall(r'apiKey\\?"\s*:\s*\\?"([0-9a-f]{40})', page)
    if not keys:
        raise RuntimeError(f"kein apiKey auf der Startseite (Status {status})")
    return collections.Counter(keys).most_common(1)[0][0]


def store_for_zip(key, zip_code):
    """Löst eine Postleitzahl zur nächstgelegenen Target-Store-ID auf."""
    query = urlencode({"key": key, "place": zip_code, "limit": 1,
                       "within": 100, "channel": "WEB", "page": "/s"})
    status, body = unlock(f"{REDSKY}nearby_stores_v1?{query}")
    try:
        store = json.loads(body)["data"]["nearby_stores"]["stores"][0]
    except (ValueError, KeyError, IndexError) as error:
        raise RuntimeError(f"kein Laden für {zip_code} ({status})") from error
    return store["store_id"], store["location_name"]


def price_rows(key, tcin, store_id, zip_code):
    """Gibt eine Zeile pro verkäuflicher Variante (untergeordnete TCIN) an einem Laden zurück."""
    query = urlencode({"key": key, "tcin": tcin, "store_id": store_id,
                       "pricing_store_id": store_id,
                       "has_pricing_store_id": "true", "channel": "WEB",
                       "page": f"/p/A-{tcin}"})
    status, body = unlock(f"{REDSKY}pdp_client_v1?{query}")
    error = {"tcin": tcin, "store_id": store_id, "zip": zip_code}
    try:
        product = json.loads(body)["data"]["product"]
    except (ValueError, KeyError, TypeError):
        return [{**error, "error": status or "no_response"}]
    # Eine untergeordnete TCIN gibt ihr übergeordnetes Produkt zurück. Der übergeordnete
    # Preis ist eine Spanne, also den Preis jedes untergeordneten Elements in eigener Zeile speichern.
    items = product.get("children") or [product]
    now = datetime.now(timezone.utc).isoformat(timespec="seconds")
    rows = []
    for item in items:
        price = item.get("price", {})
        priced_at = str(price.get("location_id"))
        rows.append({
            "tcin": item["tcin"],
            "parent_tcin": product["tcin"],
            "title": html.unescape(
                item["item"]["product_description"]["title"]),
            "zip": zip_code,
            "store_id": store_id,
            "priced_at": priced_at,
            "scope": "online" if priced_at == ONLINE_STORE else "store",
            "price": price.get("current_retail"),
            "regular_price": price.get("reg_retail"),
            "price_type": price.get("formatted_current_price_type"),
            "collected_at": now,
        })
    return rows


def valid(row):
    """Behält Zeilen mit einem Preis vom angefragten oder Online-Laden."""
    return (isinstance(row.get("price"), (int, float))
            and row["priced_at"] in (str(row["store_id"]), ONLINE_STORE))


if __name__ == "__main__":
    tcins = sys.argv[1].split(",")
    zips = sys.argv[2].split(",")
    key = web_api_key()
    stores = {z: store_for_zip(key, z) for z in zips}
    jobs = [(t, stores[z][0], z) for t in tcins for z in zips]
    with ThreadPoolExecutor(max_workers=8) as pool:
        results = list(pool.map(lambda job: price_rows(key, *job), jobs))
    # TCINs aus einer Familie geben dieselben Zeilen zurück. Eine Zeile pro
    # Variante und Laden behalten, und nie einen Fehler eine Zeile mit Preis ersetzen lassen.
    unique = {}
    for row in (r for batch in results for r in batch):
        slot = (row["tcin"], row["store_id"])
        if slot not in unique or "error" in unique[slot]:
            unique[slot] = row
    good = [r for r in unique.values() if valid(r)]
    bad = [r for r in unique.values() if not valid(r)]
    # Anhängen, damit jeder Durchlauf die Preishistorie erweitert.
    for name, batch in (("target_prices", good), ("target_rejects", bad)):
        with open(f"{name}.jsonl", "a") as out:
            out.writelines(json.dumps(row) + "\n" for row in batch)
    print(f"{len(good)} gültig, {len(bad)} abgelehnt, Läden: {stores}")
Mit 2 Eingabe-TCINs an 2 Postleitzahlen erzeugte das Skript 12 Zeilen, weil jede Anfrage die gesamte Variantenfamilie zurückgab:
12 gültig, 0 abgelehnt, Läden: {'10001': ('3412', 'Chelsea 23rd and 8th'), '99501': ('2371', 'Anchorage NE')}Die ersten Zeilen von target_prices.jsonl zeigen die Milchfamilie im Chelsea-Laden:
{"tcin": "15078348", "parent_tcin": "94758333", "title": "Parmalat UHT 2% Reduced Fat Milk - 32 fl oz", "zip": "10001", "store_id": "3412", "priced_at": "3412", "scope": "store", "price": 3.89, "regular_price": 3.89, "price_type": "reg", "collected_at": "2026-09-27T05:34:07+00:00"}
{"tcin": "15078349", "parent_tcin": "94758333", "title": "Parmalat UHT Whole Milk - 32 fl oz", "zip": "10001", "store_id": "3412", "priced_at": "3412", "scope": "store", "price": 3.89, "regular_price": 3.89, "price_type": "reg", "collected_at": "2026-09-27T05:34:07+00:00"}
Der Durchlauf, der die Preistabelle erzeugte, umfasste 128 Produkt- und Ladenpaare, 16 Produkte an 8 Läden, und schrieb 800 Zeilen ohne Ablehnungen. Dieses Skript wiederholte den Durchlauf am nächsten Tag in 97 Sekunden mit 8 Workern, und alle 800 Preise stimmten mit dem ersten Durchlauf überein. Das Skript führt außerdem eine Datei target_rejects.jsonl für jedes Paar, das einen Wiederholungsversuch benötigt.
Die Web Unlocker API meldet Targets eigenes Ergebnis in den Headern x-brd-status-code und x-brd-error, sodass das Skript beide liest. Bei einem entfernten Produkt zeigt x-brd-error Targets 404, und das Skript erfasst dies ohne Wiederholung.
Jede Designentscheidung behandelt einen Fehler, der in einem Target-Scraper auftreten kann:
- Schlüssel von der Seite: Der Scraper funktioniert nach einer Schlüsselrotation weiter, solange die Seite den Schlüssel weiterhin als
apiKeyeinbettet. - Eine Zeile pro untergeordnetem Element: Ihre Tabelle speichert nie eine übergeordnete Spanne.
scope-Spalte: Ein Online-Preis wird alsonlinegekennzeichnet, damit er nicht mit einem Ladenpreis verwechselt werden kann.- Blockierungsprüfung: Eine HUMAN-Blockierung in HTML oder JSON wird als
blockedprotokolliert, unabhängig vom Statuscode. - Keine Überschreibungen: Ein Fehler bei einer Variante ersetzt nie die Zeile einer anderen Variante mit Preis.
- Ablehnungsdatei: Zeilen ohne gültigen Ladenpreis oder Online-Preis werden für einen Wiederholungsdurchlauf gespeichert, und entfernte Produkte behalten ihr
404.
Der Code hängt von pdp_client_v1 und nearby_stores_v1 ab, senden Sie also täglich eine Kanarienvogel-Anfrage an beide und alarmieren Sie, wenn sich das Antwortschema ändert. Unser Leitfaden zum Wiederholen fehlgeschlagener Python-Anfragen erklärt Backoff ausführlicher.
Um denselben Code auf Residential-Proxys auszuführen, senden Sie ein proxyfiziertes requests.get() in unlock() und behandeln Sie ein einfaches 404 als entferntes Produkt. Der Rest des Skripts bleibt gleich. Mit Residential-Proxys kontrollieren Sie Client und User-Agent, testen Sie diese also und jeden Endpunkt gegen Target, bevor Sie skalieren.
Target-Produkte mit der Target Scraper API sammeln
Die Target Scraper API ist der Web Scraper API-Scraper für Target. Sie senden Produkt-URLs und Postleitzahlen, und sie gibt strukturierte Datensätze mit Feldern wie Preis, Varianten, Bewertungen, Spezifikationen und Verkäufer zurück. Bright Data pflegt das Parsing und die Endpunkte, sodass Ihr Code nur die Datensätze normalisiert. Bright Data bietet außerdem einen Target Price Scraper, einen Target Reviews Scraper und einen Target Image Scraper für engere Aufgaben.
Die Konsole zeigt die Eingabefelder des Scrapers oberhalb seiner synchronen und asynchronen Modi. Die Felder sind eine URL, eine all_variations-Flagge und eine Postleitzahl:
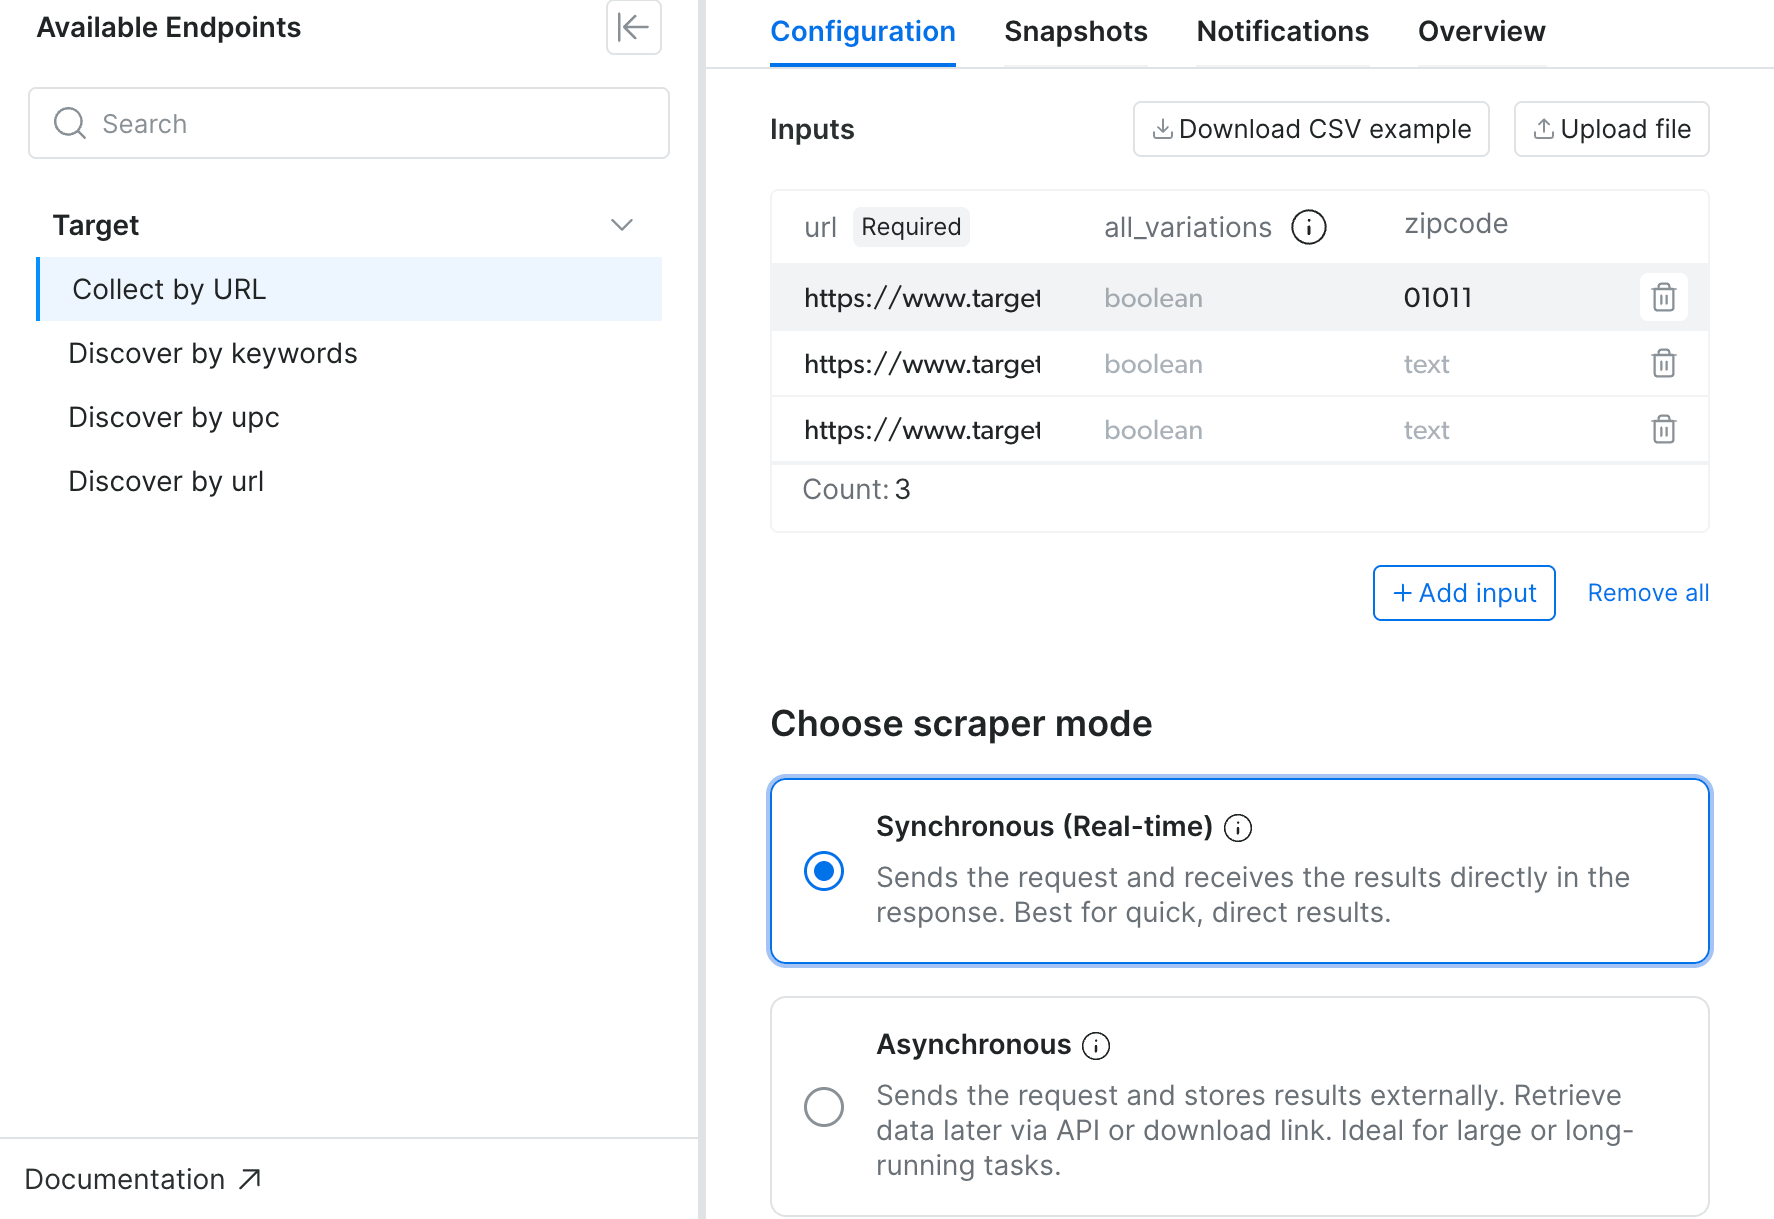
Jede Eingabezeile listet ein einzelnes Produkt auf und kann eine Postleitzahl hinzufügen, die den Standort für den Preis des Datensatzes festlegt.
Die Web Scraper API berechnet nur gelieferte Datensätze. Die Web Scraper API Preisseite listet aktuelle Tarife auf, und die kostenlose Stufe umfasst 5.000 Anfragen pro Monat ohne Kreditkarte. Für eine Client-Bibliothek installieren Sie das Bright Data Python SDK mit pip install brightdata-sdk.
Das untenstehende Skript startet einen asynchronen Job, wartet darauf, lädt die Datensätze herunter und normalisiert sie:
"""Sammelt Target-Produktdatensätze nach URL und Postleitzahl mit der Web Scraper API.

Verwendung:
    export BRIGHTDATA_API_KEY=...
    python target_scraper_api.py inputs.csv   # Spalten: url,zipcode
"""
import csv
import json
import os
import re
import sys
import time

import requests

API = "https://api.brightdata.com/datasets/v3"
DATASET_ID = "gd_ltppk5mx2lp0v1k0vo"  # Target-Produkte-Scraper
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}


def trigger(inputs):
    """Startet eine asynchrone Sammlung und gibt deren Snapshot-ID zurück."""
    r = requests.post(
        f"{API}/trigger",
        headers=HEADERS,
        params={"dataset_id": DATASET_ID, "include_errors": "true"},
        json=inputs,
        timeout=60,
    )
    r.raise_for_status()
    return r.json()["snapshot_id"]


def wait(snapshot_id, poll_seconds=15, max_minutes=60):
    """Fragt den Snapshot ab, bis er bereit ist, und gibt seinen Fortschrittsdatensatz zurück."""
    deadline = time.time() + max_minutes * 60
    while time.time() < deadline:
        progress = requests.get(f"{API}/progress/{snapshot_id}",
                                headers=HEADERS, timeout=30).json()
        if progress["status"] in ("ready", "failed"):
            return progress
        time.sleep(poll_seconds)
    raise TimeoutError(snapshot_id)


def download(snapshot_id):
    """Lädt alle Datensätze, einschließlich Fehlerdatensätze, als Liste herunter."""
    r = requests.get(f"{API}/snapshot/{snapshot_id}",
                     headers=HEADERS, params={"format": "json"}, timeout=300)
    r.raise_for_status()
    return r.json()


def normalize(record):
    """Bildet einen Datensatz auf eine flache Zeile ab oder gibt None für einen Fehlerdatensatz zurück."""
    if record.get("error_code"):
        return None
    price = record.get("final_price")
    if price is None and record.get("price_range"):
        # Ein Datensatz kann seinen Preis in price_range haben, wie "$24.99".
        match = re.fullmatch(r"\$([\d,]+\.\d{2})", record["price_range"])
        price = float(match.group(1).replace(",", "")) if match else None
    origin = record.get("discovery_input") or record.get("input") or {}
    reviewed = bool(record.get("reviews_count"))  # Bewertung 0 bedeutet unbewertet
    url_tcin = re.search(r"/A-(\d+)", record.get("url") or "")
    return {
        "tcin": url_tcin.group(1) if url_tcin else record.get("tcin_id"),
        "parent_tcin": record.get("group_id"),
        "title": record.get("title"),
        "zipcode": origin.get("zipcode") or None,
        "price": price,
        "initial_price": record.get("initial_price"),
        "available": record.get("is_available"),
        "rating": record.get("rating") if reviewed else None,
        "reviews_count": record.get("reviews_count"),
        "collected_at": record.get("timestamp"),
    }


if __name__ == "__main__":
    with open(sys.argv[1], newline="") as f:
        inputs = [{"url": row["url"], "zipcode": row["zipcode"]}
                  for row in csv.DictReader(f)]
    snapshot_id = trigger(inputs)
    progress = wait(snapshot_id)
    records = download(snapshot_id)
    rows = [row for row in map(normalize, records) if row]
    with open("target_records.jsonl", "w") as out:
        out.writelines(json.dumps(row) + "\n" for row in rows)
    print(f"snapshot {snapshot_id}: {len(rows)} Zeilen, "
          f"Fehler: {progress.get('error_codes', {})}")
Die Eingabedatei enthält die Milch an 2 Postleitzahlen, plus ein landesweit bepreistes LEGO-Set und eine 112er-Packung Tide, beide in Anchorage. Die letzte Zeile ist ein Produkt, das Target entfernt hat:
url,zipcode
https://www.target.com/p/-/A-15078349,10001
https://www.target.com/p/-/A-15078349,60601
https://www.target.com/p/-/A-86216189,99501
https://www.target.com/p/-/A-84114518,99501
https://www.target.com/p/petal-and-pup-skarlett-top/-/A-1002219928,10001
Der Job gab 4 Datensätze zurück und kennzeichnete das entfernte Produkt als dead_page:
snapshot sd_muifuppi1d0g830zfd: 4 Zeilen, Fehler: {'dead_page': 1}Alle 4 Preise stimmten mit unserem Scraper überein. Der Market-Pantry-Kaffee und die Tide-31er-Packung variierten je nach Standort im Preis. Wir verglichen sie mit unserem Scraper an allen 8 Postleitzahlen, zur gleichen Zeit:
| Produkt | Produkt- und Postleitzahlpaare | Unterschiedliche Preise | Stimmte mit unserem Scraper überein |
|---|---|---|---|
| Market Pantry Classic Roast, 25,9 oz | 8 | 7 | 8 von 8 |
| Tide Original Pods, 31 Stück | 8 | 5 | 8 von 8 |
| Milch, LEGO-Set und Tide 112 Stück (Eingabedatei oben) | 4 | Nicht zutreffend | 4 von 4 |
Alle 20 Produkt- und Postleitzahlpaare stimmten mit dem Preis unseres Scrapers am nächstgelegenen Laden überein. Einen Tag später ergab eine Wiederholung der Eingabedatei Chicagos neuen Angebotspreis von 2,97 $, den unser Scraper bestätigte.
Jeder Datensatz enthält die für seinen Preis verwendete Postleitzahl und eine Verfügbarkeitsflagge für diese Postleitzahl. Der Normalisierer bildet diese Felder ab:
- Übergeordnete ID:
group_identhält die übergeordnete TCIN. - Ursprung:
inputenthält URL und Postleitzahl eines gesammelten Datensatzes.discovery_inputenthält das Schlüsselwort oder die Kategorie-URL und eine beliebige Postleitzahl, wenn die Target Scraper API das Produkt selbst gefunden hat. - Preis: Der Normalisierer nimmt den Preis aus
final_priceoderprice_range. - Unbewertete Produkte: Eine
ratingvon 0 mit 0 Bewertungen bedeutet, dass das Produkt keine Bewertung hat.
Synchronen oder asynchronen Modus wählen
Der synchrone Endpunkt /scrape gibt Ergebnisse in der Antwort für schnelle Aufgaben zurück und gibt eine snapshot_id zum Abfragen für längere Aufgaben zurück. Die Dokumentation zu synchronen Anfragen nennt das aktuelle Zeitlimit. Nutzen Sie /trigger für geplante Stapel. Sie fragen eine snapshot_id von beiden Endpunkten auf dieselbe Weise ab.
Für wiederkehrende Aufgaben richten Sie die API so ein, dass sie die Ergebnisse liefert. Die Zustellungsoptionen umfassen Webhooks und Cloud-Speicher wie Amazon S3, Google Cloud Storage und Microsoft Azure. Setzen Sie bei /scrape limit_per_input im Anfragekörper, um die Datensätze pro Eingabe zu begrenzen, wie die Dokumentation zeigt.
Produkte nach Schlüsselwort oder Kategorie entdecken
Die Target Scraper API kann auch Produkte für Sie finden:
- Schlüsselwort: “dog treats” und “shirts” mit auf 20 gesetztem
limit_per_inputgaben 40 Datensätze ohne Fehler zurück. - Kategorie-URL: 2 Kategorieseiten, jeweils mit einer Postleitzahl, gaben 40 Datensätze zurück.
Der oben genannte Normalisierer liest bereits discovery_input, sodass derselbe Code entdeckte Datensätze verarbeitet.
Browser API für Sitzungen und Fehlersuche nutzen
Die Browser API betreibt ein entferntes Chrome, das Sie mit Playwright oder Puppeteer über das Chrome DevTools Protocol (CDP) oder mit Selenium über WebDriver steuern. Bei Target lud sie die Produktseite als vollständige Browser-Sitzung, einschließlich HUMANs Skript. Da sie die gesamte Seite lädt, eignet sich die Browser API gut, um den Netzwerkverkehr zu erfassen, nachdem Target sein Frontend ändert.
Der Bright Data MCP Server stellt KI-Agenten Tools über das Model Context Protocol (MCP) bereit. Seine Browser-Tools geben Agenten denselben entfernten Browser für Arbeitsabläufe, die auf einer Seite klicken oder tippen.
Die Browser API berechnet pro GB, wie die Browser API Preisseite zeigt. Das Blockieren von Bildern und Trackern hilft, jede Sitzung klein zu halten. Sobald eine Aufzeichnung die benötigten Anfragen zeigt, kann die Web Unlocker API diese direkt senden, ohne die Seite zu laden.
Ohne gespeichertes Standort-Cookie wies Target jeder unserer US-Browser-Sitzungen einen Laden in der Nähe der Exit-IP zu. Der über CDP gesendete Befehl Proxy.setLocation der Browser API wählt eine Exit-IP in der Nähe von Koordinaten, die Sie wählen. Um das Skript auszuführen, installieren Sie playwright und setzen Sie die Verbindungszeichenfolge einer Browser API-Zone in der Umgebungsvariable BROWSER_API_WSS, wie der Browser API Schnellstart zeigt:
import asyncio
import os

from playwright.async_api import async_playwright

# wss://brd-customer--zone-:@brd.superproxy.io:9222
WSS = os.environ["BROWSER_API_WSS"]


async def main():
    async with async_playwright() as pw:
        browser = await pw.chromium.connect_over_cdp(WSS)
        page = await browser.contexts[0].new_page()
        cdp = await page.context.new_cdp_session(page)
        # Ausstieg nahe Manhattan, damit Target die Sitzung dort georeferenziert.
        await cdp.send("Proxy.setLocation", {
            "lat": 40.7506, "lon": -73.9972, "distance": 10, "strict": True,
        })
        await page.goto("https://www.target.com/p/-/A-15078349",
                        wait_until="domcontentloaded", timeout=120_000)
        # Die Seite rendert den Preis zweimal, und eine Kopie bleibt verborgen.
        price = page.locator('[data-test="product-price"]').first
        await price.wait_for(state="attached", timeout=60_000)
        cookies = await page.context.cookies("https://www.target.com")
        store = {c["name"]: c["value"] for c in cookies}.get("fiatsCookie")
        print(store, await price.text_content())
        await browser.close()

asyncio.run(main())
Bei 3 Durchläufen mit denselben Koordinaten wies Target 3 verschiedene New Yorker Läden in der Nähe dieser Koordinaten zu. Der Wert von fiatsCookie listete die Store-ID (DSI), den Namen (DSN) und die Postleitzahl (DSZ) auf:
DSI_2475|DSN_Bronx%20Terminal|DSZ_10451 $3.59
DSI_3284|DSN_Lower%20East%20Side%20Grand%20and%20Clinton|DSZ_10002 $3.99
DSI_3394|DSN_Upper%20West%20Side%2098th%20and%20Columbus|DSZ_10025 $3.99
Da jede Sitzung einen nahegelegenen Laden erhielt, ist diese Konfiguration nützlich, um Preise in einem Ballungsraum zu erfassen.
Target-Datensatz für Katalog-Nachfüllung kaufen
Der Target-Datensatz bietet vorab gesammelte Target-Produktdatensätze, die Sie filtern und kaufen können, ohne einen Scraper auszuführen. Er eignet sich gut für eine Katalog-Nachfüllung, die viele Zeilen auf einmal benötigt.
Die Datensatzseite listet die aktuelle Datensatzanzahl, Felder und Preise auf. Im Dataset Marketplace können Sie Datensätze filtern und eine Stichprobe vor dem Kauf ansehen:
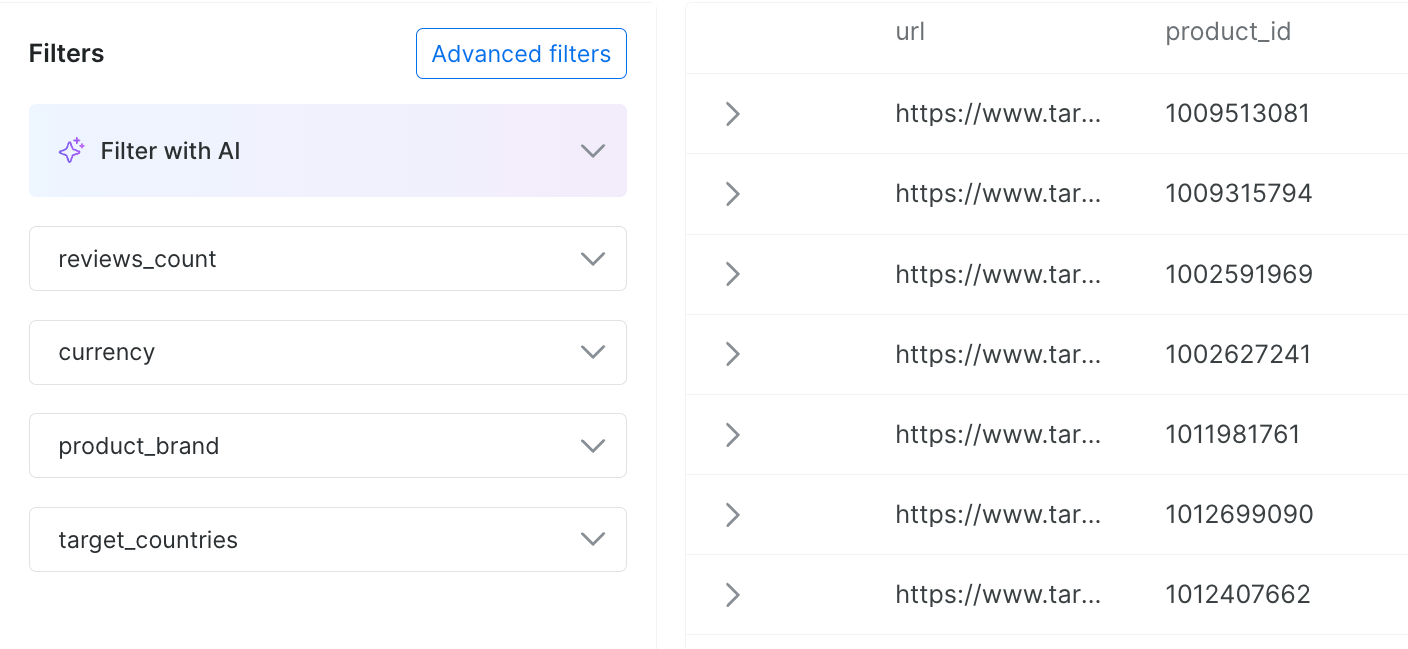
Die Feldfilter des Target-Datensatzes und eine Stichprobe seiner Datensätze.
Bilden Sie die Datensätze vor dem Laden auf Ihr eigenes Schema ab:
- Produkt-IDs: Verwenden Sie die TCIN in der URL jedes Datensatzes als Tabellenschlüssel, dieselbe ID, die die obigen Scraper verwenden.
- Bewertungen: Eine
ratingvon 0 mit 0 Bewertungen bedeutet, dass das Produkt noch keine Bewertung hat.
Ansatz nach Standort, Umfang und Aktualisierungsrate wählen
Optionen mit mehr Kontrolle erfordern mehr Wartung, die mit der Häufigkeit wächst, mit der Target seine Seiten und Endpunkte ändert. Teams, die fertige Target-Dashboards wünschen, können den Target Price Tracker oder Target Inventory Tracker nutzen. Für andere Einzelhändler siehe unseren Leitfaden zum E-Commerce-Web-Scraping. Jeder Ansatz berechnet nach seiner eigenen Einheit, und die Preisseite jedes Produkts listet aktuelle Tarife auf:
| Ansatz | Abgerechnet nach | Umfang eines Aufrufs oder Datensatzes | Beste Eignung |
|---|---|---|---|
| Eigener Code mit Web Unlocker API | Erfolgreiche Anfrage | 1 Variantenfamilie bei 1 Store-ID | Store-IDs und kanalspezifischer Bestand |
| Eigener Code mit Residential-Proxys | GB an Traffic | 1 Variantenfamilie bei 1 Store-ID, in unseren Tests etwa 15 KB komprimiert | Niedrige Kosten pro Aufruf, mit voller Kontrolle über den Client |
| Target Scraper API | Gelieferter Datensatz | 1 Produkt bei 1 Postleitzahl | Wiederkehrende Sammlung mit für Sie erledigtem Parsing und Wartung |
| Browser API | GB an Traffic | 1 vollständige Browser-Sitzung | Sitzungen und Fehlersuche |
| Target-Datensatz | Datensatz | 1 vorab gesammelter Produktdatensatz | Nachfüllung und Katalogforschung |
Wählen Sie danach, wie Sie Standorte verfolgen. Wenn Sie nach Postleitzahl verfolgen, stimmte die Target Scraper API in unseren Tests mit dem Preis des nächstgelegenen Ladens überein, und Bright Data pflegt sie für Sie. Wenn Sie Store-IDs und kanalspezifischen Bestand verfolgen, führen Sie eigenen Code auf der Web Unlocker API oder Residential-Proxys aus. Für eine Nachfüllung wählen Sie den Datensatz, wie unser Vergleich von Datensätzen und Web-Scraping-APIs erklärt.
Bevor Sie wählen, schätzen Sie den monatlichen Umfang, indem Sie Produkte mit Läden, mit Aktualisierungen pro Tag und mit 30 multiplizieren. Die Verfolgung von 5.000 Produkten in 50 Läden einmal täglich bedeutet 7,5 Millionen Anfragen oder Datensätze pro Monat. Kanalspezifischer Bestand fügt 1 product_fulfillment_v1-Anfrage pro TCIN und Laden hinzu. Multiplizieren Sie die Summe mit dem Einheitspreis auf der Preisseite, wo monatliche Pläne den Preis senken.
Ihr eigener Code kann weniger Anfragen senden als diese Schätzung, auf 2 Weisen. Von unseren 16 Testprodukten hatten 4 denselben Preis in jedem Laden und benötigten nur 1 Anfrage pro Aktualisierung. Eine Produkt-API-Anfrage gibt außerdem eine ganze Variantenfamilie zurück, sodass 128 Produkt- und Ladenpaare in unserem Durchlauf 800 Zeilen erzeugten.
Bei Residential-Proxys würden 7,5 Millionen gzip-komprimierte pdp_client_v1-Aufrufe etwa 110 GB übertragen. Wie die Preisseite für Residential-Proxys anmerkt, zählt die Abrechnung Header und Inhalte, die bei uns durchschnittlich 15 KB pro Aufruf betrugen. Die Abrechnungs-FAQ erklärt, wie Traffic gemessen wird. Fordern Sie komprimierte Antworten an, da dieselben pdp_client_v1-Inhalte ohne Komprimierung durchschnittlich 134 KB und mit gzip 14 KB betrugen.
Die Web Unlocker API übernimmt die Entsperrung für Sie und berechnet nur erfolgreiche Anfragen. In unserem IP- und Client-Test bestand sie jeden Aufruf auf US-Exit-IPs ohne Client-Feinabstimmung. Sie können auch sowohl die Web Unlocker API als auch Residential-Proxys verwenden. Senden Sie die Anfragen jedes Endpunkts über die zu deren Umfang passende Option und verschieben Sie einen Endpunkt zur Web Unlocker API, wenn sich Targets Bot-Prüfung ändert.
Target-Sammlung validieren und überwachen
Eine Blockierung, die is_human_block() erkennt, erscheint als Fehler. Ein falscher Ladenpreis, der gültig aussieht, erscheint als Daten, sodass kein Fehler ihn kennzeichnet. Die untenstehenden Prüfungen helfen, Fehler zu erkennen, die wie gültige Daten aussehen oder Anfragen verschwenden können:
| Prüfung | Wo zu suchen | Erkennt |
|---|---|---|
| Preis ist eine Zahl über null | price |
Fehlende Preise und Spannen |
| Preis stammt vom angefragten Laden oder ist als online gekennzeichnet | location_id, scope |
Falsche Ladenpreise |
| Zeile ist eine untergeordnete TCIN | tcin, children |
Übergeordnete Spannen |
| Inhalt hat das erwartete JSON-Schema und keine HUMAN-Blockierung | Antwortinhalt | HTML- und JSON-Blockierungsantworten (HTTP 435) |
| Produkt existiert noch | 404, dead_page |
Tote URLs, die bei jedem Durchlauf wiederholt werden |
| Preisänderung seit dem letzten Durchlauf liegt innerhalb Ihres Schwellenwerts | Preishistorie | Fehlerhaft geparste oder falsche Preise |
Führen Sie die Prüfungen bei jedem Stapel durch und speichern Sie jede Zeile mit TCIN, Store-ID und Sammelzeit, damit die Historie wächst. Zählen Sie Fehler nach Grund, etwa eine Blockierung, ein falscher Laden, ein entferntes Produkt oder ein Timeout. Eine allgemeine Fehlerrate kann einen Anstieg der Fehler aus einem Grund verbergen, alarmieren Sie also, wenn die Rate aus irgendeinem Grund über das Normale steigt. Verfolgen Sie auch die Kosten pro erfolgreichem Datensatz, damit Sie Ansätze mit demselben Maß vergleichen können.
Abschließende Gedanken
Target zeigt seine Produktdaten öffentlich, aber ein Preis kann vom Laden, der Variante und dem Zeitpunkt der Sammlung abhängen. In unseren Tests sahen Online-Preise von Standort 3991, übergeordnete Preisspannen und JSON-Blockierungsantworten alle wie gültige Daten aus. Behalten Sie Store-ID, Variante und Anfragestatus bei jeder Zeile und führen Sie täglich eine Kanarienvogel-Anfrage gegen jeden Endpunkt durch, von dem Sie abhängen.
Die Web Unlocker API übernimmt die Entsperrung, und Ihr Code kontrolliert Läden und Kanäle, während die Target Scraper API auch Parsing und Wartung übernimmt. Um zu wählen, führen Sie eine Stichprobe Ihrer Produkte und Postleitzahlen auf beiden über die kostenlose Stufe aus, die 5.000 Anfragen pro Monat ohne Kreditkarte umfasst, und vergleichen Sie die Preise.
FAQ
Hat Target eine öffentliche Produkt-API?
Nein, Targets Entwicklerportal ist nur für Target-Mitarbeiter, Target Plus-Verkäufer und Partner. Die Website ruft interne JSON-APIs auf redsky.target.com mit einem API-Schlüssel aus ihren Seiten auf, und diese Endpunkte können sich ohne Vorwarnung ändern. Bright Datas Target Scraper API gibt Produktdatensätze aus einer URL und einer Postleitzahl zurück.
Wie erhält man Target-Produktpreise nach Laden?
Rufen Sie Targets Produkt-API mit einer Store-ID und seinem öffentlichen API-Schlüssel auf, um den Preis jeder Variante an diesem Laden zu erhalten. Ein weiterer Endpunkt bildet eine Postleitzahl auf die nächstgelegene Store-ID ab. Eine Standort-ID von 3991 markiert Targets Online-Preis, nicht einen Ladenpreis. Bright Datas Target Scraper API gibt Preise für die von Ihnen gesendete Postleitzahl zurück.
Kann man Target-Bestand nach Laden verfolgen?
Ja, in unseren Tests gab Targets product_fulfillment_v1-Endpunkt eine Einheitenanzahl sowie den Versand-, Abhol- und Ladenstatus für den angefragten Laden zurück. Ein New Yorker Laden hatte 0 Einheiten und ein nahegelegener Laden hatte 6, während der Versand den Artikel auf Lager zeigte. Speichern Sie Bestand pro Laden und pro Kanal.
Wie viel kostet es, Target-Daten zu scrapen?
Die Kosten wachsen mit der Anzahl der Produkte, Läden und täglichen Aktualisierungen. Die tägliche Verfolgung von 5.000 Produkten in 50 Läden bedeutet 7,5 Millionen Anfragen oder Datensätze pro Monat. Bright Data berechnet Web Scraper API-Datensätze bei Lieferung, Web Unlocker API-Anfragen bei Erfolg und Residential-Proxys pro GB. Jede Preisseite listet aktuelle Tarife auf.
Wie scrapt man Target-Produkte kostenlos?
Bright Datas kostenlose Stufe umfasst 5.000 Anfragen pro Monat ohne Kreditkarte und deckt sowohl die Target Scraper API als auch die Web Unlocker API ab, sodass Sie Preise an Ihren eigenen Produkten testen können. Einfache HTTP-Anfragen sind kostenlos, aber Targets Bot-Prüfung blockierte in unseren Tests Clients mit Standardeinstellungen von US-IPs.