In diesem Artikel erfahren Sie:
- Was das Datenschwungrad-Modell ist.
- Was eine KI-Datenschwungrad-Strategie ist und warum Unternehmen sie benötigen.
- Wie man ein KI-Datenschwungrad mit Bright Data-Diensten implementiert.
Legen wir los!
Was ist das Datenschwungrad-Modell?
Das Schwungrad-Modell ist ein von Jim Collins entwickeltes Konzept aus seinem Buch “Good to Great”. Durch eine vergleichende Studie identifizierte Collins die Faktoren, die Unternehmen eine dauerhaft hohe und über die Zeit aufrechtzuerhaltende Leistung ermöglichen.
In diesem Zusammenhang ist die Idee des Schwungrads besonders treffend für den zugrunde liegenden Prozess. Wenn man schrittweise Kraft auf ein Schwungrad ausübt, nehmen seine Rotationsgeschwindigkeit und sein Schwung mit der Zeit zu, bis es nicht mehr aufzuhalten ist. In genau diesem Moment arbeitet das Schwungrad für Sie, und Sie müssen seinen Schwung nur noch mit kleinen Kräften aufrechterhalten.
Dieses Konzept ist für Unternehmen bedeutsam, da die Rolle von Daten in den letzten Jahrzehnten zunehmend wichtiger geworden ist. Aus diesem Grund, inspiriert von Collins’ Idee, begannen Unternehmen das Datenschwungrad-Modell anzuwenden.
Dies ist ein Modell, bei dem das Sammeln, Verarbeiten und Nutzen von Informationen einen kontinuierlichen Feedback-Kreislauf erzeugt. Das Kernprinzip ist einfach: Daten optimieren Prozesse, die hochwertigere Informationen liefern, und dieses Wissen treibt weitere Gewinne voran. Im Laufe der Zeit erzeugt dieser Kreislauf unaufhaltbaren Schwung, genau wie Kräfte es mit einem Schwungrad tun.
Das Datenschwungrad-Modell in Unternehmen
Für Unternehmen lässt sich das Datenschwungrad-Modell in seiner einfachsten Form wie folgt darstellen:
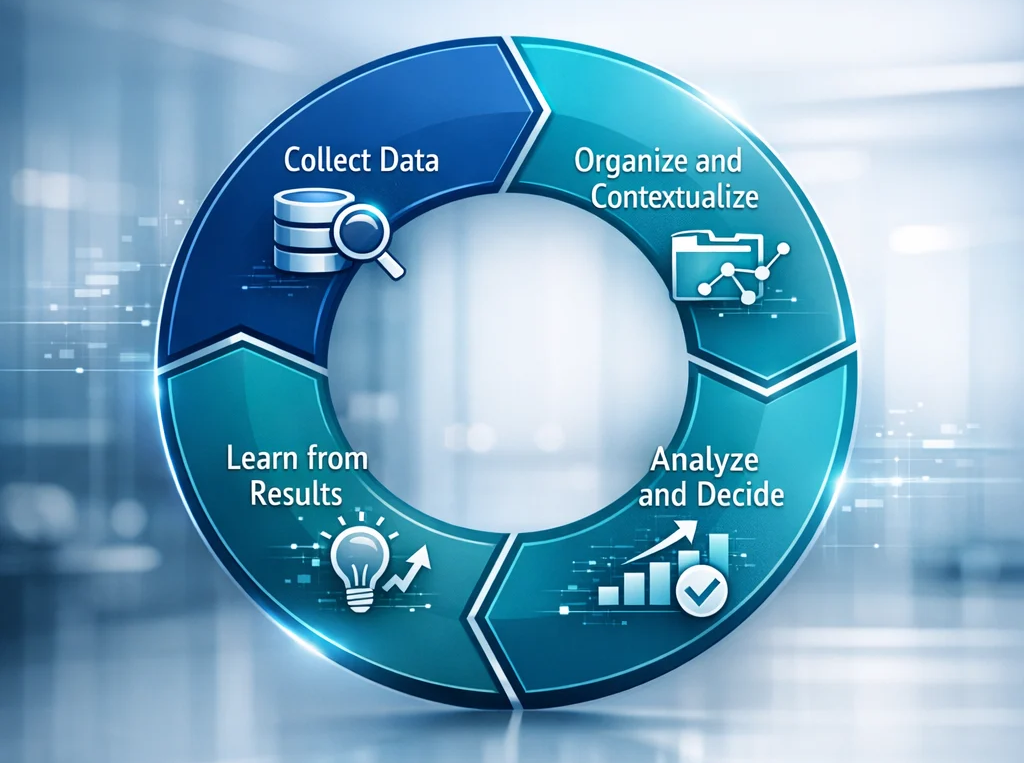
Im Folgenden wird erklärt, wie es funktioniert:
- Daten sammeln: Der Datenerfassungsschritt kann verschiedene Quellen umfassen, wie interne Unternehmensdaten, Web-Daten und Kundeninteraktionen mit Ihren Produkten oder Dienstleistungen.
- Organisieren und kontextualisieren: Nachdem die Daten gesammelt wurden, besteht der nächste Schritt darin, sie zu organisieren und für die Analyse vorzubereiten.
- Analysieren und entscheiden: Sobald die Daten ordnungsgemäß organisiert sind, können Sie sie analysieren, um Muster, Abweichungen und aufkommende Trends zu finden. Dies hilft Ihnen, genaue und datengestützte Entscheidungen zu treffen.
- Aus Ergebnissen lernen: Ergebnisse erzeugen neue Eingaben und machen das System in nachfolgenden Zyklen intelligenter.
Was ist ein KI-Datenschwungrad?
Mit dem Aufstieg von LLMs erhielten Unternehmen die Möglichkeit, ihre datengesteuerten Prozesse mit KI zu verbessern. Hier begann das KI-Datenschwungrad aufzusteigen. Das Konzept ähnelt dem vorherigen, aber der zugrunde liegende Prozess ist umfangreicher.
Ein KI-Datenschwungrad-Kreislauf ist ein sich selbst verstärkender Zyklus, bei dem aus verschiedenen Quellen gesammelte Daten KI-Modelle kontinuierlich verbessern. Nachfolgend ein Schema, das zeigt, wie dies auf hoher Ebene für Unternehmen funktioniert:
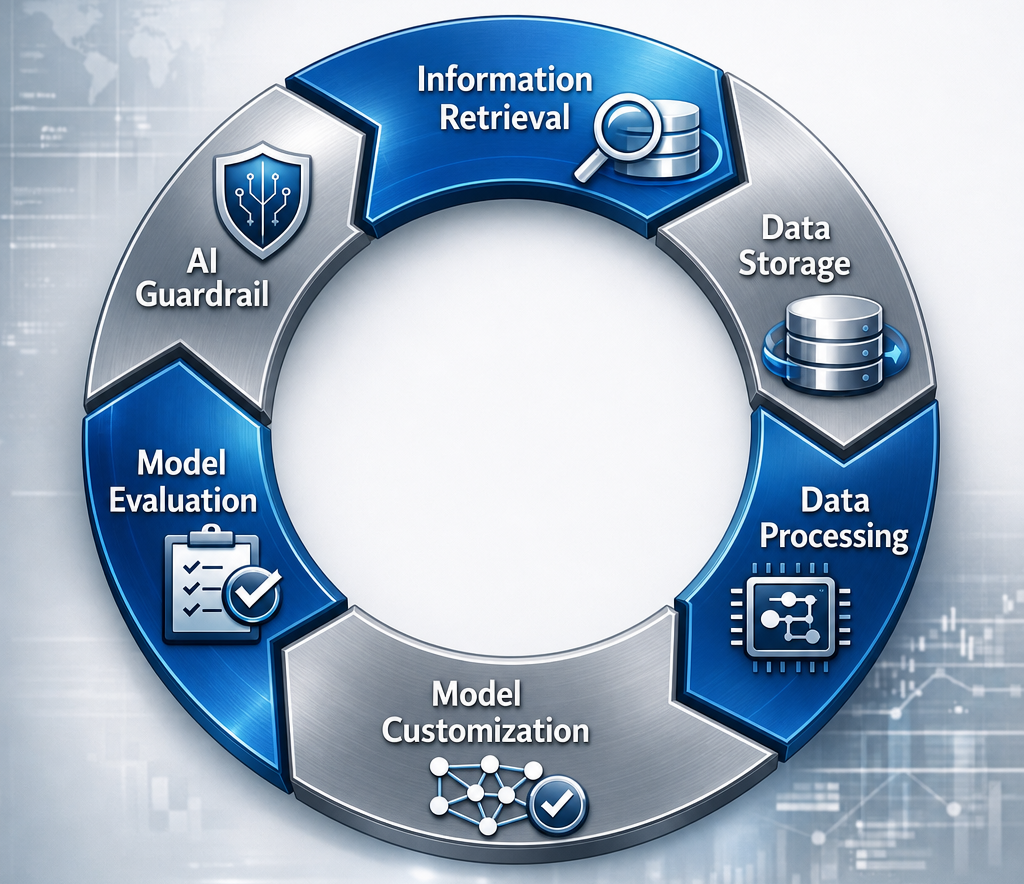
In diesem Fall ist der Kreislauf wie folgt:
- Informationsabruf: Ein KI-Datenschwungrad-Zyklus beginnt mit dem Sammeln von Unternehmensdaten aus verschiedenen Quellen wie dem Web, internen Wikis und Dokumentationen, Support-Anfragen und -Antworten, Kundeninteraktionen mit Chatbots und mehr. Das bedeutet auch, dass die Daten in verschiedenen Formen abgerufen werden können, darunter Text, Bilder und Videos.
- Datenspeicherung: Der Kern jeder Datenstrategie, insbesondere für Unternehmen, beruht darauf, wie Daten gespeichert werden. Da LLMs sowohl strukturierte als auch unstrukturierte Daten verarbeiten können, muss ein mit einer KI-Datenschwungrad-Strategie kompatibles Datenspeichersystem alle benötigten Datentypen speichern können.
- Datenverarbeitung: Die Datenverarbeitung ist der Schritt im Kreislauf, der Daten aus dem Speicher extrahiert und verfeinert. Hier werden Rohdaten gefiltert, um Rauschen zu entfernen, und für die LLM-Verarbeitung vorbereitet.
- Modellanpassung: In diesem Schritt umfasst Ihr KI-Datenschwungrad Modellverbesserungen auf Basis von Prozessen wie begleitetem Fine-Tuning oder Mixture of Experts (MoE). Einfach ausgedrückt, speisen Sie LLMs mit den gesammelten und verarbeiteten Daten und nutzen diese, um die Fähigkeiten der Modelle zu verbessern. Aus geschäftlicher Sicht bedeutet dies, dass die LLMs neue Fähigkeiten erlernen und neues Wissen erlangen, das speziell aus Ihrer Unternehmensdatensammlung stammt.
- Modellbewertung: Die Anpassung von LLMs garantiert nicht automatisch, dass die erhaltenen Ausgaben sofort für Ihre Anwendung und Ihren spezifischen Anwendungsfall geeignet sind. Sie müssen die Modellleistung bewerten und sie gegebenenfalls so lange verbessern, bis die Ergebnisse mit Ihren Geschäftszielen übereinstimmen.
- KI-Leitplanken: Unternehmen benötigen konforme und sichere Daten. KI-Leitplanken sind die Systeme, die sicherstellen, dass Ihre LLMs in Übereinstimmung mit Ihren Richtlinien reagieren.
Warum benötigen Ihre Unternehmenspipelines eine KI-Datenschwungrad-Strategie?
Datenpipelines wurden nach einer linearen Logik aufgebaut: Daten fließen von einer Quelle zu einem Ziel, werden unterwegs transformiert und speisen nachgelagerte Systeme. Traditionell werden diese Datenpipelines ETL (Extract, Transform, Load) genannt. Dieser Ansatz ist funktional, lässt aber viel Wert ungenutzt, weil diese Pipelines statisch sind.
In einer von KI geprägten Geschäftswelt sind statische Pipelines nicht mehr ausreichend, da sie Daten verarbeiten, aber nicht daraus lernen. Genau hier verändert ein KI-Datenschwungrad die Gleichung.
Durch die Einbettung eines sich selbst verstärkenden Kreislaufs in Ihre Unternehmensdateninfrastruktur hören Ihre Pipelines auf, passiv zu sein, und werden zu aktiven Treibern kontinuierlicher Verbesserung. Auf diese Weise erzeugt jede Interaktion, Anfrage oder Transaktion, die Ihre KI-Systeme verarbeiten, neue Daten. Sobald neue Informationen in den Kreislauf zurückgeführt werden, macht es diese Systeme genauer und auf Ihre Geschäftsziele ausgerichtet.
Im Laufe der Zeit übersetzt sich dieser kumulative Effekt in greifbare Unternehmensvorteile wie:
- Reduzierte Betriebskosten.
- Schnellere und zuverlässigere Entscheidungsfindung.
- KI-Modelle, die leistungsfähiger werden, während Ihr Unternehmen wächst.
Mit anderen Worten: Je mehr Ihre Pipelines arbeiten, desto intelligenter werden sie. Und je intelligenter sie werden, desto mehr Wert liefern sie an das Unternehmen zurück.
Vorteile einer KI-Schwungrad-Strategie
Bei richtiger Implementierung gehen die Vorteile einer KI-Datenschwungrad-Strategie über die Modellleistung hinaus. So können Unternehmen von der Implementierung eines solchen Modells profitieren:
- Kontinuierliche Modellverbesserung: Im Gegensatz zu statischen KI-Bereitstellungen, die mit der Zeit an Qualität verlieren, wenn sich Datenverteilungen verschieben, stellt ein KI-Datenschwungrad sicher, dass Ihre Modelle ständig mit frischen Daten verfeinert werden. Jede neue Interaktion wird zu einem Trainingssignal, was bedeutet, dass Ihre KI-Systeme genauer und relevanter werden – ohne kostspielige manuelle Neutrainingszyklen von Grund auf.
- Kumulativer Wettbewerbsvorteil: Der Schwungradeffekt ist von Natur aus kumulativ. Unternehmen, die den Zyklus früher beginnen, sammeln proprietäre Datenbestände und Modellverbesserungen an, die Wettbewerber nicht replizieren können. Im Laufe der Zeit entsteht ein struktureller Graben: Je länger das Schwungrad dreht, desto schwieriger wird es für Wettbewerber, den Abstand zu schließen.
- Reduzierung der Betriebskosten im großen Maßstab: Je leistungsfähiger KI-Modelle durch aktives Lernen werden, desto komplexere Aufgaben können sie mit weniger menschlichem Eingriff bewältigen. Dies führt zur Automatisierung repetitiver Arbeitsabläufe in hohem Volumen.
- Schnellere und genauere Entscheidungsfindung: Eine KI-Schwungrad-Strategie stellt sicher, dass die Modelle, die Ihre Analysetools antreiben, mit den aktuellsten und kontextuell relevantesten Daten gespeist werden. Dies reduziert die Latenz zwischen Ereignissen und Erkenntnissen und ermöglicht es der Führungsebene, nahezu in Echtzeit auf genauen Informationen zu handeln.
- Tiefe Unternehmenspersonalisierung: Während das Schwungrad Interaktionsdaten von Kunden, internen Nutzern und Geschäftsprozessen aufnimmt, entwickeln KI-Modelle ein granulares Verständnis unternehmensspezifischer Muster und Bedürfnisse. Dies ermöglicht ein Maß an Personalisierung, das allgemeine KI-Modelle nicht erreichen können.
- Verbesserte Datenverwaltung und Compliance: Ein gut strukturiertes KI-Schwungrad integriert Leitplanken und Bewertungsebenen direkt in den Kreislauf. Das bedeutet, dass Compliance und Sicherheit eingebettete Kontrollpunkte sind, die Modellausgaben kontinuierlich gegen sich entwickelnde regulatorische und geschäftliche Anforderungen validieren.
Wie Bright Data Ihnen helfen kann, eine KI-Datenschwungrad-Strategie zu implementieren
Bright Data-Dienste befinden sich an der Spitze des KI-Datenschwungrad-Zyklus und helfen Ihnen, aktuelle Daten aus dem Web abzurufen, insbesondere dank der folgenden Dienste:
- Web-Daten-Marktplatz: Eine Sammlung von 350+ KI-bereiten Datensätzen, die über 250 Domänen abdecken. Sie werden in mehreren Formaten wie JSON, CSV und Parquet über Cloud-Lieferung und andere Verteilungsmethoden bereitgestellt.
- Web-Scraping-Produkte: Eine Suite von API-basierten Lösungen für die Live-Web-Datenextraktion, die Folgendes umfassen:
– SERP-API: Liefert strukturierte Suchergebnisse von Suchmaschinen wie Google, Bing und anderen in Echtzeit.
– Crawl-API: Führt skalierbares Website-Crawling für strukturierte Datenextraktion durch.
– Scraper-APIs: Decken 120+ Websites für direkte Datenextraktion aus beliebten Domänen ab.
- MCP-Server: Der Bright Data MCP-Server ermöglicht KI-Anwendungen den Zugriff auf, die Entdeckung von und die Extraktion von Web-Daten in Echtzeit. Er erlaubt Ihnen, KI-Agenten zu erstellen, die mit Clients wie Claude Desktop, Cursor und allen anderen MCP-kompatiblen Lösungen verbunden sind, um das Web in Echtzeit zu durchsuchen, Aktionen durchzuführen und Daten abzurufen, ohne blockiert zu werden.
Was Bright Data auszeichnet, ist seine unternehmenstaugliche Scraping-Infrastruktur, die auf Folgendem basiert:
- Ein Residential-Proxy-Netzwerk mit 400M+ IPs, verteilt über 195 Länder, das eine hochskalierbare und gleichzeitige Web-Datenerfassung unterstützt.
- Konform mit GDPR, CCPA und anderen hochrangigen Datenschutz- und Sicherheitszertifizierungen wie ISO27001, SOC2 und mehr.
Was Bright Data besonders geeignet für eine KI-Datenschwungrad-Strategie macht, ist seine Integrationsfähigkeit. Daten sind nutzbar, solange sie in Ihrem Unternehmensdatenspeicher gespeichert sind. Bright Data-Dienste lassen sich nahtlos in Snowflake, S3-Buckets und mehrere andere Cloud-Anbieter (GCP, Azure, AWS usw.) integrieren. Dies ermöglicht es Ihnen, Bright Data-Dienste zu integrieren und dabei den Speicherdienst Ihrer Wahl weiterhin zu verwenden.
Wie man eine KI-Datenschwungrad-Strategie mit Bright Data implementiert
Die Implementierung einer KI-Datenschwungrad-Strategie erfordert die Zusammenstellung der richtigen Dienste auf jeder Ebene des Kreislaufs. Wie zuvor eingeführt, passt Bright Data in die Datenabrufschicht und fungiert als Einstiegspunkt des Zyklus.
Nachfolgend finden Sie eine übergeordnete Architektur, wie eine KI-Datenschwungrad-Strategie mit Bright Data-Diensten auf der Erfassungsebene implementiert werden kann:
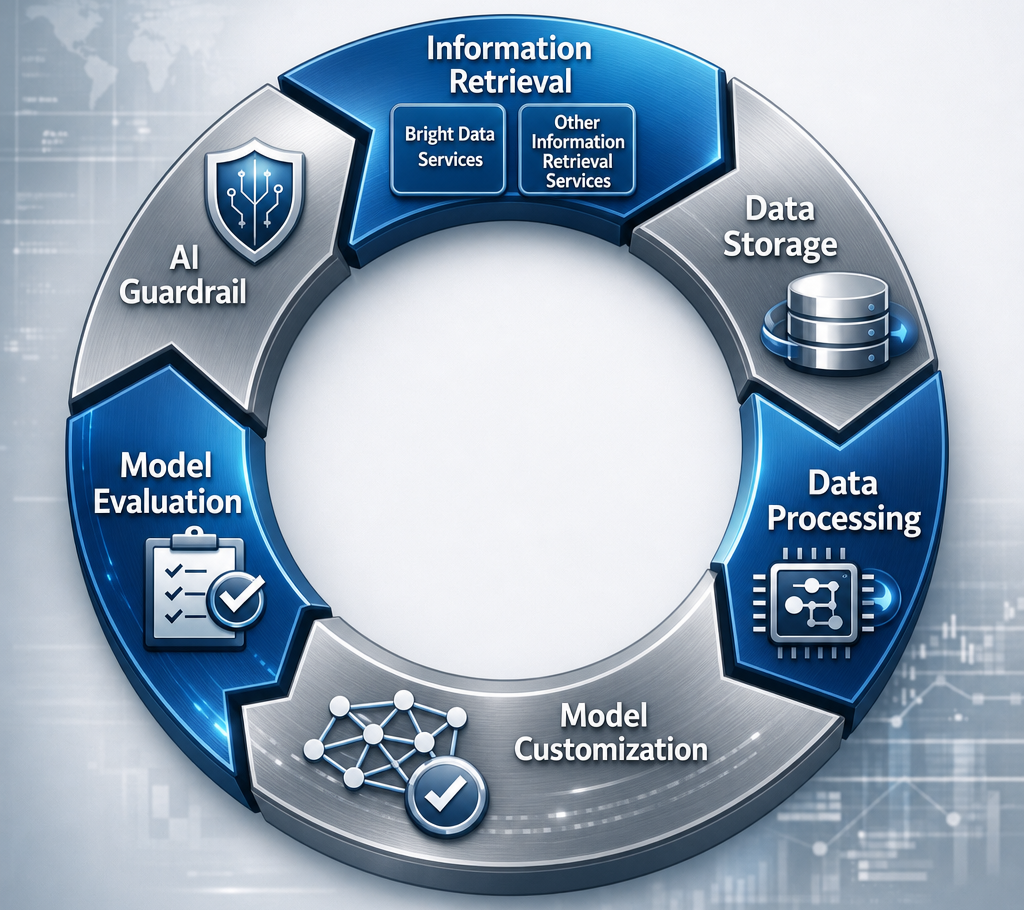
Mit dieser Architektur im Hinterkopf wollen wir uns zwei konkrete Unternehmensanwendungsfälle ansehen, bei denen Bright Data das Schwungrad antreibt.
Wettbewerbsanalyse für Finanzdienstleistungen
Finanzinstitute operieren in Märkten, in denen sich die Bedingungen schnell ändern. Preise, Stimmung, regulatorische Aktualisierungen und die Positionierung von Wettbewerbern ändern sich nahezu in Echtzeit. Ein statischer Datensatz, selbst ein aktueller, wird schnell veraltet.
In diesem Kontext kann ein von Bright Data angetriebenes KI-Datenschwungrad wie folgt strukturiert werden:
- Datenabruf: Nutzen Sie die SERP-API und Scraper-APIs von Bright Data, um strukturierte Daten aus Finanznachrichtenquellen, Ergebnisberichten, Regulierungsbehörden und Plattformen wie Reddit zur Erfassung der Nutzerstimmung zu sammeln.
- Datenspeicherung und -verarbeitung: Gescrapte Daten fließen über Bright Datas native Integration in eine Snowflake-Instanz, wo sie bereinigt, dedupliziert und mit kontextuellen Metadaten angereichert werden, bevor sie für die Modellverarbeitung verfügbar gemacht werden.
- Modellanpassung: Ein LLM wird regelmäßig am aktualisierten Korpus feinabgestimmt, um sein Verständnis domänenspezifischer Finanzbegriffe, Wettbewerbsstrategien und Marktmuster zu verbessern.
- KI-Anwendung: Das verfeinerte Modell treibt ein internes Analysetool an, das Wettbewerbserkenntnisse aufzeigt, regulatorische Risiken markiert und automatisierte Briefings für Analysten und Entscheidungsträger erstellt.
- Schwungrad-Feedback: Interaktionen mit dem Tool werden als neue Trainingssignale protokolliert. Diese Signale fließen in die Speicherschicht zurück und veranlassen eine neue gezielte Datenerfassung für die vom Modell aufgedeckten Lücken.
Im Laufe der Zeit spezialisiert sich das Modell zunehmend auf den spezifischen Marktfokus der Institution und baut ein proprietäres Informationskapital auf, das kein handelsübliches KI-Produkt replizieren kann.
Optimierung der Kundenerfahrung für E-Commerce
Für große E-Commerce-Unternehmen ist es eine große Herausforderung, mit den Kundenerwartungen Schritt zu halten. Produktpräferenzen verschieben sich, Wettbewerberpreise ändern sich täglich, und die Kundenstimmung entwickelt sich auf Dutzenden von Plattformen. Sich auf periodische Umfragen oder vierteljährliche Überprüfungen zu verlassen, ist nicht mehr ausreichend, um wettbewerbsfähig zu bleiben.
In diesem Szenario kann das KI-Datenschwungrad, das mit Bright Datas Angebot aufgebaut wurde, wie folgt funktionieren:
- Datenabruf: Bright Datas Scraper-APIs extrahieren strukturierte Produktbewertungen, Bewertungen und Q&A-Inhalte von Plattformen wie Amazon, Trustpilot und Google Shopping. Alternativ können Sie KI-bereite Datensätze vom Web-Daten-Marktplatz herunterladen, der Ihnen verschiedene Aktualisierungsoptionen bietet.
- Datenspeicherung und -verarbeitung: Extrahierte Daten landen über Bright Datas native Cloud-Lieferung in einem S3-Bucket, wo sie verarbeitet und für die LLM-Verarbeitung vorbereitet werden.
- Modellanpassung: Ein LLM wird mit den gescrapten und verarbeiteten Daten feinabgestimmt. Dies ermöglicht es dem Modell, ein granulares Verständnis davon zu entwickeln, wie echte Kunden Produktbedürfnisse, Schmerzpunkte und Zufriedenheitstreiber beschreiben.
- KI-Anwendung: Das feinabgestimmte Modell treibt personalisierte Produktempfehlungen, proaktive Support-Antworten und dynamische Preisvorschläge an, die auf die Marktpositionierung abgestimmt sind.
- Schwungrad-Feedback: Jede Kundeninteraktion mit dem System erzeugt neue Verhaltenssignale. Diese werden in die Datenpipeline zurückgeleitet, um sie zu aktualisieren und das Modell zu verfeinern.
Das Ergebnis ist ein System, das sein Verständnis der Kundenbedürfnisse schärft, die Abwanderung reduziert und Wettbewerber übertrifft, die auf manuelle Analysesysteme angewiesen sind.
Vor- und Nachteile der Implementierung einer KI-Datenschwungrad-Strategie
Wie bei jeder Unternehmensinitiative bietet die Einführung einer KI-Datenschwungrad-Strategie sowohl große Chancen als auch Herausforderungen. Das Verständnis beider Seiten der Gleichung ist für Unternehmen, die klug investieren und realistische Erwartungen setzen wollen, unerlässlich.
👍 Vorteile:
- Selbsttragende Wertschöpfung: Sobald das Schwungrad ausreichend Schwung erreicht, erzeugt es Verbesserungen autonom. Unternehmen müssen nicht mehr ständig Ressourcen einspritzen, um Gewinne zu sehen, da sich der Zyklus selbst verstärkt und im Laufe der Zeit mit proportional geringerem Grenzaufwand steigende Erträge liefert.
- Proprietäre Daten als strategisches Kapital: Das Schwungrad fördert die systematische Datenerfassung und -vorverarbeitung, die im Laufe der Zeit eine proprietäre Datengrundlage aufbaut, die einzigartig für Ihr Unternehmen ist. Dieses Kapital ist von Wettbewerbern nicht replizierbar und wird zu einer der verteidigungsfähigsten Quellen langfristiger Wettbewerbsvorteile.
- Skalierbarkeit ohne proportionales Kostenwachstum: Da KI-Modelle, die durch das Schwungrad trainiert werden, zunehmend leistungsfähiger werden, können Unternehmen den Betrieb skalieren, ohne einen entsprechenden Anstieg bei Mitarbeiterzahl oder Infrastrukturausgaben.
- Ausrichtung zwischen KI und Unternehmenskontext: Kontinuierliches Nachtraining mit unternehmensspezifischen Daten stellt sicher, dass Modelle eng auf die Sprache, Prozesse und Ziele Ihrer Organisation ausgerichtet bleiben. Mit anderen Worten: Sie beginnen mit einem allgemeinen LLM und enden mit einem spezialisierten Modell, das ein einzigartiges und tiefgründiges Wissen über Ihre Geschäftsbedürfnisse hat.
👎 Nachteile:
- Hohe Anfangsinvestition: Die Initiierung eines KI-Datenschwungrads erfordert erhebliches anfängliches Kapital. Der Aufbau oder die Integration von Speicher-, Verarbeitungs- und Modellanpassungssystemen ist ein Unterfangen, das Investitionen in Technologie und Talent erfordert, bevor ein Ertrag sichtbar ist.
- Anforderungen an Expertise und Talente: Ein KI-Datenschwungrad auf Unternehmensebene zu betreiben, ist keine Aufgabe, die allgemeine IT-Teams übernehmen können. Es erfordert spezialisierte Expertise in den Bereichen Datentechnik, MLOps und KI. Diese Profile sind selten und kostspielig.
- Langsamer Start, verzögerte Erträge: Die Schwungrad-Metapher selbst impliziert, dass der frühe Schwung schwer aufzubauen ist. In den Anfangsphasen sind die Vorteile bescheiden und die Kosten hoch. Sie müssen auf eine verlängerte Anlaufzeit vorbereitet sein, bevor die kumulativen Effekte des Zyklus messbar und bedeutsam werden.
- Komplexität bei Governance und Compliance: Mit zunehmendem Volumen und zunehmender Vielfalt der durch das Schwungrad fließenden Daten wächst auch die Angriffsfläche für regulatorische Risiken. Unternehmen, die in mehreren Rechtsgebieten tätig sind, müssen sicherstellen, dass Datenerfassung, -speicherung und Modelltraining-Praktiken mit Rahmenbedingungen wie GDPR und CCPA konform bleiben.
Fazit
In diesem Artikel über das KI-Datenschwungrad haben Sie erfahren, woher das Konzept des Schwungrads stammt und was eine KI-Datenschwungrad-Strategie ist. Sie haben auch gesehen, warum dies für Ihr Unternehmen wichtig ist und wie Bright Data Ihnen bei der Implementierung helfen kann.
Bright Data tritt in der KI-Informationsabrufschicht in Aktion und hilft Ihnen, Daten aus dem Web zu extrahieren, ohne die Scraping-Infrastruktur selbst verwalten zu müssen. Dank seiner unternehmenstauglichen Infrastruktur und breiten Integrationsfähigkeiten können Sie die benötigten Daten scrapen und in den Diensten speichern, die Sie bereits nutzen.
Erstellen Sie kostenlos ein Bright Data-Konto, um unsere Web-Datenlösungen zu integrieren!