Datenpipeline-Architektur ist das Design des Systems, das Daten von Quellen zu Menschen, Modellen und Agenten bewegt. Es definiert, wie Daten gesammelt, gespeichert, geprüft, transformiert und bereitgestellt werden.
Wenn öffentliche Websites eine Quelle sind, kann eine Pipeline einen Erfolg protokollieren, während ein Händler eine Länderauswahlseite statt Preise liefert. Von einer Heimverbindung aus riefen 4 Open-Source-Clients jeweils 13 Such- und Listingseiten 3-mal ab. Von 88 Erfolgsantworten enthielten 39 keine nutzbaren Daten.
Dieser Leitfaden zeigt, wie man jede Stufe gestaltet, ein Muster wählt, diese Fehler erkennt und entscheidet, was gebaut oder gekauft werden soll.
TL;DR
- Prüfen Sie auf die erwarteten Daten, nicht auf Blockseiten. Ein Blockseiten-Detektor markierte nur 8 von 39 Erfolgsantworten ohne Daten.
- Modellieren Sie jedes Feld auf seiner eigenen Granularität. Amazon teilt eine Bewertungssumme über die Varianten eines Listings, daher überhöhte die Zeilensumme die Bewertungszahl von 20 Produkten um 23%.
- Bei hohem Volumen sollte ein LLM den Parser schreiben, nicht jede Seite lesen. Der Hauptinhalt einer Amazon-Seite verbrauchte das 19-fache der Token ihres 12-Felder-Datensatzes.
- Vergleichen Sie Collector nach Kosten pro akzeptiertem Datensatz. Im Fetch-Test hatten 39 von 88 Erfolgsantworten keine Daten, zählen Sie also nur Zeilen, die Ihren Datenvertrag erfüllen.
Diagramm und Stufen der Datenpipeline-Architektur
Eine typische Datenpipeline-Architektur hat 5 Stufen. Jede Stufe erledigt eine Aufgabe, und die nächste Stufe kann ihr Ergebnis prüfen:
- Sammeln. Daten aus jeder Quelle abrufen, mit Change Data Capture für Datenbanken, API-Aufrufen für SaaS-Tools und HTTP- oder Browser-Anfragen für Websites.
- Roh speichern. Die Daten genau so, wie sie ankamen, in Object Storage schreiben, vor jeglichem Parsing. In einer Medallion-Architektur bilden diese Rohdaten die Bronze-Schicht.
- Validieren. Jeden Datensatz gegen einen Datenvertrag prüfen, der erforderliche Felder, Typen und Bereiche auflistet. Fehlerhafte Datensätze mit einem Grundcode in Quarantäne senden.
- Transformieren. Daten in einem Warehouse oder Lakehouse deduplizieren, verknüpfen und modellieren. Silber-Tabellen enthalten validierte Zeilen, Gold-Tabellen sind einsatzbereit.
- Bereitstellen. Das Ergebnis an Dashboards, Anwendungen, Modelle und KI-Agenten liefern.
Ein Orchestrator wie Airflow, Dagster oder Prefect plant die Stufen. Monitoring verfolgt Aktualität, Volumen, Feldfüllraten und Kosten pro akzeptiertem Datensatz über alle Stufen hinweg.
Data Pipelining ist der allgemeine Begriff für den Bau und Betrieb von Pipelines, und “Data Pipes” ist eine informelle Bezeichnung für die Pipelines selbst. ETL (Extract, Transform, Load) ist ein Muster darin, und ELT ist ein anderes, das Rohdaten zuerst lädt und sie im Warehouse transformiert.
Eine Big-Data-Pipeline-Architektur nutzt dieselben 5 Stufen bei einem Volumen, bei dem Speicher und Rechenleistung getrennt skalieren müssen. Sie hält Daten daher meist in Object Storage und offenen Tabellenformaten.
Öffentliche Webdaten fügen einen Discovery-Schritt hinzu, der die zu sammelnden URLs findet, und die SERP-API kann diesen aus Suchergebnissen ausführen. Für das Sammeln liefert die Bright Data Web Scraper API strukturierte Datensätze von öffentlichen Websites. Web Unlocker handhabt Bot-Abwehr und liefert die Rohseite für Teams, die eigene Parser schreiben.
Dieses Diagramm der Datenpipeline-Architektur zeigt, wie die Stufen verbunden sind, wenn öffentliche Websites eine der Quellen sind:
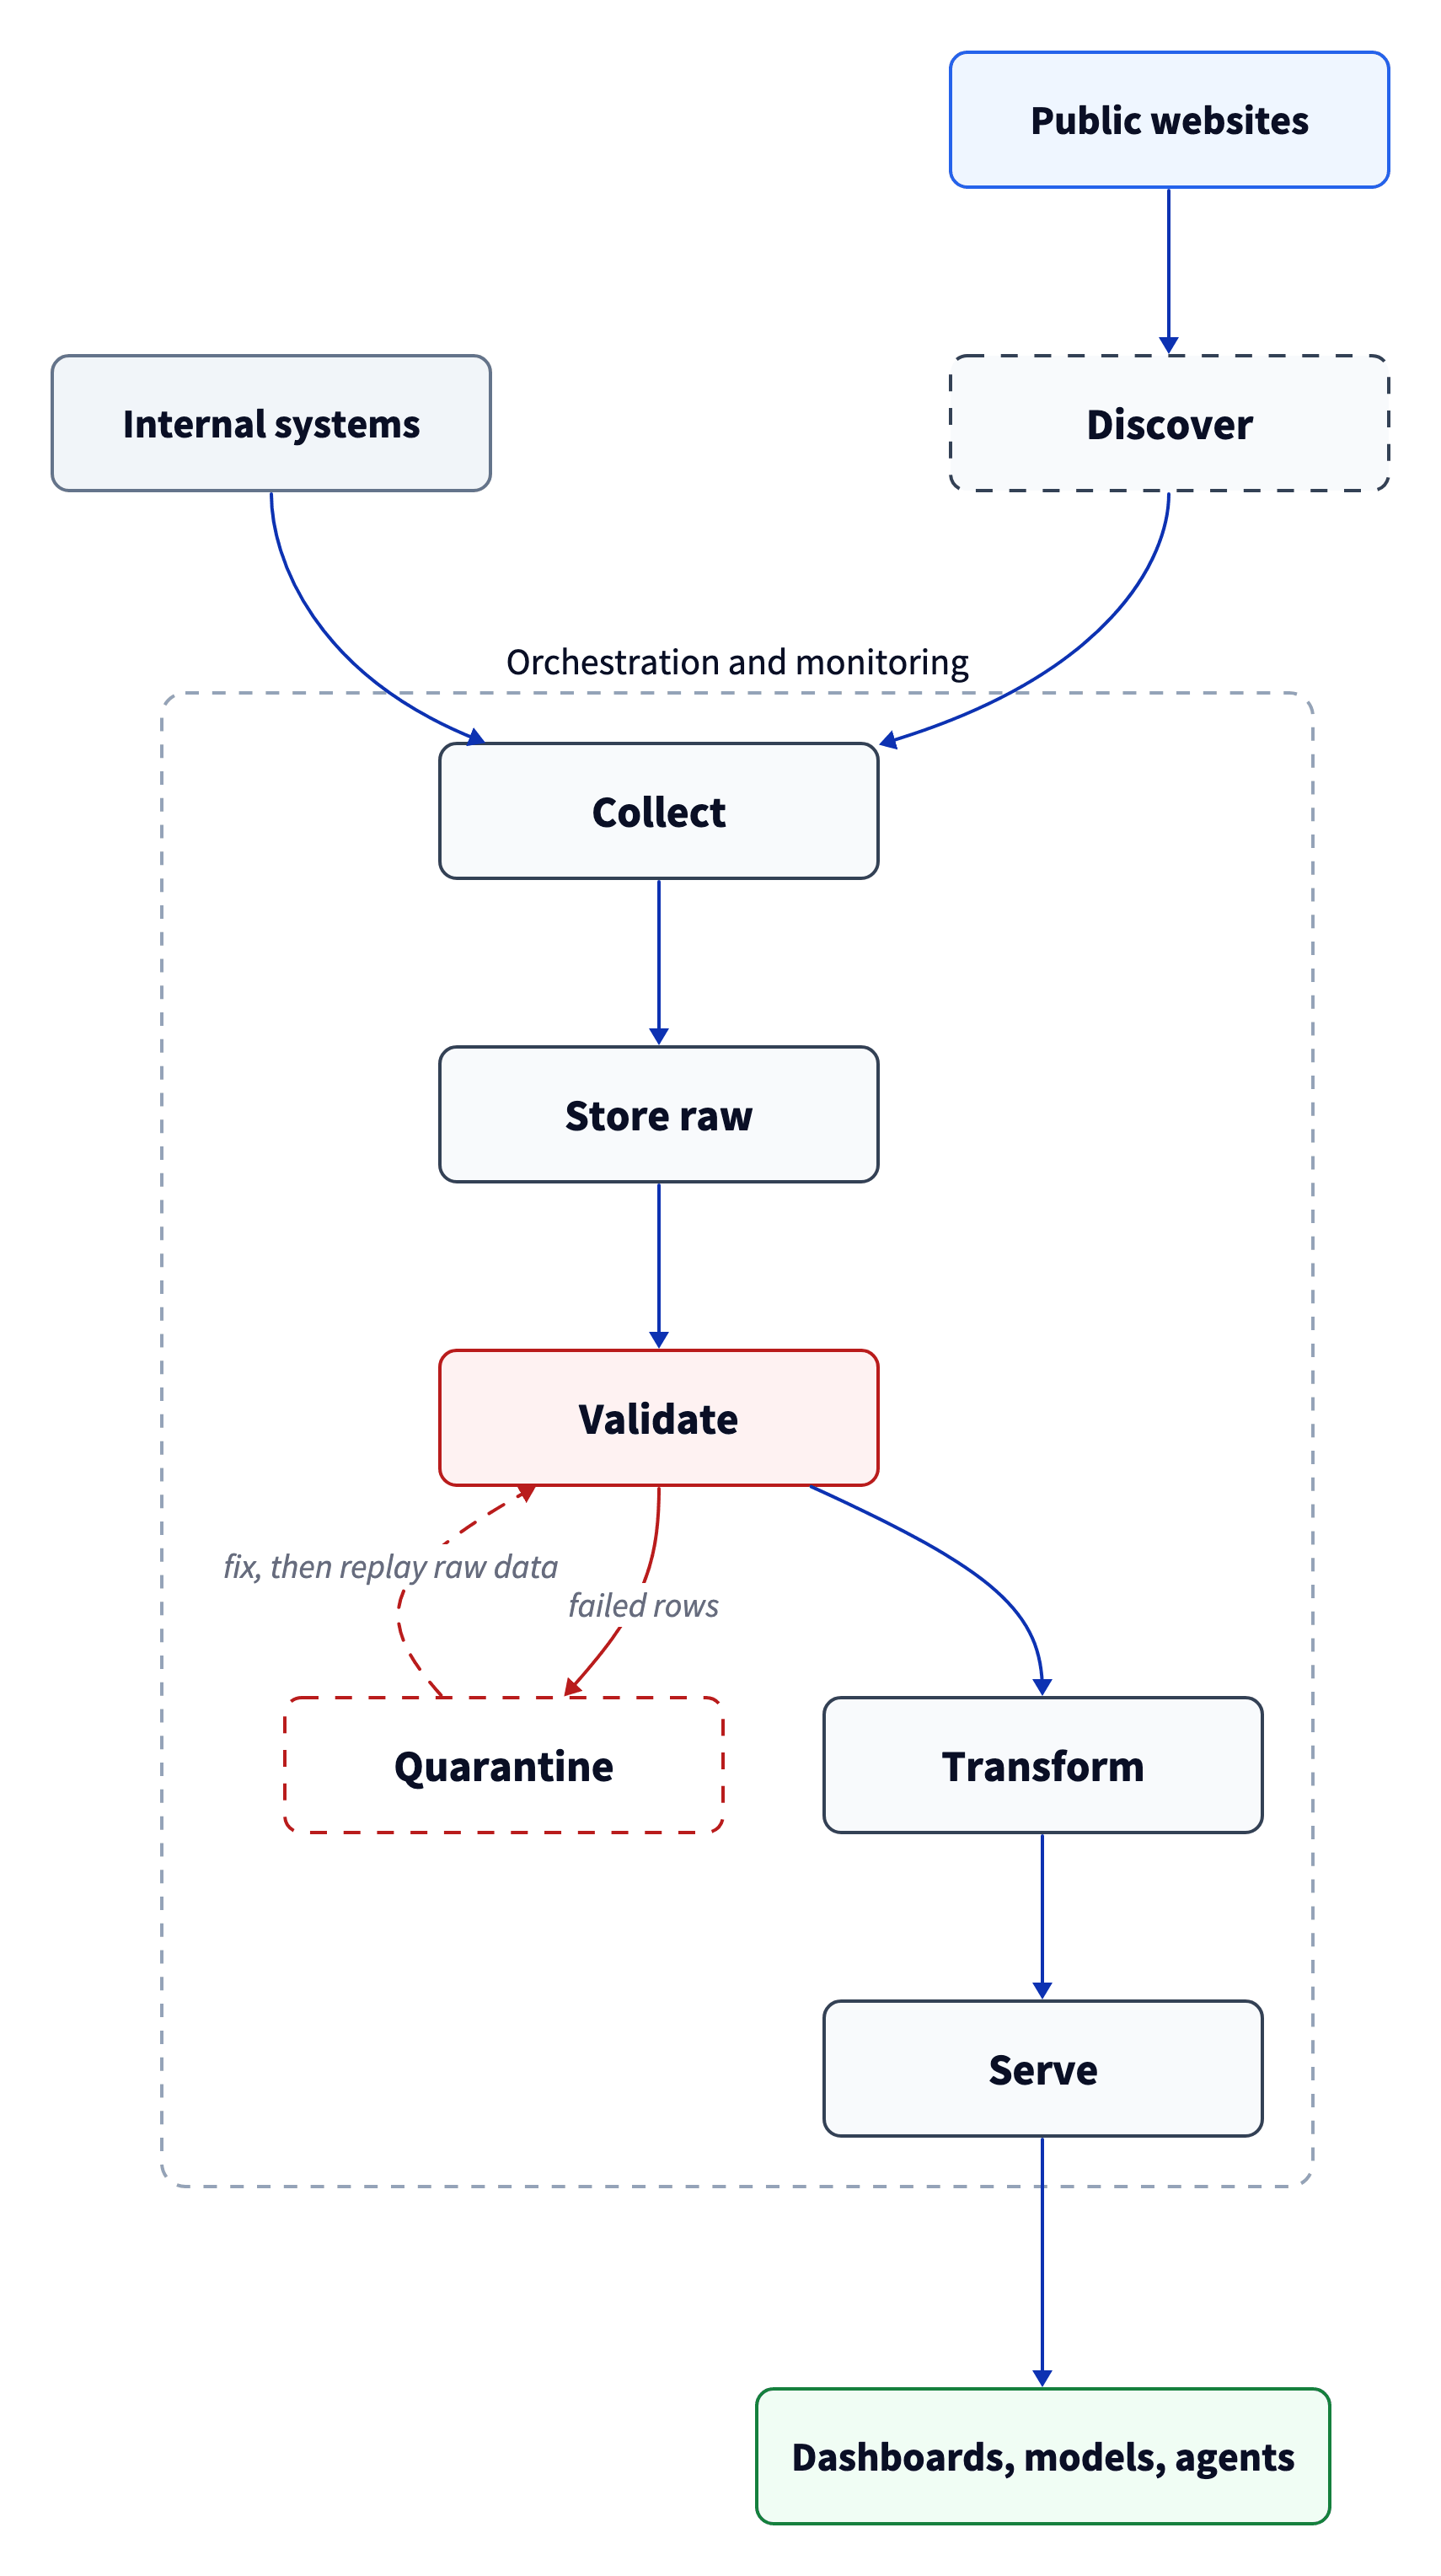
Webquellen erzeugen den meisten Aufwand bei der Validierungsstufe und auf dem Quarantäne-Pfad.
Beispiele für Batch-, Streaming-, Hybrid- und On-Demand-Datenpipeline-Architektur
Das richtige Muster hängt davon ab, wie schnell die Entscheidung neue Daten benötigt.
Batch. Ein Händler sammelt jede Nacht Konkurrenzpreise für 50.000 Produkte, und ein Repricing-Agent liest sie am Morgen. Die Web Scraper API kann jeden Durchlauf direkt an Ziele wie Amazon S3, Google Cloud Storage oder Snowflake liefern.
Streaming. Ein Marken-Team überwacht Social-Posts und Nachrichten, da eine Erwähnung innerhalb von Stunden an Wert verlieren kann. Kafka transportiert die Events, ein Stream-Prozessor wie Flink berechnet Zählungen über Zeitfenster, und ein Connector schreibt die Ergebnisse in eine Iceberg-Tabelle. Für ein Beispiel mit Spark siehe den Leitfaden zu Spark Structured Streaming mit Webdaten.
Hybrid. Ein Investment-Research-Team führt einen täglichen Batch von Stellenanzeigen für die Historie und streamt Preisänderungen für eine kurze Watchlist von Produkten. Ältere Designs führten dies als 2 getrennte Pfade aus, bekannt als Lambda-Architektur. Viele neuere Stacks schreiben den Stream in eine Iceberg-Tabelle, sodass Batch- und Streaming-Jobs dieselben Daten lesen.
On Demand. Ein Shopping-Agent prüft den Live-Preis und Bestand eines Produkts, wenn ein Benutzer fragt. Die Pipeline liefert die neueste validierte Zeile, es sei denn, sie ist älter als die Entscheidung erlaubt. Falls ja, liefert eine synchrone Web Scraper API-Anfrage einen aktuellen Datensatz in einem Aufruf, und die Pipeline prüft ihn gegen denselben Vertrag. Geben Sie der Live-Abfrage ein für den Benutzer akzeptables Timeout, und falls es abläuft, antworten Sie mit der gespeicherten Zeile und ihrem Alter.
Standards für eine moderne Datenpipeline-Architektur
Beginnen Sie ein neues Datenpipeline-Design mit diesen Standards für jede Schicht:
| Schicht | Standard | Warum |
|---|---|---|
| Speicher und Tabellen | Rohdateien in Object Storage, Tabellen in einem offenen Format wie Apache Iceberg | Snowflake, Databricks und Open-Source-Engines lesen dieselben Iceberg-Tabellen, sodass eine Datenkopie alle bedienen kann |
| Transformation | SQL-Modelle in Versionskontrolle, erstellt mit einem Tool wie dbt | Modelle erhalten Code-Review und Tests wie jeder andere Code |
| Orchestrierung | Eine unterstützte Version von Airflow, Dagster oder Prefect | Prüfen Sie das Support-Fenster, bevor Sie beginnen. Airflow 2 erreichte sein End of Life im April 2026 |
| Datenverträge | Eine Vertragsdatei pro Tabelle, in einem Format wie dem Open Data Contract Standard (ODCS) | ODCS kann auch festlegen, wie KI-Agenten die Daten nutzen dürfen, sodass Nutzungsregeln mit Typen und Eigentümern gespeichert sind |
| Agentenzugriff | Eine Model Context Protocol (MCP)-Schnittstelle über verwaltete Tabellen | Die meisten Agenten-Frameworks unterstützen MCP, und ein Linux Foundation-Projekt pflegt es |
Wenn Sie noch AWS Data Pipeline betreiben, planen Sie eine Migration, da AWS es 2024 für Neukunden geschlossen hat.
Warum öffentliche Webdaten eine andere Data-Ingestion-Pipeline benötigen
Im Gegensatz zu internen Quellen koordinieren öffentliche Websites ihre Änderungen nicht mit Ihrem Team. Sie können Markup und Bot-Abwehr ohne Vorankündigung ändern, Inhalte je nach Standort oder Client variieren und einen Erfolgsstatus ohne Daten zurückgeben. Interne Quellen ändern sich meist auf geplante Weise, etwa durch eine Schema-Migration oder eine neue API-Version.
Ein Erfolgsstatus garantiert nicht, dass Daten angekommen sind
Ein 2xx-Status zeigt nur, dass ein Server geantwortet hat. Ein Fetch-Test auf 13 Such- und Listingseiten zeigt, was ein 2xx-Status verbergen kann. Die Seiten stammten von Einzelhandels-, Reise-, Job-, Immobilien-, Bewertungs- und Suchseiten.
Jeder von 4 gängigen Open-Source-Clients rief jede Seite 3-mal ab, von einer Heiminternetverbindung in Indien aus, ohne Proxys. Eine Antwort zählte nur dann als Daten, wenn sie die HTML-Muster enthielt, die die Listings dieser Seite kennzeichnen. Ihr Anteil an leeren Erfolgsantworten wird je nach Client und Netzwerk variieren, also messen Sie ihn mit einer Inhaltsprüfung wie der unten.
| Client | 2xx-Antworten | 2xx-Antworten ohne Daten | Seiten mit Daten in einem der 3 Abrufe (von 13) |
|---|---|---|---|
Python requests, Standard-Header |
15 | 9 | 2 |
Python requests, Chrome-Header |
24 | 10 | 5 |
curl_cffi mit Chrome-Imitation |
29 | 9 | 7 |
| Headless Chrome (Playwright) | 20 | 11 | 3 (8 bei einem erneuten Durchlauf mit normalem User-Agent) |
Über alle Clients hinweg hatten 39 von 88 Erfolgsantworten keine nutzbaren Daten, 27 mit HTTP 200 und 12 mit HTTP 202. Ein Statuscode konnte einen fehlgeschlagenen Abruf markieren, aber keinen guten bestätigen.
Eine der 39 war diese Seite, die ein Händler mit HTTP 200 an die Heimverbindung in Indien lieferte, statt Suchergebnisse:
Gerendert aus dem gespeicherten HTML dieser Antwort.
Die Fehler sahen nicht wie Fehler aus. Ein aus 8 gängigen Blockseiten-Signaturen gebauter Detektor, etwa Press-and-Hold- und Unusual-Traffic-Seiten, markierte nur 8 von 39. Der Rest waren Challenge-Seiten, die die Liste nicht abdeckte, die Länderauswahlseite eines Händlers, nur-JavaScript-Seiten und 670-KB-Seiten mit leeren Ergebnissen.
Die 670-KB-Seiten sahen bis auf einen leeren Ergebnisbereich vollständig aus:
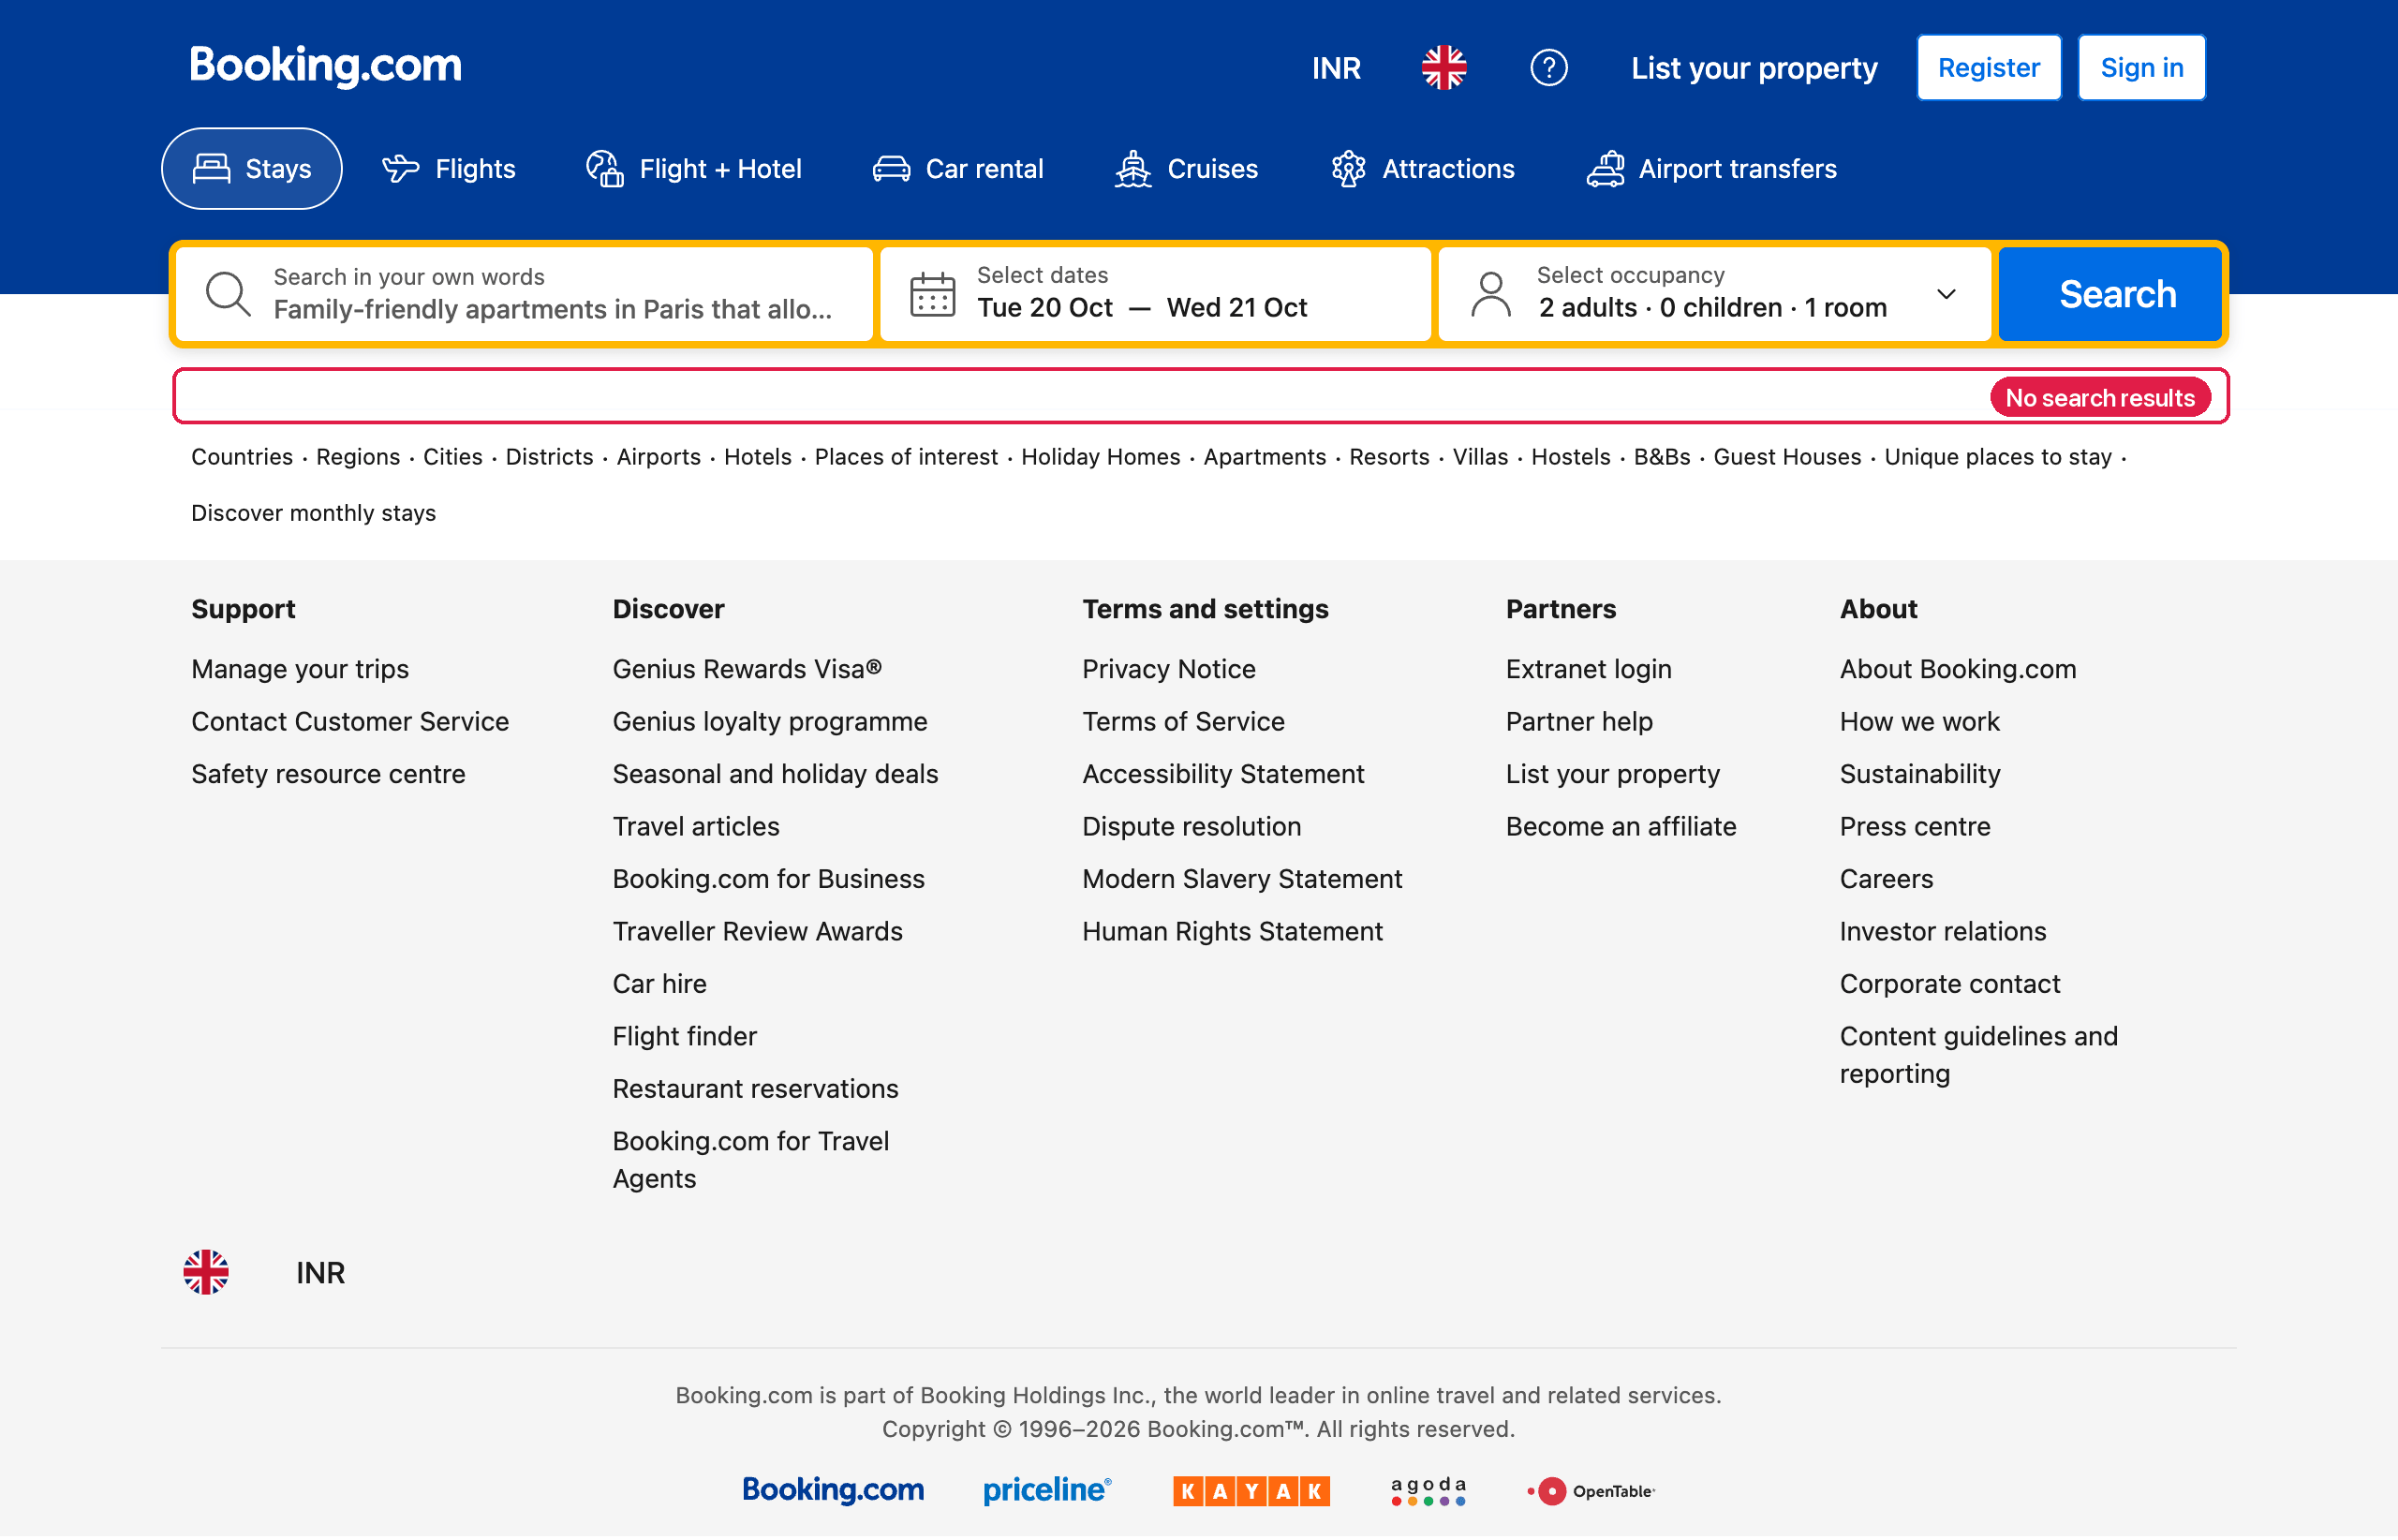
Die Seite, die Headless Chrome mit HTTP 202 erhielt, gerendert aus dem gespeicherten HTML. Eine Prüfung der Antwortgröße hätte sie bestehen lassen.
Derselbe Detektor markierte 12 von 49 guten Antworten als blockiert. Auf 2 der Seiten lädt ein Bot-Abwehr-Skript auch auf normalen Listingseiten, und sein Tag passte zu einer der Signaturen. Prüfen Sie auf die erwarteten Daten, nicht auf eine Blockseite.
Bot-Abwehr vergleicht Clients mit echten Browsern
Websites können einen Client erkennen, bevor HTML gesendet wird, indem sie seinen TLS-Fingerabdruck und Header mit denen echter Browser vergleichen. Bei einer Fingerabdruck-Prüfung passte der TLS-Fingerabdruck von Web Unlocker zu dem eines aktuellen installierten Chrome. Zum Testzeitpunkt lag das neueste Chrome-Ziel in der curl_cffi-Imitationsbibliothek 5 Hauptversionen hinter dem installierten Chrome zurück. Headless Chrome erhielt Daten von nur 3 der 13 Seiten, solange sein User-Agent HeadlessChrome enthielt, und von 8 mit einem normalen User-Agent.
Von dieser Heimverbindung aus lieferten 5 von 13 Seiten keinem Open-Source-Client Daten, aber der Test trennte den Client nicht vom Netzwerk. Den Zugang funktionsfähig zu halten bedeutet, Browser-Releases, Fingerabdrücke, Header und IP-Reputation zu verfolgen, während sie sich ändern. Sie stellen entweder Personen dafür ein oder kaufen es, über Web Unlocker für Seiten oder die Browser API für vollständige Browser-Sitzungen.
Agenten stehen vor derselben Abwehr
Bei den 13 URLs des Fetch-Tests lieferte Claude Codes WebFetch-Tool Listings von 2 davon in einem einzigen Durchlauf. Von den anderen 11 Anfragen gaben 7 einen Fehlerstatus zurück.
Die restlichen 4 lieferten eine Challenge-Seite, eine Länderauswahlseite, eine leere Seite und eine Fehlermeldung, alle mit Erfolgsstatus. Der Agent muss den Inhalt selbst prüfen.
Für Live-Zugriff können Agenten den Bright Data MCP Server nutzen, der Suchen und Seitenabrufe über die SERP-API und Web Unlocker ausführt.
Manche Websites lassen Agenten sich auch identifizieren und erhalten Zugang zu vereinbarten Bedingungen. Seiten auf Cloudflare können Agenten verifizieren, die ihre Anfragen mit Web Bot Auth signieren. Der Really Simple Licensing (RSL)-Standard lässt eine Website Lizenzbedingungen veröffentlichen. Wo eine Seite eines davon anbietet, planen Sie, es zu nutzen.
Prüfen Sie, was der Collector meldet, nicht nur den HTTP-Status
Web Unlocker meldet das Ergebnis jedes Abrufs in 2 Antwort-Headern. x-brd-status-code enthält den Status der Zielseite. x-brd-error enthält den Grund, wenn ein Abruf fehlschlägt, wie in den Web Unlocker-Fehlercodes aufgelistet. Ihr Ingestion-Code sollte auf Basis dieser Header, des API-Aufrufstatus selbst und des Inhalts entscheiden, was zu tun ist.
Speichern Sie diese Prüfung als content_check.py. Sie löst bei einem ungültigen Schlüssel oder einer ungültigen Zone einen Fehler aus und gibt andernfalls accept, retry oder quarantine in ihrem action-Feld zurück:
import os, re, requests

# Ein Marker pro Quelle, ein Muster, das nur erscheint, wenn echte Datensätze vorhanden sind.
MARKERS = {
    "amazon_search": r'data-component-type="s-search-result"',
    "walmart_search": r'"usItemId"',
}


def fetch_and_check(source: str, url: str, min_hits: int = 5) -> dict:
    r = requests.post(
        "https://api.brightdata.com/request",
        headers={"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"},
        json={"zone": "web_unlocker", "url": url, "format": "raw", "country": "us"},
        timeout=(15, 240),
    )
    # Ein ungültiger Schlüssel oder Zonenname. Ein Retry behebt das nicht.
    if r.status_code in (400, 401, 403):
        r.raise_for_status()
    # Der Abruf scheiterte oder erreichte ein Ratenlimit. Später erneut versuchen.
    if r.headers.get("x-brd-error") or r.status_code == 429 or r.status_code >= 500:
        reason = r.headers.get("x-brd-error") or f"HTTP {r.status_code}"
        return {"source": source, "action": "retry", "reason": reason[:60]}
    hits = len(re.findall(MARKERS[source], r.text))
    action = "accept" if hits >= min_hits else "quarantine"
    return {
        "source": source,
        "action": action,
        "target_status": r.headers.get("x-brd-status-code"),
        "marker_hits": hits,
        "bytes": len(r.content),
    }


if __name__ == "__main__":
    amazon = "https://www.amazon.com/s?k=noise+cancelling+headphones"
    walmart = "https://www.walmart.com/search?q=noise+cancelling+headphones"
    print(fetch_and_check("amazon_search", amazon))
    print(fetch_and_check("walmart_search", walmart))
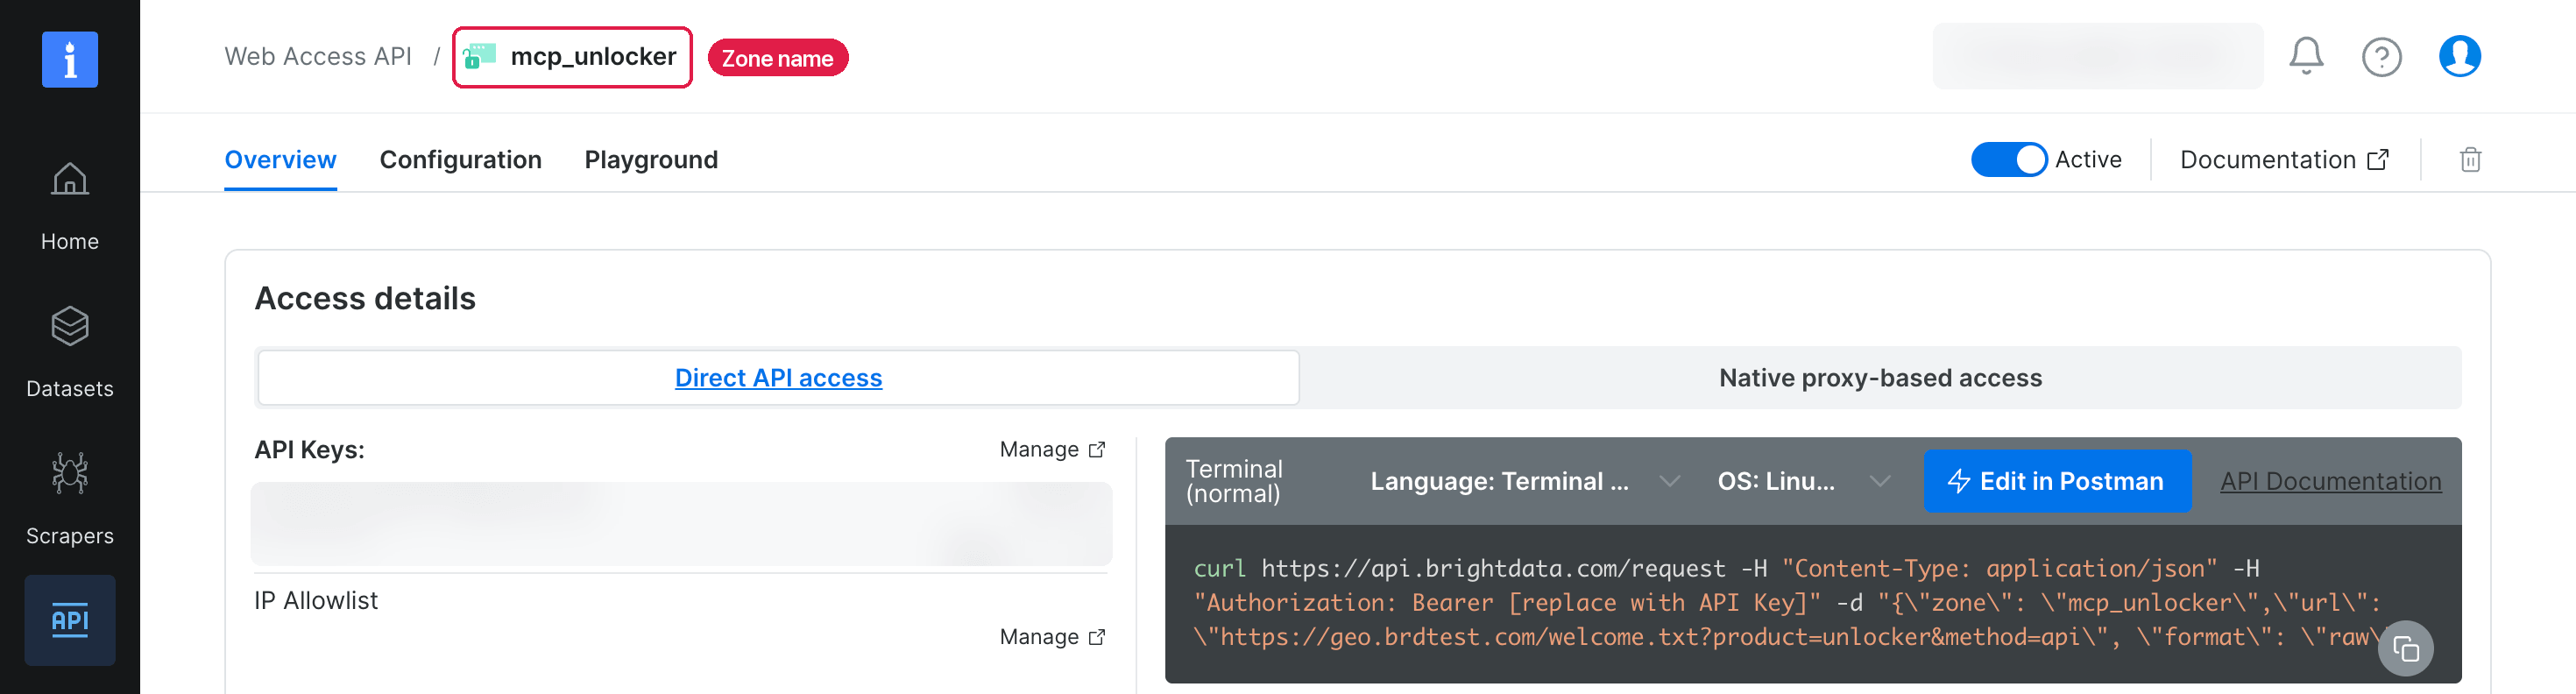
Um es auszuführen, erstellen Sie eine Web Unlocker-Zone, ein benanntes Setup für dieses Produkt, unter Web Access im Bright Data Control Panel. Neue Konten erhalten monatliche kostenlose Credits, genug, um die Skripte in diesem Leitfaden auszuführen.
Erstellen Sie einen API-Schlüssel unter Account settings im Control Panel und speichern Sie ihn in einer Umgebungsvariable namens BRIGHTDATA_API_KEY. Ersetzen Sie web_unlocker durch den Namen Ihrer Zone. Der Name erscheint oben auf der Zonenseite, und das Anfragebeispiel der Seite nutzt ihn:
Nach pip install requests führen Sie python content_check.py aus. Ein Beispieldurchlauf akzeptierte beide Seiten:
{'source': 'amazon_search', 'action': 'accept', 'target_status': '200', 'marker_hits': 16, 'bytes': 1516805}
{'source': 'walmart_search', 'action': 'accept', 'target_status': '200', 'marker_hits': 395, 'bytes': 1535496}
Ihre Pipeline wiederholt einen retry-Abruf mit Backoff und wartet nach jedem Fehlschlag länger. Eine quarantine-Seite geht an eine Person oder einen Klassifikator, da sich die Quelle geändert haben könnte. Frontends können sich ohne Vorankündigung ändern, also prüfen Sie zuerst, ob der Marker der Quelle noch im HTML der Seite erscheint, wenn eine Quelle plötzlich keine Daten mehr liefert.
Eine Referenz-Data-Ingestion-Pipeline für Webquellen
Die untenstehende Referenzpipeline nutzt die Web Scraper API, die strukturierte Datensätze liefert, sodass die Validierung Felder prüft, statt Seiten zu parsen.
Filtern Sie, was Discovery zurückgibt
Bei einer Suche nach einem Kopfhörermodell lieferte die SERP-API Googles 7 organische Ergebnisse, die AI Overview, Videos und People Also Ask als separate JSON-Felder. Google rankte nur 3 Händlerseiten unter den 7, und eine davon verkaufte ein anderes Produkt, die Earbuds-Version desselben Modells. Die Preisangabe der AI Overview zitierte als erste Quelle eine YouTube-Bewertung, keinen Händler. Behandeln Sie KI-Antworten als zu prüfende Behauptungen und filtern Sie Ergebnisse nach Domain und einem Identifikator wie einer Modellnummer.
Die Pipeline bauen und ausführen
Die Pipeline nimmt eine Liste von Produkt-URLs, etwa gefilterte Discovery-Ergebnisse. Sie startet einen Job mit dem /trigger-Endpunkt der Web Scraper API, verfolgt ihn mit /progress und lädt die Datensätze mit /snapshot herunter. Mit include_errors=true meldet die API jede fehlgeschlagene Eingabe als eigenen Datensatz mit einem error_code.
In Python ersetzt das Bright Data SDK diese 3 Aufrufe durch einen Aufruf pro Scraper. Das untenstehende Skript ruft die Endpunkte direkt auf, sodass jede Stufe sichtbar bleibt, und das Skript funktioniert mit jedem Orchestrator. Speichern Sie es als pipeline.py. Seine Funktionen folgen den Stufen im Diagramm, mit collect(), store_raw(), validate() und model() für die Tabellen, dann domain_checks() für die Markierungen:
"""Referenz-Webdaten-Pipeline, die sammelt, roh speichert, validiert, modelliert und prüft.

Sammlung: Bright Data Web Scraper API (asynchroner Trigger + Snapshot-Download).
Speicher: ein lokaler Ordner anstelle von Object Storage (Bronze), DuckDB für Silber und Gold.
"""
import json, os, sys, time, pathlib, datetime as dt
import duckdb, requests
from pydantic import BaseModel, Field, ValidationError

API = "https://api.brightdata.com/datasets/v3"
# Replay benötigt keinen Schlüssel.
HEADERS = {"Authorization": f"Bearer {os.environ.get('BRIGHTDATA_API_KEY', '')}"}
DATASET = "gd_l7q7dkf244hwjntr0"  # Amazon-Produkte, Sammlung per URL
LAKE = pathlib.Path("lake")


def collect(inputs: list[dict]) -> str:
    """Eine asynchrone Sammlung auslösen und darauf warten. Gibt die Snapshot-ID zurück."""
    params = {"dataset_id": DATASET, "include_errors": "true"}
    r = requests.post(
        f"{API}/trigger", headers=HEADERS, json=inputs, params=params, timeout=60
    )
    r.raise_for_status()
    snapshot_id = r.json()["snapshot_id"]
    deadline = time.time() + 3600  # nach einer Stunde fehlschlagen, damit der Orchestrator warnen kann
    while time.time() < deadline:
        url = f"{API}/progress/{snapshot_id}"
        p = requests.get(url, headers=HEADERS, timeout=60).json()
        if p["status"] == "ready":
            summary = {k: p.get(k) for k in ("records", "errors", "error_codes")}
            print("progress:", summary)
            return snapshot_id
        if p["status"] in ("failed", "canceled"):
            raise RuntimeError(f"snapshot {snapshot_id} ended as {p['status']}")
        time.sleep(15)
    raise TimeoutError(f"snapshot {snapshot_id} not ready after 1 hour")


def store_raw(snapshot_id: str) -> pathlib.Path:
    """Den Snapshot unverändert in einen unveränderlichen, partitionierten Pfad schreiben."""
    url = f"{API}/snapshot/{snapshot_id}"
    r = requests.get(url, headers=HEADERS, params={"format": "ndjson"}, timeout=300)
    # Alles außer 200, etwa 202 während der Snapshot-Erstellung, sind keine Daten.
    if r.status_code != 200:
        raise RuntimeError(
            f"snapshot {snapshot_id} not downloadable: HTTP {r.status_code}"
        )
    day = dt.datetime.now(dt.timezone.utc).date()
    path = LAKE / "bronze/amazon_products" / f"dt={day}" / f"{snapshot_id}.ndjson"
    path.parent.mkdir(parents=True, exist_ok=True)
    if not path.exists():  # ein gespeicherter Snapshot wird nie überschrieben
        path.write_bytes(r.content)
    return path


class Product(BaseModel):
    """Der Datenvertrag, der definiert, was nachgelagerte Tabellen empfangen können."""
    asin: str = Field(pattern=r"^[A-Z0-9]{10}$")
    parent_asin: str | None = None
    title: str = Field(min_length=3)
    final_price: float = Field(gt=0, lt=100_000)
    currency: str = Field(pattern=r"^[A-Z]{3}$")
    rating: float | None = Field(default=None, ge=0, le=5)
    reviews_count: int | None = Field(default=None, ge=0)
    buybox_seller: str | None = None
    timestamp: dt.datetime


def validate(path: pathlib.Path) -> tuple[list[dict], list[dict]]:
    """Eine Rohdatei in akzeptierte Zeilen und mit Grund in Quarantäne gestellte Zeilen aufteilen."""
    accepted, quarantined = [], []
    for line in path.read_text().splitlines():
        rec = json.loads(line)
        if rec.get("error_code"):  # fehlgeschlagene Eingabe, pro Datensatz gemeldet
            quarantined.append({"input": rec.get("input"), "reason": rec["error_code"]})
            continue
        try:
            row = Product(**rec).model_dump()
            row["snapshot_file"] = path.name  # Herkunftsnachweis zurück zu den Rohbytes
            accepted.append(row)
        except ValidationError as e:
            fields = ",".join(str(x["loc"][0]) for x in e.errors())
            reason = f"contract:{fields}"
            quarantined.append({"input": rec.get("url"), "reason": reason})
    return accepted, quarantined


def model(accepted: list[dict]) -> duckdb.DuckDBPyConnection:
    """Silber idempotent laden, dann Gold-Tabellen in der richtigen Granularität bauen."""
    con = duckdb.connect(str(LAKE / "warehouse.duckdb"))
    con.execute("SET TimeZone = 'UTC'")  # jede Beobachtung in UTC speichern und anzeigen
    con.execute("""CREATE TABLE IF NOT EXISTS silver_prices (
        asin TEXT, parent_asin TEXT, title TEXT, final_price DOUBLE,
        currency TEXT, rating DOUBLE, reviews_count BIGINT, buybox_seller TEXT,
        observed_at TIMESTAMPTZ, snapshot_file TEXT,
        PRIMARY KEY (asin, observed_at))""")
    # Der Primärschlüssel macht einen erneuten Lauf zu einem No-Op statt zu einem Duplikat.
    for r in accepted:
        con.execute(
            "INSERT OR IGNORE INTO silver_prices VALUES (?,?,?,?,?,?,?,?,?,?)",
            [r["asin"], r["parent_asin"] or r["asin"], r["title"], r["final_price"],
             r["currency"], r["rating"], r["reviews_count"], r["buybox_seller"],
             r["timestamp"], r["snapshot_file"]],
        )
    con.execute("""CREATE OR REPLACE VIEW latest_prices AS
        SELECT * FROM silver_prices
        QUALIFY row_number() OVER (PARTITION BY asin ORDER BY observed_at DESC) = 1""")
    # Preis gehört zur Variante. Bewertungen gehören zum übergeordneten Listing.
    con.execute("""CREATE OR REPLACE VIEW gold_parent_reviews AS
        SELECT parent_asin, max(reviews_count) AS reviews_count, max(rating) AS rating,
               count(DISTINCT asin) AS variants_seen
        FROM latest_prices GROUP BY parent_asin""")
    return con


def domain_checks(con: duckdb.DuckDBPyConnection) -> None:
    """Jedes Produkt mit seiner vorherigen Beobachtung vergleichen. Markieren, niemals löschen."""
    con.execute("""CREATE OR REPLACE TABLE flags AS
        WITH obs AS (
            SELECT *,
                lag(final_price) OVER w AS prev_price,
                lag(currency) OVER w AS prev_currency,
                lag(reviews_count) OVER w AS prev_reviews,
                lag(buybox_seller) OVER w AS prev_seller
            FROM silver_prices WINDOW w AS (PARTITION BY asin ORDER BY observed_at))
        SELECT asin, observed_at, 'price_moved_over_30pct' AS flag FROM obs
            WHERE abs(final_price - prev_price) / prev_price > 0.3
        UNION ALL SELECT asin, observed_at, 'currency_changed' FROM obs
            WHERE currency <> prev_currency
        UNION ALL SELECT asin, observed_at, 'reviews_went_down' FROM obs
            WHERE reviews_count < prev_reviews
        UNION ALL SELECT asin, observed_at, 'reviews_jumped_over_50pct' FROM obs
            WHERE reviews_count > prev_reviews * 1.5
        UNION ALL SELECT asin, observed_at, 'buybox_seller_changed' FROM obs
            WHERE buybox_seller <> prev_seller""")


if __name__ == "__main__":
    # --replay lädt jede Bronze-Datei erneut in die Tabellen, ohne neuen Crawl.
    if sys.argv[1] == "--replay":
        raws = sorted(LAKE.glob("bronze/amazon_products/*/*.ndjson"))
    else:
        inputs = json.load(open(sys.argv[1]))
        snapshot_id = sys.argv[2] if len(sys.argv) > 2 else collect(inputs)
        raws = [store_raw(snapshot_id)]
    for raw in raws:
        ok, bad = validate(raw)
        con = model(ok)
        print(f"{raw.name}: accepted={len(ok)} quarantined={len(bad)}")
        for q in bad:
            print("quarantine:", q)
    domain_checks(con)
    print(con.sql(
        "SELECT count(*) AS rows, count(DISTINCT asin) AS asins FROM silver_prices"
    ))
    print(con.sql(
        "SELECT * FROM gold_parent_reviews WHERE variants_seen > 1 ORDER BY parent_asin"
    ))
    print(con.sql("SELECT * FROM flags ORDER BY asin"))
Der DATASET-Wert im Skript ist die ID des Amazon-Produkte-Scrapers, einer der vorgefertigten Scraper, die Bright Data pflegt. Seine Seite im Control Panel zeigt diese ID in ihrem Anfragebeispiel, neben einem zipcode-Eingabefeld:
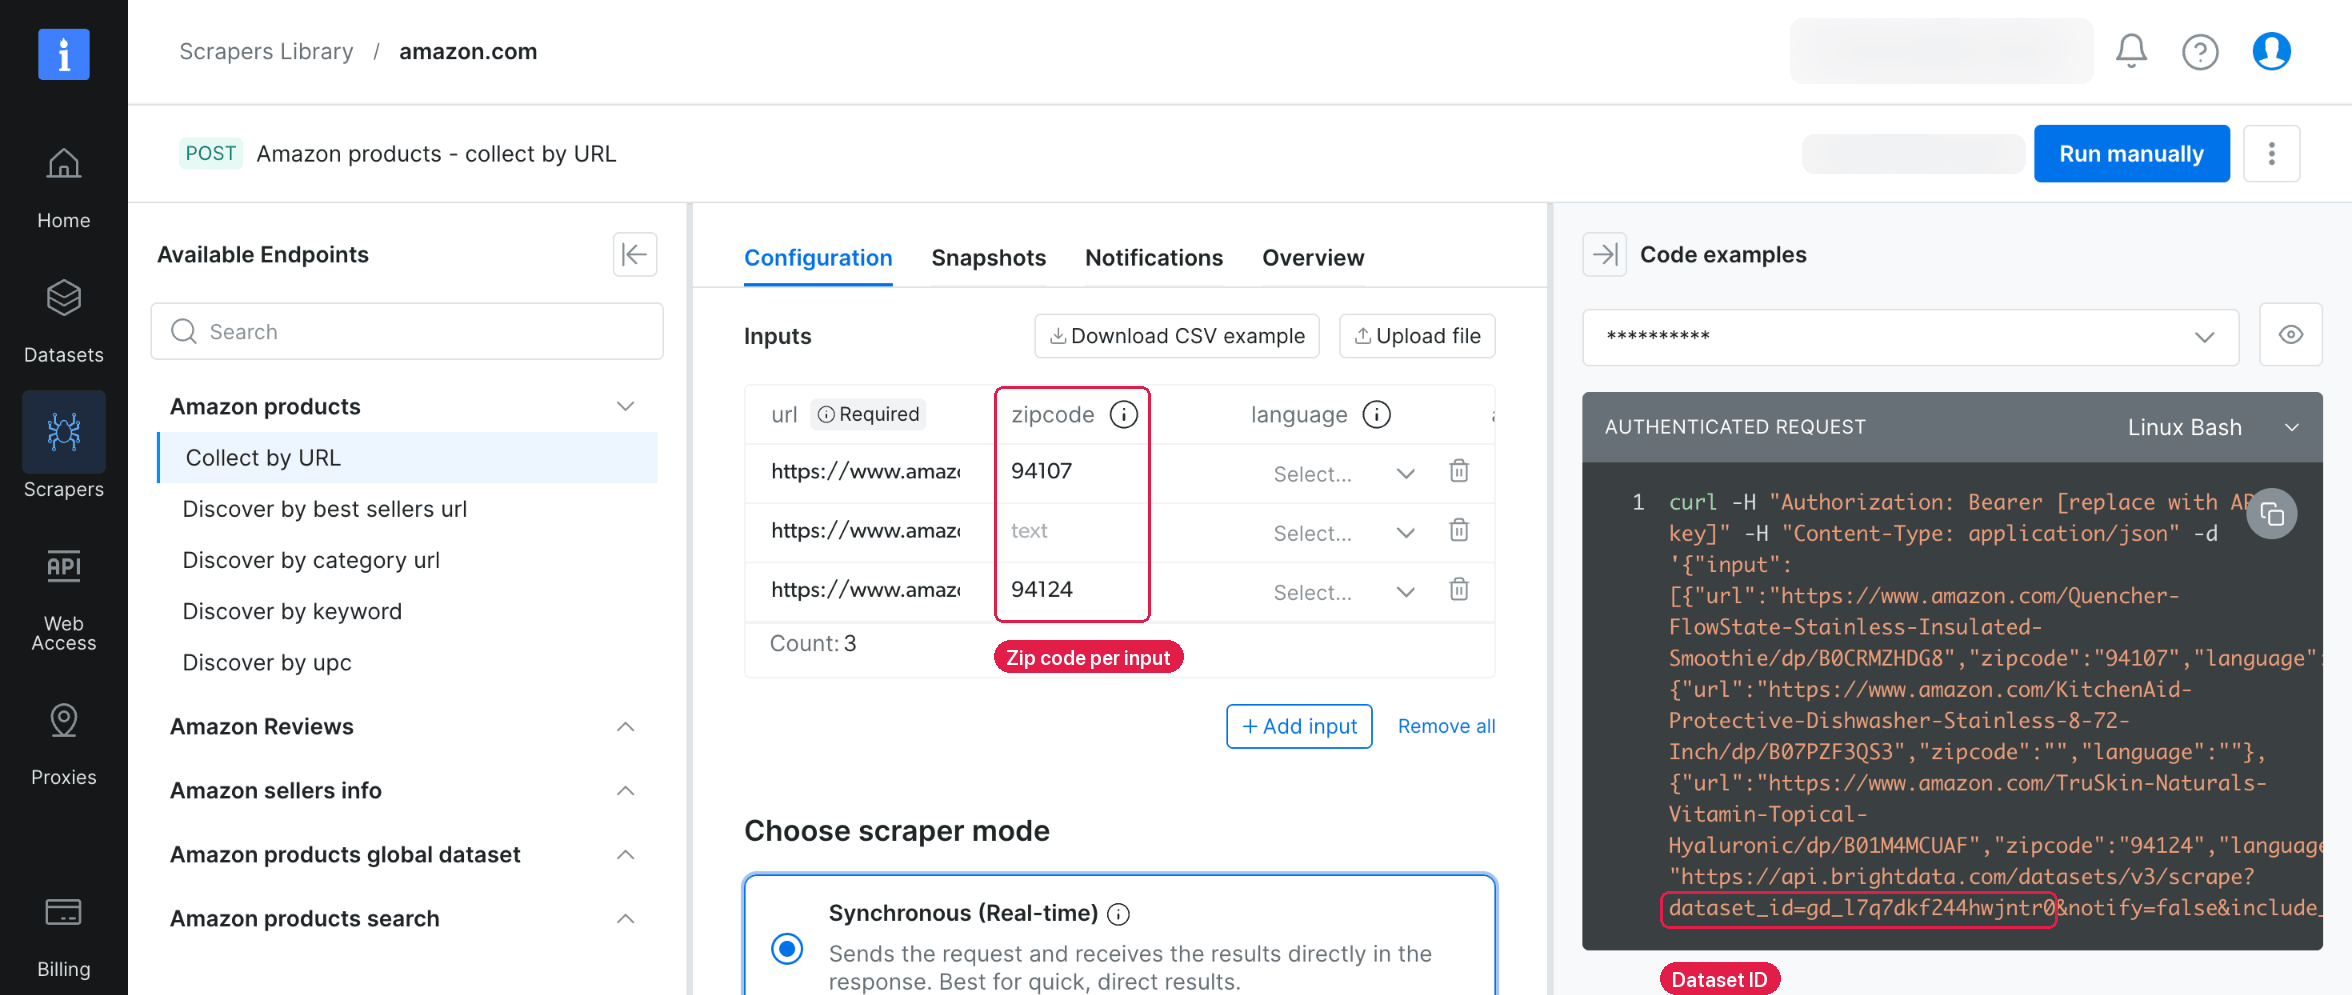
Das Anfragebeispiel der Seite nutzt den synchronen /scrape-Endpunkt, der Datensätze im selben Aufruf zurückgibt. Das Skript nutzt stattdessen /trigger, das große Batches im Hintergrund ausführt und die Ergebnisse als Snapshot liefert.
Unter Python 3.10 oder höher speichern Sie Ihre Eingaben als inputs.json im Format [{"url": "https://www.amazon.com/dp/<ASIN>", "zipcode": "<ZIP>"}], wobei <ASIN> die Amazon-Produkt-ID ist. Führen Sie dann aus:
pip install requests pydantic duckdb
export BRIGHTDATA_API_KEY="your_api_key"
python pipeline.py inputs.json
python pipeline.py --replay
Der erste python-Befehl sammelt und lädt einen Durchlauf. Der --replay-Befehl lädt jede gespeicherte Rohdatei erneut in die Tabellen, ohne die API aufzurufen. Die untenstehende Ausgabe stammt von einer Watchlist von 20 Amazon-Produkten und 1 absichtlich ungültigen ID, 2-mal etwa 2 Stunden auseinander gesammelt und dann erneut abgespielt:
sd_mvgo38o997m0dxre9.ndjson: accepted=20 quarantined=1
quarantine: {'input': {'url': 'https://www.amazon.com/dp/B0ZZZZZZZZ', 'asin': '', 'zipcode': '', 'language': ''}, 'reason': 'dead_page'}
sd_mvgsyvcx1fcvvspadf.ndjson: accepted=20 quarantined=1
quarantine: {'input': {'url': 'https://www.amazon.com/dp/B0ZZZZZZZZ', 'asin': '', 'zipcode': '', 'language': ''}, 'reason': 'dead_page'}
┌───────┬───────┐
│ rows  │ asins │
│ int64 │ int64 │
├───────┼───────┤
│    40 │    20 │
└───────┴───────┘

┌─────────────┬───────────────┬────────┬───────────────┐
│ parent_asin │ reviews_count │ rating │ variants_seen │
│   varchar   │     int64     │ double │     int64     │
├─────────────┼───────────────┼────────┼───────────────┤
│ B0FMZYMXNR  │          3015 │    4.2 │             3 │
│ B0GKGDTLG2  │           668 │    4.5 │             6 │
│ B0H1QVR9JS  │         17115 │    4.3 │             2 │
└─────────────┴───────────────┴────────┴───────────────┘

┌────────────┬────────────────────────────┬───────────────────────────┐
│    asin    │        observed_at         │           flag            │
│  varchar   │  timestamp with time zone  │          varchar          │
├────────────┼────────────────────────────┼───────────────────────────┤
│ B0FDKQZ18F │ 2026-10-20 14:53:09.044+00 │ buybox_seller_changed     │
│ B0HJ5K8WN4 │ 2026-10-20 14:53:11.293+00 │ reviews_jumped_over_50pct │
└────────────┴────────────────────────────┴───────────────────────────┘
Um die Demo einfach zu halten, setzten diese Durchläufe keine Postleitzahl, aber Produktionsdurchläufe sollten eine setzen. Die Silber-Tabelle behielt beide Beobachtungen aller 20 Produkte. Erneutes Abspielen beließ die Tabelle bei 40 Zeilen, da der Primärschlüssel doppelte Zeilen blockiert.
Designentscheidungen, die Probleme früh finden
- Rohdaten einmal schreiben und nie bearbeiten. Mit der gespeicherten Rohdatei braucht das Hinzufügen eines Felds keinen neuen Crawl. Fügen Sie es dem
Product-Vertrag und dersilver_prices-Tabelle hinzu, löschen Sielake/warehouse.duckdbund führen Sie--replayaus. Das Buy-Box-Verkäuferfeld des Skripts, das den Händler erfasst, der die Standard-In den Einkaufswagen-Schaltfläche gewinnt, wurde auf diese Weise hinzugefügt. - Jeden Download ablehnen, der nicht HTTP 200 ist. Der Snapshot-Endpunkt gibt HTTP 202 zurück, während der Job noch läuft, wie viele asynchrone APIs es tun. Code, der diese Prüfung überspringt, speichert die Warte-Nachricht als Daten. Der Vertrag stellt sie dann in Quarantäne, da der Nachricht keines der erforderlichen Felder fehlt.
- Markierungen nach der Vertragsprüfung hinzufügen und markierte Zeilen nie löschen. Eine Schemaprüfung erkennt einen fehlenden Preis, nicht einen Preis, der zur falschen Packungsgröße passt. In der obigen Ausgabe markierten die Domänenprüfungen eine Buy-Box-Verkäuferänderung und eine Bewertungszahl, die von 27 auf 52 stieg. Zählungen können auch sinken, etwa von 15 auf 14 in einem dritten Durchlauf, was wie von der Seite entfernte Bewertungen aussieht.
- Einen Grundcode in Quarantäne behalten. Eine
dead_page-Zeile bedeutet, die Eingabe-URL ist verschwunden, also entfernt sie, wer die Eingabeliste besitzt. Einecontract:-Zeile bedeutet, ein Feld fehlte oder lag außerhalb des Bereichs, also prüft ein Data Engineer die Quelle. - Zeitzone bei jedem Zeitstempel behalten. Eine Spalte ohne eine speicherte eine 14:53-UTC-Beobachtung als 20:23 Ortszeit, was Vergleiche über Quellen hinweg zerstört. Nutzen Sie
TIMESTAMPTZund UTC.
Bevor Sie die Pipeline in Produktion ausführen
Wer auch immer Ihre Daten nutzt, innerhalb oder außerhalb des Unternehmens, beurteilt jede Lieferung meist nach Abdeckung, Aktualität, Herkunft und Reproduzierbarkeit. Diese Praktiken unterstützen diese 4 Kennzahlen:
- Mit jeder Lieferung eine Laufzusammenfassung senden. Eingaben, akzeptierte Zeilen, Quarantänegründe und Markierungen auflisten, damit Nutzer genau sehen, was der Datensatz abdeckt. Prüfen Sie die Abdeckung auch gegen eine unabhängige Referenz, etwa die Sitemap der Seite, da die Metriken eines Durchlaufs nur die gesendeten Eingaben abdecken.
- Gegen den Grundwert jeder Quelle alarmieren. Einen Alarm senden, wenn die Akzeptanzrate eines Durchlaufs oder die Füllrate eines Felds unter ihren Grundwert fällt. Jedes Feld braucht seinen eigenen Grundwert, festgelegt aus seiner jüngsten Historie, etwa einem gleitenden Median der letzten 7 Durchläufe.
- Einen Schweregrad für jede Markierung festlegen. Ein Agent kann einen falschen Preis nutzen, bevor ein Analyst ihn sieht. Agenten am Lesen von Zeilen mit Preis- oder Währungsmarkierungen hindern und weniger schwerwiegende Markierungen, etwa einen kleinen Bewertungsrückgang, an eine Person senden. Auch eine tägliche Stichprobe akzeptierter Zeilen gegen ihre Quellseiten prüfen, da Regeln nur die vorhergesehenen Fehler erkennen.
- Die Prüfungen selbst messen. Falsch-Positive, Falsch-Negative, manuelle Überprüfungsrate und Vorfälle pro Quelle verfolgen. Der Blockseiten-Detektor im Fetch-Test markierte gute Seiten als blockiert, daher braucht jede Prüfung ihre eigene Fehlerrate.
- Eine Vertragsdatei behalten. Ingestion-Code und Tabellentests sollten dieselbe Datei lesen. Tools wie das Open-Source-
datacontract-clitesten eine ODCS-Datei direkt gegen Tabellen. - Den Collector benachrichtigen lassen. Der Web Scraper API-Trigger akzeptiert eine Webhook-URL in
endpointmitnotifyauftruegesetzt, sodass der Orchestrator die Validierung starten kann, sobald der Snapshot bereit ist. - Für Rohspeicher budgetieren. Eine 2,4-MB-Amazon-Seite komprimierte sich auf 449 KB, sodass das Sammeln von 100.000 Rohseiten pro Tag etwa 45 GB Speicher pro Tag hinzufügt. Der vollständige JSON-Datensatz desselben Produkts war vor der Komprimierung 24 KB groß, etwa 100-mal kleiner als die Seite. Speichern Sie jeden Rohantwortkörper mit Status und Headern in JSON oder einer WARC-Archivdatei, dann verschieben Sie alte Dateien in Cold Storage.
Modellieren Sie jedes Feld in der Granularität, die die Website nutzt
Die Granularität einer Tabelle ist, was eine Zeile darstellt, etwa eine Produktvariante oder ein übergeordnetes Listing. Ein gescrapter Datensatz sieht wie eine Zeile aus, aber seine Felder können unterschiedliche Dinge beschreiben. Auf einem Marktplatz gehört der Preis meist zur exakten Variante. Bewertungen und Bewertungszahlen gehören oft zum übergeordneten Listing, das alle Farben und Größen gruppiert.
Auf dem Amazon-Listing eines der Kopfhörer in der Watchlist erscheint die Bewertungssumme über den Farboptionen, die sie abdeckt:
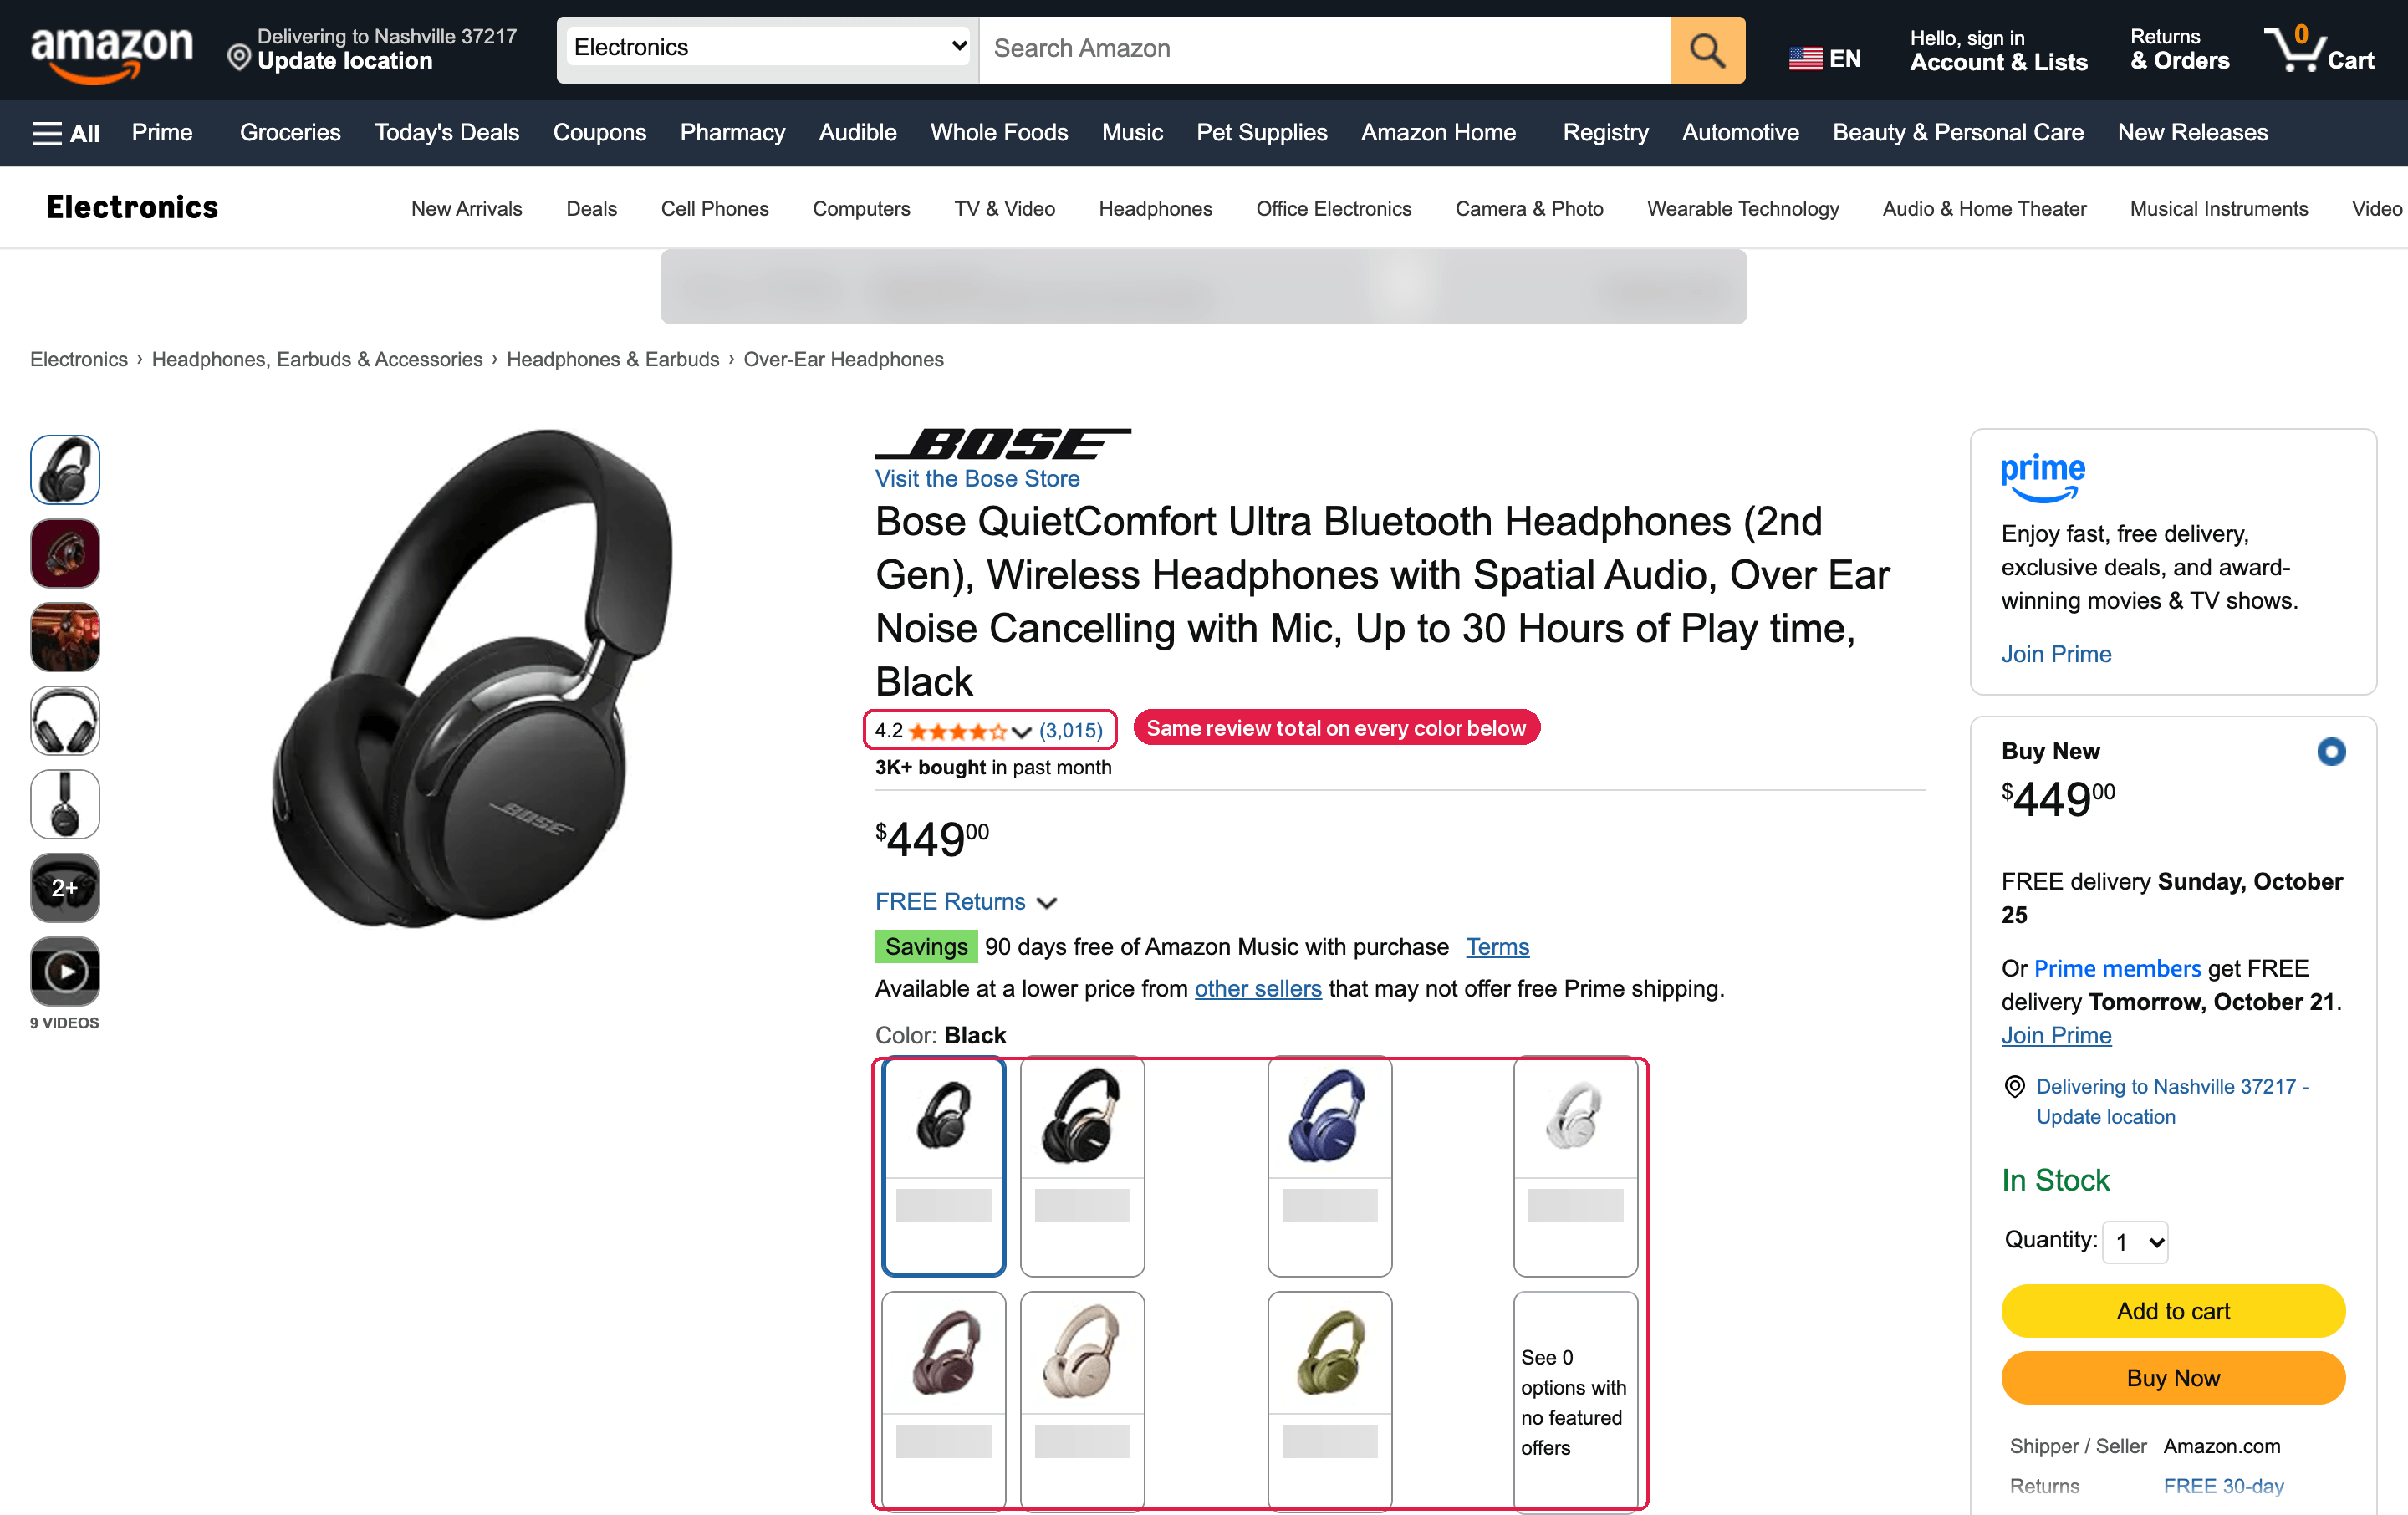
Das wie gesammelte Listing, gerendert aus dem gespeicherten HTML. Die 3 Farben in der Watchlist meldeten jeweils dieselben 3.015 Bewertungen.
In der 20-Produkte-Watchlist waren 11 Produkte Varianten von nur 3 übergeordneten Listings, etwa 6 Versionen eines Ohrschützer-Paars. Die 20 Produkte gehörten also nur zu 12 übergeordneten Listings. Eine Zeile-für-Zeile-Summe zählt die 3.015 Bewertungen der Bose-Kopfhörer dann 3-mal, einmal pro Farbe. Jeder Web Scraper API-Datensatz enthält eine parent_asin, sodass ein GROUP BY darauf jede Bewertungssumme einmal zählt:
-- Falsche Granularität: eine Bewertungssumme pro Variantenzeile
SELECT sum(reviews_count) AS naive_variant_sum FROM latest_prices;

-- Richtige Granularität: eine Bewertungssumme pro übergeordnetem Listing
SELECT sum(reviews_count) AS parent_grain_sum, count(*) AS parents
FROM gold_parent_reviews;
Auf lake/warehouse.duckdb lieferten die 2 Abfragen:
┌───────────────────┐
│ naive_variant_sum │
│      int128       │
├───────────────────┤
│            139537 │
└───────────────────┘

┌──────────────────┬─────────┐
│ parent_grain_sum │ parents │
│      int128      │  int64  │
├──────────────────┼─────────┤
│           113052 │      12 │
└──────────────────┴─────────┘
Die Zeilenebenen-Summe überhöhte die Bewertungszahl um 23%. Sie können den Preis auch nicht auf übergeordneter Ebene speichern, da die Ohrschützer-Varianten von 12,95 $ bis 14,99 $ reichten. Schreiben Sie die Granularität jedes Felds in den Datenvertrag und bauen Sie eine Gold-Tabelle pro Granularität.
Standort ist ebenfalls Teil der Granularität. Angebote und Lieferschätzungen können sich mit dem Standort des Käufers ändern. Setzen Sie die Postleitzahl oder das Land bei jeder Eingabe und speichern Sie sie mit jedem Datensatz. Der Amazon-Produkte-Scraper nimmt eine zipcode bei jeder Eingabe.
Preis besteht oft aus mehreren Feldern. Das Feld coupon_description enthielt zum Beispiel ein Mehrfachkauf-Angebot bei 1 der 20 Produkte. Bei 5 anderen enthielt es eine kostenlose Amazon-Music-Testversion, die kein Preisnachlass ist. Das Savings-Abzeichen im obigen Bose-Screenshot ist eine dieser Testversionen.
Listenpreis, Verkaufspreis, Angebotstyp und Couponstext getrennt speichern und einen Coupon parsen, bevor Sie ihn als Rabatt zählen. Auch die Typen deklarieren, da JSON 449 $ als 449 schreibt, und ein Loader, der Typen aus einer Stichprobe ableitet, Preis zu einer Ganzzahl machen kann.
Produkte über Händler hinweg abgleichen
Ein Titelabgleich kann ein Kopfhörerpaar mit den Earbuds verknüpfen, die sich den Produktnamen teilen, gleichen Sie also auf Identifikatoren ab. Aber Identifikatoren fehlen oft oder sind inkonsistent. Nur 7 der 20 Amazon-Listings zeigten einen UPC (Universal Product Code) auf der Seite. Sony schrieb auch ein Basismodell auf 2 Arten, als WH-CH720N/P und WHCH720N/W.
Gleichen Sie also nach Vertrauensreihenfolge ab. Beginnen Sie mit einer GTIN (Global Trade Item Number), etwa einem UPC. Als Nächstes versuchen Sie Marke plus eine normalisierte Modellnummer, dann einen Titelabgleich mit einem Vertrauensschwellenwert. Normalisieren Sie Modellnummern, indem Sie Trennzeichen und Farbsuffixe entfernen.
Von den 20 Produkten hatten nur 6 weder einen UPC noch eine Modellnummer, und alle 6 waren Varianten eines Produkts. Also brauchte nur das Titelabgleich dieses einen Produkts eine Prüfung durch eine Person.
Aktualisierungszeitpläne nach Änderungsgeschwindigkeit der Daten festlegen
Webdaten verlieren mit unterschiedlicher Geschwindigkeit an Wert, und der Aktualisierungszeitplan sollte dazu passen. Selbst die Felder eines Datensatzes ändern sich mit unterschiedlicher Geschwindigkeit. Die stündlichen Durchläufe der Watchlist zeigen, wie sehr:
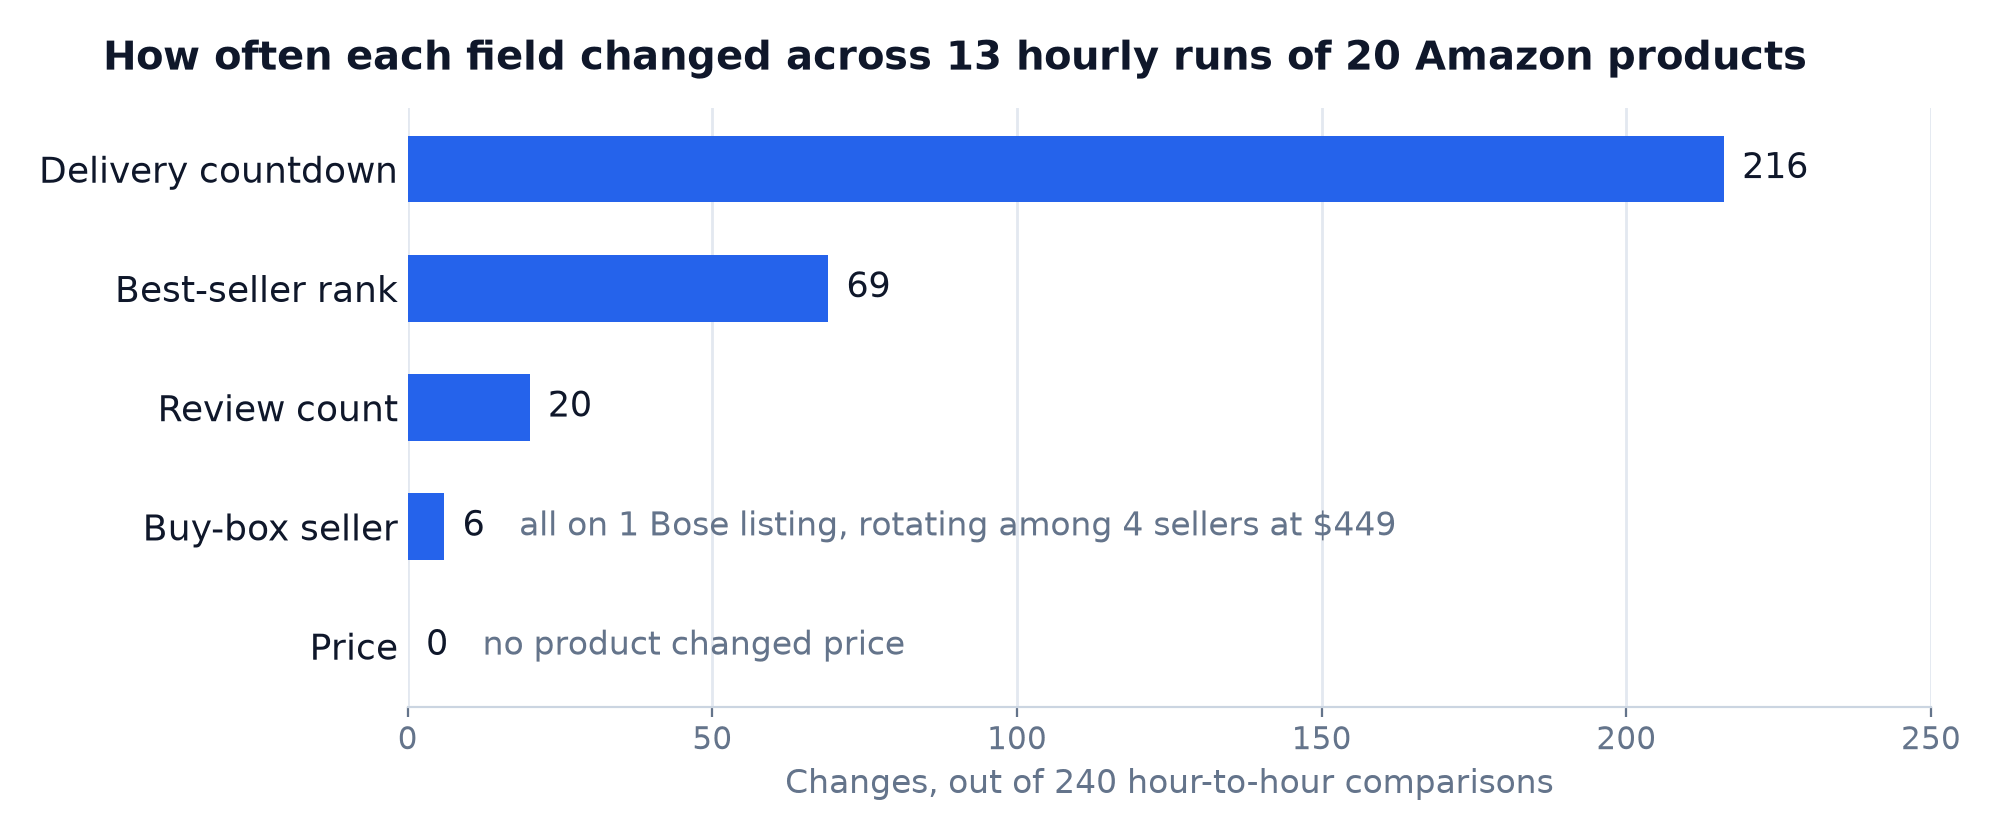
Gesammelt mit der Web Scraper API. Der Lieferzähler ist Amazons Nachricht “Bestellen Sie innerhalb von 2 Std. 44 Min.”
Bei einem Bose-Listing wechselte die Buy-Box 6-mal zwischen 4 Verkäufern, während der Preis bei 449 $ blieb. Ein Monitor, der nur den Preis verfolgte, hätte jede Änderung verpasst.
Gruppieren Sie Produkte danach, wie schnell sich ihre Schlüsselfelder ändern, und geben Sie jeder Gruppe ihren eigenen Sammelzeitplan, damit Ausgaben dorthin fließen, wo sich die Daten ändern. Führen Sie einen kleinen Job mehrmals täglich zu wechselnden Zeiten für Produkte aus, bei denen die Buy-Box wichtig ist, und einen täglichen Job für den Rest.
Inkrementelles Crawling senkt die Kosten der Aktualität, indem nur Seiten erneut gesammelt werden, die sich wahrscheinlich geändert haben, mit Signalen wie den lastmod-Daten in Sitemaps. Vergleichen Sie nach dem Sammeln einen Hash der Felder, die Ihr Vertrag nutzt, sodass spätere Stufen nur geänderte Datensätze erneut verarbeiten.
Im Fetch-Test unterschied sich der rohe HTML-Hash bei jedem wiederholten Abruf. Über die 240 Stunde-zu-Stunde-Vergleiche der stündlichen Durchläufe änderte sich ein Vollständige-Datensatz-Hash 239-mal. Die meisten dieser Änderungen stammten vom Lieferzähler. Ein Hash der 8 Vertragsfelder außer dem Zeitstempel änderte sich nur 26-mal, jedes eine echte Änderung bei Bewertungszahl oder Buy-Box-Verkäufer.
Ein niedriges Medianalter kann einige sehr alte Datensätze verbergen. Messen Sie Aktualität also als Verteilung, mit p50- und p99-Alter pro Quelle, und alarmieren Sie beim p99.
Datenpipeline-Architektur für KI und Agenten
Eine KI-Pipeline nutzt dieselben 5 Stufen, meist mit einem Modell oder Agenten bei der Bereitstellungsstufe.
Lassen Sie ein LLM Parser für Quellen mit hohem Volumen schreiben
Die Hauptfrage ist, ob ein großes Sprachmodell Daten aus jeder Seite extrahieren sollte. Eine Amazon-Produktseite, gezählt mit dem o200k_base-Tokenizer, hilft, sie zu beantworten:
| Form derselben Produktseite | Bytes | Token |
|---|---|---|
| Vollständige Seite als rohes HTML | 2.446.738 | 911.129 |
| Vollständige Seite als Markdown | 236.088 | 97.977 |
| Nur Hauptinhalt, aus dem rohen HTML extrahiert | 17.339 | 3.252 |
| Vollständiger JSON-Datensatz, alle Felder | 23.923 | 7.692 |
| Gekürzter JSON-Datensatz (12 Felder) | 501 | 171 |
Vollständiges Seiten-Markdown eignet sich für einen Agenten, der eine Seite liest, aber bei hohem Volumen reduzieren Teams Seiten meist vor der Extraktion auf ihren Hauptinhalt. So reduziert, verbrauchte die Seite immer noch das 19-fache der Token des 12-Felder-Datensatzes. Bei einem Beispielpreis von 0,10 $ pro 1 Million Eingabe-Token kosten 100.000 solcher Seiten pro Tag etwa 33 $ an Modelleingabe. Stattdessen die 12-Felder-Datensätze zu lesen würde etwa 2 $ kosten.
Beide Zahlen schließen das Sammeln aus, das jeder Pfad zu einem anderen Satz bezahlt. Vergleichen Sie also Gesamtkosten, nicht nur Token-Kosten. Der extrahierte Hauptinhalt begann mit einem Garantie-Upsell, und ein Modell, das ihn liest, kann trotzdem den falschen Preis oder die falsche Variante wählen. Ein Web Scraper API-Datensatz liefert Preis und Variante als separate Felder, sodass kein Modell sie aus dem Seitentext herauspicken muss.
Wählen Sie den Ansatz nach Volumen und Risiko. Für eine Quelle, die Tausende Male am Tag gesammelt wird, nutzen Sie das Modell, um den Parser zu schreiben, und reparieren Sie ihn, wenn er bricht. Gewöhnlicher Code führt diesen Parser dann auf jeder Seite aus und liefert dieselbe Ausgabe für dieselbe Seite. Scraper Studio betreibt dieses Muster als Dienst und baut einen Scraper aus einem einfachen Sprachprompt, mit Ein-Klick-Selbstheilung, wenn sich die Seite ändert.
Für Seiten mit geringem Volumen, deren Layouts sich oft ändern, kann LLM-Extraktion pro Seite weniger kosten als die Wartung eines Parsers. In beiden Fällen die Ausgabe gegen denselben Vertrag prüfen.
Wenn die Validierung fehlschlägt, kann ein Coding-Agent eine Parser-Korrektur vorschlagen und sie über die Rohseiten in der Bronze-Schicht erneut abspielen. Der Replay zeigt, wie viele in Quarantäne gestellte Zeilen die Korrektur wiederherstellt und ob sich eine akzeptierte Zeile geändert hat, und ein Mensch überprüft beides vor dem Merge.
Agenten aus validierten Tabellen bedienen
Für Agenten ist ein Live-Abruf riskanter als eine Tabellenlesung, da ein blockierter Abruf die Aufgabe eines Agenten stoppen kann, während ein Nutzer wartet. Im September 2026 änderte Cloudflare zum Beispiel die Standards für neu hinzugefügte Domains, um KI-Agenten und Trainings-Bots auf Seiten mit Werbung zu blockieren. Bedienen Sie Agenten also zuerst aus validierten Tabellen, über eine MCP-Schnittstelle, die die Nutzungsregeln des Vertrags enthält.
Agenten brauchen auch eine Prompt-Injection-Prüfung, da Seitentext, einschließlich Bewertungs- und Titelfelder in Ihren Tabellen, Anweisungen enthalten kann, die auf einen Agenten abzielen. Für Live-Lesungen hat der Bright Data MCP Server ein Inhalts-Gate, standardmäßig aktiviert. Es bittet den Nutzer um Bestätigung, bevor es Seitentext zurückgibt, der wie Anweisungen zur Änderung der Serverkonfiguration aussieht.
KI-Antworten als Datenquelle verfolgen
KI-Assistenten sind ebenfalls eine Datenquelle, da ihre Antworten einen Käufer vor jedem Suchergebnis erreichen können. In einem Test war ChatGPTs erste Empfehlung für dieselbe Shopping-Frage Bose in 3 von 5 Durchläufen und Sony in 2. Probieren Sie also jeden Prompt mehrfach aus und halten Sie das Land bei jedem Durchlauf gleich, damit die Ergebnisse vergleichbar bleiben. Die KI-Chat-Scraper der Web Scraper API sammeln Antworten von ChatGPT, Copilot, Gemini, Perplexity und Grok, mit ihren Zitaten als strukturiertem JSON.
Die Sammelschicht bauen oder kaufen
Die meiste Datenpipeline-Infrastruktur, einschließlich Speicher, Transformation und Orchestrierung, läuft auf gut etablierten Tools. Das Sammeln von geschützten Websites ist anders, da es sich ändern muss, wann immer sich Browser und Bot-Abwehr ändern.
Vergleichen Sie Kosten pro akzeptiertem Datensatz, nicht pro Anfrage. Web Unlocker berechnet nur für erfolgreiche Ergebnisse, und die Web Scraper API nur für gelieferte Datensätze. Teilen Sie die Gesamtausgaben durch die Datensätze, die Ihren Vertrag erfüllen.
Auf der Bauseite zählen Sie die Ingenieurstunden, die für Proxys, Parser-Korrekturen und Entsperrung aufgewendet werden. Auf beiden Seiten zählen Sie, was eine schlechte Lieferung kostet, etwa eine Repricing-Entscheidung auf Basis falscher Preise.
Collector an Ihren eigenen URLs benchmarken
Holen Sie sich diese Kosten aus einem Benchmark, so wie viele Einkaufsteams Anbieter in einem Proof of Concept bewerten. Führen Sie Ihren aktuellen Collector und jeden Kandidaten mehrere Tage lang an denselben URLs aus, vom Netzwerk und bei der Parallelität, die Ihre Pipeline wirklich nutzt. Vergleichen Sie jeden Kandidaten anhand derselben Kennzahlen:
| Kennzahl | Wie zu zählen |
|---|---|
| Akzeptierte Datensätze | Zeilen, die Ihren Datenvertrag erfüllen, pro Quelle |
| Fehlschläge nach Grund | Blocks, Challenges und Erfolgsantworten, die Ihre Inhaltsprüfung nicht bestehen, etwa leere oder regionsfremde Seiten |
| Kosten pro 1.000 akzeptierten Datensätzen | Alle Ausgaben, einschließlich Retries, Proxys und der untenstehenden Ingenieurstunden, pro 1.000 akzeptierte Zeilen |
| Latenz | p50- und p95-Zeit bis zur Lieferung, für Batch-Jobs und Live-Abrufe |
| Ingenieurstunden | Während des Tests für Blocks, Parser-Korrekturen und Warnungen aufgewendete Zeit |
Bright Datas monatliche kostenlose Credits können einen ersten Test an einer Stichprobe Ihrer URLs abdecken.
Pro Quelle entscheiden
Entscheiden Sie für jede Quelle separat, da eine Pipeline meist ungeschützte und geschützte Seiten mischt. Zählen Sie eine Seite als geschützt, wenn Ihr eigener Client die Inhaltsprüfung während des Benchmarks auf ihr nicht besteht:
| Situation | Bauen | Kaufen |
|---|---|---|
| Wenige ungeschützte Seiten, gelegentlich gesammelt | Ja | Mit kostenlosen Credits beginnen, dann mit wachsendem Volumen zu Pay-as-you-go wechseln |
| Geschützte Seiten, nach Zeitplan gesammelt | Nur mit einem Team, das Browser-Releases verfolgt, und meist mit Residential-Proxys | Web Unlocker oder Browser API übernimmt den Zugang, sodass Ihr Team nur die Parser schreibt |
| Seiten, bei denen Sie Datensätze brauchen, keine Seiten | Oft nicht lohnend, außer die Seite ist zentral für Ihr Produkt | Web Scraper API liefert strukturiertes JSON, und Scraper Studio baut benutzerdefinierte Scraper aus einem Prompt |
| Daten, die Sie brauchen, aber nicht selbst sammeln müssen | Nein | Datensätze, nach Zeitplan mit nur neuen oder aktualisierten Datensätzen aktualisiert, oder die Web Archive API für bereits gesammelte Seiten |
| Agenten, die live browsen oder suchen | Nur für kleine interne Tools | MCP Server, der die SERP-API und Web Unlocker nutzt |
Ein Datenvertrag macht den Collector auch leicht austauschbar, sodass das Ausprobieren eines neuen risikoarm ist. Nachgelagerte Tabellen, Markierungen und Warnungen hängen nur von den Feldern des Vertrags ab. Wechseln bedeutet, die Sammelstufe mit einem neuen Collector zu verbinden und den Benchmark an Ihren eigenen URLs erneut auszuführen. Verfolgen Sie weiterhin die Akzeptanzrate jeder Quelle, da Seiten ihre Abwehr im Laufe der Zeit ändern.
Für die Budgetplanung listet die Web Scraper API-Preisseite aktuelle Pay-as-you-go-Tarife und Volumenpläne. Der Leitfaden zu Datenqualitätskennzahlen hilft, “akzeptiert” zu definieren, bevor Sie Kosten vergleichen.
Compliance und Herkunft
Sammeln Sie nur öffentliche Daten, ohne sich anzumelden und mit Anfrageraten, die jede Seite bewältigen kann. Sammeln Sie personenbezogene Daten nur, wo Sie eine rechtliche Grundlage haben, und prüfen Sie den Urheberrechtsstatus von allem, was Sie erneut veröffentlichen oder darauf trainieren.
Bewahren Sie die Herkunft bei jedem Datensatz, einschließlich Quell-URL, Sammelzeit, Methode, Codeversion und geltenden Nutzungsbedingungen. Dann können Sie zeigen, wo und wie jeder Datensatz gesammelt wurde.
Bright Data hält die ISO-27001-Zertifizierung und einen SOC-2-Typ-II-Bericht, beide auf seiner Sicherheitsübersicht aufgeführt.
Wie die Tests durchgeführt wurden
Jeder Test lief gegen Live-Seiten und -Dienste, die sich mit der Zeit ändern:
| Test | Setup |
|---|---|
| Fetch-Test | Jeder von 4 Open-Source-Clients rief 13 Such- und Listingseiten 3-mal ab. Die Clients waren Python requests mit Standard-Headern, requests mit Chrome-Headern, curl_cffi mit seinem Chrome-150-Ziel und Headless Chrome 155 über Playwright. Alle liefen von einer Heiminternetverbindung in Indien, ohne Proxys. Eine Antwort zählte als Daten, wenn sie die HTML-Muster enthielt, die die Listings der Seite kennzeichnen, und ein separater Detektor prüfte 8 Blockseiten-Signaturen. Ein erneuter Headless-Durchlauf mit normalem User-Agent rief jede Seite 2-mal ab. |
| Fingerabdruck-Prüfung | TLS-Handshakes von Web Unlocker, Python requests, curl_cffi (Chrome-150-Ziel) und installiertem Chrome 155, verglichen auf tls.peet.ws |
| Agenten-Abruf | Dieselben 13 URLs, ein Durchlauf über das WebFetch-Tool, das Claude-Code-Agenten nutzen |
| Referenzpipeline | 20 Amazon-Produkte plus 1 absichtlich ungültige ID, Web Scraper API, 2 Durchläufe etwa 2 Stunden auseinander und ein dritter etwa 17 Stunden später |
| Stündliche Durchläufe | Dieselben 20 Produkte, 13 Durchläufe eine Stunde auseinander, 240 Stunde-zu-Stunde-Vergleiche |
| Discovery | Eine Google-Suche nach einem Kopfhörermodell über die SERP-API |
| Token-Zählungen | Eine Amazon-Produktseite über Web Unlocker (HTML und Markdown) und die Web Scraper API (JSON), o200k_base-Tokenizer, Hauptinhalt extrahiert mit trafilatura 2.3 |
| KI-Antworten | Eine Shopping-Frage an ChatGPT über die Web Scraper API, 5 Durchläufe ohne gesetztes Land |
Abschließende Gedanken
Wenn eine Datenpipeline von öffentlichen Websites sammelt, kann eine Antwort einen Erfolgsstatus und keine Daten haben, und ein Datensatz kann mehrere Granularitäten mischen.
Speichern Sie Rohdaten unverändert, prüfen Sie Inhalte gegen einen Datenvertrag, markieren Sie ungewöhnliche Änderungen und spielen Sie jede von einem Agenten vorgeschlagene Parser-Korrektur erneut ab, bevor Sie sie mergen. Wenn die Sammelschicht mehr an Ingenieurzeit als an Anfragen kostet, kann die Web Scraper API diese Stufe für Ihr Team übernehmen. Beginnen Sie damit, eine Inhaltsprüfung an Ihrer unzuverlässigsten Quelle auszuführen, und zählen Sie, wie viele ihrer Erfolgsantworten nutzbare Datensätze enthalten. Führen Sie dann dieselben URLs über Web Unlocker oder die Web Scraper API auf einem kostenlosen Bright Data-Konto aus und vergleichen Sie die Kosten pro akzeptiertem Datensatz.
FAQ
Was sind Data Pipes?
“Data Pipes” ist eine informelle Bezeichnung für Datenpipelines, die Systeme, die Daten von ihren Quellen zu den Tools bewegen, die sie nutzen. Eine typische sammelt, speichert, prüft, transformiert und liefert Daten. Datenpipeline-Architektur ist ihr Design, das die Stufen, die Tools und die Prüfungen dazwischen definiert.
Was ist Data Pipelining?
Data Pipelining ist die Praxis, Datenpipelines zu bauen und zu betreiben, die Daten von Quellen zu den Tools bewegen, die sie nutzen. Die Arbeit umfasst das Sammeln, Speichern, Prüfen, Transformieren und Bereitstellen von Daten sowie die Planung und Überwachung jeder Stufe. Es ist nicht dasselbe wie Instruction Pipelining in CPUs, das Prozessorschritte innerhalb eines Chips überlappt.
Was sind die 5 Schritte einer Datenpipeline?
Die 5 Schritte einer typischen Datenpipeline sind Sammeln, Roh speichern, Validieren, Transformieren und Bereitstellen. Das Sammeln zieht Daten aus Quellen, und die Rohspeicherung bewahrt sie unverändert. Die Validierung prüft sie gegen einen Datenvertrag, die Transformation modelliert sie in Tabellen, und die Bereitstellung liefert sie an Dashboards, Modelle oder Agenten.
Was ist eine moderne Datenpipeline-Architektur?
Eine moderne Datenpipeline-Architektur speichert Rohdaten meist in Object Storage und hält Tabellen in einem offenen Format wie Apache Iceberg. Sie transformiert Daten mit einem Tool wie dbt und plant Stufen mit einem Orchestrator wie Airflow. Ein Datenvertrag kontrolliert, was in die Tabellen gelangt, und Agenten können sie über das Model Context Protocol (MCP) lesen.
Was sind einige Beispiele für Datenpipelines?
Ein nächtlicher Batch von Konkurrenzpreisen, der in ein Warehouse geladen wird, ist ein gängiges Beispiel. Ein Strom von Social-Posts, der in Minuten für Markenüberwachung verarbeitet wird, ist ein anderes. Ein Hybrid behält tägliche Historie und streamt Änderungen für eine kurze Watchlist, und eine On-Demand-Pipeline ruft Live-Daten ab, wenn ein Agent fragt. Alle 4 nutzen dieselben 5 Stufen.
Kann KI Datenpipelines erstellen?
Ja, ein Coding-Agent kann den meisten Code einer Pipeline schreiben, während ein Mensch jede Änderung überprüft. Für das Sammeln baut Bright Datas Scraper Studio einen Scraper aus einem einfachen Sprachprompt. LLM-Extraktion pro Seite funktioniert, wenn jede Ausgabe den Datenvertrag erfüllt, nutzt aber mehr Token. Der Hauptinhalt einer Amazon-Seite betrug 3.252 Token, gegenüber 171 für einen 12-Felder-Datensatz.
Was ist eine Data-Ingestion-Pipeline?
Eine Data-Ingestion-Pipeline, der erste Teil einer Datenpipeline, sammelt und speichert Daten aus Quellen. Webquellen brauchen eine Inhaltsprüfung. In einem Test von Open-Source-Clients auf 13 Seiten hatten 39 von 88 Erfolgsantworten keine Daten. Für Seiten mit Bot-Abwehr liefert Bright Datas Web Unlocker die Seite, oder die Web Scraper API liefert strukturierte Datensätze.
Was ist eine Big-Data-Pipeline?
Eine Big-Data-Pipeline ist eine Datenpipeline, die für Volumen gebaut ist, bei denen Speicher und Rechenleistung getrennt skalieren müssen. Sie speichert Daten meist in Object Storage und hält sie in offenen Tabellenformaten wie Apache Iceberg oder Delta Lake. Verteilte Engines wie Spark oder Flink verarbeiten sie.