In der neuen Ära des agentischen Engineerings ist ‘Kontext’ nicht mehr nur Daten; er ist der Treibstoff für jede Entscheidung, die Ihr Agent trifft. Dennoch behandeln die meisten Teams Kontext als statischen Input statt als dynamische Engineering-Herausforderung. Der eigentliche Engpass ist nicht nur der Datenzugang – sondern die Fähigkeit, diese Daten in einen Zustand zu formen, der frisch, verifiziert und token-effizient genug für zuverlässiges Reasoning ist.
Context-as-a-Service hat sich als grundlegende Lösung etabliert, um Agenten den bestmöglichen Kontext bereitzustellen. CaaS liefert die Infrastruktur, um diese riesigen und unstrukturierten Web-Daten in eine agentenfertige Wissensbasis zu verwandeln. Sie investieren Zeit in das Engineering des Kontexts und der Quellen, aus denen die Agenten ihre endgültigen vernetzten und strukturierten Informationen erhalten.
CaaS überbrückt die rohe Wissensbasis, die Menschen ein Leben lang aufgebaut haben (Web-Daten), und intelligente Ausführung, indem es domänenspezifische Datenschichten anbietet; so wird sichergestellt, dass Agenten nicht nach Informationen suchen, sondern durch angereicherten, verifizierten Kontext angetrieben werden, der auf automatisiertes Reasoning und Entscheidungsfindung zugeschnitten ist.
Dies hat jedoch seinen Preis: Sie mieten ständig den von anderen entwickelten Kontext, um Ihre Agenten zu betreiben.
Die versteckten Kosten des Kontext-Mietens
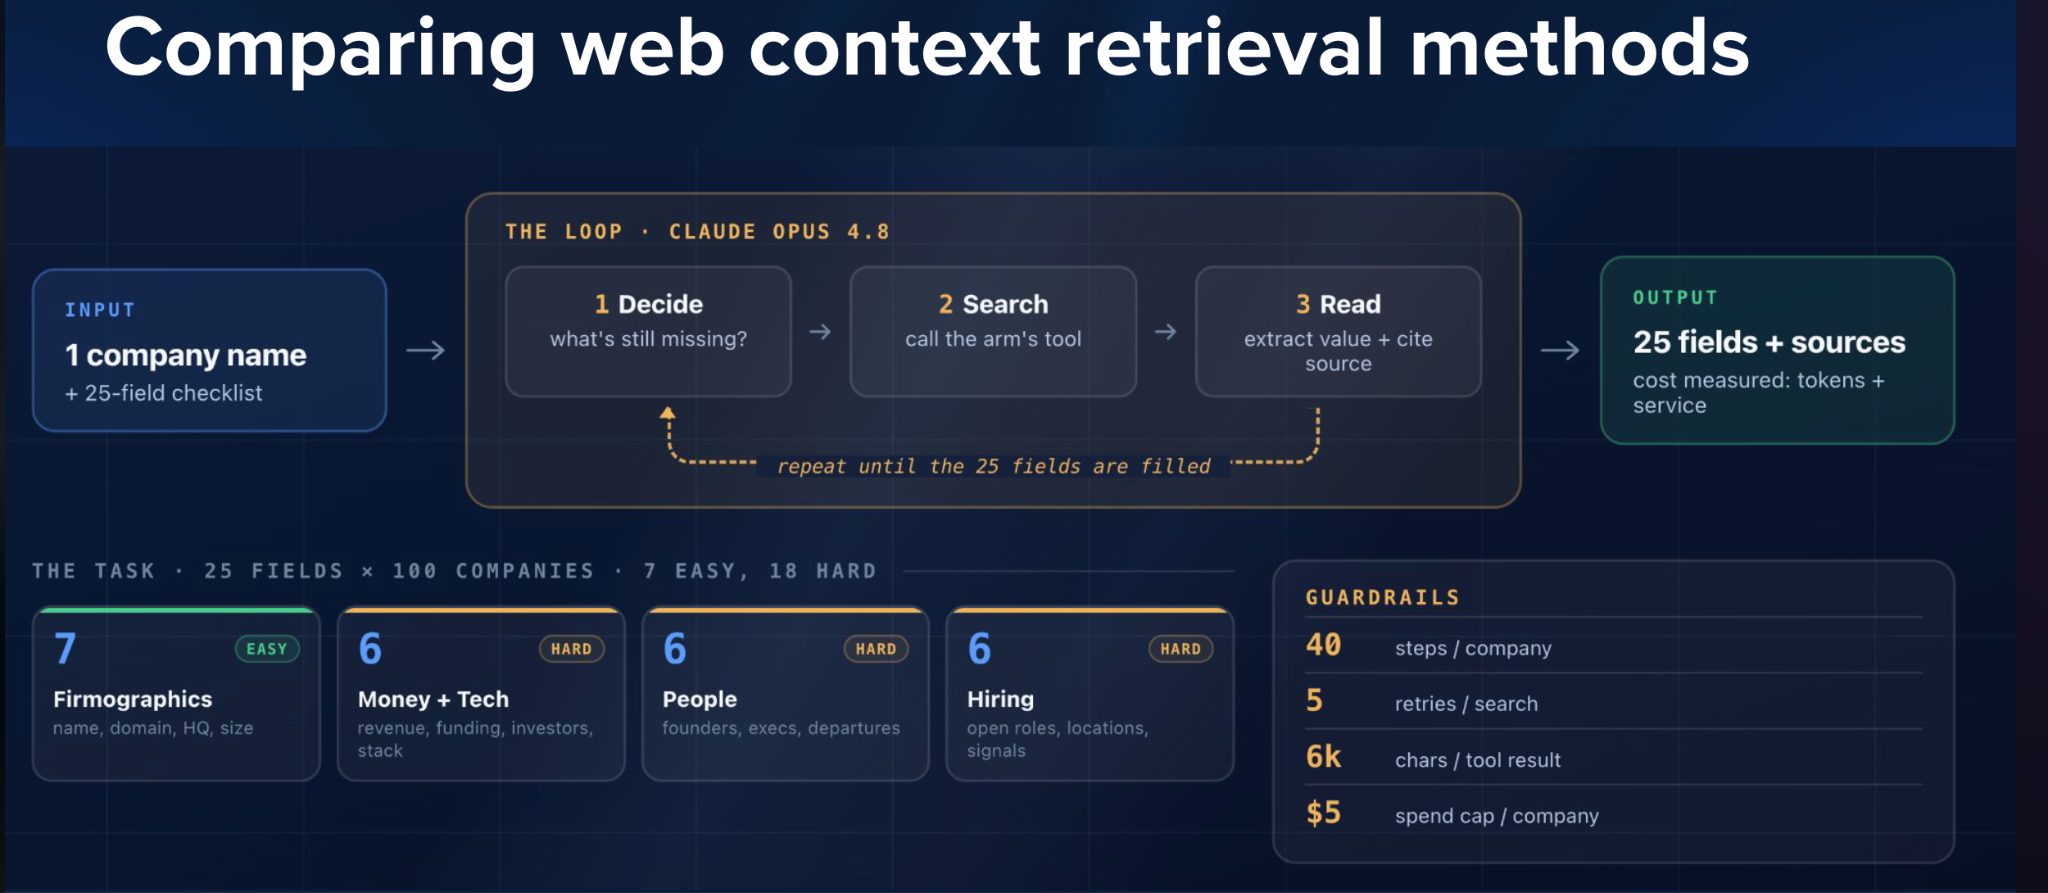
Um die wirtschaftlichen Kompromisse dieser Infrastruktur zu verstehen, haben wir einen KI-Agenten beauftragt, 100 Unternehmen mit 25 Datenfeldern mithilfe verschiedener Abrufmethoden anzureichern. Die Felder umfassten leicht zu erfassende Firmografiken (Hauptsitz, Mitarbeiterzahl, Domain) und schwierigere wie Umsatz, Finanzdaten, Tech-Stack, Personen und Einstellungssignale.
Das Abrufwerkzeug, auf das die KI Zugriff hatte, war die einzige veränderte Variable.
Harness shape
Verglichene Methoden
| Öffentlicher Name | Was er repräsentiert |
|---|---|
| Search 1 / Search 2 / Search 3 | KI-Suchwerkzeuge, die ein Kontextfenster statt eines Browser-Tabs befüllen sollen. |
| Native | Modell-native Suche innerhalb der Modellumgebung. |
| CaaS 1 / CaaS 2 / CaaS 3 | Kontextdienste und vertikale Anbieter. |
| Unlocker + SERP | Agent auf roher Web-Infrastruktur: Suchergebnisse plus entsperrte Seiten. |
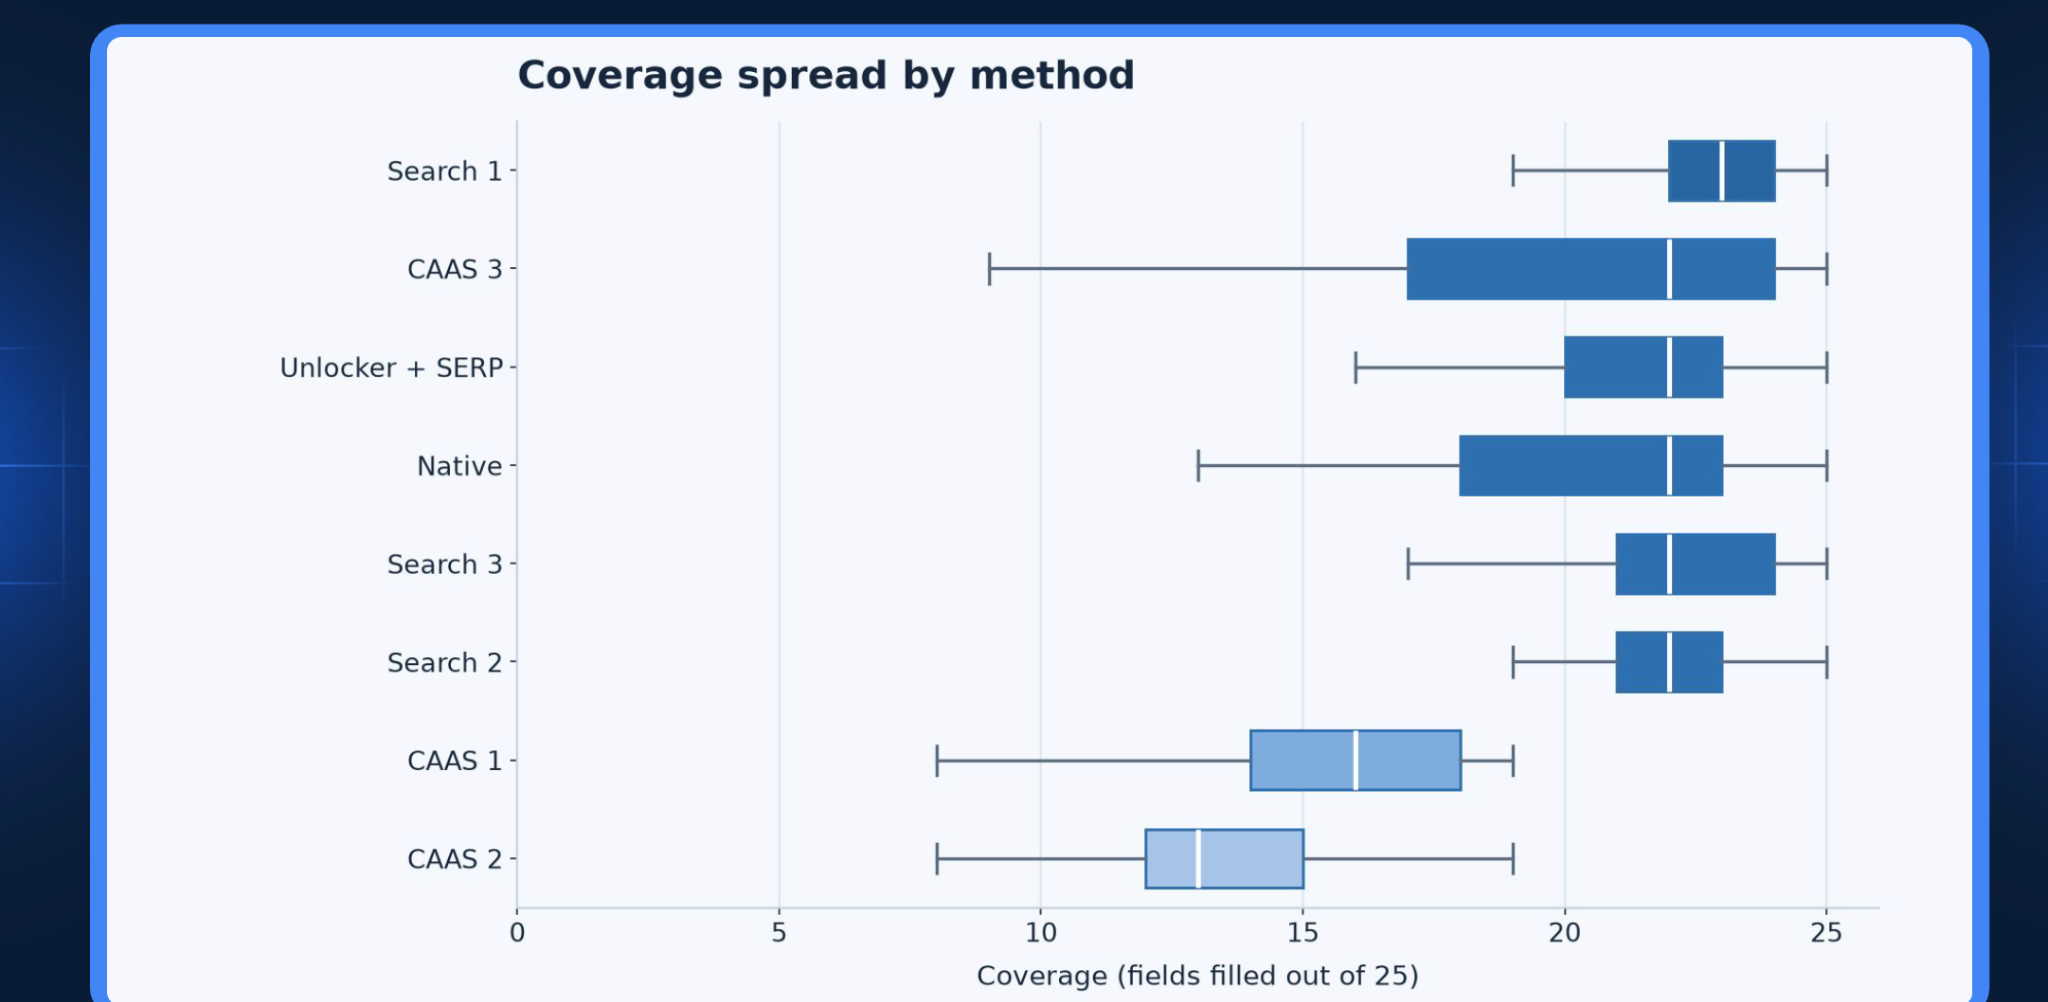
Coverage beschreibt, wie viel der Daten jede Methode ausfüllen konnte…
Die Kosten gliedern sich in zwei Teile: den Preis des Dienstes selbst und die Tokens, die die KI zum Verarbeiten und Strukturieren der Daten aufwendet.
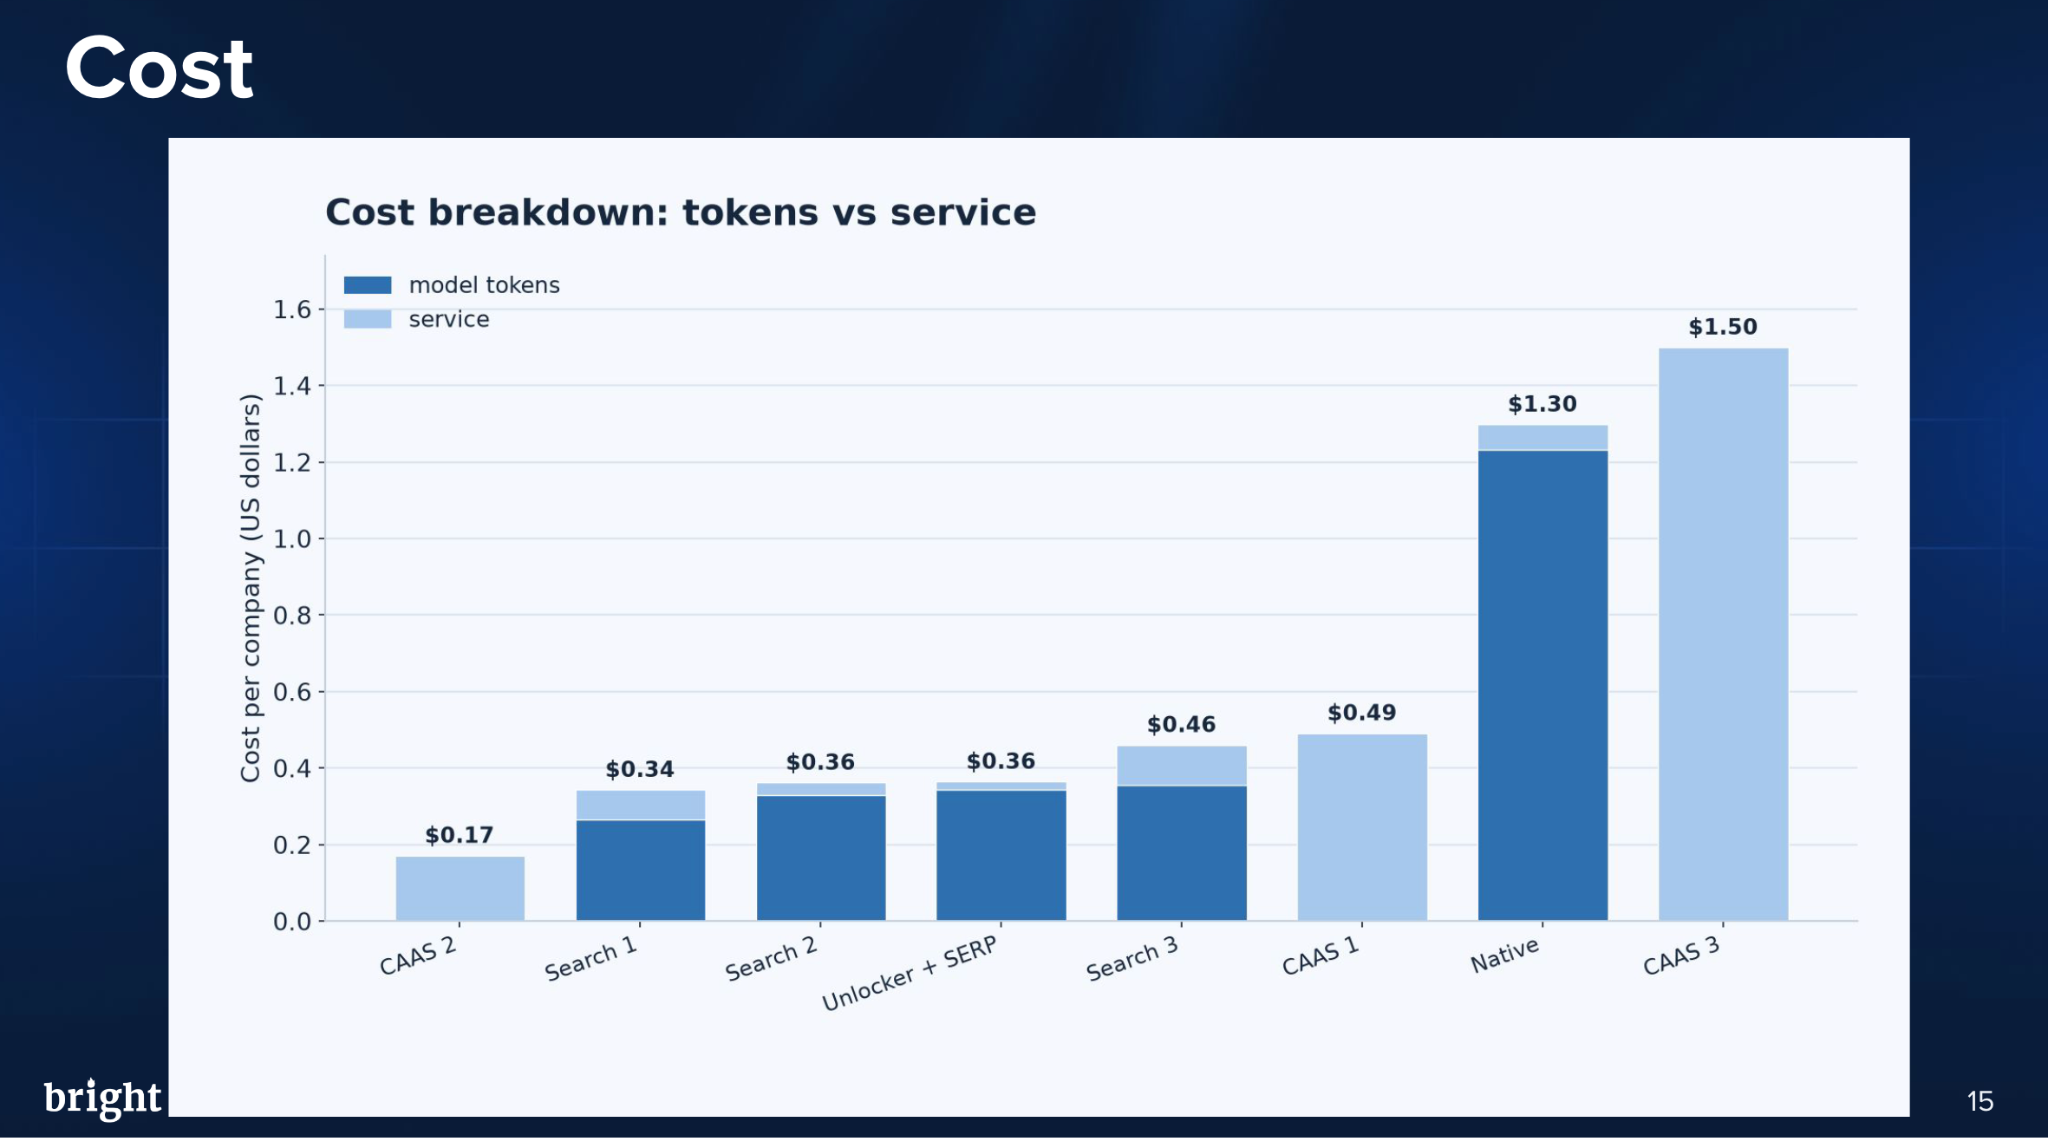
Suchen und CaaSes eignen sich hervorragend für diesen Anwendungsfall – wenn Sie schnell grundlegende Daten benötigen, genau wie ein Mietwagen.
Aber skaliert das?
Es gibt ein grundlegendes Muster: Sie zahlen jedes Mal erneut, wenn Sie Kontext anfordern. Egal ob Sie 100, 1.000, 100.000 oder Millionen von Unternehmen oder Datenpunkten abfragen – Sie ‘mieten’ Ihre Daten nach wie vor.
- Jede wiederholte Entität kostet genauso viel wie beim ersten Mal
- Rauschen und Falschpositive, die Sie nicht herausfiltern können
- Token-Kosten komprimieren sich nicht mit dem Volumen
- Teams beginnen, Abstriche zu machen, um die Rechnung zu managen
In großem Maßstab ist es ziemlich offensichtlich, dass es besser ist, das Auto zu besitzen, als jeden Tag eines zu mieten, um zum selben Ort zu fahren.
Wie besitzt man es also? Wie besitzt man sein KI-Suchwerkzeug oder CaaS?
Web-Kontext-Engineering
Web-Kontext-Engineering bedeutet, die vielfältigen Quellen, die Sie haben, in eine spezifische Pipeline zu strukturieren, die Sie wiederverwenden und skalieren können, und die Informationen auf die beste Weise für die KI bereitzustellen.
Anstatt einen Agenten für jedes Unternehmen live im Web suchen zu lassen, haben wir eine wiederholbare, Scraper-gestützte Pipeline aufgebaut.
Wir verwendeten Bright Data’s Scraper Studio sowie einige vorhandene Bright Data Scraper, um die Quellen zu sammeln, die wir für relevant hielten, und ordneten diese Datensätze dann denselben 25 Feldern zu.
Der Agent führt nicht mehr die gesamte Abrufarbeit live durch. Die Kontextschicht erledigt mehr der Arbeit, bevor das Modell sie überhaupt zu sehen bekommt.
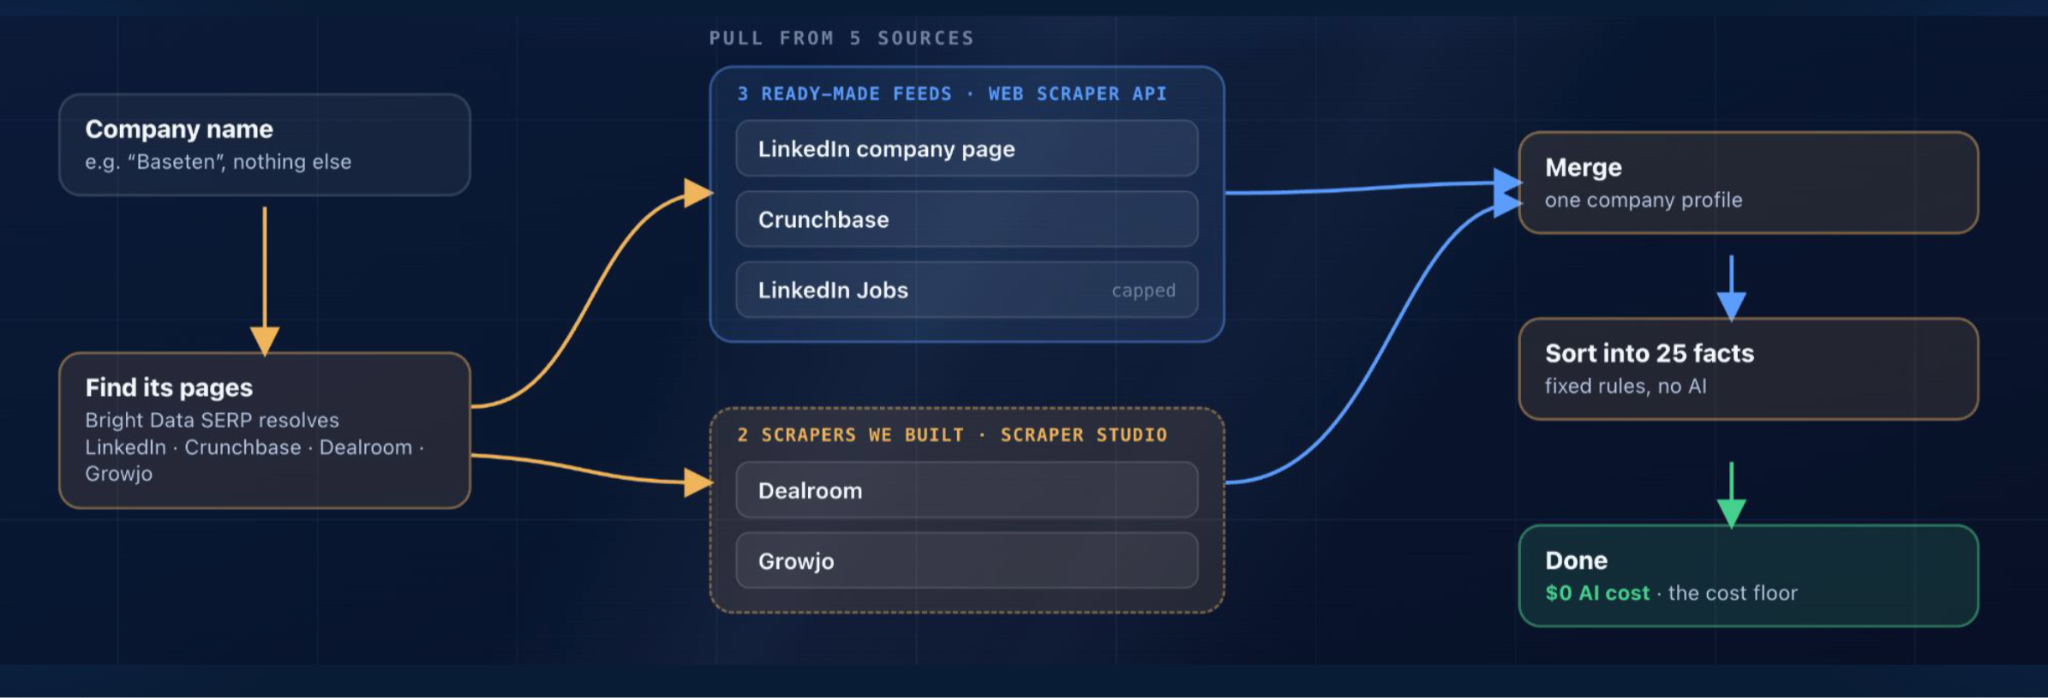
Abbildung: eigene Kontext-Pipeline
Plot twist: Einrichtungskosten
Um den Vergleich fair zu gestalten, haben wir der eigenen Pipeline auch echte Einrichtungskosten zugewiesen.
Stellen Sie sich vor, ich hätte die klügste Person, die ich kenne, engagiert, um diesen Scraper zu bauen, und ihr übertriebene $5.000 dafür bezahlt, zu recherchieren und zu planen, aus welchen Quellen Daten gezogen werden sollen – was tatsächlich etwa drei Stunden Gespräche mit Claude dauerte.
Und wir nannten diese Methode DIY, was für ‘Do (or Build) it yourself’ steht.
Danach ist die wichtige Zahl die Grenzkosten, die jedes Mal anfallen, wenn wir ein weiteres Unternehmen anreichern.
Der DIY-Vorteil: Für Skalierung bauen
Die Coverage ist in etwa gleich; obwohl sie etwas geringer ist, gibt es keinen wesentlichen Unterschied.
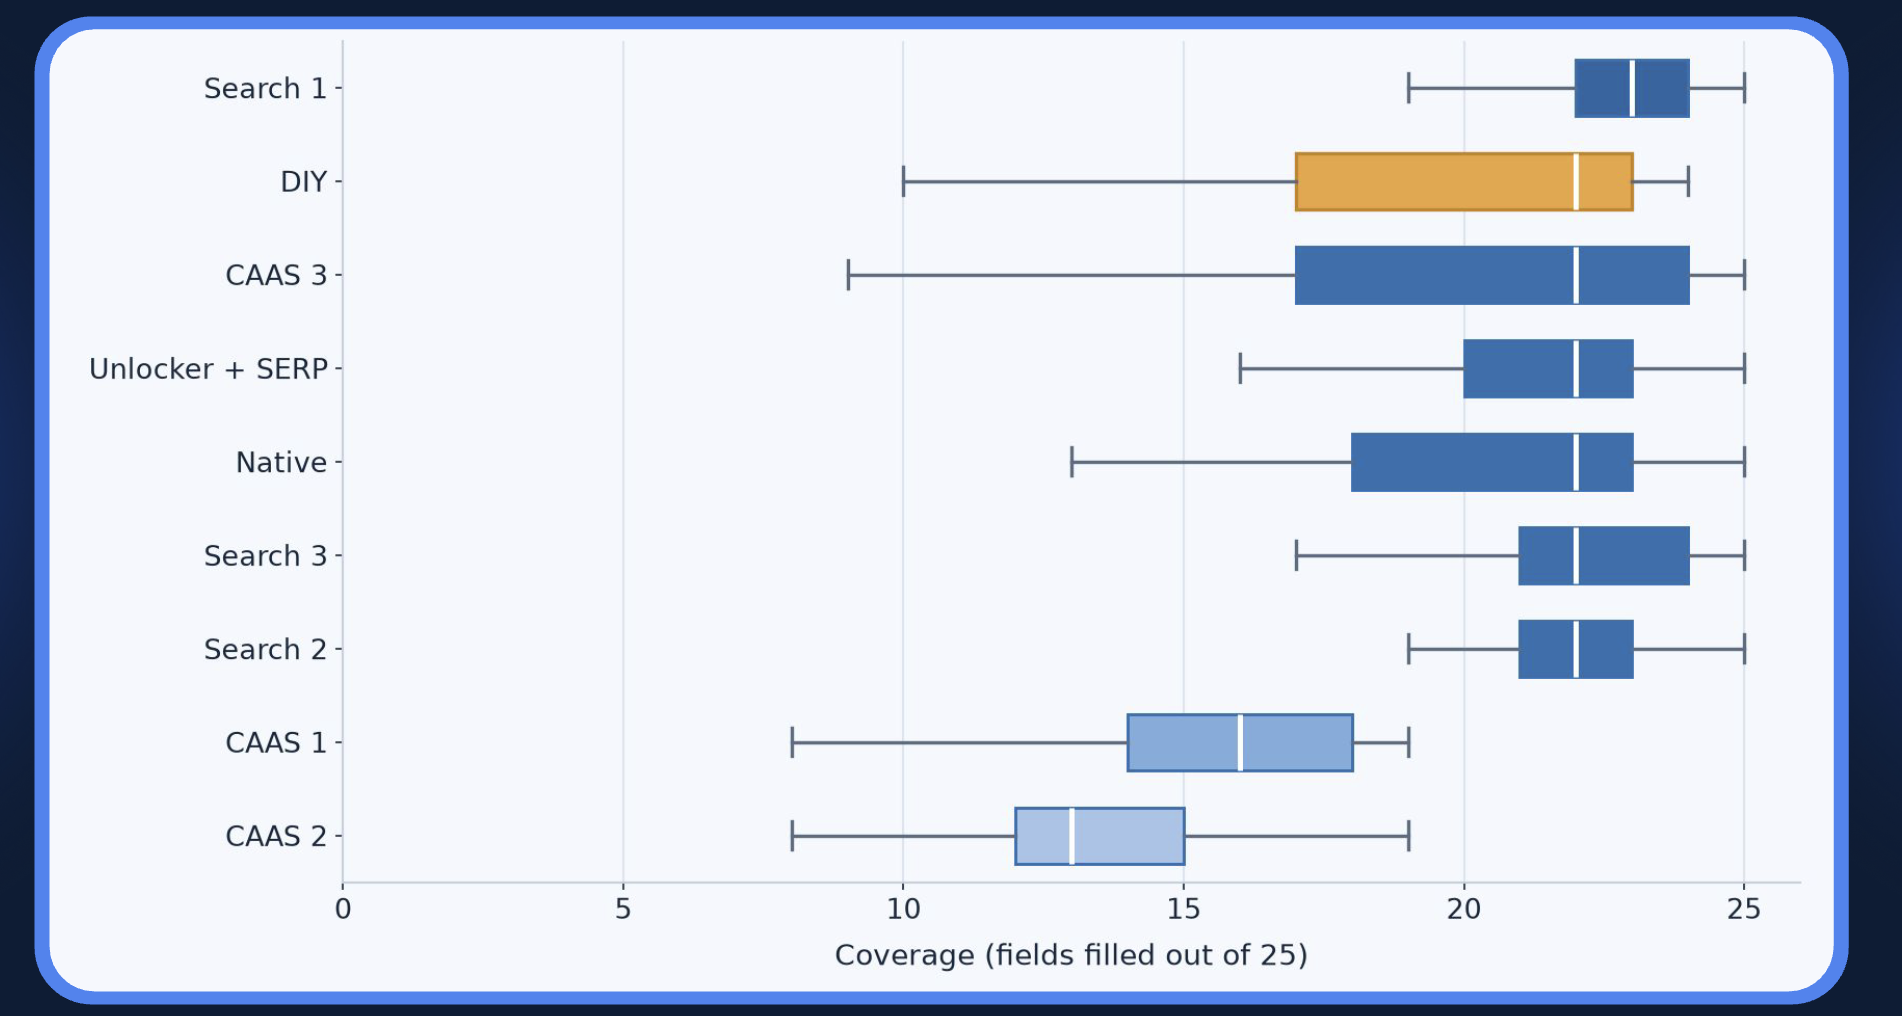
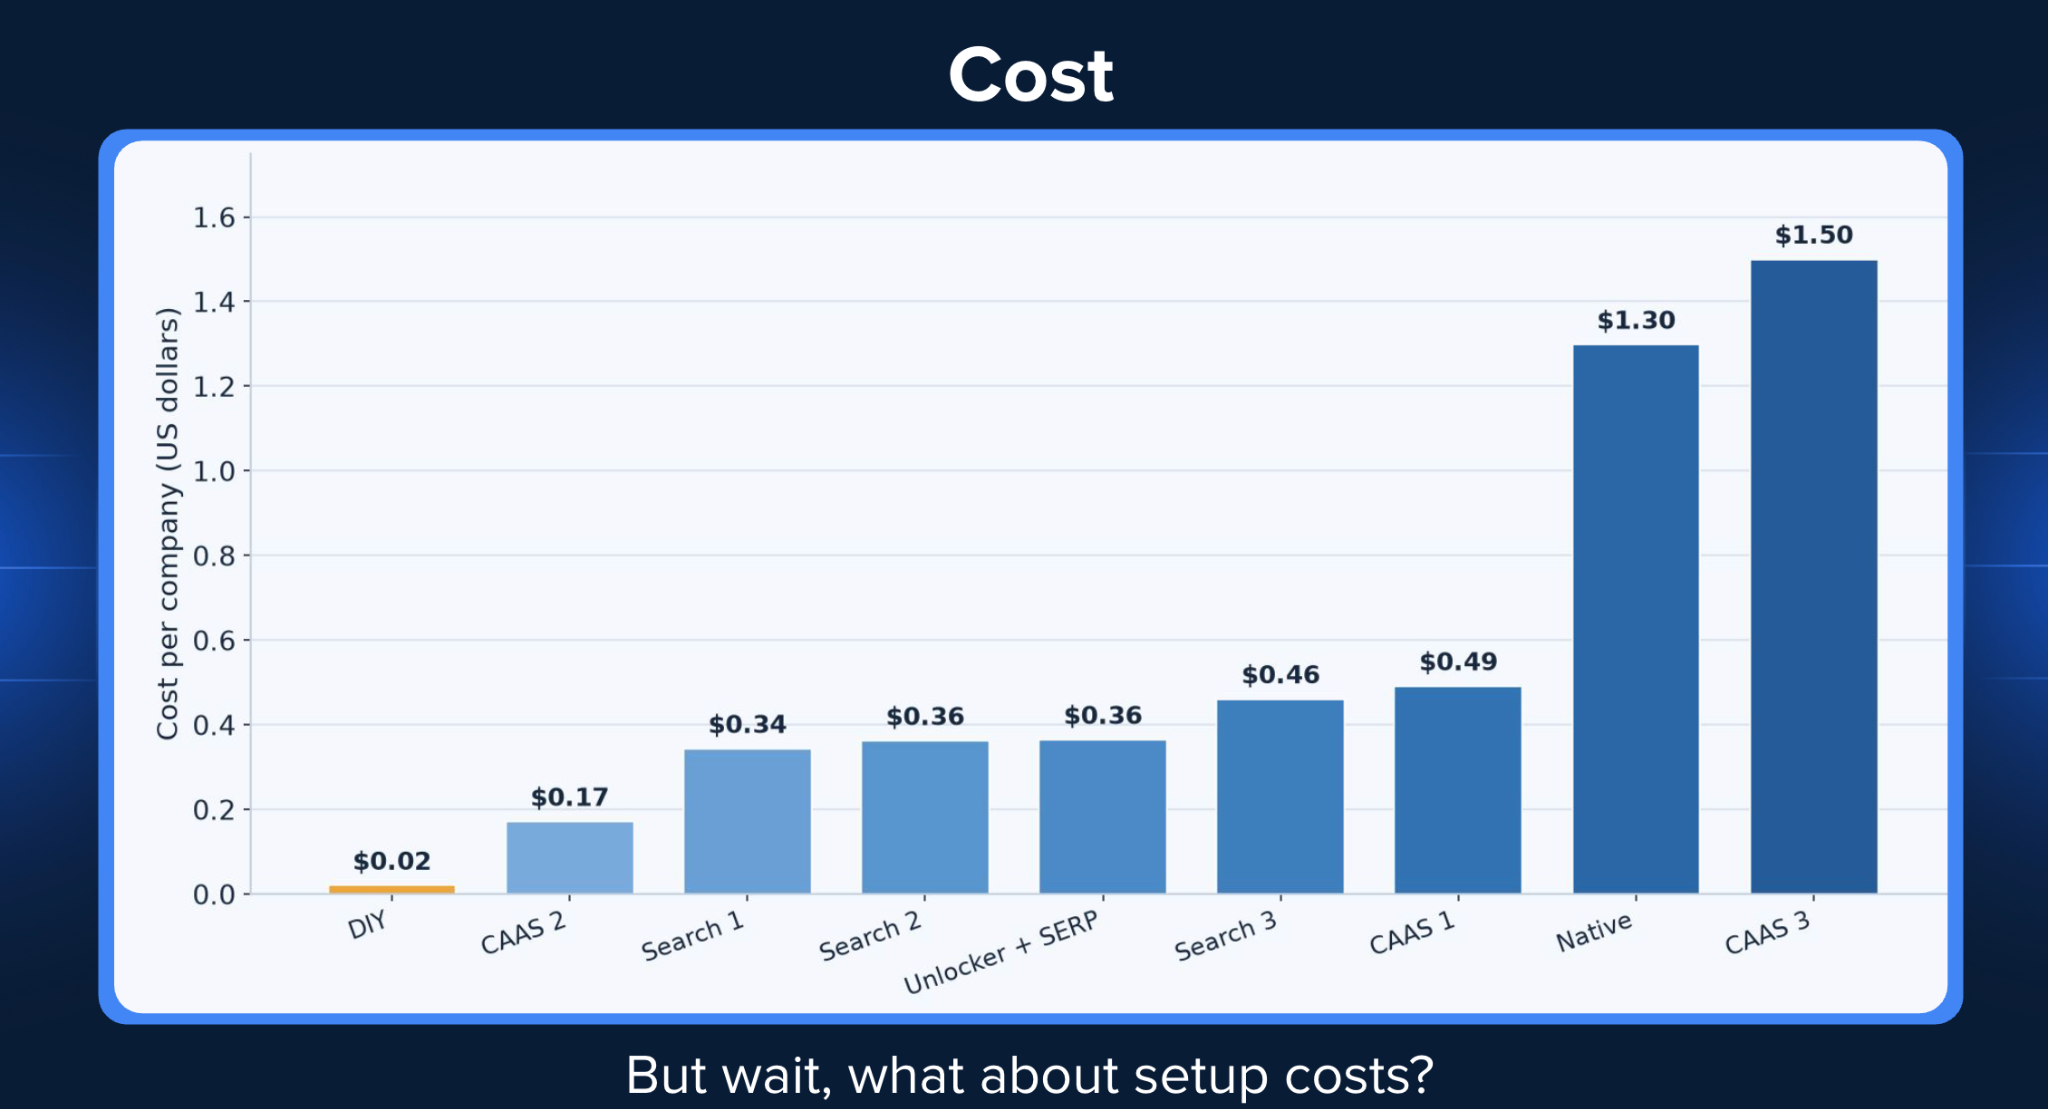
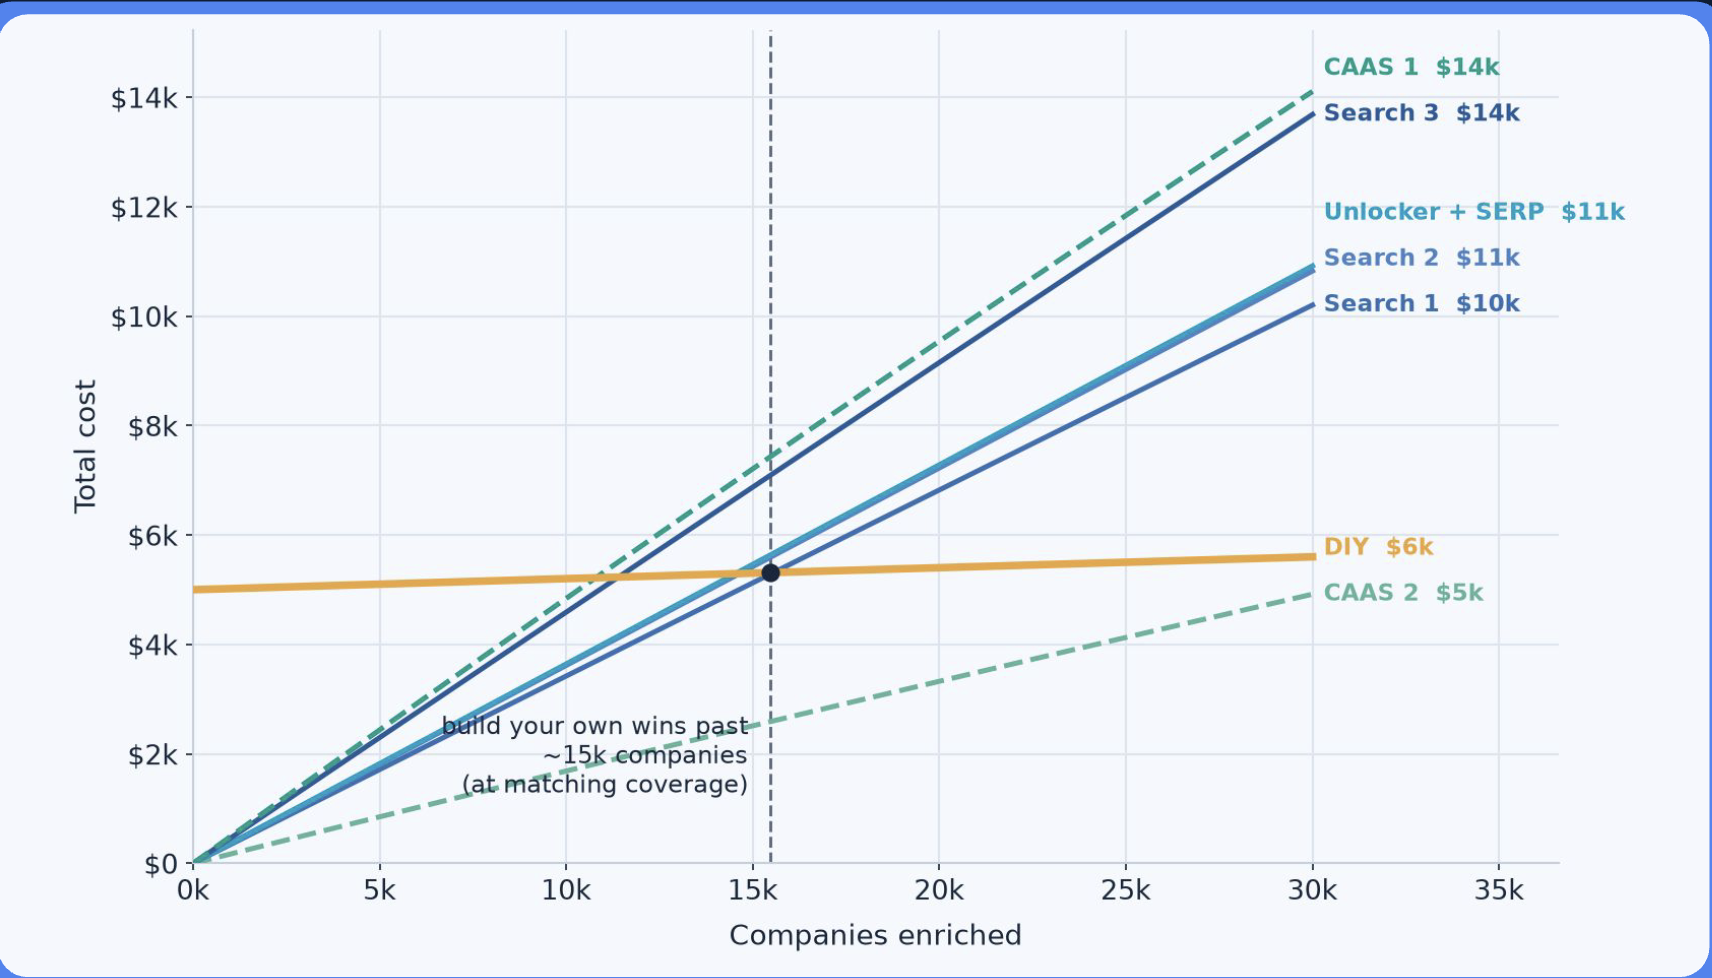
Abbildung: Build vs. Rent Tipping Point
In kleinem Maßstab kann Mieten noch die offensichtliche Wahl sein. In größerem Maßstab verteilen sich die einmaligen Aufbaukosten auf immer mehr Anreicherungen.
Der Tipping Point zeigt uns, dass der Besitz einer eigenen Pipeline ab einer bestimmten Größe weitaus effizienter wird.
Die Wirtschaftlichkeit des Web-Kontext-Engineerings
Wie die Daten zeigen, hat das Mietmodell eine Obergrenze. Ab einem bestimmten Volumen übersteigen die Kosten dieser Dienste die Anfangsinvestition für den Aufbau einer eigenen Infrastruktur. Lassen Sie uns auf eine größere Skala zoomen…
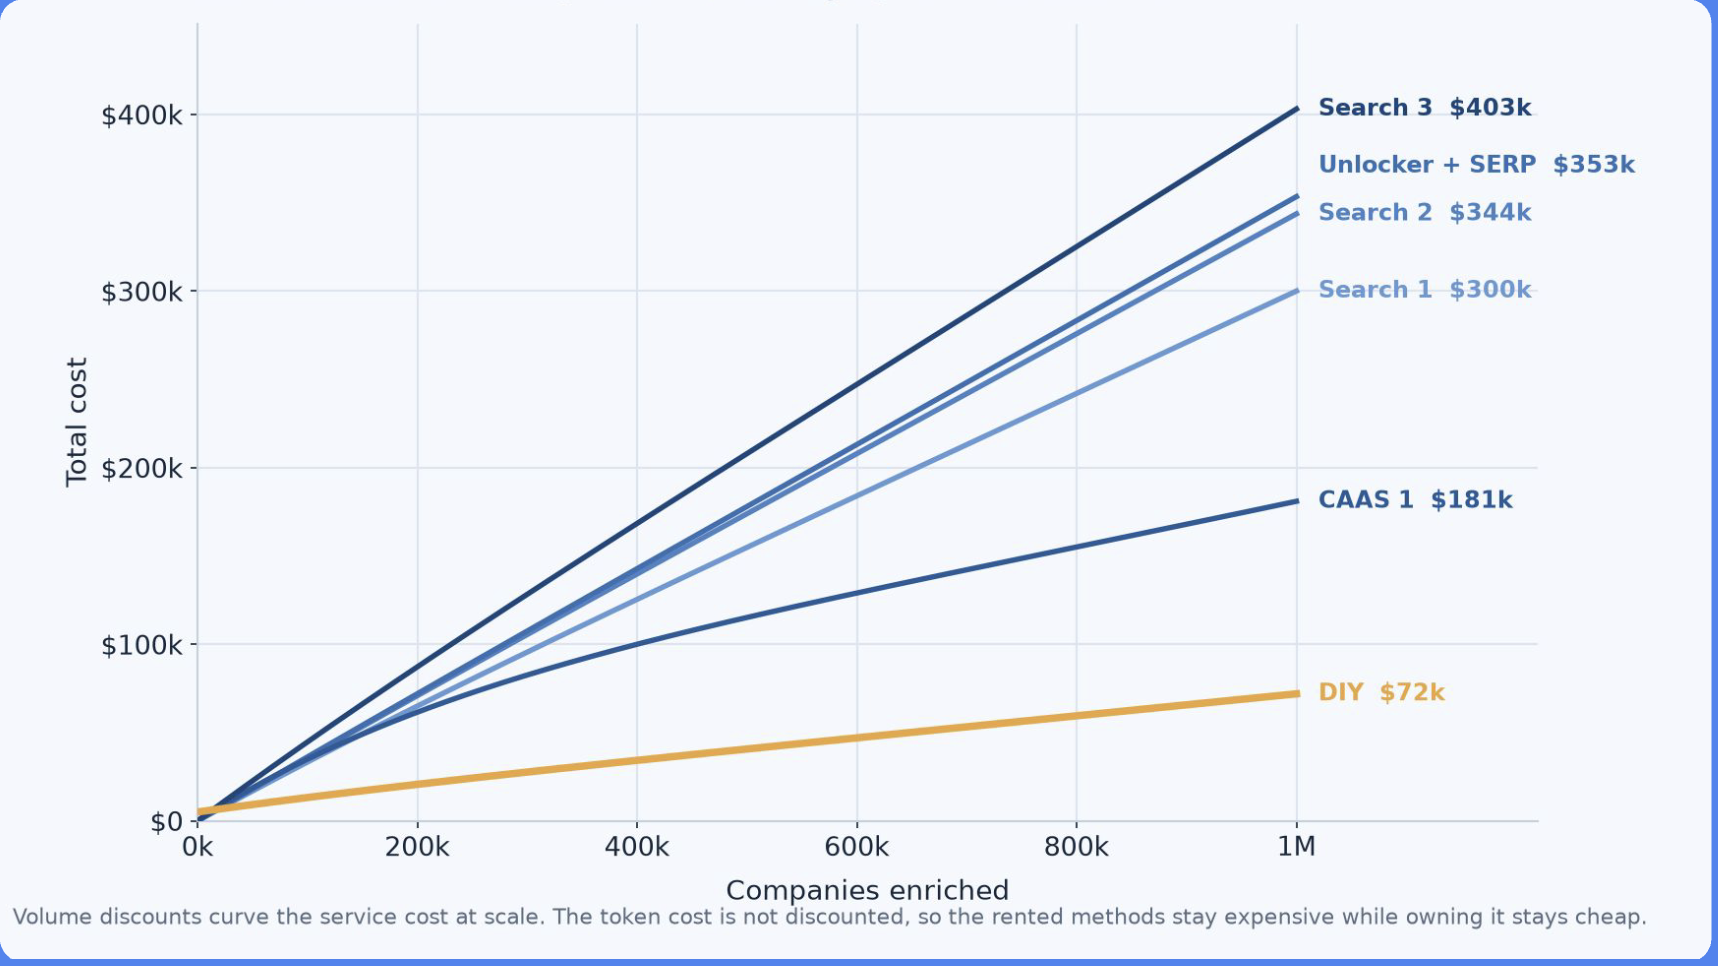
Der Fall ist klar:
- Mieten, wenn Ihr Wissensbedarf gering und vielfältig ist.
- Suche verwenden, wenn die Aufgabe ad hoc und offen ist.
- CaaS verwenden, wenn die Domäne wiederkehrend und spezialisiert ist und Sie strukturierten, verifizierten, agentenfertigen Kontext wünschen.
Bauen, wenn der Workflow sich wiederholt, dieselben Entitäten wiederkehren, Aktualität wichtig ist und Sie Kontrolle über die Geschäftslogik benötigen.
Genau dort wird Web-Kontext-Engineering zu einem echten operativen Vorteil.
Und wenn Sie ein Builder sind, ist dies auch die Chance.
CaaS ist nicht nur eine Anbieterkategorie. Es ist ein Zeichen dafür, dass Agenten eine verwaltete Kontextschicht benötigen:
- Kontrollierte Entitäten
- Kontrollierte Schemata
- Aktualitätsregeln
- Quellenverifizierung
- Domänenspezifische Ontologien
- Wiederverwendbare Kontext-Pipelines
Die Agentenära verwandelt Web-Daten in Infrastruktur. Die Gewinner sind die Teams, die unübersichtliche, sich schnell verändernde Web-Daten in zuverlässigen, strukturierten, wiederverwendbaren Kontext umwandeln können.
Bauen Sie Ihr eigenes!