DSPy ist ein Python-Framework, das Sprachmodellprogramme mit Daten verbessert. DSPy lädt Agent-Tools von Model Context Protocol (MCP) Servern. Mit dem Bright Data MCP-Server durchsucht ein Agent Google und liest Seiten als Markdown, während der Server den Bot-Schutz übernimmt.
Das MCP-Tutorial-Muster von DSPy funktioniert gut für einen einzelnen Agentenlauf. DSPys Evaluator und GEPA, sein Prompt-Optimierer, führen Agenten auf Worker-Threads aus, wobei asynchrone Tool-Aufrufe im Test stillschweigend fehlschlugen und der Agent aus dem Gedächtnis antwortete.
Diese Anleitung zeigt dir, wie du diesen Agenten erstellst, seine Tools parallel ausführst und misst, was Webdaten hinzufügen.
TL;DR
- Webdaten erhöhten die Genauigkeit. Mit dem Bright Data MCP-Server beantwortete
gpt-5.4-mini54-58 von 60 Fragen korrekt, gegenüber 14 zuvor, und alle 8 Fragen zu Ereignissen nach seinem Wissensstichtag, gegenüber 0. - Wähle 2 Tools und füge einen Elicitation-Callback hinzu. Weniger Tools halten Prompts klein. Der Callback genehmigt Seiten, die als mögliche Prompt-Injection markiert sind.
- Gib threaded Läufen synchrone Tools. Asynchrone Tools schlugen in
dspy.Evaluateund GEPA stillschweigend fehl oder blieben hängen. Eine Hintergrund-Event-Loop behob beides. - Behebe zuerst die Tools. GEPA kopierte Trainingsantworten in seine Anweisungen, ohne den Score zu erhöhen. Bei 6 Fragen zu langen Seiten halbierte ein
find-Argument die Prompt-Token.
Was du brauchst
Der Agent verbindet sich über HTTP mit Bright Datas Web MCP, dem gehosteten Bright Data MCP-Server, sodass Python die einzige Laufzeitumgebung ist, die installiert werden muss. Der Server läuft auf der Web Unlocker API, die Proxy-Rotation und Bot-Schutz für den Agenten übernimmt. Für den Code enthält das begleitende GitHub-Repository jedes Skript und jede Datendatei, einschließlich evaluate.py und post_cutoff_questions.csv für die Bewertungsschritte. Du benötigst:
- Python 3.10 oder höher und uv zur Installation von Paketen
- Ein kostenloses Bright Data-Konto und dessen API-Schlüssel aus den Kontoeinstellungen
- Einen OpenAI API-Schlüssel oder einen Schlüssel für einen anderen Anbieter, den
dspy.LMmit Tool-Aufrufen unterstützt
Kopiere den Bright Data-Schlüssel aus der Tabelle API-Schlüssel im Tab Benutzer und API-Schlüssel:
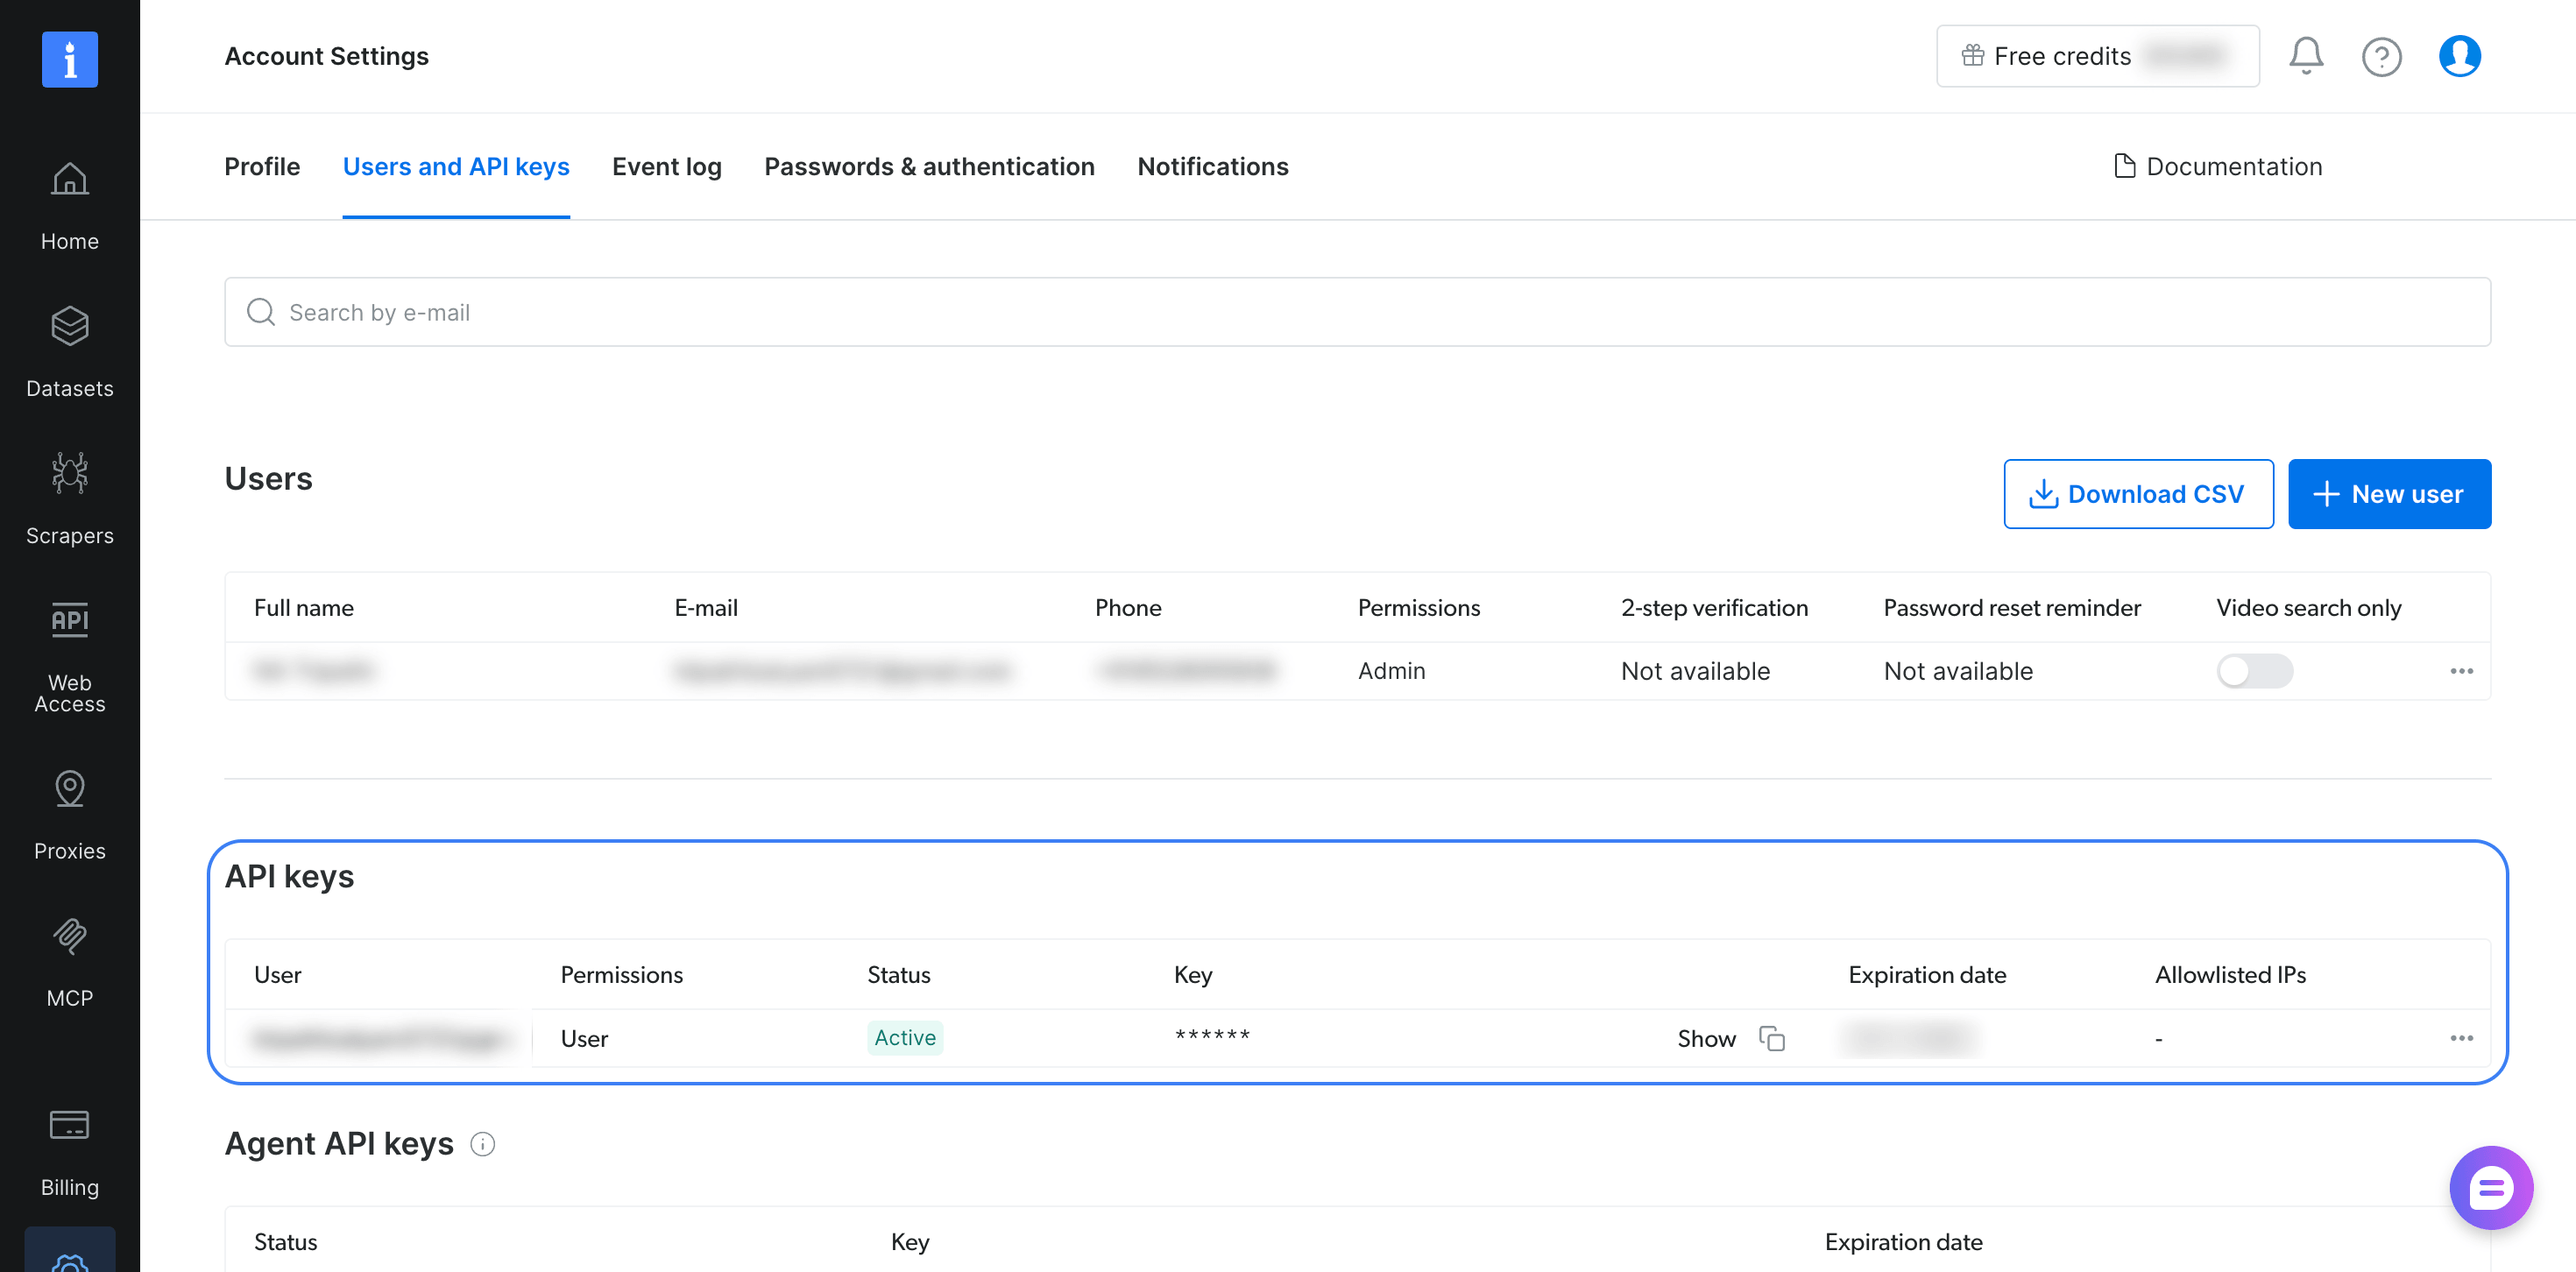
Derselbe Schlüssel funktioniert sowohl mit dem gehosteten als auch mit dem lokalen Server.
Klone das Repository, installiere DSPy mit seinem MCP-Extra, festgelegt auf die getesteten Versionen, und exportiere beide Schlüssel:
git clone https://github.com/triposat/dspy-bright-data-research-agent && cd dspy-bright-data-research-agent
uv venv && source .venv/bin/activate
uv pip install "dspy[mcp]==3.4.1" "mcp==2.3.0"
export BRIGHTDATA_API_TOKEN="your-bright-data-api-key"
export OPENAI_API_KEY="your-openai-api-key"
Der Befehl legt das MCP Python SDK auf die getestete Version 2.3.0 fest, da das dspy[mcp]-Extra in DSPy 3.4.1 die SDK-Version nicht festlegt. Du kannst mit kostenlosen monatlichen Anfragen beginnen, und die MCP-Server-Preisseite listet das aktuelle Kontingent auf.
Den Bright Data MCP-Server mit DSPy verbinden
dspy.Tool.from_mcp_tool konvertiert jedes Tool, das ein MCP-Server listet, in ein DSPy-Tool, sodass der Agent den Namen, die Beschreibung und das Argumentschema jedes Tools sieht. Das folgende Skript, agent.py im Repository, verbindet sich mit dem gehosteten Bright Data MCP-Server und lädt dessen Such- und Scrape-Tools. Dann fragt es nach einem Ereignis nach dem Wissensstichtag des Modells:
import asyncio
import os

import dspy
from mcp import types
from mcp.client import Client
from mcp.client.streamable_http import create_mcp_http_client, streamable_http_client

dspy.configure(
    lm=dspy.LM("openai/gpt-5.4-mini", temperature=1.0, max_tokens=16000),
    adapter=dspy.ChatAdapter(use_native_function_calling=True),
)

SERVER_URL = "https://mcp.brightdata.com/mcp?tools=search_engine,scrape_as_markdown"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_TOKEN']}"}


async def approve_page(context, params):
    # Der Server fragt nach, bevor er eine Seite zurückgibt, die MCP-Setup-
    # Anweisungen enthält. Die Tools dieses Agenten lesen nur das Web, also wird sie zurückgegeben.
    return types.ElicitResult(action="accept", content={"return_content": True})


class ResearchQuestion(dspy.Signature):
    """Beantworte die Frage mit im Web gefundenen Fakten."""

    question: str = dspy.InputField()
    answer: str = dspy.OutputField(desc="eine kurze, direkte Antwort")
    sources: list[str] = dspy.OutputField(desc="URLs der Seiten, die die Antwort stützen")


async def main():
    async with create_mcp_http_client(headers=HEADERS) as http:
        transport = streamable_http_client(SERVER_URL, http_client=http)
        async with Client(transport, elicitation_callback=approve_page) as client:
            mcp_tools = (await client.list_tools()).tools
            tools = [dspy.Tool.from_mcp_tool(client, t) for t in mcp_tools]
            agent = dspy.ReActV2(ResearchQuestion, tools=tools, max_iters=8)

            question = "Wer hat das FIFA-Weltmeisterschaftsfinale 2026 gewonnen, und wie war das Ergebnis?"
            pred = await agent.acall(question=question)
            for event in pred.history.messages:
                for call in getattr(event.get("tool_calls"), "tool_calls", []):
                    print(f"{call.name}: {call.args}")
            print("\nAnswer:", pred.answer)
            print("Sources:", pred.sources)


asyncio.run(main())
Das Ausführen von python agent.py gab 2 Suchen aus, dann den abschließenden submit-Aufruf:
search_engine: {'query': '2026 FIFA World Cup final winner score', 'engine': 'google', 'cursor': '', 'geo_location': 'us'}
search_engine: {'query': '2026 FIFA World Cup final winner score site:en.wikipedia.org OR site:fifa.com', 'engine': 'google', 'cursor': '', 'geo_location': 'us'}
submit: {'answer': 'Spanien gewann das FIFA-Weltmeisterschaftsfinale 2026 und besiegte Argentinien 1–0 nach Verlängerung.', 'sources': ['https://www.fifa.com/en/tournaments/mens/worldcup/canadamexicousa2026/final', 'https://www.fifa.com/en/tournaments/mens/worldcup/canadamexicousa2026/articles/spain-argentina-final-report-highlights']}

Answer: Spanien gewann das FIFA-Weltmeisterschaftsfinale 2026 und besiegte Argentinien 1–0 nach Verlängerung.
Sources: ['https://www.fifa.com/en/tournaments/mens/worldcup/canadamexicousa2026/final', 'https://www.fifa.com/en/tournaments/mens/worldcup/canadamexicousa2026/articles/spain-argentina-final-report-highlights']
Ohne Tools sagte gpt-5.4-mini, dass das Weltmeisterschaftsfinale 2026 nach seinem Wissensstichtag liegt.
Das Skript basiert auf dem DSPy MCP-Tutorial, das einen lokalen Demo-Server verwendet, und fügt 3 Einstellungen für den gehosteten Server hinzu.
Sende den API-Schlüssel in einem Header. create_mcp_http_client sendet den Schlüssel als Authorization-Header bei jeder Anfrage, sodass der Schlüssel nicht in URLs erscheint, die Proxys und Protokolle aufzeichnen.
Wähle die Tools, die der Agent benötigt. Der Bright Data MCP-Server bietet Tools für Suche, Scraping, Batch-Jobs, Browser-Automatisierung und vorgefertigte Scraper, die strukturiertes JSON für Seiten wie Amazon und LinkedIn zurückgeben. Der URL-Parameter tools wählt die aus, die der Agent sieht, und die MCP-Server-Tool-Referenz listet jeden Namen auf, wie search_engine_batch und scraping_browser_navigate. Das Schema jedes ausgewählten Tools wird bei jedem Modellaufruf gesendet, daher wählt dieser Agent nur search_engine und scrape_as_markdown, um den Prompt klein zu halten.
Beantworte die Elicitation-Anfragen des Servers. Der Bright Data MCP-Server enthält eine Schutzmaßnahme gegen Prompt-Injection. Wenn eine gescrapte Seite Anweisungen zum Ändern einer MCP-Konfiguration enthält, fragt der Server den Client, dies über MCP Elicitation zu bestätigen, bevor er die Seite zurückgibt. Übergebe einen Elicitation-Callback an Client mit dem Argument elicitation_callback, damit der DSPy-Client antworten kann.
approve_page genehmigt jede Anfrage, da dieser Agent nur das Web liest. Für einen Agenten, der Dateien schreiben oder seine eigene Konfiguration ändern kann, sende die Anfrage zur Genehmigung an eine Person.
Um den Server stattdessen lokal auszuführen, installiere Node.js und übergebe StdioServerParameters(command="npx", args=["-y", "@brightdata/mcp@latest"], env=...) an denselben Client, mit API_TOKEN und TOOLS in env. Mit @latest holt npx bei jedem Start die Version, auf die das latest-Tag zeigt. Für reproduzierbare Bewertungen ersetze es durch die getestete Version aus den Bright Data MCP-Releases.
In einem Jupyter Notebook ersetze asyncio.run(main()) durch await main(), da Jupyter bereits eine Event-Loop ausführt.
Das Skript verwendet dspy.ReActV2, das die DSPy ReAct-Dokumentation als die Implementierung auflistet, die dspy.ReAct ab DSPy 3.5 verwendet, wobei der Name ReActV2 in 3.6 entfernt wurde. ReActV2 gibt history statt trajectory zurück und schließt mit einem submit-Tool ab. Beim Upgrade ändere dspy.ReActV2 zu dspy.ReAct und führe deine Bewertung erneut aus.
Derselbe Server funktioniert auch mit anderen Agent-Frameworks, wie AutoGen, LangGraph und Pydantic AI.
Die DSPy MCP-Tools mit Threads und GEPA ausführen
In DSPy 3.4.1 führt dspy.Evaluate dein Programm synchron auf Worker-Threads aus, und GEPA verwendet es, um jede Kandidatenanweisung zu bewerten. Tools von from_mcp_tool sind asynchrone Funktionen, die an die Event-Loop gebunden sind, die die MCP-Sitzung geöffnet hat. Im Test schlug der Aufruf von synchronen Worker-Threads auf 2 Arten fehl, die leicht zu übersehen sind.
Mit wie im DSPy MCP-Tutorial geladenen Tools wurde Evaluate ohne Ausnahme abgeschlossen. Jeder Tool-Aufruf schlug fehl, bevor er den Server erreichte, und Python gab nur eine Warnung aus, dass eine Coroutine nie erwartet wurde. Der Agent antwortete aus dem Gedächtnis, und Evaluate meldete trotzdem einen Score. Mit aktivierter DSPy-Einstellung allow_tool_async_sync_conversion blieb der Lauf hängen und wartete noch 9 Minuten später.
Die Lösung hält eine einzige MCP-Sitzung auf einer Hintergrund-Event-Loop offen und gibt DSPy synchrone Funktionen, die jeden Aufruf an diese Loop senden:
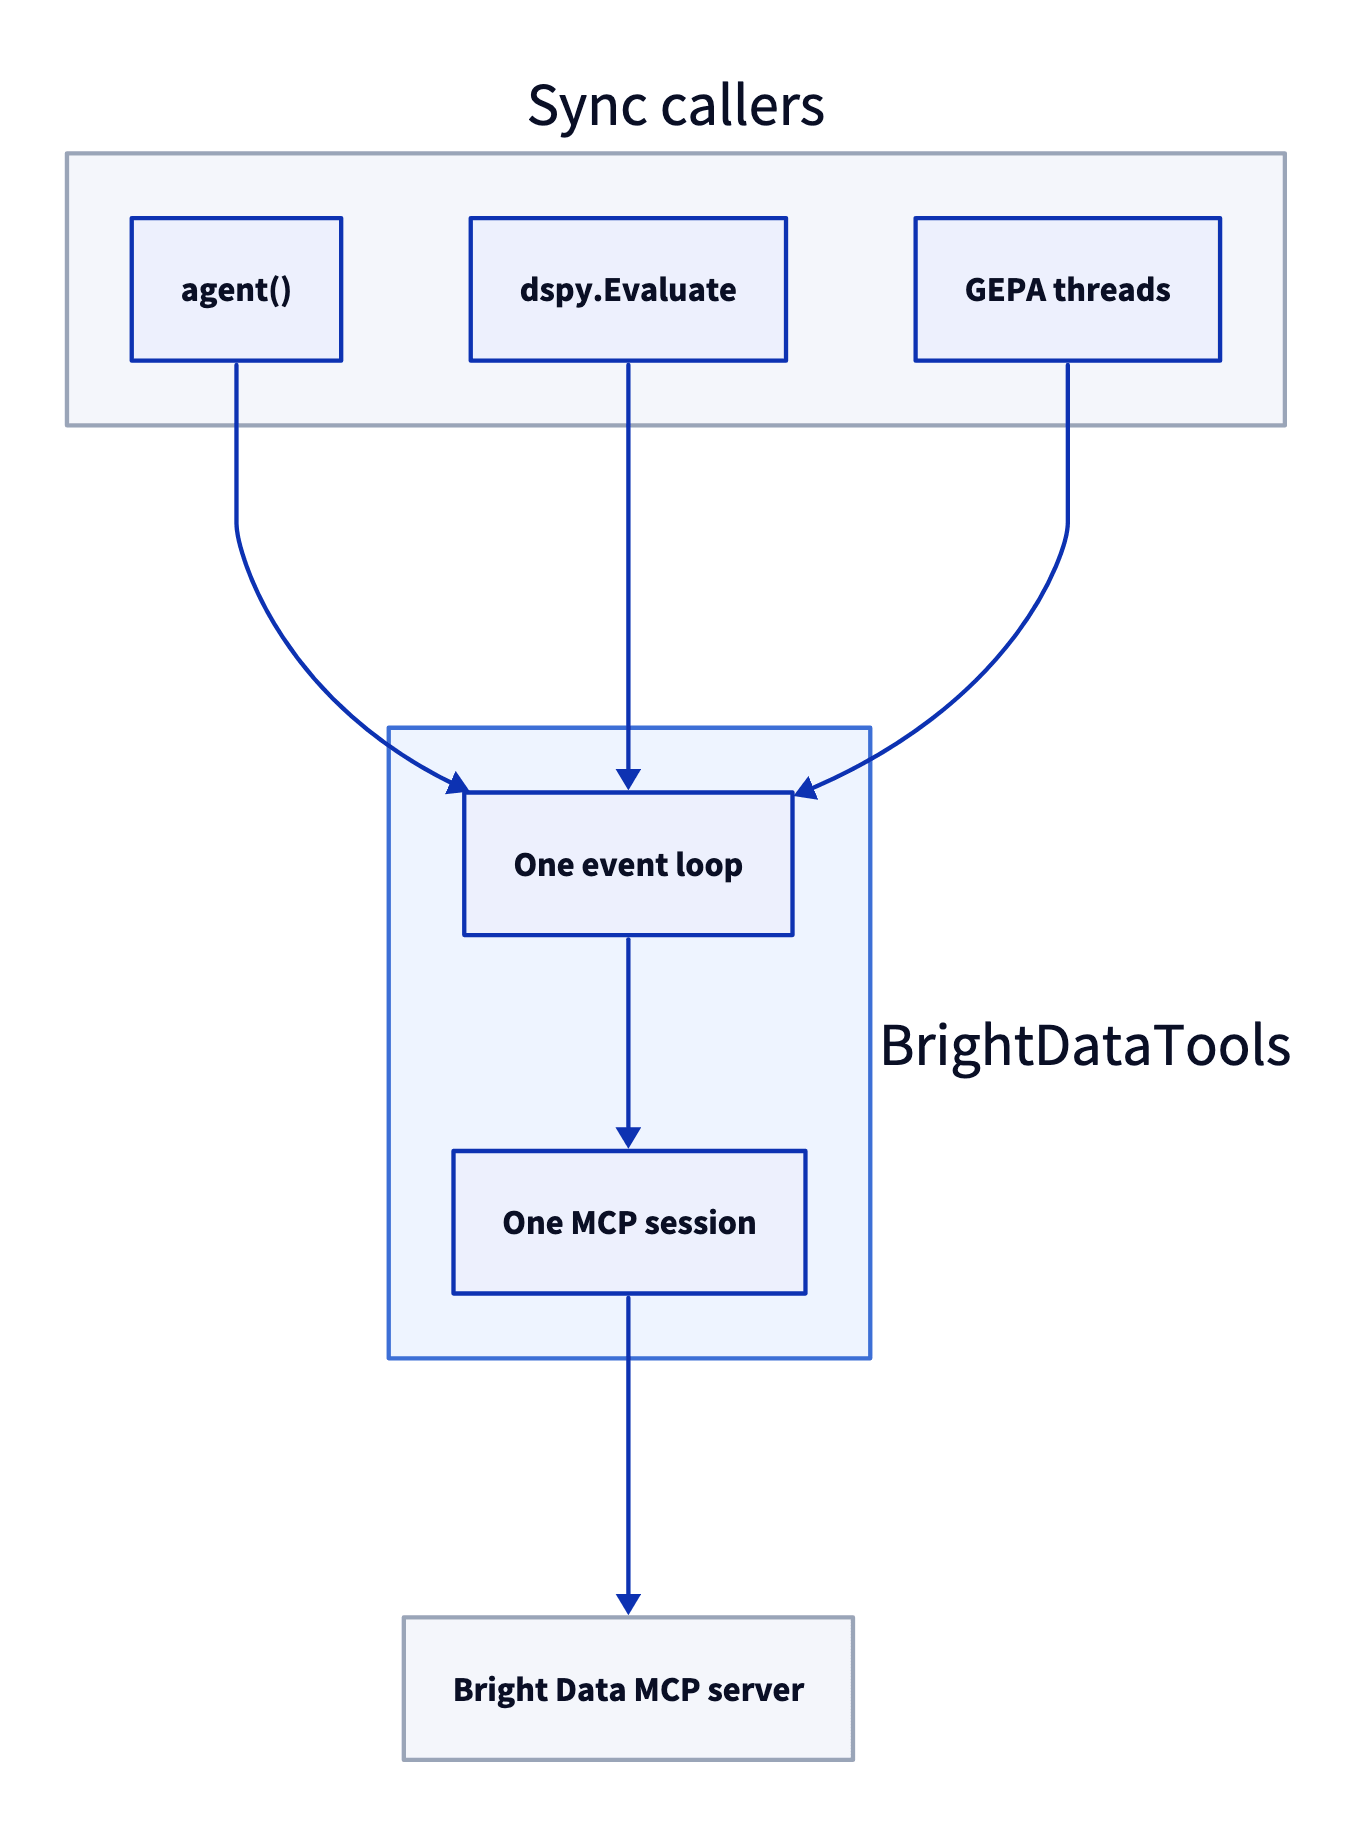
Jeder synchrone Aufruf wird mit run_coroutine_threadsafe an die Loop gesendet, sodass nur die Event-Loop, die die MCP-Sitzung geöffnet hat, diese Sitzung verwendet.
Die Klasse befindet sich in brightdata_tools.py, dem Modul, das die Bewertungs- und Optimierungsskripte importieren:
import asyncio
import json
import os
import re
import threading
from urllib.parse import urlparse

import dspy
from mcp import StdioServerParameters, types
from mcp.client import Client
from mcp.client.streamable_http import create_mcp_http_client, streamable_http_client

SERVER_URL = "https://mcp.brightdata.com/mcp?tools=search_engine,scrape_as_markdown"
# Der Bright Data MCP-Server verpackt Ergebnisse in einen Sicherheitshinweis und zwei Markierungen
WRAPPED = re.compile(r"(=====UNTRUSTED_\w+_BEGIN=====\n)(.*)(\n=====UNTRUSTED_\w+_END=====)", re.S)


async def approve_page(context, params):
    # Nur-Lese-Tools, daher werden Seiten mit MCP-Setup-Text als Daten zurückgegeben
    return types.ElicitResult(action="accept", content={"return_content": True})


class BrightDataTools:
    """Eine MCP-Sitzung auf einer Hintergrund-Event-Loop, als synchrone dspy.Tools bereitgestellt."""

    def __init__(self, country="us", max_chars=20_000, retries=2,
                 blocked_domains=(), timeout=180, cache=False, remote=True):
        self.country = country
        self.max_chars = max_chars
        self.retries = retries
        self.blocked = tuple(blocked_domains)
        self.timeout = timeout
        self.cache = {}  # Seiten immer, Suchen auch wenn cache=True
        self.keep_all = cache  # Suchergebnisse während der Optimierung wiederverwenden
        self.lock = threading.Lock()
        self.stats = {"calls": 0, "sent": 0, "errors": 0}
        self.error = None  # warum die MCP-Sitzung nicht gestartet werden konnte oder gestoppt wurde
        self.remote = remote
        self.loop = asyncio.new_event_loop()
        self.ready = threading.Event()
        self.thread = threading.Thread(target=self.loop.run_until_complete,
                                       args=(self._serve(),), daemon=True)
        self.thread.start()
        self.ready.wait()
        if self.error:
            raise RuntimeError("Verbindung zum MCP-Server nicht möglich") from self.error

    async def _serve(self):
        try:
            await self._connect()
        except Exception as e:  # melden statt ewig zu warten
            self.error = e
        finally:
            self.ready.set()

    async def _connect(self):
        token = os.environ["BRIGHTDATA_API_TOKEN"]
        if self.remote:  # gehosteter Server über streambares HTTP
            async with create_mcp_http_client(headers={"Authorization": f"Bearer {token}"}) as http:
                async with Client(streamable_http_client(SERVER_URL, http_client=http),
                                  elicitation_callback=approve_page) as client:
                    await self._hold(client)
        else:  # lokaler Server, neuestes Release
            local = StdioServerParameters(
                command="npx", args=["-y", "@brightdata/mcp@latest"],
                env={"API_TOKEN": token, "TOOLS": "search_engine,scrape_as_markdown",
                     "PATH": os.environ["PATH"]})
            async with Client(local, elicitation_callback=approve_page) as client:
                await self._hold(client)

    async def _hold(self, client):
        self.client = client
        self.mcp_tools = (await client.list_tools()).tools
        self.stop = asyncio.Event()
        self.ready.set()
        await self.stop.wait()

    def close(self):
        self.loop.call_soon_threadsafe(self.stop.set)
        self.thread.join(timeout=30)  # die Sitzung sauber beenden lassen

    def _is_blocked(self, url):
        host = urlparse(url).netloc.lower()
        return any(host == d or host.endswith("." + d) for d in self.blocked)

    def call(self, name, args):
        start = int(args.pop("start", 0) or 0)  # wo eine lange Seite fortgesetzt werden soll
        find = args.pop("find", "") or ""  # Ausdruck, nach dem auf einer langen Seite gesucht werden soll
        if name == "search_engine":
            args = {**args, "geo_location": self.country}
        if name == "scrape_as_markdown" and self._is_blocked(args.get("url", "")):
            return "Diese Domain ist für diese Aufgabe ausgeschlossen. Verwende eine andere Quelle."
        key = (name, json.dumps(args, sort_keys=True))
        with self.lock:
            self.stats["calls"] += 1
            text = self.cache.get(key)
        if text is None:
            try:
                text = self._send(name, args)
            except Exception:
                with self.lock:
                    self.stats["errors"] += 1  # der Agent sieht einen Fehler, keine Seite
                raise
            with self.lock:
                self.stats["sent"] += 1
                if self.keep_all or name == "scrape_as_markdown":
                    self.cache[key] = text  # Seiten bleiben zwischengespeichert, weiteres Lesen ist kostenlos
        wrapped = WRAPPED.search(text)
        head, body, tail = (text[:wrapped.start(2)], wrapped.group(2), text[wrapped.end(2):]
                            ) if wrapped else ("", text, "")
        if name == "search_engine" and self.blocked:
            data = json.loads(body)
            data["organic"] = [r for r in data.get("organic", [])
                               if not self._is_blocked(r["link"])]
            body = json.dumps(data, indent=1)
        if find:
            spans = [(max(0, m.start() - 1500), m.end() + 1500)
                     for m in re.finditer(re.escape(find), body, re.I)][:6]
            body = ("\n...\n".join(body[a:b] for a, b in spans)
                    or f"[{find!r} nicht auf der {len(body)}-Zeichen-Seite gefunden]")
        end = start + self.max_chars
        if len(body) > end:
            body = (body[start:end] + f"\n[zeigt Zeichen {start} bis {end} von {len(body)}. "
                    f"Rufe {name} erneut mit start={end} auf, um weiterzulesen, oder mit "
                    "find='ein Wort oder eine Phrase', um passende Abschnitte der gesamten Seite zu erhalten]")
        elif start:
            body = body[start:] + f"\n[Ende der Seite: Zeichen {start} bis {len(body)}]"
        return head + body + tail

    def _send(self, name, args):
        if self.error or not self.thread.is_alive():
            raise RuntimeError("Die MCP-Sitzung ist geschlossen") from self.error
        for _ in range(self.retries + 1):
            future = asyncio.run_coroutine_threadsafe(
                self.client.call_tool(name, args), self.loop)
            try:
                result = future.result(self.timeout)
            finally:
                future.cancel()  # ein zeitüberschrittener Aufruf stoppt, statt weiterzulaufen
            text = "\n".join(c.text for c in result.content if hasattr(c, "text"))
            wrapped = WRAPPED.search(text)
            body = wrapped.group(2) if wrapped else text
            if not result.is_error and body.strip():
                return text
        raise RuntimeError(text[:500] or "leeres Ergebnis")

    def tools(self):
        out = []
        for t in self.mcp_tools:
            spec = dspy.Tool.from_mcp_tool(self.client, t)  # Name, Beschreibung, Argumente
            args, types, desc = dict(spec.args), dict(spec.arg_types), spec.desc
            if t.name == "scrape_as_markdown":  # dem Agenten erlauben, über das Zeichenlimit hinaus zu lesen
                args["start"] = {"type": "integer", "default": 0,
                                 "description": "Zeichen-Offset, ab dem gelesen werden soll, für lange Seiten"}
                args["find"] = {"type": "string", "default": "",
                                "description": "Wort oder Phrase zum Finden; gibt passende Abschnitte zurück"}
                types["start"], types["find"] = int, str
                desc += (f" Gibt jeweils {self.max_chars} Zeichen zurück; übergib find, um "
                         "die gesamte Seite nach einem Wort oder einer Phrase zu durchsuchen.")

            def run(_name=t.name, **kwargs):
                return self.call(_name, kwargs)

            out.append(dspy.Tool(run, name=spec.name, desc=desc,
                                 args=args, arg_types=types))
        return out
BrightDataTools().tools() gibt 2 synchrone Tools zurück, die die Toolnamen, Beschreibungen und Argumente des Servers beibehalten. Das Scrape-Tool erhält 2 zusätzliche Argumente, start und find, sodass der Agent Text über das Zeichenlimit hinaus lesen kann, das max_chars festlegt. Der Bright Data MCP-Server verpackt Ergebnisse in einen Sicherheitshinweis, der den Seitentext markiert und dem Modell sagt, es als Daten zu behandeln. Die Klasse filtert und kürzt nur den markierten Text, sodass das Modell weiterhin den vollständigen Hinweis erhält.
Die Einstellungen des Konstruktors:
remote=Falseverwendet den lokalen statt des gehosteten Servers.countrylegtgeo_locationbei jeder Suche fest, sodass jeder Lauf Ergebnisse für dasselbe Land erhält.max_charsbegrenzt jedes Ergebnis auf 20.000 Zeichen, da manche Seiten sehr lange Seiten veröffentlichen, wie vollständige Wikipedia-Artikel. Ohne das Limit hatte 1 Modellanfrage 491.564 Token und überschritt das Kontextfenster des Modells. Damit benötigte keine Frage mehr als 58.651 Prompt-Token in 2 Bewertungsläufen. Seiten bleiben zwischengespeichert, sodass ein Aufruf mitstartoderfindkeine neue Anfrage sendet.retriesundtimeouthelfen langen Bewertungsläufen, abzuschließen. Ein Aufruf, der einen Fehler zurückgibt, wird bis zu 2 Mal erneut gesendet, und ein Aufruf, der nachtimeoutSekunden noch läuft, wird abgebrochen, statt im Hintergrund weiterzulaufen. Jeder weiterhin fehlschlagende Aufruf wird instats["errors"]gezählt, dasevaluate.pyundoptimize.pyausgeben. Prüfe es, bevor du einem Score vertraust, denn der Agent antwortet aus dem Gedächtnis, wenn seine Tools fehlschlagen.blocked_domainsentfernt ausgewählte Seiten aus Suchergebnissen und blockiert das Scraping dieser Seiten. Verwende es während der Bewertung und lasse es in der Produktion leer.cache=Trueverwendet auch Suchergebnisse wieder, undoptimize.pyaktiviert dies.
BrightDataTools ist für synchrone, threaded Jobs wie dspy.Evaluate und GEPA gebaut und funktioniert unverändert in einem Jupyter Notebook. In einem asynchronen Webdienst, wie einem FastAPI-Endpunkt, führe einen auf BrightDataTools aufgebauten Agenten in einem Worker-Thread mit await asyncio.to_thread(agent, question=question) aus, sodass die Event-Loop weiterhin andere Anfragen bedient.
Den Agenten mit SimpleQA Verified bewerten
GEPA verbessert ein Programm, indem es es mit einer Metrik bewertet, daher braucht der Agent zuerst Fragen mit bekannten Antworten. SimpleQA Verified liefert diese. Es ist eine öffentliche, MIT-lizenzierte Sammlung von 1.000 kurzen Faktenfragen mit verifizierten Antworten.
Lade die Fragen in den Repository-Ordner herunter:
curl -L -o simpleqa_verified.csv https://huggingface.co/datasets/google/simpleqa-verified/resolve/main/simpleqa_verified.csvresearch.py enthält den Agenten, einen SimpleQA-ähnlichen LLM-Bewerter namens grader, und die Metrik, die GEPA verwendet:
import csv
import random

import dspy

# Hosts, die die Benchmark-Antworten veröffentlichen, während der Bewertung ausgeschlossen
EVAL_BLOCKLIST = ("huggingface.co", "github.com", "raw.githubusercontent.com",
                  "kaggle.com", "openaipublic.blob.core.windows.net")

AGENT_LM = dspy.LM("openai/gpt-5.4-mini", temperature=1.0, max_tokens=16000)
JUDGE_LM = dspy.LM("openai/gpt-5.4-mini", temperature=1.0, max_tokens=16000)


class ResearchQuestion(dspy.Signature):
    """Beantworte die Frage mit im Web gefundenen Fakten."""

    question: str = dspy.InputField()
    answer: str = dspy.OutputField(desc="eine kurze, direkte Antwort")
    sources: list[str] = dspy.OutputField(desc="URLs der Seiten, die die Antwort stützen")


def make_agent(tools):
    return dspy.ReActV2(ResearchQuestion, tools=tools, max_iters=8)


def load_examples(path="simpleqa_verified.csv", seed=7):
    rows = list(csv.DictReader(open(path)))
    random.Random(seed).shuffle(rows)
    return [dspy.Example(question=r["problem"], gold=r["answer"]).with_inputs("question")
            for r in rows]


class Grade(dspy.Signature):
    """Bewerte eine vorhergesagte Antwort gegen die Gold-Antwort, im SimpleQA-Stil.
    CORRECT: die Vorhersage enthält die Bedeutung der Gold-Antwort und widerspricht ihr nicht.
    Kleine Rechtschreib- oder Formatierungsunterschiede sind in Ordnung; bei Zahlen und Daten muss der Wert übereinstimmen.
    INCORRECT: die Vorhersage gibt eine andere oder widersprüchliche Antwort an, oder zögert zwischen mehreren.
    NOT_ATTEMPTED: die Vorhersage gibt keine Antwort."""

    question: str = dspy.InputField()
    gold_answer: str = dspy.InputField()
    predicted_answer: str = dspy.InputField()
    grade: str = dspy.OutputField(desc="CORRECT, INCORRECT oder NOT_ATTEMPTED")


grader = dspy.Predict(Grade)


def tool_calls(pred):
    calls = []
    history = getattr(pred, "history", None)
    for event in (history.messages if history else []):
        for call in getattr(event.get("tool_calls"), "tool_calls", []):
            if call.name != "submit":
                calls.append((call.name, call.args))
    return calls


def metric(gold, pred, trace=None, pred_name=None, pred_trace=None):
    """Score für GEPA, plus Feedback, das nie die Referenzantwort zeigt."""
    answer = getattr(pred, "answer", "") or ""
    with dspy.context(lm=JUDGE_LM):
        grade = grader(question=gold.question, gold_answer=gold.gold,
                       predicted_answer=answer).grade.strip().upper()
    correct = grade.startswith("CORRECT")
    calls = tool_calls(pred)
    searches = [args.get("query") for name, args in calls if name == "search_engine"]
    pages = [args.get("url") for name, args in calls if name == "scrape_as_markdown"]
    feedback = (f"Grade: {'CORRECT' if correct else 'INCORRECT'}. Agent antwortete: {answer!r}. "
                f"Suchen ({len(searches)}): {searches}. Geöffnete Seiten ({len(pages)}): {pages}.")
    if not correct and not pages:
        feedback += " Der Agent antwortete, ohne eine Seite zu öffnen."
    return dspy.Prediction(score=float(correct), feedback=feedback)


def leaked_answers(instruction, examples):
    """Referenzantworten (4+ Zeichen), die eine optimierte Anweisung wiederholt."""
    text = instruction.lower()
    return sorted({ex.gold for ex in examples if len(ex.gold) >= 4 and ex.gold.lower() in text})
Der Bewerter verwendet das eigene kleine Modell des Agenten, um SimpleQAs 3 Noten zu vergeben, die korrekt, falsch und nicht versucht sind. Die Metrik gibt einen Score und schriftliches Feedback zurück, das die Suchen und Seiten des Agenten auflistet, aber nicht die Referenzantwort. Während der Bewertung blockiert EVAL_BLOCKLIST die Seiten, die die Antworten des Benchmarks veröffentlichen, sodass der Agent jede Antwort im offenen Web finden muss.
evaluate.py im Repository führt den Agenten auf einem Ausschnitt der gemischten Fragen aus, 8 auf einmal, und speichert jede Antwort in results.json. Standardmäßig bewertet es die 60 Testfragen. --no-tools bewertet das Modell allein, und --local verwendet den lokalen Server. Die Läufe ergaben diese Ergebnisse:
Setup, alle mit gpt-5.4-mini |
Korrekt, von denselben 60 SimpleQA Verified-Fragen |
|---|---|
| Nur Modell, keine Tools | 14 (1 Lauf) |
Agent mit Bright Data Tools, lokaler Server, ohne find |
58, 55, 58, 54 (4 Läufe) |
Agent mit Bright Data Tools, gehosteter Server, mit find |
57 (1 Lauf) |
Alle 46 Fehler des Modells allein waren spezifische falsche Antworten, wie Omaha für einen in Beatrice, Nebraska, geborenen Maler. Die falschen Antworten des Modells sahen wie korrekte aus.
Wiederholte Läufe desselben Agenten zeigen, wie viel von jedem einzelnen Score Rauschen ist. Die 4 Läufe des Agenten unterschieden sich teilweise wegen zufälliger Modellsamples und der Bewertung des Richters. Der Agent nannte in verschiedenen Läufen unterschiedliche Instrumente für dasselbe John-Cage-Stück, und der Richter bewertete “4½ Punkte” als korrekt, aber “4,5” als falsch für denselben Schachwert.
Behandle eine Veränderung von bis zu 4 Fragen von 60 als Rauschen und vergleiche Programme Frage für Frage in ihren gespeicherten Ergebnissen, nicht anhand von Summen. DSPy cached Modellaufrufe standardmäßig, also setze cache=False bei beiden LMs, bevor du einen Lauf wiederholst.
Überprüfe auch die Noten des Richters stichprobenartig, besonders wenn der Richter dasselbe Modell wie der Agent ist. Bei einer manuellen Überprüfung von 1 anderen Lauf waren alle 60 Noten korrekt, wenn sie mit den Referenzantworten verglichen wurden.
Was ein Lauf kostet. Ein Lauf mit 60 Fragen hatte im Durchschnitt 2,3 Tool-Aufrufe pro Frage, weniger als 200 Anfragen an Bright Data, und 0,29 $ an gpt-5.4-mini-Aufrufen für den Agenten. Die vollständige Bewertung passt in die kostenlosen monatlichen Anfragen.
Den Agenten bei Ereignissen nach dem Wissensstichtag des Modells testen
Die stabilen Fragen von SimpleQA Verified sind nicht dafür konzipiert, Fakten nach dem Wissensstichtag des Modells zu testen. Für diese Fakten enthält post_cutoff_questions.csv im Repository 14 Fragen zu Ereignissen aus 2025 und 2026, mit gegen Wikipedia geprüften Antworten. Führe python evaluate.py --csv post_cutoff_questions.csv --start 0 --n 14 aus, dann erneut mit --no-tools. Jedes Setup lief einmal:
| Fragen zu, je 1 Lauf | gpt-5.4-mini allein |
gpt-5.4-mini mit Bright Data Tools, gehosteter Server |
|---|---|---|
| Ereignisse 2025 | 5 von 6 | 6 von 6 |
| Ereignisse 2026 | 0 von 8 | 8 von 8 |
Ohne Tools sagte das Modell, dass mehrere Ereignisse von 2026 noch nicht stattgefunden hätten. Es kannte 5 von 6 Fakten aus 2025, obwohl es sagte, sein Wissensstichtag sei Juni 2024. Teste, was ein Modell weiß, statt seinem angegebenen Wissensstichtag zu vertrauen, und füge Fragen aus deinem eigenen Anwendungsfall hinzu, deren Antworten nur auf kürzlich veröffentlichten Seiten erscheinen.
Den Agenten mit GEPA optimieren
GEPA ist DSPys reflektierender Prompt-Optimierer. Er führt das Programm auf kleinen Chargen von Trainingsfragen aus. Dann zeigt er die fehlgeschlagenen Läufe und das Feedback der Metrik einem stärkeren Reflexionsmodell, das in diesen Läufen gpt-5.5 ist. GEPA behält die neuen Anweisungen, die auf einem Validierungssatz am besten abschneiden.
GEPA braucht falsche Antworten, um daraus zu lernen. Wenn der Agent jede ausgewählte Trainingsfrage korrekt beantwortet, schlägt GEPA keine neue Anweisung vor.
Baue also den Trainingssatz aus Fragen auf, die der Agent falsch beantwortet. Führe python evaluate.py --start 108 --n 400 --out pool.json bei Fragen außerhalb des Testsatzes aus. optimize.py kombiniert dann 12 falsche mit 12 korrekten Antworten für den Trainingssatz und baut den Validierungssatz auf dieselbe Weise auf:
import json
import random

import dspy
from brightdata_tools import BrightDataTools
from research import AGENT_LM, EVAL_BLOCKLIST, leaked_answers, make_agent, metric

dspy.configure(lm=AGENT_LM, adapter=dspy.ChatAdapter(use_native_function_calling=True))

# Halb falsche, halb korrekte Antworten aus einem evaluate.py-Lauf außerhalb des Testsatzes
pool = json.load(open("pool.json"))
misses = [r for r in pool if not r["correct"] and not r.get("error")]
hits = [r for r in pool if r["correct"]]
random.Random(0).shuffle(hits)


def to_ex(rows):
    return [dspy.Example(question=r["question"], gold=r["gold"]).with_inputs("question")
            for r in rows]


half = min(12, len(misses) // 2)
trainset = to_ex(misses[:half] + hits[:half])
valset = to_ex(misses[half:2 * half] + hits[half:2 * half])

bd = BrightDataTools(blocked_domains=EVAL_BLOCKLIST, cache=True)
agent = make_agent(bd.tools())
gepa = dspy.GEPA(
    metric=metric,
    reflection_lm=dspy.LM("openai/gpt-5.5", temperature=1.0, max_tokens=32000),
    max_metric_calls=300,
    num_threads=8,
    track_stats=True,
    log_dir="gepa_logs",
)
optimized = gepa.compile(agent, trainset=trainset, valset=valset)
optimized.save("optimized_agent.json")

instruction = optimized.react.signature.instructions
print(instruction)
print("Trainingsantworten in der Anweisung:", leaked_answers(instruction, trainset + valset))
print("Tool-Aufrufe:", bd.stats["calls"], "| gesendete Anfragen:", bd.stats["sent"],
      "| Fehler:", bd.stats["errors"])
bd.close()
Führe es mit python optimize.py aus. Der Cache in BrightDataTools ist hier wichtig, da GEPA dieselben Fragen viele Male stellt. In 1 GEPA-Lauf beantwortete der Cache 524 von 994 Tool-Aufrufen ohne neue Anfrage.
Diese 4 GEPA-Läufe verwendeten jeweils 24 Trainingsfragen, 24 Validierungsfragen und dieselben 60 Testfragen:
| Trainingssatz | Erwartete Antwort im Feedback | Validierungsscore, von 24 | In die Anweisung kopierte Trainingsantworten | Testscore, von 60 |
|---|---|---|---|---|
| 24 zufällige Fragen | Ja | 21 bis 23 | 3 | 55, 52 |
| 24 zufällige Fragen | Nein | 24, keine neue Anweisung | 0 | Nicht gemessen |
| 12 falsche, 12 korrekte Antworten | Ja | 18 bis 21 | 3 | 57, 55 |
| 12 falsche, 12 korrekte Antworten | Nein | 20 bis 21 | 3 | Nicht gemessen |
GEPA kann Trainingsantworten in die Anweisung schreiben. Die Anweisung aus dem ersten Lauf endete so:
Bekannte Fakten, die für wiederholte Fragen nützlich sein könnten:
- Galip Ulsoy erhielt 2013 den Charles Russ Richards Memorial Award von ASME und Pi Tau Sigma. ...
- Die Größe des Koshi/Kosi-Flussbeckens wird üblicherweise mit etwa 74.500 km² angegeben. ...
- Beim Erdbeben in Nepal/Gorkha am 25. April 2015 trat etwa 34 Minuten nach dem ursprünglichen Mw 7,8-Ereignis ein Nachbeben der Stärke Mw 6,6 auf ...
Jede Zeile beantwortet 1 Trainingsfrage, und jede Anweisung, die GEPA in diesem Lauf vorschlug, hatte einen ähnlichen Block. Das Verbergen der erwarteten Antwort stoppte dies nicht. Das Reflexionsmodell übernahm dann die Antworten aus den eigenen korrekten Läufen des Agenten, wie die Anzahl der Haushalte in Weston, Ohio, bei der Volkszählung im Jahr 2000.
Führe falsche Antworten erneut aus, bevor du darauf trainierst. Beim Validierungssatz, der aus falschen Antworten aufgebaut wurde, erzielte der Basis-Agent bereits 18 bis 20 von 24. Mindestens 6 seiner 12 falschen Antworten waren also bei einer Wiederholung korrekt. Behalte nur die Fragen, die der Agent in mehr als einem Lauf falsch beantwortet.
Miss das Ergebnis bei zurückgehaltenen Fragen. Die Validierungsscores stiegen bei jedem Lauf, der eine Anweisung vorschlug. Bei den 60 Testfragen erzielten die optimierten Programme 52 bis 57, und der Basis-Agent mit Bright Data Tools erzielte 54 bis 58. Die Anweisungsänderungen von GEPA erhöhten den Score nicht messbar, und allein der erste Lauf kostete 3,31 $ an Modellaufrufen für den gpt-5.4-mini-Agenten und das gpt-5.5-Reflexionsmodell.
Überprüfe die Anweisung auf kopierte Antworten. leaked_answers in research.py erkennt Referenzantworten von 4 oder mehr Zeichen, die eine Anweisung wiederholt. In diesen Läufen fand es die meisten kopierten Antworten, aber ein String-Abgleich erkennt keine kurzen Zahlen oder umformulierten Antworten. Lies die gesamte Anweisung und lösche jede Zeile über eine bestimmte Trainingsfrage.
Tool-Korrekturen mit Fehleranalyse finden
GEPA schreibt nur Anweisungen um, kann also kein Problem in den Tools selbst beheben. Die Fehleranalyse der falschen Antworten findet diese Probleme. Hier häuften sich die falschen Antworten bei Daten und Zahlen. Über 3 Läufe und 519 bewertete Fragen beantwortete der Agent etwa 15% der Fragen zu Daten und Zahlen falsch, verglichen mit 7% der Fragen zu Personen und Orten.
Diese Läufe begrenzten jede Seite auf 20.000 Zeichen mit der eigenen max_chars-Einstellung des Agenten. Bei 24 von seinen 62 falschen Antworten hatte der Agent eine Seite geöffnet, die länger als das Limit war. Bei erneutem vollständigem Abruf hatten 6 dieser Seiten die Antwort nach dem Limit:
| Vom Agenten geöffnete Seite | Antwort beginnt bei Zeichen (Limit des Agenten ist 20.000) | Antwort des Agenten | Korrekte Antwort |
|---|---|---|---|
| Wikipedia, Äquinoktium | 38.604 | Äquinoktium | Äquilux |
| Wikipedia, ChromeOS | 24.709 | Oktober 2011 | August 2011 |
| Wikipedia, Cannibal Corpse | 25.566 | März 1993 | Februar 1993 |
| Aseprite-Release-Notes | 59.987 | v1.2.22 | v1.3-rc8 |
| Baseball-Reference, Tim Wakefield | 65.663 | 2,25 | 12,27 |
| RuPaul’s Drag Race Wiki, Staffel 1 | 99.250 | “I Will Survive” | “Stronger” |
In allen 6 Fällen zitierte der Agent die Seite, die die korrekte Antwort enthielt. Ein Zitat zeigt, wo der Agent nachgesehen hat, nicht was auf der Seite steht.
In BrightDataTools, der Wrapper-Klasse, gibt start die nächsten 20.000 Zeichen zurück, und find gibt bis zu 6 Passagen von etwa 3.000 Zeichen um jede Übereinstimmung eines Wortes oder einer Phrase zurück. Eine Notiz am Ende einer gekürzten Seite informiert den Agenten über beide Argumente. Das Paging allein war nicht genug. In einem separaten Test mit nur start forderte der Agent den nächsten Teil einer Seite in 3 von 18 Läufen an.
Jedes Setup lief 8 Mal pro Frage:
| Setup, dieselben 6 Fragen zu langen Seiten | Korrekt, von 48 Läufen | Prompt-Token pro Lauf | gpt-5.4-mini-Kosten, alle 48 Läufe |
|---|---|---|---|
| Nur Zeichenlimit | 24 | 23.023 | 0,52 $ |
Zeichenlimit mit start und find |
33 | 11.908 | 0,35 $ |
Der Agent rief find in 28 der 48 Läufe auf. Der Genauigkeitsgewinn ist vielversprechend, aber bei 48 Läufen pro Version noch nicht statistisch signifikant (p ≈ 0,10).
Überprüfe Quellen, bevor du sie Benutzern zeigst. Der Agent zitierte oft Suchergebnisse, die er nie geöffnet hatte. In den lokalen Läufen hatte er weniger als 1 von 4 der zitierten URLs geöffnet. Um eine Quelle zu prüfen, rufe das BrightDataTools-Scrape-Tool mit find und einem charakteristischen Teil der Antwort auf.
Jeden Tool-Aufruf mit MLflow nachverfolgen
Eine Trace zeigt jede Suche, die der Agent durchgeführt hat, und jede Seite, die er gelesen hat. Damit kannst du sehen, wie der Agent jede Antwort erzeugt hat, und schnell den Schritt finden, der eine falsche verursacht hat. Die MLflow DSPy-Integration zeichnet jedes Modul, jeden Modellaufruf und jeden Tool-Aufruf als Span auf. Installiere die getestete MLflow-Version:
uv pip install "mlflow==3.17.1"Füge dann diese Zeilen zu agent.py hinzu, bevor der Agent läuft:
import mlflow

mlflow.set_tracking_uri("sqlite:///mlflow.db")
mlflow.dspy.autolog()
MLflow 3.17 braucht ein Datenbank-Backend, daher wird die Tracking-URI auf eine lokale SQLite-Datei gesetzt. Führe mlflow ui --backend-store-uri sqlite:///mlflow.db aus, um die Traces anzuzeigen. Dieser Span-Baum stammt aus 1 Frage:
CHAIN       ReActV2.forward
LLM         Predict.forward          x6
CHAT_MODEL  LM.__call__              x6
PARSER      ChatAdapter.format       x6
TOOL        Tool.search_engine       x4
TOOL        Tool.scrape_as_markdown  x1
TOOL        Tool.submit              x1
Jeder TOOL-Span speichert die Argumente, die das Modell gesendet hat, und den Text, den der Bright Data MCP-Server zurückgegeben hat. Das Auswählen des ersten Such-Spans in der MLflow-Benutzeroberfläche zeigt beides für diesen Aufruf:
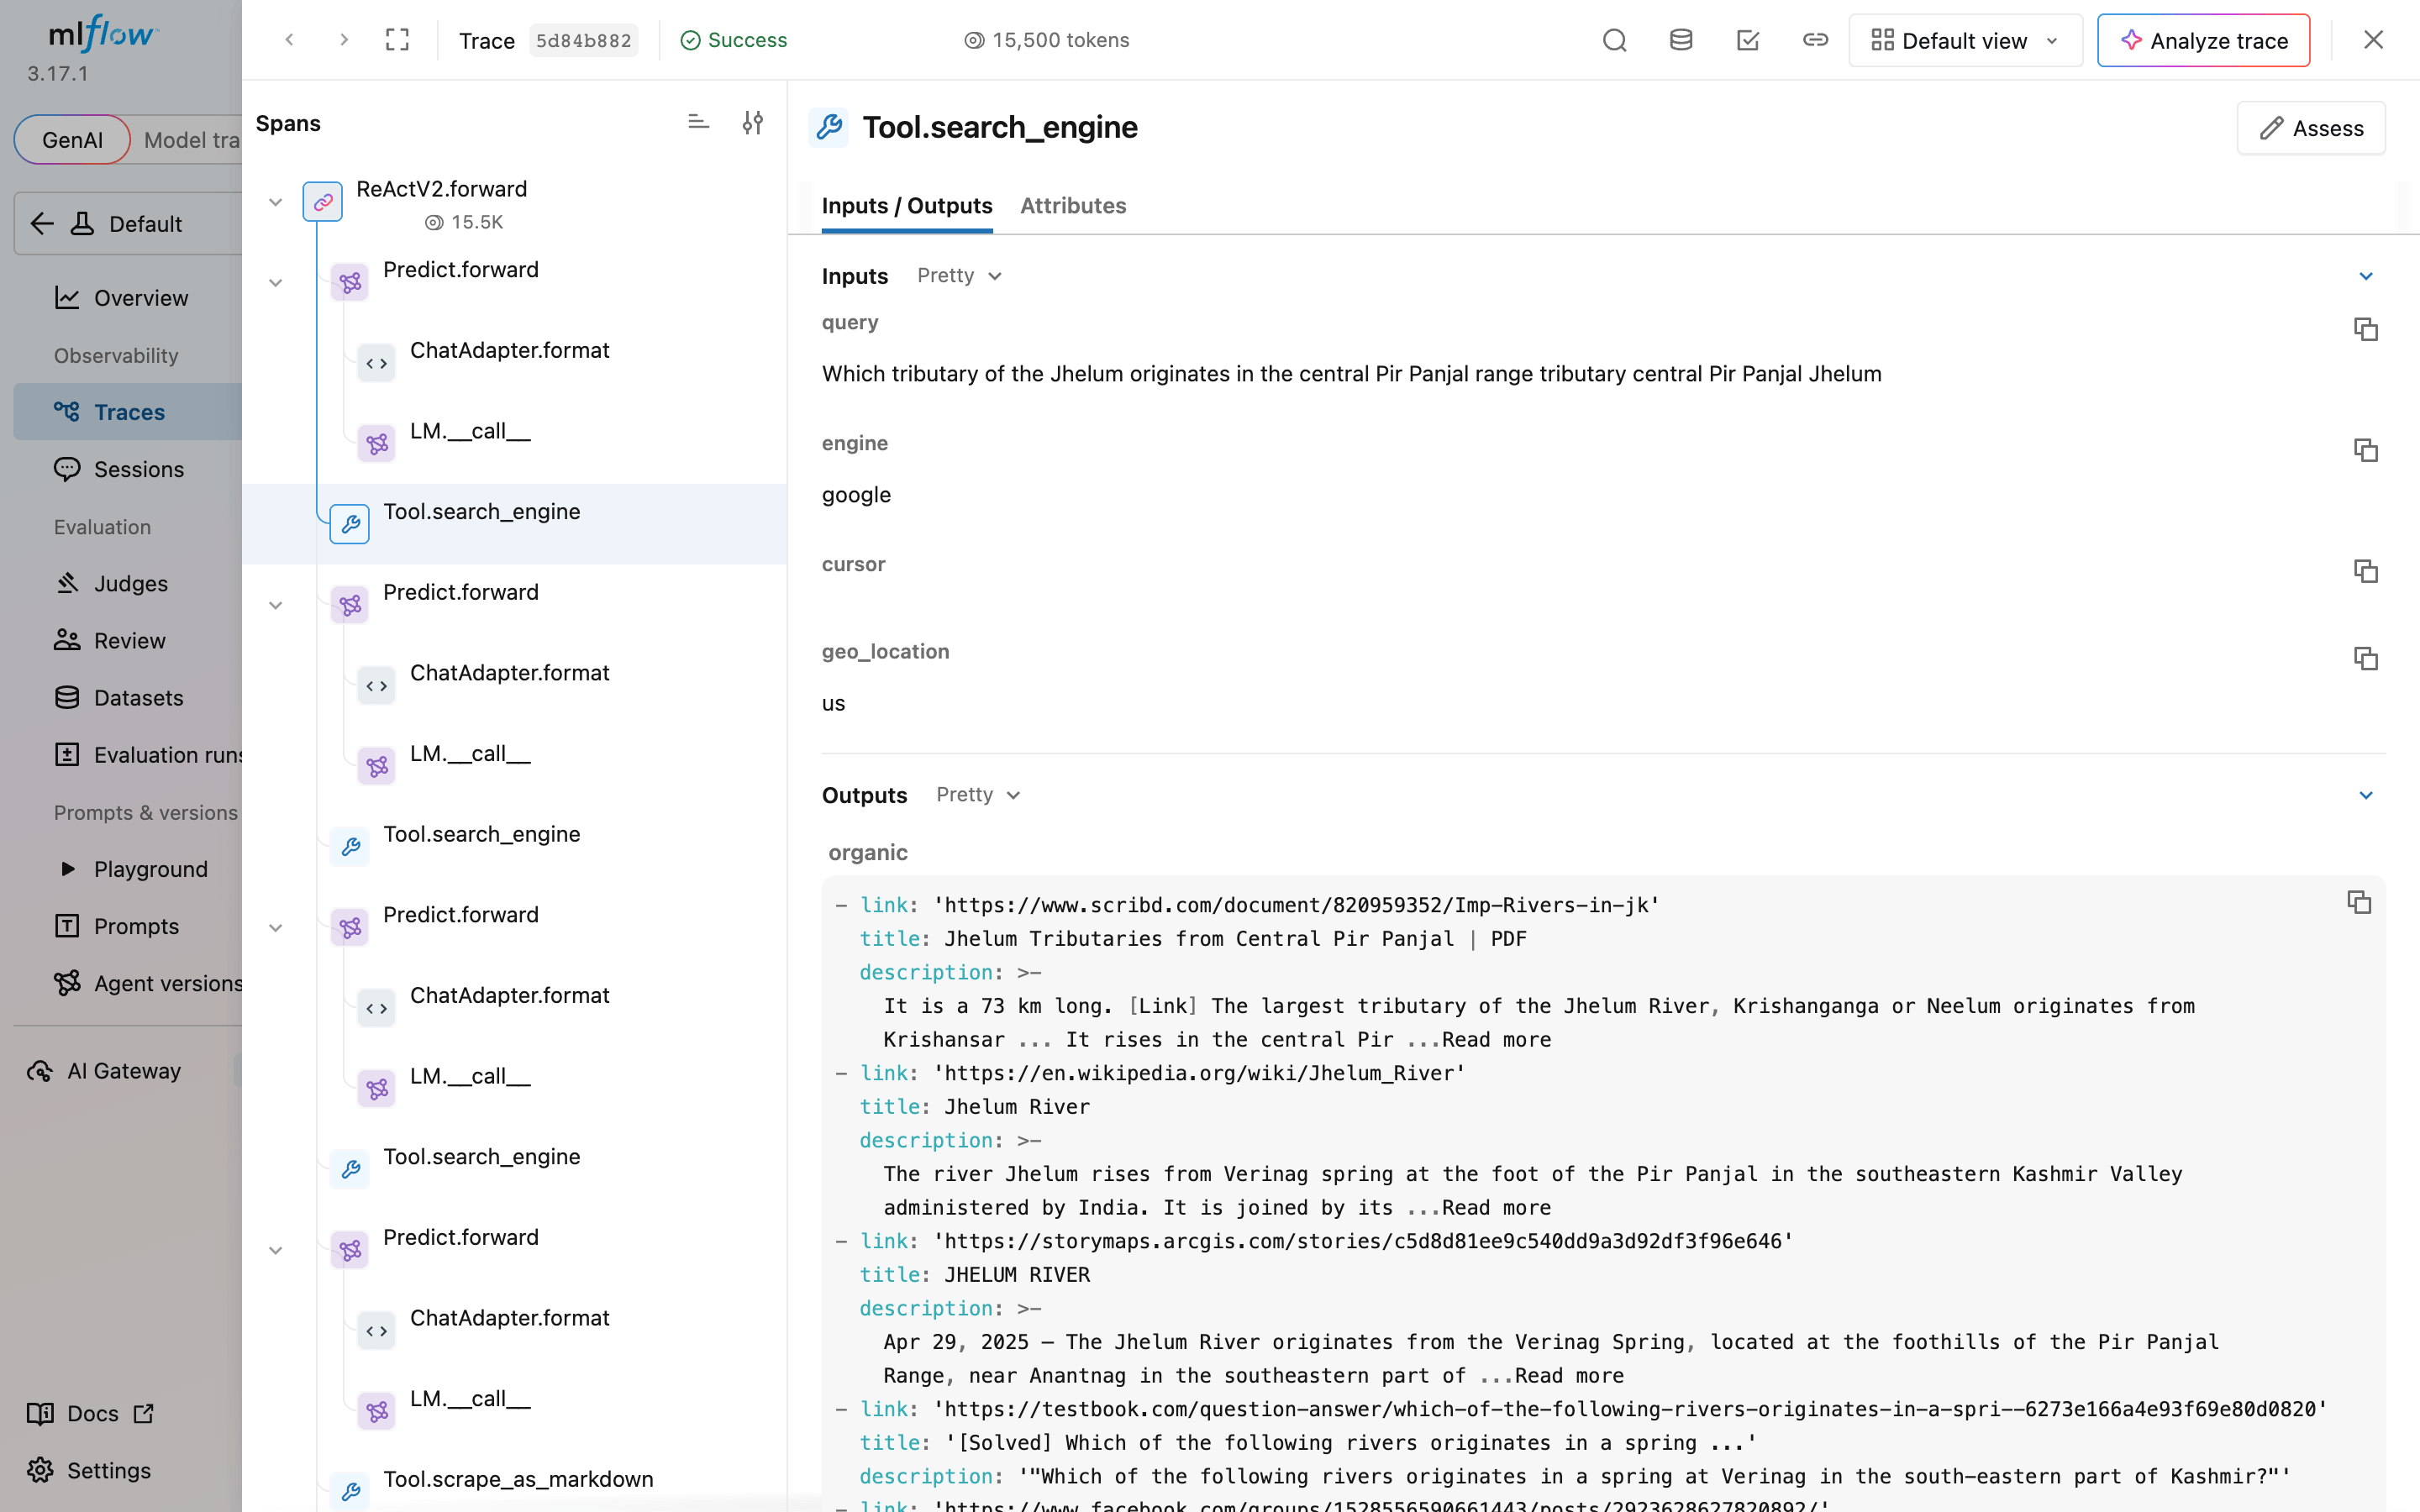
Bei einer falschen Antwort zeigt diese Ansicht, ob die Abfrage des Agenten eine Seite mit der korrekten Antwort gefunden hat.
Abschließende Gedanken
Mit dem Bright Data MCP-Server beantwortete dieser DSPy-Agent 54 bis 58 von 60 Benchmark-Fragen korrekt, gegenüber 14 zuvor, und alle 8 Fragen zu Ereignissen nach seinem Wissensstichtag. Um ihn zu bewerten und zu optimieren, halte die MCP-Sitzung auf ihrer eigenen Event-Loop, da dspy.Evaluate und GEPA Tools von Worker-Threads aus aufrufen. Überprüfe die falschen Antworten, bevor du optimierst, denn 6 davon hatten hier die Antwort über das eigene Zeichenlimit des Agenten hinaus, und find lässt den Agenten die gesamte Seite durchsuchen. GEPA kann am meisten helfen, wenn falsche Antworten eine Ursache teilen, die eine Anweisung beheben kann, und du solltest seine Ausgabe auf kopierte Antworten überprüfen. Erstelle ein kostenloses Bright Data-Konto, führe agent.py bei einer Frage aus, die dein Modell nicht aus dem Gedächtnis beantworten kann, und führe evaluate.py bei deinen eigenen Fragen aus.
FAQ
Unterstützt DSPy MCP-Server?
Ja. Mit dspy.Tool.from_mcp_tool und einem Client aus dem MCP Python SDK konvertiert DSPy die Tools eines MCP-Servers, wie des Bright Data MCP-Servers, in DSPy-Tools. Installiere das MCP-Extra mit pip install "dspy[mcp]". In DSPy 3.4.1 sind MCP-Tools asynchron, rufe Agenten also mit acall auf. Bei Worker-Threads verwende synchrone Wrapper auf einer Hintergrund-Event-Loop.
Ist DSPy ein MCP-Client?
Nein, nicht von sich aus. DSPy verwendet einen Client aus dem MCP Python SDK, und dspy.Tool.from_mcp_tool konvertiert die Tools dieses Clients in DSPy-Tools. DSPy baut und optimiert das Agentenprogramm, und MCP verbindet den Agenten mit Servern wie dem Bright Data MCP-Server.
Wie füge ich einem DSPy-Agenten Websuche hinzu?
Verbinde den Bright Data MCP-Server und übergib seine Such- und Scrape-Tools an dspy.ReActV2, die Implementierung, die dspy.ReAct ab DSPy 3.5 verwendet. Der Agent durchsucht Google, liest Seiten als Markdown und gibt seine Quell-URLs zurück. Eine Python-Funktion, die die Bright Data SERP-API aufruft, die Suchergebnisse als JSON zurückgibt, funktioniert ebenfalls als DSPy-Tool.
Welches Websuche-Tool funktioniert mit DSPy?
Der Bright Data MCP-Server gibt einem DSPy-Agenten Google-Ergebnisse und vollständige Seiten als Markdown über eine einzige Verbindung, und der Server übernimmt den Bot-Schutz. Bei 60 SimpleQA Verified-Fragen beantwortete gpt-5.4-mini damit 54-58 korrekt, gegenüber 14 ohne. Andere Suchwerkzeuge funktionieren auch, und der Vergleich von Suchwerkzeugen für KI-Agenten behandelt sie.
Was ist DSPy ReActV2?
dspy.ReActV2 ist das experimentelle DSPy-Agentenmodul, das auf nativem Tool-Aufruf aufbaut. Es behält strukturierten Verlauf, kann mehrere Tool-Aufrufe pro Runde machen und schließt mit einem submit-Tool ab. Die DSPy-Dokumentation listet es als die Implementierung, die dspy.ReAct ab DSPy 3.5 verwendet, wobei der Name ReActV2 in 3.6 entfernt wurde.
Ist DSPy noch relevant?
Ja, für Programme, die du mit einer Metrik bewerten kannst. DSPy hält die Aufgabe getrennt vom Prompt, sodass du Modelle wechseln und mit einer Metrik und einem Optimierer wie GEPA neu optimieren kannst. Mit Standardeinstellungen schlägt GEPA nur dann Änderungen vor, wenn das Programm noch einige Trainingsfragen falsch beantwortet, bewerte das Programm also zuerst.
Ist DSPy produktionsreif?
Ja, wenn du Versionen festlegst und die Tool-Aufrufe robust machst. Lege dspy und jeden MCP-Server fest, begrenze die Größe der Tool-Ausgabe, lass den Agenten Text über dieses Limit hinaus durchsuchen, füge Wiederholungen, Timeouts und Fehlerzählungen zu Tool-Aufrufen hinzu, und verfolge Läufe mit MLflow nach. Experimentelle Module wie ReActV2 können sich zwischen Nebenversionen ändern.
Kann DSPy für Prompt-Optimierung verwendet werden?
Ja. DSPy-Optimierer wie GEPA schreiben die Anweisungen eines Programms basierend auf bewerteten Beispielen um. GEPA überprüft bewertete Läufe und ihr schriftliches Feedback und schlägt neue Anweisungen vor, dann behält es diejenigen, die auf einem Validierungssatz am besten abschneiden. Überprüfe das Ergebnis, bevor du es bereitstellst, da GEPA manchmal Trainingsantworten in die Anweisung kopieren kann.