Yelp zu scrapen bedeutet, Unternehmenseinträge, Bewertungen und Rezensionen für Sentimentanalyse, Marktforschung oder Vertriebsleads zu sammeln. Yelps Self-Serve-API-Pläne enthielten höchstens 7 Rezensionsauszüge pro Unternehmen, während yelp.com den vollständigen Text anzeigt.
Yelps Bot-Schutz gab bei jeder Python-HTTP-Anfrage, die wir sendeten, eine Challenge-Seite zurück. Ein lokaler Chromium-Browser erhielt ein Slider-CAPTCHA. Selbst wenn eine Unternehmensseite geladen wurde, enthielt ihr HTML keinen vollständigen Rezensionstext.
Dieser Leitfaden zeigt, wo Yelp seine Daten speichert und wie man Unternehmensdetails und vollständige Rezensionen in Python sammelt. Er erklärt auch, wann Bright Datas Yelp Scraper API verwendet werden sollte.
TL;DR
- DataDome, Yelps Bot-Schutz, stoppte Python-HTTP-Clients mit einer JavaScript-Challenge, selbst mit TLS-Imitation und US-Residential-IPs. Bright Datas Web Unlocker API lud alle 30 getesteten Unternehmensseiten.
- Vollständige Rezensionen kamen von Yelps GraphQL-API, bis zu 49 pro Aufruf. Die 582 empfohlenen Rezensionen eines Restaurants benötigten 12 Aufrufe.
- Die persistente Abfrage-ID kann sich ändern, wenn Yelp ein Deployment durchführt, und ein Browser-API-Skript erfasst die neue. Ein Open-Source-Scraper veröffentlichte eine veraltete ID.
- Bright Datas Yelp Scraper API übernimmt für Sie die Parser- und Abfrage-ID-Wartung, zu einem höheren Preis pro Rezension. Sie sammelt auch Rezensionen, die Yelp nicht empfiehlt.
Was einen Yelp-Scraper blockiert
In unseren Tests waren Yelps Seiten durch DataDome geschützt, einen kommerziellen Bot-Schutzdienst. Die blockierten Antworten enthielten dessen Header (server: DataDome und x-datadome: protected) und setzten ein datadome-Cookie.
Wir sendeten Anfragen für Yelp-Unternehmensseiten von mehreren Client-Setups. Die Clients umfassten curl_cffi, einen Python-HTTP-Client, der den TLS-Handshake eines Browsers imitiert.
Über Heim-Breitband forderte jedes Setup dieselbe Seite an. Über US-Residential-Proxys forderte jeder Client 12 verschiedene Seiten an. Keines der Setups bestand die Challenge:
| Client | Netzwerk | Was Yelp zurückgab |
|---|---|---|
requests und httpx (HTTP/2) |
Heim-Breitband außerhalb der USA | 403 CAPTCHA-Seite, jeweils 5 von 5 |
curl_cffi mit Chrome-, Safari- oder Firefox-TLS-Profil |
Heim-Breitband außerhalb der USA | 403 Device-Check-Seite, jeweils 5 von 5 |
curl_cffi mit Chrome-TLS-Profil und Python-User-Agent |
Heim-Breitband außerhalb der USA | 403 CAPTCHA-Seite, 5 von 5 |
requests und curl_cffi |
US-Residential-Proxys, neue IP pro Anfrage | 403 Device-Check-Seite, jeweils 12 von 12 |
| Playwright mit headless Chromium | Heim-Breitband außerhalb der USA | 403 CAPTCHA-Seite |
| Playwright mit headed Chromium | Heim-Breitband außerhalb der USA | Zuerst Device-Check, dann ein Slider-CAPTCHA innerhalb von 8 Sekunden |
Jeder 403-Body dieser Setups war DataDomes Challenge-Seite. Die Seite bettete ein var dd={...}-Objekt ein, und das rt-Feld des Objekts zeigte den Challenge-Typ an. Der Wert c lud das CAPTCHA-Skript, und i lud eine Device-Check-Seite.
Bei der Heimverbindung erhielten requests und httpx c. Mit einem Browser-TLS-Profil erhielt curl_cffi i, und mit einem Python-User-Agent wieder c. Über US-Residential-IPs erhielt auch die requests-Bibliothek i. Das Erzwingen von HTTP/1.1 in curl_cffi gab dieselbe Device-Check-Seite zurück.
Der Device-Check führte JavaScript aus, und ein HTTP-Client kann es nicht ausführen. Ein headed Browser führte den Device-Check durch und erhielt dann diesen Slider:
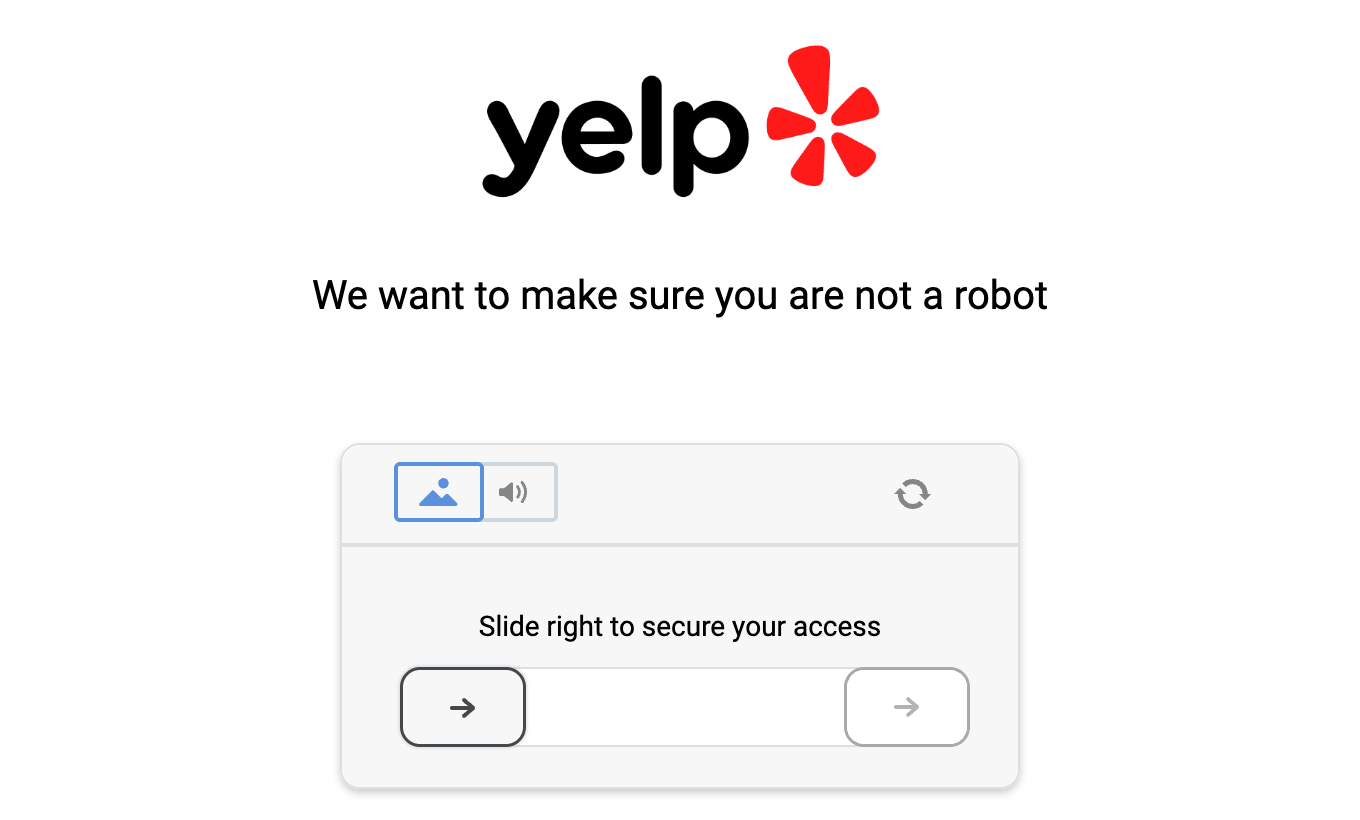
Eine headed Chromium-Sitzung über eine Heimverbindung zeigte diesen Slider innerhalb von 8 Sekunden nach dem Laden der Seite. Wenn eine Person den Slider ziehen muss, kann ein Scraper nicht automatisch laufen.
Die HTTP-Clients stoppten an einer JavaScript-Challenge, die sie nicht ausführen konnten, selbst über US-Residential-IPs. Die Browser konnten JavaScript ausführen, verwendeten aber eine einzelne Heim-IP, und Yelp gab an diese IP CAPTCHA-Seiten zurück. Bright Datas Web Unlocker API übernimmt für Sie die Browser-Umgebung, die IP und DataDome-Challenges, einschließlich der CAPTCHAs auf Yelp. Jede Yelp-Anfrage im Python-Scraper nutzt sie.
Wo Yelp Unternehmens- und Rezensionsdaten speichert
Bright Datas Browser API, ein Cloud-Browser, den Sie mit Playwright steuern, zeigt, wie eine Yelp-Unternehmensseite ihre Daten lädt. Ein protokollierter Seitenaufruf sendete 12 XHR- und Fetch-Anfragen an www.yelp.com, und 7 der 12 waren POST-Anfragen an /gql/batch. Die Daten befanden sich an 3 Stellen:
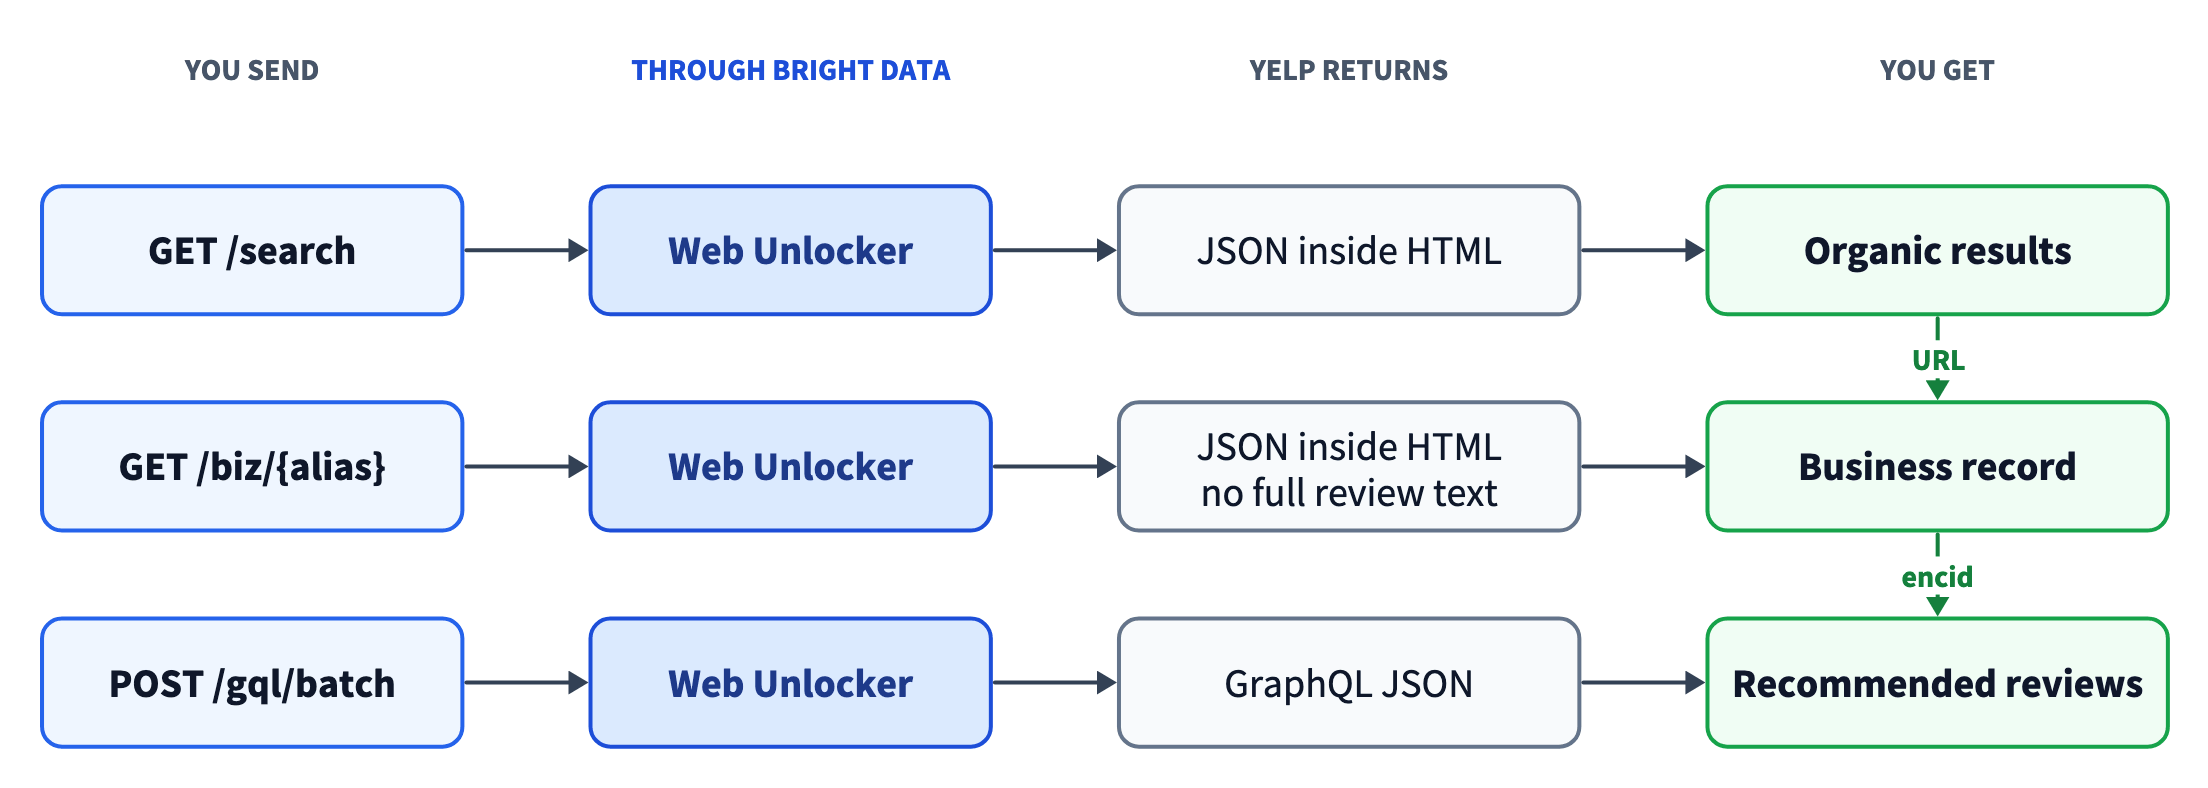
Such- und Unternehmensseiten enthielten ihre Daten als JSON innerhalb des HTML. Rezensionen benötigten einen separaten GraphQL-Aufruf, der die Unternehmens-ID von der Seite verwendete.
Suchseiten
Yelp rendert Suchergebnisse serverseitig mit Hypernova, das 2 JSON-Objekte in das HTML einbettete. Ein <script data-hypernova-key>-Tag enthielt die Seiten-Props, einschließlich der Liste der Ergebniskarten. Ein <script data-apollo-state>-Tag enthielt einen Apollo-Client-Cache. Beide JSON-Objekte waren in einen HTML-Kommentar eingebettet, und der Apollo-Cache war zusätzlich HTML-escaped (").
Die 2 Objekte teilten jedes Ergebnis zwischen sich auf. Eine organische Karte enthielt nur ihre bizId, Rang und URL, während Name, Bewertung und Rezensionsanzahl im Apollo-Cache unter Business:<bizId> standen. Gesponserte Karten waren umgekehrt, mit ihren Details inline und Links über /adredir. Ein Parser, der nur die Karten liest, würde volle Details für gesponserte Ergebnisse erhalten und keinen Namen, keine Bewertung oder Rezensionsanzahl für organische.
Auf der gerenderten Suchseite sahen die 2 Kartentypen so aus:
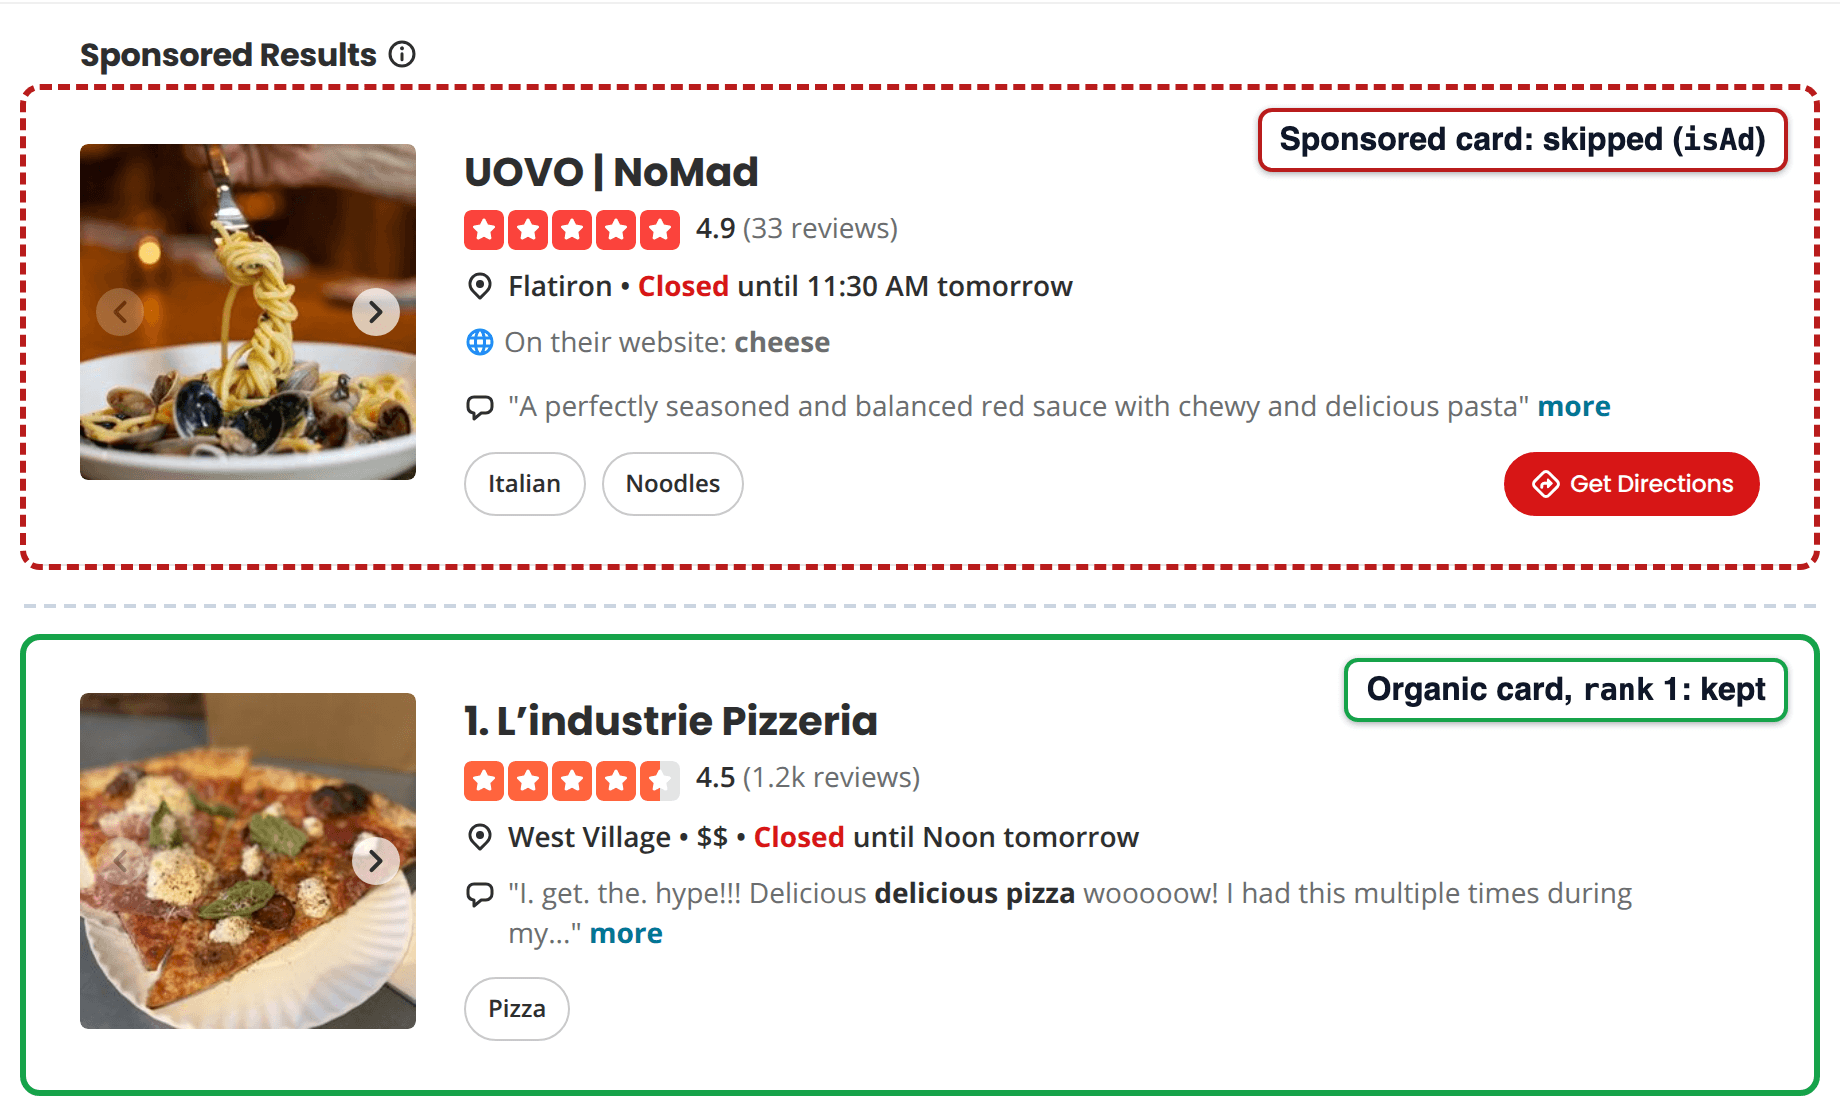
Yelp listete gesponserte Ergebnisse vor den nummerierten organischen Ergebnissen auf. parse_search() behält den Rang jeder organischen Karte bei und überspringt jede als isAd markierte Karte.
Die Yelp-Suche begrenzte auch die Anzahl der Ergebnisse. Der Paginierungsblock meldete totalResults: 240 für alle 4 von uns geprüften Abfragen, einschließlich “Restaurants” in Dallas, und jede Seite zeigte 10 Ergebnisse. Um Ergebnisse für eine ganze Stadt zu sammeln, teilen Sie die Abfrage nach Stadtteil, Kategorie oder Kartenbereich auf.
Unternehmensseiten
Eine Unternehmensseite enthielt denselben Apollo-Cache, und dieser Cache enthielt die meisten Unternehmensfelder. Dazu gehörten die Unternehmens-ID (encid), Bewertung, Rezensionsanzahl, Adresse, Telefon, Preisspanne, Kategorien, Beanspruchungsstatus und Website. Das <meta name="yelp-biz-id">-Tag enthielt ebenfalls die encid. Suchkarten nennen dieselbe ID bizId, und die GraphQL-Anfrage nennt sie encBizId.
Auf der Seite von L’industrie Pizzeria erschienen diese Felder im Header und in der Seitenleiste:
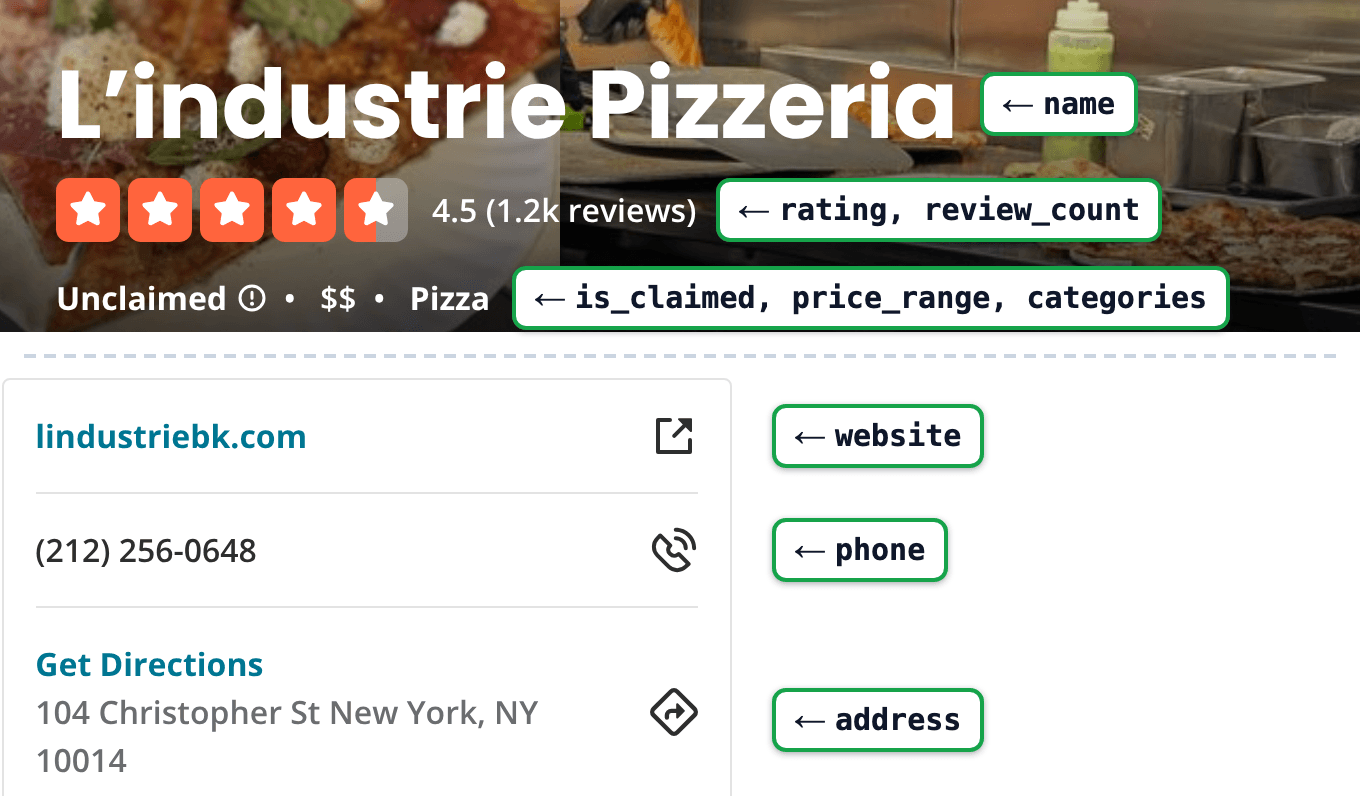
Die Labels sind die Schlüssel, die parse_business() zurückgibt, und jeder Wert stammte aus dem Apollo-Cache im HTML der Seite. Die Seite rundete die Rezensionsanzahl auf 1,2k, während der Cache die genaue Zahl enthielt.
Ältere Leitfäden lasen die Bewertung aus JSON-LD und die Rezensionen aus der Seite selbst. Auf allen 19 von uns gespeicherten Unternehmensseiten enthielten die JSON-LD-Blöcke nur Fotolisten und Breadcrumbs, ohne Unternehmensbewertung. Der Apollo-Cache enthielt auf keiner der 19 Seiten vollständigen Rezensionstext.
Auf 14 dieser Seiten hatte der Cache Rezensions-IDs und kurze Highlight-Auszüge, und die anderen 5 hatten keine Rezensionsreferenzen. Die vollständige Rezensionsliste wurde später geladen, über eine GraphQL-Anfrage vom Browser.
Rezensionen in der GraphQL-API
Rezensionen kamen von Yelps GraphQL-Endpunkt. Die Seite sendete ein POST an /gql/batch mit einem JSON-Array von Operationen, und die Operation GetBusinessReviewFeed gab die Rezensionsliste zurück. Yelp verwendete persistente Abfragen, sodass die Anfrage eine 64 Zeichen lange persistente Abfrage-ID (documentId) anstelle des Abfragetexts enthielt. Der Server lehnte IDs ab, die er nicht erkannte.
Das Öffnen von Seite 2 der Rezensionen sendete diese Anfrage, hier in Chrome DevTools dargestellt:
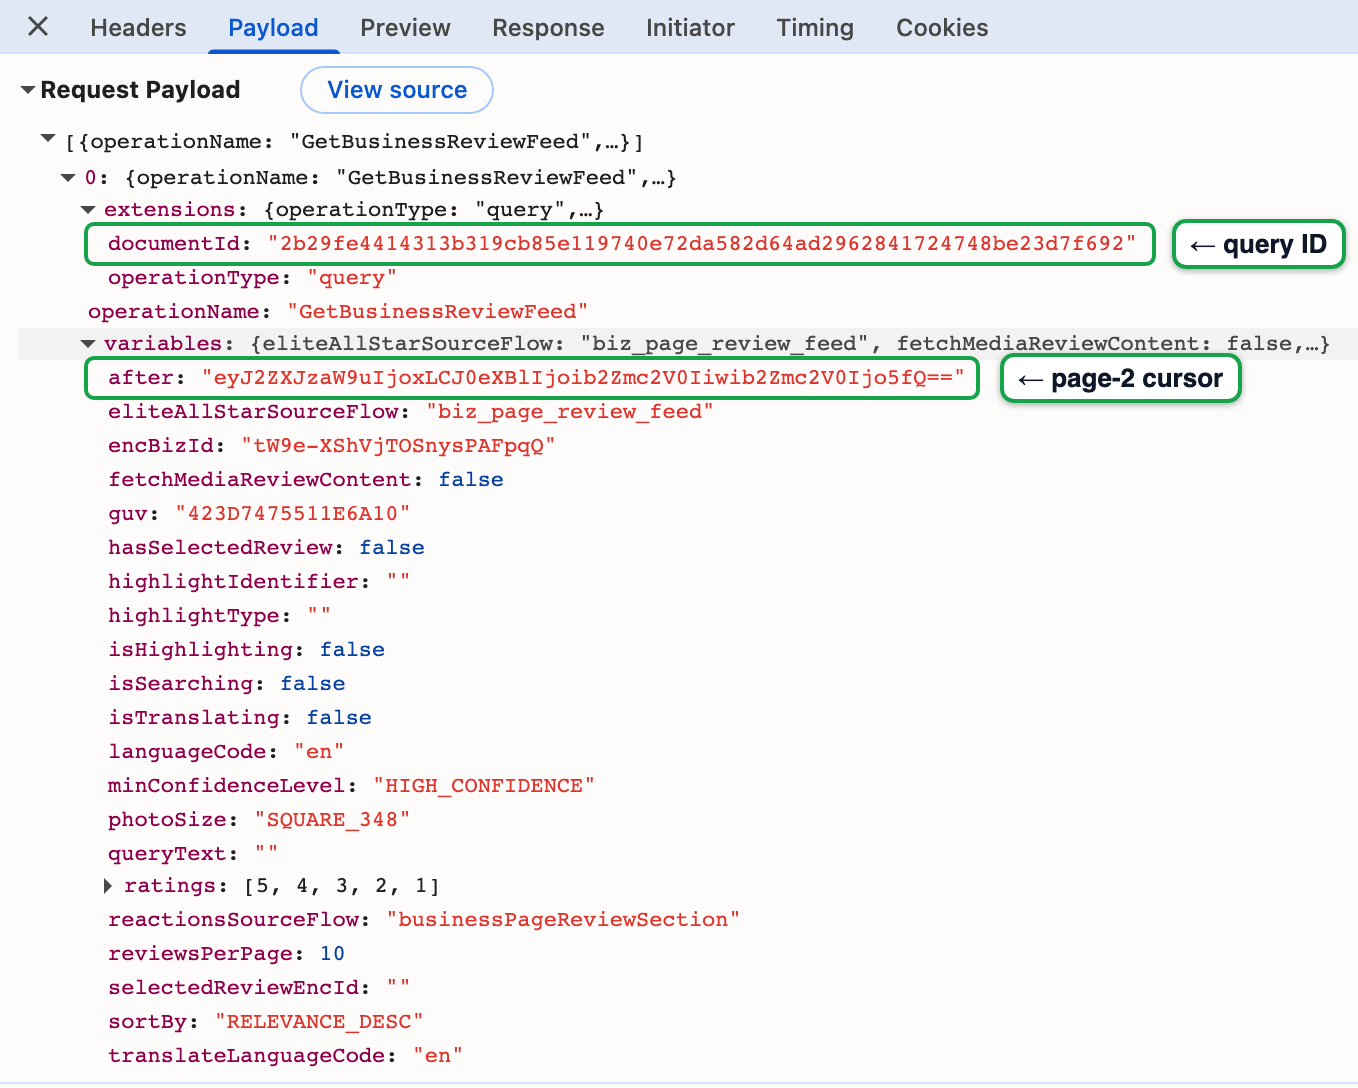
Die eigene Anfrage der Seite für Rezensionsseite 2. Der Scraper sendet dieselbe documentId und erstellt den after-Cursor selbst.
Die GraphQL-API verhielt sich in unseren Tests so:
- Seitengröße:
reviewsPerPageakzeptierte 49. Ein Wert von 50 gab einenBAD_USER_INPUT-Fehler zurück. - Paginierung: der
after-Cursor war base64-kodiertes JSON. Der Browser forderte 10 Rezensionen pro Seite an, und der Cursor für Seite 2 dekodierte zu{"version":1,"type":"offset","offset":9}. Dieses Format erlaubt es, den Cursor jeder Seite selbst zu erstellen und die Seiten parallel abzurufen. - Sortierung und Filter:
sortByakzeptierteRELEVANCE_DESC,DATE_DESC,DATE_ASC,RATING_ASCundELITES_DESC. Einratings-Wert von[1]reduziertetotalCountauf 35. Das ist die Anzahl der 1-Sterne-Rezensionen bei Ziziki’s in Dallas, dem Restaurant, das wir für die GraphQL-Tests verwendeten. - Fehler: Validierungsfehler wurden in einer HTTP-200-Antwort zurückgegeben und listeten jede fehlende Variable auf. Eine unbekannte
documentIderhielt im Browser eine HTTP-403-AntwortForbidden. Über Web Unlocker gab dieselbe Anfrage502mit dem Fehlercodehttp_statuszurück, was bedeutet, dass Yelp einen Fehlerstatus zurückgab. Keine der beiden Antworten enthielt DataDomes Challenge-Seite, sodass eine veraltete ID nicht wie eine Blockierung aussieht. - Umfang:
GetBusinessReviewFeedgab Yelps empfohlene Rezensionen zurück, den Satz, den die Unternehmensseite auflistet. Laut Yelp verschiebt dessen Software Rezensionen, die es als unzuverlässig, angefordert oder unfair voreingenommen markiert, in eine separate nicht empfohlene Liste. Bei Ziziki’s betrugtotalCount582, der Unternehmens-Header zeigte 583, und der eingeklappte Bereich der Seite zeigte 39 nicht empfohlene Rezensionen.
Yelps Seite zeigte dieselbe Aufteilung. Unter der Rezensions-Paginierung zeigte ein eingeklappter Bereich die Anzahl der Rezensionen, die sie nicht empfahl:
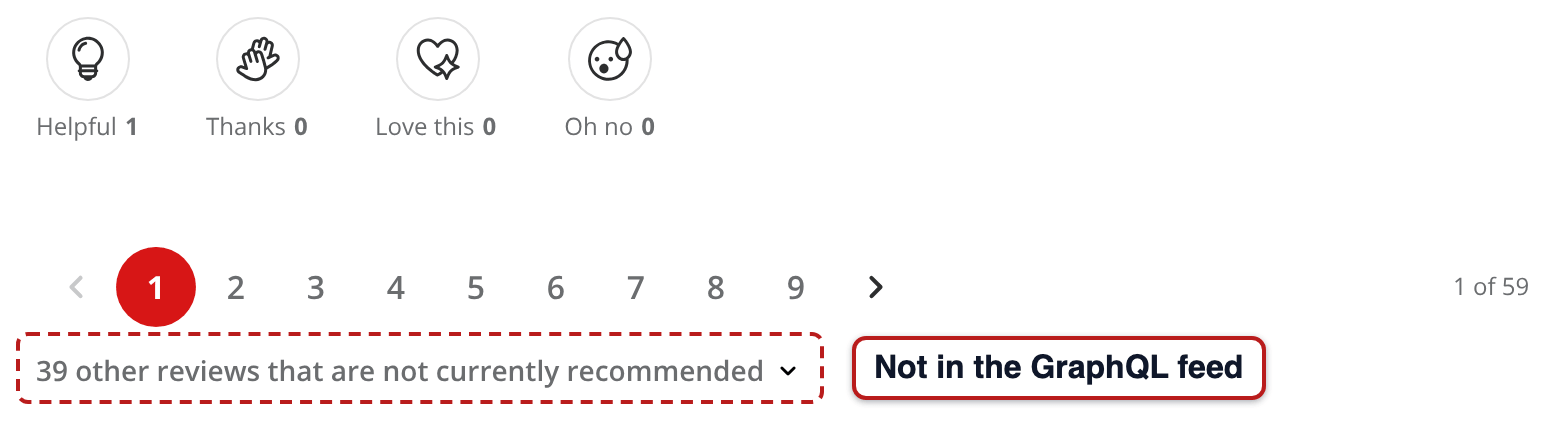
Ziziki’s Seite listete 59 Seiten mit empfohlenen Rezensionen auf, 10 pro Seite, und zeigte 39 weitere im eingeklappten Bereich.
Die documentId kann sich ändern, wenn Yelp neuen Frontend-Code veröffentlicht. Ein beliebter Open-Source-Yelp-Scraper veröffentlichte eine documentId, aber diese ID stimmte nicht mehr mit der überein, die die Live-Seite sendete. Ein kurzes Browser-API-Skript, refresh_doc_id.py, erfasst die aktuelle ID von einer Live-Seite, damit Sie den Scraper aktualisieren können, nachdem Yelp neuen Code veröffentlicht.
Einen Yelp-Scraper in Python bauen
Der Scraper fordert Such- und Unternehmensseiten über Web Unlocker mit GET an. Er sendet die GraphQL-Anfrage für Rezensionen als POST mit einem JSON-Body.
Der Code löst einen Fehler aus, wenn ein JSON-Objekt oder ein erforderlicher Schlüssel fehlt. Er löst auch einen aus, wenn die persistente Abfrage-ID veraltet ist oder Yelp eine GraphQL-Variable ablehnt. Andere Änderungen erscheinen als leere Felder oder eine Zeilenanzahl unter totalCount, also prüfen Sie beides nach jedem Lauf.
Wenn Sie neu im Scraping mit Python sind, beginnen Sie mit unserem Python-Web-Scraping-Leitfaden, der die Grundlagen behandelt. Sie benötigen Python 3.10 oder höher, das Paket requests und ein Bright-Data-Konto. Erstellen Sie eine Web-Unlocker-Zone, die benannte Konfiguration, auf die jede Anfrage verweist, indem Sie Bright Datas Web-Unlocker-Schnellstart folgen. Dann erstellen Sie einen API-Schlüssel.
Die kostenlose Stufe enthält 5K Credits pro Monat, geteilt über Bright Datas Scraping-APIs. Jede Web-Unlocker-Anfrage oder gelieferter Yelp-Scraper-API-Datensatz verbraucht 1 Credit. Web Unlocker berechnet nur erfolgreiche Anfragen. Installieren Sie die Abhängigkeit und exportieren Sie Ihren API-Schlüssel und Zonennamen:
pip install requests
export BRIGHTDATA_API_KEY="your_api_key"
export BRIGHTDATA_UNLOCKER_ZONE="web_unlocker"
Web Unlocker- und Browser-API-Anfragen an Yelp benötigen ein Konto mit vollem Zugriff. Konten im Sofortzugriffsmodus, der keine Know-Your-Customer-Verifizierung (KYC) erfordert, folgen der robots.txt. Yelps robots.txt verbot Crawler, die sie beim Lesen nicht namentlich nannte.
Sie erhalten vollen Zugriff nach der KYC-Überprüfung oder über Ihren Account Manager. Bis dahin gibt Web Unlocker für Yelp-URLs einen ub_bad_endpoint_robots-Fehler zurück, und die Browser API gibt einen brob-Fehler zurück.
Seiten über Web Unlocker abrufen
Der Helfer sendet jede URL per POST an Web Unlockers /request-Endpunkt und gibt den Antworttext des Ziels zurück, mit bis zu 3 Versuchen pro URL. Speichern Sie dies als ersten Teil von yelp_scraper.py:
import base64
import html
import json
import os
import re
import time
import urllib.parse
from concurrent.futures import ThreadPoolExecutor

import requests

API_KEY = os.environ["BRIGHTDATA_API_KEY"]
ZONE = os.environ.get("BRIGHTDATA_UNLOCKER_ZONE", "web_unlocker")

# Persistente Abfrage-ID von Yelps GetBusinessReviewFeed-Operation.
# Sie kann sich ändern, wenn Yelp deployt. refresh_doc_id.py erfasst sie.
REVIEW_FEED_DOC_ID = os.environ.get(
    "YELP_REVIEW_FEED_DOC_ID",
    "2b29fe4414313b319cb85e119740e72da582d64ad2962841724748be23d7f692",
)
PAGE_SIZE = 49  # Yelps GraphQL-API lehnte 50 mit BAD_USER_INPUT ab


class FetchError(Exception):
    pass


def unlock(url, method="GET", body=None, attempts=3):
    """Ruft eine URL über Web Unlocker ab; gibt den Antworttext des Ziels zurück."""
    payload = {"zone": ZONE, "url": url, "format": "raw",
               "country": "us", "method": method}
    if body is not None:
        payload["body"] = json.dumps(body)
        payload["headers"] = {"content-type": "application/json"}
    last_error = None
    for attempt in range(attempts):
        try:
            r = requests.post(
                "https://api.brightdata.com/request",
                headers={"Authorization": f"Bearer {API_KEY}"},
                json=payload,
                timeout=180,
            )
            # r.status_code meldet den API-Aufruf selbst.
            # Der eigene Status des Ziels steht in x-brd-status-code.
            status = r.headers.get("x-brd-status-code", str(r.status_code))
            if status == "200" and r.text:
                return r.text
            last_error = f"{status} {r.headers.get('x-brd-error-code')}"
        except requests.RequestException as exc:
            last_error = type(exc).__name__
        if attempt < attempts - 1:
            time.sleep(2 ** attempt)
    raise FetchError(f"{url}: {last_error}")
In einem separaten Test mit 30 Yelp-Unternehmensseiten lud unlock() jede Seite.
Unternehmensdetails aus dem Apollo-Cache parsen
Fügen Sie diesen Parser zu yelp_scraper.py hinzu. Er extrahiert den Apollo-Cache, findet das Unternehmen, um das es auf der Seite geht, und flacht dessen Felder zu einem einzelnen Datensatz ab:
def embedded_json(page, marker, escaped):
"""Gibt das JSON zurück, das Yelp in <!-- --> innerhalb eines <script>-Tags einbettet."""
m = re.search(
r"<script[^>]*" + marker + r"[^>]*>\s*<!--(.*?)-->\s*</script>",
page,
re.S,
)
if not m:
raise FetchError(f"{marker} fehlt: Soft-Block oder Markup-Änderung")
raw = html.unescape(m.group(1)) if escaped else m.group(1)
return json.loads(raw)
def apollo_state(page):
# Der Apollo-Cache war HTML-escaped (") innerhalb eines HTML-Kommentars.
return embedded_json(page, "data-apollo-state", escaped=True)
def parse_business(page):
state = apollo_state(page)
ref = next(v["__ref"] for k, v in state["ROOT_QUERY"].items()
if k.startswith("business("))
biz = state[ref]
loc = state[biz["location"]["__ref"]]
claim = next((v for k, v in biz.items()
if k.startswith("claimability(")), None) or {}
website = (biz.get("externalResources") or {}).get("website") or {}
return {
"encid": biz["encid"],
"alias": biz["alias"],
"name": biz["name"],
"rating": biz["rating"],
"review_count": biz["reviewCount"],
"price_range": (biz.get("priceRange") or {}).get("display"),
"phone": (biz.get("phoneNumber") or {}).get("formatted"),
"address": loc["address"]["formatted"].replace("\n", ", "),
"neighborhoods": loc.get("neighborhoods"),
"categories": [state[c["__ref"]]["title"] for c in biz["categories"]],
"is_claimed": claim.get("isClaimed"),
"is_closed": biz.get("isClosed"),
"website": website.get("url"),
}
def get_business(url):
return parse_business(unlock(url))Apollo speichert zugehörige Objekte einmal und verweist mit __ref-Schlüsseln darauf, sodass der Parser location und categories zu ihren eigenen Einträgen folgt. Einige Schlüssel enthielten ihre Abfrageargumente, wie claimability({"useConsumerClaimability":true}), sodass der Code diese Schlüssel nach Präfix abgleicht. Der Parser las alle 19 gespeicherten Unternehmensseiten ohne Fehler.
Yelp-Rezensionen aus der GraphQL-API scrapen
Um Yelp-Rezensionen zu scrapen, senden Sie eine Anfrage mit der Unternehmens-encid, der persistenten documentId und den Variablen, die die Abfrage erwartet. Der nächste Teil von yelp_scraper.py erstellt den Offset-Cursor selbst, sodass jede Seite nach der ersten parallel läuft. Yelps Cursor enthielt den Offset der letzten Rezension der vorherigen Seite, daher übergibt review_page() start - 1:
def review_cursor(offset):
    # Yelps "after"-Cursor ist base64-JSON mit einem numerischen Offset darin.
    raw = json.dumps({"version": 1, "type": "offset", "offset": offset},
                     separators=(",", ":"))
    return base64.b64encode(raw.encode()).decode()


def review_page(encid, start, sort_by="DATE_DESC"):
    variables = {
        "encBizId": encid,
        "reviewsPerPage": PAGE_SIZE,
        "after": review_cursor(start - 1) if start else None,
        "sortBy": sort_by,  # RELEVANCE_DESC, DATE_DESC, DATE_ASC, ...
        "ratings": [5, 4, 3, 2, 1],
        "queryText": "",
        "isSearching": False,
        "selectedReviewEncId": "",
        "hasSelectedReview": False,
        "isTranslating": False,
        "translateLanguageCode": "en",
        "isHighlighting": False,
        "highlightType": "",
        "highlightIdentifier": "",
        "photoSize": "SQUARE_348",
        "fetchMediaReviewContent": False,
        "eliteAllStarSourceFlow": "biz_page_review_feed",
        "reactionsSourceFlow": "businessPageReviewSection",
        "minConfidenceLevel": "HIGH_CONFIDENCE",
    }
    body = [{
        "operationName": "GetBusinessReviewFeed",
        "variables": variables,
        "extensions": {"operationType": "query",
                       "documentId": REVIEW_FEED_DOC_ID},
    }]
    try:
        raw = unlock("https://www.yelp.com/gql/batch", method="POST",
                     body=body)
    except FetchError as exc:
        # Über Web Unlocker wurde eine unbekannte documentId als
        # 502 http_status zurückgegeben, daher schlägt die Meldung vor, die ID zu aktualisieren.
        raise FetchError(f"{exc} (veraltete documentId? refresh_doc_id.py ausführen)")
    result = json.loads(raw)[0]
    # GraphQL-Fehler können in einer HTTP-200-Antwort zurückgegeben werden.
    if result.get("errors"):
        raise FetchError(result["errors"][0]["message"])
    return result["data"]["business"]["reviews"]


def flatten_review(node):
    author = node.get("author") or {}
    # Autorenfelder sind personenbezogene Daten, also entfernen Sie sie, wenn Sie nur Sentiment benötigen.
    return {
        "review_id": node["encid"],
        "rating": node["rating"],
        "created_at": node["createdAt"]["localDateTimeForBusiness"],
        "text": (node.get("text") or {}).get("full"),
        "language": (node.get("text") or {}).get("language"),
        "author": author.get("displayName"),
        "author_location": author.get("displayLocation"),
        "author_review_count": author.get("reviewCount"),
    }


def get_reviews(encid, max_reviews=None, workers=4):
    first = review_page(encid, 0)
    total = first["totalCount"]
    if max_reviews:
        total = min(total, max_reviews)
    reviews = [e["node"] for e in first["edges"]]
    # Offsets sind im Voraus bekannt, daher laufen die restlichen Seiten parallel.
    starts = range(PAGE_SIZE, total, PAGE_SIZE)
    with ThreadPoolExecutor(workers) as pool:
        for page in pool.map(lambda s: review_page(encid, s), starts):
            reviews += [e["node"] for e in page["edges"]]
    unique = {r["encid"]: flatten_review(r) for r in reviews}
    return list(unique.values())[:total], first["totalCount"]
get_reviews() sammelte alle 582 empfohlenen Rezensionen von Ziziki’s in 12 GraphQL-Aufrufen, und die Rezensionsdaten umfassten etwa 20 Jahre.
Der Browser sendete auch eine guv-Besucher-ID und einen languageCode-Wert. Die GraphQL-API erforderte in unseren Tests keinen von beiden, daher sendet der Code sie nicht.
Der created_at-Wert liegt in der lokalen Zeitzone des Unternehmens, mit einem Offset wie -05:00 oder -06:00 für Dallas, je nach Sommerzeit. Bevor Sie Rezensionsdaten über Städte hinweg vergleichen, behalten Sie den Offset bei, wenn Sie jeden Wert speichern, oder konvertieren Sie ihn in UTC.
Unternehmen aus Suchergebnissen entdecken
Die bisherigen Funktionen starten von einer Unternehmens-URL, die Sie bereits haben. Suchseiten geben Ihnen die Unternehmens-URLs für get_business() und die encid-Werte für get_reviews(). Fügen Sie die Suchfunktionen ebenfalls zu yelp_scraper.py hinzu. Der Parser verknüpft jede organische Karte mit ihrem Apollo-Datensatz und überspringt gesponserte Karten:
def parse_search(page):
    props = embedded_json(page, "data-hypernova-key", escaped=False)
    comps = (props["legacyProps"]["searchAppProps"]["searchPageProps"]
             ["mainContentComponentsListProps"])
    state = apollo_state(page)
    hits = []
    for comp in comps:
        section = comp.get("props") or {}
        if comp.get("type") != "searchResultSection":
            continue
        for item in section.get("searchResults", []):
            if item.get("isAd"):
                continue  # gesponserte Karten überspringen
            # Details aus dem Apollo-Cache entnehmen; organischen Karten können sie fehlen.
            biz = state.get(f"Business:{item['bizId']}", {})
            hits.append({
                "rank": item.get("ranking"),
                "encid": item["bizId"],
                "name": biz.get("name"),
                "rating": biz.get("rating"),
                "review_count": biz.get("reviewCount"),
                "url": "https://www.yelp.com"
                       + item["businessUrl"].split("?")[0],
            })
    paging = next(c["props"] for c in comps if c.get("type") == "pagination")
    return hits, paging["totalResults"]


def search(term, location, pages=1):
    query = urllib.parse.urlencode({"find_desc": term, "find_loc": location})
    base = f"https://www.yelp.com/search?{query}"
    hits = []
    for n in range(pages):
        # Seite 1 hat keinen start-Parameter, so wie ein Browser sie lädt.
        url = f"{base}&start={n * 10}" if n else base
        batch, total = parse_search(unlock(url))
        hits += batch
        if (n + 1) * 10 >= total:
            break
    return hits
search() sendet Seite 1 ohne start, so wie ein Browser eine Suche zuerst lädt. Sie stoppt bei der letzten Seite, die totalResults erlaubt, sodass eine Abfrage, die Yelps Limit von 240 Ergebnissen erreicht, 24 Seiten benötigt.
Den Yelp-Scraper ausführen
Der letzte Block von yelp_scraper.py führt die Schritte der Reihe nach aus. Er ruft 2 Suchseiten, 1 Unternehmensseite und die 150 neuesten Rezensionen dieses Unternehmens ab und schreibt die Rezensionen in eine JSON-Lines-Datei:
if __name__ == "__main__":
    hits = search("Pizza", "Lower Manhattan, New York, NY", pages=2)
    print(f"{len(hits)} organische Ergebnisse")
    for hit in hits[:3]:
        print(hit["rank"], hit["name"], hit["rating"], hit["review_count"])

    business = get_business(hits[0]["url"])
    print(json.dumps(business, indent=2, ensure_ascii=False))

    reviews, reported = get_reviews(business["encid"], max_reviews=150)
    print(f"{len(reviews)} von {reported} Rezensionen gesammelt")
    for r in reviews[:2]:
        print(r["created_at"], r["rating"], r["text"][:60])

    with open("reviews.jsonl", "w") as f:
        for row in reviews:
            f.write(json.dumps({"business": business["alias"], **row}) + "\n")
Führen Sie das Skript aus dem Verzeichnis aus, in dem Sie es gespeichert haben. Die erste Zeile wird erst gedruckt, nachdem beide Suchseiten geladen sind:
python yelp_scraper.pyDer Lauf gab die Top-Suchergebnisse, den Unternehmensdatensatz und die ersten 2 Rezensionen aus:
20 organische Ergebnisse
1 L'industrie Pizzeria 4.5 1222
2 Prince Street Pizza 4.3 5720
3 Juliana's 4.4 2997
{
  "encid": "G9hV4H2iGpWD8RoUpjtokg",
  "alias": "l-industrie-pizzeria-new-york",
  "name": "L'industrie Pizzeria",
  "rating": 4.5,
  "review_count": 1222,
  "price_range": "$$",
  "phone": "(212) 256-0648",
  "address": "104 Christopher St, New York, NY 10014",
  "neighborhoods": [
    "West Village"
  ],
  "categories": [
    "Pizza"
  ],
  "is_claimed": false,
  "is_closed": false,
  "website": "http://lindustriebk.com"
}
150 von 1220 Rezensionen gesammelt
2026-09-25T20:43:26-04:00 4 I arrived here on a Saturday afternoon and man what a line.
2026-09-25T20:37:09-04:00 4 The pizza was like 4.25/5, I came with locals and they said
Der Lauf nutzte 7 abrechenbare Anfragen (2 für Suchseiten, 1 für die Unternehmensseite und 4 für GraphQL-Aufrufe). Die Unternehmensseite meldete 1.222 Rezensionen, während der totalCount der GraphQL-API 1.220 betrug. Vergleichen Sie Ihre Zeilenanzahl mit totalCount, nicht mit der Zahl auf der Seite, wenn Sie prüfen, ob ein Lauf vollständig ist.
Die persistente Abfrage-ID aktualisieren, wenn Yelp deployt
Wenn die Rezensionsaufrufe mit 502 http_status fehlschlagen, während Unternehmensseiten weiterhin laden, hat sich die documentId höchstwahrscheinlich geändert. Speichern Sie dieses Skript als refresh_doc_id.py. Es öffnet eine einzelne Unternehmensseite in der Browser API und scrollt, bis die Seite die GraphQL-Anfrage für Rezensionen sendet. Es gibt die ID dieser Anfrage aus, oder None nach 30 Scrolls ohne Treffer:
import asyncio
import json
import os

from playwright.async_api import async_playwright

# Browser-API-Endpunkt vom Overview-Tab der Zone, mit angehängtem -country-us.
BROWSER_WSS = os.environ["BRIGHTDATA_BROWSER_WSS"]
BIZ_URL = "https://www.yelp.com/biz/zizikis-dallas-2"


async def capture_review_feed_doc_id():
    async with async_playwright() as p:
        browser = await p.chromium.connect_over_cdp(BROWSER_WSS)
        page = await browser.new_page()
        found = asyncio.get_running_loop().create_future()

        def on_request(request):
            if (request.url.endswith("/gql/batch")
                    and "GetBusinessReviewFeed" in (request.post_data or "")
                    and not found.done()):
                ops = json.loads(request.post_data)
                op = next(o for o in ops
                          if o["operationName"] == "GetBusinessReviewFeed")
                found.set_result(op["extensions"]["documentId"])

        page.on("request", on_request)
        await page.goto(BIZ_URL, wait_until="domcontentloaded",
                        timeout=120_000)
        # Scrollen, bis die Seite die GraphQL-Anfrage für Rezensionen sendet.
        for _ in range(30):
            if found.done():
                break
            await page.mouse.wheel(0, 1200)
            await page.wait_for_timeout(1500)
        await browser.close()
        return found.result() if found.done() else None


if __name__ == "__main__":
    print(asyncio.run(capture_review_feed_doc_id()))
Installieren Sie Playwright mit pip install playwright, und erstellen Sie eine Browser-API-Zone, indem Sie Bright Datas Browser-API-Schnellstart folgen. Setzen Sie dann BRIGHTDATA_BROWSER_WSS auf den Endpunkt der Zone, und fügen Sie dem Benutzernamen -country-us hinzu. Der Wert hat die Form wss://brd-customer-<id>-zone-<zone>-country-us:<password>@brd.superproxy.io:9222. Der Lauf gab die ID aus, die der Scraper bereits verwendet:
2b29fe4414313b319cb85e119740e72da582d64ad2962841724748be23d7f692Wenn sich die ausgegebene ID unterscheidet, exportieren Sie sie als YELP_REVIEW_FEED_DOC_ID und führen Sie yelp_scraper.py erneut aus.
Die Browser API berechnet pro GB Traffic, und 6 Ladevorgänge von Yelp-Unternehmensseiten hatten im Durchschnitt jeweils etwa 8 MB. Web Unlocker berechnet pro erfolgreicher Anfrage. Verwenden Sie die Browser API nur für die gelegentliche Aktualisierung der documentId, und senden Sie Seiten- und Rezensionsanfragen über Web Unlocker.
Häufige Fehler beheben
Ordnen Sie das, was Sie sehen, einer wahrscheinlichen Ursache zu:
| Was Sie sehen | Wahrscheinliche Ursache | Was zu tun ist |
|---|---|---|
FetchError mit 401 None oder 400 None |
Ein falscher API-Schlüssel (401) oder Zonenname (400) | Prüfen Sie BRIGHTDATA_API_KEY, und setzen Sie BRIGHTDATA_UNLOCKER_ZONE auf den exakten Namen der Zone |
FetchError mit ub_bad_endpoint_robots, oder brob von der Browser API |
Das Konto befindet sich im Sofortzugriffsmodus (ohne KYC), der Yelps robots.txt folgt | KYC-Überprüfung abschließen oder Ihren Account Manager um vollen Zugriff bitten |
FetchError mit data-apollo-state missing oder data-hypernova-key missing |
Ein Soft-Block (eine Blockseite wurde mit HTTP 200 zurückgegeben) oder eine Markup-Änderung | Speichern Sie das HTML, das unlock() zurückgab, und durchsuchen Sie es nach dem im Fehler genannten <script>-Tag |
Rezensionsaufrufe schlagen mit 502 http_status fehl, während Unternehmensseiten laden |
Eine neue documentId |
Führen Sie refresh_doc_id.py aus und exportieren Sie die ausgegebene ID |
FetchError mit einer GraphQL-Validierungsmeldung |
Eine fehlende oder außerhalb des Bereichs liegende Variable | Vergleichen Sie Ihre Variablen mit dem Payload der Seite in DevTools |
Jeder andere FetchError von unlock() |
Die Anfrage schlug bei allen 3 Versuchen fehl | Versuchen Sie die URL später erneut, oder erhöhen Sie attempts in unlock() |
Leere Felder, oder ein KeyError oder StopIteration in einem Parser |
Ein umbenannter Schlüssel in Yelps JSON | Vergleichen Sie das JSON der Seite mit den Schlüsseln, die der Parser liest |
Yelp-Scraping mit Bright Datas Yelp Scraper API skalieren
Wenn Sie Ihren eigenen Scraper schreiben, warten Sie ihn auch. Die persistente Abfrage-ID, die Variablenliste und die Parser hängen alle von Yelps Frontend ab, sodass jedes davon brechen kann, wenn Yelp Frontend-Änderungen veröffentlicht.
Die Yelp Scraper API, Teil von Bright Datas Web Scraper API, nimmt Yelp-URLs oder Suchfilter entgegen und gibt geparste Datensätze zurück. Bright Data wartet die Parser, während sich Yelps Frontend ändert. Bright Data bietet auch einen dedizierten Yelp-Bild-Scraper und einen Yelp-MCP-Server für KI-Agenten.
Die Yelp Scraper API kann auch nicht empfohlene Rezensionen sammeln, die die GetBusinessReviewFeed-Abfrage in unseren Tests nicht zurückgab. Yelps Software empfahl 17% der im Jahr 2025 veröffentlichten Rezensionen nicht, laut dessen 2025 Trust and Safety Report.
Die Yelp Scraper API von Python ausführen
Im Kontrollfeld listet die Scraper-Bibliothek die Yelp-Endpunkte auf. Die Unternehmens-Endpunkte akzeptieren URLs, Suchfilter oder eine Bounding Box als Eingabe, und die Rezensions-Endpunkte akzeptieren Unternehmens-URLs oder Suchfilter. Jeder Endpunkt akzeptiert eine Liste von Eingaben und läuft im synchronen oder asynchronen Modus:
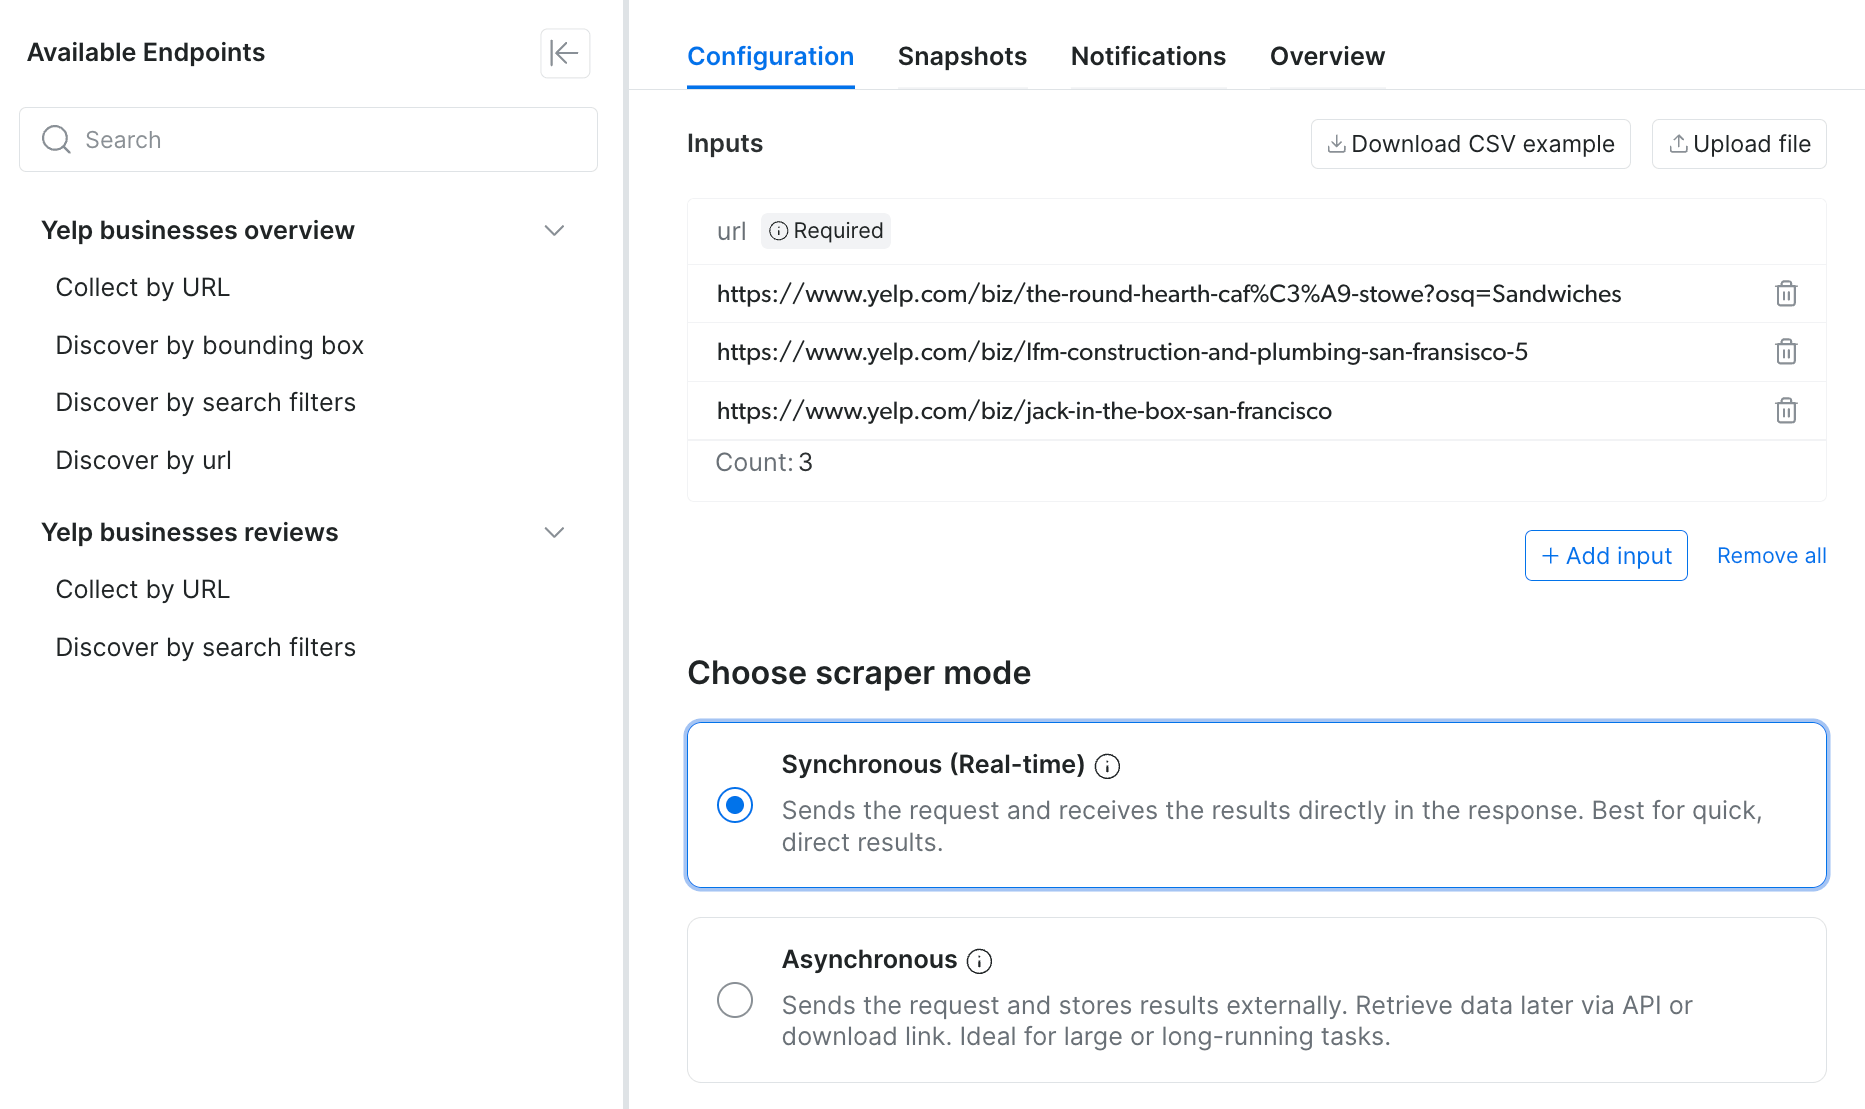
Der Collect-by-URL-Endpunkt für Unternehmensdatensätze, mit 3 Beispiel-Eingaben und ausgewähltem Synchronous-Modus. Ein synchroner Aufruf, der länger als sein 1-Minuten-Limit dauert, gibt statt Datensätzen eine Snapshot-ID zurück, daher läuft scraper_api.py asynchron.
Sie können dieselben Scraper von Python über den asynchronen Trigger-Endpunkt ausführen. Speichern Sie dieses Skript als scraper_api.py. Es benötigt nur BRIGHTDATA_API_KEY, da Scraper-API-Aufrufe keine Zone verwenden. Es führt eine Discovery-Suche nach Pizza in Brooklyn, NY, durch und sammelt dann die 20 neuesten Rezensionen des ersten Ergebnisses:
import os
import time

import requests

API = "https://api.brightdata.com/datasets/v3"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}

YELP_BUSINESSES = "gd_lgugwl0519h1p14rwk"
YELP_REVIEWS = "gd_lgzhlu9323u3k24jkv"


def collect(dataset_id, inputs, limit_per_input=None, poll_every=15,
            **params):
    """Löst einen Scraper-API-Job aus, wartet auf ihn und gibt seine Datensätze zurück."""
    body = {"input": inputs}
    if limit_per_input:
        body["limit_per_input"] = limit_per_input
    r = requests.post(
        f"{API}/trigger",
        headers=HEADERS,
        params={"dataset_id": dataset_id, "include_errors": "true",
                **params},
        json=body,
        timeout=60,
    )
    r.raise_for_status()
    snapshot_id = r.json()["snapshot_id"]

    while True:
        progress = requests.get(f"{API}/progress/{snapshot_id}",
                                headers=HEADERS, timeout=60).json()
        if progress["status"] == "ready":
            break
        if progress["status"] in ("failed", "canceled"):
            raise RuntimeError(f"{snapshot_id}: {progress}")
        time.sleep(poll_every)

    records = requests.get(f"{API}/snapshot/{snapshot_id}",
                           headers=HEADERS, params={"format": "json"},
                           timeout=120).json()
    # Mit include_errors=true werden fehlgeschlagene Eingaben als Fehlerdatensätze zurückgegeben.
    errors = [x for x in records if x.get("error")]
    rows = [x for x in records if not x.get("error")]
    return rows, errors


if __name__ == "__main__":
    rows, errors = collect(
        YELP_BUSINESSES,
        [{"country": "US", "category": "Pizza",
          "location": "Brooklyn, NY, United States"}],
        limit_per_input=5,
        type="discover_new",
        discover_by="search_filters",
    )
    for row in rows:
        print(row["name"], row["overall_rating"], row["reviews_count"],
              row["url"])
    print(f"{len(rows)} Unternehmen, {len(errors)} Fehler")
    if not rows:
        raise SystemExit("Discovery hat keine Unternehmen zurückgegeben")

    reviews, errors = collect(
        YELP_REVIEWS,
        [{"url": rows[0]["url"], "unrecommended_reviews": False,
          "sort_by": "DATE_DESC"}],
        limit_per_input=20,
    )
    print(f"{len(reviews)} Rezensionen, {len(errors)} Fehler")
    for r in reviews[:1]:
        print(r["date_iso_format"], r["Rating"], r["Content"][:120])
YELP_BUSINESSES und YELP_REVIEWS sind die Datensatz-IDs von Bright Datas Yelp-Scrapern, die in den API-Beispielen jedes Scrapers im Kontrollfeld angezeigt werden. collect() prüft den Fortschritt jedes Jobs alle 15 Sekunden und gibt dessen Datensätze zurück, sobald der Job fertig ist. Für jedes entdeckte Unternehmen gibt das Skript den Namen, die Bewertung, die Rezensionsanzahl und die URL aus. Anschließend gibt es die Anzahl der Rezensionen sowie Datum, Bewertung und die ersten 120 Zeichen des Texts der ersten Rezension aus.
Die Yelp Scraper API berechnet nur erfolgreiche Lieferungen. limit_per_input legt die maximale Anzahl an Datensätzen pro Eingabe fest. Dieses Skript verwendet 5 für Unternehmen und 20 für Rezensionen, sodass ein Testlauf für ein Unternehmen mit 5K Rezensionen nicht für 5K Datensätze berechnet wird. Eingaben, die ein Job nicht sammeln konnte, werden als Fehlerdatensätze zurückgegeben, die ihre Eingabe enthalten, bereit zur erneuten Einreichung.
Rezensions-Jobs konfigurieren und deren Felder zuordnen
Diese 3 Details beeinflussen, welche Datensätze ein Job zurückgibt und wie Sie sie lesen:
unrecommended_reviewswählte 1 der 2 Rezensionssätze aus. Mittruegab ein Job nur nicht empfohlene Rezensionen zurück (recommended_review: false). Um beide Sätze zu sammeln, senden Sie die Unternehmens-URL einmal mit jedem Wert. Lassen Sie den Datumsbereich bei dertrue-Eingabe leer, um nicht empfohlene Rezensionen aus allen Daten zu sammeln.- Datumsfilter bei empfohlenen Rezensionen stimmten mit der GraphQL-Anzahl überein. Mit
unrecommended_reviewsauffalsegesetzt und einem Datumsbereich vonstart_datebisend_dategab der Job 6 Rezensionen zurück. Der GraphQL-Scraper fand für diesen Bereich dieselben 6. - Yelps Reaktionslabels änderten sich im Laufe der Zeit. Neuere Datensätze verwendeten
Helpful,Thanks,Love thisundOh no, während ältere Yelp-Rezensionenuseful,funnyundcoolverwendeten. Ordnen Sie beide Sätze zu, bevor Sie Reaktionen über Jahre hinweg vergleichen.
Für wiederkehrende Jobs liefert die Yelp Scraper API an einen Webhook, Amazon S3, Google Cloud Storage, Google Pub/Sub, Microsoft Azure Storage, Snowflake oder SFTP.
Yelp-API, Scraper oder Datensatz: Was 1K Unternehmen kosten
Die richtige Option hängt davon ab, ob Sie vollständigen Rezensionstext benötigen und wer die Datenerfassung wartet. Diese Tabelle zeigt die Kosten einer einzelnen Arbeitslast, 1K Unternehmen mit jeweils 200 Rezensionen, zu den Listenpreisen zum Zeitpunkt unserer Prüfung:
| Option | Vollständiger Rezensionstext | Kosten für 1K Unternehmen und 200K Rezensionen | Ihre laufende Arbeit |
|---|---|---|---|
| Yelp Places API, Enhanced-Plan | Nein, 3 Auszüge von etwa 160 Zeichen | $299 pro Monat, innerhalb der 30K enthaltenen Aufrufe | Anzeigeregeln und das 24-Stunden-Caching-Limit befolgen |
| Yelp Insights API, Premium-Plan | Ja | Individuelles Angebot von Yelps Vertriebsteam, ab $0,08 pro Standort auf rollierender 12-Monats-Basis | Yelps Vertragsbedingungen befolgen |
| Eigener Scraper auf Web Unlocker | Ja, empfohlene Rezensionen | $9 für 6K Anfragen (1K Unternehmensseiten und 5K GraphQL-Aufrufe) zu $1,5 pro 1K | Persistente Abfrage-ID, Variablen und Parser aktualisieren, wenn sich Yelps Frontend ändert |
| Bright Data Yelp Scraper API | Ja, empfohlen und nicht empfohlen | $301,50 für 201K Datensätze zu $1,5 pro 1K | Eingabelisten und Lieferung verwalten |
| Bright Data Yelp-Datensätze | Ja, vorab gesammelt | Bis zu $502,50 für 201K Datensätze zu bis zu $0,0025 pro Datensatz (Mindestbestellung $250) | Keine Sammelarbeit, monatliche Datenaktualisierung |
Der Web-Unlocker-Wert ist niedrig, weil jeder GraphQL-Aufruf bis zu 49 Rezensionen zurückgab und Web Unlocker nur erfolgreiche Anfragen berechnet. Die Yelp Scraper API berechnet pro Datensatz, sodass Jobs mit vielen Rezensionen mehr kosten. Für diesen Preis verbringen Sie keine Entwicklungszeit mit Parsern oder persistenten Abfrage-IDs.
Discovery fügt bei beiden Optionen Kosten hinzu. Bei Web Unlocker zahlen Sie für Suchseiten, die jeweils 10 Ergebnisse zeigten. Bei der Yelp Scraper API zahlen Sie für Discovery-Datensätze.
Bright Datas Yelp-Datensätze eignen sich gut für historische Nachfüllungen. Sie enthalten mehr als 200M Rezensionsdatensätze und mehr als 9M Unternehmensdatensätze. Ein separater Yelp-Restaurants-Datensatz ist ebenfalls verfügbar.
Jede Datensatzseite im Kontrollfeld zeigt vor dem Kauf die Felder, den Preis und ein Datenbeispiel:
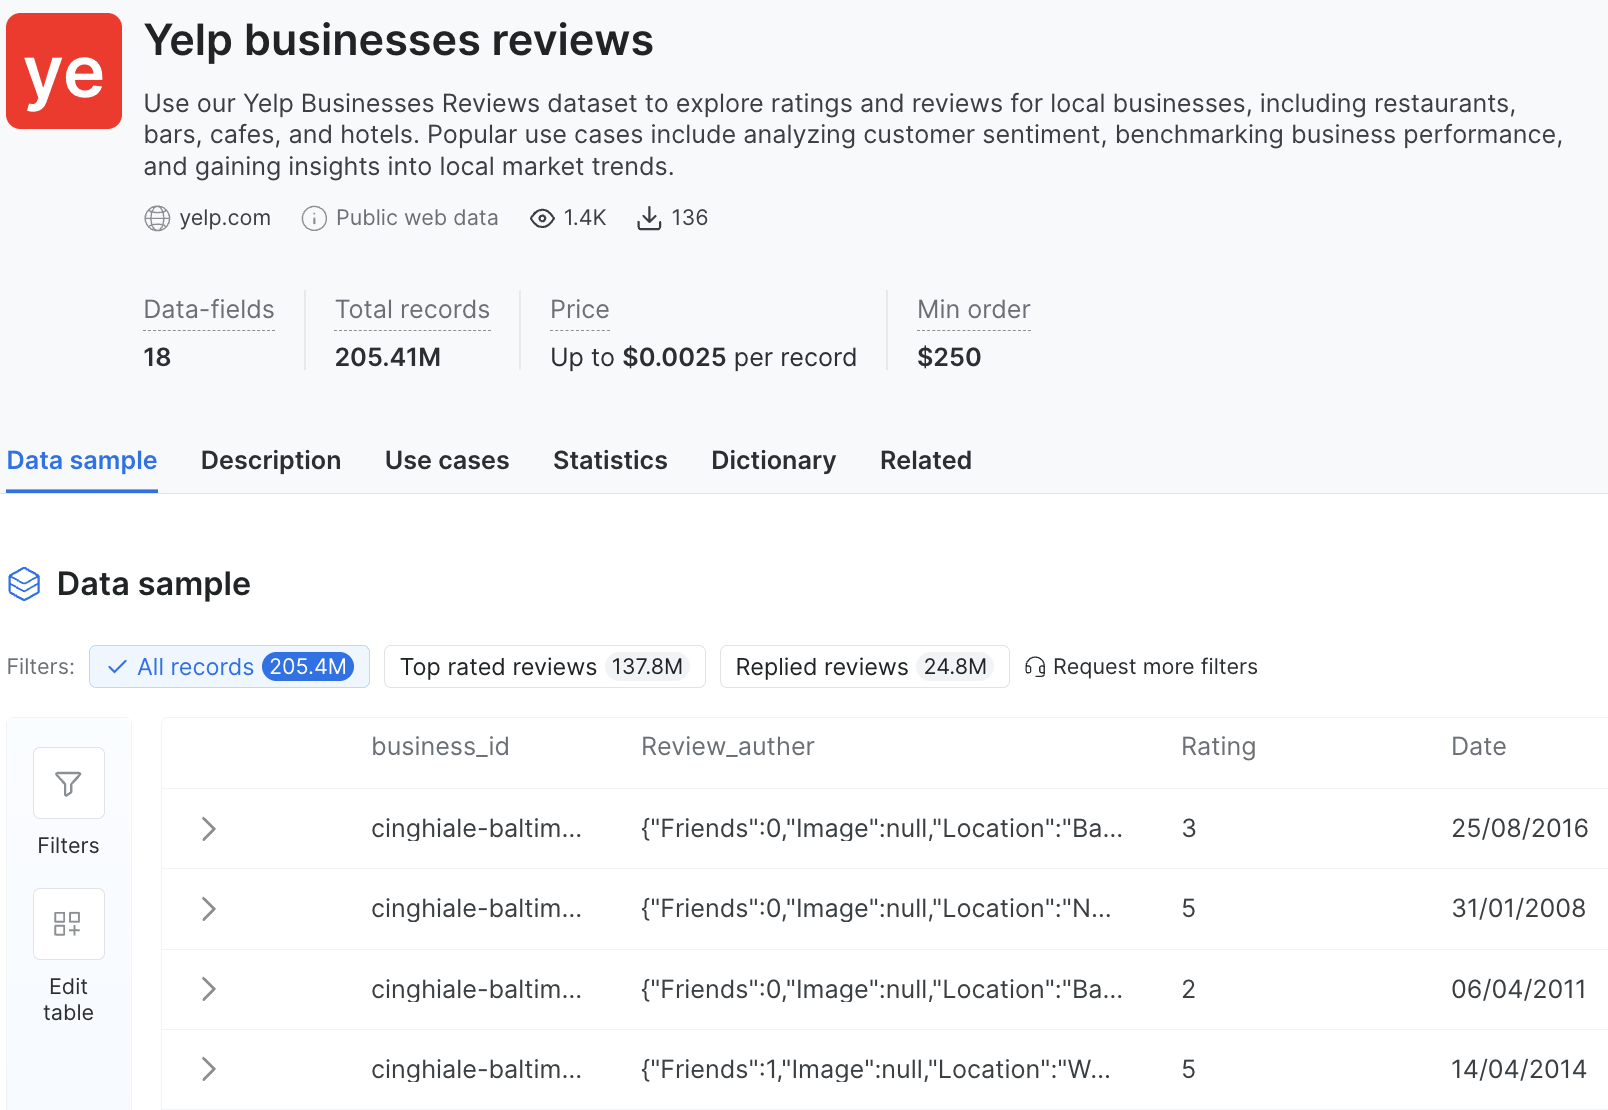
Der Datensatz Yelp businesses reviews. Zu bis zu $0,0025 pro Datensatz kauft die Mindestbestellung von $250 mindestens 100K Rezensionen.
Abschließende Gedanken
Das Scrapen von Yelp in Python funktionierte in unseren Tests, sobald jede Anfrage Web Unlocker nutzte und Rezensionen aus der GraphQL-API stammten, nicht aus dem HTML. Die persistente Abfrage-ID kann sich ändern, wenn Yelp deployt, also führen Sie zuerst refresh_doc_id.py aus, wenn Rezensionsaufrufe zu scheitern beginnen. Bright Datas Yelp Scraper API übernimmt die Parser-Wartung und fügt nicht empfohlene Rezensionen hinzu, zu einem höheren Preis pro Rezension. Bright Datas Yelp-Datensätze liefern historische Daten für Nachfüllungen. Beginnen Sie mit Bright Datas kostenloser Stufe bei einem Ihnen bekannten Unternehmen, und vergleichen Sie die Zeilenanzahl von yelp_scraper.py mit totalCount, bevor Sie es für weitere Unternehmen ausführen.
FAQ
Wie scrapt man Yelp-Rezensionen?
Fordern Sie sie von Yelps GraphQL-Endpunkt /gql/batch mit der persistenten Abfrage-ID GetBusinessReviewFeed an, da das HTML der Unternehmensseite in unseren Tests keinen vollständigen Rezensionstext enthielt. Jeder Aufruf gab bis zu 49 Rezensionen zurück. Leiten Sie die Aufrufe über Bright Datas Web Unlocker API, da DataDome, Yelps Bot-Schutz, die von uns getesteten Python-HTTP-Clients blockierte.
Gibt die Yelp-API alle Rezensionen aus?
Nein, nicht als wir es geprüft haben. Yelps Dokumentation listete 3 Places-API-Rezensionsauszüge bei Enhanced und bis zu 7 bei Premium auf, jeweils etwa 160 Zeichen. Vollständiger Text war über Yelps Insights-API-Premium-Plan oder über die von yelp.com genutzte GraphQL-API verfügbar, die empfohlene Rezensionen zurückgab. Bright Datas Yelp Scraper API gibt ebenfalls vollständigen Text zurück, einschließlich nicht empfohlener Rezensionen.
Kann ich die Yelp-API kostenlos nutzen?
Nur zur Evaluierung. Yelps Dokumentation listete 5K kostenlose Places-API-Aufrufe während einer 30-tägigen Testphase, und Testaufrufe waren nicht für kommerzielle Nutzung bestimmt. Kostenpflichtige Pläne begannen bei $229 pro Monat für den Base-Plan, der keine Rezensionsauszüge oder Fotos enthielt.
Wie viel kostet die Yelp Fusion API?
Yelps Preisseite listete die Places API (auch Fusion genannt) mit $229 pro Monat für Base, $299 für Enhanced und $643 für Premium auf. Jeder Plan enthielt standardmäßig 30K Aufrufe pro Monat, und zusätzliche Aufrufe kosteten je nach Plan $5,91 bis $14,13 pro 1K.
Gibt es einen kostenlosen Yelp-Scraper?
Ja, Open-Source-Yelp-Scraper sind kostenlos, aber in unseren Tests blockierte DataDome, Yelps Bot-Schutz, Python-HTTP-Clients. Bright Datas kostenlose Stufe enthält 5K Credits pro Monat, genug für 5K Yelp-Scraper-API-Datensätze. Web-Unlocker-Anfragen an Yelp benötigen ein Konto mit vollem Zugriff.
Können Websites Scraping erkennen?
Ja. Bot-Schutzdienste können TLS-Fingerabdrücke, IPs und JavaScript-Ausführung prüfen, und Yelp nutzte in unseren Tests DataDome. Python-HTTP-Clients erhielten bei jeder Testanfrage 403-Challenge-Seiten, selbst mit Browser-TLS-Fingerabdrücken und US-Residential-IPs. Alle 30 getesteten Unternehmensseiten luden über Bright Datas Web Unlocker API.