Wenn dein Scraper einen HTTP 429 oder 403 mit x-kpsdk-*-Headern erhält, blockiert Kasada ihn, und die Antwort erklärt nicht warum. Kasada ist eine Anti-Bot-Plattform, die Websites, APIs und mobile Apps vor automatisiertem Traffic schützt. Sie führt eine verschleierte JavaScript-Challenge im Browser aus, bewertet den Client und stellt ein kurzlebiges Token aus, das jede spätere Anfrage enthalten muss.
Um Kasada zu umgehen, musst du zuerst wissen, was dieses Challenge-Skript prüft. Ich habe ein echtes analysiert, und das Ergebnis entscheidet, ob du einen Solver baust oder kaufst.
Kurzfassung
- Kasada benötigt ein gültiges Token:
x-kpsdk-ctkommt nur durch das Abschließen der JavaScript-Challenge zustande, daher reicht TLS-Impersonation allein nicht aus. - Die Challenge ändert sich bei jeder Anfrage: Es ist eine eigene virtuelle Maschine, sodass ein kopierter Solver innerhalb von Stunden nicht mehr funktioniert.
- Automatisierte Browser hinterlassen Signale: Ein Standard-Setup zeigt
navigator.webdriver, einenHeadlessChrome-User-Agent und Namen von Automatisierungs-Frameworks, die Kasada erkennen kann. - Du kannst bauen oder kaufen: Einen Solver zu warten ist laufende Arbeit, während Bright Datas Web Unlocker die Challenge für dich löst und pro erfolgreicher Anfrage abrechnet.
So bestätigst du, dass eine Website Kasada verwendet
Ein 403 oder 429 sagt dir, dass etwas die Anfrage blockiert hat. Es sagt dir nicht, welches System es war, und diese Antwort entscheidet alles Weitere. Cloudflare, DataDome, Akamai und Kasada geben alle dieselben Statuscodes zurück, sodass der Code allein das System nicht identifizieren kann. Die Header und Cookies jedes Anbieters identifizieren es, und du kannst sie mit 1 Anfrage auslesen:
curl -sI https://target.example/ | grep -i \
  -e '^x-kpsdk' -e '^set-cookie: kp_uidz' \
  -e '^cf-ray:' -e '^set-cookie: __cf_bm' -e '^server: cloudflare' \
  -e '^x-datadome' -e '^set-cookie: datadome' \
  -e '^server: akamaighost' -e '^set-cookie: _abck'
Suche vom Anfang der Header-Zeile an (das macht das ^), nicht irgendwo in der Zeile. Ein breites grep -i akamai trifft auch auf nicht verwandte Header, die einen CDN-Hostnamen enthalten, etwa die Content-Security-Policy der Seite, und liefert falsch-positive Ergebnisse.
Jedes System hat eine andere Signatur. Die Kasada-Zeile stammt aus meiner eigenen Erfassung, und die anderen Zeilen stammen aus der öffentlichen Dokumentation der jeweiligen Anbieter:
| Was die Antwort enthält | Das System ist |
|---|---|
x-kpsdk-*-Header und ein KP_UIDz-Cookie, plus ein ips.js-Skript, das window.KPSDK setzt |
Kasada |
cf-ray-Header, __cf_bm-Cookie, server: cloudflare |
Cloudflare |
x-datadome-Header und ein datadome-Cookie |
DataDome |
server: AkamaiGHost bei einer blockierten Antwort, oder ein _abck-Cookie bei einer erlaubten Antwort |
Akamai |
Wenn du einen x-kpsdk-*-Header siehst, ist das System Kasada. Siehst du einen der anderen, gelten die folgenden Kasada-spezifischen Schritte nicht, und Bright Datas Anleitungen zum Umgehen von Cloudflare und zur Akamai-Bot-Erkennung decken diese Systeme ab.
Was Kasada prüft, bevor es einem Client Zugriff gewährt
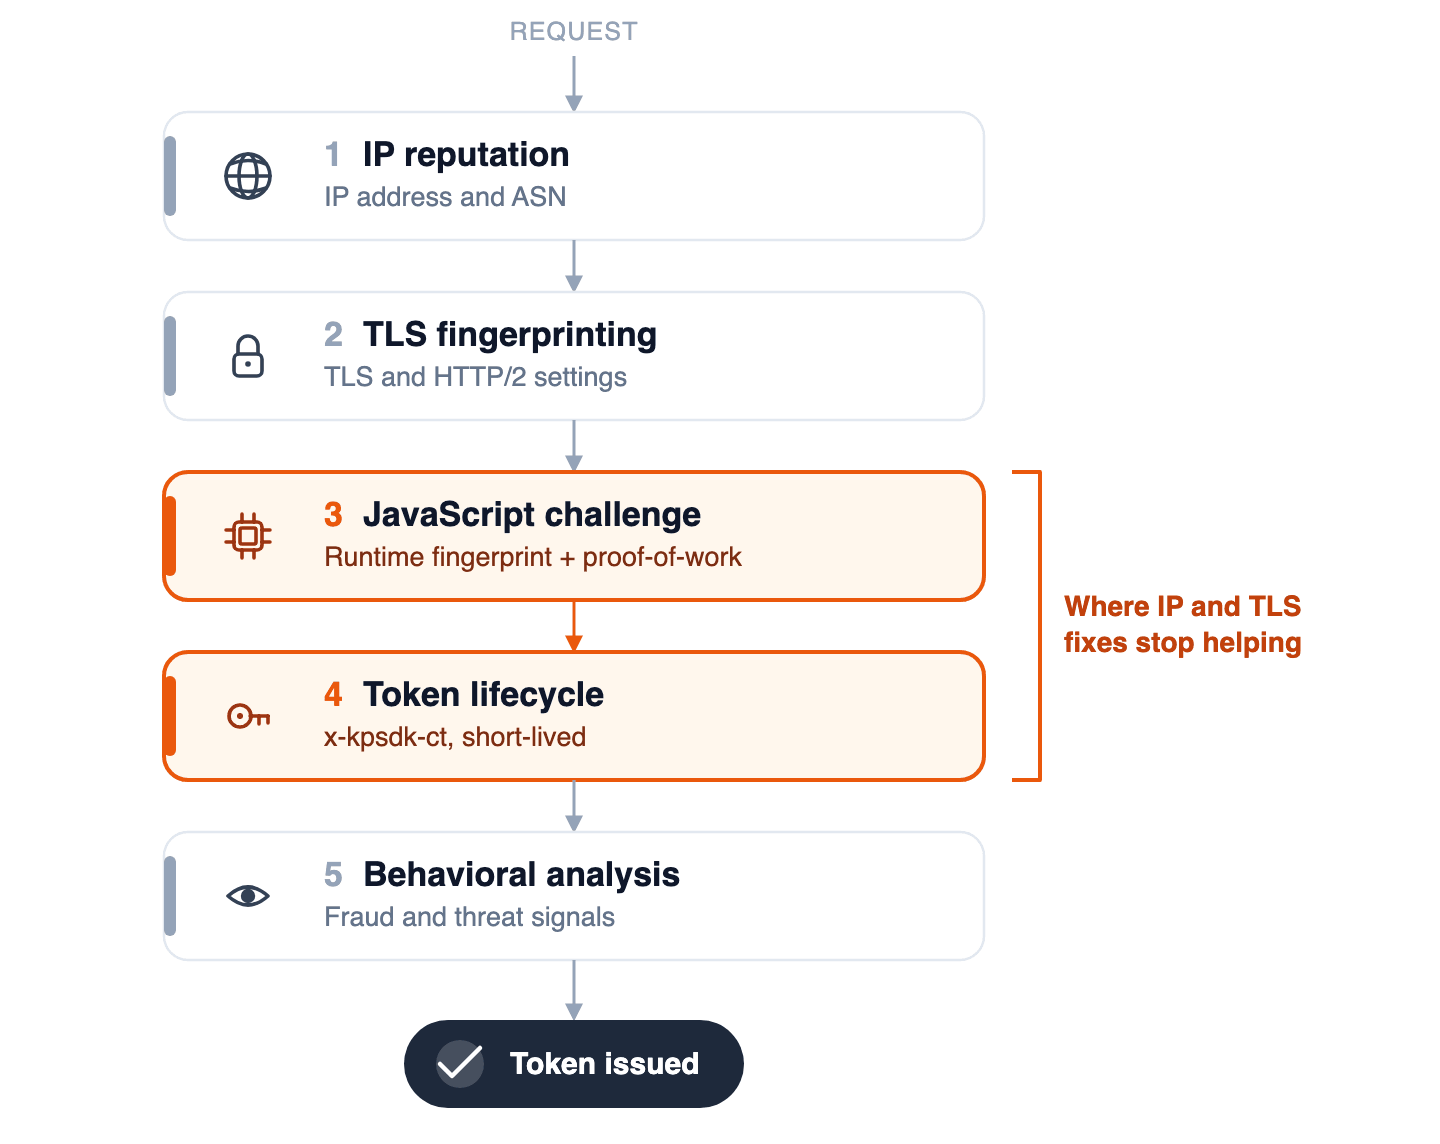
Kasada verlässt sich nicht auf ein einziges Signal. Es nutzt mehrere Ebenen, und eine Anfrage muss alle bestehen, um ein Token zu erhalten. Das Verständnis der Ebenen erklärt, warum eine Lösung, die gegen ein einfacheres System funktioniert, hier wirkungslos bleibt.
Die erste Ebene ist die IP-Reputation. Kasada prüft die Reputation der IP-Adresse und ihrer Autonomous System Number (das Netzwerk, zu dem die Adresse gehört). Ein Datacenter-IP-Bereich, den bereits viele Scraper genutzt haben, hat einen schlechten Ruf, noch bevor du einen einzigen Header sendest. Residential-IP-Adressen von echten Verbraucher-ISPs haben eine bessere Reputation, weil echte Nutzer über dieselben Netzwerke verbunden sind.
Die zweite Ebene ist das TLS-Fingerprinting. Kasada liest den TLS-Handshake und die HTTP/2-Einstellungen und vergleicht sie mit dem, was ein echter Browser sendet. Ein Standard-Python-Client bietet Cipher Suites und Erweiterungen in einer Reihenfolge an, die kein Browser verwendet, sodass der Fingerabdruck nicht zum angegebenen User-Agent passt. Wie TLS-Fingerprinting funktioniert behandelt das ausführlicher.
Die dritte Ebene ist die JavaScript-Challenge. Kasada sendet ein verschleiertes Skript an deinen Client und prüft, was er zurückgibt. Das Skript erstellt einen Fingerabdruck der Laufzeitumgebung, führt eine Proof-of-Work-Berechnung aus (ein Rätsel, das der Client lösen muss) und kombiniert beides zu einem verschlüsselten Paket. Die vierte Ebene ist der Token-Lebenszyklus, den ich aus der Funktionsweise des Protokolls abgeleitet, aber nicht direkt erfasst habe, und die fünfte ist die Verhaltensanalyse, die ich nicht getestet habe. Eine gute IP und ein passender TLS-Handshake erfüllen nur die Ebenen 1 und 2, daher konzentrieren sich die folgenden Abschnitte auf die Ebenen 3 und 4.
In der Reihenfolge, in der eine Anfrage sie durchläuft, sehen die Ebenen so aus:
Wie die Kasada-ips.js-Challenge funktioniert
Die ips.js-Challenge ist eine eigene virtuelle Maschine, daher zeigt das Lesen des Skripts nicht, was sie prüft. Um es direkt zu sehen, habe ich eine von Kasada geschützte Seite angefragt und die Antwort gelesen. Das Ziel war eine öffentliche Immobilien-Website, und die Antwort war ein 429 statt der Seite.
Die 429-Antwort und das ips.js-Skript
Die Antwort enthielt die Kasada-Header und einen kleinen HTML-Body, der die Challenge startet:
HTTP/2 429
x-kpsdk-r: 1-AA
x-kpsdk-ct:
content-type: text/html; charset=utf-8
access-control-expose-headers: x-kpsdk-ct,x-kpsdk-r,x-kpsdk-c,x-kpsdk-h,x-kpsdk-fc
set-cookie: KP_UIDz-ssn=
Du kannst dieselben Header selbst in den Chrome DevTools sehen, bei der ersten Anfrage im Network-Tab (der rote Eintrag oben in der Liste):
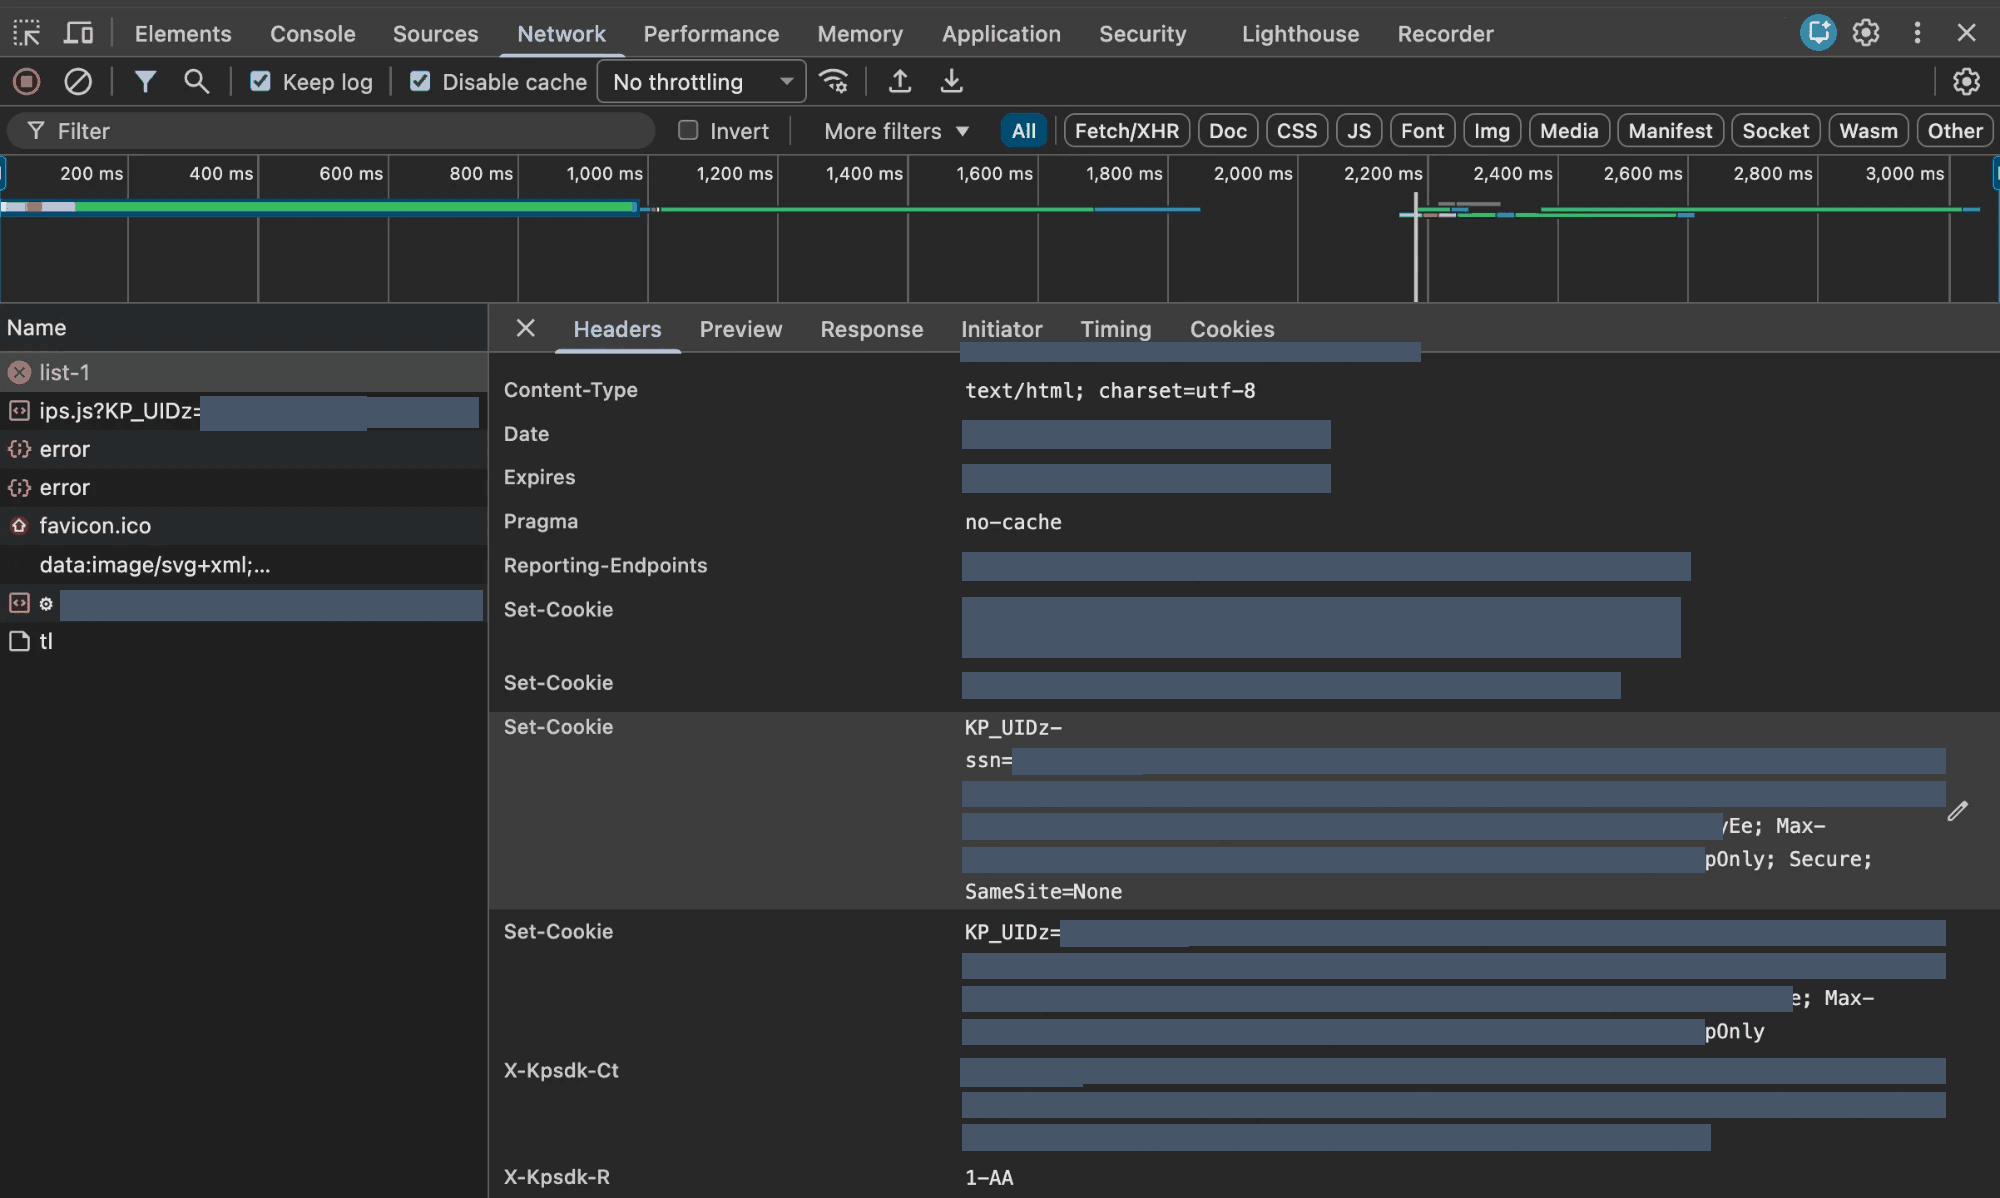
Der 429 ist die Challenge selbst, kein Rate-Limit, und er enthält ein initiales Token und ein Script-Tag. Der Body setzt ein window.KPSDK-Objekt und lädt das Challenge-Skript von einem Pfad, der für jede geschützte Website eindeutig ist:
<script>window.KPSDK={};KPSDK.now=typeof performance!=='undefined'&&performance.now?performance.now.bind(performance):Date.now.bind(Date);KPSDK.start=KPSDK.now();</script>
<script src="///ips.js?KP_UIDz=...&x-kpsdk-im=..."></script>
In den DevTools erscheint der gesamte Austausch als das 429-Dokument, gefolgt vom geladenen Skript, und die Initiator-Spalte verknüpft das Skript mit diesem Dokument:
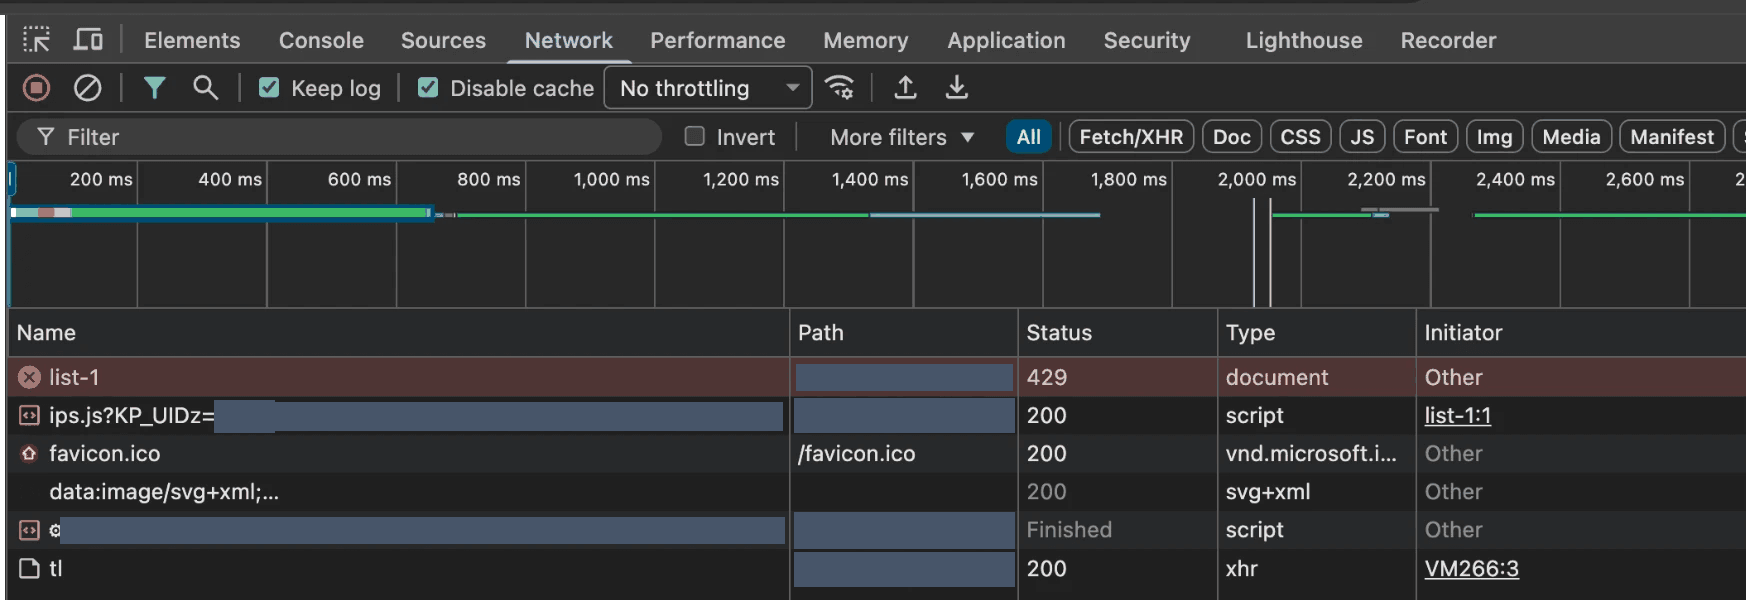
Das Skript, ips.js, ist eine 641-KB-Datei mit fast dem gesamten Code in 1 Zeile. In einem Texteditor geöffnet, ist es unlesbar:
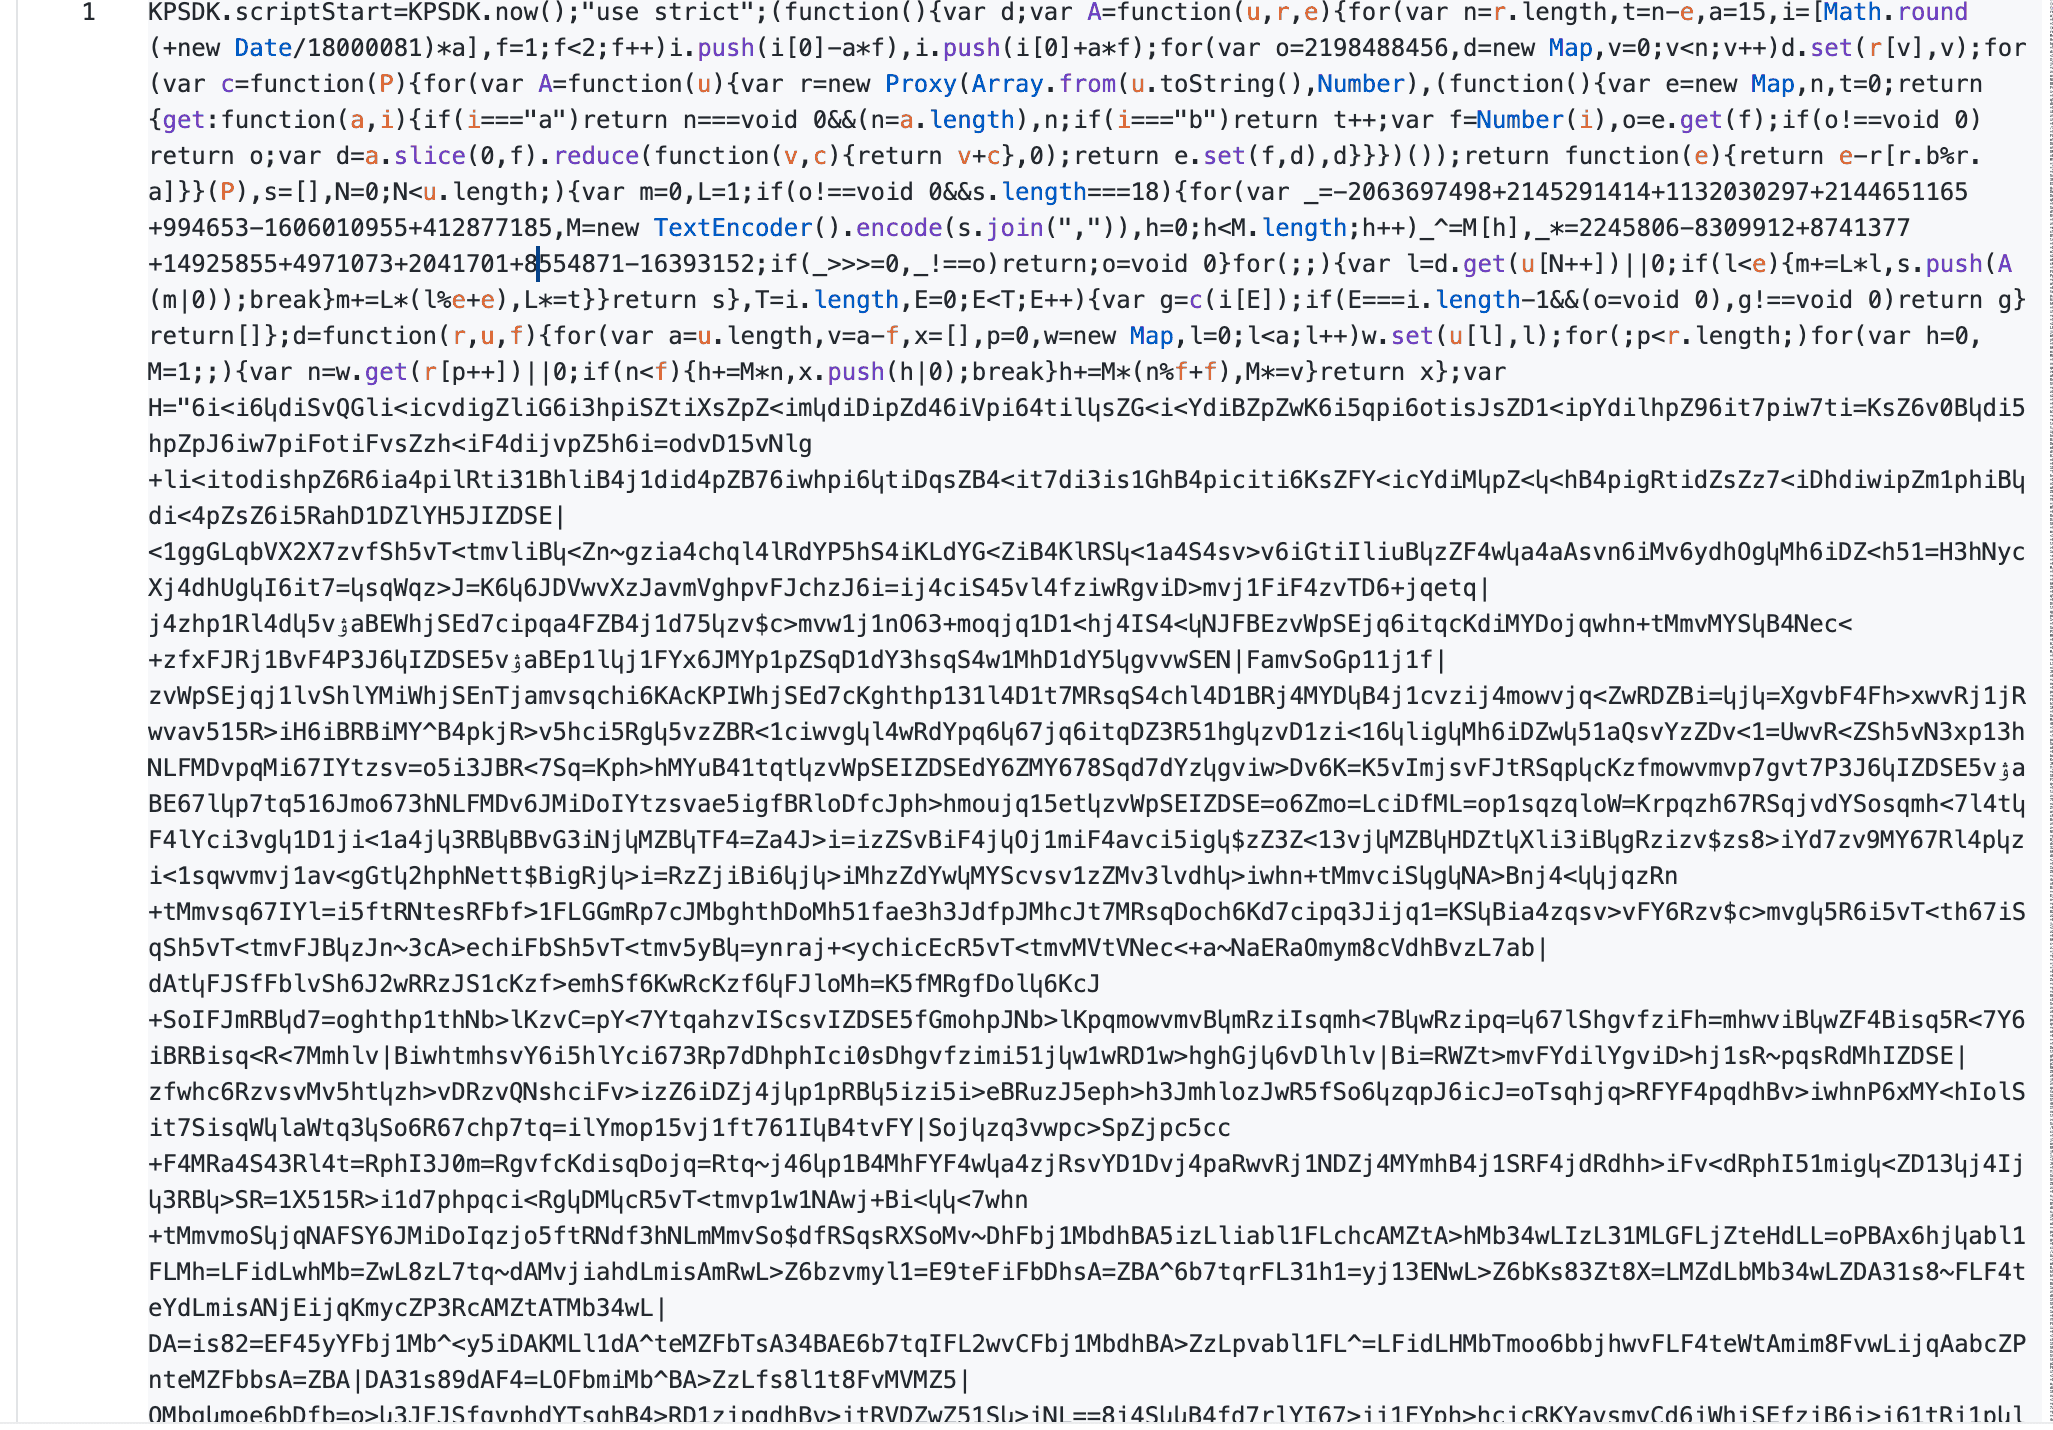
Es gibt keine lesbaren Namen für die Prüfungen, keine navigator.webdriver-Zeichenkette und keine Funktion namens detectHeadless. Das gesamte Programm ist eine eigene virtuelle Maschine (VM), deren Logik zu Bytecode kompiliert ist, sodass der lesbare Quellcode nur der Interpreter ist, während die Prüfungen im Bytecode verborgen bleiben.
Dekodierung von Bytecode und String-Tabelle
Um ins Innere des Interpreters zu schauen, habe ich seine Decoder-Stufe in einem isolierten Node.js-Prozess ausgeführt und das Ergebnis ausgegeben. Das Ergebnis zeigt die tatsächliche Größe des Programms:
BYTECODE len: 268444
STRING POOL len: 38459
Die Nutzlast ist also ein Bytecode-Programm plus eine String-Tabelle (die STRING POOL-Zeile), beide zur Laufzeit aus einer großen Zeichenkette am Anfang des Skripts dekodiert. Da sich das Programm zur Laufzeit selbst dekodiert, existieren die Zeichenketten, nach denen du suchen würdest, erst, wenn die VM sie während der Ausführung erstellt. Rufst du dasselbe Skript erneut ab, ändern sich die Größen. Bei 3 weiteren aufeinanderfolgenden Anfragen an dieselbe URL hatte das dekodierte Programm 266.322, 275.713 und 266.322 Bytecode-Einträge.
Verschiedene Teile ändern sich nach unterschiedlichen Zeitplänen. Ein 5-Stunden-Fenster steuert den Schlüssel, der entschlüsselt, welchen Inhalt eine Anfrage erhält. Der Inhalt selbst, also das Padding und die im Skript gespeicherten Werte, ändert sich bei jeder Antwort zufällig, unabhängig von diesem Schlüssel. Eine gespeicherte Kopie scheitert also aus zwei Gründen: Ihr Schlüssel läuft ab, und jeder neue Abruf hat anderen Inhalt.
Warum eine gespeicherte Kopie des Skripts aufhört zu funktionieren
Einige Eigenschaften des Decoders sind wichtig, wenn du einen Solver aus einer gespeicherten Kopie des Skripts bauen möchtest. Erstens hängt der Schlüssel von der aktuellen Zeit ab. Der Decoder leitet ihn aus Math.round(Date.now() / 18000081) ab, und 18000081 Millisekunden sind fast genau 5 Stunden. Als ich die Systemuhr über dieses Fenster hinaus vorstellte und die Dekodierung erneut ausführte, gab sie ein leeres Programm zurück:
 0h  -> bytecode len 268444, pool len 38459
 6h  -> bytecode len 0, pool len undefined
Der Decoder akzeptiert einen Schlüssel aus etwa 1 Zeitfenster vor oder nach dem aktuellen, wie lange ein gespeichertes Skript also funktioniert, hängt davon ab, an welcher Stelle seines Fensters du es erfasst hast. Bei meinem erneuten Lauf 6 Stunden später lieferte es bereits nichts mehr, ein gespeichertes Skript bleibt also einige Stunden nützlich, nicht einen Tag.
Zweitens prüft die Nutzlast ihre eigene Integrität. Als ich 2 Zeichen im 72-Zeichen-Alphabet des Decoders vertauschte, scheiterte die Dekodierung des gesamten Programms komplett, statt falsche Ausgaben zu erzeugen. Ein Prüfer in der Dekodierschleife führt eine laufende Prüfsumme mit und stoppt, wenn ein Byte verändert wurde.
Nichts davon ergibt Code, den es sich zu kopieren lohnt. Die Challenge ist polymorph (sie ändert sich bei jedem Abruf), daher funktioniert Logik, die du aus 1 Erfassung kopierst, nicht lange weiter. Ein Solver, der das Skript frisch abruft, vermeidet die veraltete Kopie, muss dann aber bei jedem Durchlauf neuen Inhalt unter einem neuen Schlüssel dekodieren, was die im Abschnitt Bauen oder Kaufen beschriebene Wartungsarbeit ist. Die obigen Zahlen stammen von 1 geschützten Website und 1 Durchlauf, und Kasada kann jede davon in einer späteren Version ändern. Was für andere Websites gilt, ist das Design. Das Skript prüft sich selbst, der Schlüssel hängt von der Zeit ab, und der Proof-of-Work ist mit dem Fingerabdruck verknüpft.
Warum das Token, nicht der Proof-of-Work, Scraper blockiert
Der Proof-of-Work ist für einen echten Browser leichtgewichtig und für den Server kostengünstig zu überprüfen, sodass er nicht teuer genug ist, um Automatisierung allein durch Kosten zu blockieren. Das Token ist es, was einen Scraper blockiert, denn Kasada stellt ein gültiges nur für ein Ergebnis aus einem vollständigen VM-Durchlauf aus, und der Proof-of-Work ist nur ein Teil dieses Ergebnisses.
Der Proof-of-Work erfordert, dass der Client die VM ausführt. Die VM berechnet den Nachweis und sammelt den Fingerabdruck, dann kombiniert sie beides zu 1 verschlüsselten Paket. Das Skript prüft seine eigene Integrität während der Dekodierung, sodass ein Client die VM ausführen und das Fingerprinting normal ablaufen lassen muss, um ein gültiges Ergebnis zurückzugeben. Den Nachweis auf einem Server zu berechnen und einen separaten Fingerabdruck anzuhängen, hilft nicht, denn Kasada akzeptiert nur ein Token aus 1 vollständigen VM-Durchlauf.
Dieser Ablauf endet mit einem Token. Ich habe diesen Austausch nicht direkt erfasst, daher ist das Folgende aus der Funktionsweise des Protokolls abgeleitet. Der Client sendet das verschlüsselte Paket mit einer POST-Anfrage zurück, und wenn es besteht, ersetzt Kasada den initialen x-kpsdk-ct-Wert durch einen gültigen, der Zugriff gewährt. Jede spätere Anfrage muss dieses Token in ihrem Header und Cookie enthalten, und das Token läuft ab. Weil das Token abläuft, muss ein Scraper den Austausch wiederholen, um ein neues zu erhalten.
Vom ersten 429 bis zu einem gültigen Token sieht der Austausch zwischen Client und Server so aus:
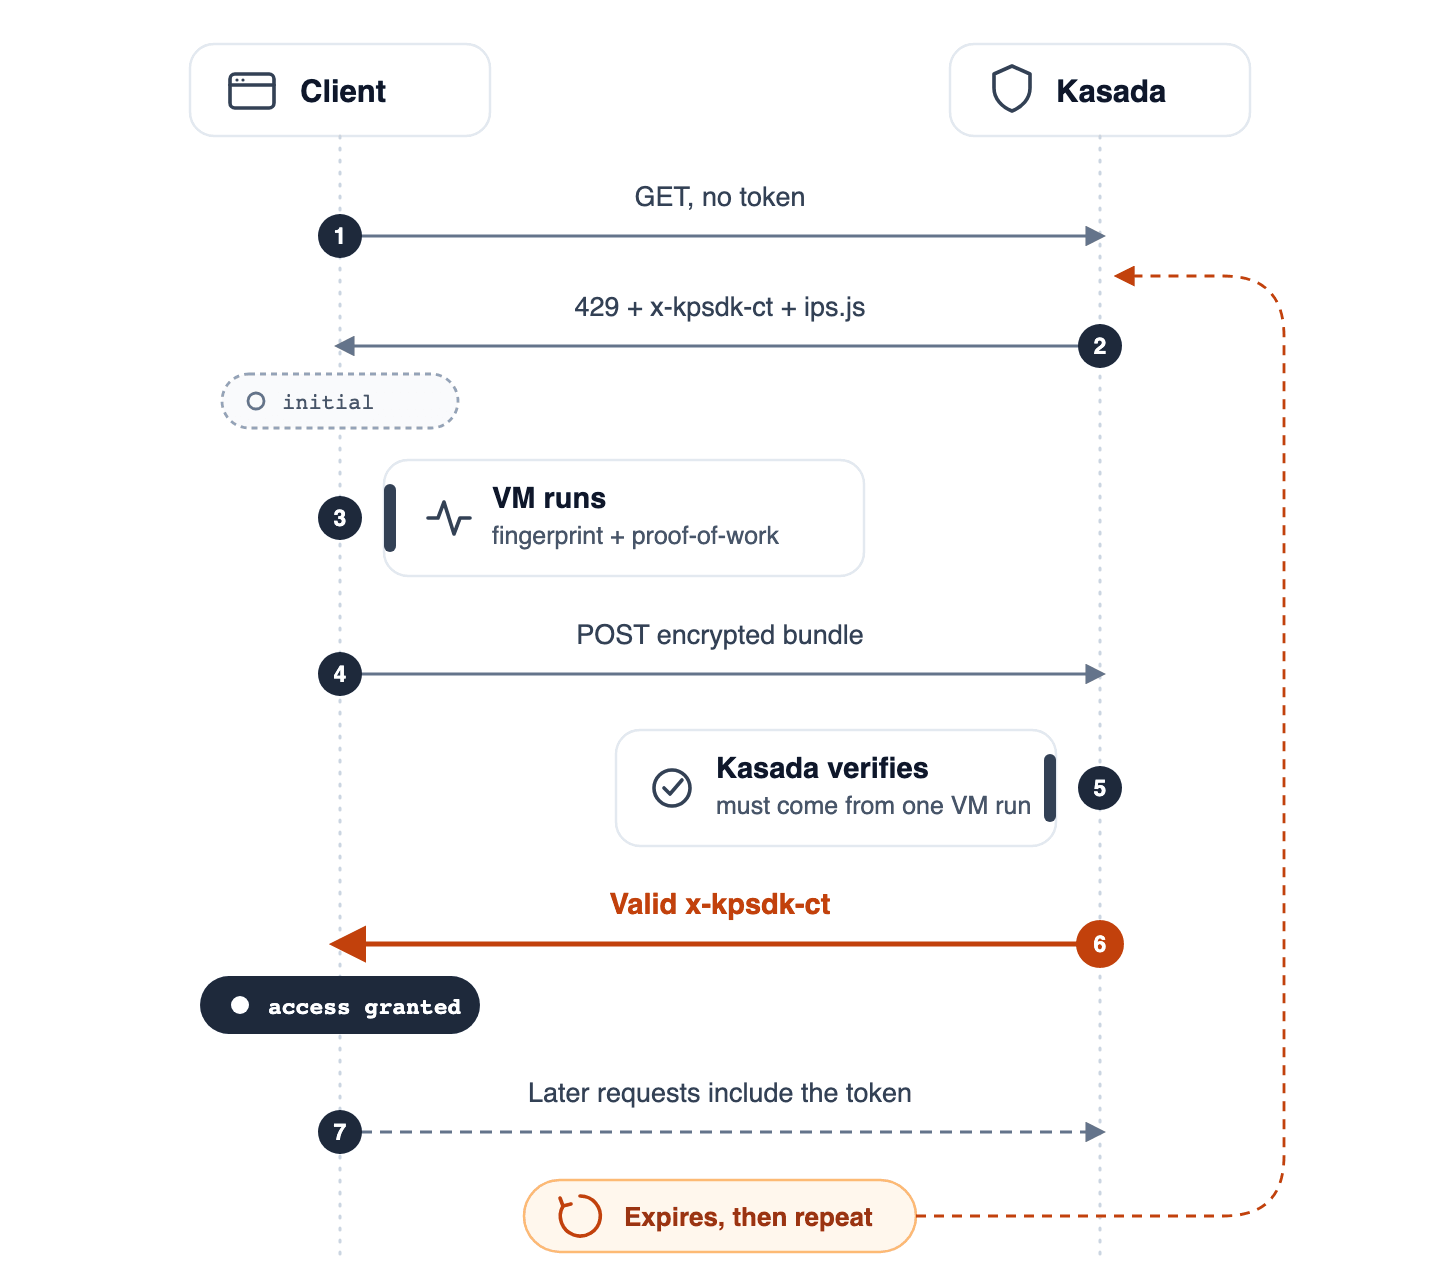
Das Token unterscheidet sich auch zwischen Antworten. Über 3 aufeinanderfolgende Anfragen gab derselbe Kasada-429 3 unterschiedliche x-kpsdk-ct-Werte zurück, das Token ist also kein fester Wert, den du einmal erfassen und erneut senden kannst.
Wie Kasada Headless-Browser erkennt
Wenn die VM eine Laufzeitumgebung benötigt, die sich wie ein echter Browser verhält, liegt der naheliegende Schritt darin, einen echten Browser zu automatisieren. Das funktioniert besser als ein HTTP-Client, aber ein standardmäßig automatisierter Browser sendet dennoch Signale, und die dekodierte String-Tabelle enthält die Namen, nach denen Kasada sucht.
Signale in einem standardmäßigen Headless-Browser
Ein unverändertes Headless-Chromium zeigt, dass es automatisiert ist. Ich habe eines mit Playwright gestartet und die Browser-Eigenschaften gelesen, die die Nutzlast prüft:
# pip install playwright, falls noch nicht vorhanden
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    page = p.chromium.launch().new_page()
    print(page.evaluate("[navigator.webdriver, navigator.userAgent, navigator.plugins.length, window.chrome]"))
Die ausgegebenen Werte, hier jeweils in einer Zeile:
navigator.webdriver     true
userAgent               ...HeadlessChrome/ Safari/537.36
navigator.plugins       0        (ein echter Browser mit UI listet mehrere auf)
window.chrome           null     (vorhanden bei einem normalen Desktop-Chrome)
Jede Zeile ist ein Signal. navigator.webdriver ist true unter Automatisierung und false bei einem normalen Browser. Die User-Agent-Zeichenkette enthält HeadlessChrome. Die Plugin-Liste ist leer, und das window.chrome-Objekt, das ein Desktop-Chrome bereitstellt, fehlt.
Du kannst diese Signale verbergen, aber wie du sie verbirgst, ist entscheidend, wenn das Ziel Kasada ist. Ein stealth-gepatchtes Playwright ändert diese Eigenschaften per JavaScript, nachdem der Browser gestartet ist, sodass eine Prüfung, die darauf ausgelegt ist, solche Überschreibungen zu finden, dies dennoch erkennen kann. Ein Build auf Quellcode-Ebene, wie der Camoufox-Firefox-Fork oder ein gepatchtes Chromium wie BotBrowser, ändert die Werte im eigenen C++-Code des Browsers, bevor überhaupt ein Skript läuft. Das hinterlässt keine JavaScript-Überschreibung, die die Prüfung finden könnte. Ein veraltetes Chrome-Build ist ebenfalls ein Signal, weil seine Version nicht dem entspricht, was echte Nutzer verwenden. Das Aktualisieren des Browsers entfernt jedoch nicht die eigenen Signale des Automatisierungs-Frameworks.
Signale von Automatisierungs-Frameworks
Playwright hinterlässt in der Seite Namen, die ein normaler Browser nicht hat. Als ich einer Playwright-Seite eine einzelne Bindung hinzufügte, erstellte sie diese globalen Variablen:
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    page = p.chromium.launch().new_page()
    page.expose_binding("demo", lambda source: None)
    print([k for k in page.evaluate("Object.keys(window)") if "playwright" in k.lower()])
Sie gibt diese Namen aus:
['__playwright__binding__', '__playwright__binding__controller__']Die obigen Namen sind nur das, was eine einzelne Bindung erzeugt. Zusätzlich habe ich die dekodierte String-Tabelle nach Playwrights internen Bindungsnamen durchsucht. Etwa die Hälfte der Namen in der getesteten Playwright-Version erschien dort als reine Zeichenketten, neben webdriver, HeadlessChrome und electron. Die gefundenen Namen sind seine Recorder- und DevTools-Bindungen.
Ein Name in der dekodierten String-Tabelle beweist nicht, dass die VM danach handelt. Dennoch zeigt das Auffinden, dass Kasada diese Tools namentlich kennt, es muss also nicht raten, welche Automatisierungsbibliothek es erkennt.
CDP-Erkennung und die Tools, die sie vermeiden
Auch ohne Bindung macht das Chrome DevTools Protocol (CDP), das Automatisierungs-Frameworks zur Steuerung des Browsers nutzen, sie erkennbar. Ein Artikel zu CDP-Fingerprinting zeigte, dass der Aufruf von Runtime.enable, den Playwright und Puppeteer standardmäßig durchführen, den Browser sofort dazu bringt, Objekte, die an console-Methoden übergeben werden, zu serialisieren (in Text umzuwandeln). Ein kurzes Skript kann dies ohne Zeitmessungen erkennen, indem es ein Proxy-Objekt an einen console-Aufruf übergibt:
let detected = false;
const trap = new Proxy({}, { ownKeys() { detected = true; return []; } });
console.groupEnd(Object.create(trap));
// detected ist true auf älterem Chromium, wenn ein CDP-Client Runtime.enable aufgerufen hat
Der Autor berichtete, dass die Technik zum Zeitpunkt der Veröffentlichung funktionierte, und ich habe dies unabhängig auf älteren Chromium-Builds bestätigt, wo das Snippet auf einer Standard-Playwright-Seite true zurückgibt, weil Playwright Runtime.enable standardmäßig aufruft. Auf den neueren von mir getesteten Chromium-Builds gibt dasselbe Snippet false zurück, selbst nachdem ich Runtime.enable selbst aufgerufen habe, Chrome hat also geändert, wie es Konsolenargumente behandelt. Teste es mit deiner eigenen Browserversion, bevor du dich darauf verlässt. Eine solche Prüfung benötigt keine Berechtigungen oder Erweiterungen, sodass sie für ein Anti-Bot-System kostengünstig auszuführen und für dich schwer zu bemerken ist.
Eine Antwort besteht darin, Chrome ohne den Framework-Code zu steuern, der Runtime.enable aufruft. Tools wie nodriver, sein Fork zendriver und SeleniumBases CDP-Modus kommunizieren direkt über CDP mit Chrome und rufen nie Runtime.enable auf. Gepatchte Playwright-Forks wie patchright beheben dasselbe Problem innerhalb von Playwright. Auf dem älteren Build, bei dem das Snippet für Playwright true zurückgab, gab es gegen zendrivers Standardseite false zurück, weil nie ein Runtime.enable-Aufruf erfolgt. Jedes dieser Tools hilft, aber keines ist dauerhaft, denn das Signal, der Fix und Kasadas Prüfung ändern sich alle nach eigenem Zeitplan, und die obige Browseränderung ist ein Beispiel dafür.
Scraping mit einem HTTP-Client und seine Grenzen
Viele Teams versuchen, den Browser ganz zu umgehen, aus gutem Grund. Ein Browser ist langsam und ressourcenintensiv, und ein HTTP-Client, der den richtigen Fingerabdruck liefert, ist pro Anfrage viel günstiger. Die Frage ist, wie gut dieser Ansatz gegen Kasada funktioniert.
Du kannst die TLS-Fingerprint-Prüfung mit Bibliotheken wie curl_cffi in Python oder surf in Go bestehen, die den TLS-Handshake an einen echten Browser anpassen. Um dies zu überprüfen, nutze einen Dienst, der den empfangenen TLS-Handshake meldet. Er meldet JA4, einen allein aus dem Handshake berechneten Fingerabdruck, und listet die HTTP/2-Einstellungen (die Kasada ebenfalls liest) als separaten Fingerabdruck auf:
# pip install curl_cffi, falls noch nicht vorhanden
from curl_cffi import requests as cf

r = cf.get("https://tls.peet.ws/api/all", impersonate="chrome")
print(r.json()["tls"]["ja4"])
# impersonate= entfernen, um stattdessen das JA4 des Standard-Clients zu sehen
Führe es beide Male aus und vergleiche. Dies sind die Werte, die ich erhalten habe, deine werden abweichen, da Browser und Bibliotheken aktualisiert werden, also prüfe sie gegen echtes Chrome auf demselben Dienst:
curl_cffi impersonate="chrome"  JA4=t13d1516h2_8daaf6152771_806a8c22fdea
curl_cffi (ohne impersonate)    JA4=t13d2712h2_b4f9224df7c1_9ced094328c9
Der nachgeahmte Client sendet ein JA4, das einem echten Browser entspricht, während der Standard-Client ein JA4 sendet, das kein Browser verwendet. Legst du eine bestimmte Browserversion fest, behauptet der User-Agent weiterhin diese Version, nachdem das echte Chrome aktualisiert wurde, wodurch dein Client veraltet wirkt. impersonate="chrome" zu verwenden, lässt die Bibliothek stattdessen die Chrome-Version wählen, sodass du keine Versionsnummer aktualisieren musst. Die curl_cffi-Anleitung zeigt das vollständige Setup.
Ich habe das Snippet erneut über einen zweiten Dienst laufen lassen, https://tls.browserleaks.com/json, und das nachgeahmte JA4 war identisch. Er meldet den Wert als r.json()["ja4"], funktioniert also als Fallback, falls tls.peet.ws nicht erreichbar ist, was mir einmal von meinem Netzwerk aus passiert ist.
Das Problem ist, dass der TLS-Handshake nicht die Stelle ist, an der Kasada seine Entscheidung trifft. Ein HTTP-Client, der die TLS-Prüfung besteht, erhält trotzdem die Challenge, und er kann die VM nicht ausführen.
Um mit einem reinen HTTP-Ansatz ein Token zu erhalten, müsstest du den Interpreter, die Fingerabdruckerfassung und den Proof-of-Work in deinen eigenen Code portieren und diesen Code bei jeder Änderung der Nutzlast aktualisieren. Spezialisierte Solver-Dienste verkaufen genau das als API und generieren das Token und den Proof-of-Work über HTTP. So oder so zahlst du laufende Kosten, entweder eigene Wartung oder eine Gebühr pro Lösung, und der Solver muss sich an jede Änderung der Nutzlast anpassen. Der HTTP-Ansatz behandelt die TLS-Prüfung schnell und korrekt, kann aber nicht das von Kasada benötigte Token erzeugen.
Ein weiterer Punkt beeinflusst, wie du entscheidest, ob eine Anfrage erfolgreich war. Kasadas eigener Field-CTO hat den von ihnen bevorzugten Ansatz beschrieben. Statt mit einem Fehler zu blockieren, liefern sie eine Seite, die richtig aussieht, aber falsch ist, sodass der Betreiber weiter glaubt, der Bot funktioniere. Eine Antwort mit Inhalt ist nicht immer eine korrekte Antwort, daher muss jeder Test gegen Kasada den Inhalt mit dem vergleichen, was ein Browser zeigt, und nicht nur prüfen, dass etwas zurückgegeben wurde.
Bauen oder Kaufen bei Kasada
Zusammengenommen zeigt die Analyse, dass ein selbst gebauter Solver kein einzelnes schwieriges Problem ist. Es ist laufende Wartungsarbeit. Du müsstest all das pflegen:
- Einen VM-Interpreter, der sich an eine selbstprüfende Nutzlast und einen häufig rotierenden Schlüssel anpasst
- Ein Fingerabdruckprofil, das Kasadas sich ändernden Prüfungen entspricht
- Token-Handling, das funktioniert, wenn ein Token während einer Sitzung abläuft
- Einen Proxy-Pool mit ausreichend guter Reputation, um die IP-Reputationsprüfung zu bestehen
Selbst bauen kann sinnvoll sein, wenn du nur eine Website im Visier hast und Entwickler zur Verfügung stehen, die den Solver aktuell halten können. Zielst du auf mehrere Websites ab oder kannst keine Entwicklungszeit widmen, nimmt dir ein verwalteter Dienst diese Arbeit ab.
Web Unlocker für einzelne Anfragen
Ein verwalteter Dienst ist die Alternative zur Einstellung von Entwicklern für diese laufende Arbeit. Bright Datas Web Unlocker nimmt eine Ziel-URL entgegen und übernimmt die Challenge, die Sitzung und die Wahl der Exit-IP (die Adresse, die das Ziel sieht) für dich, sodass dein Code 1 Anfrage sendet und das Ergebnis liest:
curl -H "Content-Type: application/json" \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -d '{"zone":"YOUR_ZONE_NAME","url":"https://target.example/listing","format":"raw"}' \
  https://api.brightdata.com/request
Ersetze beide Platzhalter durch deinen eigenen Zonennamen und API-Schlüssel und setze url auf dein eigenes Ziel, bevor du es ausführst.
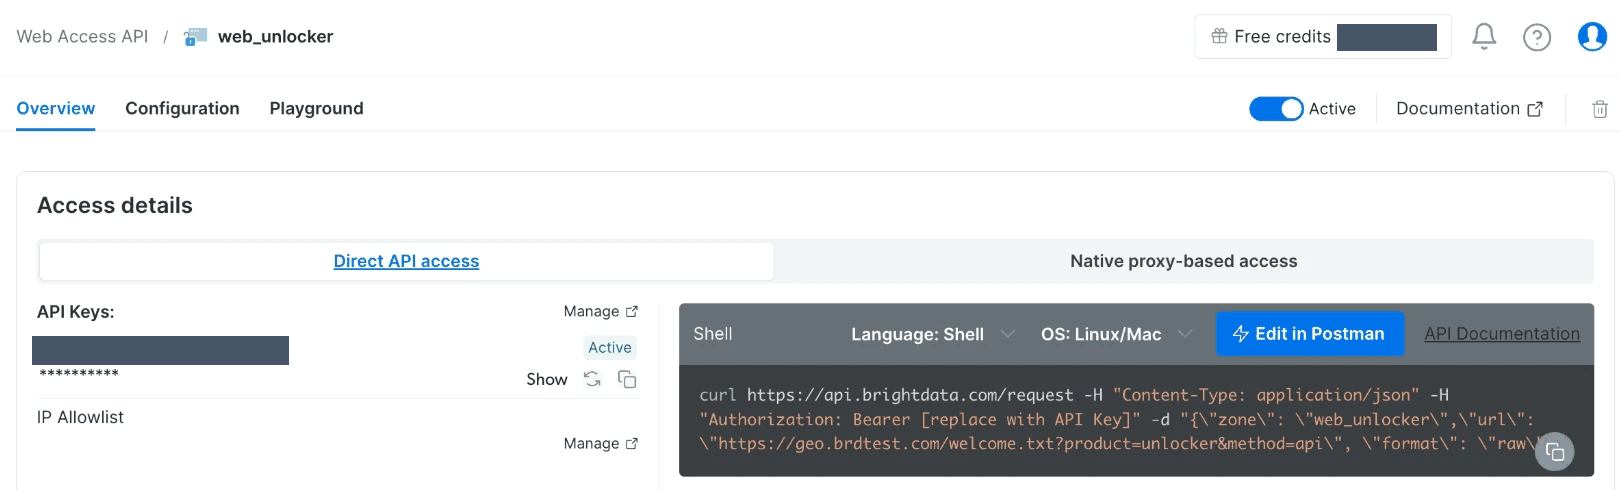
Beide Werte findest du im Overview-Tab deiner Web-Unlocker-Zone. Das Panel für den direkten API-Zugriff listet deinen Schlüssel und eine sofort ausführbare Anfrage, die bereits deinen Zonennamen enthält:
Um einen erfolgreichen Aufruf zu sehen, bevor du ihn gegen ein echtes Ziel einsetzt, führt der Playground-Tab der Zone dieselbe Anfrage gegen die Test-URL von Bright Data aus und zeigt die Antwort:
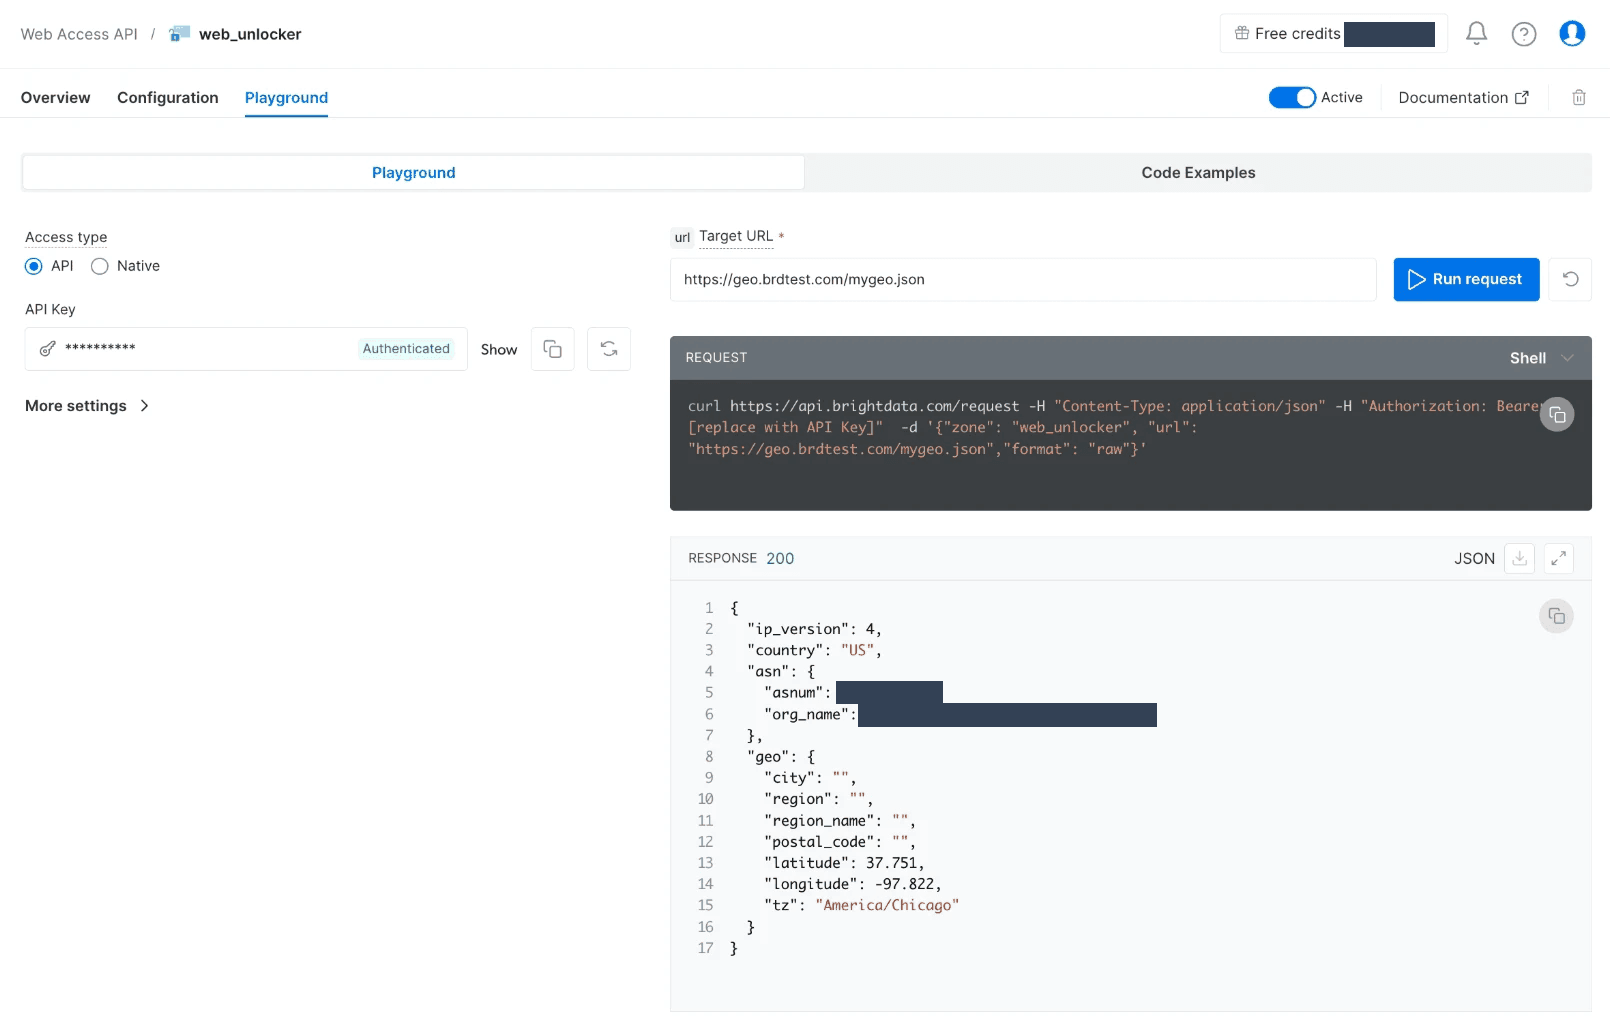
Ein erfolgreicher Aufruf gibt den entsperrten Seiteninhalt zurück. Web Unlocker rechnet pro erfolgreicher Anfrage ab, und seine kostenlose Stufe umfasst 5.000 Anfragen im Monat ohne Kreditkarte, sodass du ihn gegen dein eigenes Ziel testen kannst. Die Kasada-Lösung ist eingebaut, wie auf Bright Datas Kasada-Solver-Seite beschrieben. Aktuelle Pläne und Preise findest du auf der Web-Unlocker-Preisseite. Optionale Anfragefelder lassen dich das Exit-Land mit country wählen und Seiten laden, die JavaScript benötigen, mit render, beides aufgelistet in der API-Referenz.
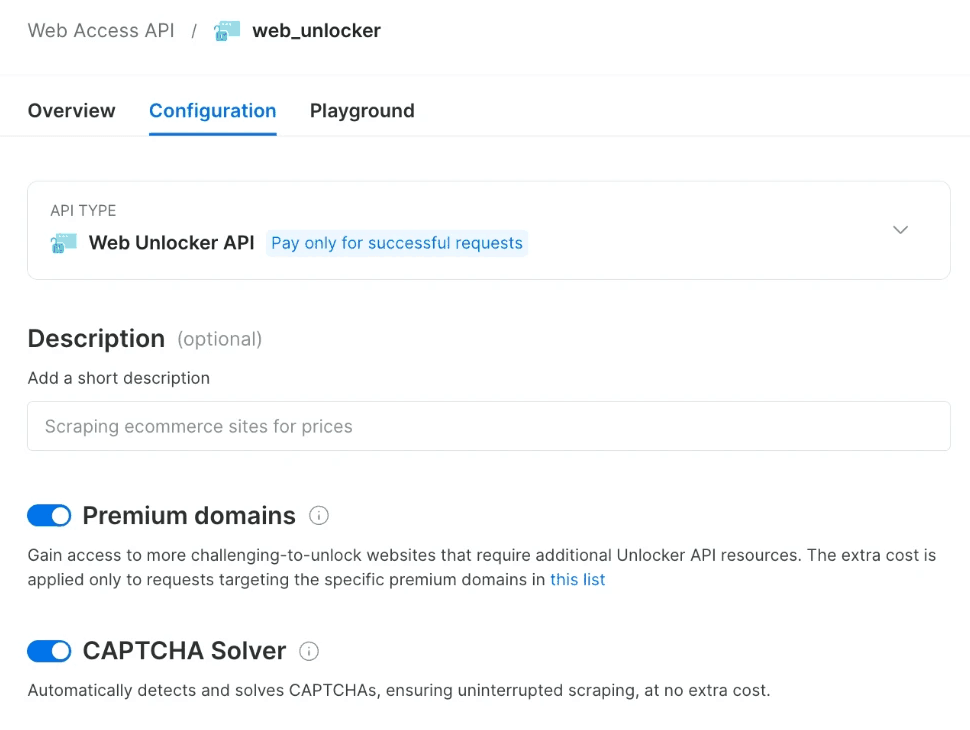
Für anspruchsvollere Websites aktiviere die Option Premium-Domains im Configuration-Tab der Zone, um die zusätzlichen Ressourcen hinzuzufügen, die diese Websites benötigen:
Browser API für interaktive Seiten
Wenn das Ziel volle Seiteninteraktion benötigt, etwa einen Login-Ablauf oder eine mehrstufige Suche, führt die Browser API einen verwalteten Browser aus, mit dem du dich verbindest. Playwright und Puppeteer steuern ihn über CDP. Die Verbindungs-URL enthält deine Kunden-ID, den Zonennamen und das Zonenpasswort, und der Overview-Tab der Zone listet all das unter Zugangsdaten auf:
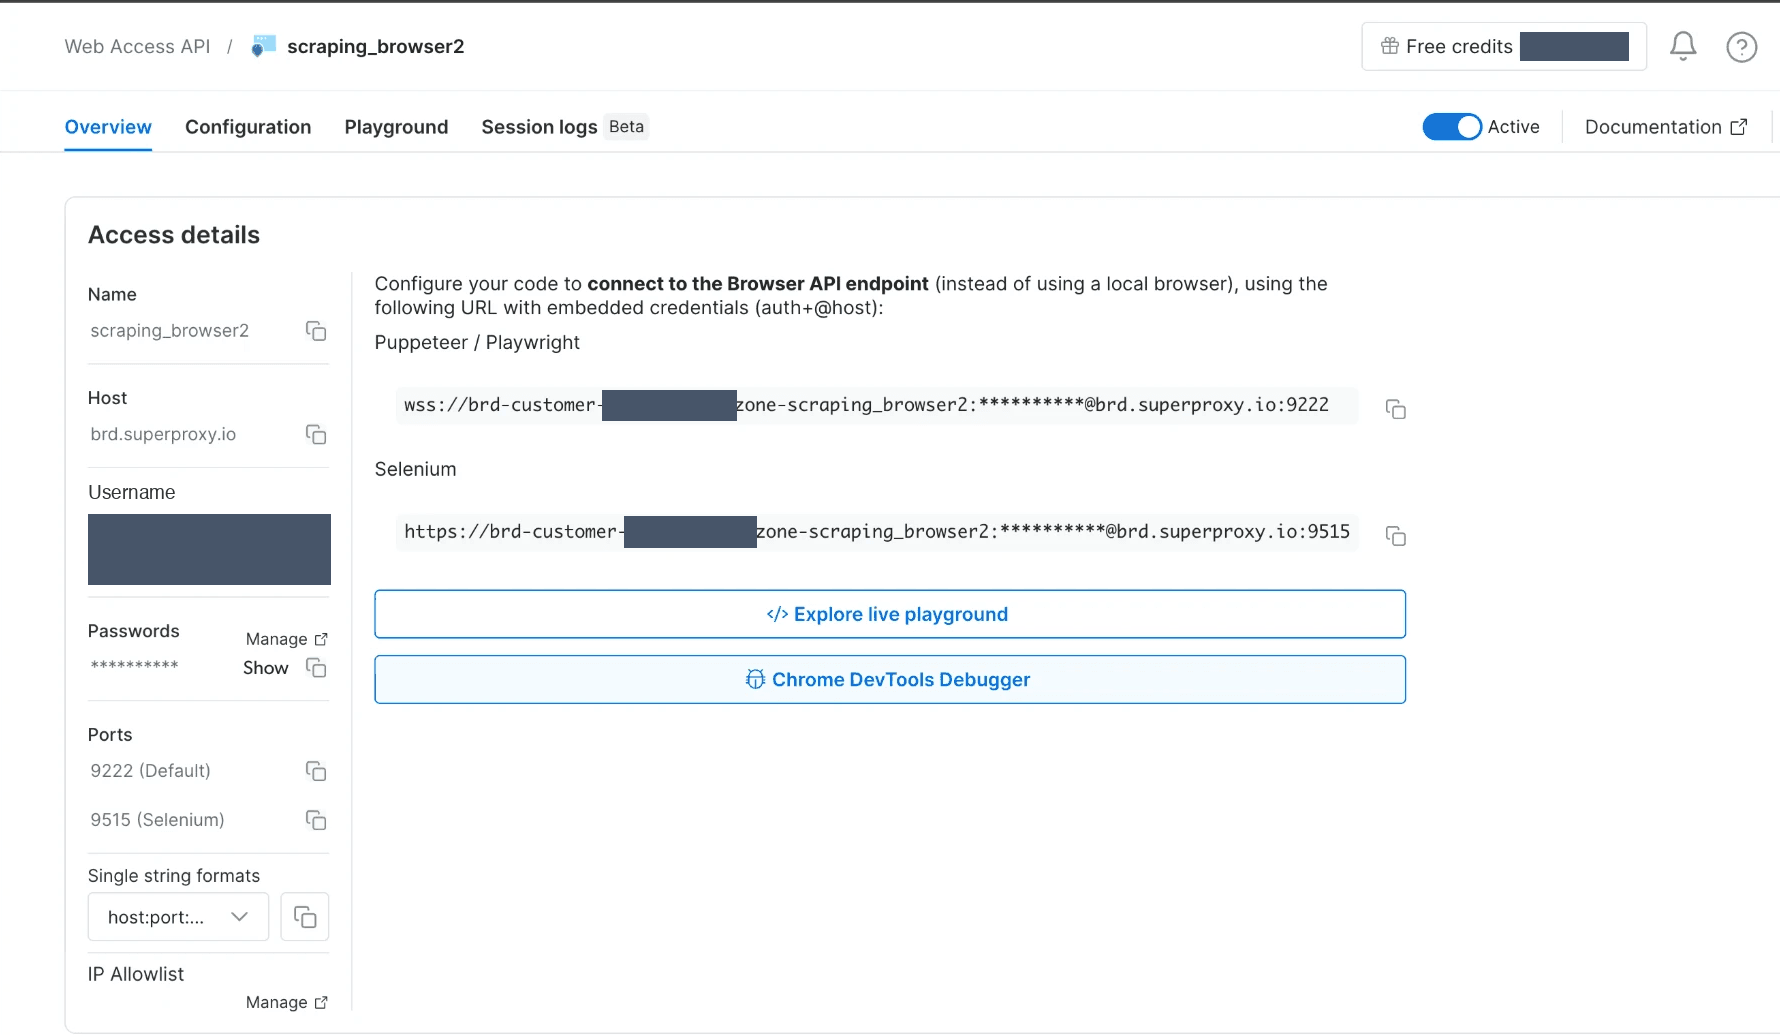
Nachdem du diese Werte eingegeben hast, verbindet es sich wie jeder Remote-Browser:
# pip install playwright, falls noch nicht vorhanden
from playwright.sync_api import sync_playwright

CDP = "wss://brd-customer-CUSTOMER_ID-zone-ZONE_NAME:[email protected]:9222"
with sync_playwright() as p:
    browser = p.chromium.connect_over_cdp(CDP)
    page = browser.new_page()
    page.goto("https://target.example/search")
    page.wait_for_selector("YOUR_CONTENT_SELECTOR")  # durch einen Selektor für den benötigten Inhalt ersetzen
    print(page.title())
    browser.close()
Wenn du dich auf diese Weise verbindest, übernimmt das eingebaute Unlocking der Browser API die Kasada-Challenge, sodass dein Skript mit einer gewöhnlichen Seite arbeitet. Warte mit einem Selektor auf den benötigten Inhalt und nutze diesen Inhalt, nicht einen Statuscode, um den Erfolg zu bestätigen. Die Browser API unterstützt auch Selenium, und für ein Kasada-Ziel beginne mit der oben gezeigten CDP-Verbindung. Der Overview-Tab der Zone verlinkt zudem zu einem Live-Playground und einem Chrome-DevTools-Debugger, sodass du eine Sitzung beim Aufbau beobachten kannst.
Aktuelle Preise der Browser API findest du auf ihrer Preisseite. Für einfachere Seiten ist eine einzelne Web-Unlocker-Anfrage die schnellste Option, und Standard-Techniken gegen Blockierung decken die übrigen Fälle ab.
KI-Agenten und verifizierte Bots
Kasada entwickelt sich weiter, und Traffic von KI-Agenten verändert, was erkannt werden muss. Es brachte AI Agent Trust heraus, ein Produkt zur Verwaltung von KI-Agenten-Traffic. Es klassifiziert Agenten danach, wie gut sie ihre Identität nachweisen können, und erlaubt einer Website, manche Agenten zuzulassen und andere zu blockieren.
Die Identifizierung von Agenten basiert auf einem Standard namens Web Bot Auth. Er lässt einen Bot seine Identität bei jeder Anfrage nachweisen, mittels HTTP-Nachrichtensignaturen (definiert in RFC 9421), einem signierten Header und einem veröffentlichten Schlüsselverzeichnis. Die Internet Engineering Task Force (IETF) Working Group pflegt die Entwürfe, prüfe also den aktuellen Status, bevor du dich darauf verlässt. Cloudflare verifiziert diese Signaturen bereits für Bots, die sich dort registrieren. Die Richtung geht zu einem Web, in dem ein verifizierter Agent Zugriff erhält und ein unverifizierter die volle Challenge bestehen muss. Nichts davon macht ein Kasada-Token für einen Scraper optional.
Fazit
Kasada blockiert Anfragen ohne gültiges Token und stellt eines erst aus, nachdem der Client seine selbstprüfende Challenge abgeschlossen hat. TLS-Impersonation besteht nur die TLS-Prüfung, das zu lösende Problem ist also das x-kpsdk-ct-Token. Vergleiche einen selbst gebauten und gewarteten Solver, der innerhalb von Stunden aufhören kann zu funktionieren, mit Bright Datas Web Unlocker, der die Challenge für dich löst und 5.000 kostenlose Anfragen im Monat ohne Kreditkarte umfasst. Wenn du entscheidest, worauf du deine Entwicklungszeit konzentrierst, beginne mit der verwalteten Option, indem du 1 Anfrage an genau die URL sendest, die deine 429er zurückgibt, und prüfe den Antwortinhalt statt des Statuscodes.
FAQ
Wie funktioniert Kasada?
Kasada liefert eine verschleierte JavaScript-Challenge von einem Pfad wie /ips.js. Das Skript führt eine virtuelle Maschine aus, die die Laufzeitumgebung fingerprintet, einen Proof-of-Work berechnet und ein verschlüsseltes Paket zurücksendet. Besteht es, stellt Kasada ein x-kpsdk-ct-Token aus, und jede Anfrage muss es enthalten oder erhält eine 429-Antwort.
Kann man Kasada mit einem kostenlosen Open-Source-Solver umgehen?
Ein kostenloser Solver von GitHub funktioniert anfangs vielleicht, hört aber schnell auf zu arbeiten. Die Nutzlast ändert ihren Decoder-Schlüssel häufig (in meiner Erfassung etwa alle 5 Stunden) und prüft ihre eigene Integrität, sodass erfasste Logik innerhalb von Stunden nicht mehr dekodiert. Ein öffentlicher Solver kann veraltet sein, nutze ihn also zum Lernen, nicht im Produktivbetrieb.
Umgeht eine Chrome-Aktualisierung Kasada?
Aktualisieren hilft, löst aber nicht das Problem. Ein altes Chrome-Build ist allein schon ein Signal, ein aktuelles Build entfernt dieses Signal. Es entfernt nicht die anderen Signale, wie navigator.webdriver, eine leere Plugin-Liste oder die eigenen Signale des Automatisierungs-Frameworks, die die Challenge ebenfalls prüft.
Was sind die x-kpsdk-Header?
Es sind Kasadas Header. x-kpsdk-ct ist das Client-Token (ein gültiges gewährt Zugriff), x-kpsdk-r und x-kpsdk-c sind zugehörige Challenge-Header, und die passenden KP_UIDz-Cookies verfolgen die Sitzung. Jeder x-kpsdk-*-Header bei einem 429 oder 403 ist ein zuverlässiges Zeichen, dass Kasada die Anfrage abgelehnt hat.
Was ist der schnellste Weg, einen Kasada-429 zu umgehen?
Leite die Anfrage über Bright Datas Web Unlocker, der die URL entgegennimmt, die Challenge für dich löst und pro erfolgreicher Anfrage abrechnet. Für Seiten, die einen Login oder eine mehrstufige Interaktion benötigen, nutze die Browser API über CDP, deren eingebautes Unlocking die Challenge übernimmt.