Amazon Bedrock Knowledge Bases ist ein verwalteter Dienst für Retrieval Augmented Generation (RAG). Man verweist ihn auf eine Datenquelle, und er zerlegt, bettet ein und indexiert die Dokumente, um dann Anfragen mit Zitaten zu beantworten. Zu seinen Konnektoren gehören Amazon S3, SharePoint und ein nativer Web Crawler für öffentliche Seiten.
Dieser Crawler deckt das kooperative Web ab. Viele Produktkataloge, Marktplätze und Nachrichtenseiten werden mit JavaScript gerendert, liegen hinter Bot-Schutz oder liefern je nach Land unterschiedliche Inhalte. Der Crawler liefert dann eine leere Hülle, eine Blockierung oder den Inhalt des falschen Landes. Diese Anleitung speist solche Seiten über Bright Data und S3 in eine Knowledge Base ein.
Kurzfassung
- Web Unlocker liefert eine öffentliche Seite in einer Anfrage als Markdown, es sei denn, die Seite erfordert Interaktion. Jede Seite wird als
.mdplus einer.metadata.json-Begleitdatei nach S3 geschrieben. - Den Inhalt vor dem Schreiben hashen, damit eine Aktualisierung nur die neu geschriebenen Seiten neu einbettet statt des gesamten Korpus.
- Vor dem Skalieren den Abruf gegen einen goldenen Datensatz messen, denn die Chunking-Einstellung wird an der Datenquelle festgelegt und die nicht filterbaren Metadatenschlüssel an einem S3-Vectors-Index. Beides lässt sich später nicht mehr ändern.
- Pro Anfrage routen. Bei einem Höchstwert unterhalb einer Relevanzschwelle auf eine Live-Abfrage zurückgreifen.
Warum der native Web Crawler eine Lücke lässt
Die Web-Crawler-Datenquelle ist ein nativer Konnektor, und für eigene statische Seiten ist er eine gute Wahl. Aktuell überlassen seine Einschränkungen öffentliche Webdaten im großen Maßstab Bright Data.
- Er unterstützt statische Websites. Die Dokumentation sagt das direkt, und der Crawler ruft keine Seiten ab, die clientseitig gerendert werden. Viele Kataloge, Dashboards und Listenseiten werden so gerendert, sodass der Crawler dort eine leere Hülle sieht, wo die Daten sein sollten.
- Er ist für das kooperative Web gebaut. Der Crawler respektiert
robots.txtgemäß RFC 9309 und behandelt die Site als nicht erlaubt, wenn er keine findet. Er identifiziert sich alsbedrockbotund stoppt konzeptionell an Bot-Schutzmaßnahmen. - Er ist pro Synchronisation auf 25.000 Seiten begrenzt und unterstützt einen Vektorspeicher. Wird dieses Limit überschritten, schlägt die Synchronisation fehl und nichts wird eingespeist. Dieser Speicher ist derzeit Amazon OpenSearch Serverless, sodass S3 Vectors mit dem Crawler keine Option ist.
- Er liefert Seiten, keine sauberen Datensätze. Der Crawler nimmt HTML auf. Navigation, Cookie-Banner und Textbausteine kommen mit dem Inhalt mit, und es gibt keinen strukturierten Extraktionsschritt. Die Chunks tragen das Rauschen in die Embeddings.
Die Konsole kennzeichnet den Web Crawler als Preview auf dem Bildschirm, auf dem man ihn auswählt:
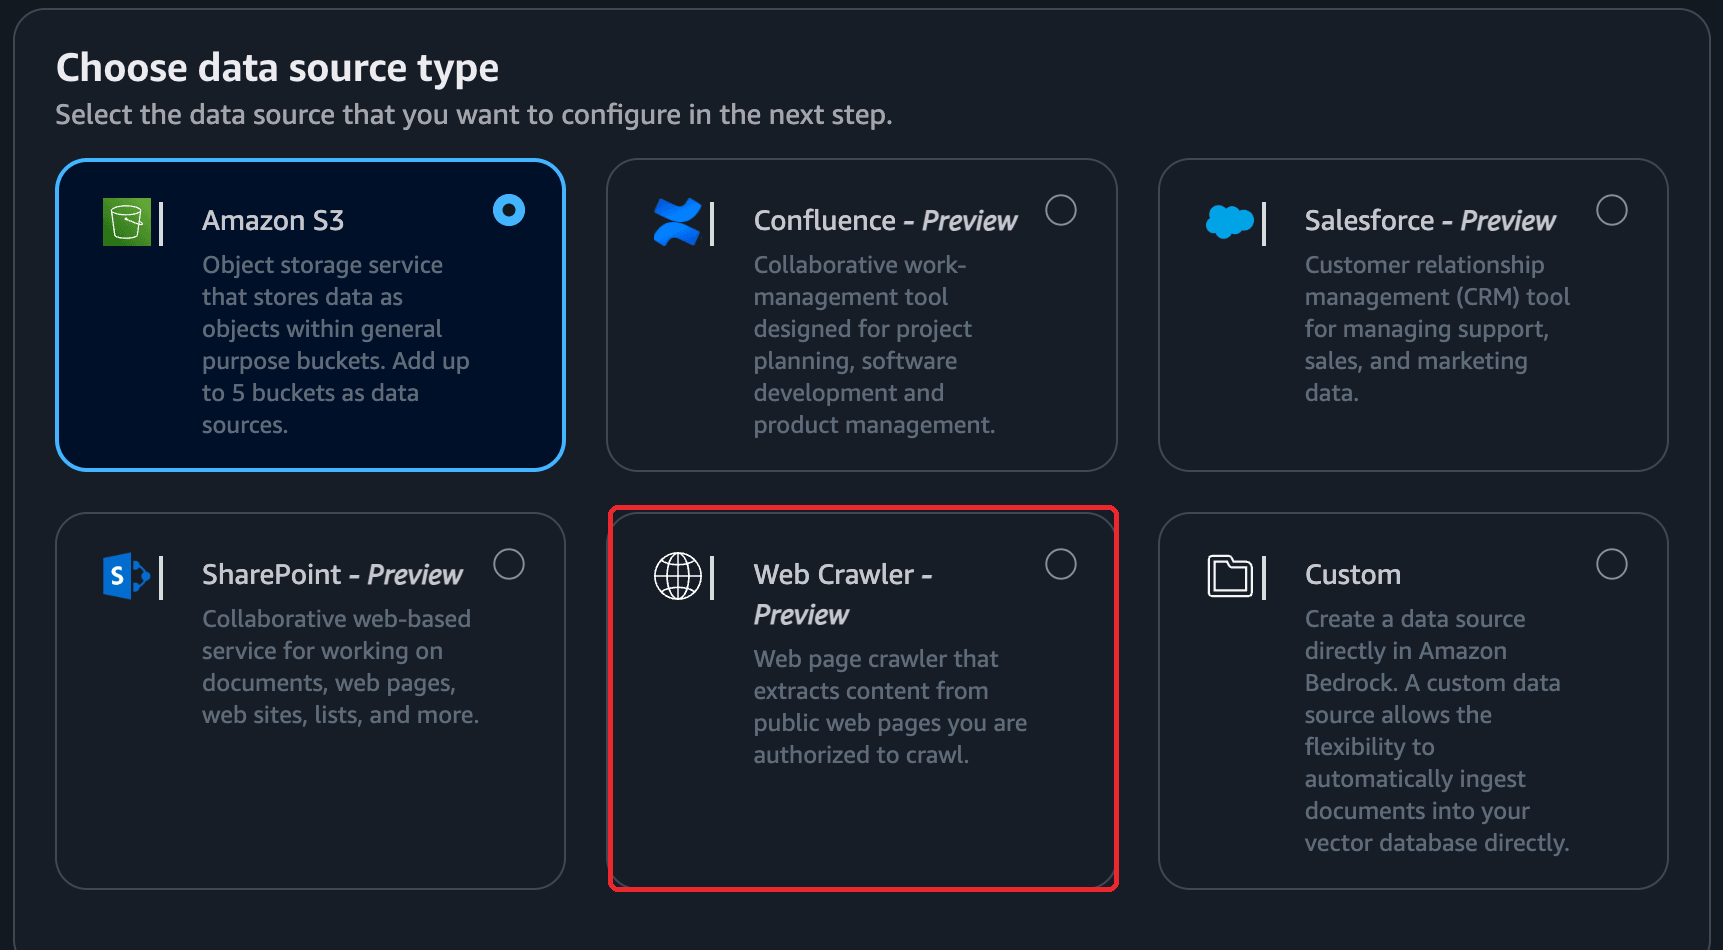
Das macht den Crawler nicht zur falschen Wahl für die statischen, kooperativen Seiten, für die er gebaut wurde. In Bright Datas Daten für KI 2026 Report gaben 90% der KI-Organisationen an, dass Zugriffsbeschränkungen ihre Initiativen einschränken. Cloudflare stufte KI-Crawler neu ein im Juli 2026. Man kündigte an, gemischt genutzte Crawler ab dem 15. September 2026 standardmäßig auf werbefinanzierten Seiten für neue Kunden, neue Websites und unveränderte kostenlose Konten zu blockieren. Den Zugriff funktionsfähig zu halten, erfordert kontinuierlichen Aufwand, und Bright Data übernimmt das.
Die Architektur
Die Pipeline verwandelt eine Liste öffentlicher URLs in eine durchsuchbare, mit Zitaten versehene Knowledge Base und hält sie aktuell. Bright Data übernimmt den Zugriff und die Markdown-Umwandlung. S3 ist die Übergabestelle. Bedrock übernimmt Indexierung und Abruf.
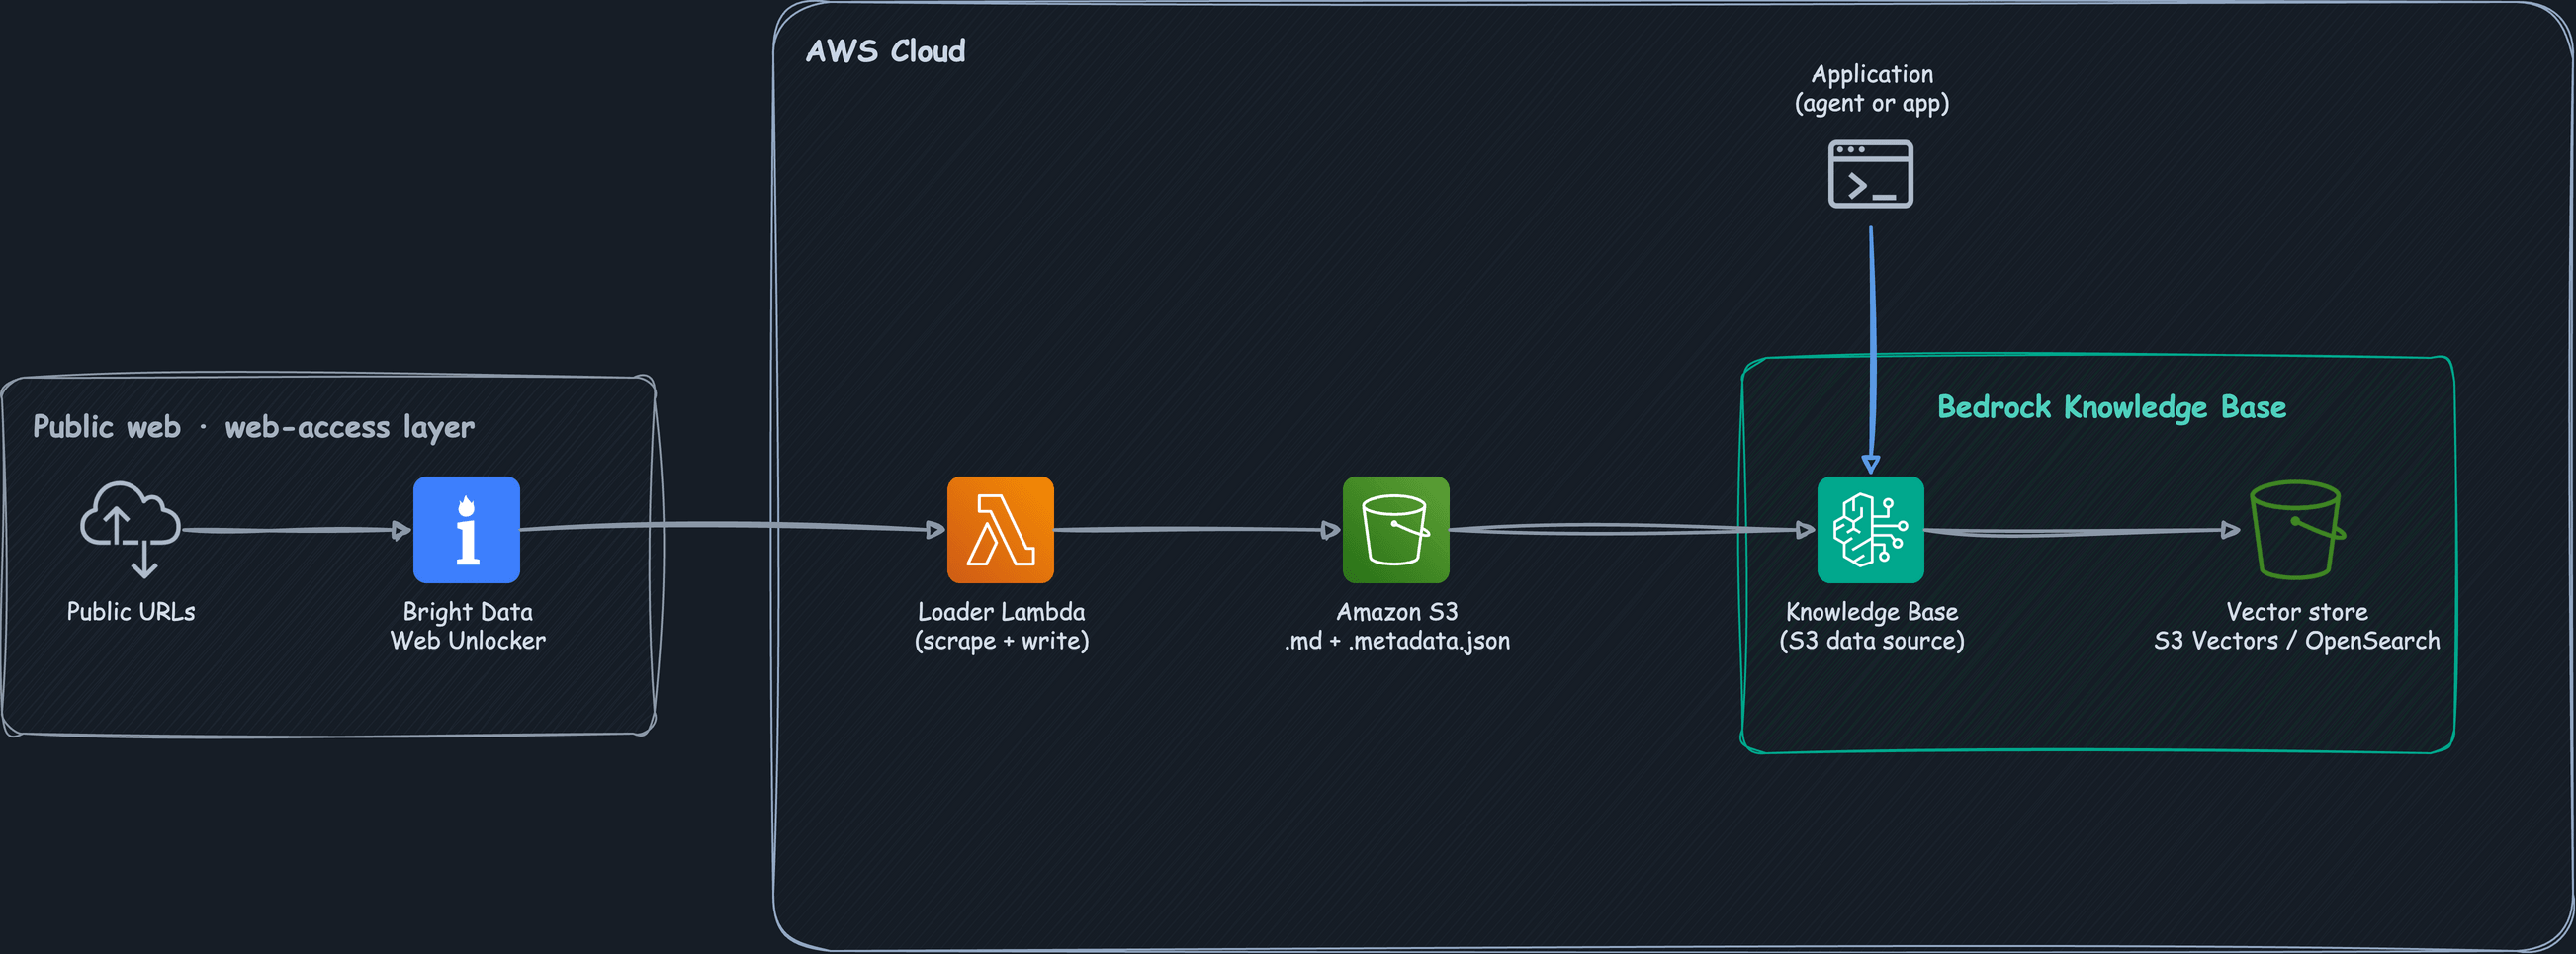
Das Diagramm zeigt den Kernpfad:
- Der Loader ruft Bright Datas Web Unlocker für Bot-Schutz, Geo-Routing und JavaScript-Rendering auf und erhält die Seite als Markdown zurück.
- Der Loader schreibt dann jede Seite als
<slug>.md-Dokument plus eine<slug>.md.metadata.json-Begleitdatei nach Amazon S3. - Die Knowledge Base synchronisiert die S3-Datenquelle mit
StartIngestionJob, und spätere Läufe sind inkrementell. - Bedrock zerlegt jedes Dokument in Chunks, bettet es mit Titan Text Embeddings V2 ein und schreibt die Vektoren in einen Speicher wie Amazon S3 Vectors oder OpenSearch Serverless.
- Eine Anwendung ruft
Retrievefür Roh-Chunks oderRetrieveAndGeneratefür eine fundierte, zitierte Antwort auf.
Drei Teile der Produktionsumgebung liegen außerhalb dieses Kernpfads, und das Diagramm zeigt sie nicht. Ein Amazon-EventBridge-Zeitplan löst den Loader so oft aus, wie man es möchte, AWS Secrets Manager hält das Bright-Data-Token, und die Knowledge Base nimmt eine IAM-Rolle mit minimalen Rechten an. Das Diagramm stellt den Loader als Lambda dar, wo er läuft, sobald man ihn plant. Im Folgenden führt man den Loader auf der eigenen Maschine aus, um jede Phase zunächst zu beobachten.
Das Schreiben nach S3 ist eine Wahl und keine Vorgabe, denn man kann Dokumente auch direkt über eine benutzerdefinierte Datenquelle und die IngestKnowledgeBaseDocuments-API senden. Der Bucket ist die bessere Option für einen gescrapten Korpus. Die Objekte bleiben wiederholbar, die Begleitdateien erlauben die Prüfung des Metadatenvertrags, und ein fehlgeschlagener Lauf lässt den vorherigen Korpus unberührt. Bright Datas Crawl API liefert ebenfalls nativ in denselben Bucket.
Voraussetzungen
- Ein AWS-Konto mit Zugriff auf Amazon Bedrock in einer unterstützten Region, und dort aktiviertem Amazon Titan Text Embeddings V2 (
amazon.titan-embed-text-v2:0). Zusätzlich ein Generierungsmodell in derselben Region, wenn man geschriebene Antworten aus Schritt 5 statt Roh-Chunks möchte. - Ein IAM-Prinzipal, der S3-Buckets, Bedrock-Knowledge-Bases und -Datenquellen, einen Vektorspeicher und die IAM-Servicerolle erstellen kann, die die Knowledge Base annimmt. Das begleitende Repository listet die genauen Richtlinienanweisungen auf.
- Ein Bright-Data-Konto mit einem API-Token und einer Web-Unlocker-Zone. Jede Anfrage referenziert die Zone per Namen. Eine kostenlose Stufe deckt die ersten 5.000 Credits pro Monat ab, genug, um alle folgenden Schritte durchzuarbeiten. Das aktuelle Kontingent und den Tarif auf der Web-Unlocker-Preisseite prüfen, dann ein Ausgabenlimit für die Zone setzen.
- Python 3.10 oder höher mit
boto3undrequests. - Praktische Kenntnisse von Amazon S3 und IAM.
Das Embedding-Modell legt die Vektordimension fest, und der Index des Vektorspeichers muss dazu passen. Erstellt man den Speicher manuell und beide stimmen nicht überein, schlägt die Einspeisung beim Schreiben fehl. Titan Text Embeddings V2 unterstützt 256, 512 oder 1024 Dimensionen.
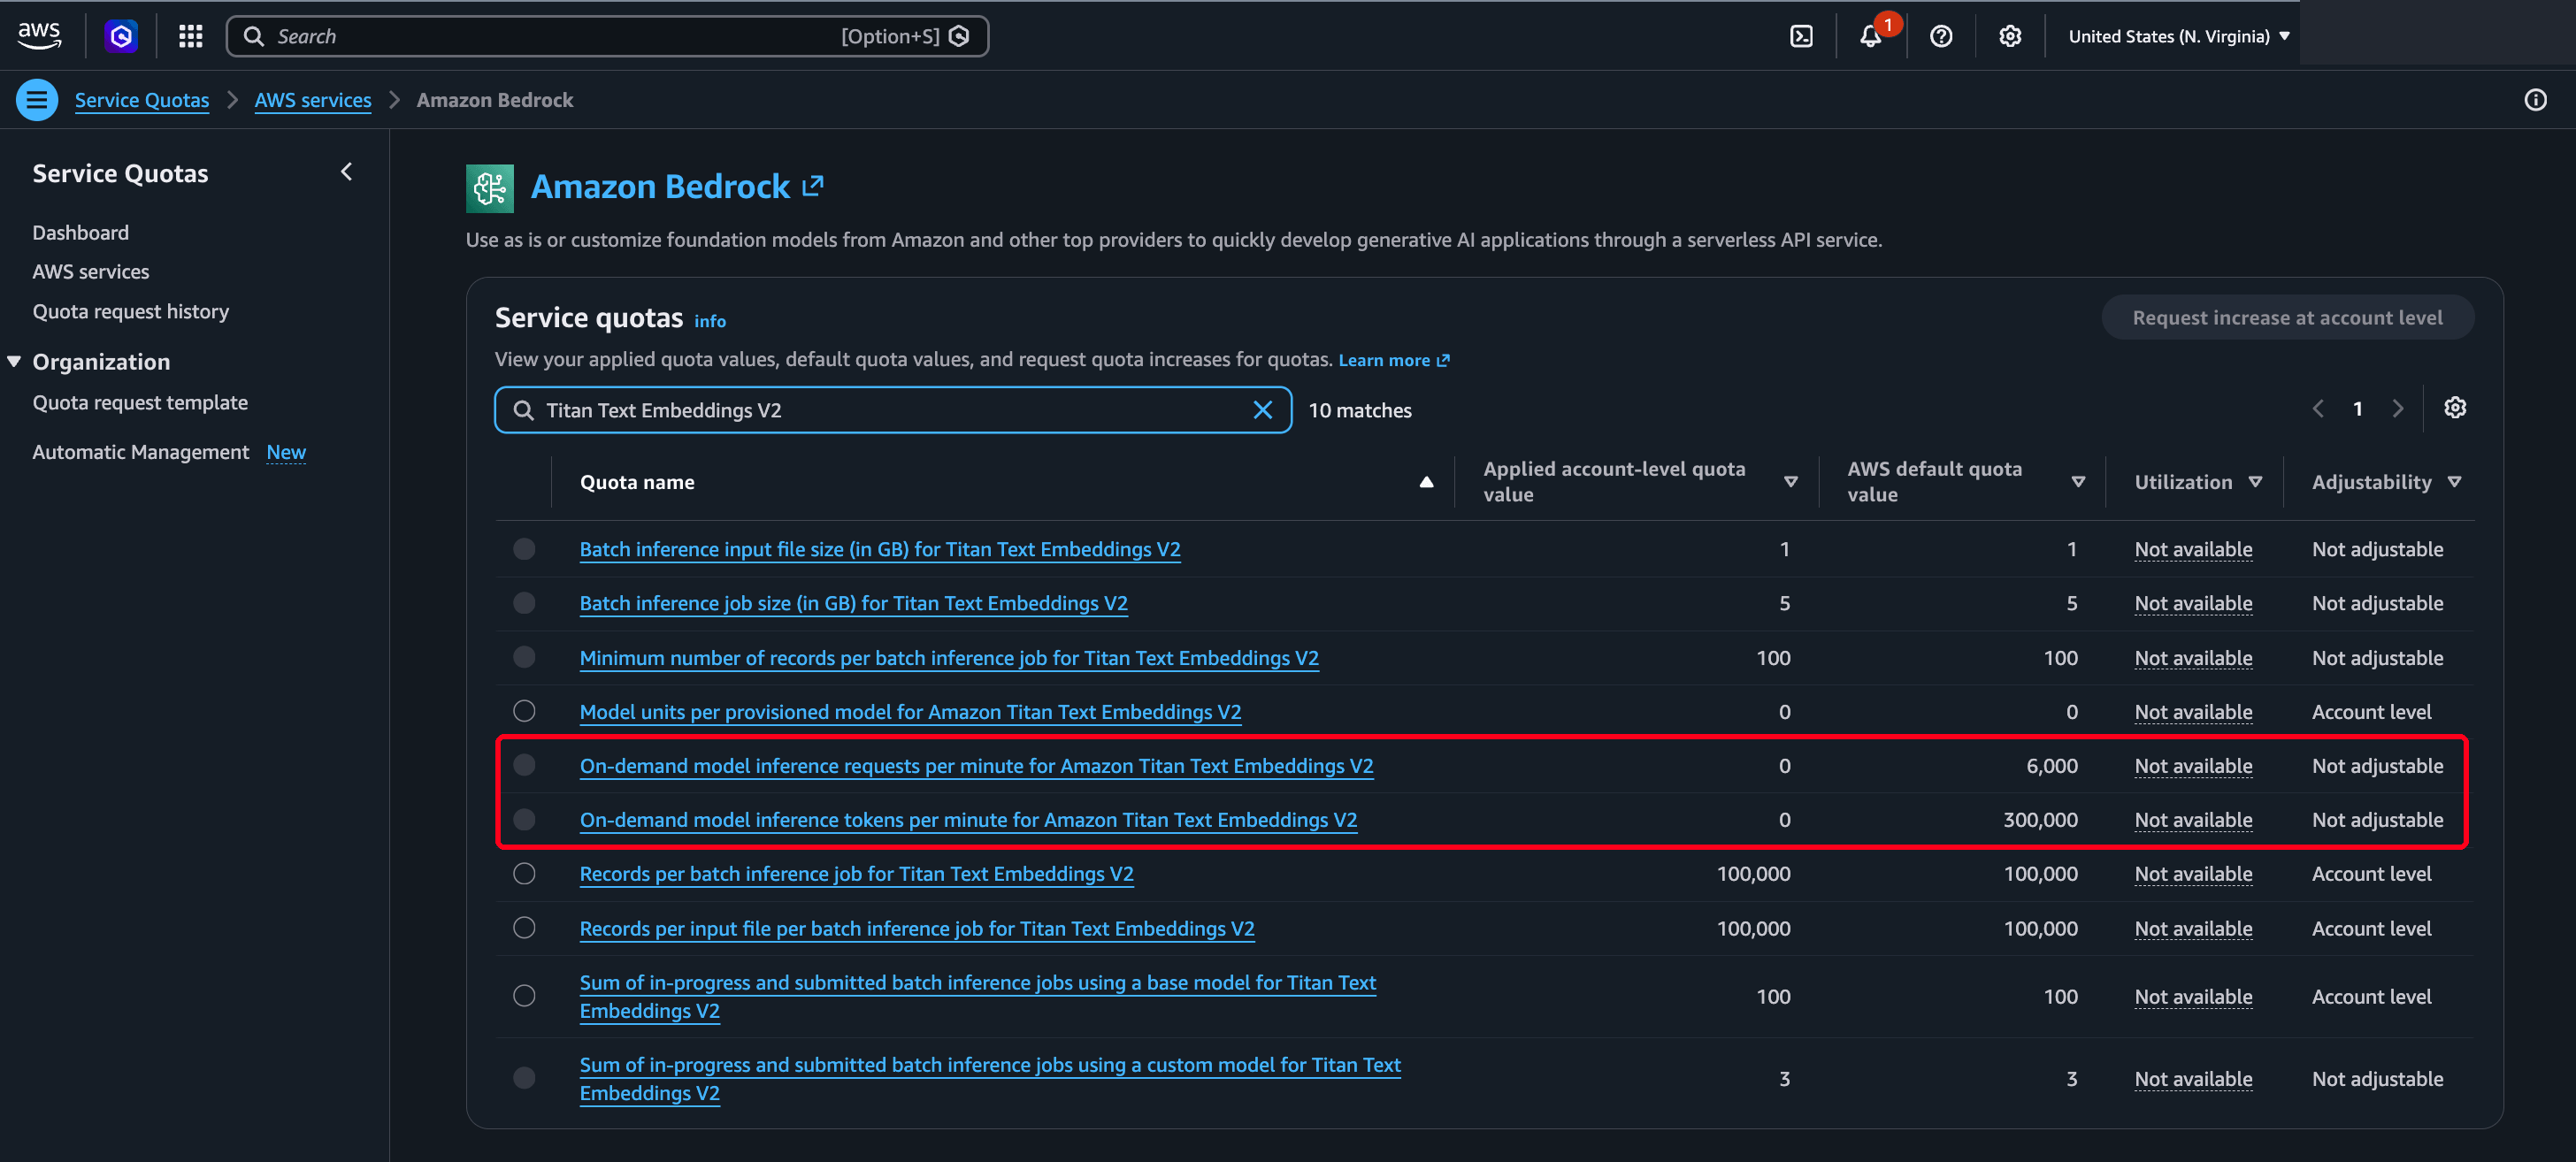
Vor dem Aufbau das Embedding-Kontingent prüfen, denn es kann null sein, ohne dass der Erstellungsablauf davor warnt. Ein neues Konto kann für das Embedding-Modell ein On-Demand-Kontingent von 0 Anfragen pro Minute haben. Dieses Kontingent erlaubt es normal, Knowledge Base und Datenquelle zu erstellen, lässt dann aber jeden Einspeisungsjob fehlschlagen. In einem Aufruf bestätigen und bei Service Quotas eine Erhöhung beantragen, falls null angezeigt wird:
aws service-quotas list-service-quotas --service-code bedrock --region YOUR_REGION \
  --query "Quotas[?contains(QuotaName,'Titan Text Embeddings V2')].[QuotaName,Value]" --output text
Dies gegen die Region ausführen, die man tatsächlich nutzen möchte, denn AWS legt das Kontingent pro Region fest, und der Unterschied kann alles oder nichts bedeuten. In einem Konto hatte Titan Text Embeddings V2 am selben Tag ein angewandtes On-Demand-Kontingent von 0 Anfragen pro Minute und 0 Token pro Minute in US East (Nord-Virginia):
In US East (Ohio) hatte dasselbe Modell 60 Anfragen pro Minute und 300.000 Token pro Minute:
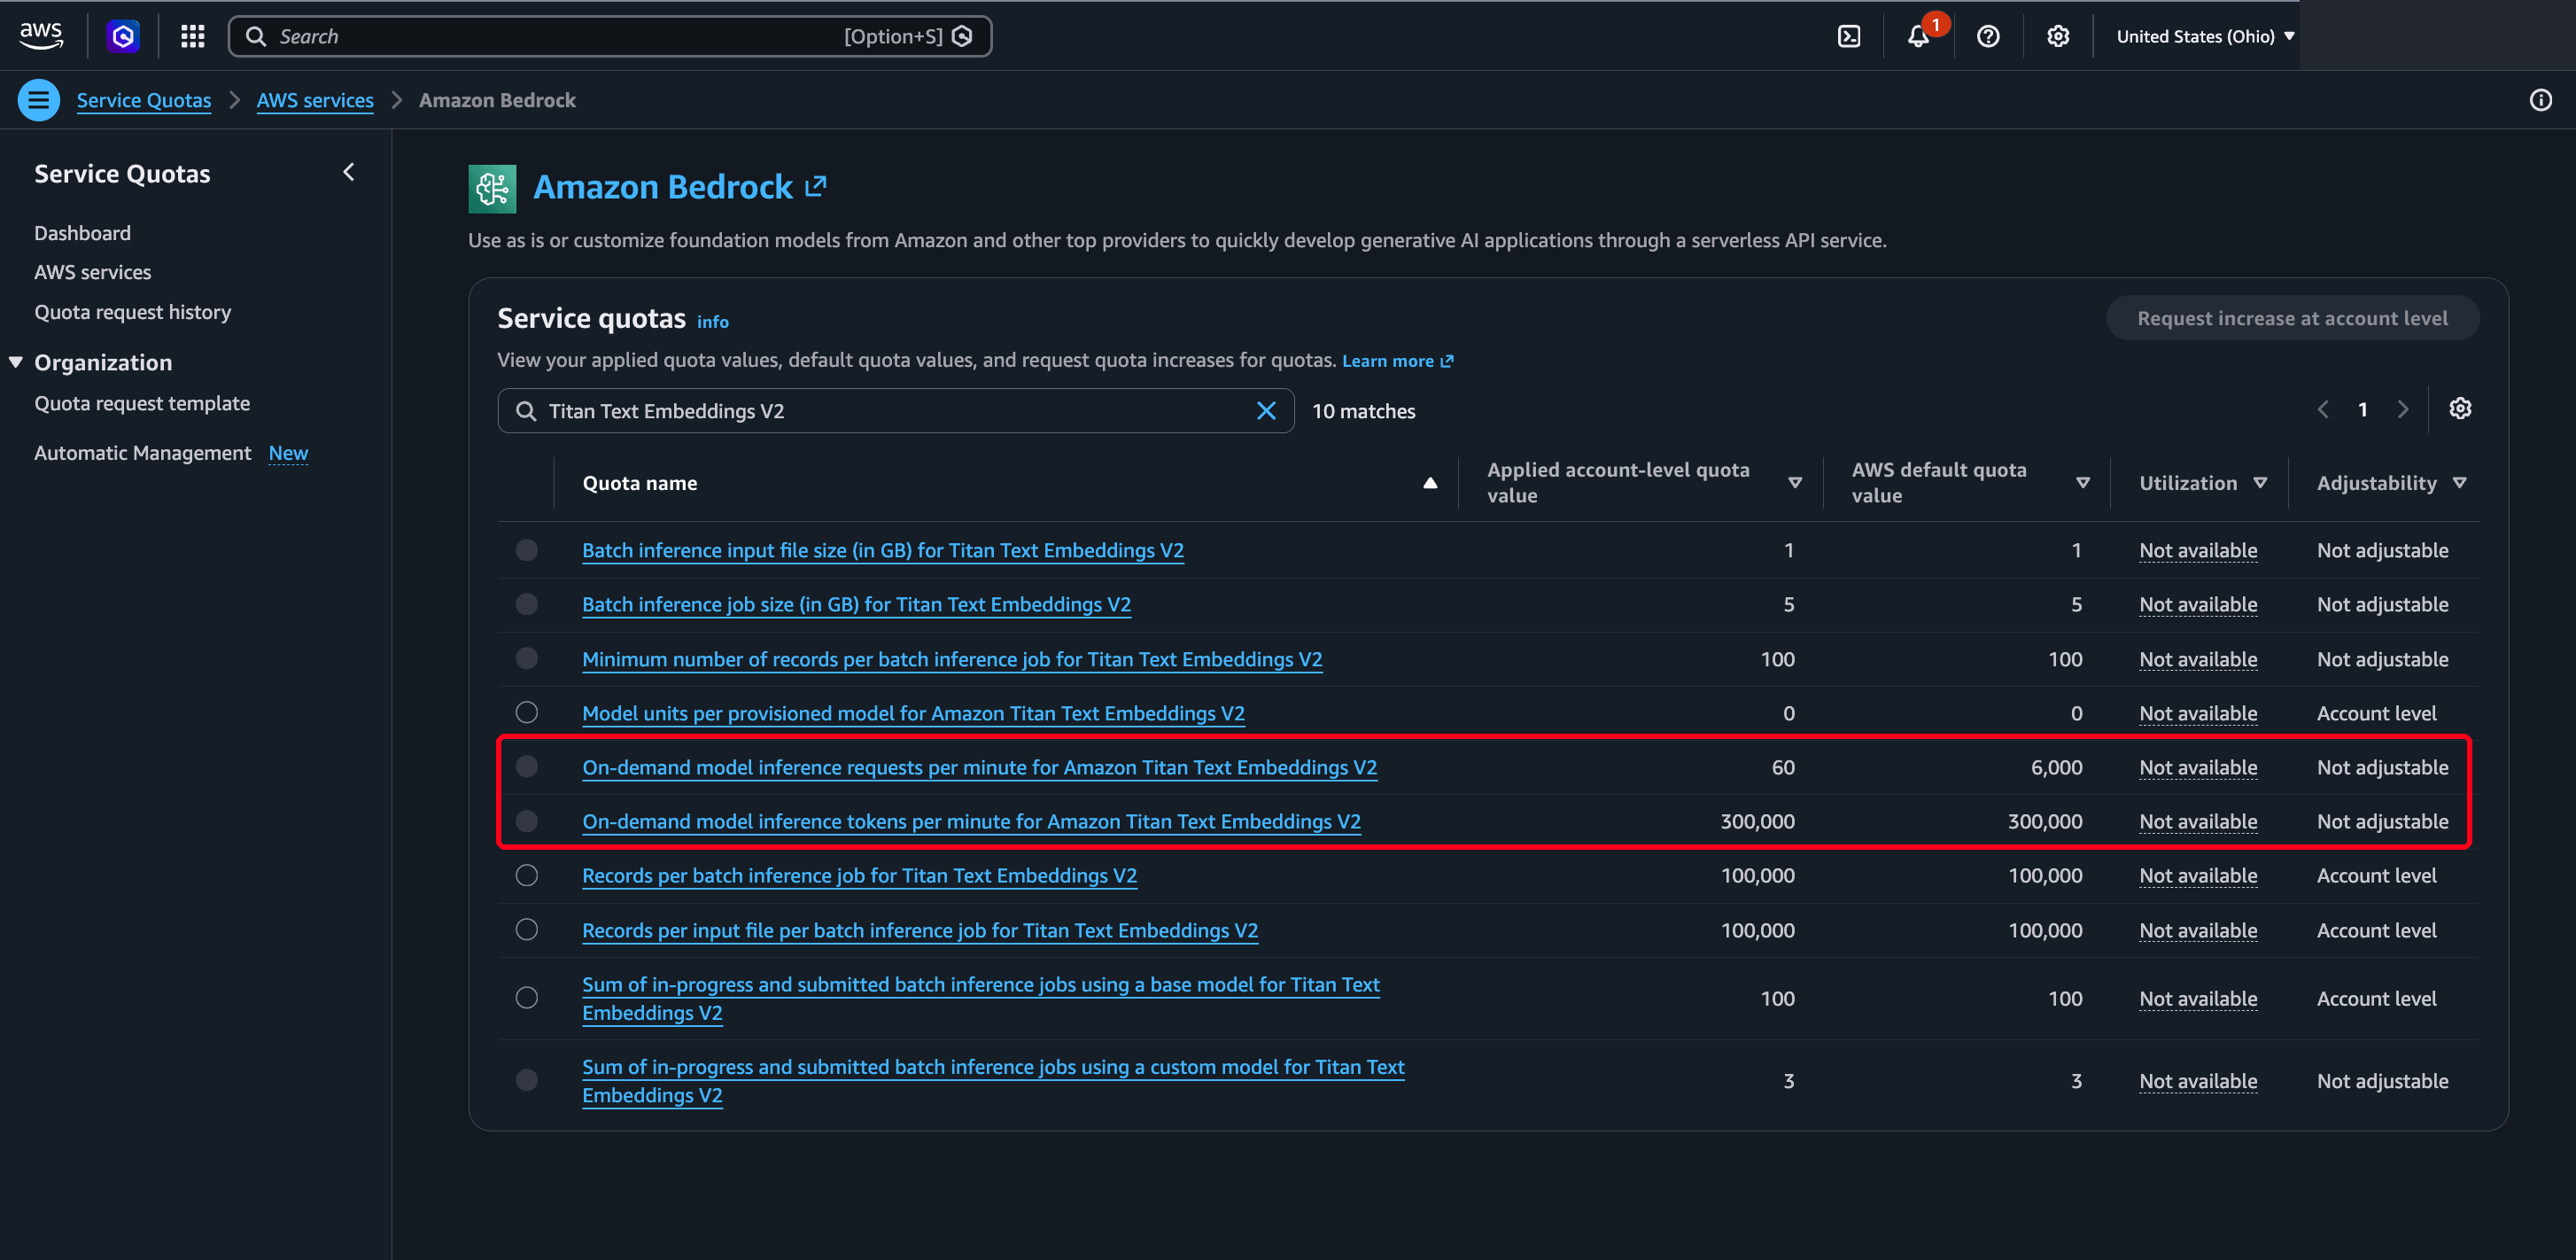
Den angewandten Wert mit dem AWS-Standard in der Service-Quotas-Konsole vergleichen. Ein Kontingent von 60 gegenüber einem Standard von 6.000 bedeutet, dass die funktionierende Region noch bei einem Hundertstel der Standard-Anfragerate läuft. Das Token-Kontingent daneben liegt beim vollen Standard, sodass Anfragen pro Minute das entscheidende Limit ist. Bei etwa 300 Token pro Chunk sind 60 Anfragen pro Minute etwa 18.000 Token pro Minute gegenüber einer Obergrenze von 300.000. Das reicht für einen kleinen Korpus. Für einen großen ist es ein Engpass.
Zwei Fehlermeldungen in dieser Pipeline nennen die falsche Ursache.
AccessDeniedExceptionbeiCreateKnowledgeBase, unter Nennung des Benutzers und der Aktion. Das bedeutet meist einen fehlerhaftenroleArnstatt eines Berechtigungsproblems, also den ARN-String prüfen, bevor man IAM auditiert.not able to call specified bedrock embedding modelwährend der Einspeisung. Das sieht wie ein Berechtigungsfehler aus, und ein Null-Embedding-Kontingent erzeugt es ebenfalls. Das Embedding-Modell direkt als man selbst aufrufen, und wenn das auch gedrosselt wird, liegt ein Kontingentproblem vor.
Beides sind Einrichtungsprobleme, keine Pipeline-Probleme, und keines kehrt zurück, sobald das Konto richtig eingestellt ist.
Schritt 1 – Die Seiten mit Bright Data scrapen
Bright Datas Web Unlocker nimmt eine einzelne URL entgegen und liefert die Seite. Bot-Prüfungen und Proxy-Routing laufen auf seiner Seite ab, und er rendert JavaScript, wenn man diese Option aktiviert. data_format auf markdown setzen, und statt rohem HTML erhält man die Seite als Markdown, die Form, die man für RAG möchte.
Man erstellt die Web-Unlocker-Zone einmal im Bright-Data-Kontrollzentrum, und jede Anfrage referenziert sie per Namen. Die Zone trägt auch die Geolocation-Einstellung. Bei einer Seite, die je nach Land unterschiedliche Inhalte liefert, ruft Web Unlocker vom dort konfigurierten Land ab, nicht von dort, wo der Loader zufällig läuft. Der folgende Code benötigt zwei Dinge aus dem Overview-Tab der Zone: den Zonennamen (hier web_unlocker) und das API-Token.
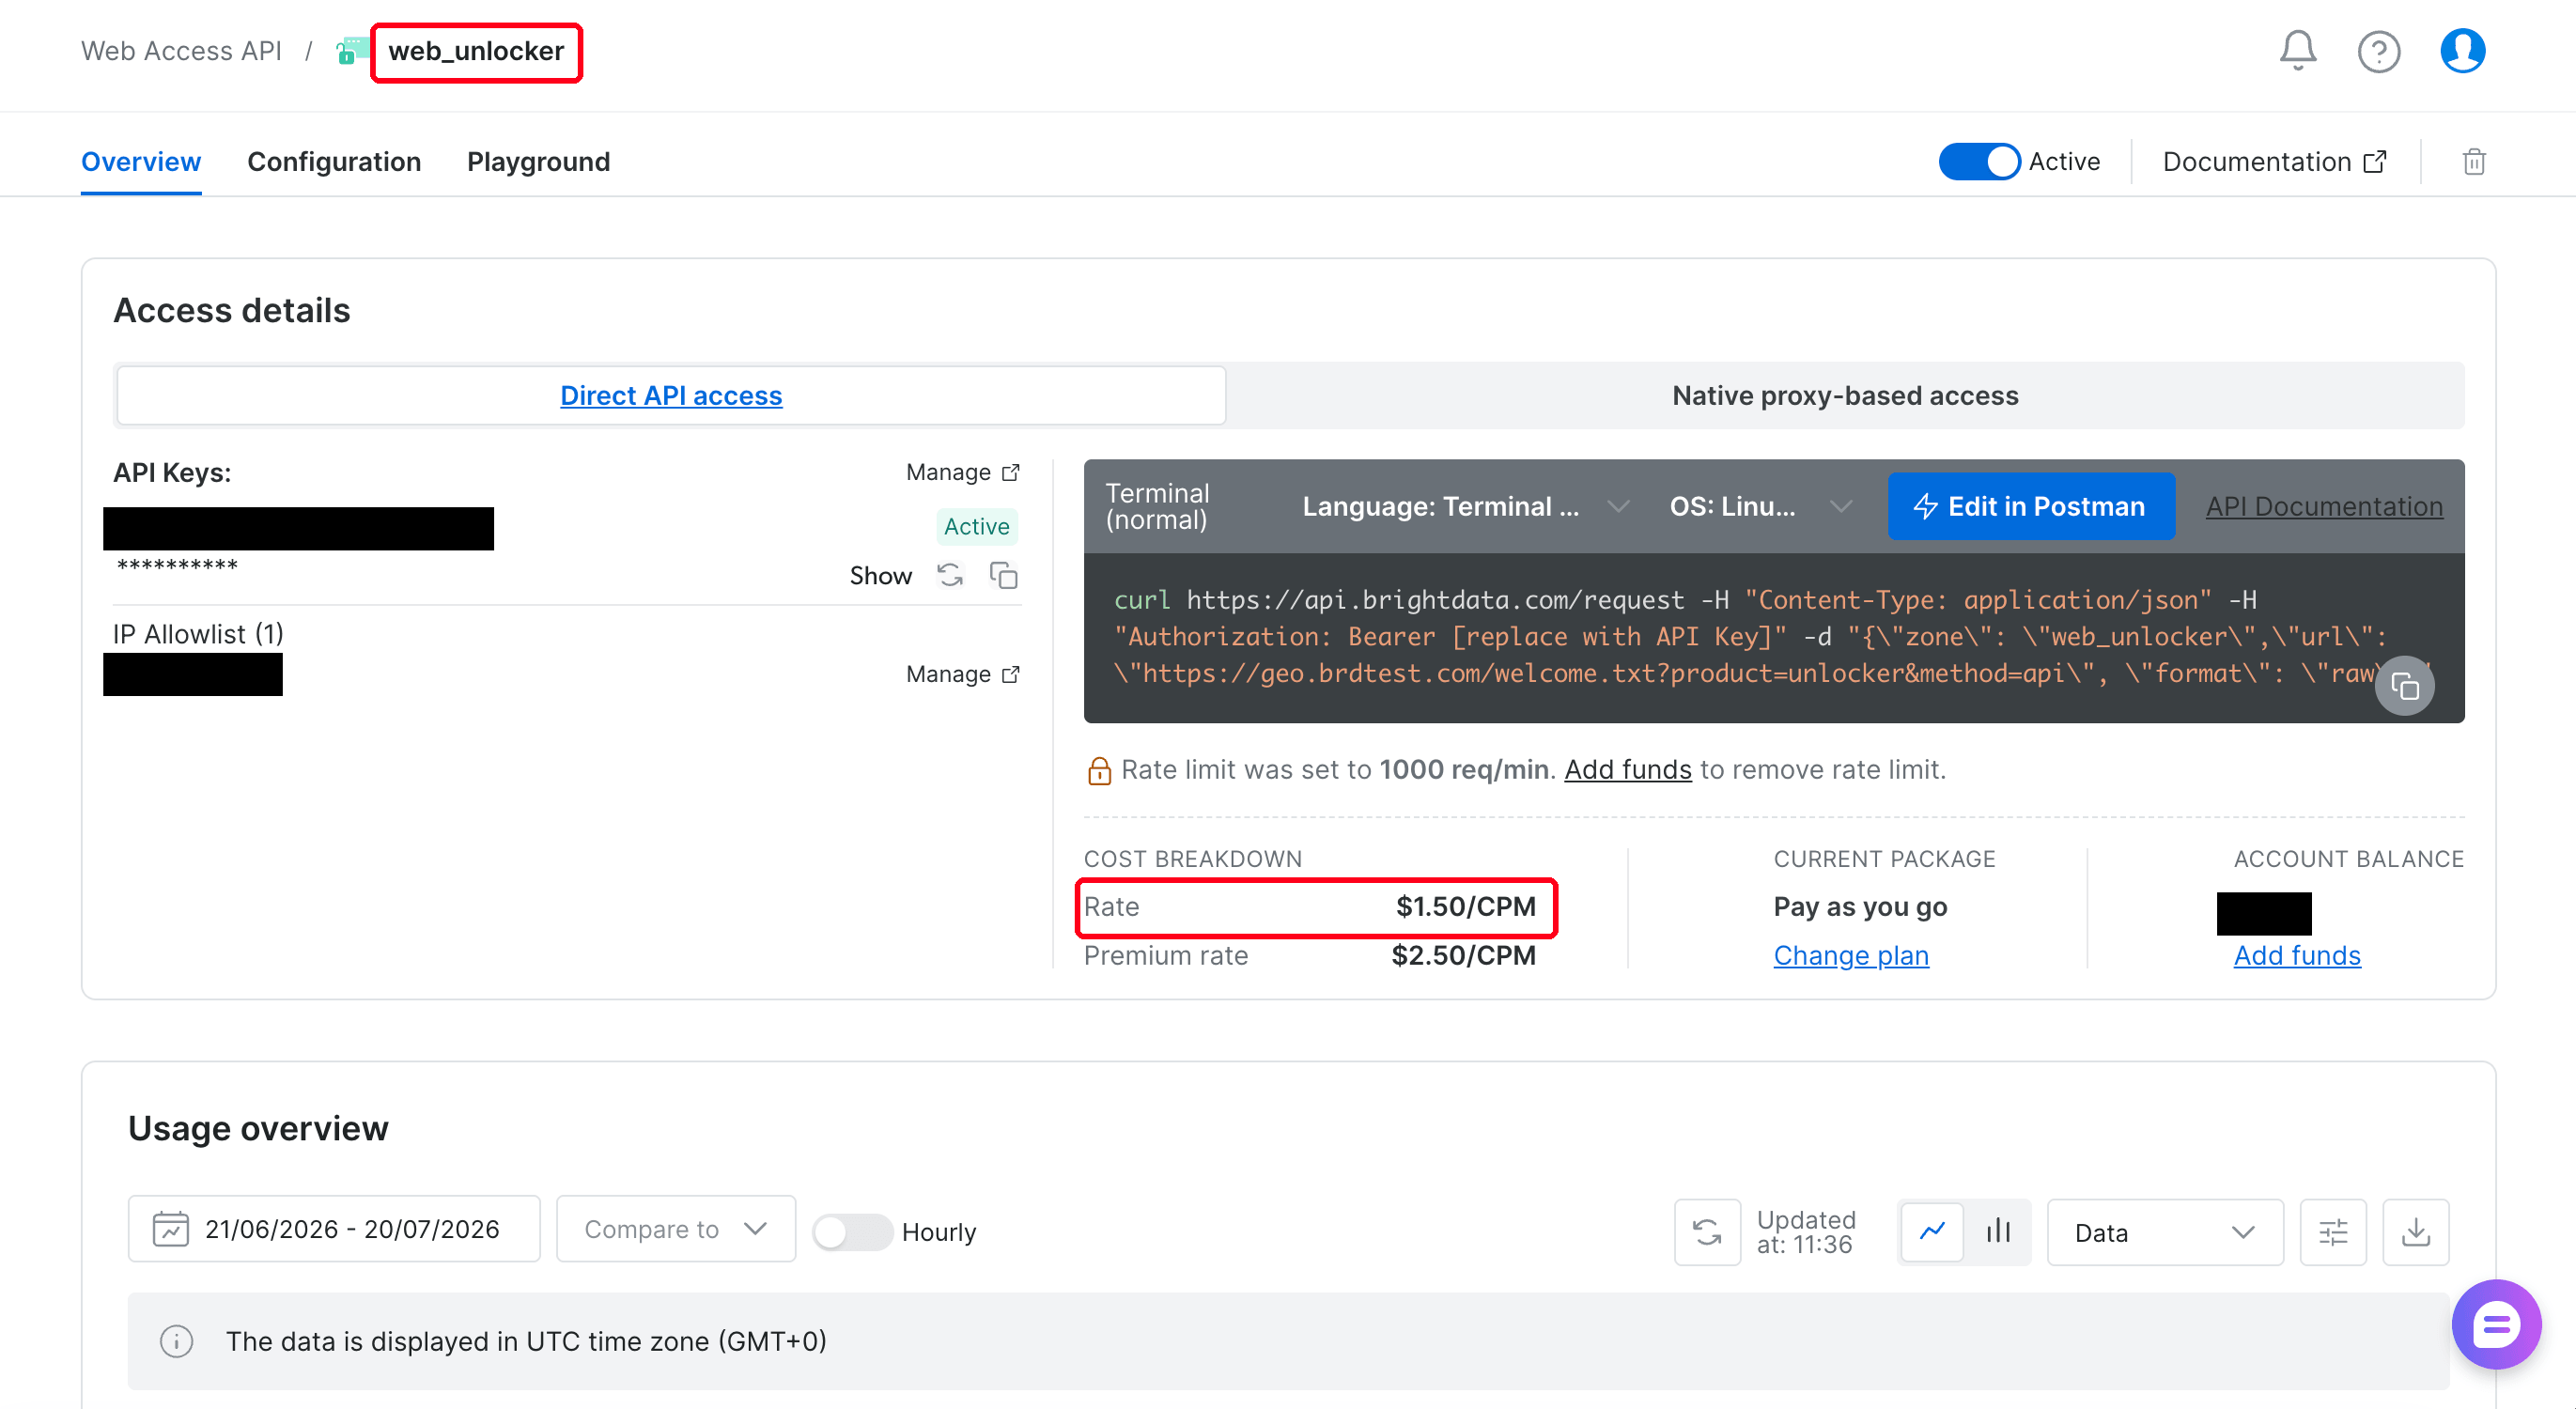
In Python ist dieser Aufruf ein einziges POST mit der Zone, der Ziel-URL und dem gewünschten Ausgabeformat:
import requests

BRIGHTDATA_TOKEN = "..."   # aus dem eigenen Bright-Data-Konto
UNLOCKER_ZONE = "web_unlocker"

def scrape_markdown(url: str) -> str:
    """Eine öffentliche URL per Bright Data Web Unlocker als Markdown abrufen."""
    resp = requests.post(
        "https://api.brightdata.com/request",
        headers={"Authorization": f"Bearer {BRIGHTDATA_TOKEN}"},
        json={
            "zone": UNLOCKER_ZONE,
            "url": url,
            "format": "raw",            # den Antwortkörper direkt zurückgeben
            "data_format": "markdown",  # die Seite in Markdown umwandeln
            # "render": "true" hinzufügen, wenn Inhalt nur nach clientseitigem JS existiert
        },
        timeout=120,
    )
    resp.raise_for_status()
    return resp.text
Es gibt keine Browser-Sitzung zu verwalten, keinen CAPTCHA-Schritt und kein HTML-Parsing.
Ein Fehlschlag hier sieht nicht wie ein Fehlschlag aus. Drei Dinge liefern ein leeres 200 statt eines Fehlers: ein falscher Zonenname, ein widerrufenes Token oder eine IP-Zulassungsliste, die nicht mehr zur aktuellen Adresse passt. raise_for_status akzeptiert das also, und der Loader speichert die Seite als leeres Dokument. Die Länge der Antwort prüfen, nicht nur den Statuscode. Bei einer geplanten Pipeline die Zulassungsliste weglassen und das Token als Anmeldedaten verwenden lassen.
Ein Headless-Browser würde ebenfalls JavaScript rendern, und dieser Teil bleibt gleich. Der Rest ist keine Einstellung, die man einmal konfiguriert. Es ist ein sich ständig ändernder Ablauf: eine passende Exit-IP für dieses Ziel finden, Header anpassen und Fingerprints rotieren, wenn sich die Erkennung ändert. Die Preisgestaltung legt dieses Risiko auf Bright Data, da fehlgeschlagene Anfragen nicht berechnet werden.
Hat man die Seite, muss sie noch strukturiert, geparst und bereinigt werden, da HTML unordentlich ist. Das markdown-Format verlagert diese Arbeit auf die Seite von Bright Data.
Rendering nur aktivieren, wenn die Seite es benötigt
Web Unlocker startet nicht bei jeder Anfrage einen Browser. Er nutzt den schnellen Pfad für eine Seite, die ohne JavaScript-Ausführung abgerufen werden kann. Für Inhalte, die erst nach clientseitigem Rendering existieren, render auf "true" setzen.
Die Übungsseite quotes.toscrape.com/js injiziert ihren Inhalt per JavaScript. Ein einfaches GET lieferte 96 Zeichen indexierbaren Text und keines der Zitate, der schnelle Pfad lieferte eine 191 Zeichen lange Hülle, und nur die gerenderte Anfrage lieferte alle 1.583 Zeichen. Auf dieser Seite war die gerenderte Anfrage in 7,7 Sekunden fertig, gegenüber 17,1 Sekunden auf dem schnellen Pfad. Das ist eine Stichprobe von eins auf jedem Pfad, also Rendering als Korrektheitsschalter behandeln statt als Latenzstrafe, und die eigenen Ziele messen.
Das 8_render_check.py des Repositories führt diese dreifache Prüfung gegen jede URL aus, also ist es das Erste, was man versucht, wenn ein Scrape verdächtig dünn aussieht. Es benötigt nur ein Bright-Data-Token und sonst nichts. Man kann es auf eigene URLs richten und sehen, was jeder Pfad liefert, bevor man eine einzige AWS-Ressource erstellt. Fehlt der Inhalt auch mit aktiviertem Rendering, braucht die Seite vermutlich Interaktion, was die Browser API abdeckt und Web Unlocker nicht. Das Skript beendet sich auf dieser Seite nicht-null, wenn man --probe übergibt:

Die unten gescrapten Seiten sind serverseitig gerendert, also lässt der Standardlauf render aus.
Eine Liste scrapen, nicht eine Seite
Web Unlocker ist eine Anfrage pro URL, also hält ein kleiner Thread-Pool den Durchsatz hoch, ohne ein schweres Framework zu benötigen:
from concurrent.futures import ThreadPoolExecutor

def scrape_many(urls: list[str], workers: int = 8) -> dict[str, str]:
    """Einen Stapel URLs scrapen. {url: markdown} für die erfolgreichen zurückgeben."""
    out: dict[str, str] = {}
    with ThreadPoolExecutor(max_workers=workers) as pool:
        for url, md in zip(urls, pool.map(_safe_scrape, urls)):
            if md:
                out[url] = md
    return out

def _safe_scrape(url: str) -> str | None:
    try:
        return scrape_markdown(url)
    except requests.RequestException:
        return None   # eine fehlschlagende Seite wird übersprungen, nicht als fatal behandelt
Eine fehlgeschlagene Seite liefert None und verlässt den Stapel, statt den Lauf zu stoppen. Der Loader im Repository ist strenger als dieser Ausschnitt. Er versucht es zweimal erneut, mit einer Rückwartezeit von 1 dann 2 Sekunden. Er behandelt zudem einen leeren oder HTML-Körper als Fehlschlag, nicht als Inhalt. Das bedeutet, eine Seite, deren Abruf fehlschlug, behält ihre vorherige Version im Korpus, und nichts in einer späteren Antwort markiert sie als veraltet. Abruffehler als Signal behandeln, auf das man reagiert, nicht als Zeile in einem Log.
Web Unlocker holte 6 Dokumentationsseiten ab. Jede Anfrage dauerte zwischen 24,6 und 36,7 Sekunden, mit einem Median von 30,6 Sekunden. Jeder nummerierte Schritt hier wurde live an diesem einen 6-seitigen Korpus an einem einzigen Tag ausgeführt. Diese Seiten sind kooperativ, also messen die Zeiten die Pipeline selbst statt die Verteidigung eines Ziels. Eine Seite zu entsperren ist kein statischer Abruf, was die Zeit erklärt, und Nebenläufigkeit macht das machbar. Dieselben 6 Seiten dauerten 43,1 Sekunden Gesamtzeit bei 6 Workern, gegenüber den etwa 3 Minuten, die ein serieller Lauf benötigen würde.
Die Worker-Anzahl trotzdem niedrig halten, da der Pool auf eine Site zielt. Bright Data begrenzte die obige Zone auf 1.000 Anfragen pro Minute, bis Guthaben hinzugefügt wird. Bei einem Median von 30 Sekunden ist das weit mehr Spielraum, als eine Handvoll Worker nutzen wird. Die Obergrenze der eigenen Zone prüfen und die Latenz an eigenen Zielen bestätigen, bevor man die Liste skaliert.
Das eigene Markdown-Pendant der Site bevorzugen
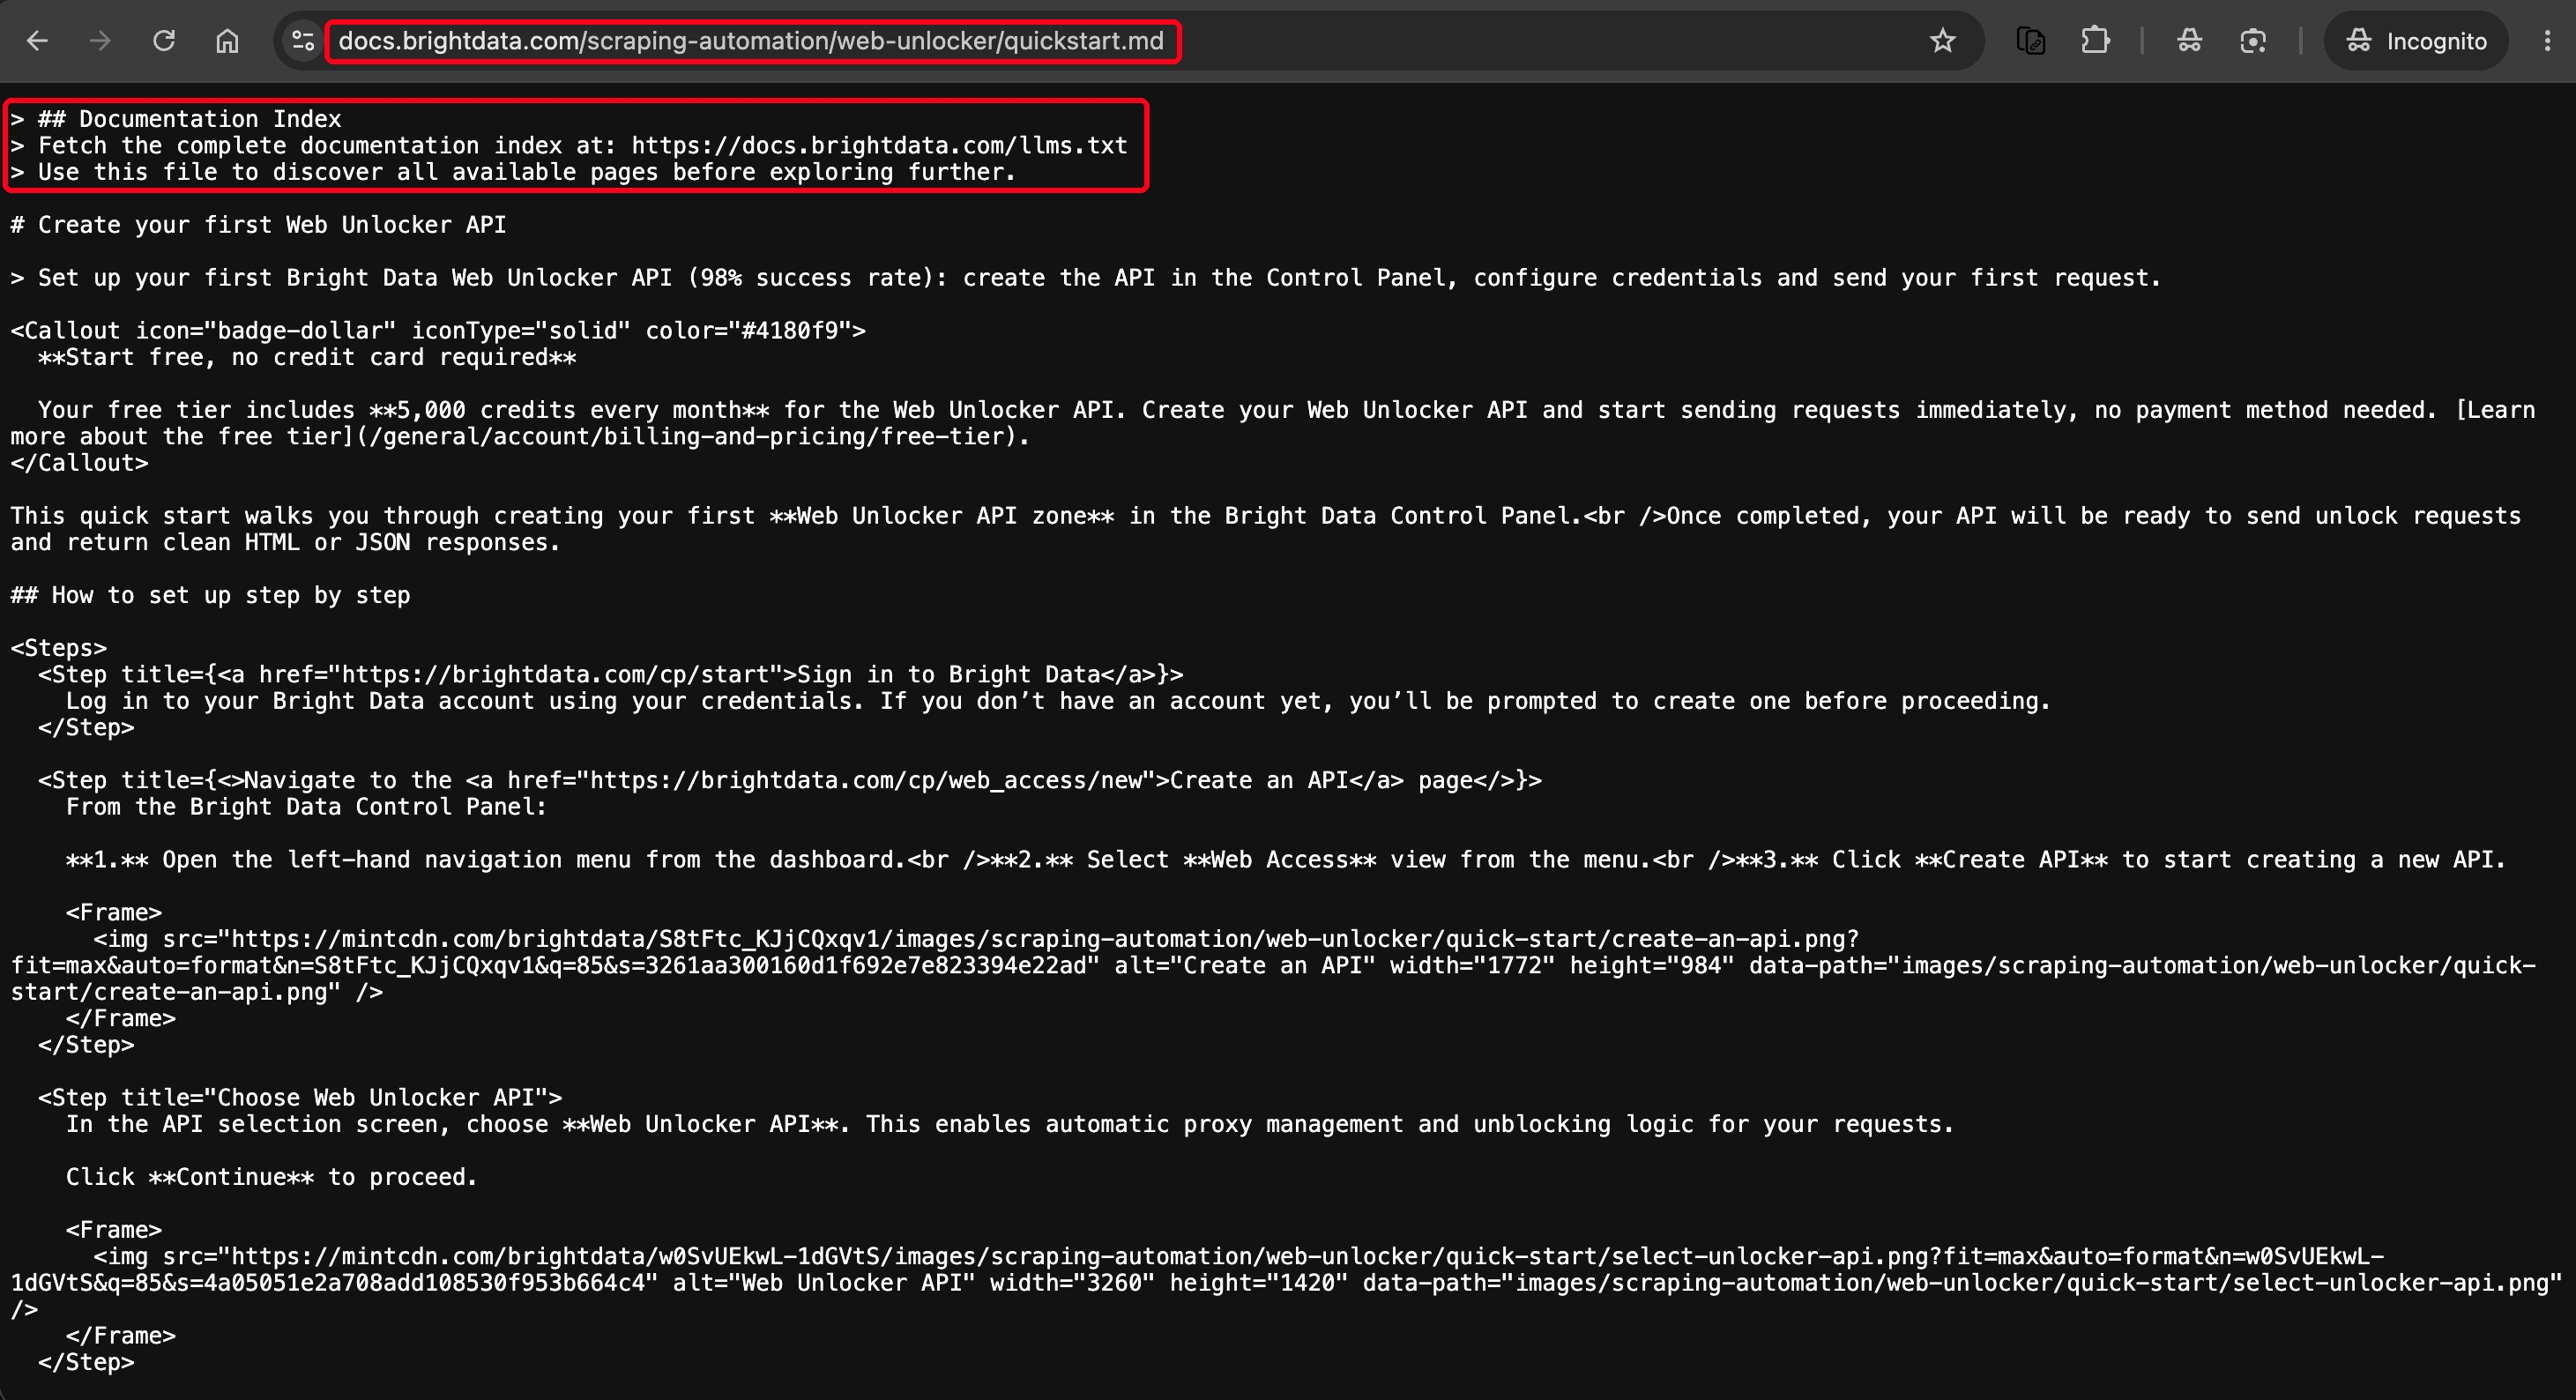
Bevor man eine Site überhaupt scrapt, prüfen, ob sie bereits veröffentlicht, was man gerade rekonstruieren will. Viele Dokumentationsplattformen liefern ein LLM-fertiges Markdown-Pendant jeder Seite, meist als <page-url>.md, und listen die Pendants in einem /llms.txt-Index auf. Bright Datas eigene Dokumentation veröffentlicht Pendants und indexiert sie unter docs.brightdata.com/llms.txt, sodass alle 6 obigen Seiten ein Pendant hatten. Diese Pendants sind kostenlos, und ein einziges GET liefert sie statt eines 30,6-sekündigen Scrapes. Sie tragen nichts von der Navigation, die der Scrape aufnimmt.
Sie sind keine reine Prosa. Das Pendant unten trägt noch die eigenen Komponenten-Tags der Plattform und vollständige Bild-URLs, sodass man Site-Chrome gegen Markup eintauscht, das zeilenbasiertes Entfernen nicht erfasst:
Außerhalb von Entwickler-Dokumentationsplattformen ist ein Markdown-Pendant selten, und dort übernimmt Web Unlocker die Arbeit. Das macht den Abruf zu einer zweistufigen Entscheidung:
def fetch_page(url: str) -> str:
    """Das eigene Markdown-Pendant der Site bevorzugen. Nur scrapen, wenn keines existiert."""
    return native_markdown(url) or scrape_markdown(url)
native_markdown ist der src/web_kb/clean.py-Helfer des Repositories, ein GET von <page-url>.md, der None zurückgibt, wenn die Seite kein Pendant hat. Er entfernt das Komponenten-Markup nicht, und das Chrome-Entfernen in Schritt 2 auch nicht. Ein pendant-lastiger Korpus braucht einen eigenen tag-bewussten Durchgang.
Muss man doch scrapen, liefert Web Unlocker die Seite, statt zu entscheiden, welche Teile davon der Hauptinhalt sind. Über 6 Seiten einer Live-Dokumentations-Site trug das Markdown noch Site-Chrome: die Logo-Leiste, einen “Skip to main content”-Link, das Suchfeld, den vollständigen Seitenleisten-Navigationsbaum und eine “War diese Seite hilfreich”-Fußzeile. Dieses Chrome machte etwa 43% der Zeichen aus. Schritt 2 behandelt das Entfernen sich wiederholender Inhalte.
Schritt 2 – Saubere Dokumente und Metadaten nach S3 schreiben
Bedrock liest jede unterstützte Datei unter dem angegebenen Präfix. Jede wird zu einem Dokument von bis zu 50 MB, mit einer optionalen Begleitdatei für Metadaten daneben. Man schreibt beides.
Zuerst das Chrome entfernen
Ein Navigationsblock ist auf fast jeder Seite einer Site nahezu identisch, sodass ein Korpus mit 50 Seiten denselben Block 50-mal einbettet. Man zahlt für die Einbettung, man zahlt für die Speicherung, und zur Abfragezeit konkurrieren diese 50 nahezu identischen Chunks mit dem angeforderten Inhalt. Die Deduplizierung später in diesem Schritt kann das nicht erfassen, weil die Seiten keine Duplikate sind. Nur ihr Chrome wiederholt sich.
Man braucht keine site-spezifischen Regeln, um es zu entfernen, denn das meiste Chrome ist sich wiederholender Text. Zählen, wie oft jede Zeile über den Stapel hinweg erscheint, und die weglassen, die auf den meisten Seiten vorkommen:
from collections import Counter

KEEP = {"", "-" * 3, "`" * 3}          # Leerzeilen, bloße Linien und bloße Zäune sind nie Chrome

def strip_repeated(pages: dict[str, str], threshold: float = 0.6) -> dict[str, str]:
    """Zeilen entfernen, die sich auf den meisten Seiten des Stapels wiederholen. Das ist das Chrome."""
    counts = Counter()
    for markdown in pages.values():
        for line in {ln.strip() for ln in markdown.splitlines()}:
            if line not in KEEP and len(line) >= 2:   # >= 2, damit der ⌘K-Hinweis zählt
                counts[line] += 1

    cutoff = max(2, int(len(pages) * threshold))
    boilerplate = {line for line, n in counts.items() if n >= cutoff}
    return {url: "\n".join(ln for ln in md.splitlines() if ln.strip() not in boilerplate)
            for url, md in pages.items()}
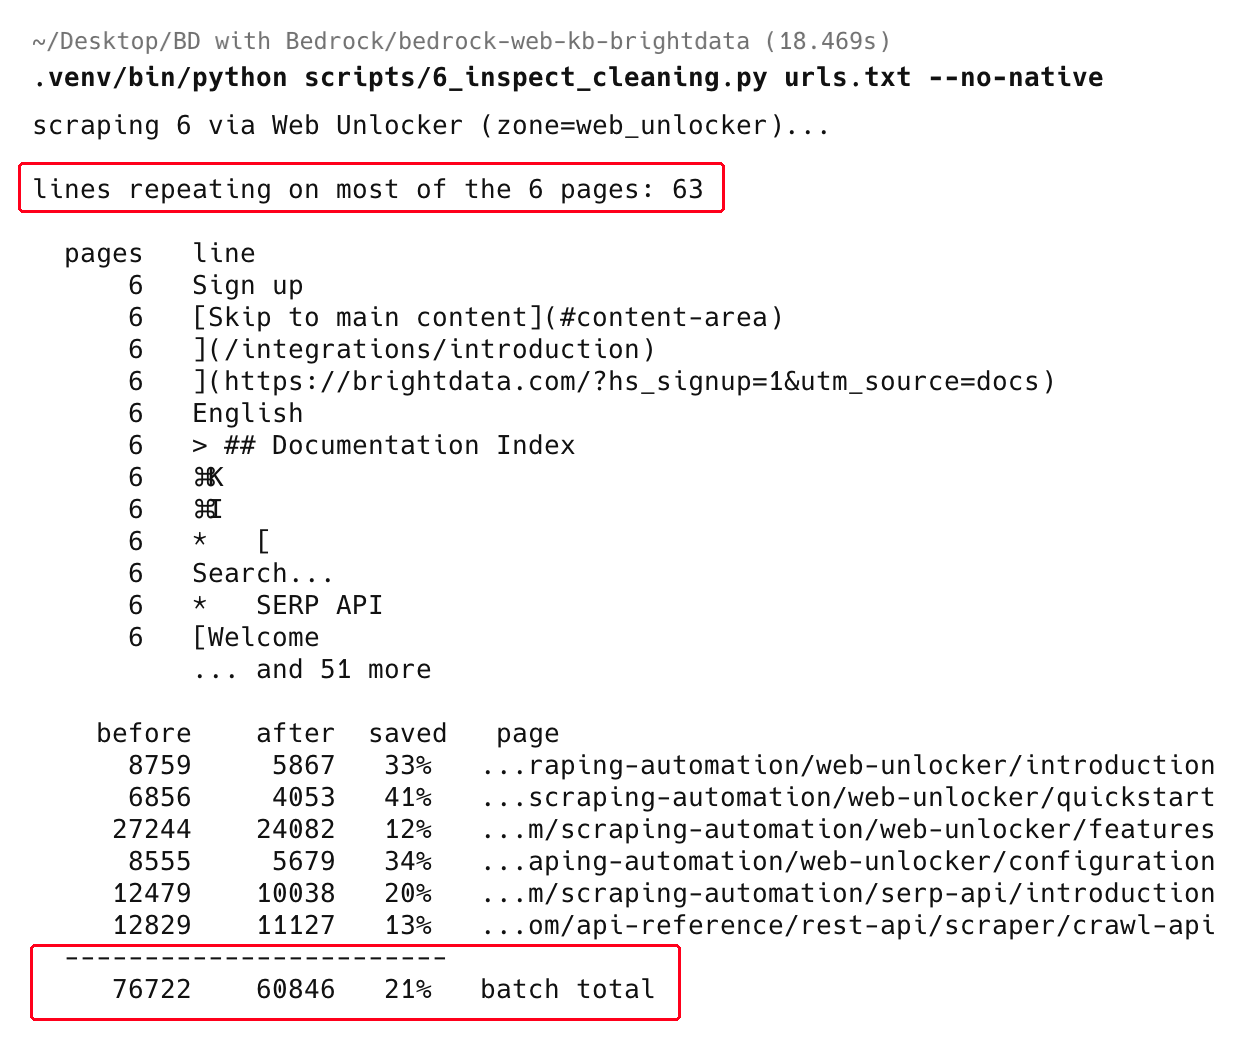
An der Stichprobe mit 6 Seiten brachte das den Stapel von 76.722 auf 60.846 Zeichen, eine Kürzung um 21%. Das ist etwa die Hälfte des in Schritt 1 gemessenen Chromes. Die Regel greift nur bei Zeilen, die über Seiten hinweg identisch sind, aber manche Sites formulieren ihre Navigation auf jeder Seite etwas anders. Zeilen, die sich über den Großteil des Stapels wiederholten, gingen von 63 auf 0. Jede dieser Zeilen hätte zu einem doppelten Chunk werden können. Alle 6 Seiten zeigten das Suchfeld, den ⌘K-Shortcut-Hinweis, den Sprachumschalter und jeden Seitenleisten-Navigationslink.
Die Einsparungen sind ungleichmäßig, da Chrome ein fixer Aufwand pro Seite ist. In diesem Lauf entfernte es 41% der kürzesten Seite und 12% der längsten. Ein Korpus vieler kurzer Seiten würde sonst am meisten für das Einbetten von Navigation zahlen.
Die Technik ist eine Heuristik, kein Parser, also vor dem Vertrauen auf einer neuen Site prüfen. Bei einem code-lastigen Korpus auch die sprachmarkierten Zäune zu KEEP hinzufügen, da KEEP nur die bloßen schützt, und das Entfernen eines gemeinsamen öffnenden Zauns dessen schließenden Zaun verwaist zurücklässt.
Das 6_inspect_cleaning.py des Repositories listet jede Zeile auf, die es entfernen würde, und --verify bewertet, was gegen das eigene Markdown-Pendant einer Seite überlebt hat. Bei diesem Korpus ging kein seitenspezifischer Inhalt durch das Entfernen verloren. Diesem Vergleich nach war die einzige fehlende Zeile pro Seite dieselbe llms.txt-Textbausteinzeile. Für rohes HTML statt Markdown einen dedizierten Extraktor wie Trafilatura verwenden.
Alle 6 dieser Seiten veröffentlichen ein Markdown-Pendant, also nutzt der Standardlauf sie jedes Mal. Die obigen Scrape- und Chrome-Zahlen stammen vom Erzwingen des Web-Unlocker-Pfads mit --no-native.
Das Dokument und seine Begleitdatei schreiben
Bedrock paart ein Dokument allein über den Dateinamen mit seinen Metadaten. Für ein Dokument quickstart-3f9a2c1b04.md ist die Metadatendatei quickstart-3f9a2c1b04.md.metadata.json. Darin hat jedes Attribut einen typisierten Wert und ein includeForEmbedding-Flag. Dieses Flag steuert, ob Bedrock den Wert dem eingebetteten Text hinzufügt. Der Loader schreibt die Begleitdatei, dann das Dokument, versehen mit dem Inhalts-Hash, der dem nächsten Lauf erlaubt, beide zu überspringen:
import boto3, json, hashlib, re
from datetime import datetime, timezone

REGION = "us-east-2"                    # eine Region mit nicht-null Embedding-Kontingent
s3 = boto3.client("s3", region_name=REGION)
BUCKET = "web-kb-corpus-111122223333"   # eigener Bucket
PREFIX = "docs"

def slugify(url: str) -> str:
    """Stabiler, sicherer Objektschlüssel, abgeleitet von der URL."""
    digest = hashlib.sha1(url.encode()).hexdigest()[:10]
    tail = url.rstrip("/").split("/")[-1][:40] or "page"
    safe = "".join(c if c.isalnum() or c in "-_" else "-" for c in tail)
    return f"{safe}-{digest}"

def content_hash(markdown: str) -> str:
    """Den bedeutungsvollen Text hashen. Whitespace zu normalisieren verhindert, dass
    unterschiedliche Zeilenumbrüche wie eine Inhaltsänderung aussehen."""
    return hashlib.sha256(re.sub(r"\s+", " ", markdown).strip().encode()).hexdigest()

def stored_hash(key: str) -> str | None:
    """Der im letzten Lauf am Objekt gespeicherte Hash, oder None, wenn das Objekt nicht vorhanden ist.

    Nur ein fehlendes Objekt zählt als nicht vorhanden. Jeden ClientError abzufangen würde
    AccessDenied oder Drosselung als neue Seite melden, sie neu schreiben und den Korpus neu einbetten."""
    try:
        return s3.head_object(Bucket=BUCKET, Key=key)["Metadata"].get("content-hash")
    except s3.exceptions.ClientError as exc:
        if exc.response["Error"]["Code"] in ("404", "NoSuchKey", "NotFound"):
            return None
        raise

def put_document(url: str, markdown: str, title: str, section: str,
                 raw: str | None = None) -> str:
    key = f"{PREFIX}/{slugify(url)}.md"
    chash = content_hash(raw or markdown)   # den ROHEN Scrape hashen, nicht den bereinigten Text

    if stored_hash(key) == chash:
        return "unchanged"          # das Objekt unverändert lassen, damit die nächste Synchronisation es überspringt

    metadata = {
        "metadataAttributes": {
            "source_url":  {"value": {"type": "STRING", "stringValue": url},
                            "includeForEmbedding": False},
            "title":       {"value": {"type": "STRING", "stringValue": title},
                            "includeForEmbedding": True},
            "section":     {"value": {"type": "STRING", "stringValue": section},
                            "includeForEmbedding": True},
            "scraped_date":{"value": {"type": "NUMBER",
                                      "numberValue": int(datetime.now(timezone.utc).strftime("%Y%m%d"))},
                            "includeForEmbedding": False},
        }
    }
    # Erst die Begleitdatei. Das Dokument trägt den Hash, mit dem der nächste Lauf vergleicht, es ist also
    # der Commit-Punkt. Die umgekehrte Reihenfolge kann ein neues Dokument neben einer veralteten Begleitdatei
    # belassen, die sich nie selbst heilt, weil der Hash bereits übereinstimmt.
    s3.put_object(Bucket=BUCKET, Key=f"{key}.metadata.json",
                  Body=json.dumps(metadata).encode("utf-8"),
                  ContentType="application/json")
    s3.put_object(Bucket=BUCKET, Key=key, Body=markdown.encode("utf-8"),
                  ContentType="text/markdown", Metadata={"content-hash": chash})
    return "written"
Nur schreiben, wenn sich der Inhalts-Hash ändert
Die Hash-Prüfung am Anfang von put_document hält eine Aktualisierung günstig. Bei einer inkrementellen Synchronisation nutzt Bedrock die eigene Änderungsverfolgung der Datenquelle, um zu entscheiden, was neu eingebettet wird. AWS’ Dokumentation gibt derzeit nicht an, welches Signal Bedrock für S3 liest. Ein Loader, der bei jedem Lauf jedes Objekt neu schreibt, aktualisiert dieses Signal, unabhängig davon, ob sich der Inhalt geändert hat. Die sichere Annahme ist, dass eine Synchronisation, die drei Seiten berühren soll, den gesamten Korpus neu einbettet, und man zahlt für alles davon. Der Vergleich des Inhalts-Hashs vor dem Schreiben bedeutet, dass man eine unveränderte Seite in Ruhe lässt, und das kostet nachgelagert nichts.
Cloudflares Daten deuten darauf hin, dass über die Hälfte des KI-Crawler-Traffics auf das erneute Abrufen unveränderter Seiten entfällt. Diese Prüfung löst das nicht, denn die Seite wird so oder so abgerufen, und sie spart nur das Embedding. Der Resync-Zeitplan in Schritt 4 steuert den Abruf selbst.
Den rohen Scrape hashen statt den vom Chrome bereinigten Text. Das Entfernen früher in diesem Schritt ist stapel-relativ, sodass eine unveränderte Seite in einem anderen Stapel sonst anders hashen und umsonst neu eingebettet würde. Der Ausschnitt nimmt genau deshalb ein separates raw-Argument, also beim Aufruf den unbereinigten Text übergeben.
Der Loader des Repositories behält die in einem Lauf gesehenen Hashes, sodass er auch exakte Duplikate entfernt, bei denen zwei URLs byte-identischen Text liefern. In der Praxis deckt das ?utm_source=– und ?print=1-Aliase ab. Eine syndizierte Kopie oder eine paginierte Variante unterscheidet sich um einige Bytes und entgeht dieser Prüfung.
Diese zu erfassen erfordert Near-Duplicate-Erkennung, und das Repository liefert sie als MinHash hinter einem opt-in --near-dup-Flag am Loader. Standardmäßig liegt die Ähnlichkeitsschwelle bei 0,85. Bei diesem Korpus erreichten unterschiedliche Seiten höchstens 0,02, und eine Seite gegen ihr eigenes Markdown-Pendant erreichte 0,75, also behält die Standardeinstellung beides. Die reine Python-Implementierung eignet sich für Korpora bis zu einigen tausend Seiten. Bei der zuvor gemessenen Latenz ist das mehr, als ein einzelner Stapellauf üblicherweise abdeckt.
Festlegen, was die Metadaten tragen
Die Begleitdatei hält die zwei Dinge, die ein gescrapter Korpus auf dem Weg in einen Vektorspeicher verliert. source_url gibt jedem abgerufenen Chunk ein Zitat zurück zur Seite, von der es stammt, sodass eine Antwort ihre Quelle zeigen kann. section und scraped_date werden zu Filterschlüsseln zur Abfragezeit. Man kann eine Suche auf einen Teil des Korpus beschränken, oder auf Inhalte, die nach einem Stichtag geändert wurden.
Die Begleitdatei trägt auch den Seitentitle. includeForEmbedding auf True bei title und section zu setzen, fügt sie dem eingebetteten Text hinzu, sodass eine Anfrage, die eines von beidem nennt, mehr zum Abgleich hat. Es bei source_url auf False zu setzen, hält eine lange URL aus den Vektoren, wo sie mehr Rauschen als Signal hinzufügen würde.
Bedrock unterstützt die Metadatentypen STRING, NUMBER, BOOLEAN und STRING_LIST. scraped_date als NUMBER im Format YYYYMMDD zu speichern, erlaubt es später, mit greaterThan und lessThan zu filtern. Man schreibt eine unveränderte Seite nicht neu, also behält sie ihr früheres Datum. Das macht scraped_date zu einem Inhaltsalter-Filter, nicht zu einem Signal, dass eine Seite noch aktualisiert wird. Dieses Signal braucht einen separaten Zuletzt-gesehen-Stempel, und das Repository schreibt einen bei jedem erfolgreichen Abruf.
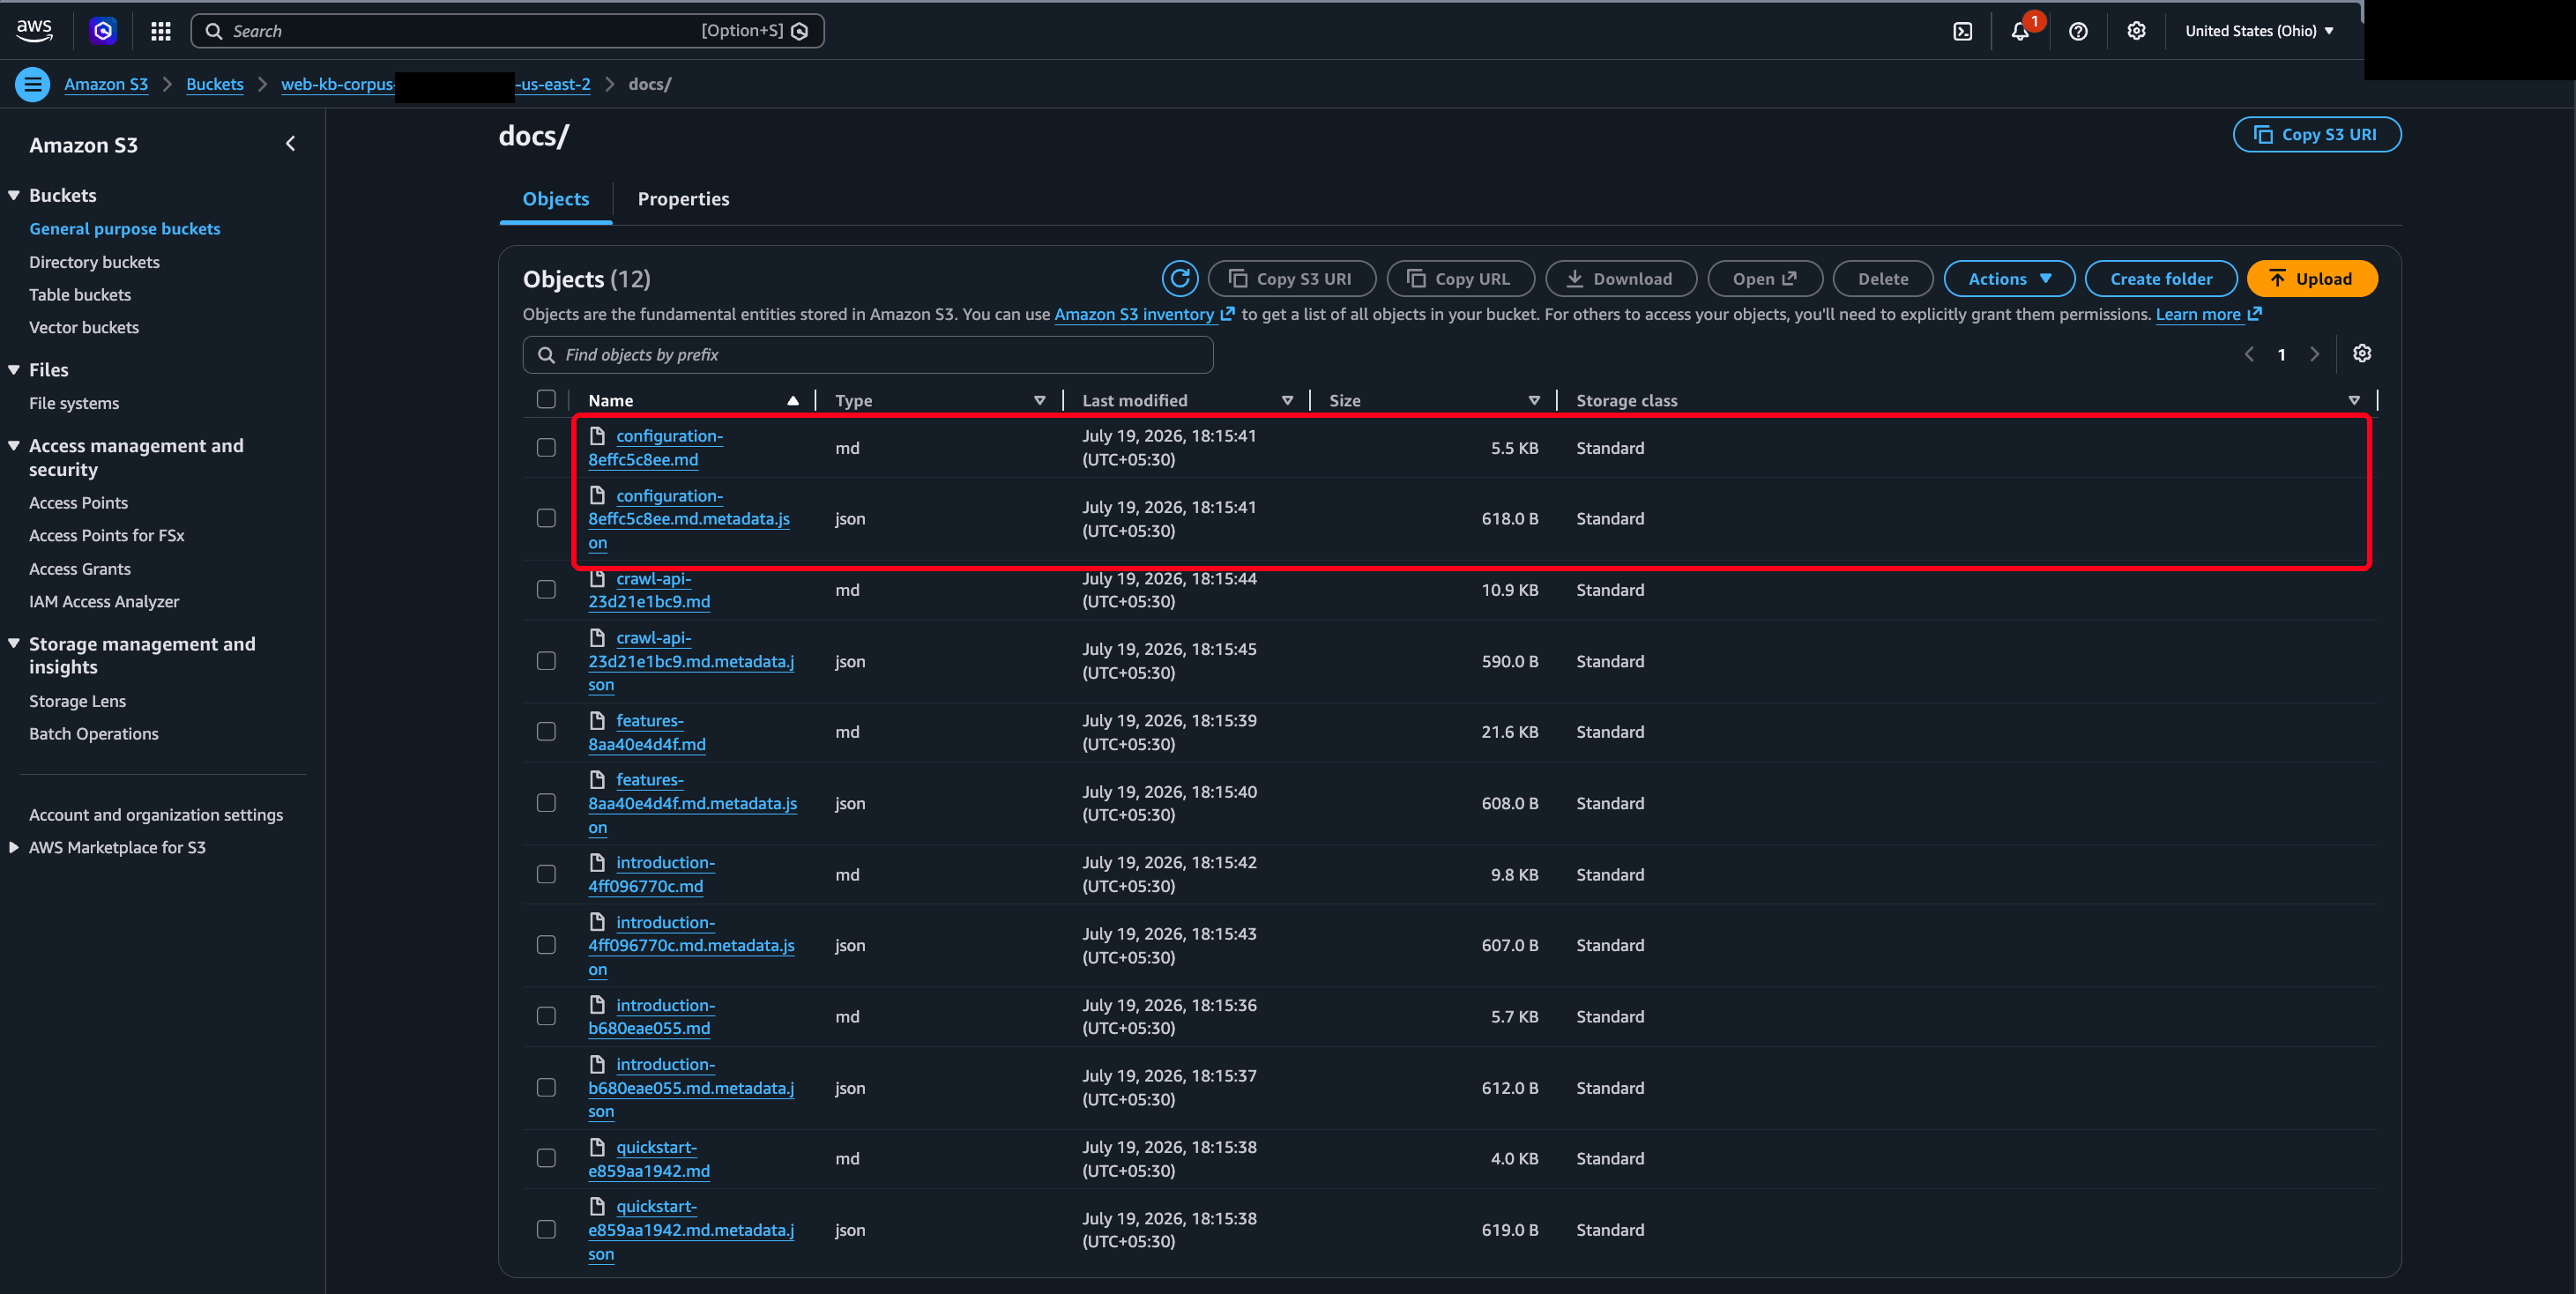
Den Loader über die eigene URL-Liste laufen lassen, und der Bucket hält dann ein Dokument und eine Begleitdatei pro Seite. Die Paare in der Konsole bestätigen, bevor man eine Knowledge Base auf das Präfix richtet:
Schritt 3 – Die Knowledge Base erstellen
Man erstellt die Knowledge Base einmal. Danach schreibt die Pipeline Dateien und löst Synchronisationen aus. Die Konsole ist der klarste Weg für diese Einrichtung, und der create-knowledge-base-Ablauf deckt jeden Bildschirm ab.
Verwaltet oder kundenverwaltet wählen
AWS’ Dokumentation empfiehlt standardmäßig die vollständig verwaltete Knowledge Base. Je nach Region bietet die Konsole sie ebenfalls an. Verwaltete Knowledge Bases betreiben ihren eigenen Datenspeicher, Parsing und Reranking. Sie fügen zudem agentisches Retrieval hinzu und enthalten native Konnektoren wie Google Drive.
Dieser Aufbau nimmt den kundenverwalteten Pfad. Den eigenen Vektorspeicher zu wählen bringt die unten stehende S3-Vectors-Preisgestaltung und belässt den Index im eigenen Konto. Eine verwaltete Knowledge Base kann die von dieser Pipeline nach S3 geschriebenen Dokumente über dieselbe S3-Datenquelle einspeisen. Die Crawler-Lücke bleibt auf beiden Pfaden dieselbe.
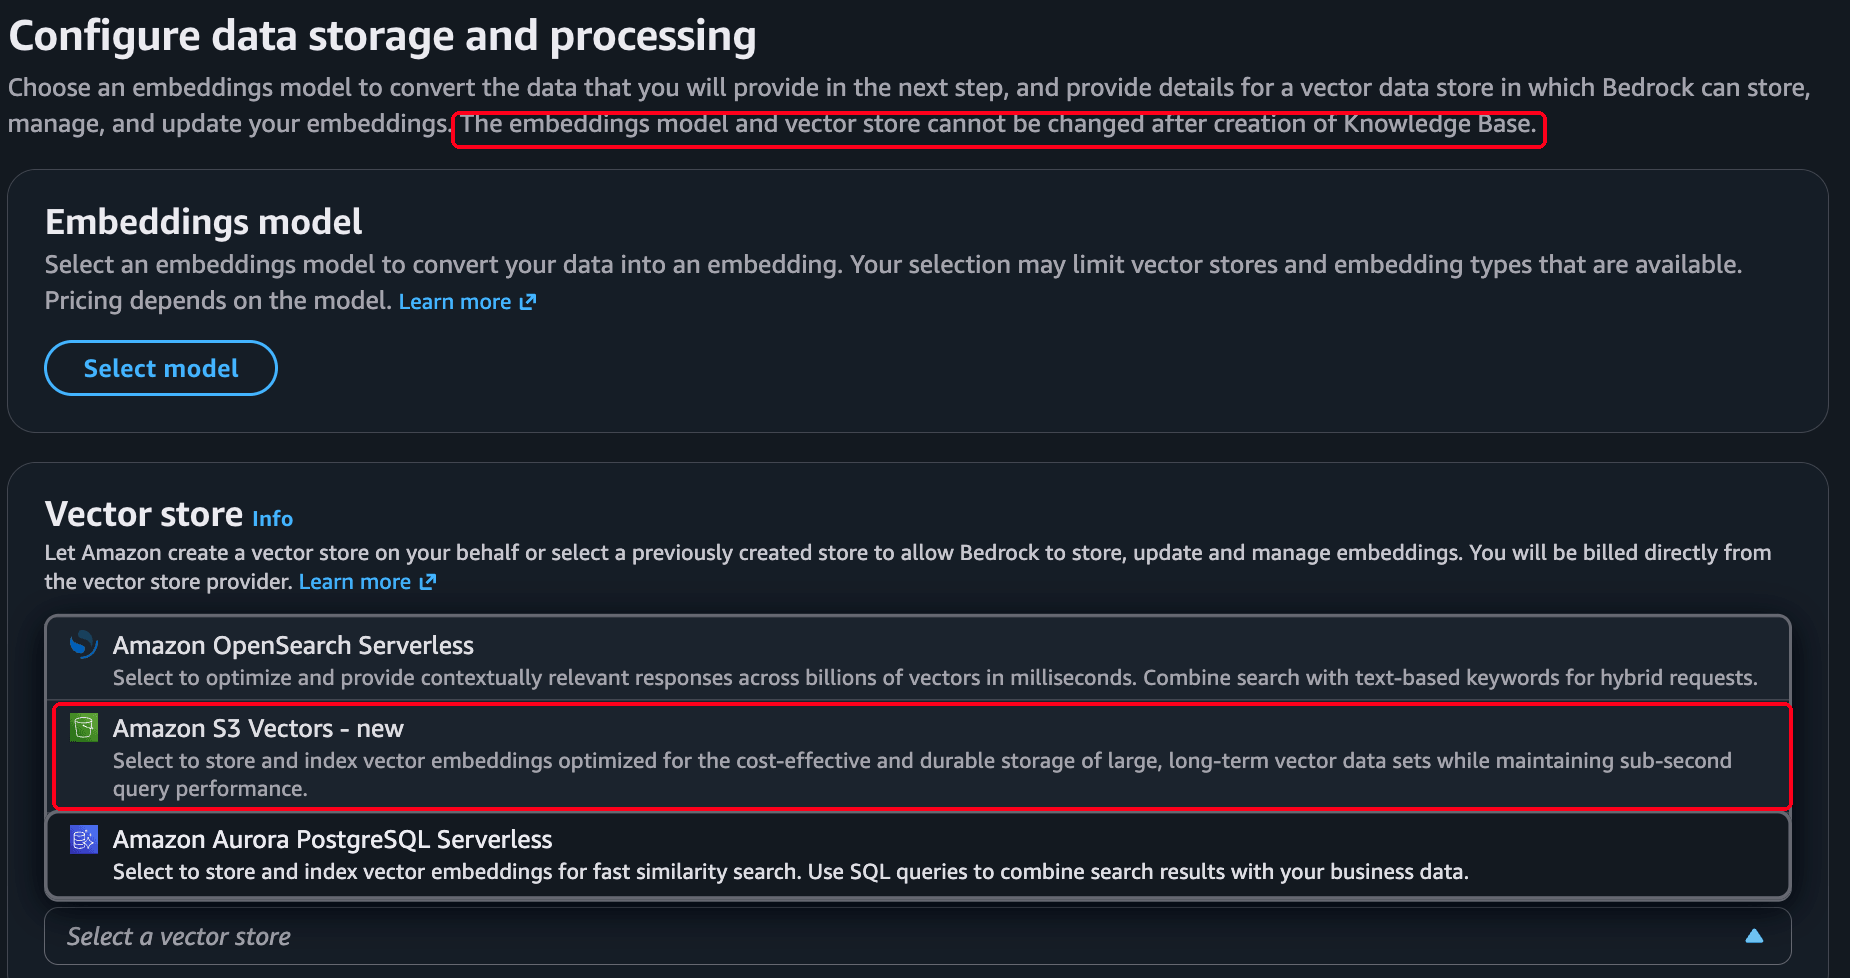
Die Entscheidungen treffen, die man später nicht ändern kann
Vier Entscheidungen prägen den Abruf. Drei der vier sind fixiert, sobald die Knowledge Base und ihre Datenquelle existieren.
- Datenquelle. Amazon S3 wählen und auf den eigenen Bucket und das
docs/-Präfix richten. Bedrock liest die Dokumente und ihre Begleitdateien dann bei jeder Synchronisation von dort. Eine Knowledge Base nimmt bis zu 5 Buckets als Datenquellen. - Embedding-Modell. Amazon Titan Text Embeddings V2 (
amazon.titan-embed-text-v2:0) ist der Standard für Text und das Modell hinter jeder unten stehenden Abrufzahl. Bei 1024 Dimensionen erhält man bessere Abrufqualität, bei 256 niedrigere Speicherkosten. Die unterstützten Embedding-Modelle umfassen Amazon Nova Multimodal Embeddings, erwägenswert, wenn ein Korpus Text mit Bildern mischt. Einmal wählen, denn das Embedding-Modell einer bestehenden Knowledge Base lässt sich nicht ändern. - Vektorspeicher. Amazon S3 Vectors erreichte im Dezember 2025 die allgemeine Verfügbarkeit. Es speichert und befragt Vektoren nach dem Pay-as-you-go-Prinzip ohne Cluster zu betreiben, und man kann es nicht austauschen, sobald die Knowledge Base existiert. Dessen Bucket und Index erstellen, bevor man den Assistenten öffnet. Dann den Assistenten auf diesen bestehenden Speicher richten, statt Amazon einen für einen erstellen zu lassen. Der nächste Abschnitt erklärt warum. AWS sagt, S3 Vectors reduziert die Kosten für Hochladen, Speichern und Abfragen von Vektoren um bis zu 90% im Vergleich zu nicht genannten alternativen Lösungen. Amazon OpenSearch Serverless bleibt die Option, wenn man dessen Abfragefunktionen oder höheren Durchsatz benötigt, obwohl dieser Aufbau nur mit S3 Vectors lief. Für einen Korpus, den man nach Zeitplan aktualisiert statt bei hohem Abfragevolumen zu bedienen, lohnt sich dieser Tausch meist. Die Konsole bietet auch Amazon Aurora PostgreSQL Serverless. Den aktuellen Status und die Preise gegen die S3-Vectors-Dokumentation beim Aufbau prüfen.
- Chunking. Gescrapte Artikel haben Satz- und Absatzstruktur, also ist das standardmäßige Chunking von etwa 300 Token an Satzgrenzen ein vernünftiger Ausgangspunkt. Scrapt man lange Referenzseiten, ruft hierarchisches Chunking präzise Kind-Chunks ab und liefert deren übergeordnete Elternteile für Kontext zurück, obwohl Bedrock davon bei einem S3-Vectors-Speicher abrät. Bedrock bietet auch andere Strategien. Feste Größenaufteilung nutzt eine eingestellte Token-Anzahl. Semantisches Chunking gruppiert nach Bedeutung statt Länge. Eine Keine-Chunking-Option behandelt jedes Dokument als einen einzigen Chunk. Die Chunking-Strategie lässt sich nach Erstellung der Datenquelle nicht ändern.
Der Assistent warnt davor beim Embedding-Modell und beim Vektorspeicher, auf dem Bildschirm, auf dem man sie einstellt:
Die nicht filterbaren Metadatenschlüssel benennen
Wählt man S3 Vectors, den Chunk-Text und Bedrocks eigene Metadaten bei Erstellung des Index als nicht filterbar markieren. Sonst scheitert Bedrock daran, den Großteil des Korpus einzuspeisen. S3 Vectors erlaubt höchstens 2048 Byte filterbarer Metadaten pro Vektor, und Bedrock nutzt einen Teil davon für den Chunk-Text und seine eigene Buchführung. Alles außer einem sehr kurzen Chunk überschreitet das Budget. Nach diesem Overhead legt die S3-Vectors-Knowledge-Base-Dokumentation den praktischen Spielraum für eigene Attribute auf 1 KB und 35 Schlüssel pro Vektor fest. Begleitdateien klein halten.
Beim ersten Lauf schlugen 5 von 6 Dokumenten mit Filterable metadata must have at most 2048 bytes fehl, und das einzige, das überlebte, hatte einen 499-Byte-Chunk. Beide eigenen Schlüssel von Bedrock bei der Index-Erstellung zu benennen behebt das, und diese Entscheidung lässt sich danach nicht ändern:
aws s3vectors create-vector-bucket --vector-bucket-name YOUR_VECTOR_BUCKET --region YOUR_REGION

aws s3vectors create-index --vector-bucket-name YOUR_VECTOR_BUCKET --region YOUR_REGION \
  --index-name web-kb-index --data-type float32 --dimension 1024 --distance-metric cosine \
  --metadata-configuration '{"nonFilterableMetadataKeys":["AMAZON_BEDROCK_TEXT","AMAZON_BEDROCK_METADATA"]}'
Der Name, den man oft falsch macht, ist AMAZON_BEDROCK_TEXT. AMAZON_BEDROCK_TEXT_CHUNK ist der OpenSearch-Feldname, und stattdessen diesen zu benennen lässt den Fehlschlag genau so, wie er war. Das 2_create_kb.py des begleitenden Repositories erstellt den Index auf diese Weise automatisch. Es weigert sich zudem, mit einem bestehenden Index fortzufahren, dem diese Schlüssel fehlen. Die Alternative ist, das Problem während einer Synchronisation zu entdecken, die Erfolg meldet.
Der Assistent wiederholt die Warnung für die Parsing- und Chunking-Strategien einen Bildschirm später.
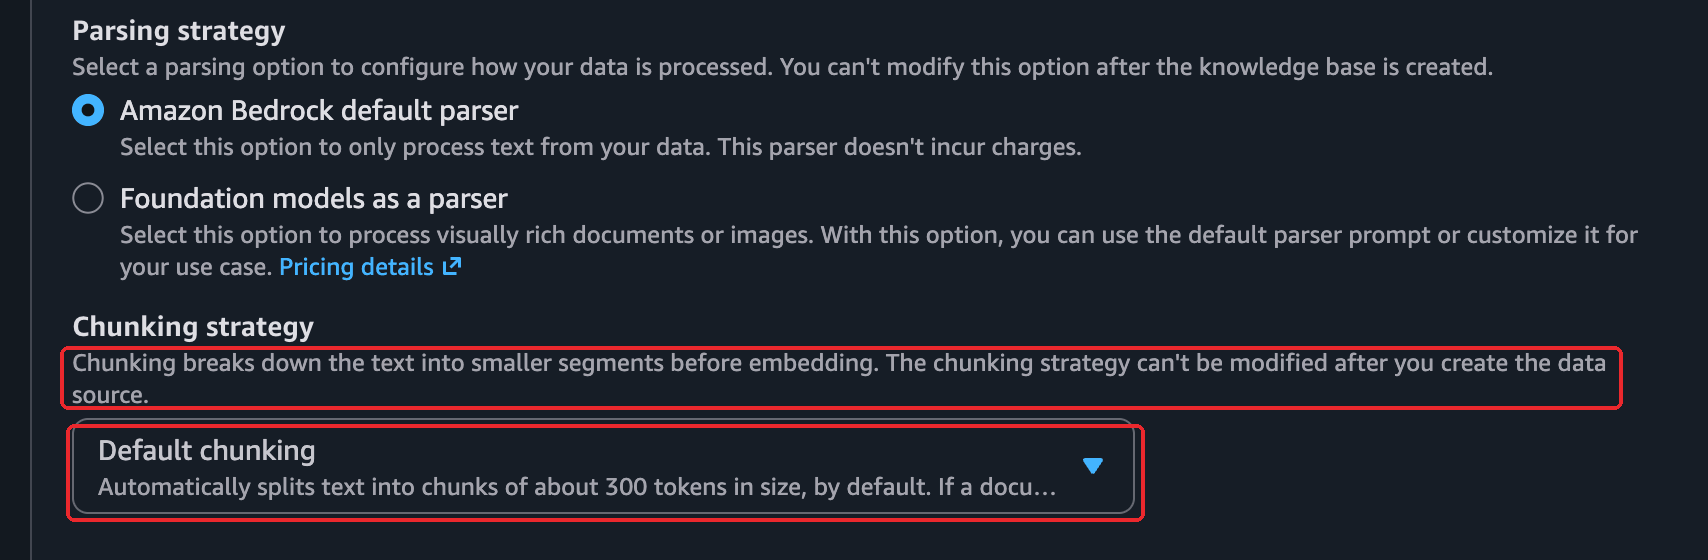
Derselbe Bildschirm trägt eine optionale Transformationsfunktion. Kontextuelles Retrieval stellt vor dem Einbetten eine vom Modell geschriebene Notiz über die Position jedes Chunks im Dokument voran. Anthropic maß einen Rückgang von 35% bei Top-20-Abruffehlern. Bedrock führt diese Funktion bei der Einspeisung aus, zum Preis eines Modellaufrufs pro Chunk. Dieser Aufbau lässt sie aus, sodass die unten stehenden Abrufzahlen allein vom Standard-Chunking stammen.
Zieht man es vor, die Knowledge Base im Code zu erstellen, ruft dasselbe 2_create_kb.py create_knowledge_base und create_data_source des bedrock-agent-Clients auf. Es setzt die S3-Konfiguration und die IAM-Servicerolle automatisch. Das Repository liefert auch Terraform für die gesamte AWS-Seite. Das ist der kürzere Pfad, wenn man sich lieber nicht durch all dies klicken möchte, und es setzt die obigen nicht filterbaren Metadatenschlüssel, sodass man sie nicht vergessen kann.
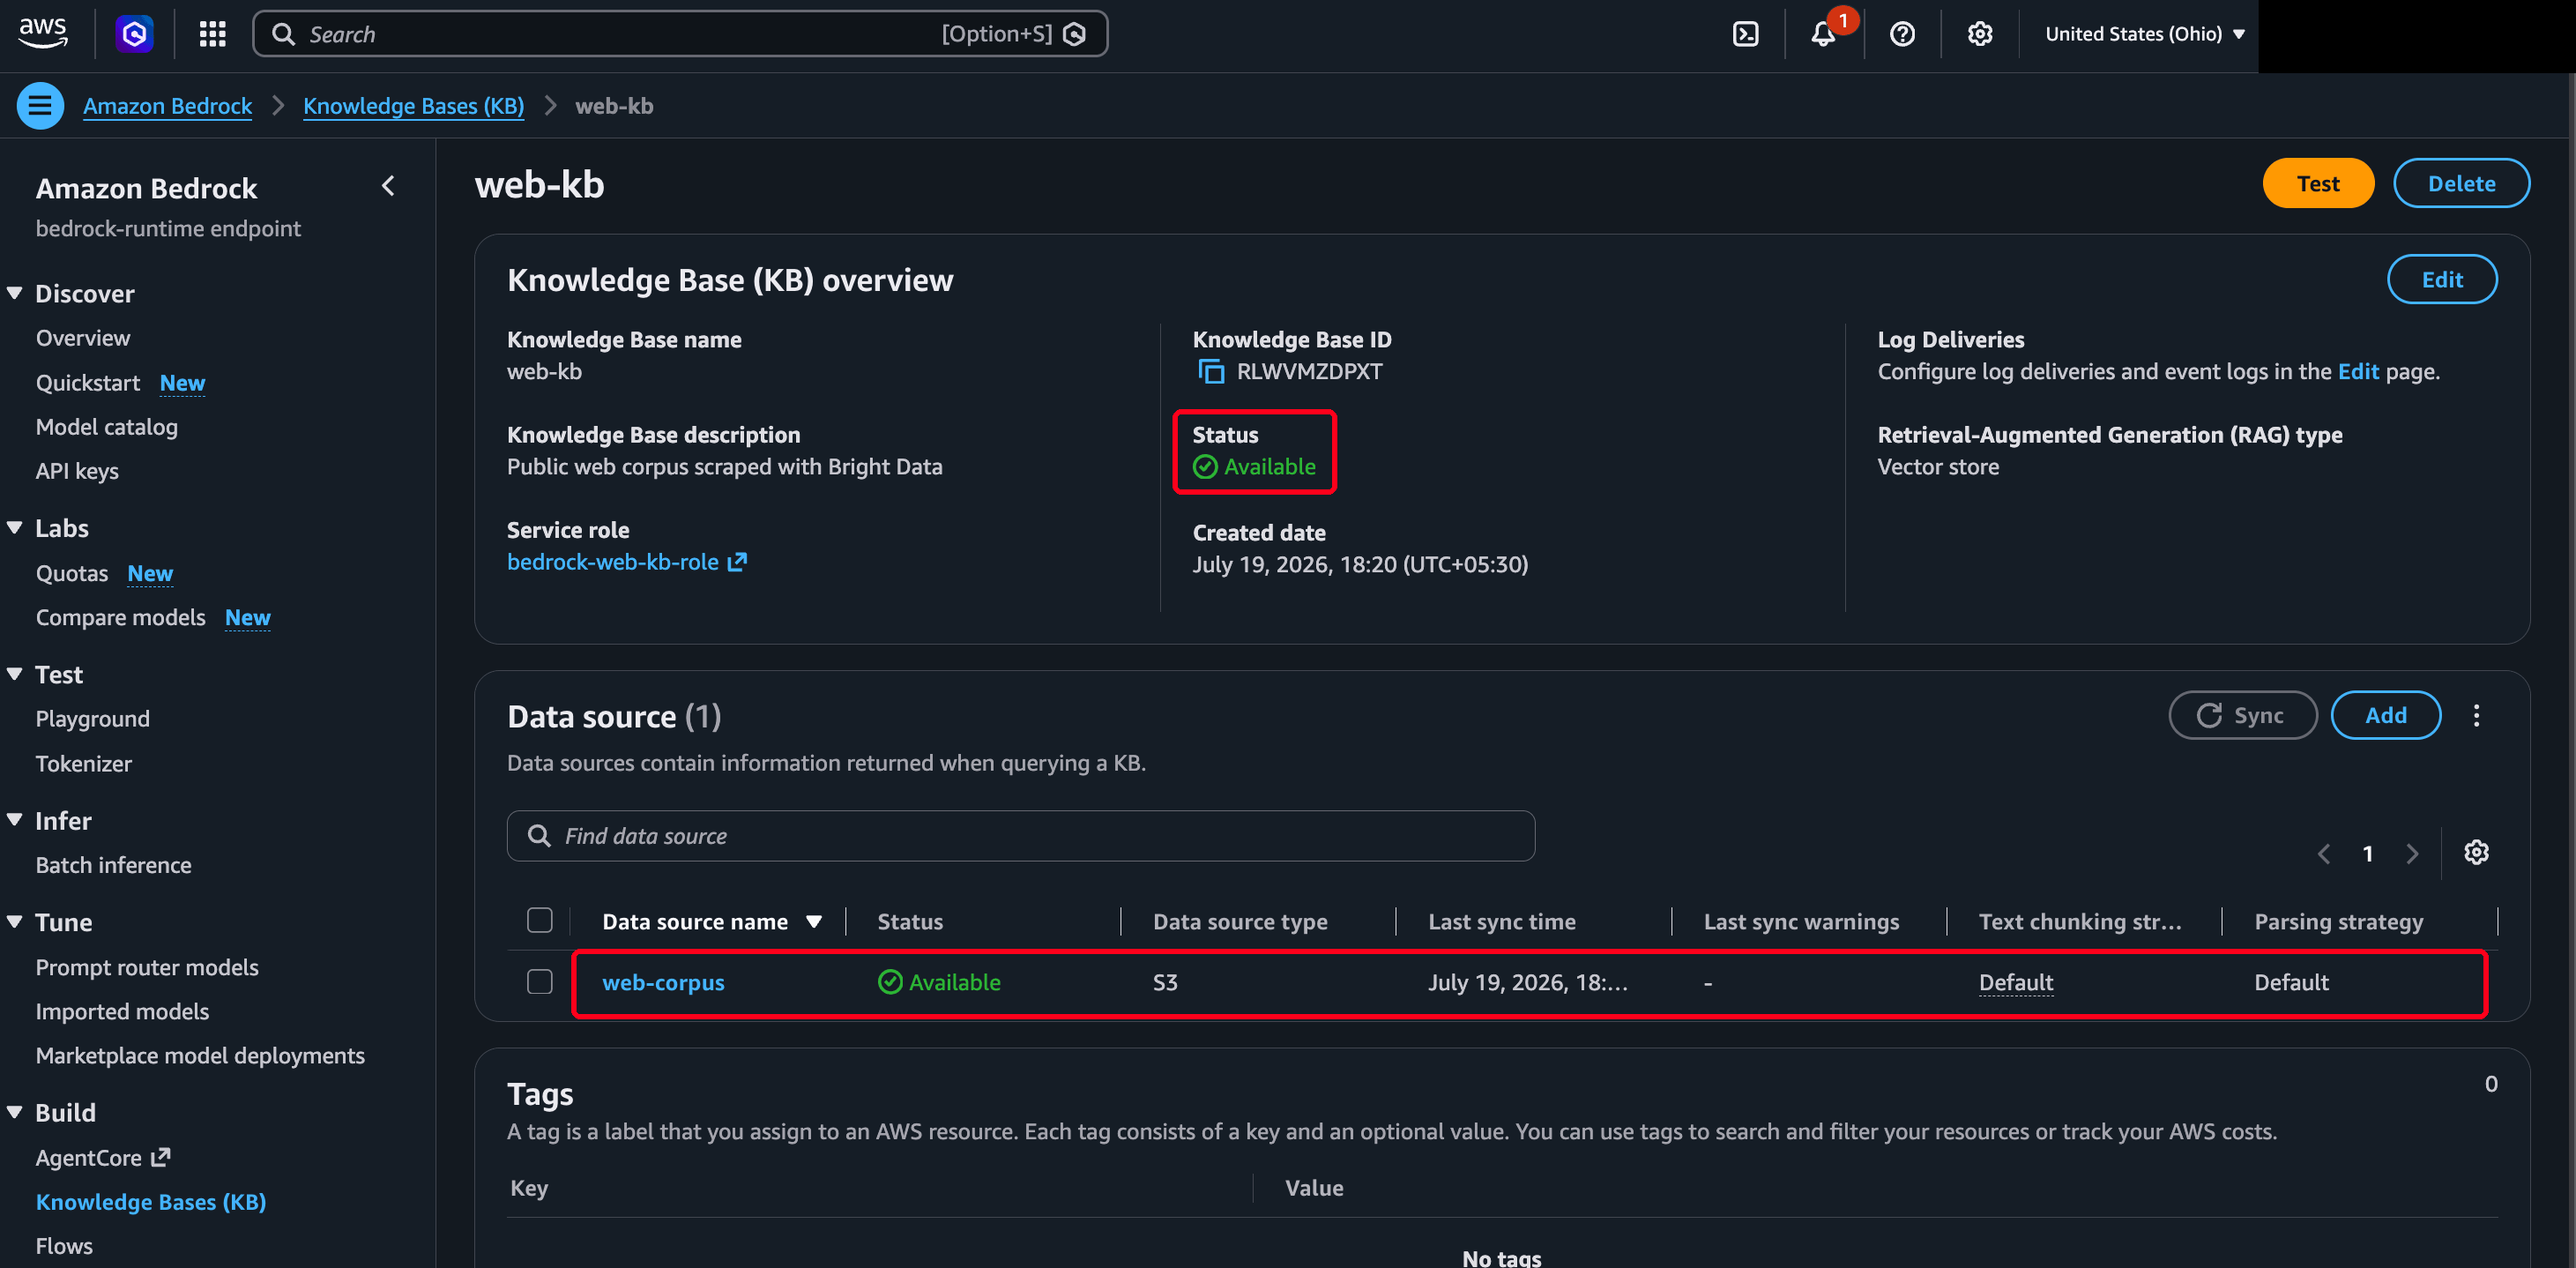
Ist der Erstellungsablauf abgeschlossen, zeigt die Detailseite der Knowledge Base, was man gebaut hat:
Schritt 4 – Einspeisen und die Daten aktuell halten
Das Erstellen der Knowledge Base liest die Daten nicht. Die Einspeisung tut das. Eine Synchronisation, genannt Ingestion-Job, liest den Bucket, zerlegt und bettet die Dokumente ein und schreibt die Vektoren. Man startet eine nach dem ersten Laden und erneut nach jeder Aktualisierung:
bedrock_agent = boto3.client("bedrock-agent", region_name=REGION)

def sync(knowledge_base_id: str, data_source_id: str) -> str:
    job = bedrock_agent.start_ingestion_job(
        knowledgeBaseId=knowledge_base_id,
        dataSourceId=data_source_id,
    )
    return job["ingestionJob"]["ingestionJobId"]
Nach der ersten vollständigen Synchronisation sind spätere Synchronisationen inkrementell. Bedrock speist neue und geänderte Dateien ein und entfernt Vektoren für solche, die den Bucket verlassen haben, sodass eine Aktualisierung nur die Seiten neu einbettet, die der Loader neu geschrieben hat. Dieses Verhalten macht die Hash-Prüfung aus Schritt 2 wesentlich, da ein mit identischen Bytes neu geschriebenes Objekt trotzdem als geändert zählen kann. Der slugify-Schlüssel ist deterministisch, sodass ein erneuter Scrape derselben URL dasselbe Objekt überschreibt statt ein Duplikat zu erstellen.
Das erfasst neue und geänderte Seiten, aber nichts entfernt die ausgemusterten. Der Loader schreibt nur, also löscht das Entfernen einer URL aus der Liste nicht ihr Objekt. Dieser veraltete Inhalt bleibt im Korpus, wo er in jeder späteren Antwort erscheinen kann. Eine Seite auszumustern ist ein separater Abgleichsschritt, der den Bucket auflistet, Objekte findet, deren URL verschwunden ist, und sie löscht, damit die nächste Synchronisation ihre Vektoren entfernt. Das begleitende Repository liefert das als 7_reconcile.py, ein standardmäßig im Dry-Run laufendes Skript. Es gleicht gegen die vollständige URL-Liste ab, sodass es nie eine Seite, die lediglich nicht gescrapt werden konnte, mit einer entfernten verwechselt.
Den Resync-Zeitplan an den sich am schnellsten ändernden Inhalt im Korpus anpassen. Social-Posts können innerhalb von Stunden veraltet sein, Nachrichten innerhalb von Tagen, Preis- und Finanzseiten innerhalb von Wochen, während Referenzdokumentation monatelang aktuell bleiben kann. Das sind Ausgangspunkte, keine Messungen. Eine Knowledge Base mit Nachrichtenseiten könnte täglich resynchronisieren, eine aus Produktdokumentation wöchentlich. Ein Amazon-EventBridge-Zeitplan kann das Scrape-und-Sync in jedem gewählten Intervall auslösen, sodass die Aktualisierung ohne menschlichen Anstoß läuft.
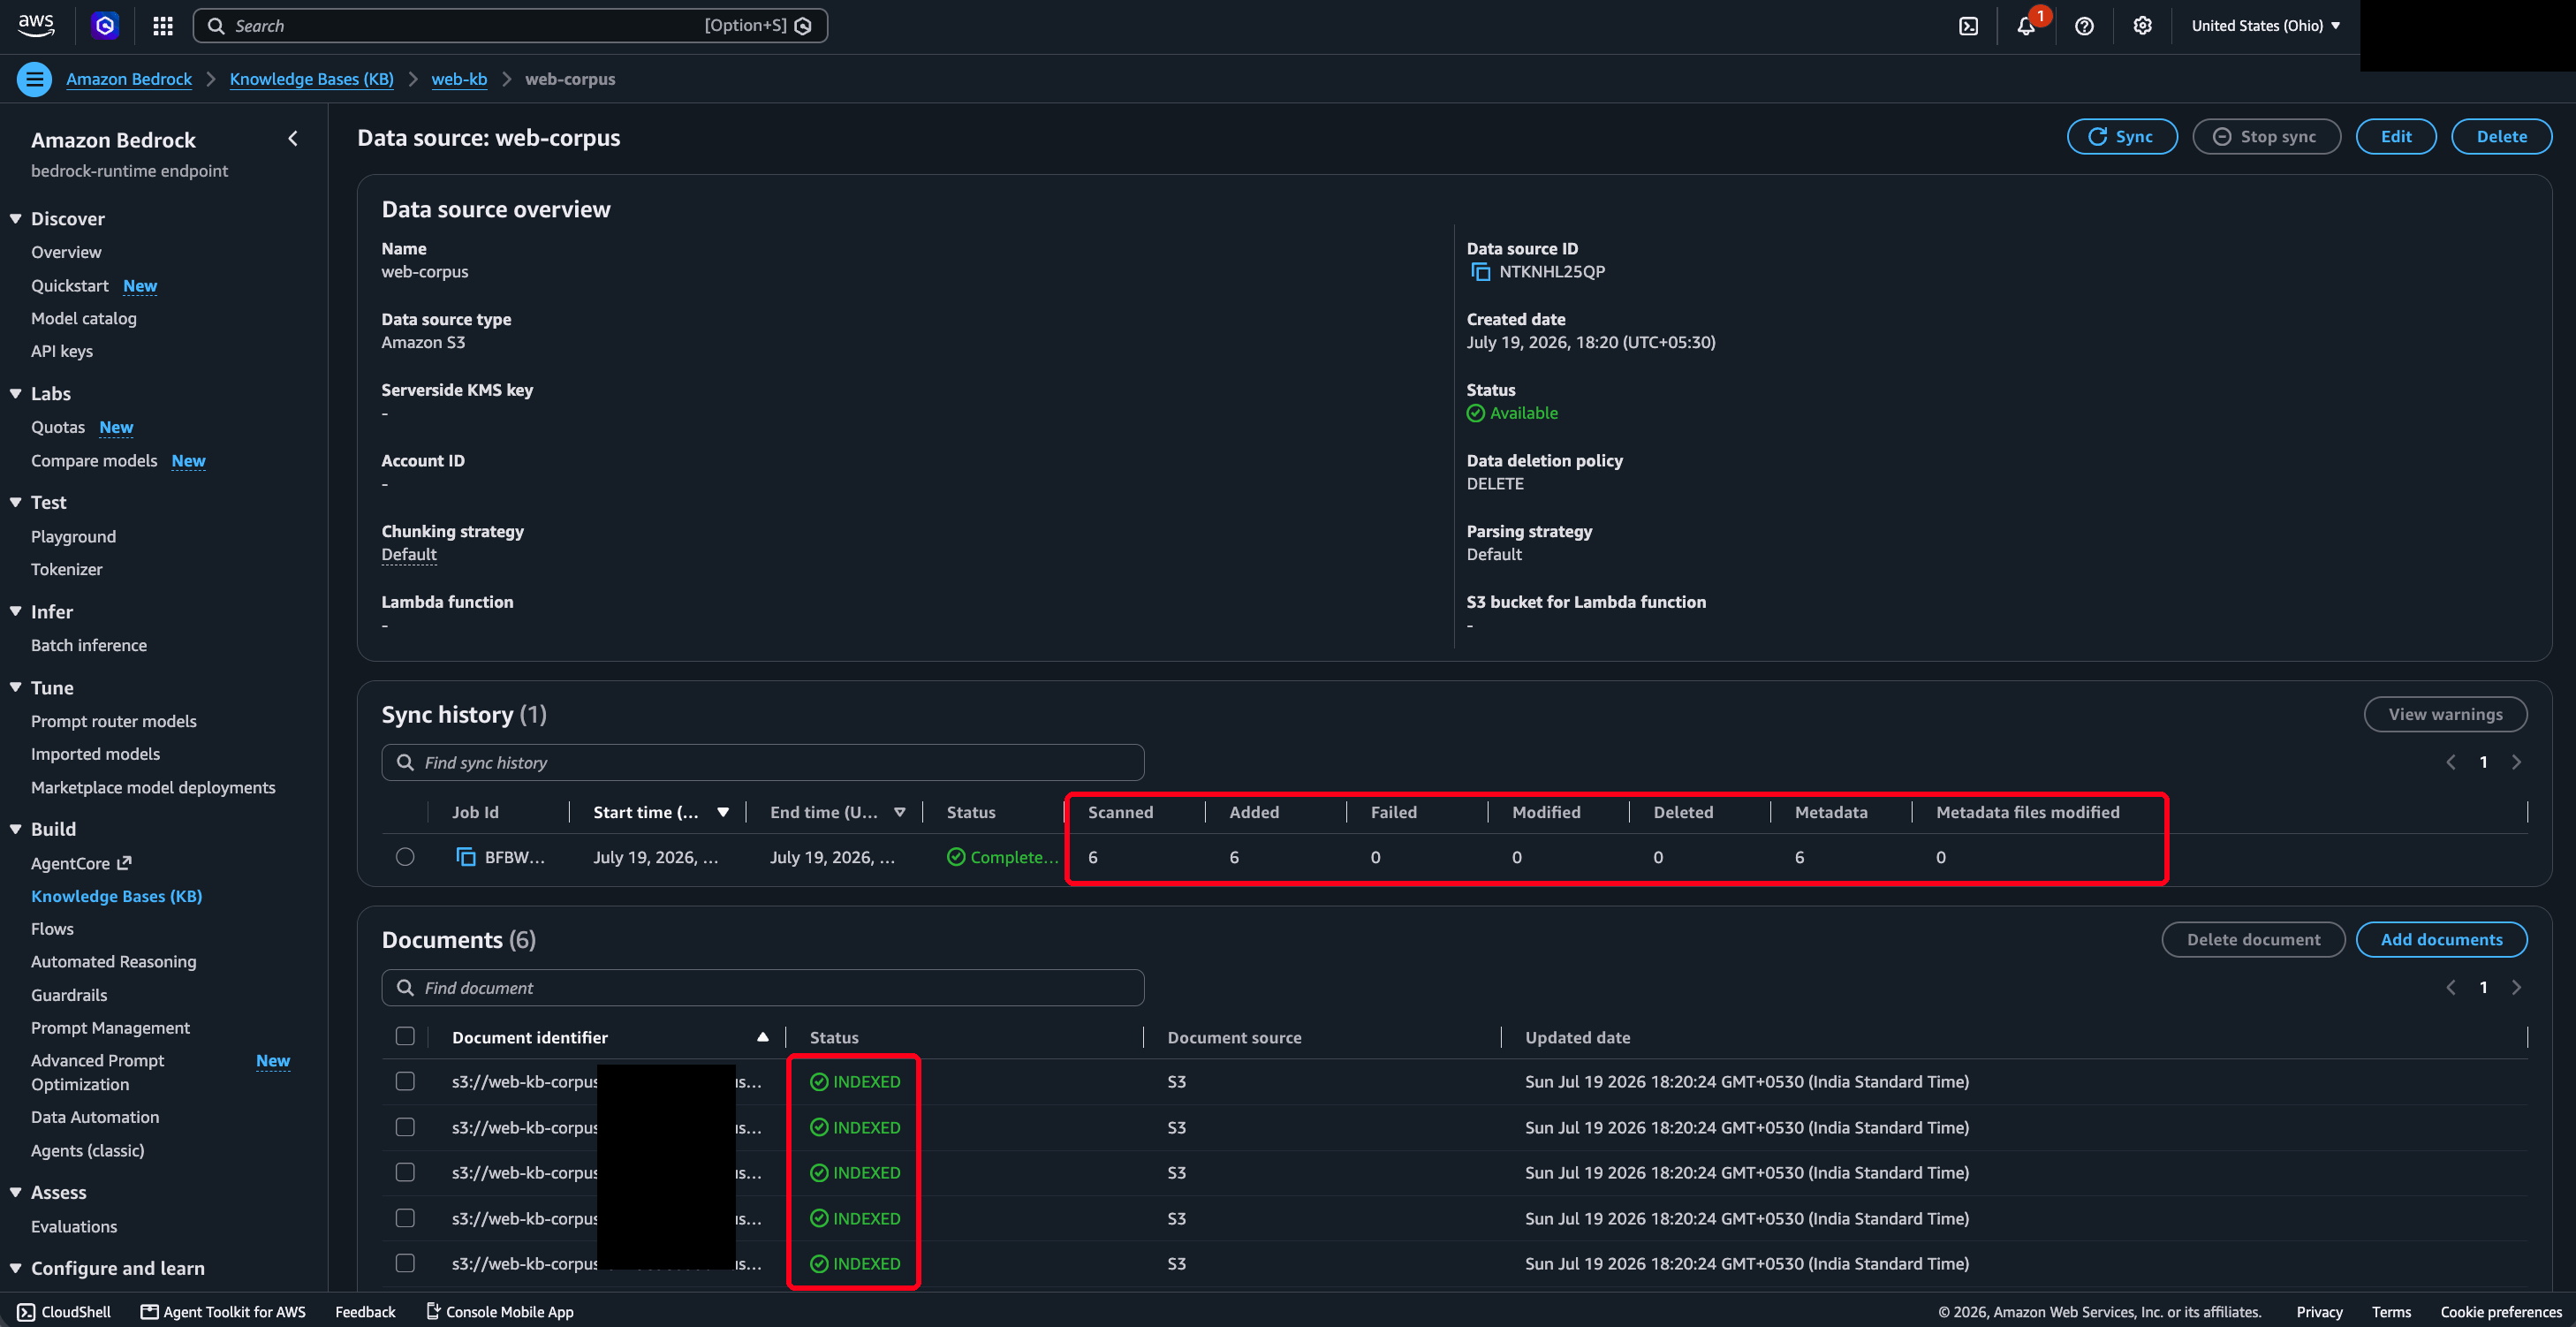
Die Statistiken lesen, nicht den Status. Ein Ingestion-Job meldet COMPLETE, selbst wenn die meisten seiner Dokumente fehlschlugen. Ein Lauf, der 1 von 6 Seiten indexiert hat, sieht allein anhand des Status-Feldes noch wie ein Erfolg aus. Das 3_sync.py des Repositories gibt diese Zählungen aus und beendet sich bei Fehlschlägen nicht-null:
{"status": "COMPLETE",
 "statistics": {"numberOfDocumentsScanned": 6, "numberOfNewDocumentsIndexed": 6,
                "numberOfModifiedDocumentsIndexed": 0, "numberOfDocumentsDeleted": 0,
                "numberOfDocumentsFailed": 0}}
Das ist ein gemessenes Ergebnis aus dem 6-seitigen Korpus, und es brauchte zwei Versuche, dorthin zu gelangen. Der erste Lauf meldete COMPLETE mit numberOfDocumentsFailed: 5, alle davon trafen auf das in Schritt 3 beschriebene S3-Vectors-Metadatenlimit. Schlagen Dokumente fehl, trägt failureReasons am Job den tatsächlichen Fehler und ist das Erste, was man liest. Ein Null-Embedding-Kontingent erscheint auch hier und sieht wie ein Berechtigungsproblem aus. Die Einspeisung von 6 Seiten dauerte etwa 25 Sekunden. Zeit und Chunk-Anzahlen skalieren mit dem eigenen Korpus und dessen Chunking, also an eigenen Daten messen.
Die Datenquellenseite listet jeden Job in seinem Synchronisationsverlauf mit den Statistiken pro Dokument:
Schritt 5 – Die Knowledge Base abfragen
Bedrock bietet einen Abrufaufruf und einen Generierungsaufruf. Welchen man wählt, hängt davon ab, ob man die Rohbelege oder eine geschriebene Antwort möchte. Beide befinden sich auf dem bedrock-agent-runtime-Client.
Retrieve liefert die Quell-Chunks und sonst nichts. Das ist die richtige Wahl, wenn das eigene Modell oder die eigene Anwendung das Schreiben übernimmt und man nur fundierten Kontext und Zitate benötigt:
runtime = boto3.client("bedrock-agent-runtime", region_name=REGION)

def retrieve(kb_id: str, query: str, section: str | None = None,
             num_results: int = 5) -> list[dict]:
    config = {"vectorSearchConfiguration": {"numberOfResults": num_results}}
    if section:
        config["vectorSearchConfiguration"]["filter"] = {
            "equals": {"key": "section", "value": section}
        }
    resp = runtime.retrieve(
        knowledgeBaseId=kb_id,
        retrievalQuery={"text": query},
        retrievalConfiguration=config,
    )
    return resp["retrievalResults"]
Jedes Ergebnis trägt den Chunk-Text, eine Relevanzscore, den location des Quellobjekts und die in Schritt 2 geschriebenen metadata. Bei diesem Korpus erzielte ein korrektes Top-Ergebnis 0,67, eine Zahl, mit der man später die Relevanzschwelle festlegt. Diese Metadaten ermöglichen den optionalen filter, der die Suche auf eine section oder einen Datumsbereich beschränkt:
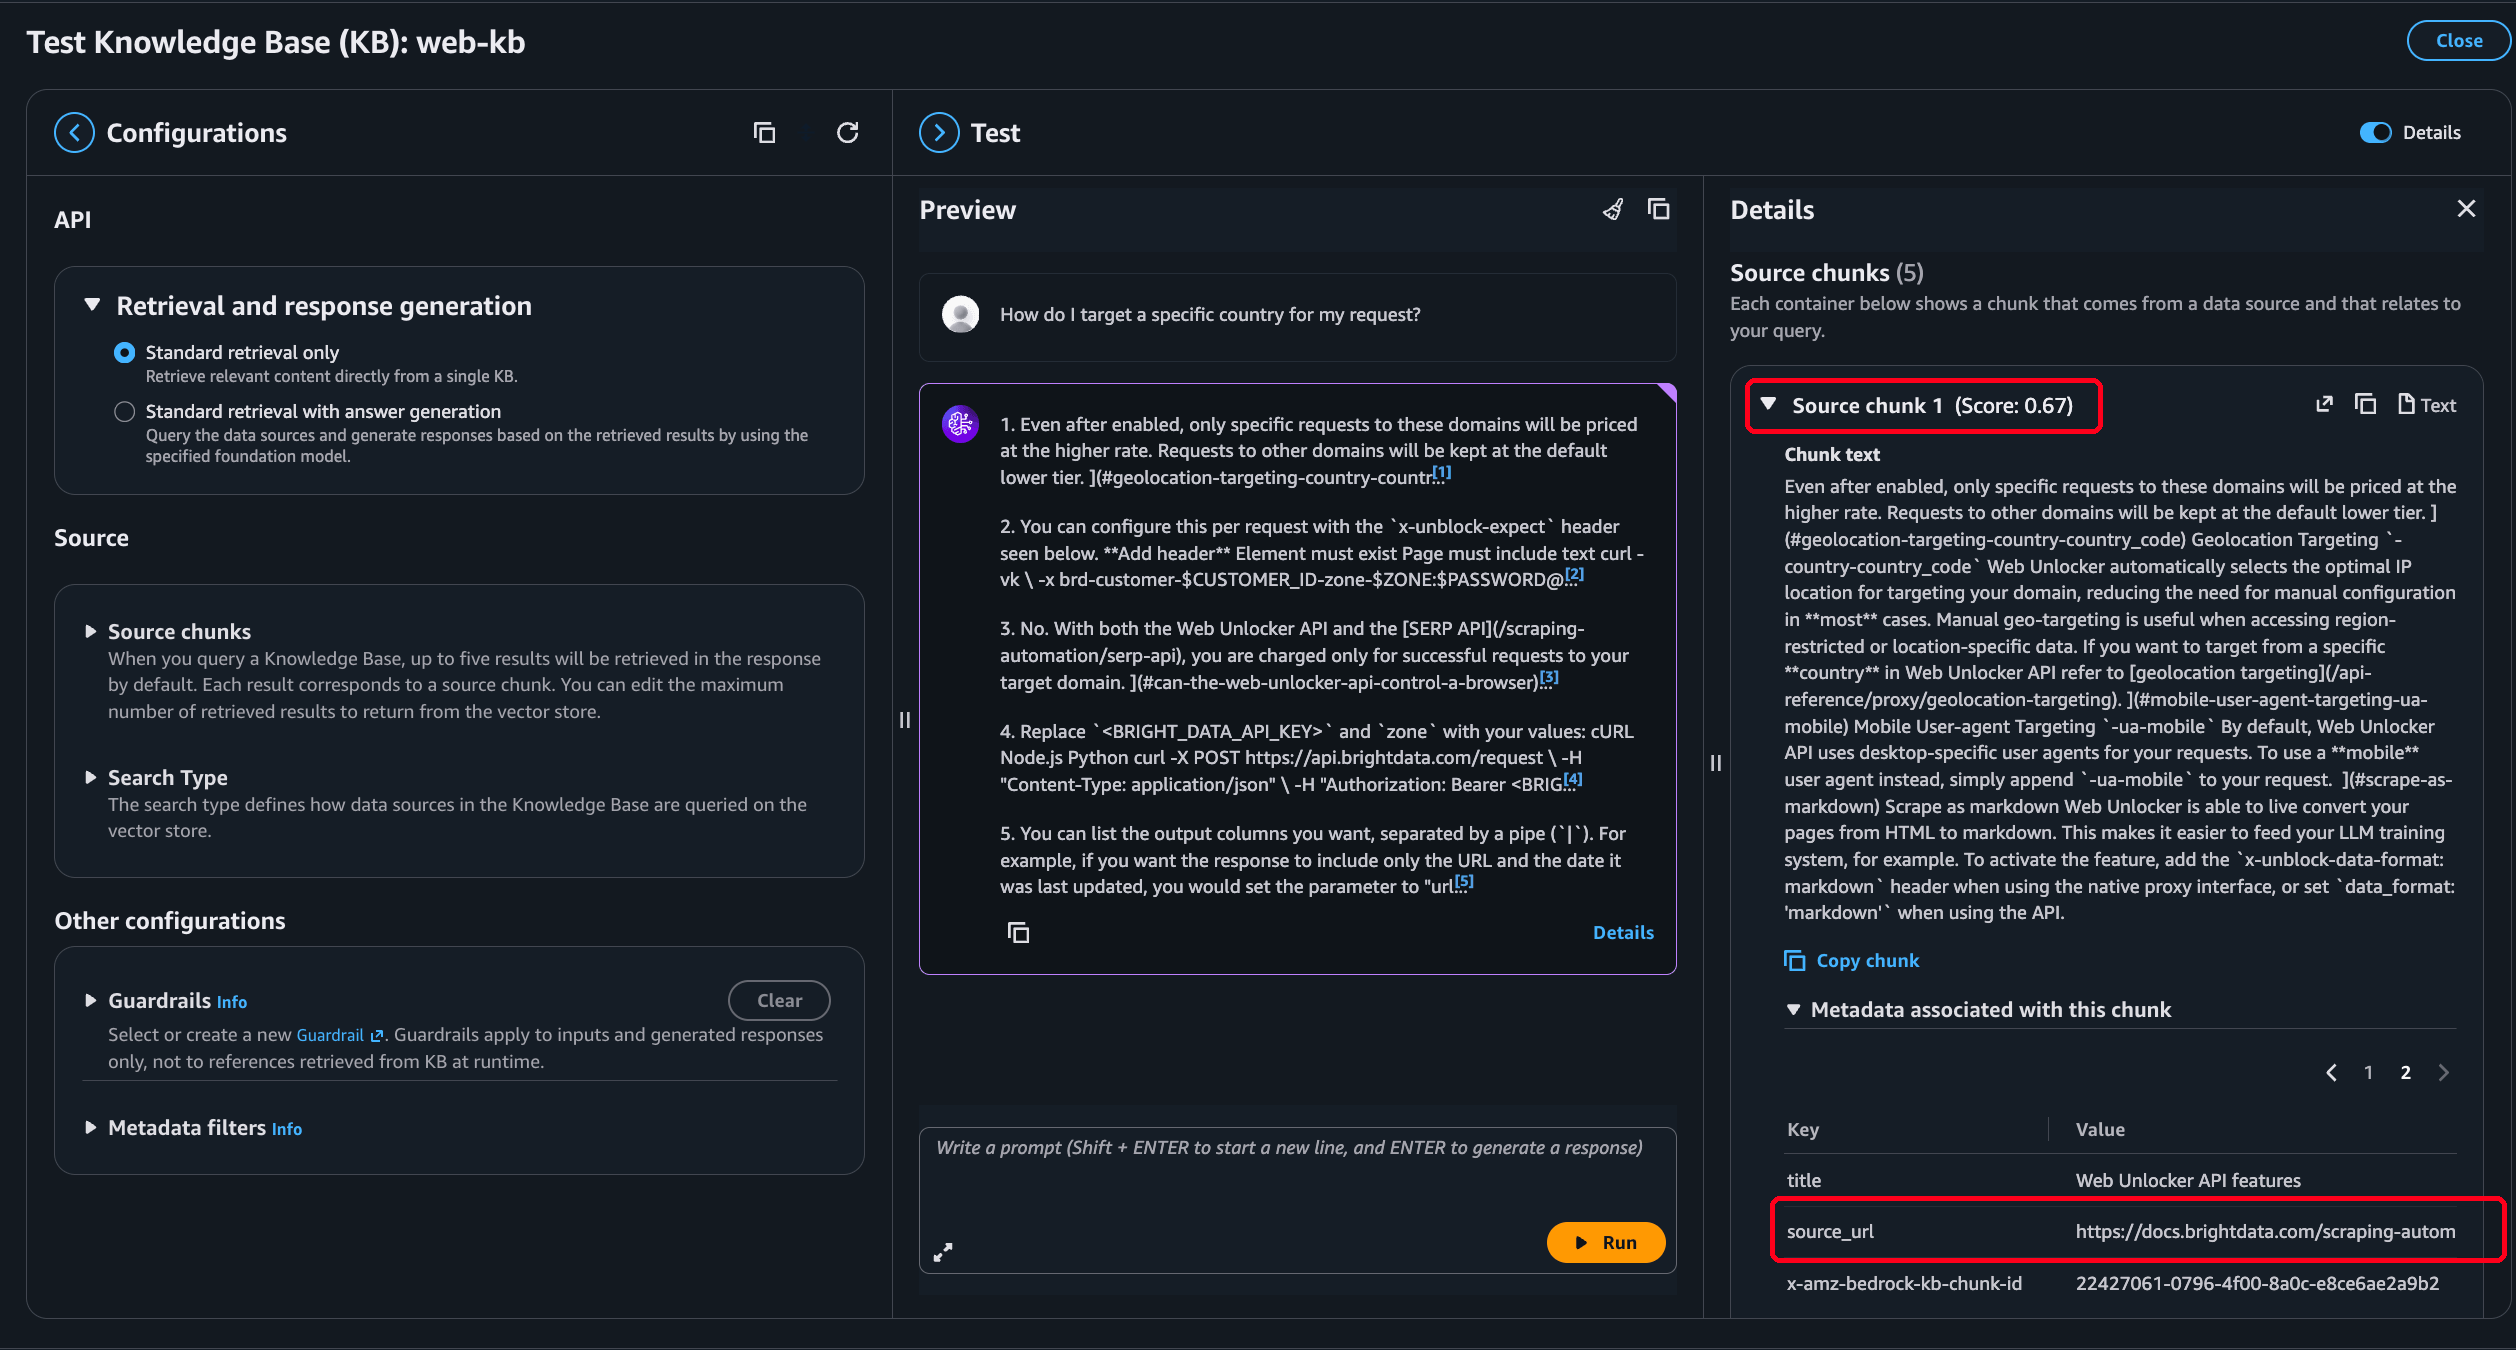
Der native Crawler nimmt HTML ohne Begleitdatei-Schritt auf, sodass diese Attribute nirgendwoher kommen können.
RetrieveAndGenerate macht, was Retrieve macht, und schreibt dann die Antwort. Es fundiert diese Antwort in den abgerufenen Chunks und liefert Zitate damit zurück:
def answer(kb_id: str, query: str, model_arn: str) -> dict:
    resp = runtime.retrieve_and_generate(
        input={"text": query},
        retrieveAndGenerateConfiguration={
            "type": "KNOWLEDGE_BASE",
            "knowledgeBaseConfiguration": {
                "knowledgeBaseId": kb_id,
                "modelArn": model_arn,
            },
        },
    )
    return resp   # resp["output"]["text"] plus resp["citations"]
Die Antwort hält den generierten Text und ein citations-Array, das Textabschnitte der Antwort auf die Chunks abbildet, aus denen sie stammen. Da man source_url in der Begleitdatei setzt, löst jedes Zitat zur gescrapten Seite auf. Eine Antwort über die Preisgestaltung eines Produkts zitiert dann die von Bright Data abgerufene Preisseite.
Baut man eine vollständig verwaltete Knowledge Base, managedSearchConfiguration anstelle von vectorSearchConfiguration verwenden, da verwaltete Knowledge Bases standardmäßig Hybrid-Suche mit aktiviertem Reranking betreiben. Die retrieve()-Funktion des begleitenden Repositories markiert, wo man es austauscht.
Schritt 6 – Messen, ob der Abruf funktioniert
Nichts in der Pipeline sagt bisher, ob die Knowledge Base die richtige Seite für die Fragen der Nutzer liefert. Eine falsche Chunk-Größe zu korrigieren bedeutet, die Datenquelle neu zu erstellen, also sollte man das an 20 Seiten statt an 20.000 herausfinden.
Das Werkzeug dafür ist ein goldener Datensatz, eine Liste von Fragen, jede mit den Seiten, die sie beantworten sollten. Der Datensatz dieser Pipeline enthält 6 Fragen und liegt im Repository als eval/golden.json, neben eval/golden-v1-mislabeled.json, der ersten Version, deren fehlerhafte Beschriftung dieser Abschnitt erklärt:
[
  {"question": "How do I get the page back as markdown instead of HTML?",
   "expect": ["https://docs.brightdata.com/scraping-automation/web-unlocker/features"]},
  {"question": "How do I target a specific country for my request?",
   "expect": ["https://docs.brightdata.com/scraping-automation/web-unlocker/features",
              "https://docs.brightdata.com/scraping-automation/web-unlocker/configuration"]}
]
Dann führt man jede Frage durch Retrieve und notiert, wo die erwartete Seite in den Ergebnissen erscheint:
def evaluate(kb_id: str, golden: list[dict], k: int = 5):
    ranks = []
    for item in golden:
        chunks = retrieve(kb_id, item["question"], num_results=k)
        got = [c.get("metadata", {}).get("source_url", "") for c in chunks]
        # 1-basierter Rang der ersten erwarteten Seite, oder None, falls sie nie erschien
        ranks.append(next((i + 1 for i, u in enumerate(got) if u in item["expect"]), None))

    hit_rate = sum(r is not None for r in ranks) / len(ranks)
    mrr = sum(1 / r if r else 0 for r in ranks) / len(ranks)
    missed = [g["question"] for g, r in zip(golden, ranks) if r is None]
    return hit_rate, mrr, missed
Die Trefferquote ist der Anteil der Fragen, bei denen die erwartete Seite überhaupt erschien. Sie zeigt, ob der Korpus überhaupt eine Antwort fundieren kann. Mean Reciprocal Rank mittelt 1 geteilt durch den Rang dieser Seite. Er fällt, wenn die richtige Seite erscheint, aber auf Rang 5 liegt, und eine Trefferquote allein verbirgt das.
Die Liste der Fehlschläge ist der Teil, auf den man reagiert. Ein Fehlschlag bedeutet meist eines von vier Dingen. Die Seite erreichte den Korpus nie, also die Loader-Ausgabe auf einen fehlgeschlagenen Abruf prüfen. Die Chunks sind zu groß, sodass umgebender Text die relevante Passage verwässert. Die Chunks sind zu klein, sodass die Passage den Kontext verlor, der sie treffend machte. Oder der goldene Datensatz ist falsch.
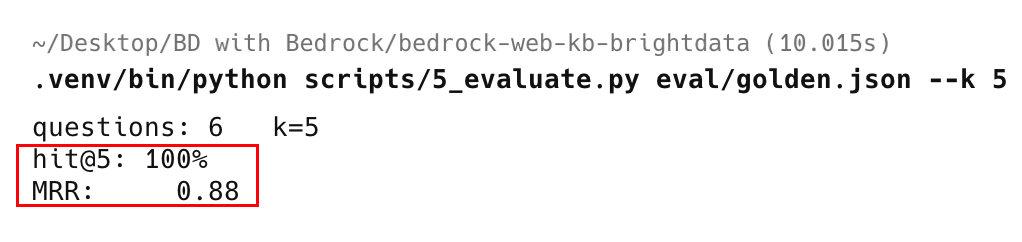
Der erste Evaluationslauf erzielte 83% hit@5, mit einem Fehlschlag bei “How do I target a specific country for my request?” Der goldene Datensatz erwartete die Konfigurationsseite. Das Lesen des stattdessen gelieferten Chunk-Abrufs klärte die Frage. Die Passage von der Features-Seite enthielt die Länder-Targeting-Dokumentation wortwörtlich. Der Abruf war richtig gewesen, und die Beschriftung war falsch gewesen. Die Korrektur ergab 100% hit@5 mit einem MRR von 0,88 und 83% hit@3 mit einem MRR von 0,83. Das sind 6 Fragen gegen 6 Seiten, also als einen gemessenen Datenpunkt lesen, nicht als Benchmark.
Immer lesen, was der Abruf bei einem Fehlschlag geliefert hat, bevor man irgendetwas an der Pipeline ändert. Nur der abgerufene Text sagt, ob der Abruf oder die Beschriftung falsch ist. Ein Pipeline-Problem schickt einen zum Loader, ein Chunking-Problem schickt einen zurück zur Datenquelle, und eine falsch beschriftete Frage braucht nur einen besseren goldenen Datensatz.
Das vor dem Skalieren des Korpus ausführen, und weiterhin ausführen. Sobald man eine zufriedenstellende Trefferquote hat, sie als Freigabeschranke behandeln. Das Evaluationsskript des begleitenden Repositories nimmt genau dafür ein --min-hit-rate-Flag. Eine geplante Aktualisierung, die den Abruf still verschlechtert, scheitert dann laut, statt schlechtere Antworten auszuliefern.
Bedrock liefert auch verwaltete Evaluation, die Abruf und Generierung mit einem Richtermodell bewertet. Sie zum Studium der Qualität nutzen und den goldenen Datensatz als Freigabeschranke behalten. Der Datensatz ist deterministisch, kostet nur die Abrufaufrufe und läuft bei dieser Größe in Sekunden.
Wann man über die Knowledge Base hinausgehen sollte
Eine Knowledge Base ist eine Momentaufnahme ausgewählter Seiten. Man bettet sie einmal ein und befragt sie viele Male. Diese Momentaufnahme macht jede Abfrage günstig, bringt aber auch zwei Arten von Fragen außer Reichweite. Fragen zu Fakten, die sich schneller ändern als der Synchronisationszeitplan, erhalten veraltete Antworten. Fragen zu Seiten, die nie im Korpus waren, haben nichts zum Abgleich.
Pro Anfrage routen, statt einmal zwischen persistenter Knowledge Base und Live-Abruf zu wählen. Zuerst die Knowledge Base fragen, und wenn sie die Frage nicht fundieren kann, auf eine Live-Bright-Data-Abfrage zurückgreifen:
def route_answer(kb_id: str, query: str, min_score: float = 0.4):
    chunks = retrieve(kb_id, query, num_results=5)
    top = max((c.get("score", 0.0) for c in chunks), default=0.0)

    if chunks and top >= min_score:
        return "knowledge_base", chunks

    # nichts im Korpus deckt das ab, also live suchen und abrufen
    return "live_web", live_context(query)      # Bright Data SERP + Web Unlocker
live_context ist der Suche-dann-Abruf-Helfer des Repositories in src/web_kb/live_tool.py, und er benötigt eine Bright-Data-SERP-Zone neben der Web-Unlocker-Zone aus Schritt 1. Man erstellt die SERP-Zone genauso und ruft sie über denselben api.brightdata.com/request-Endpunkt auf. Sie liefert die Ergebnisseite als JSON, sodass der Fallback URLs zum Abrufen auswählen kann.
Die Relevanzschwelle ist das Routing-Signal. Bedrock liefert mit jedem Chunk eine Bewertung, und wenn der beste unter die Schwelle fällt, deckt der Korpus die Frage vermutlich nicht ab. Trotzdem aus dem Korpus zu antworten ist der zu vermeidende Fehlerfall, denn das Ergebnis ist eine selbstbewusste Antwort, die eine Seite zitiert, die sie nicht stützt.
Die obige 0,4 ist ein Ausgangspunkt, kein gemessener Wert. Sie liegt unter den 0,67, die ein korrektes Top-Ergebnis in Schritt 5 erzielte. Sie gegen den goldenen Datensatz aus Schritt 6 abstimmen, neben einigen Fragen, von denen man weiß, dass der Korpus sie nicht abdeckt. 5_evaluate.py gibt die beobachtete Bandbreite aus, die niedrigste Bewertung bei einem Treffer und die höchste bei einem Fehlschlag. Die Schwelle gehört dazwischen. Diese zusätzlichen Fragen in einer separaten Datei halten, da eine Frage ohne erwartete Seite als Fehlschlag gegen die Freigabeschranke zählt.
Verwaltete Knowledge Bases treffen eine Version dieser Entscheidung intern, genannt agentisches Retrieval. Diese Entscheidung im eigenen Code zu behalten bedeutet, man kann das Signal, die Schwelle und den Fallback einsehen, und der Live-Pfad kann über AWS hinausreichen. Ihn als Bedrock-Agent-Aktionsgruppe verbinden, als Tool in einem Framework wie Strands Agents, oder als Bright Datas MCP-Server.
Dieser Server gibt jedem MCP-kompatiblen Agenten dieselbe Live-Suche, Entsperrung und Crawling-Funktion. In einem AgentCore Gateway sitzt er neben einem Tool, das Retrieve aufruft. Die Routing-Regel ändert sich nicht, nur wo der Fallback läuft.
Eine Knowledge Base ist die richtige Wahl, wenn man dieselben Seiten wiederholt abfragt, wenn man Zitate, Filter und Zugriffskontrolle benötigt, und wenn der Korpus sich langsamer ändert, als man ihn abfragt. Live-Abruf gewinnt, wenn sich ein Fakt schneller ändert als die Synchronisation, wenn der Fragenraum offen ist, oder wenn man weit mehr einbetten würde, als man je abrufen wird. Das klarste Zeichen, dass das Gleichgewicht falsch ist, ist so oft zu synchronisieren, dass man die meisten Seiten neu einbettet, bevor jemand sie abfragt. Dann zahlt man dafür, einen Index zu pflegen, statt ihn zu nutzen.
Prompt-Caching hat einen Teil dieser Regel verändert. Bei einem Korpus, der klein und stabil genug ist, um in das Kontextfenster eines Modells zu passen, kann man den Abruf ganz überspringen. Diese Pipeline lohnt sich, sobald der Korpus den Cache übersteigt, oder wenn Antworten exakte Seiten zitieren müssen, Filter Abfragen einschränken müssen, oder Seiten nach unterschiedlichen Zeitplänen aktualisieren. Ohne eines davon ist das Caching des gesamten Korpus einfacher.
Vollständige Site-Abdeckung mit der Crawl API und nativer S3-Auslieferung
Die bisherige Pipeline nimmt eine bekannte Liste von URLs. Wächst der Korpus, kennt man nicht unbedingt jede URL im Voraus, und möchte die Abrufschleife lieber nicht selbst betreiben. Bright Datas Crawl API handhabt beides. Sie entdeckt und crawlt die internen Seiten einer Site ausgehend von einer Startadresse und liefert jede Seite als Markdown. Sie kann die Ausgabe auch direkt in den eigenen S3-Bucket liefern.
Dieser Pfad wurde aus der Dokumentation zusammengestellt, nicht ausgeführt. Die Aufrufreihenfolge und Feldnamen unten folgen Bright Datas API-Referenz, also diese gegen die Crawl-API-Dokumentation prüfen, bevor man sich auf diesen Pfad verlässt.
Dieser Ausschnitt setzt die vorherigen Schritte fort: Er nutzt BRIGHTDATA_TOKEN aus Schritt 1 und REGION aus Schritt 2 wieder. Crawl-Jobs sind asynchron, und die Auslieferung ist ein eigener Aufruf statt einer Option beim Auslösen. Man löst einen Crawl aus und erhält eine Snapshot-ID, fragt ab, bis dieser Snapshot ready ist, und übergibt ihn dann an den Auslieferungs-Endpunkt mit einem s3-Ziel. Der Auslieferungsaufruf schreibt die Ausgabe ohne Download-Schritt im eigenen Code in den Bucket:
import requests, time

BD = "https://api.brightdata.com"
HEADERS = {"Authorization": f"Bearer {BRIGHTDATA_TOKEN}"}
CRAWL_DATASET_ID = "..."   # die Crawl-API-Dataset-ID aus dem eigenen Bright-Data-Kontrollzentrum
AWS_KEY, AWS_SECRET = "...", "..."   # Auslieferungsanmeldedaten. Einen IAM-Rollen-ARN mit externer ID bevorzugen

def _call(method: str, path: str, **kw):
    resp = requests.request(method, f"{BD}{path}", headers=HEADERS, timeout=60, **kw)
    resp.raise_for_status()
    return resp.json()

def crawl_to_s3(seed_url: str, bucket: str, directory: str) -> str:
    # 1. Auslösen. Der Körper ist ein nacktes Array von Eingabeobjekten, kein Wrapper-Objekt.
    snapshot = _call("POST", "/datasets/v3/trigger",
                     params={"dataset_id": CRAWL_DATASET_ID,
                             "custom_output_fields": "markdown|url|page_title"},
                     json=[{"url": seed_url}])["snapshot_id"]

    # 2. Abfragen. Die Auslieferung akzeptiert nur einen bereits im Status `ready` befindlichen Snapshot.
    while (state := _call("GET", f"/datasets/v3/progress/{snapshot}")["status"]) != "ready":
        if state == "failed":
            raise RuntimeError(f"crawl {snapshot} failed")
        time.sleep(15)

    # 3. Ausliefern. Liefert eine Auslieferungsjob-ID zurück, die man bei
    #    GET /datasets/v3/delivery/{id} abfragt, bis ihr Status "done" ist.
    return _call("POST", f"/datasets/v3/deliver/{snapshot}",
                 json={"type": "s3",
                       "bucket": bucket,
                       "directory": directory,
                       "region": REGION,
                       "credentials": {"aws-access-key": AWS_KEY,
                                       "aws-secret-key": AWS_SECRET},
                       "filename": {"template": "crawl", "extension": "json"}})["id"]
Bright Data liefert Datensätze als JSON, NDJSON oder CSV statt eine Markdown-Datei pro Seite, es gibt also einen Normalisierungsschritt zwischen Auslieferung und Einspeisung. Eine S3-getriggerte Lambda-Funktion übernimmt das und löst aus, wenn die Auslieferung die Ausgabe in ein Landing-Präfix schreibt. Die Funktion teilt jeden Datensatz in ein <slug>.md-Dokument und seine .metadata.json-Begleitdatei unter dem Quellpräfix der Knowledge Base auf. Das ist genau die Form, die man in Schritt 2 von Hand geschrieben hat. Bedrocks S3-Datenquelle speist diese dann bei der nächsten Synchronisation ein.
Das obige Beispiel übergibt ein Schlüsselpaar. Einen IAM-Rollen-ARN mit externer ID bevorzugen, sodass kein langlebiger Schlüssel in der Anfrage sitzt.
Der Tausch zwischen den beiden Pfaden ist Kontrolle gegen Skalierung. Web Unlocker mit eigenem Loader gibt exakte Kontrolle über jeden Dateinamen und jedes Metadatenfeld. Das ist ideal für eine kuratierte Liste. Die Crawl API mit S3-Auslieferung und einer Normalisierungs-Lambda gibt breite Abdeckung ohne eigene Abrufschleife. Das ist ideal, wenn der Korpus ein ganzer Site-Abschnitt ist, den man synchron halten will.
Kostenüberlegungen
Die unten stehenden Zahlen als Vorlage für eigene Zahlen behandeln, nicht als Angebot, und den eigenen Korpus gegen die Bright-Data-Preise und Amazon-S3-Preise kalkulieren, bevor man sich festlegt.
| Komponente | Wie die Preisgestaltung funktioniert | Was sie bestimmt |
|---|---|---|
| Bright Data Web Unlocker | 1,50 $ pro 1.000 erfolgreiche Anfragen bei Pay-as-you-go, mit einem Premium-Tarif von 2,50 $. Fehlschläge werden nicht berechnet | 1 Anfrage pro gescrapter Seite |
| Bright Data Crawl API | 1,50 $ pro 1.000 Datensätze bei Pay-as-you-go | Pro Job entdeckte und gecrawlte Seiten |
| Bedrock-Embeddings (Titan V2) | Pro Eingabe-Token | Gesamte Token über alle Chunks bei der Einspeisung, plus jede Abfrage |
| Vektorspeicher | S3 Vectors Pay-as-you-go, oder OpenSearch Serverless pro OCU-Stunde | Korpusgröße und Abfragevolumen |
| Amazon S3 | Speicherung und Anfragen, bei dieser Größe wenige Cent | 1 .md plus 1 Begleitdatei pro Seite |
| RetrieveAndGenerate | Pro Token beim Generierungsmodell | Antwortvolumen und Modellwahl |
Hier ist, was eine Aktualisierung des 6-seitigen Korpus kostet, auf dem Web-Unlocker-Pfad zum Standardtarif.
- Scraping. 6 Web-Unlocker-Anfragen, 0,009 $ bei 1,50 $ pro 1.000.
- Embedding. 60.846 bereinigte Zeichen, etwa 15.000 Token bei je 4 Zeichen, etwa drei Hundertstel Cent bei 0,00002 $ pro 1.000.
- Vektorspeicherung. Etwa 50 standardgroße Chunks, deutlich unter einem Megabyte, zu klein, um bei 0,06 $ pro GB-Monat eine Rolle zu spielen.
Eine wöchentliche Aktualisierung dieses Pilotprojekts kostet etwa 4 Cent im Monat, fast alles Web-Unlocker-Anfragen. Die Hash-Prüfung hält das Embedding bei null, wenn sich nichts geändert hat. Skaliert man linear, kosten 500 Seiten, die man wöchentlich aktualisiert, etwa 3,25 $ im Monat an Scraping und unter einem Cent an Speicherung.
Generierungs-Token pro Abfrage und der gewählte Vektorspeicher sind die zwei Kosten, die über diese Zahlen hinauswachsen können. Eine klassische Amazon-OpenSearch-Serverless-Collection hat selbst im Leerlauf eine Grundkostenlast. Das sind etwa 175 $ im Monat beim reduzierten Dev-Test-Minimum und etwa das Doppelte bei der Standard-2-OCU-Untergrenze. AWS bietet auch einen Collection-Typ, der auf null skaliert, bepreist auf der OpenSearch-Service-Preisseite. Gegen die klassischen Collections ändert S3 Vectors die Rechnung für geplante Aktualisierungen bei moderatem Abfragevolumen.
Einschränkungen und Produktionshärtung
Diese Pipeline ist eine Referenzarchitektur, kein produktionsreifes Produkt.
- Aktualität ist ein selbst verantworteter Zeitplan. Eine Knowledge Base ist eine Momentaufnahme von ihrer letzten Synchronisation, und zwischen Synchronisationen veraltet sie mit der Rate, mit der die Quelldaten zerfallen. Eine Warnung auslösen, wenn eine Synchronisation fehlschlägt, denn ein übersprungener Lauf lässt veraltete Daten an Ort und Stelle.
- Ein fehlgeschlagener Scrape versteckt sich hinter guten Daten. Kann man eine Seite nicht abrufen, dient ihre vorherige Version weiterhin als aktuell. Der Loader im Repository benennt fehlgeschlagene URLs und beendet sich nicht-null, sodass ein geplanter Lauf sie meldet. Eine Seite zu erkennen, die still aufgehört hat, sich zu aktualisieren, ist eine separate Frage.
scraped_datekann sie nicht beantworten, da eine Seite monatelang sauber abgerufen werden kann, ohne sich zu ändern. Das Repository versieht jeden erfolgreichen Abruf mit einem Zuletzt-gesehen-Datum und meldet die URLs, die seit einem Stichtag nicht gesehen wurden. - Chunking oder Embedding lassen sich später nicht ändern. Beides an einer Stichprobe der eigenen Seiten testen, bevor die erste vollständige Synchronisation läuft. Das Modell zu korrigieren bedeutet, die Knowledge Base neu zu erstellen, und das Chunking zu korrigieren bedeutet, die Datenquelle neu zu erstellen.
- Abgerufener Inhalt ist nur so gut wie die Seite. Bright Data liefert, was die Seite ausgegeben hat, und wandelt es in Markdown um. Es prüft nicht, ob die Seite korrekt ist. Bei allem, worauf man handeln wird, einen Menschen im Prozess behalten und das
source_url-Zitat nutzen, um die Verifizierung zu einem Klick statt einer Vermutung zu machen. - Das Token in den Ausschnitten ist ein Platzhalter. Alles Geplante sollte es aus AWS Secrets Manager lesen. Es sollte nie ein Repository erreichen.
- Die Zahlen sind gemessen, aber nicht aus dem eigenen Korpus. Sie an eigenen Konten und Daten reproduzieren, bevor man sich auf eine bestimmte Zahl verlässt.
Abschließende Gedanken
Amazon Bedrock Knowledge Bases übernimmt Chunking, Embedding und zitierten Abruf, und seine nativen Konnektoren decken die bereits vorhandenen Daten und die eigenen statischen Seiten ab. Das öffentliche Web, das sich ändert, clientseitig rendert und sich verteidigt, liegt außerhalb dieser Reichweite, und es enthält oft die Daten, die eine Knowledge Base erst lohnenswert machen. Bright Data schließt diese Lücke, und beide treffen sich in S3.
Um die Pipeline zu erweitern, EventBridge-Zeitplanung für automatische Aktualisierung hinzufügen, Bright Datas Crawl API für vollständige Site-Abdeckung nutzen, oder Bedrock-Reranking aktivieren, sobald das Chunking feststeht.
Bright Datas Web Unlocker enthält eine kostenlose Stufe für den Einstieg, die Crawl API deckt vollständige Site-Crawls ab, und man richtet Amazon Bedrock Knowledge Bases über die Amazon-Bedrock-Konsole ein. Das vollständig lauffähige Projekt mit dem Loader, dem Knowledge-Base-Einrichtungsskript und den IAM-Richtlinien befindet sich im begleitenden Repository.
Häufig gestellte Fragen
Kann Amazon Bedrock Knowledge Bases das Web selbstständig crawlen?
Es hat einen nativen Web Crawler in der Vorschau, eine gute Wahl für eigene statische Seiten. Aktuell handhabt er nur statische Sites, verbietet eine Site ohne robots.txt, ist pro Synchronisation auf 25.000 Seiten begrenzt und benötigt OpenSearch Serverless. Für JavaScript- oder bot-geschützte Seiten Bright Data nutzen, um den Inhalt zu rendern und zu entsperren, dann von S3 einspeisen.
Warum die Daten in S3 speichern, statt sie zur Abfragezeit live aus dem Web abzurufen?
Eine persistente Knowledge Base bettet jede Seite einmal ein und bedient viele Abfragen aus einer latenzarmen Vektorsuche, mit Zitaten, Metadatenfilterung und Zugriffskontrolle. Live-Abruf über Bright Data eignet sich für schnell wechselnde oder einmalige Nachschlagevorgänge. Viele Produktionssysteme nutzen beides und routen pro Abfrage nach der Bewertung.
In welchem Format sollten gescrapte Seiten für Bedrock vorliegen?
Markdown. Bright Datas Web Unlocker liefert die Seite als Markdown, wenn man data_format auf markdown setzt, und Bedrock nimmt sie als unterstützten Dokumenttyp auf. Die Umwandlung entfernt das HTML-Markup, aber nicht die Site-Navigation, also das sich wiederholende Chrome entfernen, bevor man nach S3 schreibt.
Wie funktionieren Zitate in den Antworten?
Man schreibt ein source_url-Attribut in die .metadata.json-Begleitdatei jedes Dokuments. Bedrock trägt diese Metadaten in den Abruf, sodass Retrieve es bei jedem Chunk liefert und RetrieveAndGenerate ein Zitat-Array enthält, das jeden Textabschnitt der Antwort zur Ursprungsseite auflöst.
Warum meldet mein Ingestion-Job COMPLETE, obwohl nichts indexiert wurde?
Weil status kein Erfolgssignal ist. Ein Job kann COMPLETE melden, obwohl die meisten seiner Dokumente fehlschlugen, und bei dieser Pipeline meldete er COMPLETE mit 5 von 6 fehlgeschlagen. statistics für die Zählungen pro Dokument lesen und failureReasons für den Fehler, der hier das S3-Vectors-Limit für filterbare Metadaten war.
Wie halte ich die Knowledge Base aktuell?
Nach Zeitplan erneut scrapen, nur die Objekte schreiben, deren Inhalts-Hash sich geändert hat, und einen Ingestion-Job starten. Diese Hash-Prüfung verhindert, dass Bedrock eine unveränderte Seite neu einbettet. Den Zeitplan daran anpassen, wie schnell die Quellen zerfallen, von täglich für Nachrichten bis wöchentlich oder langsamer für Dokumentation.
Wie viele Fragen braucht ein goldener Datensatz?
Weniger als man erwartet, und die Fragen müssen echt sein. Fragen, die man dem entnimmt, was Nutzer tatsächlich fragen, schlagen erfundene, denn der Zweck ist, zu finden, was der Korpus nicht fundieren kann, statt eine Zahl zu erzeugen. Eine hinzufügen, wann immer jemand eine schlechte Antwort meldet, und der Datensatz wird zu einer Regressionssuite.
Wie viel kostet der Betrieb davon?
Die Hauptkosten sind Bright-Data-Anfragen, die mit Seiten mal Aktualisierungshäufigkeit skalieren, plus der Vektorspeicher sowie Embedding und Generierung pro Token. S3 Vectors ist Pay-as-you-go und eignet sich für geplante Aktualisierung, während eine klassische OpenSearch-Serverless-Collection selbst im Leerlauf kostet. Das 6-seitige Pilotprojekt hier kostete etwa 4 Cent im Monat bei wöchentlicher Aktualisierung.