In diesem Tutorial erfährst du:
- Das Datenanalyse-Szenario zur Untersuchung des Immobilienmarkts in San Diego.
- Warum das Python SDK von Bright Data den Zugriff auf strukturierte, einsatzbereite Datensätze vereinfacht.
- Wie man Zillow-Immobilienverkaufsdaten filtert, abruft und exportiert.
- Wie man die Daten bereinigt, Einheiten standardisiert und nützliche Kennzahlen berechnet.
- Wie man Verkaufspreise, geografische Trends, Zestimate-Genauigkeit und geschätzte Mietrenditen visualisiert.
Legen wir los!
Das Szenario vorstellen
Stell dir vor, du bist Datenanalyst und sollst den Immobilienmarkt in San Diego verstehen. Du möchtest zentrale Fragen beantworten, wie zum Beispiel: Zu welchen Preisen werden Häuser tatsächlich verkauft? Welche Stadtteile haben die höchsten Preise pro Quadratmeter? Und wie genau sagen Zillows Schätzungen die endgültigen Verkaufspreise voraus?
Dafür benötigst du einen aktuellen, zuverlässigen und umfangreichen Datensatz verkaufter Häuser. Für ähnliche Aufgaben bietet Bright Data Zugriff auf einen Zillow-Immobiliendatensatz mit mehr als 137 Millionen Datensätzen.
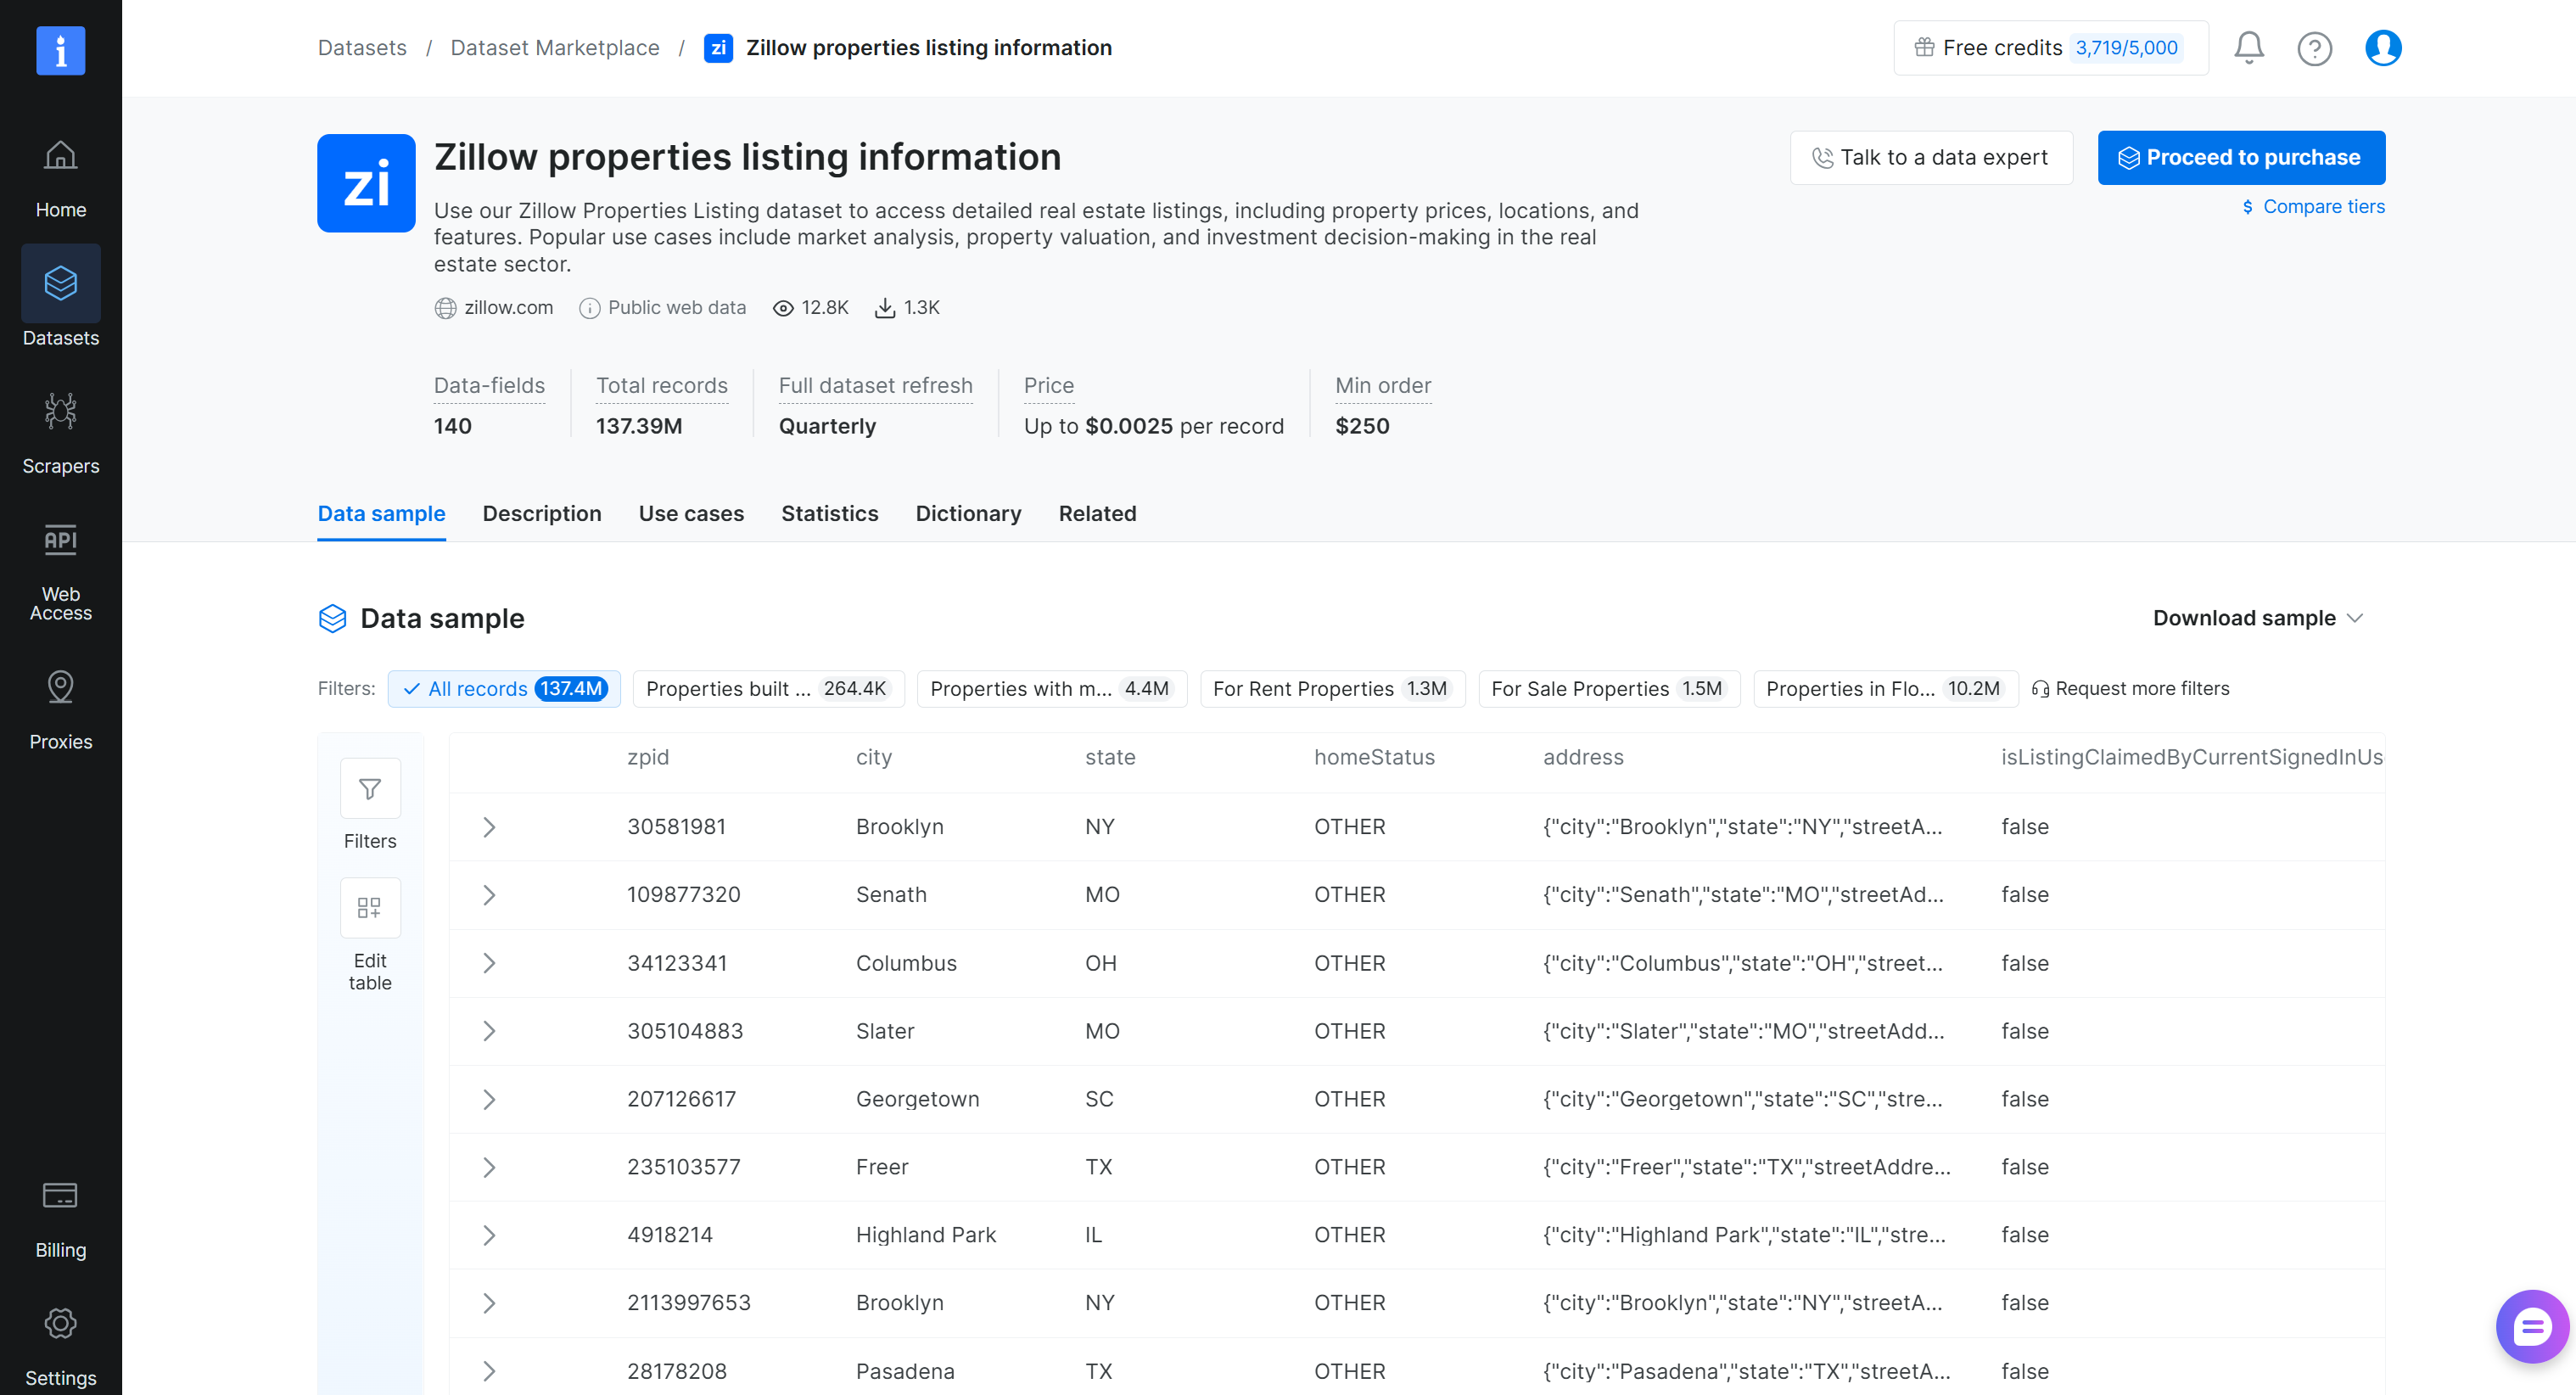
In den folgenden Schritten lernst du, wie du das Bright Data Python SDK verwendest, um einen gefilterten Snapshot dieses Datensatzes abzurufen, der nur die für das Szenario relevanten Datensätze enthält. Anschließend lädst du die Daten in pandas und erstellst ein Jupyter Notebook mit den Diagrammen und Analysen, die zur Beantwortung deiner Fragen nötig sind.
Dabei siehst du auch, wie man die Daten bereinigt, Maßeinheiten standardisiert und abgeleitete Kennzahlen berechnet, um faire und aussagekräftige Vergleiche zwischen Stadtteilen zu gewährleisten.
Warum das Bright Data Python SDK verwenden?
Bright Data ist eine führende Website für Datensätze, insbesondere als Anbieter von Immobiliendatensätzen. Es bietet eine umfangreiche Sammlung strukturierter und regelmäßig aktualisierter Datensätze mit Milliarden von Datensätzen öffentlich verfügbarer Webdaten.
Bei der Arbeit an einem Datenanalyse- und/oder Visualisierungsprojekt besteht der erste Schritt darin, die benötigten Daten zu beschaffen. Es gibt zwei Hauptansätze:
- Daten bei Bedarf sammeln: Erstelle und führe Web-Scraping-Workflows aus, um die benötigten Informationen direkt von Websites zu extrahieren.
- Vorhandene Datensätze nutzen: Hole dir gefilterte, bereits gesammelte Datensätze, die analysebereit sind.
Das Bright Data Python SDK unterstützt beide Ansätze. Es bietet eine vereinfachte, typisierte Python-Schnittstelle für den Zugriff auf die Webdaten-Sammellösungen von Bright Data und praktische Methoden, um strukturierte Datensätze direkt aus dem Bright Data Marketplace zu beziehen.
Weitere Informationen findest du in den folgenden Ressourcen:
- Python SDK-Dokumentation
- Python SDK-Repository
- Das Bright Data Python SDK kennenlernen: Scrapen, Suchen und Webdaten abrufen
Die Daten für Analyse und Visualisierung abrufen
Folge den unten stehenden Schritten, um mit deinem Datenanalyse- und Visualisierungsprojekt zu beginnen, angefangen mit dem Datenabruf.
Voraussetzungen
Stelle sicher, dass du Folgendes hast:
- Python 3.10+ auf deinem lokalen Rechner installiert.
- Ein Bright Data-Konto mit konfiguriertem API-Schlüssel. Siehe wie du deinen Bright Data API-Schlüssel erhältst.
Führe den folgenden Befehl aus, um die in diesem Leitfaden verwendeten Python-Pakete zu installieren:
pip install brightdata-sdk jupyter pandas numpy matplotlib seaborn plotlyDiese Bibliotheken bieten die Werkzeuge, die zum Zugriff auf Bright Data-Datensätze, zur Bearbeitung und Analyse von Daten sowie zur Verarbeitung von Visualisierungen in einem Jupyter Notebook benötigt werden.
Um das Bright Data Python SDK zu authentifizieren, setze deinen API-Schlüssel in der Umgebungsvariable BRIGHTDATA_API_KEY. Unter macOS oder Linux führe aus:
export BRIGHTDATA_API_KEY="<DEIN_BRIGHT_DATA_API_SCHLUESSEL>"Unter Windows führe den folgenden Befehl in PowerShell aus:
$env:BRIGHTDATA_API_KEY="<DEIN_BRIGHT_DATA_API_SCHLUESSEL>"Ersetze <DEIN_BRIGHT_DATA_API_SCHLUESSEL> durch deinen tatsächlichen Bright Data API-Schlüssel.
Der Einfachheit halber gehen wir davon aus, dass du bereits ein lokales Python-Projekt mit einem eingerichteten Jupyter Notebook hast.
Die Zieldaten abrufen
Die relevanten Daten stammen aus dem Zillow-Immobilienlistendatensatz bei Bright Data.
In diesem Szenario nehmen wir an, dass dich nur Immobilien interessieren, die im letzten Jahr in San Diego verkauft wurden.
Erstelle in deinem Python-Projekt ein Skript, das das Bright Data SDK verwendet, um einen Datensatz-Snapshot mit deinen gewählten Filtern anzufordern, auf die Verfügbarkeit des Snapshots zu warten und die resultierenden Datensätze zu exportieren:
import asyncio
from datetime import date, timedelta
from brightdata import BrightDataClient
from brightdata.datasets import export

async def main():
    # Aktuelles Datum ermitteln
    today = date.today()
    # Beginn des interessierenden Verkaufszeitraums berechnen (letztes Jahr)
    one_year_ago = today - timedelta(days=365)

    # Filter definieren, die jedes zurückgegebene Haus erfüllen muss
    filters = {
        "operator": "and",
        "filters": [
            {
                # Nur Häuser in San Diego behalten
                "name": "city",
                "operator": "=",
                "value": "San Diego",
            },
            {
                # Nur Häuser in Kalifornien behalten
                "name": "state",
                "operator": "=",
                "value": "CA",
            },
            {
                # Nur verkaufte Angebote behalten
                "name": "homeStatus",
                "operator": "includes",
                "value": "SOLD",
            },
            {
                # Nur Verkäufe aus dem letzten Jahr behalten
                "name": "dateSold",
                "operator": ">=",
                "value": one_year_ago.isoformat(),
            },
        ],
    }

    async with BrightDataClient() as client:
        # Bis zu 1.000 Datensätze aus dem gefilterten Datensatz anfordern
        snapshot_id = await client.datasets.zillow_properties(
            filter=filters,
            records_limit=1000,
        )

        # Auf Abschluss des Snapshots warten und die Datensätze herunterladen
        data = await client.datasets.zillow_properties.download(
            snapshot_id,
            timeout=600 # Bis zu 10 Minuten warten
        )

        # Bestätigen, wie viele Datensätze heruntergeladen wurden
        print(f"Downloaded {len(data)} records")

        # Die Datensätze in einer CSV-Datei speichern
        export(data, "properties.csv")

if __name__ == "__main__":
    asyncio.run(main())
Das obige Skript fordert asynchron einen Datensatz-Snapshot an, wartet bis zu 10 Minuten auf den Abschluss, lädt die Datensätze herunter, meldet die Anzahl der abgerufenen Datensätze und exportiert sie in properties.csv, bereit zur Analyse in pandas.
Es verwendet das Bright Data SDK, um Zillow-Immobiliendatensätze abzurufen, die den angegebenen Filtern entsprechen: Häuser in San Diego, Kalifornien, die in den letzten 365 Tagen verkauft wurden. Im Hintergrund ruft das SDK die Bright Data Filter API auf, mit der du gefilterte Snapshots von Bright Data-Datensätzen abrufen kannst.
Beachte, dass das Datensatzlimit auf 1.000 gesetzt ist, du kannst es aber an deine Bedürfnisse anpassen. Du kannst auch neue Filter hinzufügen oder bestehende ändern, um den Datensatz zu verfeinern und nur die für deine Analyse relevanten Datensätze abzurufen.
Hinweis: Die Hilfsfunktion export() erkennt das Ausgabeformat anhand der Dateierweiterung, sodass .csv eine CSV-Datei erzeugt. Weitere unterstützte Datenexporte sind JSON, NDJSON und JSONL.
Den abgerufenen Datensatz erkunden
Führe das Datenabruf-Skript aus. Eine properties.csv-Datei erscheint in deinem Projektverzeichnis:
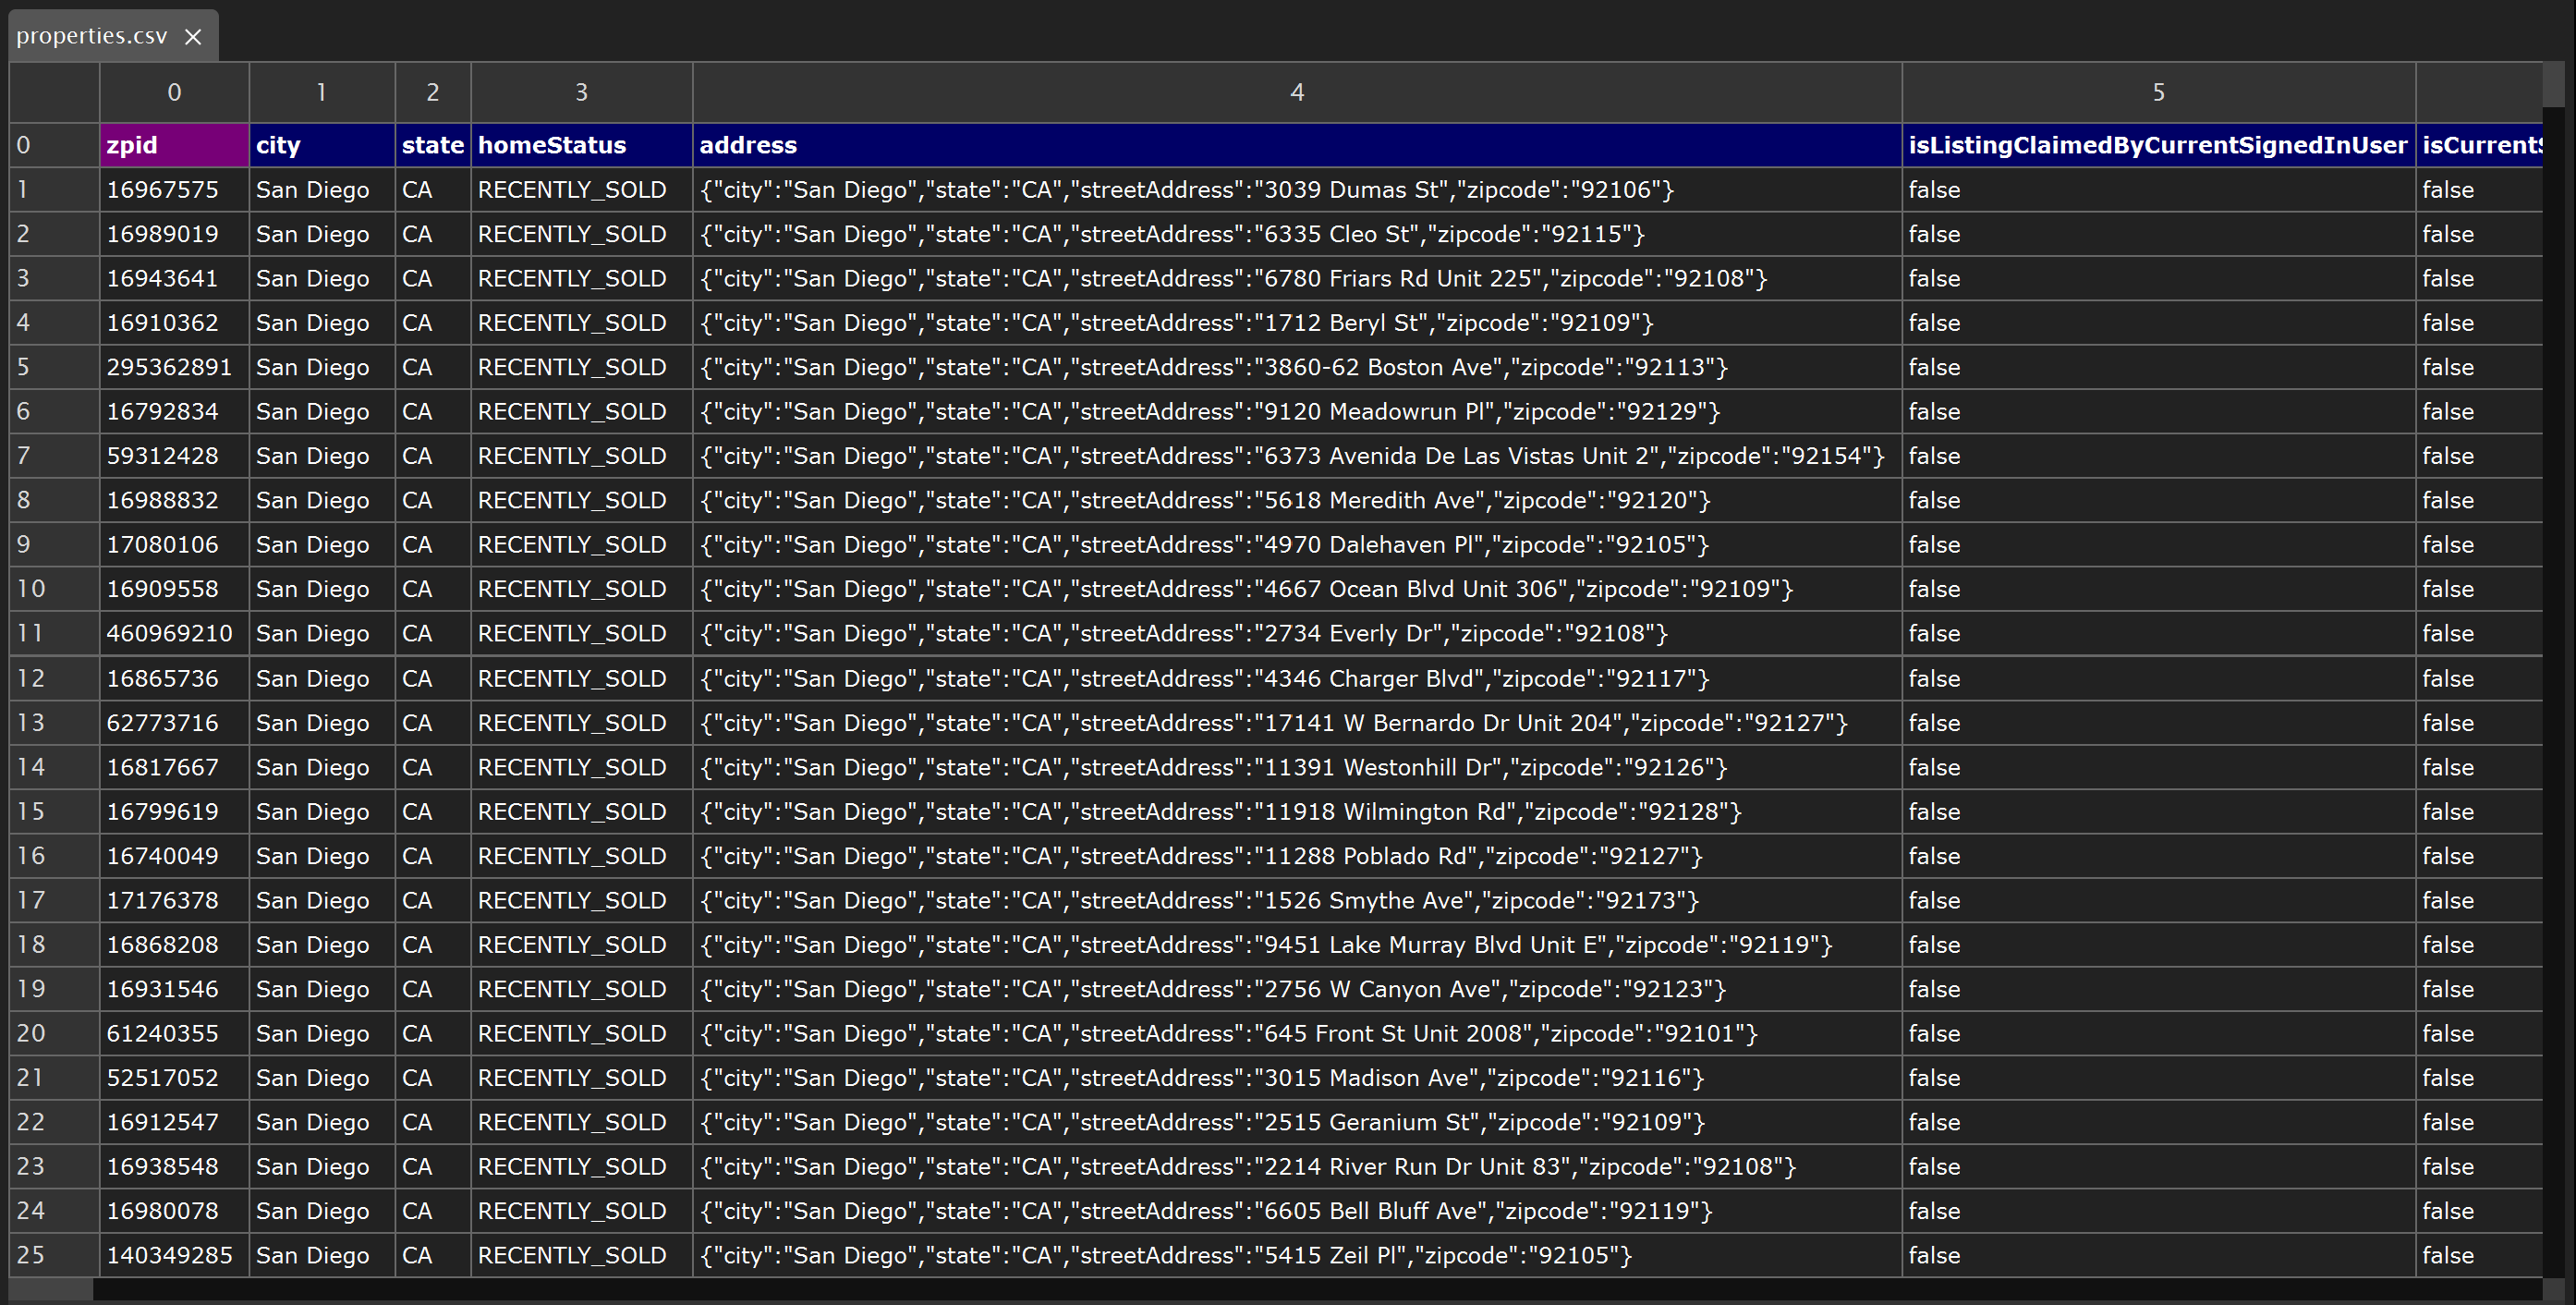
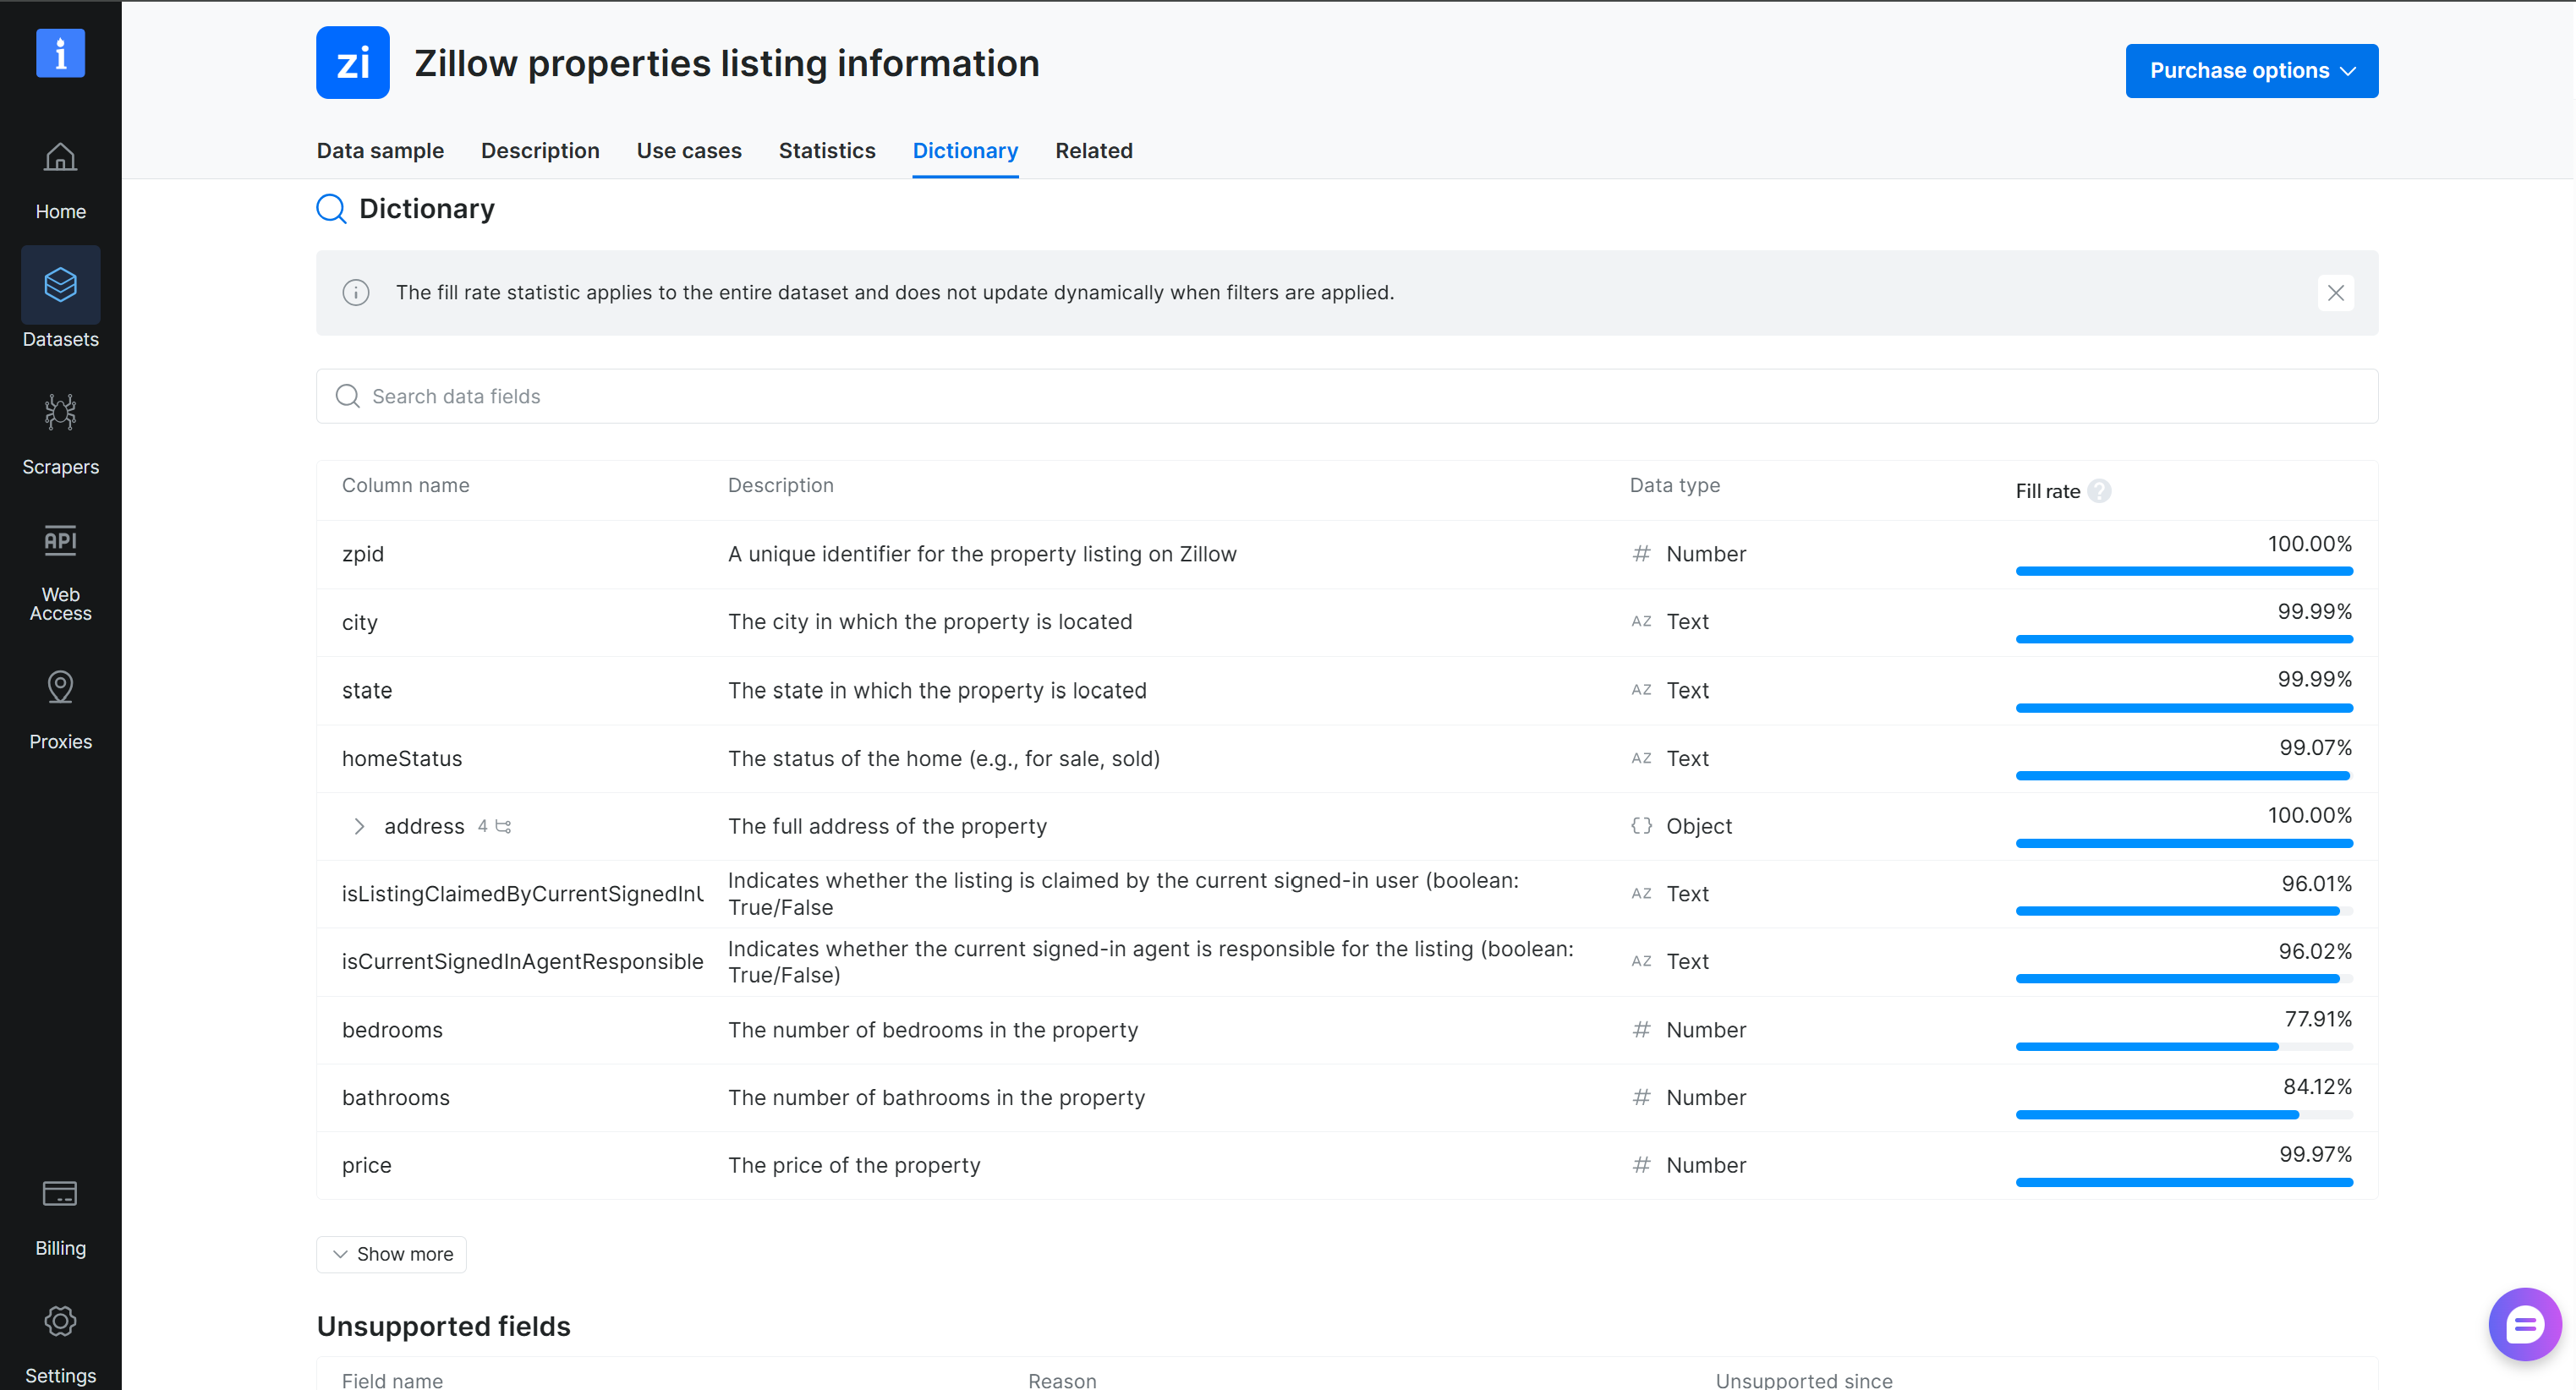
Öffne die Datei und du wirst die 1.000 zurückgegebenen Zillow-Immobiliendatensätze im strukturierten CSV-Format sehen. Jeder Datensatz enthält ungefähr 140 Spalten. Die relevantesten sind:
| Spalte | Beschreibung |
|---|---|
zipcode, latitude, longitude |
Standort des Hauses |
homeType |
Art der Immobilie, z. B. SINGLE_FAMILY oder CONDO |
bedrooms, bathrooms |
Anzahl der Schlafzimmer und Badezimmer |
price |
Verkaufspreis in USD |
livingAreaValue, livingAreaUnits |
Innenfläche und ihre Einheit |
lotAreaValue, lotAreaUnits |
Grundstücksgröße in Quadratfuß oder Acres |
yearBuilt |
Baujahr |
dateSoldString |
Verkaufsdatum (YYYY-MM-DD) |
daysOnZillow |
Wie lange das Angebot aktiv war |
zestimate, rentZestimate |
Zillows geschätzter Wert und monatliche Miete |
taxAssessedValue |
Für Grundsteuern verwendeter Wert |
Entdecke sie alle im Bereich “Dictionary” der Bright Data Control Panel-Seite für den Zillow-Immobilienlistendatensatz:
Mission erfüllt! Du hast jetzt die rohen, strukturierten Daten.
Als Nächstes lernst du, wie man sie für die Analyse und Visualisierung bereinigt und vorbereitet. Dann definierst du 10+ Szenarien, um den Immobilienmarkt in San Diego zu untersuchen und deine zentralen Fragen zu Verkaufspreisen, Erschwinglichkeit in Stadtteilen und der Genauigkeit von Zillow-Schätzungen zu beantworten.
Die Daten für Analyse und Visualisierung vorbereiten
Nachdem du den Datensatz abgerufen hast, öffne dein Notebook und bereite den Datensatz für die Datenanalyse vor. In einer eigenen Zelle führst du diese Aufgaben aus:
- Importiere die erforderlichen Bibliotheken für Datenmanipulation, statistische Analyse und Visualisierung.
- Konfiguriere die Einstellungen für die Datendarstellung.
- Lade den Datensatz, indem du
properties.csvin ein pandas DataFrame importierst. - Bereinige und standardisiere die Daten, indem du fehlende Werte behandelst, Datentypen korrigierst und Felder in einheitliche Formate umwandelst.
- Erstelle zusätzliche Variablen, um effektivere Analysen, Vergleiche und Visualisierungen zu ermöglichen.
Erledige diese Schritte mit:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
import plotly.express as px
from matplotlib.ticker import FuncFormatter
from IPython.display import display

# Achsenpreise als vollständige Zahlen anzeigen, z. B. 1.000.000
usd_fmt = FuncFormatter(lambda x, _: f"{x:,.0f}")

# Einen sauberen Rasterstil für alle Diagramme verwenden
sns.set_theme(style="whitegrid")

# Umrechnungsfaktor von Quadratfuß zu Quadratmeter
SQFT_TO_M2 = 0.092903
# Umrechnungsfaktor von Acres zu Quadratfuß
ACRE_TO_SQFT = 43560
# ZIP-Codes mit weniger Verkäufen als diesem Wert ignorieren
MIN_SALES = 3

# Die Spalten eines DataFrames als Text formatieren und dann als Tabelle anzeigen
def show_table(frame, formats, title=""):
    # Mit einer Kopie arbeiten, damit die Originaldaten unverändert bleiben
    out = frame.copy()
    # Jedes Format auf seine Spalte anwenden, fehlende Werte als Bindestrich anzeigen
    for col, fmt in formats.items():
        out[col] = out[col].map(lambda v, f=fmt: f.format(v) if pd.notna(v) else "-")
    # Eine Überschrift über der Tabelle anzeigen, wenn ein Titel angegeben ist
    if title:
        print(title)
    # Die formatierte Tabelle anzeigen
    display(out)

# Die CSV laden, ZIP-Codes als Text beibehalten
df = pd.read_csv("properties.csv", dtype={"zipcode": str})

# Die Spalten auflisten, die Zahlen sein sollten
numeric_cols = ["price", "bedrooms", "bathrooms", "livingAreaValue", "lotAreaValue",
                "yearBuilt", "daysOnZillow", "zestimate", "rentZestimate",
                "taxAssessedValue", "latitude", "longitude"]
# Diese Spalten in Zahlen umwandeln, ungültige Werte zu NaN machen
df[numeric_cols] = df[numeric_cols].apply(pd.to_numeric, errors="coerce")

# ZIP-Codes auf 5 Stellen auffüllen
df["zipcode"] = df["zipcode"].str.zfill(5)
# Den Verkaufsdatumstext in ein datetime-Objekt umwandeln
df["dateSold"] = pd.to_datetime(df["dateSoldString"])

# Die Zeilen finden, bei denen die Wohnfläche in Quadratfuß angegeben ist
is_sqft = df["livingAreaUnits"].eq("Square Feet")
# Quadratfuß in m² umrechnen, für andere Einheiten NaN belassen
df["living_area_m2"] = np.where(is_sqft, df["livingAreaValue"] * SQFT_TO_M2, np.nan)

# Grundstücksgrößen in Quadratfuß umrechnen, egal ob sie in Acres oder bereits in Quadratfuß waren
lot_sqft = np.where(df["lotAreaUnits"].eq("Acres"),
                    df["lotAreaValue"] * ACRE_TO_SQFT,
                    df["lotAreaValue"])
# Die Grundstücksgröße in Quadratmeter umrechnen
df["lot_m2"] = lot_sqft * SQFT_TO_M2

# Zeilen ohne gültigen Verkaufspreis entfernen
df = df[df["price"] > 0].copy()
# Den Verkaufspreis pro Quadratmeter berechnen
df["price_per_m2"] = df["price"] / df["living_area_m2"]
# Die Differenz zwischen Verkaufspreis und Zestimate als Prozentsatz berechnen
df["zestimate_error_pct"] = ((df["price"] - df["zestimate"])
                             / df["zestimate"].where(df["zestimate"] > 0) * 100)
# Die Jahresmiete als Prozentsatz des Verkaufspreises berechnen
df["rent_yield_pct"] = df["rentZestimate"] * 12 / df["price"] * 100
# Preise in Bänder gruppieren, beschriftet mit vollständigen Zahlen in USD
df["price_band"] = pd.cut(df["price"], bins=[0, 500_000, 1_000_000, 1_500_000, np.inf],
                          labels=["<500.000", "500.000-1.000.000",
                                  "1.000.000-1.500.000", ">1.500.000"])
# Häuser nach Bauepoche gruppieren
df["age_band"] = pd.cut(df["yearBuilt"], bins=[0, 1949, 1979, 1999, np.inf],
                        labels=["<1950", "1950-1979", "1980-1999", "2000+"])

# Zusammenfassen, wie viele Häuser und ZIP-Codes im bereinigten Datensatz enthalten sind
print(f"{len(df)} sold homes across {df['zipcode'].nunique()} ZIP codes")

# Eine Vorschau der wichtigsten Spalten mit formatierten Preisen und Flächen
show_table(
    # Die wichtigsten Spalten für die Vorschau auswählen
    df[["zpid", "streetAddress", "zipcode", "homeType", "bedrooms", "bathrooms",
        "price", "living_area_m2", "dateSold"]].head(),
    # Preise als vollständige Zahlen und Flächen mit einer Dezimalstelle formatieren
    formats={"price": "{:,.0f}", "living_area_m2": "{:,.1f} m²"},
    title="Sample of sold homes",
)
Führe es aus und du erhältst dieses Ergebnis:
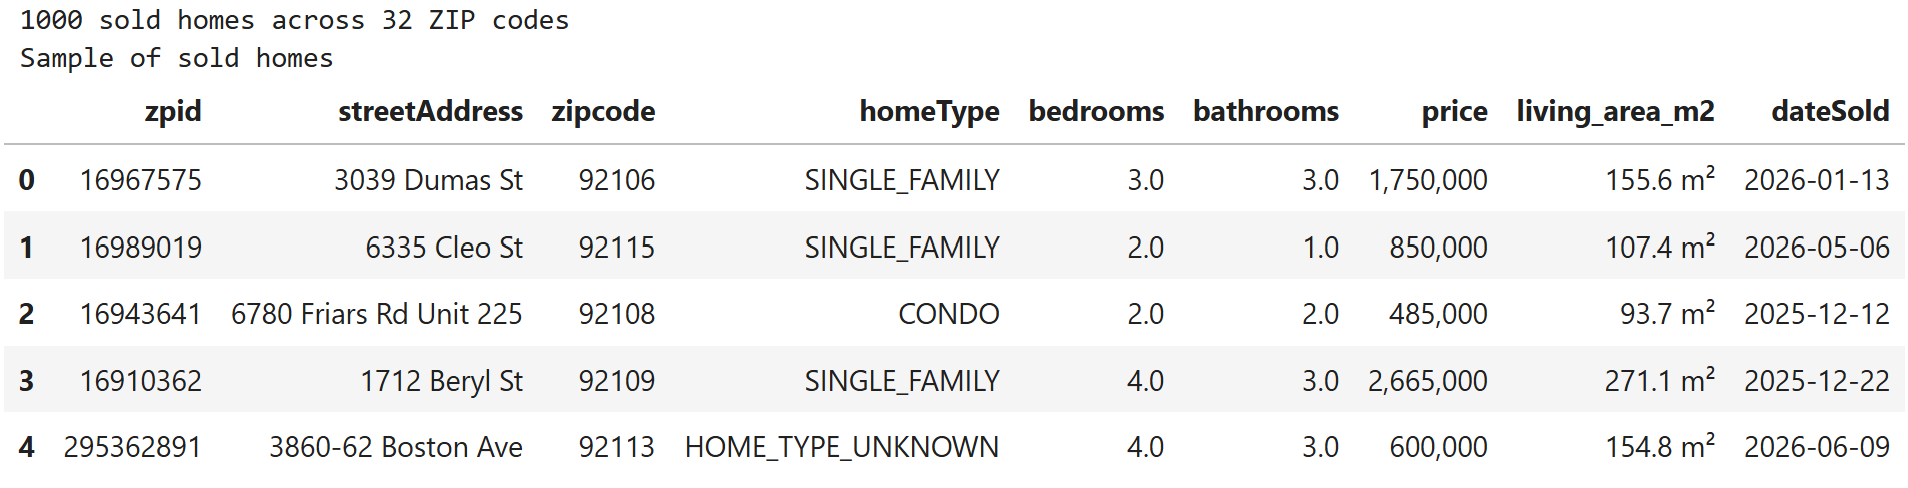
Bemerkenswert ist, dass die obige Zelle sich kümmert um:
- Normalisierung der Maßeinheiten: Wohnflächen und Grundstücksgrößen werden in Quadratmeter umgerechnet, sodass jede größenbasierte Kennzahl dieselbe Einheit verwendet.
- Behandlung fehlender Werte: Zestimate-Fehler werden nur berechnet, wenn der Zestimate größer als null ist, was eine Division durch null vermeidet.
- Hinzufügen abgeleiteter Felder: Preis pro m², Mietrendite, Preisbänder und Altersbänder werden als Spalten hinzugefügt, um die Datenvisualisierung zu vereinfachen.
Fantastisch! Du bist bereit, mit der Datenanalyse und Visualisierung fortzufahren.
Analyse und Visualisierung
Hier siehst du 10+ praktische Methoden, den Datensatz zu untersuchen und zu visualisieren, um Muster und Erkenntnisse über den Immobilienmarkt in San Diego aufzudecken. Jeder Abschnitt enthält einen kurzen Überblick, den Zellcode, das resultierende Ergebnis und eine Interpretation der Befunde.
Verteilung der Verkaufspreise
Beschreibung: Untersuche, wo die meisten Verkaufspreise liegen, mit markiertem Median, damit du siehst, wie schief der Markt ist.
Zelle:
plt.figure(figsize=(10, 6))

# Ein Histogramm der Preise mit geglätteter Dichtekurve zeichnen
sns.histplot(df["price"], bins=30, kde=True, color="steelblue")

# Den Median-Verkaufspreis berechnen
median = df["price"].median()

# Eine gestrichelte rote Linie beim Median zeichnen, beschriftet mit der vollständigen Zahl
plt.axvline(median, color="red", linestyle="--", label=f"Median: {median:,.0f} USD")
# X-Achsen-Preise als vollständige Zahlen anzeigen
plt.gca().xaxis.set_major_formatter(usd_fmt)

plt.title("Distribution of Sold Prices in San Diego")
plt.xlabel("Sold price (USD)")
# Automatisches Übergehen auf der x-Achse entfernen
plt.xlim(left=0)
plt.ylabel("Number of homes")
plt.legend()
plt.show()Ergebnis:
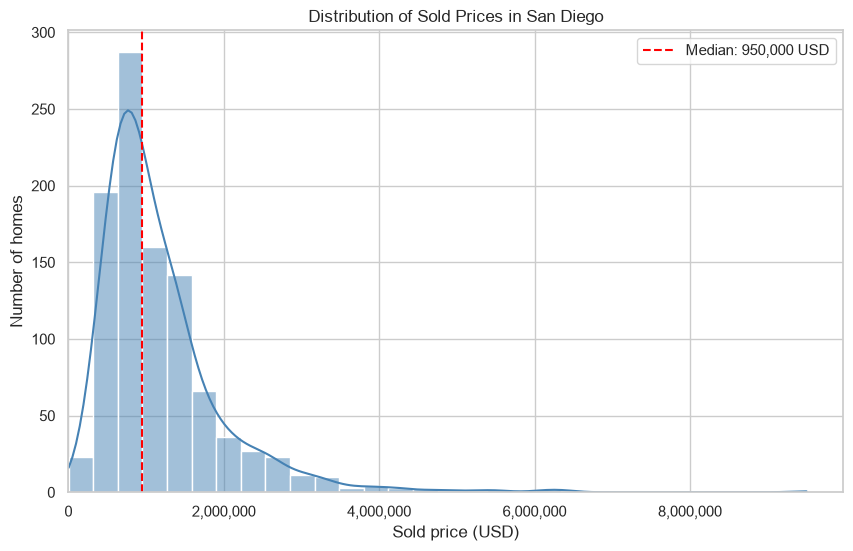
Kommentar: Die meisten Verkäufe häufen sich zwischen etwa 500.000 und 1.500.000 USD, mit einem Höhepunkt bei etwa 750.000 USD, während der Median von 950.000 USD höher liegt. Ein langer Ausläufer reicht bis fast 9.500.000 USD. Die Verteilung ist rechtsschief, was den Mittelwert über den Median zieht.
Medianpreis nach Immobilientyp
Beschreibung: Vergleiche den Median- und Durchschnittsverkaufspreis über verschiedene Immobilientypen hinweg, um zu sehen, welche Haustypen den Markt antreiben.
Zelle:
# Verkäufe nach Immobilientyp gruppieren und zusammenfassende Statistiken berechnen
by_type = (df.groupby("homeType")
             # Die Häuser zählen und den Median- und Durchschnittspreis für jeden Typ ermitteln
             .agg(homes=("zpid", "count"),
                  median_price=("price", "median"),
                  mean_price=("price", "mean"))
             # Die Typen vom höchsten zum niedrigsten Medianpreis sortieren
             .sort_values("median_price", ascending=False))

show_table(by_type.reset_index(),
           formats={"median_price": "{:,.0f}", "mean_price": "{:,.0f}"},
           title="Sold price by home type (USD)")

plt.figure(figsize=(10, 6))
sns.barplot(data=by_type.reset_index(), x="homeType", y="median_price", color="steelblue")
plt.gca().yaxis.set_major_formatter(usd_fmt)
plt.xticks(rotation=30)
plt.title("Median Sold Price by Home Type")
plt.xlabel("Home type")
plt.ylabel("Median price (USD)")
plt.show()Ergebnis:
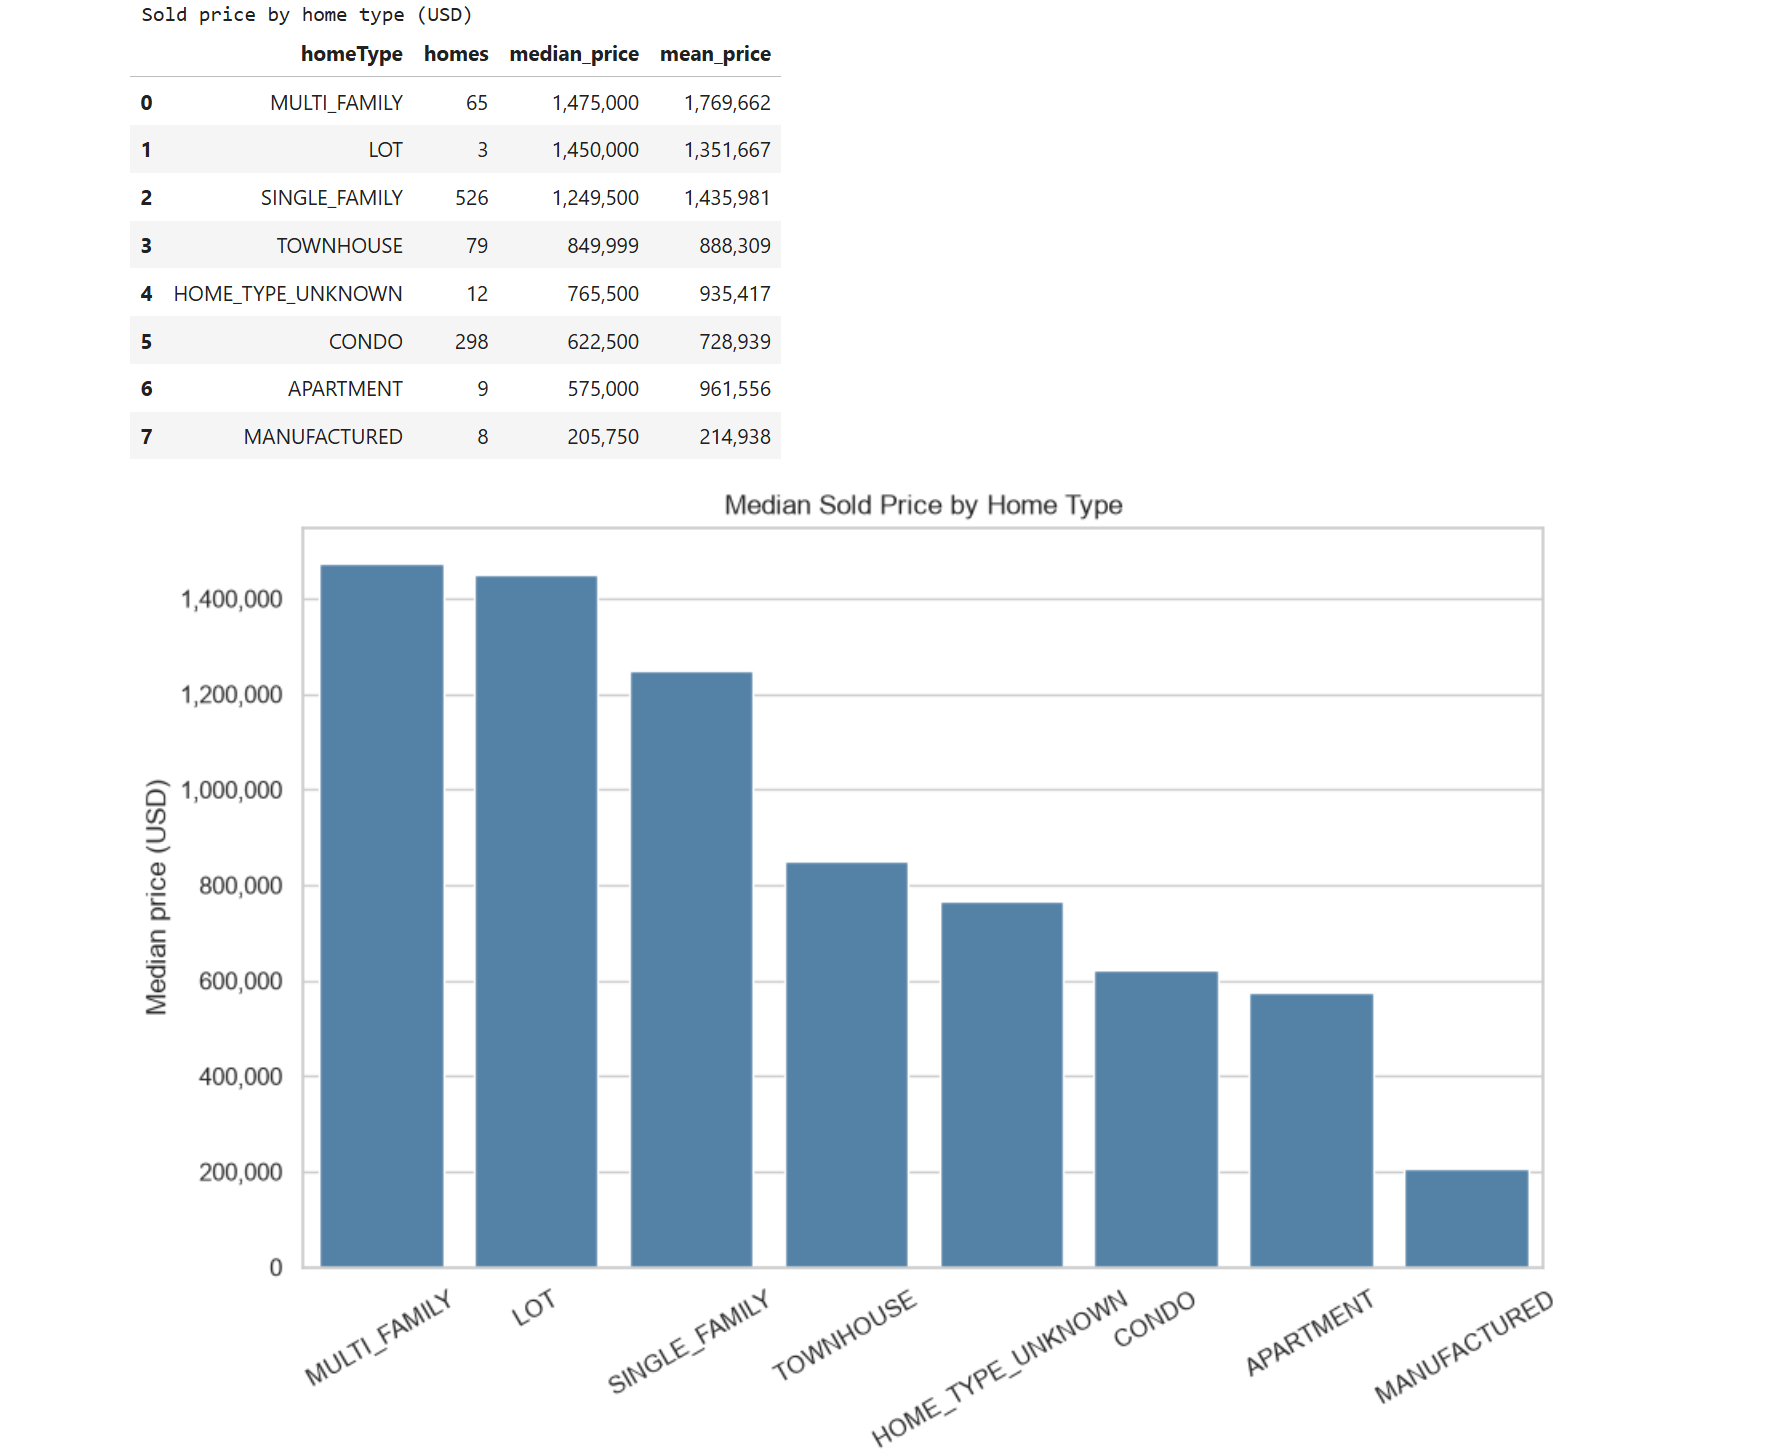
Kommentar: Einfamilienhäuser sind der zuverlässigste Maßstab, mit einem Median von 1.249.500 USD bei 526 Verkäufen. Mehrfamilienhäuser und Grundstücksmediane wirken höher, basieren aber auf weit weniger Verkäufen (65 bzw. 3), während Fertighäuser mit 205.750 USD am günstigsten sind und Eigentumswohnungen bei 622.500 USD liegen.
Top-ZIP-Codes nach Medianverkaufspreis
Beschreibung: Ranke die 15 teuersten ZIP-Codes nach Medianverkaufspreis. ZIP-Codes mit sehr wenigen Verkäufen werden ausgeschlossen, um irreführende Mediane zu vermeiden.
Zelle:
# Verkäufe nach ZIP-Code gruppieren und die Verkaufsanzahl und den Medianpreis berechnen
zip_stats = (df.groupby("zipcode")
               .agg(sales=("zpid", "count"), median_price=("price", "median"))
               # ZIP-Codes mit zu wenigen Verkäufen entfernen
               .query("sales >= @MIN_SALES")
               # Vom teuersten zum günstigsten sortieren
               .sort_values("median_price", ascending=False)
               # Nur die Top 15 behalten
               .head(15)
               # Den ZIP-Code-Index wieder in eine Spalte umwandeln
               .reset_index())

show_table(zip_stats,
           formats={"median_price": "{:,.0f}"},
           title=f"Top 15 ZIP codes by median sold price (min. {MIN_SALES} sales)")

plt.figure(figsize=(10, 7))
sns.barplot(data=zip_stats, x="median_price", y="zipcode", color="steelblue")
plt.gca().xaxis.set_major_formatter(usd_fmt)
plt.title(f"Top 15 ZIP Codes by Median Sold Price (min. {MIN_SALES} sales)")
plt.xlabel("Median price (USD)")
plt.ylabel("ZIP code")
plt.show()Ergebnisse:
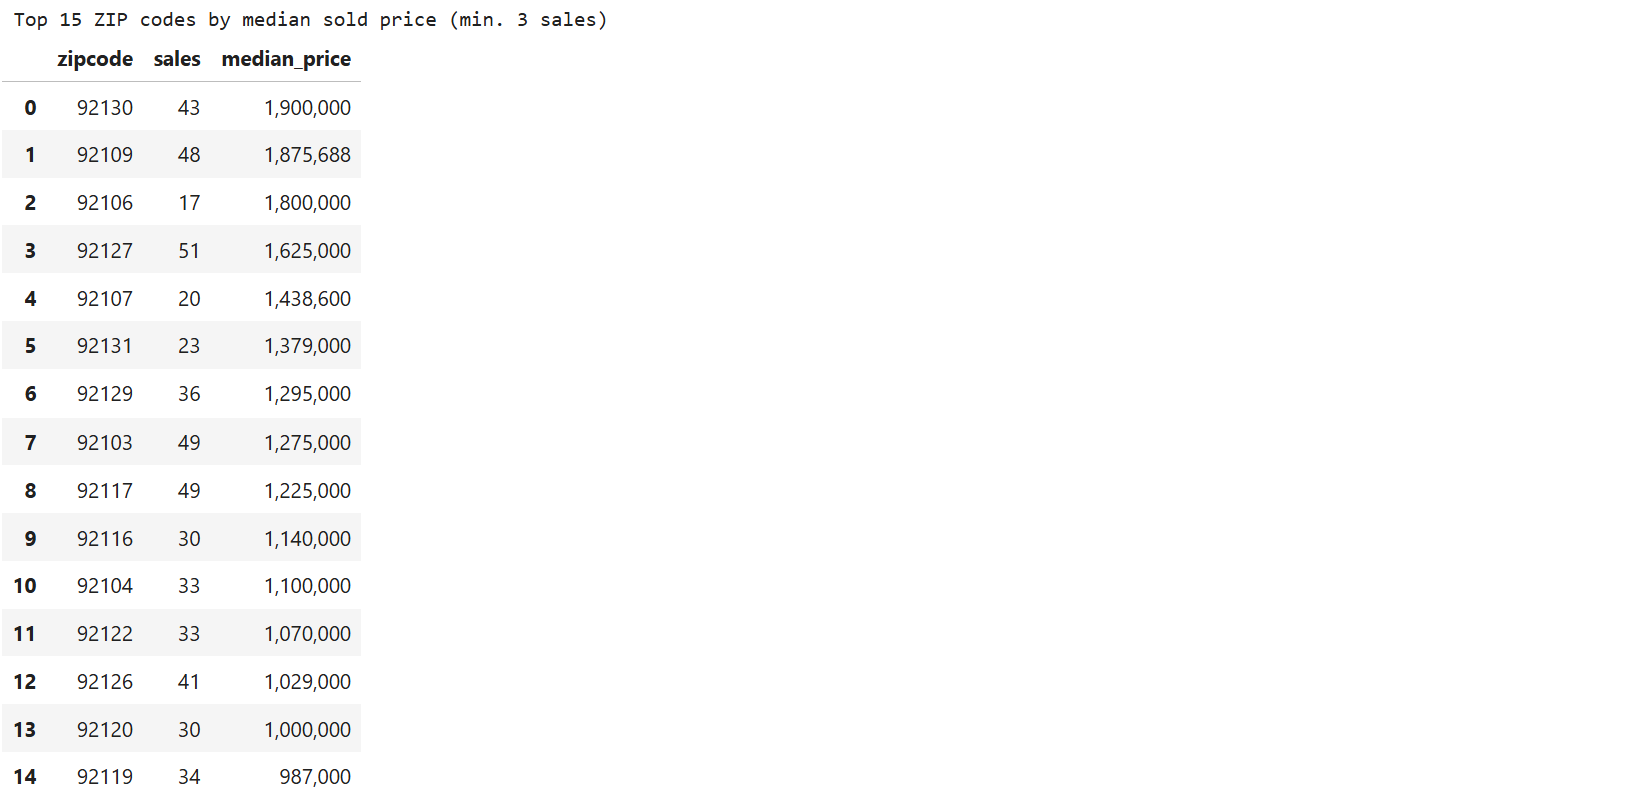
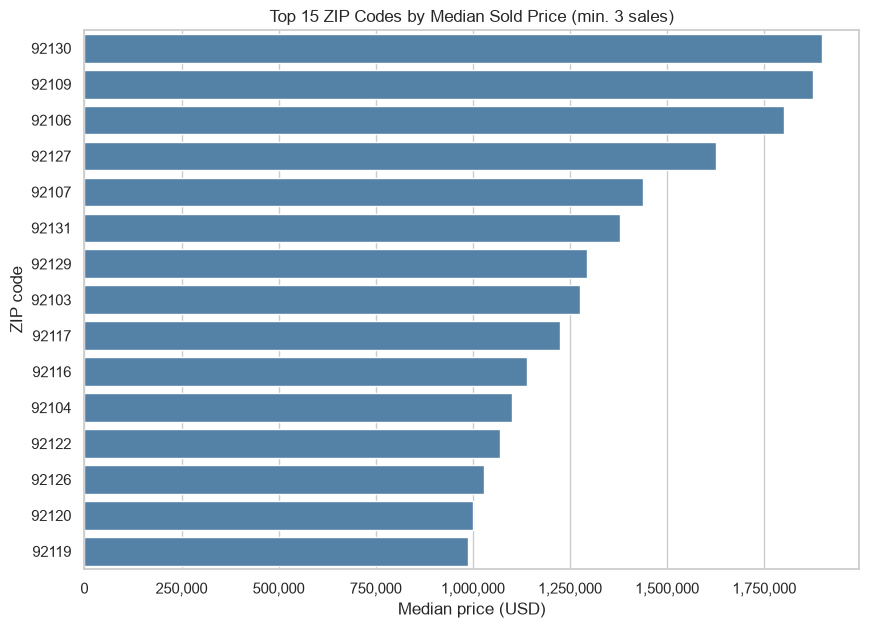
Kommentar: 92130, 92109 und 92106 führen mit Medianen von mindestens 1.800.000 USD. 92118 (Coronado) hat den höchsten Median mit über 3.300.000 USD, aber zu wenige Verkäufe, um gewertet zu werden. 92106 basiert auf nur 17 Verkäufen, sodass sich seine Position noch ändern kann.
Karte der Verkaufsorte
Beschreibung: Stelle jeden Verkauf auf einer Karte dar, farblich nach Verkaufspreis, um zu sehen, wo die teuersten Häuser liegen.
Zelle:
# Die Originaldaten kopieren
map_df = df.copy()

for col in ["latitude", "longitude", "price"]:
    map_df[col] = pd.to_numeric(map_df[col], errors="coerce")

# Zeilen mit gültigen Koordinaten und Verkaufspreisen behalten
map_df = map_df.dropna(subset=["latitude", "longitude", "price"])

fig = px.scatter_map(
    map_df,
    lat="latitude",
    lon="longitude",
    color="price",
    hover_name="streetAddress",
    hover_data={
        "zipcode": True,
        "homeType": True,
        "bedrooms": True,
        "price": ":,.0f",
        "latitude": False,
        "longitude": False,
    },
    labels={
        "price": "Sold price (USD)",
    },
    color_continuous_scale="Viridis",

    center={"lat": 32.8157, "lon": -117.1611},
    zoom=8.8,
    height=650,
    map_style="open-street-map",
    title="Where Homes Sold in San Diego (color = sold price in USD)",
)

fig.show(renderer="notebook")

# Geografische Grenzwerte definieren
longitude_cutoff = -117.2
latitude_cutoff = 32.8

# Immobilien in westliche und östliche Gruppen unterteilen
west = geo_df[geo_df["longitude"] < longitude_cutoff]
east = geo_df[geo_df["longitude"] >= longitude_cutoff]

# Immobilien in nördliche und südliche Gruppen unterteilen
north = geo_df[geo_df["latitude"] >= latitude_cutoff]
south = geo_df[geo_df["latitude"] < latitude_cutoff]

# Medianpreise und Stichprobengrößen anzeigen
print("WESTERN VS. EASTERN PROPERTIES")
print("-" * 40)
print(f"West of longitude {longitude_cutoff}:")
print(f"  Median sold price: ${west['price'].median():,.0f}")
print(f"  Number of properties: {len(west):,}")

print(f"\nEast of or at longitude {longitude_cutoff}:")
print(f"  Median sold price: ${east['price'].median():,.0f}")
print(f"  Number of properties: {len(east):,}")

print("\nNORTHERN VS. SOUTHERN PROPERTIES")
print("-" * 40)
print(f"North of or at latitude {latitude_cutoff}:")
print(f"  Median sold price: ${north['price'].median():,.0f}")
print(f"  Number of properties: {len(north):,}")

print(f"\nSouth of latitude {latitude_cutoff}:")
print(f"  Median sold price: ${south['price'].median():,.0f}")
print(f" Number of properties: {len(south):,}")Ergebnisse:
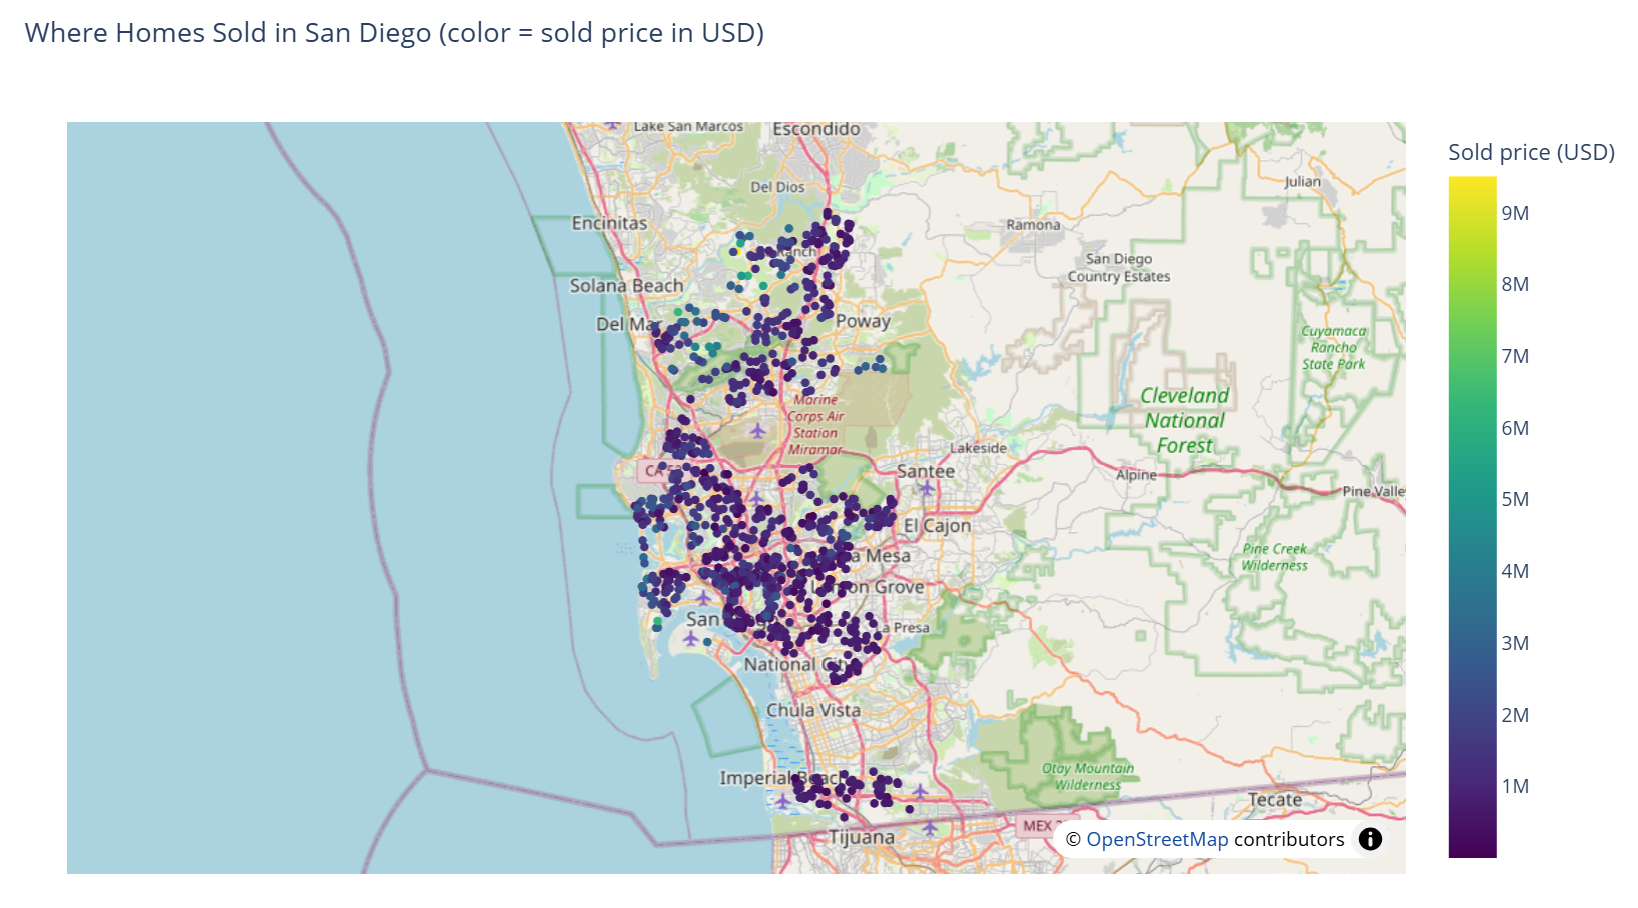
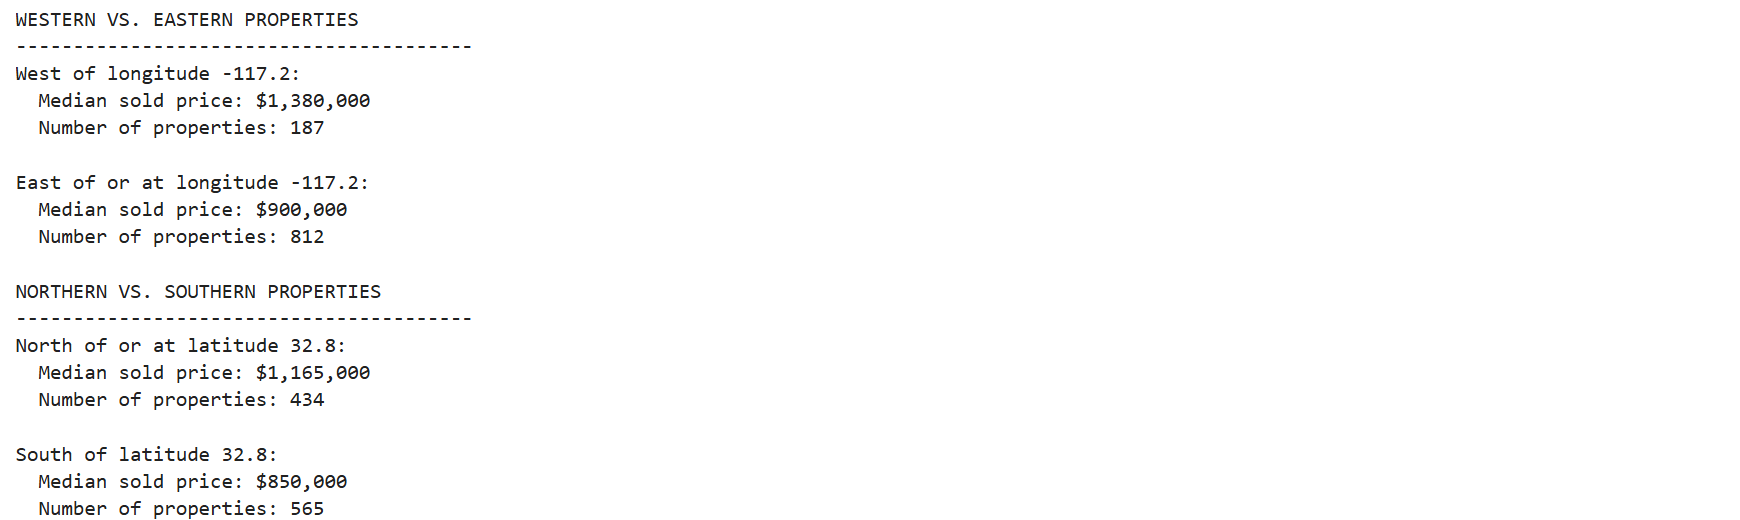
Kommentar: Häuser westlich des Längengrads -117,2 haben einen Median von etwa 1.380.000 USD, gegenüber 900.000 USD im Landesinneren. Verkäufe im Norden (Median 1.165.000 USD) sind deutlich teurer als im Süden (850.000 USD).
Preis pro m² nach ZIP-Code
Beschreibung: Vergleiche die Streuung des Preises pro Quadratmeter über die 10 ZIP-Codes mit den meisten Verkäufen.
Zelle:
# Die 10 ZIP-Codes mit den meisten Verkäufen finden
top_zips = df["zipcode"].value_counts().head(10).index
# Verkäufe in diesen ZIP-Codes behalten, die einen gültigen Preis pro m² haben
zip_m2 = df[df["zipcode"].isin(top_zips)].dropna(subset=["price_per_m2"])
# Die ZIP-Codes nach ihrem Medianpreis pro m² ordnen, höchster zuerst
order = (zip_m2.groupby("zipcode")["price_per_m2"]
               # Den Medianpreis pro m² für jeden ZIP-Code ermitteln
               .median()
               # Vom höchsten zum niedrigsten sortieren
               .sort_values(ascending=False)
               # Die ZIP-Codes in dieser Reihenfolge behalten
               .index)

plt.figure(figsize=(12, 6))
sns.boxplot(data=zip_m2, x="zipcode", y="price_per_m2", order=order,
            hue="zipcode", legend=False, palette="Set2", showfliers=False)
plt.gca().yaxis.set_major_formatter(usd_fmt)
plt.title("Sold Price per m² in the 10 Most Active ZIP Codes")
plt.xlabel("ZIP code")
plt.ylabel("Price per m² (USD)")
plt.show()Ergebnis:
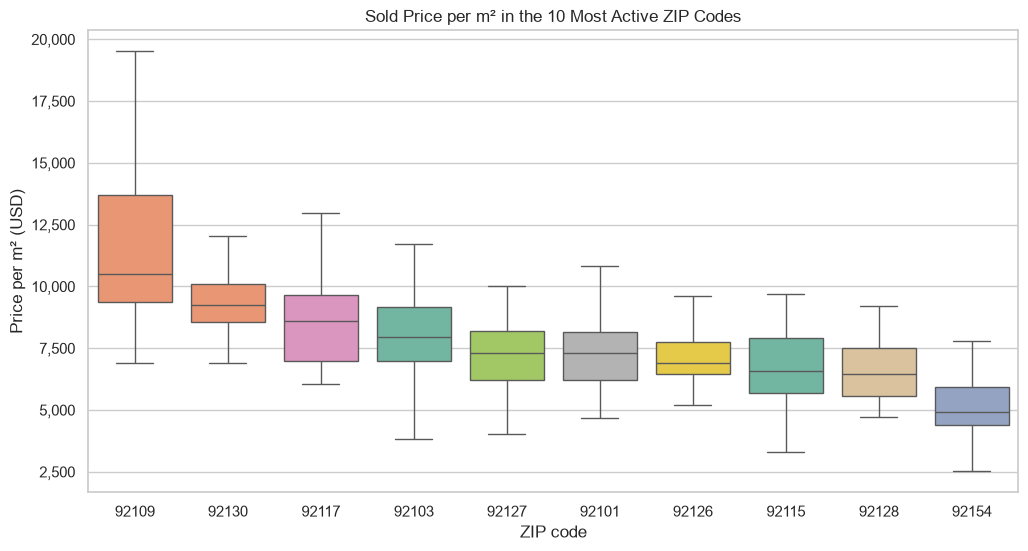
Kommentar: 92109 hat den höchsten Medianpreis pro m² (etwa 10.500 USD) und die breiteste Streuung. 92154 ist mit etwa 4.900 USD am günstigsten.
Preis pro m² vs. Wohnfläche nach ZIP-Code für Einfamilienhäuser
Beschreibung: Prüfe, ob größere Einfamilienhäuser je nach ZIP-Code zu einem niedrigeren Preis pro Quadratmeter verkauft werden.
Zelle:
# Nur Einfamilienhäuser mit sowohl einem Preis pro m² als auch einer Wohnfläche behalten
d = df[
    (df["homeType"] == "SINGLE_FAMILY")
].dropna(subset=["price_per_m2", "living_area_m2"]).copy()

# Die 10 aktivsten ZIP-Codes als eigene Gruppen behalten und den Rest in "Other" einordnen
d["zip_group"] = np.where(d["zipcode"].isin(top_zips), d["zipcode"], "Other")

zip_order = list(top_zips) + ["Other"]

fig = px.scatter(
    d,
    x="living_area_m2",
    y="price_per_m2",
    facet_col="zip_group",
    facet_col_wrap=4,
    category_orders={"zip_group": zip_order},
    hover_data={
        "zipcode": True,
        "price": ":,.0f",
        "living_area_m2": ":,.1f",
        "zip_group": False,
    },
    labels={
        "living_area_m2": "Living area (m²)",
        "price_per_m2": "Price per m² (USD)",
        "price": "Sold price (USD)",
    },
    height=1200,
    title="Price per m² vs. Living Area for Single-Family Homes by ZIP Code",
)

fig.for_each_annotation(
    lambda a: a.update(text=a.text.split("=")[-1])
)

fig.update_xaxes(
    matches=None,
    showticklabels=True,
    showline=True,
    tickformat=",.0f",
    title_text="Living area (m²)",
)

fig.update_yaxes(
    tickformat=",.0f",
    title_text="Price per m² (USD)",
)

fig.show(renderer="notebook")Ergebnis:
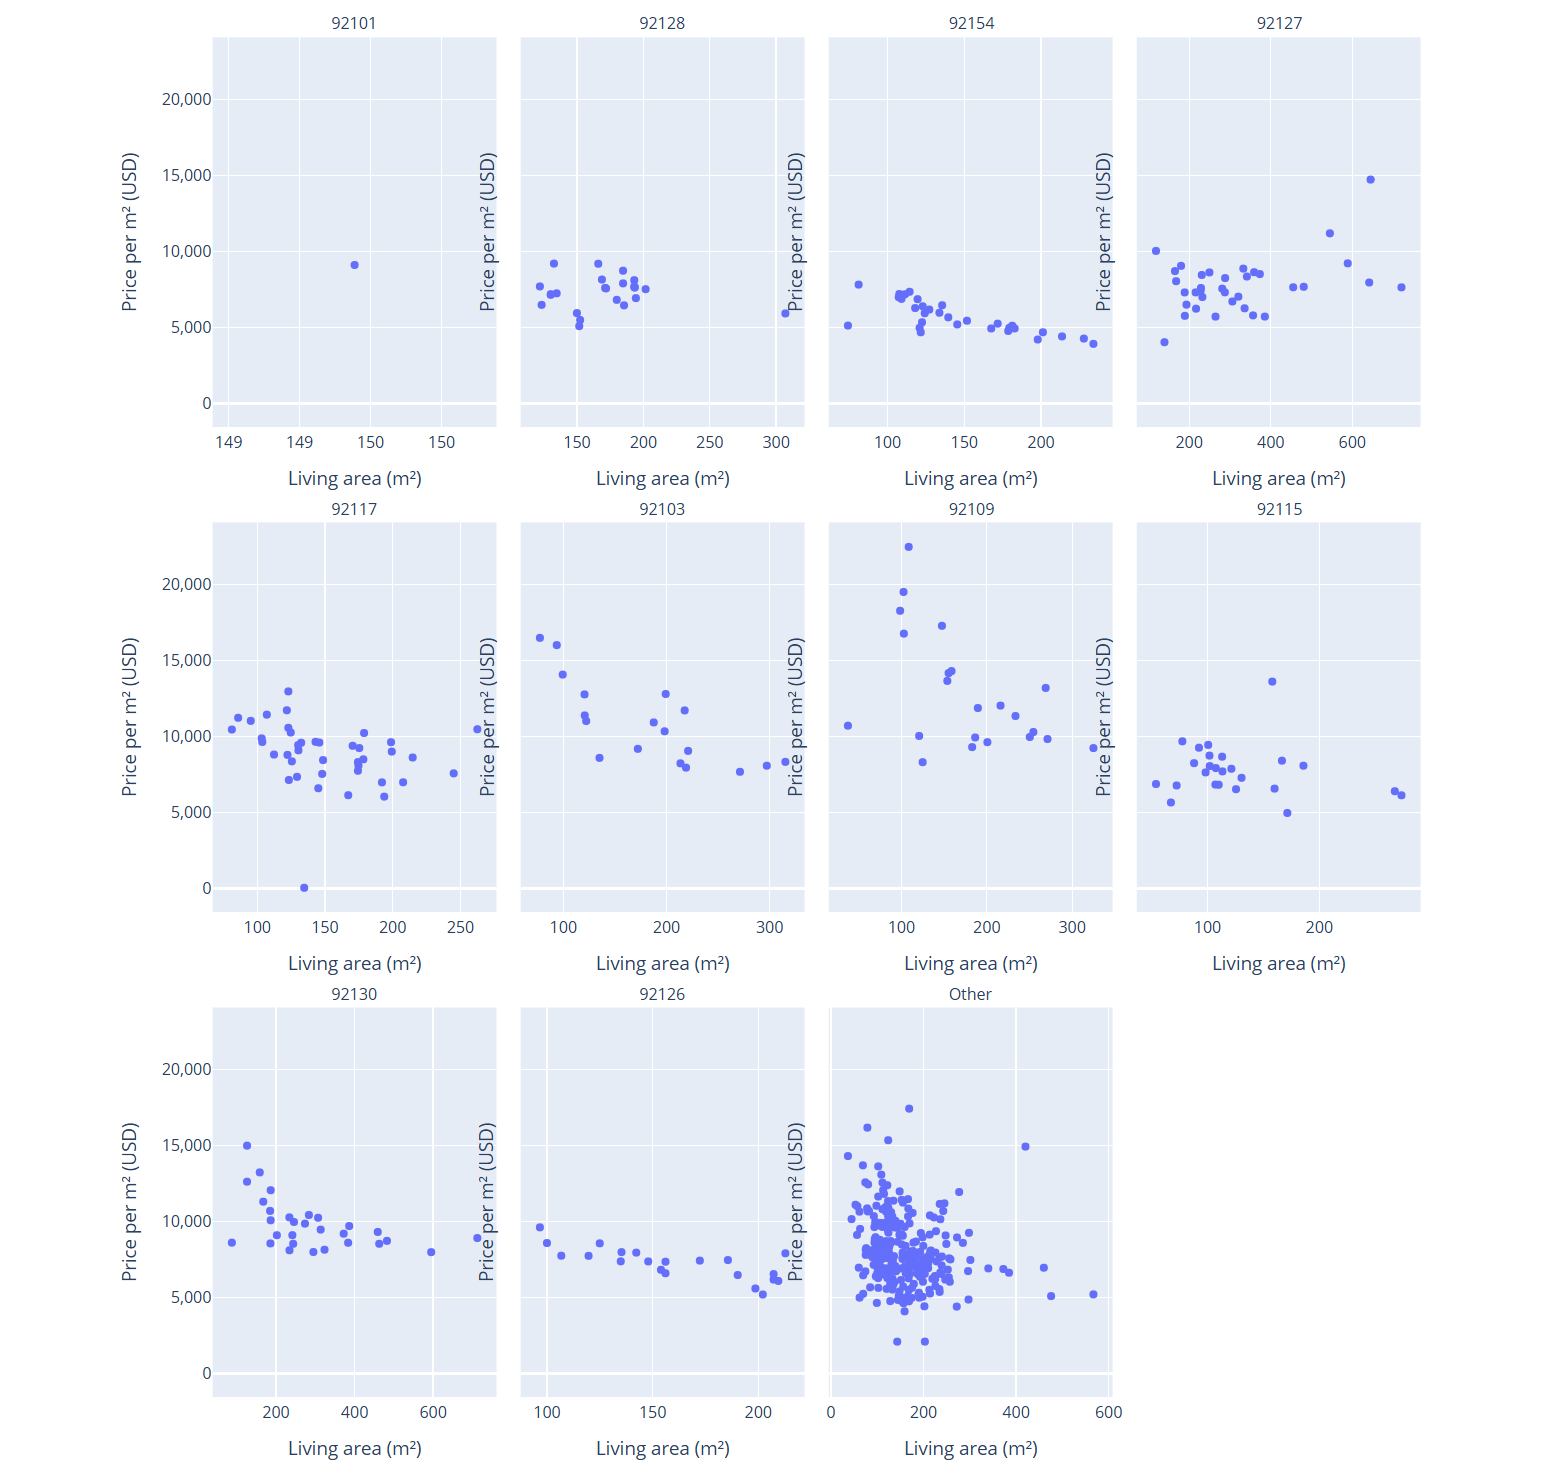
Kommentar: Einige ZIP-Codes (z. B. 92154, 92126, 92103) zeigen, dass größere Häuser weniger pro m² kosten. 92127 ist die Ausnahme mit steigendem Trend. Insgesamt scheint die Korrelation nahe null zu sein, sodass der Stadtteil wichtiger ist als die Größe.
Korrelationsmatrix der Hausmerkmale
Beschreibung: Prüfe die Pearson-Korrelation zwischen Preis und den wichtigsten physischen und listenbezogenen Merkmalen.
Zelle:
corr_cols = {
    # Verkaufspreis in USD
    "price": "Price",
    # Anzahl der Schlafzimmer
    "bedrooms": "Bedrooms",
    # Anzahl der Badezimmer
    "bathrooms": "Bathrooms",
    "living_area_m2": "Living area",
    "lot_m2": "Lot size",
    # Baujahr
    "yearBuilt": "Year built",
    # Zillows geschätzter Wert
    "zestimate": "Zestimate",
    # Bewerteter Wert für Steuern
    "taxAssessedValue": "Tax assessed value",
}
# Paarweise Pearson-Korrelationen zwischen den umbenannten Spalten berechnen
corr = df[list(corr_cols)].rename(columns=corr_cols).corr()

plt.figure(figsize=(10, 8))
sns.heatmap(corr, annot=True, fmt=".2f", cmap="coolwarm", vmin=-1, vmax=1, linewidths=0.5)
plt.title("Correlation Matrix of Sold Home Features (Pearson)")
plt.show()Ergebnis:
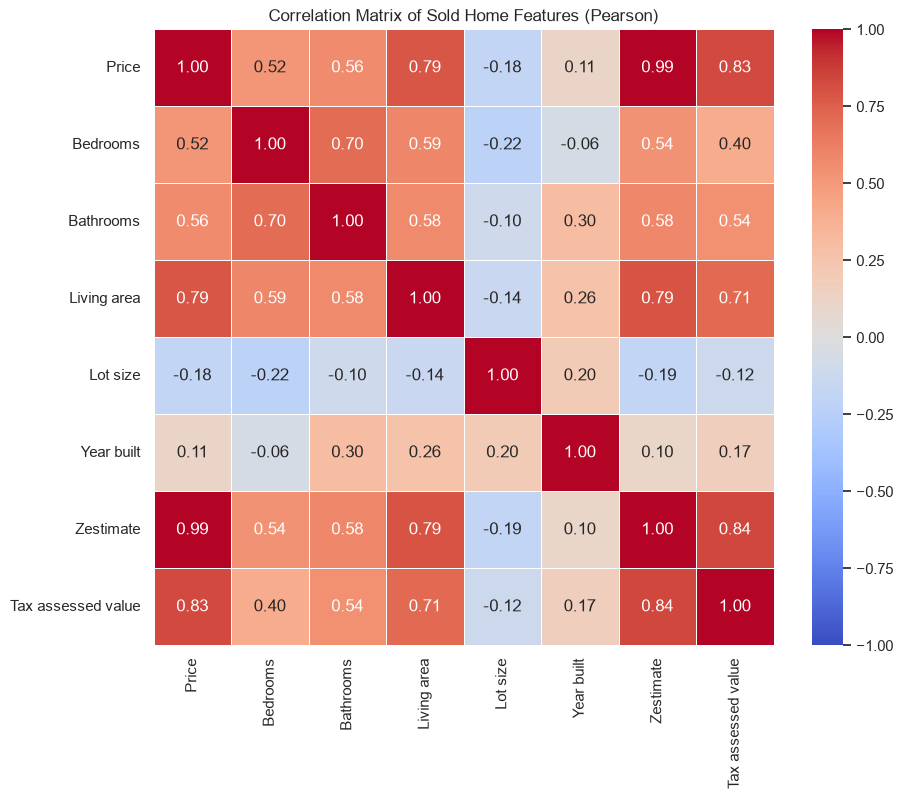
Kommentar: Zestimate (0,99) funktioniert fast wie eine Kopie des Preises. Wohnfläche (0,79), Badezimmer (0,56) und Schlafzimmer (0,52) sind die nützlichsten Preissignale, während das Baujahr den Preis kaum beeinflusst (0,11).
Preisbänder-Mix in den aktivsten ZIP-Codes
Beschreibung: Zeige, wie sich der Anteil der Verkäufe in jedem Preisband über die 10 aktivsten ZIP-Codes unterscheidet.
Zelle:
# Verkäufe aus den 10 aktivsten ZIP-Codes behalten
top_df = df[df["zipcode"].isin(top_zips)]
# Den Prozentsatz jedes Preisbands innerhalb jedes ZIP-Codes berechnen
mix = pd.crosstab(top_df["zipcode"], top_df["price_band"], normalize="index") * 100

ax = mix.plot(kind="barh", stacked=True, figsize=(10, 6),
              colormap="RdYlGn_r", width=0.8)
ax.set_xlabel("Share of sales (%)")
ax.set_ylabel("ZIP code")
ax.set_title("Price Band Mix in the 10 Most Active ZIP Codes")
ax.legend(title="Price band (USD)", bbox_to_anchor=(1.02, 1), loc="upper left")
plt.tight_layout()
plt.show()Ergebnis:
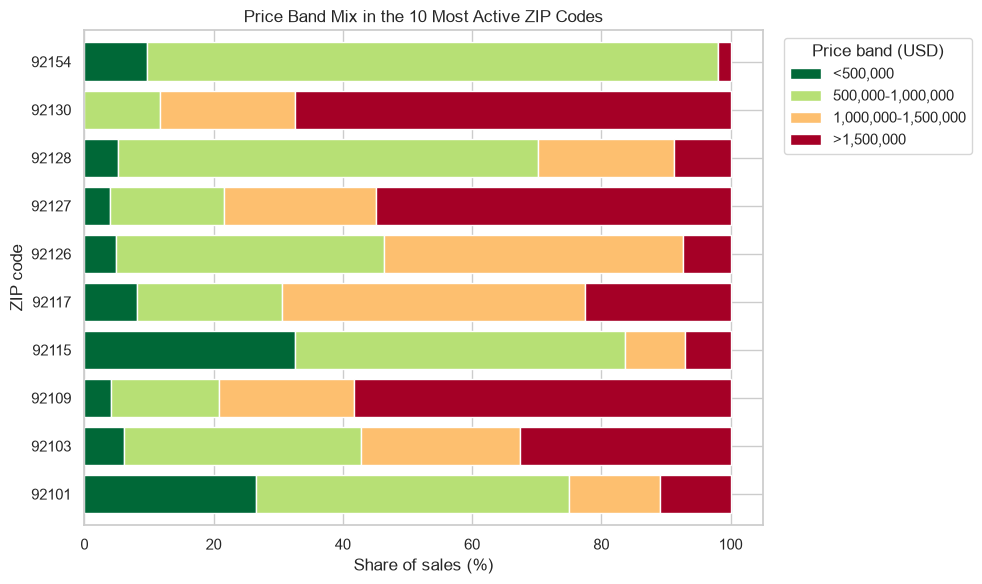
Kommentar: ZIP-Code 92154 ist am stärksten im mittleren Preissegment, mit etwa 88% der Verkäufe zwischen 500.000 und 1.000.000 USD. Die ZIP-Codes 92130, 92109 und 92127 liegen größtenteils über 1.500.000 USD. Erschwingliche Verkäufe sind in 92115 am häufigsten, mit etwa einem Drittel unter 500.000 USD.
Tage auf Zillow nach Preisband
Beschreibung: Prüfe, ob teurere Häuser länger zum Verkauf brauchen, anhand der Tage auf Zillow nach Preisband.
Zelle:
# Häuser mit sowohl Tagen auf dem Markt als auch einem Preisband behalten
d = df.dropna(subset=["daysOnZillow", "price_band"])
# Die Spearman-Korrelation berechnen, das ist die Pearson-Korrelation auf Rängen
rho = d["price"].rank().corr(d["daysOnZillow"].rank())

plt.figure(figsize=(10, 6))
sns.boxplot(data=d, x="price_band", y="daysOnZillow", hue="price_band",
            legend=False, palette="Oranges")
plt.title(f"Days on Zillow by Price Band (Spearman ρ with price = {rho:.2f})")
plt.xlabel("Price band (USD)")
plt.ylabel("Days on Zillow")
plt.show()Ergebnis:
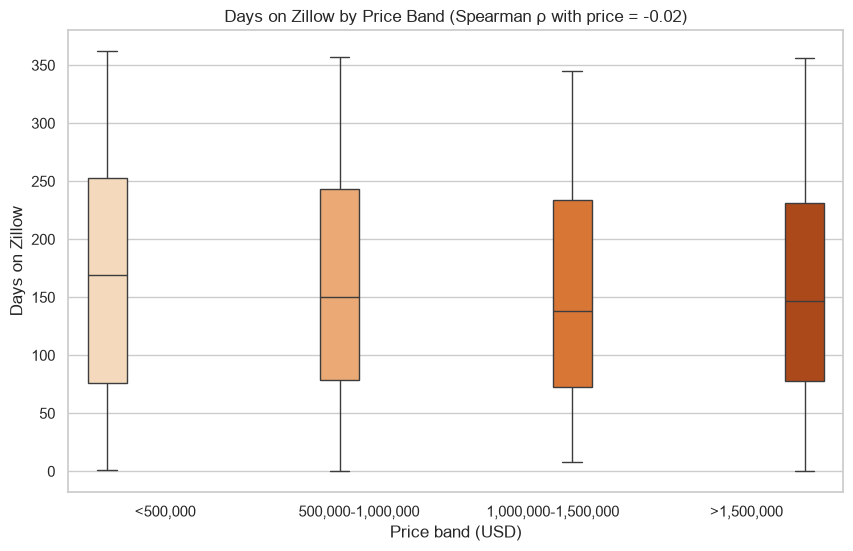
Kommentar: Die Tage auf Zillow ändern sich kaum mit dem Preis (Spearman ρ = -0,02). Die mediane Listungsdauer bleibt in jedem Band zwischen etwa 140 und 170 Tagen, mit einer breiten Streuung von nahezu null bis über 350 Tagen. Der Preis allein erklärt also nicht, wie schnell ein Haus verkauft wird.
Wie genau ist der Zestimate?
Beschreibung: Miss die Differenz zwischen jedem Verkaufspreis und Zillows Zestimate, um zu sehen, wie genau die Schätzungen sind.
Zelle:
# Häuser behalten, bei denen der Fehler berechnet werden konnte
d = df.dropna(subset=["zestimate_error_pct"])
median_abs_error = d["zestimate_error_pct"].abs().median()

plt.figure(figsize=(10, 6))
sns.histplot(d["zestimate_error_pct"], bins=40, kde=True, color="purple")
# Null-Fehler markieren, wo die Schätzung dem Verkaufspreis entspricht
plt.axvline(0, color="black", linestyle="--")
# Auf Fehler zwischen -20% und +20% fokussieren
plt.xlim(-20, 20)
plt.title(f"Sold Price vs. Zestimate (median absolute error: {median_abs_error:.1f}%)")
plt.xlabel("(Sold price - Zestimate) / Zestimate (%)")
plt.ylabel("Number of homes")
plt.show()Ergebnis:
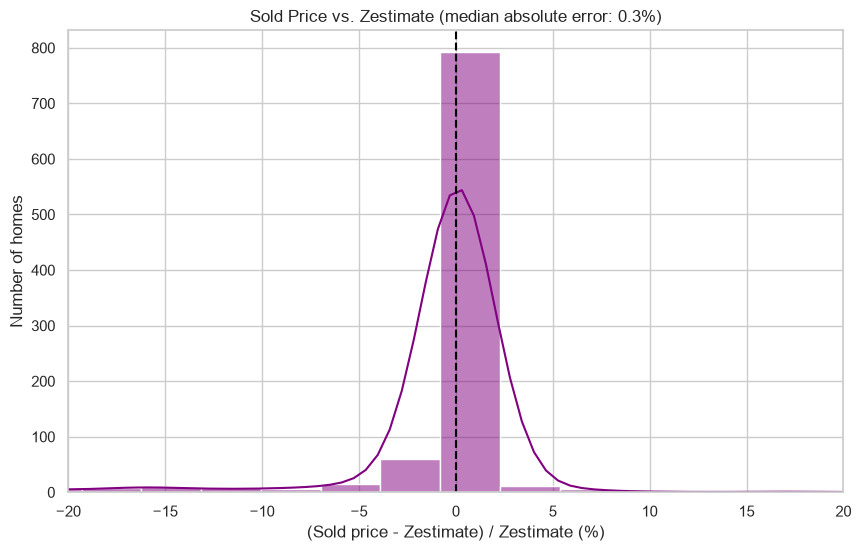
Kommentar: Der mediane absolute Fehler beträgt nur 0,3%, sodass Zestimate für die meisten Häuser genau ist. Eine Handvoll Verkäufe liegt 20% oder mehr von der Schätzung entfernt.
Geschätzte Bruttomietrendite nach ZIP-Code
Beschreibung: Schätze die Jahresmiete als Anteil des Verkaufspreises für jeden ZIP-Code, um die Mietrenditen zu vergleichen.
Zelle:
# Verkäufe nach ZIP-Code gruppieren und die Verkaufsanzahl und Medianrendite berechnen
yield_stats = (df.groupby("zipcode")
                 .agg(sales=("zpid", "count"), median_yield=("rent_yield_pct", "median"))
                 # ZIP-Codes mit zu wenigen Verkäufen entfernen
                 .query("sales >= @MIN_SALES")
                 # Von höchster zu niedrigster Rendite sortieren
                 .sort_values("median_yield", ascending=False)
                 # Nur die Top 15 behalten
                 .head(15)
                 # Den ZIP-Code-Index wieder in eine Spalte umwandeln
                 .reset_index())

show_table(yield_stats,
           formats={"median_yield": "{:.1f}%"},
           title="Top 15 ZIP codes by estimated gross rental yield")

plt.figure(figsize=(10, 7))
sns.barplot(data=yield_stats, x="median_yield", y="zipcode", color="seagreen")
plt.title("Estimated Gross Rental Yield by ZIP Code (Top 15)")
plt.xlabel("Gross yield (%) = rent Zestimate × 12 / sold price")
plt.ylabel("ZIP code")
plt.show()Ergebnis:
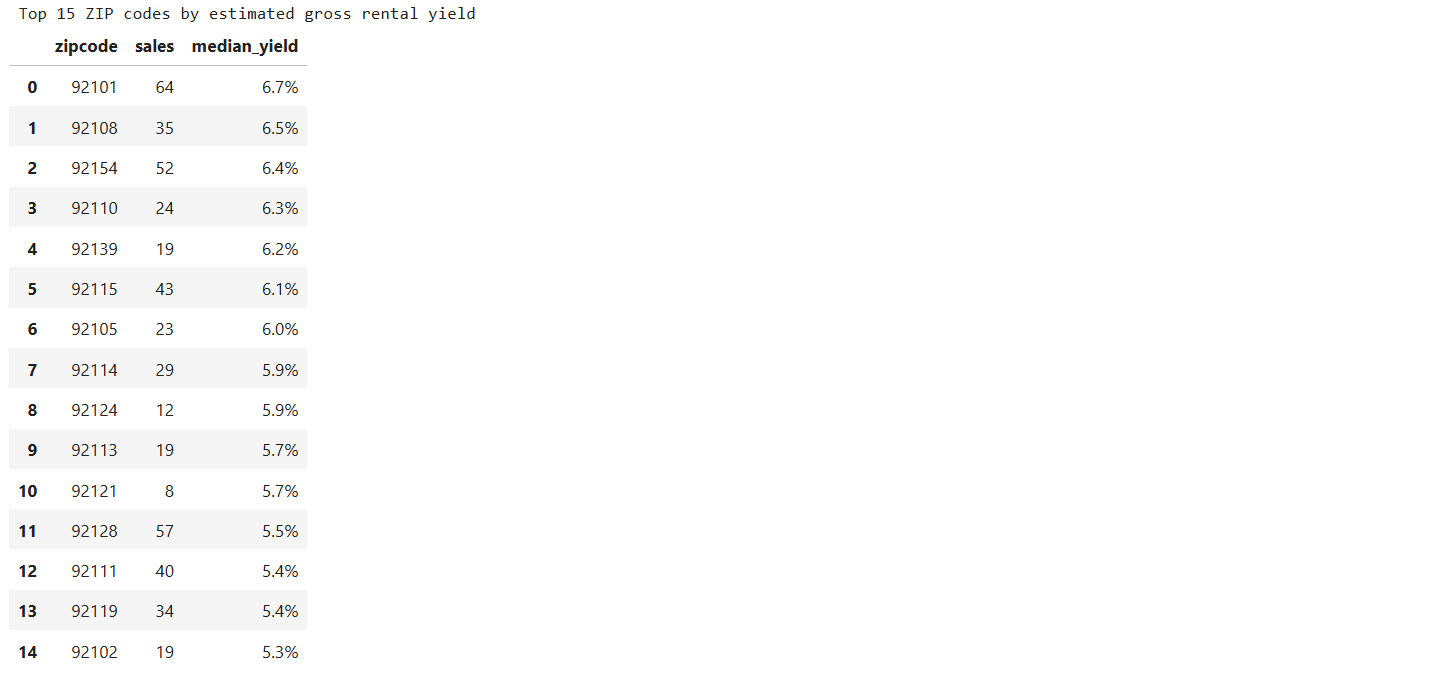
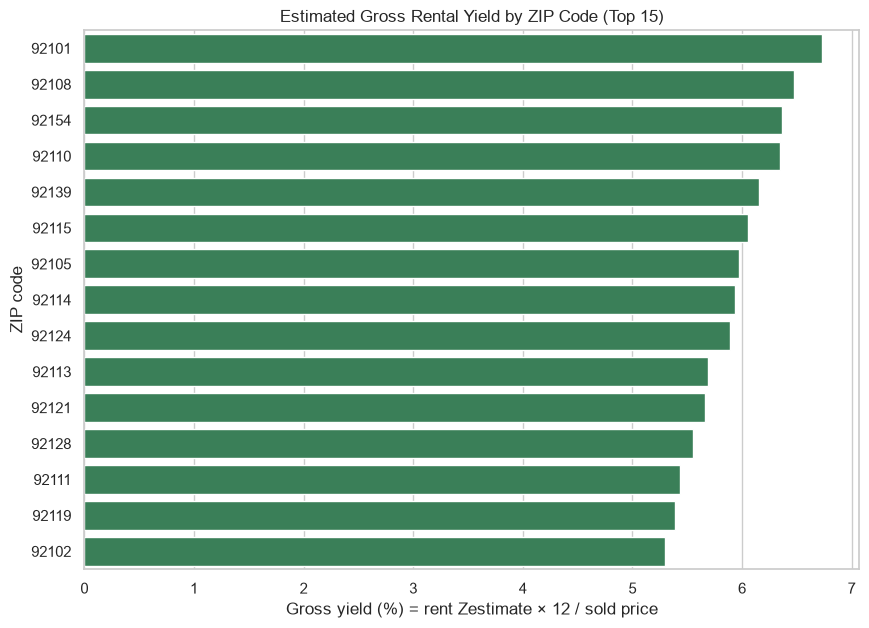
Kommentar: Die Top-15-ZIP-Codes erzielen eine Bruttorendite zwischen 5,3% und 6,7%, eine schmale Spanne. 92101 führt mit 6,7%, gefolgt von 92108 (6,5%) und 92154 (6,4%). Da die Mietwerte Zillow-Schätzungen sind, solltest du diese eher als Richtwerte denn als exakte Renditen betrachten.
Weiterführende Lektüre
Wenn dich ähnliche Ansätze zur Webdatenanalyse und -visualisierung mit Diagrammen oder KI interessieren, schau dir diese Anleitungen an:
- Einen Crunchbase-Datensatz filtern und mit KI für die Neukundenakquise verarbeiten
- Analyse von Amazons meistverkauften Produkten
- Crunchbase-Datenanalyse für die Kundenakquise
Um auf diesem Beispiel aufzubauen, könntest du dann ein Regressionsmodell zur Vorhersage von Verkaufspreisen trainieren, Immobilienmärkte zweier Städte vergleichen oder historische Preistrends für einzelne Immobilien analysieren.
Fazit
In diesem Artikel hast du gelernt, wie du das Bright Data Python SDK verwendest, um strukturierte, analysebereite Datensätze abzurufen, die auf deine Bedürfnisse zugeschnitten sind. Konkret hast du gesehen, wie man Zillow-Daten zu in San Diego verkauften Häusern abruft, die Daten bereinigt und vorbereitet und mehr als 10 Visualisierungen zu Verkaufspreisen, Standorten, Immobiliengrößen, Bewertungen und Mietrenditen erstellt.
Das Bright Data Python SDK bietet programmatischen Zugriff auf Bright Data-Produkte, einschließlich seines umfangreichen Datensatz-Marktplatzes. Das SDK vereinfacht den Datenerfassungsprozess, sodass du dich auf die Analyse konzentrieren kannst, anstatt Daten zu sammeln und vorzubereiten.
Hole deine Ergebnisse als CSV, JSON, JSONL oder andere unterstützte Formate ab und lade sie dann direkt in ein Jupyter Notebook zur Analyse und Visualisierung, oder übergib sie an KI-Tools für weitere Analysen.
Erstelle ein Bright Data-Konto, um auf die öffentlichen Webdaten zuzugreifen, die du für deine Datenanalyseprojekte benötigst!