Etsy zu scrapen bedeutet, Listing-, Shop- und Bewertungsdaten von Etsys öffentlichen Seiten zu sammeln. Etsy meldete mehr als 100 Mio. Artikel und 5,6 Mio. aktive Verkäufer im Jahresbericht 2025. Etsy nutzt DataDome. Eine direkte Anfrage liefert einen 403 und eine Blockseite. Die 2 Fixes, die meist zuerst versucht werden, sind ein Chrome-User-Agent und TLS-Impersonation. Beide liefern weiterhin einen 403. Dieser Leitfaden zeigt, was den 403 ändert, was robots.txt blockiert, und welche Extraktionsprobleme einen Etsy-Datensatz beschädigen, ohne einen Fehler auszulösen.
Kurzfassung
- Etsy nutzt DataDome hinter Fastly. DataDome setzt einen Risiko-Score in seinen eigenen Antwort-Header. Du kannst eine Anfrage bewerten, bevor du einen Crawler schreibst.
- Etsy verweigerte alle 9 getesteten Transportmethoden. Ein sichtbarer Browser lud die erste Seite in 2,2 Sekunden. Etsy verweigerte die zweite Anfrage.
- robots.txt verbietet Stichwortsuche und Verkaufshistorie und nennt keine Sitemap. Listing- und Shop-Seiten blieben dort offen. Aber Etsys Nutzungsbedingungen sind strenger.
- Währung und Preis folgen der Ausgangs-IP. Unsere Datensatz-Stichprobe enthielt 19 Währungen. Ein ungefilterter Durchschnitt dieser Spalte war 227-mal zu hoch.
Was Etsy auf eine automatisierte Anfrage zurückgibt
Lies zuerst die Ablehnung. Wiederhole die Anfrage nicht. Eine einfache Anfrage zeigt dir, welcher Anbieter am Edge läuft und wie dieser Anbieter dich bewertet hat. Jede Listing-URL funktioniert. Diese hier gehört einem Verkäufer, sie könnte also bereits verschwunden sein:
curl -sD - -o /dev/null https://www.etsy.com/listing/753913297/smoky-quartz-ring-rose-gold-ring-womenDer Server liefert einen 403 mit diesen Headern:
HTTP/2 403
server: DataDome
x-datadome: protected
x-datadome-riskscore: 0.9230727100377928
accept-ch: Sec-CH-UA,Sec-CH-UA-Mobile,Sec-CH-UA-Platform,Sec-CH-UA-Arch,Sec-CH-UA-Full-Version-List,Sec-CH-UA-Model,Sec-CH-Device-Memory
set-cookie: datadome=ovuDEZ4S0taK1jDAOvZ9W3Uq2qUujN_iPPE3uXp7~r3msKXSvMFPp4j30em5IvR0...
via: 1.1 varnish
x-served-by: cache-del-vibw2260027-DEL
Dieser Block enthält 3 Fakten. Etsy nutzt DataDome, nicht den Akamai Bot Manager, den ältere Leitfäden noch angeben, plane also gegen DataDomes Erkennungsebenen. Fastly läuft vor Etsy, und die Via– und X-Served-By-Header zeigen diesen Hop. X-DataDome-riskscore ist DataDomes Score dafür, wie bot-artig die Anfrage wirkte, auf einer Skala, bei der 1,0 am schlechtesten ist. Etsy kann Anbieter wechseln, führe den Befehl also erneut aus, bevor du gegen diese 3 Fakten planst.
Dieser Header gibt dir eine Zahl zum Messen. In unseren Tests war der Score deterministisch. Alle 6 verschachtelten Stichproben derselben Anfrage lieferten 0.9230727100377928. Der Score verfolgt die Anfrage-Signatur, die aufrufende IP und das datadome-Cookie, sobald eines zurückgegeben wird, nicht eine laufende Anzahl von Anfragen. Deine eigenen Werte können also abweichen, und auf einer anderen Adresse kann sich die Rangfolge zwischen Client-Konfigurationen ebenfalls unterscheiden.
Der Body, 776 Byte in unseren Durchläufen, ist eine DataDome-Blockseite, die ct.captcha-delivery.com/c.js lädt. Diese Blockseite enthält ein Challenge-Skript, keine Listing-Daten, ein Parser, der sie liest, liefert also leere Felder statt eines Fehlers. Die eingebettete Konfiguration enthielt 't':'fe', DataDomes Geräteprüfung, dieser Abruf erhielt also eine Challenge, die ein echter Browser beantworten kann, statt einer dauerhaften Sperre. Das 't'-Feld zeigt die aktuelle Einstufung und nimmt andere Werte an, wenn sich diese Einstufung ändert, lies also deinen eigenen Wert, statt 'fe' anzunehmen.
Wir sendeten jede Anfrage von 1 minimalen 3-Header-Client und variierten nur den Pfad. Jeder Inhaltspfad, den wir testeten, lieferte denselben 403 und denselben 0,482-Score, während /robots.txt und eine URL, die ins Leere führt, ungeschützt an Apache gingen:
path                                       HTTP server     riskscore
/                                          403  DataDome   0.482
/listing/753913297/smoky-quartz-ring...    403  DataDome   0.482
/shop/AnemoneJewelry                       403  DataDome   0.482
/legal/terms/                              403  DataDome   0.482
/robots.txt                                200  Apache     -
/nonexistent-path-xyz                      404  Apache     -
Auf den von DataDome geschützten Pfaden bewertet es also den Aufrufer statt der URL.
Eine Anfrage mit Googlebot-User-Agent umging DataDome und traf stattdessen auf einen Rate-Limiter. Apache antwortete mit 429 Too Many Requests und einem nicki_-Referenzstring. Mindestens 1 erklärter Suchmaschinen-Agent trifft auf einen eigenen Rate-Limiter, getrennt von DataDome.
Warum Header- und TLS-Fingerabdrücke nicht ausreichen
Der Risiko-Score erlaubt es, den üblichen Rat zu Headern zu testen, wobei eine niedrigere Zahl weniger bot-artig bedeutet. Wir hielten IP und URL konstant, variierten nur die Anfrage-Header bei einem requests-Client, und erfassten den von DataDome gelieferten Score:
headers sent                                         score    HTTP
requests, library default headers                    0.977    403
+ Chrome User-Agent only                             0.923    403
full 12-header Chrome set                            0.503    403
User-Agent + accept + sec-fetch-site (3 headers)     0.482    403
Diese Tabelle enthält 2 Ergebnisse. Das Hinzufügen eines Chrome-User-Agents änderte die Einstufung kaum, weil alles andere in der Anfrage weiterhin von requests kam. Und das 3-Header-Set schnitt besser ab als das volle 12-Header-Set, auf diesem Ziel zählte also Konsistenz mehr als die Anzahl der Header.
Diese 3 Header erzielten 0,482, kopiere also den accept-Wert exakt:
User-Agent:      Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36
                 (KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36
accept:          text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,
                 image/webp,image/apng,*/*;q=0.8,application/signed-exchange;v=b3;q=0.7
sec-fetch-site:  none
Wir entfernten jeweils 1 Header aus dem vollen Set und erfassten jede Änderung, wobei ein Pluszeichen bedeutet, dass sich der Score verschlechterte:
run                              score     change
full set (baseline)              0.503
minus accept                     0.845     +0.342
minus user-agent                 0.784     +0.281
minus sec-fetch-site             0.669     +0.166
minus every sec-ch-ua* header    0.503      0.000
DataDome bewirbt 7 Client Hints in seinem eigenen Accept-CH-Antwort-Header. Unser vollständiges Set hatte 3 davon, aber das Entfernen jedes sec-ch-ua-Headers änderte nichts. Der accept-Header bewegte den Score stärker als der User-Agent.
TLS-Impersonation ist der übliche nächste Schritt, wir testeten ihn daher separat. Jeder Durchlauf sendete dieselben 3 Header, nur der TLS- und HTTP/2-Fingerabdruck änderte sich. Die JA4-Werte unten stammen von curl_cffi und nicht von Etsy, sie ändern sich also jedes Mal, wenn diese Bibliothek ein Profil aktualisiert:
transport                             JA4                      riskscore  HTTP
python requests (OpenSSL, HTTP/1.1)   t13d1712h1_ab0a1bf427ad  0.482      403
curl_cffi impersonate=chrome110       t13d1516h2_8daaf6152771  0.663      403
curl_cffi impersonate=chrome116       t13d1516h2_8daaf6152771  0.663      403
curl_cffi impersonate=chrome124       t13d1516h2_8daaf6152771  0.503      403
curl_cffi impersonate=chrome131       t13d1516h2_8daaf6152771  0.503      403
curl_cffi impersonate=chrome133a      t13d1516h2_8daaf6152771  0.503      403
curl_cffi impersonate=firefox133      t13d1716h2_5b57614c22b0  0.503      403
curl_cffi impersonate=safari17_0      t13d2014h2_a09f3c656075  0.663      403
curl_cffi impersonate=safari17_2_ios  t13d2014h2_a09f3c656075  0.663      403
Diese Tabelle enthält 3 verschiedene Fingerabdrücke, je einen für Chrome, Firefox und Safari. Einfaches requests über HTTP/1.1 schnitt immer noch besser ab als alle 3. Diese Spalte zeigt nur die ersten 2 Teile einer JA4. Der dritte Teil kodiert die Erweiterungsliste und unterscheidet sich zwischen den Chrome-Profilen, die hier ein Präfix teilen.
Der Transport bewegte den Score um 0,181 zwischen dem besten und schlechtesten Durchlauf, aber kein Durchlauf lieferte eine Seite. Kein getesteter Fingerabdruck reichte allein aus.
So sind TLS-Fingerabdrücke den Aufwand bei diesem Ziel nicht wert. Wir lasen die HTTP/2-Frames jedes Profils zurück, einschließlich der Pseudo-Header-Reihenfolge, die pro Engine unterschiedlich ist:
profile      SETTINGS                       | window   | pri | pseudo-header order
chrome131    1:65536;2:0;4:6291456;6:262144 | 15663105 | 0   | m,a,s,p
firefox133   1:65536;2:0;4:131072;5:16384   | 12517377 | 0   | m,p,a,s
safari17_0   2:0;4:4194304;3:100            | 10485760 | 0   | m,s,p,a
Diese 3 Handshakes sind korrekte Kopien, und Etsy lehnte alle 3 ab. DataDome entscheidet also auf Basis von etwas anderem als dem Handshake.
Was die Prüfung tatsächlich ausführt
In einem sichtbaren Browser wird DataDomes Challenge als Schieberegler dargestellt, und 2 von 4 genannten Gründen sind die aufrufende IP und die Nutzung von Entwicklertools:
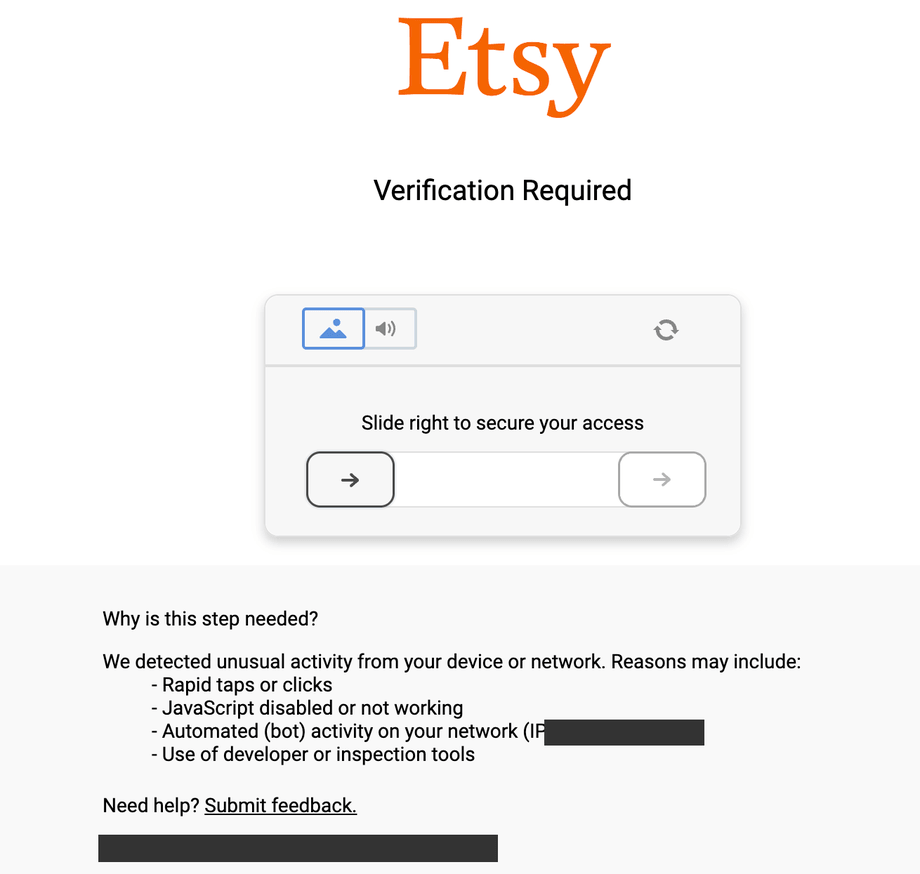
Dieser c.js-Loader ist 14 KB groß, baut eine iframe-URL und ruft eine zweite Seite ab. Diese zweite Seite enthielt an dem Tag, an dem wir sie abriefen, ein 596 KB großes Inline-Skript, und seine Modulnamen zeigen, was man neu implementieren müsste:
detection-js/dist/vm-obf.js     the detection engine, VM-obfuscated
detection-js/dist/captcha.js    challenge coordination
./picasso                       canvas-based device-class fingerprinting
./mouseMaths                    pointer-movement analysis
./slidercaptcha  ./hash  ./helpers  ./bean
Das Erkennungsmodul ist als Bytecode für einen Interpreter gespeichert, der im selben File gebündelt ist. Deshalb findet eine Textsuche im Bundle weder webdriver, noch cdc_, noch headless noch _phantom. Ein Bytecode-Bundle versteckt diese Strings unabhängig davon, ob die Prüfungen laufen oder nicht, das Suchergebnis sagt also nichts aus.
Der Build, den wir abriefen, meldete sich selbst als 1.34.0, maß die eigene Ausführungszeit und sendete diese Dauer als Signal. Dieser Build protokollierte auch eine Konsolenwarnung, die darum bat, DevTools zu schließen, bevor man fortfährt. Erwarte bis zu deinem Check eine andere Version und eine andere Modulliste, da diese Engine DataDomes Release-Zyklus folgt und nicht dem von Etsy. Die Architektur hinter diesen Namen ändert sich deutlich langsamer.
Die Prüfanfrage hat 16 Felder und kodiert die Browserumgebung in userEnv, ddCaptchaEnv und plv3.
Es gibt also 2 praktische Schlussfolgerungen. Diese Ausgabe aus requests zu reproduzieren bedeutet, eine obfuskierte VM gegen einen Versionsstring nachzubauen, der sich fortlaufend erhöht. Und DataDome sammelt Canvas-Ausgaben und Zeigerbewegungen, die erst existieren, nachdem eine echte Browser-Engine die Seite gerendert hat. DataDome-spezifisches Unblocking betreibt diese Browser-Engine als Dienst und ist darauf ausgelegt, die gerenderte Seite statt der Blockade zurückzugeben.
Diese zweite Schlussfolgerung ist testbar, wir betrieben daher ein einfaches Playwright-Chromium ohne Stealth-Patches und ohne Proxy. Jeder Modus lief 3-mal von derselben Adresse, auf der jeder Transport oben abgelehnt wurde:
headless=True (default)        403  403  403     1,530 B    0.5s
headless=True --headless=new   403  403  403     1,530 B    0.4s
headless=False (headed)        200  200  200   532,049 B    2.2s   Product JSON-LD present
Beide Fenster liefen auf 1 Maschine ohne Proxy, das sichtbare Fenster zeigt also Preise in der lokalen Währung:
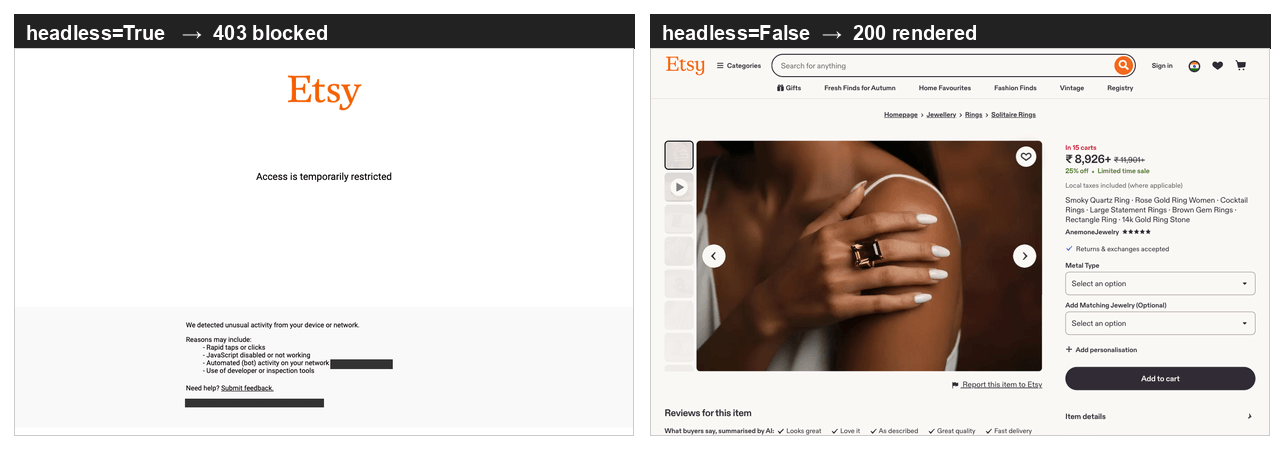
Headless-Chromium enthält HeadlessChrome in seinem eigenen User-Agent, diese Zeilen unterscheiden sich also in mehr als nur dem Fenster. Um eine Seite manuell zu prüfen oder ein paar Seiten abzurufen, ist ein sichtbarer Browser die einfachste Lösung. Unblocking-Infrastruktur ist für die Anfragen nach der ersten gebaut, und für einen einzelnen Abruf ist ein sichtbarer Durchlauf etwa 10-mal schneller, als sie zu durchlaufen.
Warum ein Browser kein Crawler ist
Wir luden 12 Listings nacheinander in einer einzelnen Browserseite, 2 Sekunden auseinander, und erhielten 1 Erfolg und 11 Ablehnungen:
#1   200   444,123 B
#2   403     1,527 B
#3-12 403   ~1,530 B each
Das Verwerfen des Browsing-Kontexts zwischen Navigationen stellte den 200 wieder her, die Ablehnungen kamen also vom Sitzungsstatus und nicht von der Adresse. Später im selben Testzeitraum funktionierte dieser Fix nicht mehr. Etsy lehnte danach jede Anfrage von dieser Adresse ab, unabhängig davon, wie neu der Kontext war.
Der Risiko-Score bewegte sich nicht, während die Erfolgsquote von jeder Anfrage auf keine fiel. Der 3-Header-Durchlauf maß weiterhin 0.4822 auf 4 Nachkommastellen, Stunden und mehrere hundert Anfragen nach dem ersten Messwert.
Der X-DataDome-riskscore-Header bewertet jeweils 1 Anfrage, nützlich also, um 1 Änderung zu testen, aber nicht, um einen Crawl zu überwachen. Eine Pipeline, die ihn beobachtet, meldet Erfolg, während sie nichts sammelt.
Mehr als ein paar Seiten zu sammeln benötigt 2 Dinge: einen neuen Browsing-Kontext und eine Adresse, die DataDome noch nicht abgelehnt hat. Den Kontext zwischen Navigationen zu verwerfen ist günstig, beginne also dort, aber dieser Fix hält nur, bis DataDome die Adresse ablehnt. Residential-Proxys geben dir einen Pool von Adressen zum Rotieren.
Web Unlocker erledigt beides, und das Skript weiter unten bleibt innerhalb des kostenlosen Kontingents. Browser API handhabt beides innerhalb eines gehosteten Browsers, den dein Playwright-Code steuert.
Was robots.txt und die Etsy-Nutzungsbedingungen nicht erlauben
Lies Etsys robots.txt selbst, bevor du etwas baust, denn die Datei verbietet Stichwortsuche und Etsy schreibt sie ohne Vorankündigung um. Als wir sie lasen, war diese Datei 1.818 Zeilen lang und nannte nur 3 User-Agent-Gruppen: *, AdsBot-Google-Mobile und Spinn3r:
User-agent: *
Disallow: /search?*q=
Disallow: /search/?*q=
Disallow: */shop/*/sold*
Disallow: */listing/*/favoriters*
Disallow: /api/
Allow:    /search/shops
Die Wildcard-Gruppe verbietet Stichwort-Suchergebnisse in jeder Sprachvariante. Diese Gruppe deckt jeden Crawler ab, den die anderen 2 Gruppen nicht nennen. Verkaufshistorie und Favoriten-Zählungen sind ebenfalls verboten, und sie gehören zu den klarsten Nachfragesignalen, die Etsy veröffentlicht. Listing-Seiten und Shop-Seiten haben keine Disallow-Regel, beide bleiben also offen.
Die Datei nennt keine Sitemap:-Direktive, und /sitemaps.xml antwortet mit 403 und leerem Body. Diese 2 Abwesenheiten zählen genauso viel wie die Disallow-Regeln oben. Beide sind 1-Zeilen-Checks, die sich zu wiederholen lohnen, da Etsy eines von beiden jederzeit ohne Vorankündigung hinzufügen kann. Solange sie fehlen, musst du Listings aus den Seiten erschließen, die Etsy offen lässt.
Etsy nannte zum Zeitpunkt unserer Prüfung nirgends in der Datei einen KI-Crawler und veröffentlichte keine llms.txt oder ai.txt. Diese Abwesenheit ist am wahrscheinlichsten das, was sich in diesem Abschnitt seit unserer Prüfung geändert hat.
DataDome lehnt diese Crawler ohnehin am Edge ab. GPTBot und ClaudeBot erhielten beide einen 403 und erzielten in unserem Test beide 0,9814, höher als die 0,923, die dieselbe Adresse mit einem Chrome-User-Agent erzielte. Unsinnige User-Agent-Strings mit denselben Headern erzielten denselben Score, DataDome bewertet also das Fehlen eines bekannten Browsers statt des Crawler-Namens.
Die Etsy-Nutzungsbedingungen, zuletzt aktualisiert am 26. August 2025, besagen, dass man zustimmt, “keine Seite der Dienste zu crawlen, zu scrapen oder zu spidern” ohne ausdrückliche Erlaubnis.
Prüfe, ob deine Erfassungsebene robots.txt für dich durchsetzt, und an welchem Punkt sie entscheidet. Der Residential-Unblocking-Endpunkt entscheidet pro Anfrage. Bei einem Konto ohne abgeschlossenes KYC liefert eine Anfrage für den verbotenen Suchpfad die Regel und das KYC-Formular:
Residential Failed (bad_endpoint): Requested site is not available for immediate
residential (no KYC) access mode in accordance with robots.txt. To get full
residential access for targeting this site, fill in the KYC form:
https://brightdata.com/cp/kyc
Dasselbe Konto rief /shop/AnemoneJewelry ohne Fehler ab, und die Antwort war 983.937 Byte groß. Der Endpunkt liest dieselbe robots.txt, die du gelesen hast, und liefert dann die erlaubten Pfade aus, während er die verbotenen Pfade an eine Compliance-Prüfung statt an einen Proxy weiterleitet. Entscheide, ob dein Anwendungsfall die verbotenen Pfade benötigt, bevor du mit dem Bau beginnst.
Wenn du die Abrufebene selbst baust, triffst du diese Entscheidung im Code und besitzt und pflegst robots.txt-Handling pro Ziel.
Was die offizielle Etsy-API liefert und was sie auslässt
Die API ist der autorisierte Weg, prüfe also, was sie tut, bevor du sie ablehnst. Die Wahl zwischen offizieller API und Scraping ist allgemein, und bei Etsy hängt sie von den Feldern ab, die die Spezifikation auslässt. Wir riefen die OpenAPI-Spezifikation direkt ab und zählten 76 Pfade, von denen 31 GET-Operationen nur einen Anwendungsschlüssel und kein Verkäufer-OAuth benötigen. Diese Summen ändern sich, sobald Etsy einen Endpunkt hinzufügt oder entfernt, zähle also aus dieser Datei neu und nicht aus diesem Absatz.
Gängige Behauptungen über die v3-API sind in 3 Punkten falsch. findAllListingsActive wurde nicht entfernt und akzeptiert keywords, min_price, max_price, taxonomy_id, shop_location, currency und buyer_country, mit einem maximalen limit von 100 pro Aufruf. getReviewsByListing und getReviewsByShop liefern Bewertungstexte mit alleinigem App-Schlüssel. getShop liefert transaction_sold_count, review_count, review_average, num_favorers und listing_active_count für jeden Shop.
Die Spezifikation führt 1 Nachfragefeld und lässt den Rest aus. getListing benötigt nur einen Anwendungsschlüssel und liefert views, eine kumulative Aufrufzahl, einmal täglich aktualisiert, im ShopListingWithAssociations-Schema. Eine Suche im gesamten Dokument liefert kein Feld für Suchvolumen, Impressionen, Konversionsrate oder Verkäufe pro Listing. Das ShopListing-Schema hatte bei unserer Zählung 50 Eigenschaften, darunter num_favorers, quantity und price, und keine davon war eine Verkaufszahl. Prüfe die Zählung erneut gegen die Spezifikation, aber bisher ist kein Verkaufsfeld aufgetaucht.
Für Transaktionen pro Listing gibt es tatsächlich einen Endpunkt, getShopReceiptTransactionsByListing, aber er benötigt den transactions_r-OAuth-Scope, den nur ein Shop-Betreiber für seinen eigenen Shop erteilen kann. Für jeden Shop, den du nicht betreibst, veröffentlicht Etsy lebenslange Verkäufe auf Shop-Ebene als aktuellen Gesamtwert ohne Historie, und nichts pro Listing.
Diese Lücke erklärt den Drittanbieter-Tool-Markt rund um Etsy. Manche Produkte verkaufen Schätzungen zu Verkäufen pro Listing oder Stichwort-Suchvolumen für Shops, die sie nicht betreiben. Nichts in der von uns gelesenen Spezifikation liefert diese Zahlen für einen Shop, den man nicht besitzt, diese Daten müssen also von außerhalb dieser API stammen.
Etsy setzt Ratenlimits pro Anwendungsschlüssel durch, pro Sekunde und pro Tag. Die Antwort-Header x-limit-per-second und x-limit-per-day melden beide, und Etsy liefert einen 429 mit retry-after, wenn eines der beiden überschritten wird.
Die Seite zu Ratenlimits bezeichnet ihre Werte als “Beispielwert” statt als Standardwerte. Das ältere Paar “10.000 pro Tag, 10 pro Sekunde” fehlte auf dieser Seite, als wir sie lasen. Lies deine eigenen Limits aus dem Developer Portal.
Etsy-Listing- und Shop-Seiten mit Python scrapen
Etsy-Listing-Seiten betten schema.org-JSON-LD ein, der Extraktionsschritt benötigt also keine CSS-Selektoren und bricht nicht, wenn Etsy das Markup drumherum umgestaltet. Der Abrufschritt benötigt Infrastruktur, und du hast 2 Wege dafür. Eine entsperrte API läuft überall und benötigt ein Konto. Ein lokaler Browser benötigt kein Konto und eignet sich für wenige Seiten.
Das Skript unten benötigt 1 Bibliothek und 2 Umgebungsvariablen:
python3 -m venv .venv && source .venv/bin/activate
pip install requests
export BRIGHTDATA_API_KEY="your-api-token"
export BRIGHTDATA_ZONE="web_unlocker"
Das Token stammt aus dem Bright-Data-Kontrollzentrum. Jede Anfrage mit diesem Token belastet dein Kontoguthaben, bewahre es also in einer Umgebungsvariable auf und nicht in einem eingecheckten Skript.
Den zweiten Wert legst du unter Web Access → Add API → Web Unlocker API an. Die Anfrage-Payload nennt es eine zone, aber das Kontrollzentrum bezeichnete es als API, als wir das einrichteten, eine Suche im Panel nach “zone” fand also nichts. BRIGHTDATA_ZONE muss dem Namen entsprechen, den du dort eingibst, da das Skript standardmäßig web_unlocker verwendet. Das Formular warnt, dass der Name dauerhaft ist:
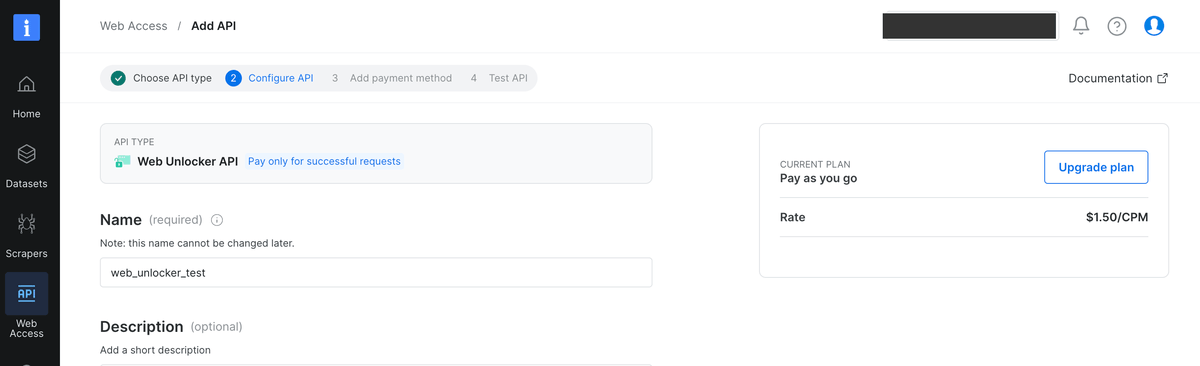
Die Zone in dieser Aufnahme heißt web_unlocker_test, der Standardwert des Skripts würde sie also verfehlen. Setze entweder BRIGHTDATA_ZONE auf den von dir eingegebenen Namen oder nutze web_unlocker und lass den Standard unangetastet. Der Web-Unlocker-Schnellstart dokumentiert beides, und wir starteten bei der Einrichtung mit dem kostenlosen Kontingent ohne Karte. Die Web-Unlocker-Preisseite listet das aktuelle kostenlose Kontingent und den Pay-as-you-go-Tarif darüber hinaus, angegeben pro 1.000 erfolgreiche Anfragen. Das Panel schreibt diesen Tarif als CPM.
Dieses Skript sendet die Anfrage über den Web-Unlocker-Endpunkt und parst das Ergebnis:
import json
import os
import re
import requests

API_KEY = os.environ.get("BRIGHTDATA_API_KEY")
ZONE = os.environ.get("BRIGHTDATA_ZONE", "web_unlocker")
ENDPOINT = "https://api.brightdata.com/request"

LD_JSON = re.compile(
    r'<script[^>]*type\s*=\s*[\'"]application/ld\+json[\'"][^>]*>(.*?)</script\s*>',
    re.S | re.I,
)


def fetch_html(url, country="us"):
    """Return the rendered HTML for an Etsy URL, or raise on failure."""
    # Checked here rather than at import, so the browser path below runs
    # without an account.
    if not API_KEY:
        raise SystemExit("BRIGHTDATA_API_KEY is not set, see the exports above")
    response = requests.post(
        ENDPOINT,
        headers={"Authorization": f"Bearer {API_KEY}"},
        json={"zone": ZONE, "url": url, "format": "raw", "country": country},
        timeout=90,
    )
    response.raise_for_status()
    body = response.text
    # A quota error arrives as HTTP 200 with a short text body, and a block page
    # arrives as HTTP 200 of valid HTML. Neither contains ld+json, which is the
    # content this actually wants, so test for that rather than for either error.
    if not LD_JSON.search(body):
        raise RuntimeError(f"no ld+json in response, most likely blocked: {body[:200]!r}")
    return body


def product_jsonld(html):
    """Pick the Product block by @type. Every listing we opened had four."""
    for block in LD_JSON.findall(html):
        try:
            parsed = json.loads(block.strip())
        except json.JSONDecodeError:
            continue
        for node in parsed if isinstance(parsed, list) else [parsed]:
            if node.get("@type") == "Product":
                return node
    return None


def parse_listing(node):
    """Flatten a Product node, keeping the offer's range rather than its lowest price."""
    offer = node.get("offers", {})
    # schema.org allows a list of offers and a single priceSpecification object,
    # and Etsy serves both, so normalize before indexing into them.
    if isinstance(offer, list):
        offer = offer[0] if offer else {}
    specs = offer.get("priceSpecification", [])
    if isinstance(specs, dict):
        specs = [specs]
    base = next((s for s in specs if "priceType" not in s), {})
    was = next(
        (s for s in specs if "Strikethrough" in str(s.get("priceType", ""))), {}
    )
    # Not every listing carries a priceSpecification. Without this fallback a
    # single-variant listing records a null price and raises nothing.
    # A range arrives three ways: nested in priceSpecification, as AggregateOffer's
    # own lowPrice and highPrice, or not at all. Try them in that order.
    low = base.get("minPrice") or offer.get("lowPrice") or offer.get("price")
    high = base.get("maxPrice") or offer.get("highPrice") or offer.get("price")
    # availability is the only field that marks a dead listing, and JSON-LD lets it
    # arrive as a bare term, an array, or an @id object. Normalize before comparing.
    avail = offer.get("availability") or ""
    if isinstance(avail, list):
        avail = avail[0] if avail else ""
    if isinstance(avail, dict):
        avail = avail.get("@id", "")
    rating = node.get("aggregateRating", {})
    return {
        "sku": node.get("sku"),
        "title": node.get("name"),
        # Etsy serves a dead listing as a full HTTP 200 page that still
        # carries a price, so availability is the only field that says so.
        "availability": str(avail).rsplit("/", 1)[-1],
        "currency": offer.get("priceCurrency"),
        "price_min": low,
        # high can be a bundle maximum rather than the item's, where a listing
        # has an add-on axis. Count the axes before trusting it as a maximum.
        "price_max": high,
        "list_price": was.get("price"),
        # True only where the variations differ in price. Same-price variants
        # read false, so this is a price-spread test, not a variation test.
        "has_variations": None if low is None else low != high,
        "rating": rating.get("ratingValue"),
        "review_count": rating.get("reviewCount"),
        "shop": node.get("brand", {}).get("name"),
    }


if __name__ == "__main__":
    url = (
        "https://www.etsy.com/listing/753913297/"
        "smoky-quartz-ring-rose-gold-ring-women"
    )
    node = product_jsonld(fetch_html(url, country="us"))
    if node is None:
        raise SystemExit("no Product block on page: blocked, or the layout changed")
    print(json.dumps(parse_listing(node), indent=2))
Wir führten das Skript gegen ein aktives Listing aus, und es lieferte einen flachen Datensatz. Die Preisspanne stammt von 1 Listing mit vielen separat bepreisten Variationen:
{
  "sku": "753913297",
  "title": "Smoky Quartz Ring · Rose Gold Ring Women · Cocktail Rings · ...",
  "availability": "InStock",
  "currency": "USD",
  "price_min": "89.25",
  "price_max": "5613.75",
  "list_price": "119.00",
  "has_variations": true,
  "rating": "4.5",
  "review_count": 99,
  "shop": "AnemoneJewelry"
}
Über 3 Durchläufe gegen dasselbe Listing hinweg dauerten Abrufe 23 bis 27 Sekunden und lieferten zwischen 540 KB und 750 KB. Diese Werte sind die Kosten des Unblocking-Schritts. Plane mit Latenz in diesem Bereich statt mit der Sub-Sekunden-Zeit einer Blockade.
Wenn du nur wenige Seiten brauchst und lieber kein Konto eröffnen möchtest, erreicht ein lokaler Browser dasselbe Ergebnis mit etwa demselben Code-Umfang. Dieser Browser läuft von einer Adresse, die DataDome noch nicht abgelehnt hat. Er braucht ein Display, führe ihn auf einem Server also sichtbar unter einem virtuellen Display wie Xvfb aus statt im Headless-Modus. Installiere Playwright und Chromium einmalig:
python3 -m venv .venv && source .venv/bin/activate   # skip if already active
pip install playwright requests
playwright install chromium
Tausche dann den Abruf aus, behalte dieselben 2 Parsing-Funktionen. Setze das oberhalb des __main__-Blocks, zu den anderen Funktionen:
from playwright.sync_api import sync_playwright


def fetch_html_browser(url):
    """Fetch one page with a visible browser, since headless returns a 403."""
    with sync_playwright() as p:
        browser = p.chromium.launch(headless=False)
        context = browser.new_context(locale="en-US")
        page = context.new_page()
        page.goto(url, wait_until="domcontentloaded", timeout=45000)
        html = page.content()
        browser.close()
        # Same rule as the guard above: test for the content you want. A block
        # page is valid HTML, so only the missing ld+json shows it.
        if not LD_JSON.search(html):
            raise RuntimeError("no ld+json on page, most likely a block page")
        return html
Ändere 1 Zeile im __main__-Block und sonst nichts:
node = product_jsonld(fetch_html_browser(url)) # was: fetch_html(url, country="us")Unser Durchlauf lieferte 535.247 Byte und wurde sauber durch dieselben 2 Funktionen geparst. Die Seite war zudem in INR bepreist, da ein Browser auf deiner Maschine über deine eigene Adresse nach außen geht, und der Browser-Pfad akzeptiert kein country-Argument. Ohne dieses Argument kannst du das Ausgangsland nicht setzen, dieser Pfad passt also für wenige Seiten, nicht für einen Datensatz.
Der Code oben parst die Seite statt sie an ein Modell zu senden. Etsy veröffentlicht die Felder als strukturierte Daten, sie zu lesen ist also deterministisch und praktisch kostenlos. Bei dem von uns gemessenen Listing dauert das Auswählen des Product-Blocks und dessen Abflachen im Median 0,3 Millisekunden.
Dieselbe Seite stattdessen an ein Sprachmodell zu übergeben bedeutet 179.599 Tokens rohes HTML, fast das gesamte 200K-Token-Kontextfenster für 1 Produkt. Markup zuerst zu entfernen reduziert das auf 5.352 Tokens, eine Reduktion um 97%. Dieses Verhältnis zählt mehr als die Wahl des Modells.
Aber ein Parser, der aufhört zu matchen, liefert ein leeres Feld statt eines Fehlers, während ein Modell zumindest etwas Falsches, aber Sichtbares produzieren würde. Wähle also den deterministischen Pfad bei einer Site, die schema.org veröffentlicht. Nutze die eingesparte Zeit, um zu prüfen, dass der Parser weiterhin die erwarteten Felder liefert.
Shop-Seiten haben ebenfalls 4 dieser Blöcke, unter anderen Typen, und einer davon zeigt, woher Listing-URLs stammen. /shop/{shop_name} liefert einen Organization-Knoten, der den Shop beschreibt, und einen ItemList-Knoten, dessen itemListElement vollständige Listing-URLs enthält. shop_itemlist wählt den ItemList nach @type aus, dieselbe Funktion mit Organization an seiner Stelle liefert also die eigenen Felder des Shops. Bei dem getesteten Shop zeigte numberOfItems 1.842, während eine einzelne Seite 36 URLs lieferte, und ?page=2 lieferte 36 weitere ohne Überschneidung.
Der Enumerator nimmt einen Shop-Namen als Eingabe, du brauchst also eine Quelle für Shop-Namen, und 3 Quellen funktionieren ohne den verbotenen Suchpfad zu berühren. Du kannst Shops nutzen, die du bereits verfolgst, den oben genannten findAllListingsActive-Endpunkt oder einen vorbereiteten Datensatz. Dieser Endpunkt akzeptiert keywords mit alleinigem Anwendungsschlüssel und enthält eine shop_id bei jedem gelieferten Listing.
Wir riefen Seiten über den Bereich hinweg ab und über das erklärte Ende hinaus:
page  2    36 items
page 25    36 items
page 51    36 items
page 52     6 items      51 x 36 + 6 = 1,842
page 53    no ItemList block
page 60    no ItemList block
Die Summe entspricht den vom Shop angegebenen 1.842. Über das Ende hinaus antwortet Etsy weiterhin mit einer vollständigen Seite von rund 420 KB und ohne ItemList.
Etsy liefert keinen Fehler und kein leeres Array zum Abbrechen, eine Schleife, die auf eines von beidem wartet, paginiert also endlos weiter gegen Seiten, die unauffällig aussehen. Breche stattdessen beim fehlenden Block ab, und lass die angegebene Anzahl deine Arbeit prüfen. Die üblichen Muster für paginierte Erfassung setzen eines dieser 2 Signale voraus, sie gelten hier also nicht.
Beide Funktionen gehören in dieselbe Datei wie die vorherigen Funktionen, da sie LD_JSON und fetch_html nutzen. Kommentiere den Einstiegspunkt aus, den du nicht ausführst, da der Enumerator 20 Minuten braucht:
def shop_itemlist(html):
    """Pick the ItemList block. The first block on a shop page is a video."""
    for block in LD_JSON.findall(html):
        try:
            parsed = json.loads(block.strip())
        except json.JSONDecodeError:
            continue
        for node in parsed if isinstance(parsed, list) else [parsed]:
            if node.get("@type") == "ItemList":
                return node
    return None


def enumerate_shop(shop_name, country="us"):
    """Page a shop until the ItemList stops appearing, and hand back the declared
    count so the caller can check it."""
    base = f"https://www.etsy.com/shop/{shop_name}"
    urls, declared, page = [], None, 1
    while True:
        suffix = "" if page == 1 else f"?page={page}"
        try:
            node = shop_itemlist(fetch_html(base + suffix, country=country))
            if node is None:
                break
            declared = node.get("numberOfItems", declared)
            urls += [item["item"]["url"] for item in node["itemListElement"]]
        except (RuntimeError, requests.RequestException, KeyError, TypeError,
            AttributeError) as err:
            print(f"stopped at page {page}: {err}", flush=True)
            break
        print(f"page {page}: {len(urls)} of {declared}", flush=True)
        # Breaking on the declared count here would make the comparison below
        # vacuous, so page until the ItemList block stops appearing.
        page += 1
    return urls, declared


if __name__ == "__main__":
    urls, declared = enumerate_shop("AnemoneJewelry")
    print(len(urls), "collected,", declared, "declared")
Der Enumerator führt 53 Abrufe gegen die oben gemessenen Seiten durch, liefert 1.842 URLs und prüft die Summe gegen die vom Shop angegebene Zahl. Vergleiche diese 2 Zahlen bei jedem Durchlauf, denn ein zu kurzer Durchlauf liefert weniger URLs und löst keinen Fehler aus.
Der try-Block muss auch das Parsen abdecken, nicht nur den Abruf. Eine 53-Anfragen-Schleife ist lang genug, um die Ratenlimit-Antwort zu erhalten, und ein einzelnes fehlerhaftes itemListElement richtet denselben Schaden an wie eine fehlgeschlagene Anfrage. Ohne die Absicherung würde eines von beidem bei Seite 30 einen Fehler auslösen und alle bis dahin gesammelten URLs verwerfen. Beide abzufangen hinterlässt einen zu kurzen Durchlauf statt eines verlorenen Laufs, und der Zahlenvergleich zeigt es. Das Behandeln fehlgeschlagener Anfragen in Python folgt einem Standardmuster, und der einzige Etsy-spezifische Teil ist, das Parsen innerhalb der Absicherung zu platzieren.
Bei der oben gemessenen Latenz sind 53 Abrufe 20 bis 24 Minuten und 53 Anfragen aus dem kostenlosen monatlichen Kontingent, für 1 Shop. Führe den Enumerator zuerst an einem kleinen Shop aus und beobachte, wie die Seitenzahl steigt, bevor du ihn an einem Shop mit 1.842 Listings einsetzt. Setze zudem ein Nutzungslimit auf die Zone, damit ein fehlgeschlagener Lauf an einer Grenze stoppt statt an deinem Guthaben.
Wir führten dieselbe Erschließung über den Etsy-Shop-Endpunkt der Web Scraper API als Batch-Job aus. Wir führten den Job am Shop aus statt an Listing-URLs, und begrenzten ihn für den Vergleich auf 50 Datensätze. Er lieferte 50 Listings in 168,9 Sekunden, also rund 3,4 Sekunden pro Datensatz, ohne Duplikate und ohne sprachpräfixierte URLs in diesem Lauf.
Diesen gesamten Shop zu erfassen benötigt 53 Erschließungsabrufe plus 1.842 Listing-Abrufe, also 1.895 Anfragen und rund 13 Stunden single-threaded. Prüfe diese 1.895 gegen das aktuelle kostenlose Kontingent, bevor du beginnst. Über dieses Kontingent hinaus wird dieselbe Arbeit zum Pay-as-you-go-Tarif pro 1.000 erfolgreiche Anfragen abgerechnet.
Fixiere country auch hier. Wir riefen denselben Shop ohne dieses Argument ab und erhielten /de/listing/-URLs und deutsche Titel. Diese URLs würden als andere Schlüssel in einen Datensatz eingehen, für Artikel, die bereits unter ihrer /listing/-Form gespeichert sind.
Extraktionsprobleme, die einen Etsy-Datensatz unbemerkt beschädigen
Jedes Problem hier liefert HTTP 200 und löst keine Ausnahme aus. Von den 5 schreiben 4 eine plausible, aber falsche Zeile, und das fünfte schreibt eine leere Zeile. Stattdessen findest du Monate später eine falsche Zahl. Datenqualitätsmetriken erkennen diese Art von Fehler, nachdem die Daten gespeichert sind, und die falsche Zeile nicht zu schreiben ist günstiger.
Eine Listing-Seite hat 4 JSON-LD-Blöcke, nicht 1. Etsy fügte Product, VideoObject, BreadcrumbList und FAQPage in 4 separaten Script-Tags bei jedem von uns geöffneten Listing ein, alle mit dem Typ application/ld+json. Der Seitenquelltext zeigt sie auf 4 aufeinanderfolgenden Zeilen:
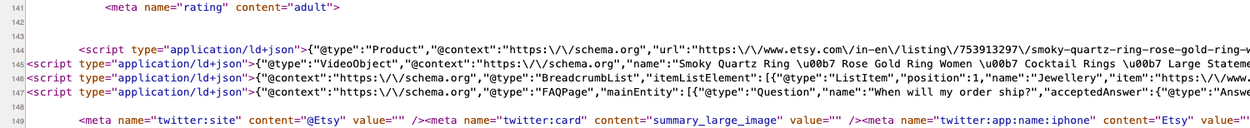
Code, der find() aufruft und den ersten Treffer nimmt, funktioniert auf Listing-Seiten und liefert auf Shop-Seiten unbemerkt den Video-Block. Wähle nach @type statt nach Position. Sonst ändert sich nichts an der Mechanik des JSON-Parsens in Python.
Eine Shop-Seite hat ebenfalls 4 eigene Blöcke, in anderer Reihenfolge:
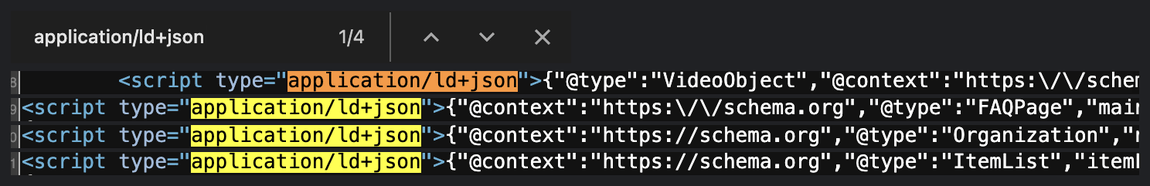
Bei dem getesteten Shop ist der erste Block ein Video, und der gewünschte ItemList steht zuletzt, den ersten Treffer zu nehmen schlägt also fehl. Das obige Skript wählt stattdessen nach @type aus.
Bei einem Listing mit Variationen ist offers.price der niedrigste Preis im Bereich, nicht der gesamte Bereich. Beim getesteten Listing zeigte offers.price 89.25, während der in offers verschachtelte priceSpecification-Eintrag minPrice 89.25 und maxPrice 5613.75 angab. Ein Parser, der offers.price liest, erfasst die billigste Variation und verwirft den Bereich. maxPrice stattdessen zu speichern ist ebenfalls keine Lösung, denn bei diesem Listing ist maxPrice der Preis eines Bundles und nicht des Artikels allein.
Wir erfassten dieselbe URL mit aktivierten Variationen und erhielten 61 separate Datensätze, 1 pro Variante, bepreist von 89,25 bis 1.871,25. Eine einzelne Listing-Zeile in deiner Tabelle repräsentiert 61 kaufbare SKUs über eine 21-fache Preisspanne.
Ein zweites Dropdown auf der Seite vervielfacht diesen Bereich:
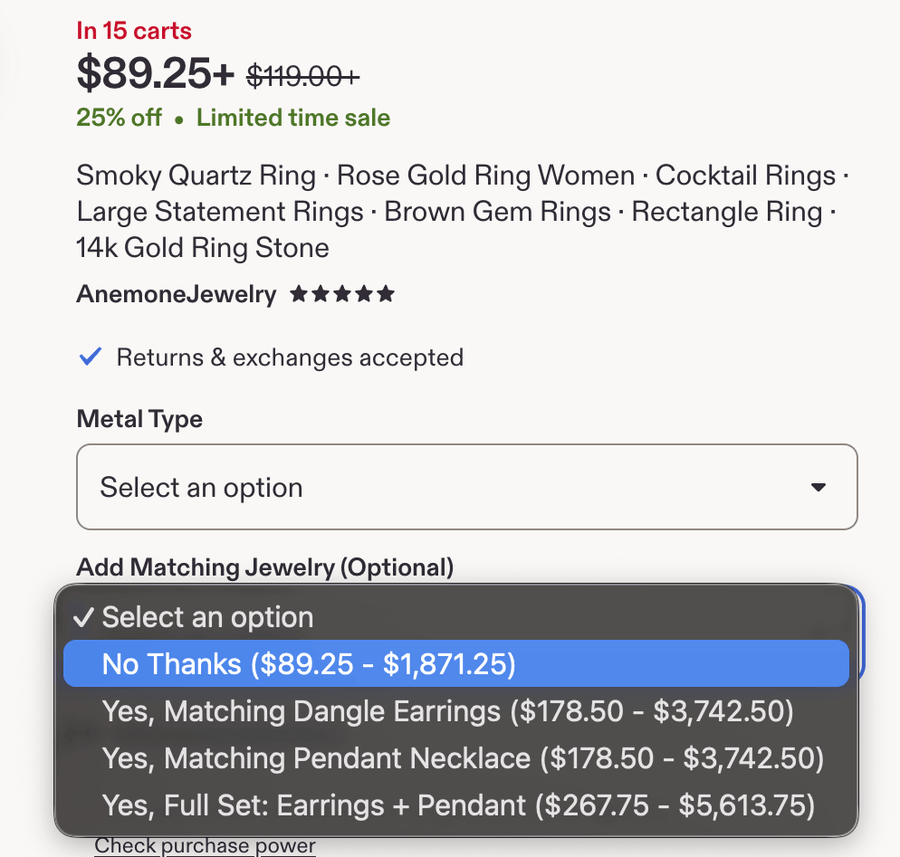
Diese 2 Höchstwerte messen unterschiedliche Dinge, und dieses Listing hat 2 Variationsachsen. Metal Type reicht von 14k Gold Filled bei 89,25 bis zu den 3 Massivgold-Optionen bei 1.871,25. Add Matching Jewelry (Optional) vervielfacht diesen Bereich dann. No Thanks reicht von 89,25 bis 1.871,25, ein einzelnes passendes Teil von 178,50 bis 3.742,50, und Full Set: Earrings + Pendant von 267,75 bis 5.613,75.
Der angegebene maxPrice ist der Massivgold-Ring plus beide passenden Teile, 3 Artikel zu 1 Preis. Der Variationsextrakt lieferte den Ring allein und traf die No Thanks-Zeile auf den Cent genau.
Wann immer ein Listing eine Zusatzachse hat, ist maxPrice also das Maximum für ein Bundle statt für den Artikel. Eine darauf aufgebaute Preisreihe verfolgt unbemerkt Bundles. Zähle die Variationsachsen, bevor du einen Bereich als den eigenen des Produkts speicherst. Sie stehen nicht im JSON-LD, lies sie also von der gerenderten Seite oder ziehe den Variationsextrakt.
Dasselbe priceSpecification-Array enthält zudem einen zweiten Eintrag mit der Kennzeichnung StrikethroughPrice, der Angebotspreis und der Listenpreis stehen also nebeneinander, unterschieden nur durch eine schema.org-URL. Dieser Eintrag hat eigene minPrice– und maxPrice-Werte. Der vom Skript erfasste list_price ist der niedrigste Preis im Listenpreisbereich, genau wie offers.price der niedrigste im aktuellen Bereich ist.
Die Sprache folgt der Ausgangs-IP, und das ändert mehr als nur das Währungssymbol. Wir riefen 1 Listing 3-mal innerhalb derselben Stunde ab und änderten nur das Ausgangsland:
country   currency   price    variation range      title
us        USD        89.25    89.25 - 5613.75      Smoky Quartz Ring, Rose Gold Ring Women
de        EUR        95.71    95.71 - 5058.76      Rauchquarzring, Damenring aus Roségold
gb        GBP        82.77    82.77 - 4338.22      Smoky Quartz Ring, Rose Gold Ring Women
Dasselbe Listing wird von jedem Ausgangsland unterschiedlich gerendert:
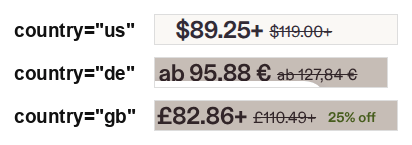
Diese Aufnahmen stammen aus einem späteren Abruf als die 3 Zeilen, und nur der Dollarwert blieb gleich. Die deutsche Seite schreibt ihren niedrigsten Preis zudem als ab, und das + markiert dasselbe auf den beiden anderen Seiten.
Die 3 Abrufe lieferten dieselbe SKU, Bewertung und Rezensionszahl, zu 3 verschiedenen Preisen in 3 Währungen. Das Verhältnis zwischen niedrigstem und höchstem Preis unterscheidet sich zwischen den 3 Zeilen, 62,9-fach bei der US-Zeile gegenüber 52,9-fach und 52,4-fach, es bewegte sich also mehr als nur der Wechselkurs zwischen diesen Abrufen. Der deutsche Ausgang lieferte zudem einen maschinell übersetzten Titel, während die 2 englischen Sprachversionen das Original behielten.
Ein rotierender Pool, der Geografie ignoriert, erzeugt eine Preisreihe, die 3 Währungen mischt, und einen Textkorpus, der Sprachen mischt, und nichts in der Pipeline meldet ein Problem. Fixiere das Ausgangsland pro Erfassungslauf und speichere die Währung bei jedem Preis.
Dasselbe Problem tritt in vorbereiteten Daten auf. Die heruntergeladene 1.000-Datensätze-Stichprobe hatte 19 Währungen, mit 109 Zeilen in einer anderen Währung als USD, 14 davon in vietnamesischem Dong bepreist. Diese Stichprobe wird aktualisiert, deine Kopie wird also von diesen Summen abweichen. Führe denselben Vergleich an deiner eigenen Kopie durch.
Die Preisspalte zu mitteln, ohne die Währungsspalte zu lesen, bläht den Mittelwert auf:
mean(final_price), all rows          31,238.84   n=991
mean(final_price), currency = USD       137.57   n=882
                                        ~227x
median(final_price), all rows            26.00
In dieser Spalte tragen 14 von 991 Zeilen 87% zur Gesamtsumme bei, aber 109 Zeilen sind nicht in USD, und alle brauchen Behandlung. Die Abfrage läuft, die Spalte ist ein sauberer Float, und die Antwort ist um 2 Größenordnungen falsch. Der Median bewegt sich kaum, da die Nicht-USD-Zeilen nur einen kleinen Anteil der Spalte ausmachen. Ein Mittelwert und Median, die so stark voneinander abweichen, sagen dir nur, dass ein starker Ausreißerbereich vorliegt. Eine Gruppierung nach der Währungsspalte trennt gemischte Einheiten von gewöhnlicher Schiefe.
Ein arXiv-Paper vom März 2026 zu Marktplatz-Listings, weiter unten erneut zitiert, beschränkte seine Stichprobe auf in USD bepreiste Listings, bevor es irgendeine Analyse durchführte. Das löst das Problem nach der Erfassung statt während ihr. Das Filtern auf diese Weise ändert zudem die Population, die der Durchschnitt beschreibt, da es Listings in anderen Währungen verwirft statt sie umzurechnen.
Dieses Problem ist auf dem Agenten-Pfad am schwersten zu erkennen. Wir riefen dieses Listing über einen MCP-Server ab, dessen Schema nur eine URL akzeptiert, und erhielten das tschechische Storefront in CZK bepreist. Der länderfixierte REST-Aufruf meldet dasselbe Listing zu 89,25 USD.
Die Ursache ist die Schnittstelle des Tools, nicht der Abruf. Ohne Land- oder Sprachparameter zum Setzen nimmst du, was auch immer der Server als Ausgang nutzt. Prüfe dieses Verhalten bei jedem solchen Server, bevor du ihn mit einem Agenten verbindest, denn der Ausgang entscheidet über die Währung jeder nachfolgenden Antwort.
Erfasse Etsy-Daten also in deinem eigenen Speicher mit fixierter Sprache, und lass den Agenten diesen Speicher lesen statt pro Frage live abzurufen. Ein Agent, der unbemerkt jedes Mal in einer anderen Währung antwortet, ist schlimmer als ein Agent, der nicht antworten kann.
Ein totes Listing ist eine vollständige Seite mit einem Preis darauf. Etsy liefert bei einem abgelaufenen oder ausverkauften Listing keinen 404. Wir riefen ein Listing von 2007 ab und erhielten HTTP 200, 465.563 Byte, einen vollständigen Product-Block und price 13.00 USD.
Die Seite rendert vollständig und zeigt sowohl das Ausverkauft-Banner als auch den Preis:
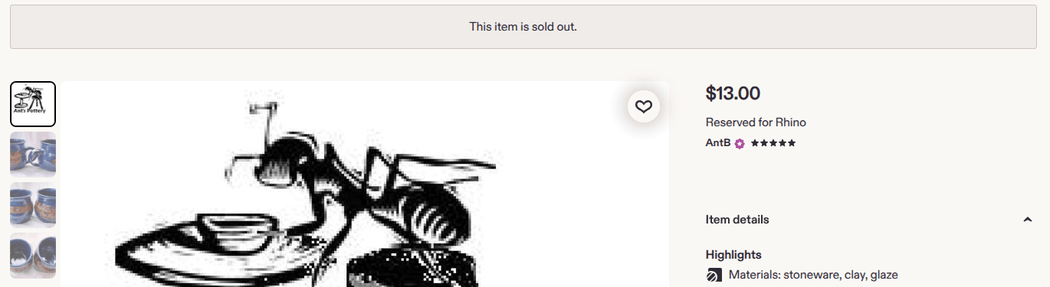
offers.availability ist das einzige Feld, das dem Preis widerspricht, und es zeigt schema.org/OutOfStock. Ein Parser, der es überspringt, erfasst einen toten Artikel zum vollen Preis, das obige Skript liest also dieses Feld.
Dieses Feld ist in vorbereiteten Daten weniger zuverlässig als auf der Seite. In derselben Kopie waren 74 von 1.000 Zeilen ausverkaufte Listings, availability war bei allen 74 leer, und 65 zeigten weiterhin einen numerischen Preis. Das Anzeichen dort ist ein show_sold_out_detail-Parameter in der gespeicherten URL. Nur die Zeilen zu behalten, deren availability InStock zeigt, würde 798 aktive Zeilen verwerfen, da das Feld bei den meisten von ihnen ebenfalls fehlt.
Eine 2xx-Antwort bedeutet nicht, dass du Daten hast. Dieses Problem liegt in der Erfassungsebene statt im Payload, und wir sahen es während der Tests mit dem obigen Skript. Der Unblocking-Endpunkt erklärt sich selbst im Body. Als das Konto ein Anfragenratenlimit erreichte, antwortete es mit 200 und einem 111 Byte großen Klartext-Body mit dem Wortlaut Your system is sending too many of this type of request. Die Statuszeile bleibt ein Erfolg, raise_for_status() besteht also, der Parser findet keinen Product-Block, und eine Schleife schreibt leere Zeilen ohne eine einzige Ausnahme.
Die Web Scraper API behandelt denselben Fall bewusst. Ihr synchroner Collect-Endpunkt liefert Datensätze innerhalb von 1 Minute, längere Jobs laufen asynchron weiter. Derselbe Endpunkt antwortet mit 202 und einer snapshot_id sowie einem retry-after, wenn ein Job diese Minute überschreitet, sodass du das Ergebnis abholen kannst, sobald es fertig ist, wie die API-Referenz dokumentiert. Beide Antworten sind Erfolgsstatus, verzweige also nach dem Statuscode, bevor du in eine Datensatzliste indizierst.
Die Absicherung in fetch_html ist 2 Zeilen lang und prüft auf eine Seite mit ld+json statt auf einen der Fehler. Den Enumerator gegen einen aktiven Shop laufen zu lassen fand einen dritten Fall, ein 200 mit leerem Body, und dieselbe Absicherung fing ihn ohne jede Änderung ab. Prüfe die Antwort also auf den gewünschten Inhalt statt gegen bereits gesehene Fehler, da Anbieter-Fehlertext keine stabile Schnittstelle ist. Schreibe das Äquivalent für jede Abrufebene, die du nutzt, denn ein Erfolgsstatus garantiert nicht das Payload.
Ein durchgearbeitetes Beispiel beweist, dass ein Problem existiert, nicht dass es häufig ist. Wir prüften das Preisspannen- und Durchstreichungs-Problem an 100 Listings aus beiden Erschließungspfaden. Variationen sind bei 98 von 100 vorhanden, und initial_price unterscheidet sich bei denselben 98 von final_price. Kein Problem ist ein Randfall, den man aufschieben kann. Diese 100 kamen über die 2 oben genannten Erschließungspfade und nicht über eine Zufallsstichprobe über Etsys Kategorien hinweg. Lies 98 also als Minimum für Schmuck-Listings statt als Rate für die gesamte Site.
Derselbe Check zeigt, dass das oben verwendete Listing in einem Punkt ungewöhnlich ist. Dieses Listing hat 99 Rezensionen, während der Median in diesem Crawl bei 1 liegt und in der veröffentlichten Datensatz-Stichprobe bei 0.
Wann ein verwalteter Datensatz statt eines gepflegten Scrapers sinnvoll ist
Du kannst den Scraper bauen, und der obige Code ist das meiste davon. Die Entscheidung liegt darin, welche Fehler du selbst behandeln möchtest.
Wir führten dasselbe Listing erneut über die Web Scraper API aus, diesmal per URL erfasst statt aus einem Shop erschlossen. Sie lieferte 58 Felder gegenüber den 14 im rohen Product-Block, und die zusätzlichen Felder behandeln die meisten der oben genannten Probleme:
raw JSON-LD (geo=us)          Web Scraper API
-----------------------------------------------------
price 89.25 (range minimum)   final_price 89.25
119.00 (StrikethroughPrice)   initial_price 119
not present                   discount_percentage 25
not present                   listing_has_variations true
not present                   reviews_count_shop 15129
not present                   is_star_seller false
4 embedded reviews            6 top_reviews
14 fields                     58 fields
Du konfigurierst diesen Extraktor pro Eingabe-URL und setzt all_variations für das Preisspannen-Problem auf true:
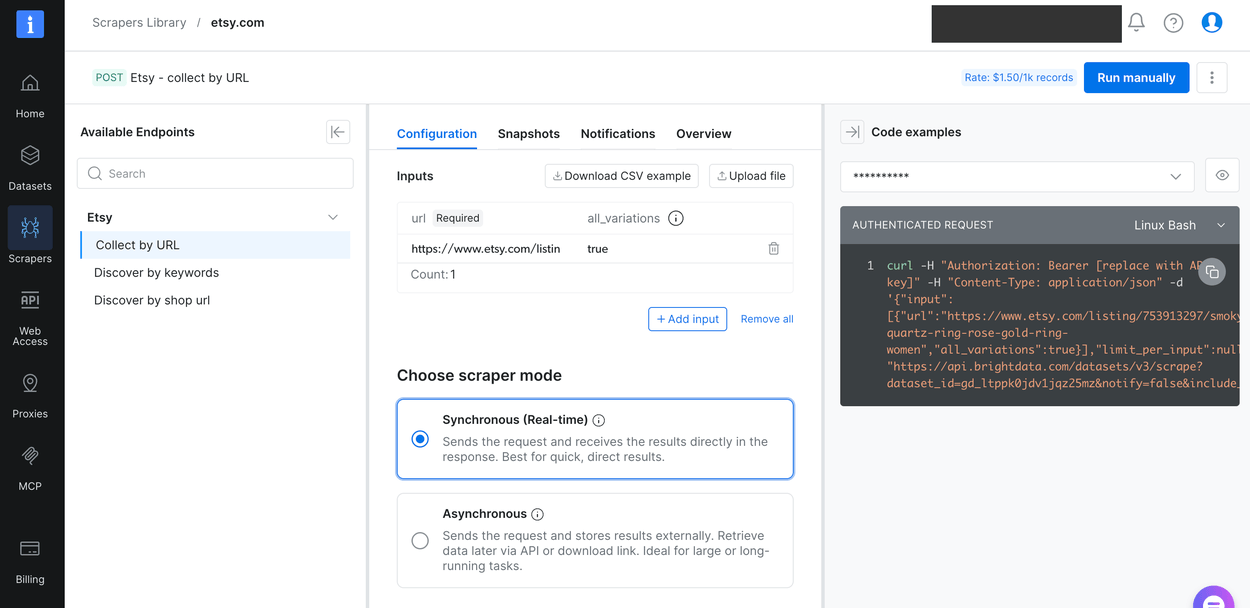
Die 6 Felder, die wir über beide Pfade verglichen, stimmten exakt überein, und zwar Währung, berechneter Preis, Listenpreis, Bewertung, Artikel-Rezensionszahl und Versandursprung. Führe diesen Check durch, bevor du einem der beiden Pfade vertraust.
Der Zeitvergleich kehrt sich um, und der Modus entscheidet über das Ausmaß. Über den synchronen Endpunkt dauerte die strukturierte Extraktion rund 50 Sekunden für einen einzelnen Datensatz, gegenüber 27 Sekunden für den rohen Abruf. Er rendert und normalisiert statt nur Bytes zu liefern. Die 50 Sekunden lassen rund 10 Sekunden innerhalb des oben genannten 1-Minuten-Timeouts. Der Endpunkt ist für 1 URL und eine sofortige Antwort gebaut.
Wir führten denselben Scraper stattdessen als Batch-Job aus und erhielten die oben genannten 50 Datensätze zu je 3,4 Sekunden. Jeder Datensatz kostet rund 1/8 der 27 Sekunden, die ein roher Abruf benötigt. Im Batch-Modus ist der 202 die erwartete Antwort, kein zu behandelnder Fehler.
Für einen wiederkehrenden Crawl nimmt der strukturierte Pfad deinem Team Selektorpflege, Sprachfixierung und Preisspannen-Behandlung ab, für die zurückgelieferten Felder. Für 1 Listing ist er in jedem Modus langsamer. Der obige Vergleich zeigt die gelöste Preisbehandlung, und der 50-Datensätze-Lauf zeigte keine sprachpräfixierten URLs. Selektorpflege ist der einzige Teil, den kein einzelner Lauf testen kann. Der strukturierte Pfad wird genauso abgerechnet wie Web Unlocker, mit dem aktuellen kostenlosen Kontingent und dem Tarif pro 1.000 Datensätze auf der Web-Scraper-API-Preisseite.
Dieselbe Stichprobe enthält 2 statt 1 Art von Datensatz, plane also beim Kauf für beide. Von den 1.000 Zeilen haben 128 den vollständigen Feldsatz, und die übrigen 872 lassen 12 ihrer Felder leer, darunter description, product_category und store_country.
Die Aufteilung folgt dem Alter des Listings, mit dem vollständigen Datensatz bei Artikeln, die ab Ende 2025 gelistet wurden. Ein über Jahre reichender Massenextrakt mischt also beide Arten in 1 Datei. Dieses Verhältnis sollte sich mit zunehmendem Alter des Korpus zum vollständigen Datensatz hin verschieben. Prüfe die Feldabdeckung gegen deine eigenen benötigten Spalten, bevor du die Bestellgröße festlegst, nicht danach.
Das Rezensionsvolumen braucht vor der Bestellung denselben Check. In der von uns abgerufenen Kopie hatten 753 von 1.000 Listings keine Rezensionen, der Median liegt also bei null. Die obersten 10% der Listings haben 98% aller Rezensionen. Der Mittelwert von 52,5 pro Listing beschreibt die Datei als Ganzes und kein Listing, das du öffnen wirst.
Die Rezensions-Schiefe sieht wie der Währungsfall aus, ist aber ein anderer Fehler mit einer anderen Lösung. Der obige Währungsfall ist ein Einheitenfehler, und der Mittelwert ist falsch. Rezensionsvolumen ist Schiefe, und dort ist der Mittelwert für eine Gesamtsumme richtig. Eine Zufallsstichprobe von 1.000 Listings sollte rund 52.500 Rezensionen liefern, nutze den Mittelwert also, wenn du einen Massenkorpus planst. Bei einer pilotgroßen Stichprobe macht diese Konzentration die Schätzung unzuverlässig.
Abdeckung ist eine andere Frage. Bei 753 von 1.000 auf null haben nur rund 25% der gekauften Zeilen überhaupt Rezensionen.
Wenn die benötigten Daten historisch statt live sind, überspringt ein vorbereiteter Datensatz den Crawl. Die Seite zum Etsy-Datensatz listet die aktuelle Feldanzahl, Gesamtdatensätze, Preis pro Datensatz und Mindestbestellung, und diese 4 Zahlen sind die Kauf-Rechnung.
Der Preis pro Datensatz auf dieser Seite ist der Einmaltarif, und Aktualisierungspläne von halbjährlich bis täglich kommen als Abonnements, die ihn vergünstigen. Wie aktuell die Daten sind, zählt ebenfalls. Die Seite beschreibt vorab erfasste Datensätze als Tage bis Monate alt, während die Erfassung auf Abruf es dir erlaubt, dieses Limit vor dem Checkout festzulegen. Du wählst den Aktualisierungsplan und das Volumenniveau direkt auf der Datensatzseite.
Diese Werte ändern sich ohne Vorankündigung, lies sie also vor der Budgetierung von der Seite, und behandle beide Preisseiten gleich. Die Datensatzseite zeigt eine Stichprobe der Datensätze unter der Zusammenfassungszeile, unscharf bis du Zugriff anfragst:
Ein externer Referenzpunkt ist hier mehr wert als eine Anbieteraussage. Dasselbe Paper, Mecha-nudges for Machines, dokumentiert in Anhang B, woher seine Daten stammen. Die Autoren geben an, dass die Rohdaten “von der Firma Bright Data bezogen wurden, die strukturierte Datensätze von Etsy-Produktlistings bereitstellt”. Ihr Extrakt “wurde am 12. November 2025 erfasst und am selben Tag geliefert”. Sie beschreiben 2 Snapshots von 5 Mio. und 1,06 Mio. Listings. Dieser Anhang ist überprüfbar, eine Anbieter-Fallstudie nicht.
Die Regel hier ist eng gefasst. Baue den Scraper, wenn du ein paar tausend Listings brauchst, die du per URL erschließen kannst, und bereit bist, 1 Sprache zu fixieren. Kaufe die Erfassungsebene, wenn die URL-Liste der schwierige Teil ist, oder wenn der Crawl dauerhaft laufen muss. Kaufe sie auch, wenn der Datensatz in Preisarbeit einfließt, denn die Preisspannen- und Durchstreichungsfelder kommen bereits getrennt an. Die Währungsspalte braucht auf beiden Pfaden weiterhin Filterung.
Beim oben gemessenen Shop kostet der Eigenbau 1.895 Anfragen und rund 13 Stunden single-threaded für 1.842 Listings. Die Kaufseite ist eine Mindestbestellung vorbereiteter Datensätze. Diese 2 Zahlen sind nicht direkt vergleichbar, da die Baukosten pro Shop anfallen und die Kaufkosten ein Minimum sind, das du über Shops verteilst.
Fazit
Etsy blockiert gewöhnliches Abrufen, während es schema.org-JSON-LD auf denselben öffentlichen Seiten veröffentlicht, die Extraktion ist also ein kurzer Job und der Zugriff der Großteil der Arbeit. Der Transport entscheidet nicht über den Zugriff, denn ein sichtbarer Browser lud eine Seite, die 9 feinabgestimmte HTTP-Clients nicht laden konnten, und Etsy lehnte denselben Browser bei seiner zweiten Anfrage ab. Das technische Problem ist also, wie man weiter sammeln kann, nicht wie man wie ein Browser aussieht. Welchen Pfad du auch wählst, die Datenfehler kosten mehr als die Zugriffsfehler, denn eine Spalte mit gemischten Währungen oder ein totes Listing zum vollen Preis parst sauber durch, und du findest es erst Monate später. Rufe 1 Listing sowohl über einen rohen Abruf als auch über einen strukturierten Extraktor ab, vergleiche die Felder, und lass das Ergebnis Eigenbau versus Kauf entscheiden, bevor du den Crawler schreibst.
Häufig gestellte Fragen
Gibt es eine API für Etsy?
Ja. Die Etsy Open API v3 listete bei unserer Zählung 76 Pfade, von denen 31 GET-Operationen nur einen Anwendungsschlüssel benötigen. Sie liefert Listings, Shops, Rezensionen und Taxonomie. Für Shops, die man nicht betreibt, lässt sie Verkäufe pro Listing, Stichwort-Suchvolumen, Konversionsrate und Historie aus, die viele Datenprojekte benötigen.
Ist die Etsy-API kostenlos?
Die API selbst hat keinen veröffentlichten Preis, aber der Zugriff hängt von einer Genehmigung und von Ratenlimits ab, die pro Anwendungsschlüssel gesetzt werden. Etsy entscheidet, wer höhere Limits erhält, und kann zusätzliche Bedingungen oder Gebühren anhängen. Die praktischen Kosten sind das Ratenlimit statt einer Gebühr.
Warum wird mein Etsy-Scraper blockiert?
Etsy nutzt DataDome, das einen 403 mit einer kurzen Blockseite und einem X-DataDome-riskscore-Header liefert, der deine Anfrage bewertet, wobei 1,0 am schlechtesten ist. Der Score folgt deiner aufrufenden IP und Anfrage-Signatur. In unseren Tests senkten Header-Änderungen den Score und Chrome-TLS-Impersonation erhöhte ihn, und keines von beiden lieferte eine Seite.
Erlaubt Etsy Web-Scraping?
Nicht ohne ausdrückliche Erlaubnis von Etsy. Die Nutzungsbedingungen sind das strengere Dokument. robots.txt verbietet Stichwortsuche, Verkaufshistorie und Favoriten in jeder Sprachvariante und lässt Listing- und Shop-Seiten offen. Etsy schreibt diese Datei ohne Vorankündigung um, lies also die aktuelle Kopie, bevor du baust.
Kann man Etsy mit Python scrapen?
Ja. Listing-Seiten betten schema.org-JSON-LD ein, die Extraktion benötigt also keine CSS-Selektoren. Wähle den application/ld+json-Block, dessen @type Product ist, und flache dann das Offer-Objekt ab. Der Abruf ist der schwierige Teil, und das Sammeln in großem Volumen benötigt neue Browsing-Kontexte und rotierende Adressen.
Wie bekomme ich Etsy-Verkaufsdaten?
Verkäufe sind nur auf Shop-Ebene öffentlich. Der getShop-Endpunkt liefert transaction_sold_count, einen lebenslangen Wert für den gesamten Shop. Nichts teilt das pro Listing für einen Shop auf, den man nicht betreibt, die Zahlen pro Listing eines Tools stammen also von anderswo. Behandle diese als Schätzungen und prüfe sie gegen Shop-Gesamtwerte.
Hat Etsy eine Sitemap zum Crawlen?
Bei unserer letzten Prüfung keine. Die robots.txt-Datei nennt keine Sitemap:-Direktiven, und /sitemaps.xml liefert einen 403 mit leerem Body. Ohne Sitemap musst du URLs aus Shop-Seiten, dem API-Endpunkt findAllListingsActive oder einem vorbereiteten Datensatz erschließen. Keiner dieser 3 Wege berührt den verbotenen Suchpfad.
Blockiert Etsy KI-Crawler wie GPTBot?
Nicht namentlich bei unserer Prüfung. Die robots.txt-Datei nennt nur 3 User-Agent-Gruppen, keine davon ein KI-Crawler, und Etsy veröffentlicht keine llms.txt oder ai.txt. DataDome lehnte GPTBot und ClaudeBot dennoch ab, beide mit einem schlechteren Score von 0,9814 gegenüber den 0,923, die ein Chrome-User-Agent erzielte. Unsinnige Strings erzielten denselben Score.