Facebook hat 3,07 Milliarden monatlich aktive Nutzer im Jahr 2026 – mehr als jede andere Social-Media-Plattform. Die mehrschichtige Anti-Bot-Infrastruktur macht das Scraping zu einer der schwierigsten technischen Herausforderungen im Bereich Data Engineering. Dieser Artikel bewertet die 8 besten Facebook-Scraper 2026, getestet unter realen Anti-Bot-Bedingungen mit ehrlichen Preisvergleichen. Bright Data führt das Feld mit einer durchschnittlichen Erfolgsrate von 98,44 % im unabhängigen Benchmark von Scrape.do mit 11 Anbietern an.
In diesem Artikel behandeln wir folgende Themen:
- Was ein Facebook-Scraper ist und wie er sich von der Graph-API unterscheidet
- Die 4 Kriterien, nach denen wir jedes Tool auf dieser Liste bewertet haben
- Bewertungen von 8 Facebook-Scrapern mit Preisen, Vor- und Nachteilen
- Eine Vergleichstabelle zur schnellen Tool-Auswahl
- So wählen Sie den richtigen Facebook-Scraper für Ihren spezifischen Anwendungsfall
TL;DR: Die besten Facebook-Scraper auf einen Blick
| Tool | Typ | Kostenloser Tarif | Startpreis | Am besten für |
|---|---|---|---|---|
| Bright Data | Dedizierter Scraper-API + Datensätze | 5.000 Datensätze/Monat kostenlos | 0,75 $/1K Anfragen | Insgesamt bestes Tool |
| Apify | Vorgefertigte No-Code-Actors | 5 $ monatliche Credits | 49 $/Monat | No-Code-Web-Scraping |
| Oxylabs | Allgemeine Scraping-API | 7-Tage-Test, 2K Ergebnisse | 49 $/Monat | Enterprise-Skalierung |
| Decodo | Allgemeine Scraping-API | 7-Tage-Test, 1K Ergebnisse | ~0,25 $/1K | Bestes Preis-Leistungs-Verhältnis |
| Zyte | Allgemeine Scraping-API | 5 $ Credits für 30 Tage | 1,01 $/1K | Entwickler-Workflows |
| ScrapingBee | Allgemeine Scraping-API | 1K Credits Test | 49 $/Monat | Schnelle Einrichtung |
| ScraperAPI | Allgemeine Scraping-API | 5K Credits Test | 49 $/Monat | Integrationsflexibilität |
| Nimble | KI-gestützte Scraping-API | Eingeschränkter Test | Kontakt Vertrieb | KI-gestütztes Parsing |
Was ist ein Facebook-Scraper?
Ein Facebook-Scraper extrahiert automatisch öffentlich zugängliche Daten von Facebook. Er erfasst Seiten, Beiträge, Profile, Gruppen, Marketplace-Angebote, Events, Reels und Kommentare ohne manuelles Durchsuchen und liefert strukturierte Ausgaben in großem Maßstab.
Die Facebook Graph-API ist kein gleichwertiger Ersatz. Sie erfordert ein Entwicklerkonto, eine App-Einreichung und eine Genehmigung nach Überprüfung. Sie setzt strenge Ratenlimits durch und schränkt den Zugriff auf die meisten öffentlichen Seitendaten ein, einschließlich Beiträge, Engagement-Metriken und Marketplace-Angebote. Ein Facebook-Scraper greift auf dieselben Daten zu, die jeder Browser sehen kann – ohne API-Genehmigung, Ratenlimit-Beschränkungen oder Einschränkungen nach Entitätstyp.
Im Jahr 2026 gibt es drei Kategorien von Facebook-Scrapern. Erstens dedizierte Facebook-Scraper-APIs mit vorgefertigten Templates und strukturierter JSON-Ausgabe – sie sind am schnellsten einsatzbereit und erfordern den wenigsten benutzerdefinierten Code. Zweitens allgemeine Scraping-APIs, die über benutzerdefinierte Parsing-Logik an Facebook angepasst werden können – ideal für Entwickler, die vollständige HTML-Kontrolle wünschen. Drittens No-Code-Tools für Nicht-Entwickler, die Daten per Klick erfassen möchten, ohne eine einzige Zeile Code zu schreiben.
Wie haben wir diese Scraper bewertet?
Jedes Tool auf dieser Liste wurde anhand von vier Kriterien bewertet, die die reale Facebook-Scraping-Leistung messen. Diese Kriterien bestimmen, ob ein Tool im Produktionsbetrieb erfolgreich ist – nicht nur in einer Demo-Umgebung.
Anti-Bot-Umgehungsleistung
Facebook setzt Login-Wall-Weiterleitungen, verhaltensbasiertes Fingerprinting, IP-Ratenlimits und dynamisch per JS gerenderte Inhalte ein. Wir haben gemessen, wie jedes Tool mit diesen Abwehrmaßnahmen umgeht, ohne leere oder blockierte Antworten zurückzugeben. Ein 200-Statuscode mit leerem HTML gilt als Fehler. Nur Tools, die rotierende Residential-Proxys mit Browser-Level-Fingerprint-Spoofing kombinieren, bestehen diesen Test zuverlässig.
Datenabdeckung und Ausgabestruktur
Wir haben gezählt, wie viele Facebook-Entitätstypen jedes Tool unterstützt. Der vollständige Umfang umfasst Seiten, Profile, Gruppen, Marketplace-Angebote, Events, Reels, Beiträge, Kommentare, Hashtags und Anzeigen. Wir haben auch geprüft, ob die Ausgabe vorverarbeitetes strukturiertes JSON oder rohes HTML ist, das manuelle Extraktion erfordert. Vorverarbeitete Ausgabe eliminiert eine gesamte Engineering-Schicht aus Ihrer Pipeline und reduziert die Time-to-Data erheblich.
Preisgestaltung und Skalierbarkeit
Wir haben die Kosten pro 1K erfolgreicher Datensätze, die Verfügbarkeit kostenloser Tarife und das Preisverhalten bei hohen Volumina verglichen. Pay-per-Success-Modelle berechnen nur für gelieferte Datensätze. Kreditbasierte Modelle verbrauchen Credits für jede Anfrage, einschließlich fehlgeschlagener und blockierter. Dieser Unterschied ist besonders relevant beim Scraping stark geschützter Facebook-Seiten mit hohen Blockierungsraten.
Entwicklererfahrung
Wir haben API-Einfachheit, SDK-Sprachunterstützung, No-Code-Optionen, Dokumentationsqualität und Verfügbarkeit des asynchronen Batch-Modus bewertet. Schlechte Dokumentation verursacht versteckte Engineering-Kosten, unabhängig vom Preis pro Anfrage des Tools. Asynchrone Batch-Ausführung ist entscheidend für Jobs, die nachts Millionen von Facebook-URLs verarbeiten.
Die besten Facebook-Scraper im Ranking
Dies sind die 8 besten Facebook-Scraper im Jahr 2026, bewertet nach den oben genannten Kriterien. Jede Tool-Bewertung umfasst Preise, Vor- und Nachteile sowie ein Fazit, um Ihnen die Auswahl zu erleichtern.
1. Bright Data: Bester Facebook-Scraper insgesamt
Bright Data ist die am besten bewertete Facebook-Scraping-Plattform im Jahr 2026.
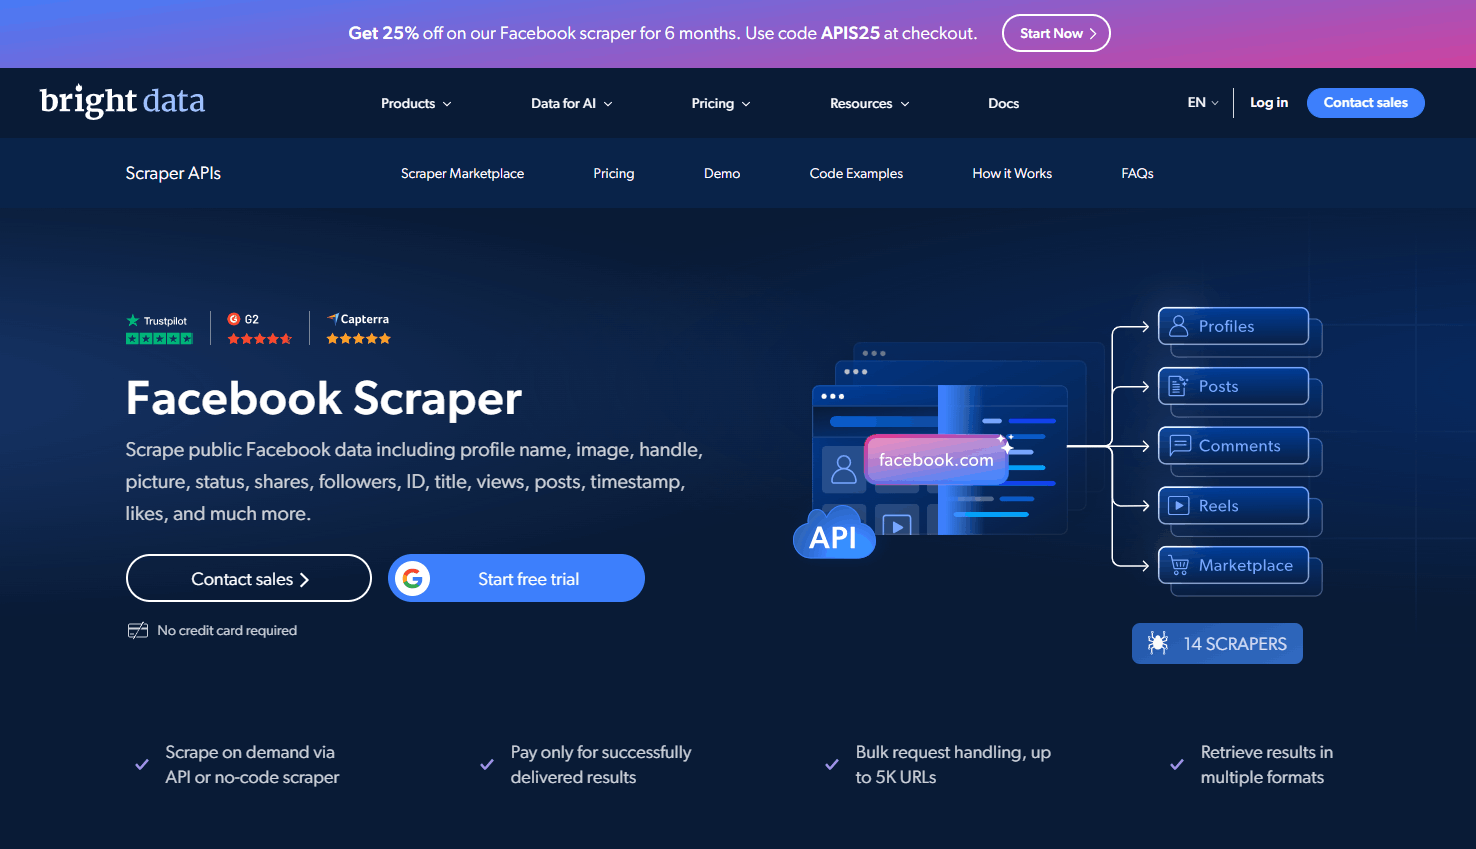
Im unabhängigen Benchmark von Scrape.do mit 11 Scraping-Anbietern erzielte Bright Data eine durchschnittliche Erfolgsrate von 98,44 % – der höchste im Test erfasste Wert. Kein anderes Tool auf dieser Liste erreichte dieses Niveau. Bright Datas Web-Scraping-API umfasst 15 dedizierte Facebook-Scraper-Templates für alle wichtigen Entitätstypen.
Sofort verfügbare Facebook-Datentypen:
- Facebook-Seiten: Name, Beschreibung, Follower-Anzahl, Kontaktdaten, Beitragsfrequenz und Engagement-Gesamtwerte
- Facebook-Profile: Bio, Standort, Berufsverlauf, Ausbildung und öffentliche Beiträge
- Facebook-Gruppen: Mitgliederanzahl, öffentlicher Beitragstext und Engagement-Metriken
- Marketplace-Angebote: Titel, Preis, Zustand, Verkäuferstandort und Produktbeschreibung
- Facebook-Events: Titel, Datum, Ort, Name des Veranstalters und Teilnehmerzahl
- Facebook-Reels: Aufrufzahl, Like-Anzahl, Kommentaranzahl und Untertiteltext
- Facebook-Beiträge: Textinhalt, Medien-URLs, Reaktionsaufschlüsselung, Anzahl der Shares und Veröffentlichungszeitstempel
- Facebook-Kommentare: Autorenname, Text, Zeitstempel und Antwortanzahl
- Hashtags: Beitragsvolumen und Trending-Status
- Anzeigen: Kreativinhalt, Laufzeiten, Targeting-Kategorie und geschätzter Impressionen-Bereich
Keine CSS-Selektoren oder XPath-Regeln erforderlich. Kein manueller Parser-Wartungsaufwand, wenn Facebook sein Layout aktualisiert.
Zwei Zugriffsmodi für jedes Team:
Entwickler rufen die REST-API direkt auf. Der Endpunkt akzeptiert Ziel-URLs oder Suchparameter und gibt strukturiertes JSON mit unbegrenzter Parallelität für große Batch-Jobs zurück. Nicht-technische Nutzer greifen über ein No-Code-Kontrollpanel auf dieselben Scraper zu. Das Panel akzeptiert URLs oder Suchbegriffe und exportiert Ergebnisse im CSV- oder JSON-Format – ohne jeglichen Code.
Sofort einsetzbare Facebook-Datensätze:
Benötigen Sie umfangreiche historische Daten ohne einen Live-Scraper? Verwenden Sie stattdessen Bright Datas Facebook-Datensätze. Diese sind vorgesammelte Datensätze, die auf Anfrage oder nach einem individuellen Lieferplan aktualisiert werden. Der Facebook-Profil-Datensatz enthält über 31 Millionen Profildatensätze, die für 250 $ pro 100K Datensätze zum Download bereitstehen. Dies eliminiert die Scraping-Infrastruktur für historische Anwendungsfälle und beseitigt das Cold-Start-Problem bei neuen Projekten.
Scraping-Browser für JavaScript-intensive Facebook-Seiten:
Facebooks React-basiertes Frontend lädt Inhalte asynchron nach der ersten HTML-Antwort. Eine einfache HTTP-Anfrage gibt eine leere Shell ohne Beitragsinhalt oder Profildaten zurück. Bright Datas Scraping-Browser ist ein verwalteter Cloud-Browser, der JavaScript ausführt und CAPTCHAs automatisch löst. Er fälscht Browser-Fingerabdrücke auf Sitzungsebene, um Facebooks Verhaltenserkennungssystem zu umgehen, und verwaltet die vollständige Rendering-Pipeline ohne jegliche Headless-Browser-Infrastruktur.
400 Mio.+ Residential-Proxy-Netzwerk:
Bright Datas Proxy-Netzwerk leitet Anfragen über ethisch bezogene Residential-IPs in 195 Ländern weiter. Stadtgenaues Geo-Targeting ermöglicht das Scraping von Facebook als Nutzer von jedem beliebigen Standort weltweit. Die Weiterleitung über den 400 Mio.+ Residential-IP-Pool von Bright Data lässt jede Anfrage wie organischen Nutzer-Traffic erscheinen – Facebooks Verhaltensanalysesystem kann dieses Muster in großem Maßstab nicht als nicht-organisch erkennen.
Facebook-MCP-Server für KI-Workflows:
Bright Data bietet einen Facebook-MCP-Server für die direkte KI-Agenten-Integration. Er verbindet sich mit Claude, GPT-4 und anderen LLM-Plattformen ohne benutzerdefinierten API-Code. KI-Agenten können Facebook-Daten in Echtzeit über die MCP-Schnittstelle abfragen. Kein anderes Tool auf dieser Liste bietet native MCP-Server-Integration für Facebook-Daten – ein klares Unterscheidungsmerkmal für Teams, die KI-gestützte Recherche- und Monitoring-Pipelines aufbauen.
Preisgestaltung:
Der kostenlose Tarif bietet 5.000 Datensätze pro Monat ohne Kreditkarte. Pay-as-you-go kostet 0,75 $ pro 1K Datensätze ohne monatliche Verpflichtung und mit unbegrenzter Parallelität. Der Scale-Plan kostet 499 $/Monat und beinhaltet 384.000 Datensätze zu 1,30 $/1K für Überschreitungen. Enterprise-Preise sind individuell mit Mengenrabatten, einem dedizierten Account Manager, Premium-SLA und Prioritätssupport.
Aktuelle Aktionen: Verwenden Sie den Code APIS25 beim Checkout für 25 % Rabatt auf die Scraper-API für 3 Monate. Bright Data verdoppelt Ihre erste Einzahlung bis zu 500 $.
Am besten für: Produktionsreife Facebook-Datenpipelines in jeder Größenordnung – von einzelnen Entwicklern bis hin zu Enterprise-Data-Engineering-Teams.
Vorteile:
- Höchste Erfolgsrate aller getesteten Anbieter: 98,44 % in einem unabhängigen Benchmark mit 11 Plattformen
- 15 vorgefertigte Facebook-Templates für alle wichtigen Entitätstypen mit strukturierter JSON-Ausgabe
- Pay-per-Success-Preismodell eliminiert Kostenverschwendung durch fehlgeschlagene oder blockierte Anfragen
- 31 Mio.+ vorgesammelte Facebook-Profildatensätze sofort zum Download verfügbar
- Facebook-MCP-Server ermöglicht KI-Agenten-Integration ohne benutzerdefinierten API-Code
Nachteile:
- Höhere Kosten pro Anfrage als einfachere allgemeine Tools für ungeschützte öffentliche Seiten
- Die Plattformbreite kann für Teams, die nur einen einzigen Facebook-Datentyp benötigen, komplex wirken
2. Apify: Bester No-Code-Facebook-Scraper
Apify ist eine Cloud-Plattform, die auf vorgefertigten Scraping-Actors für Dutzende von Websites basiert.
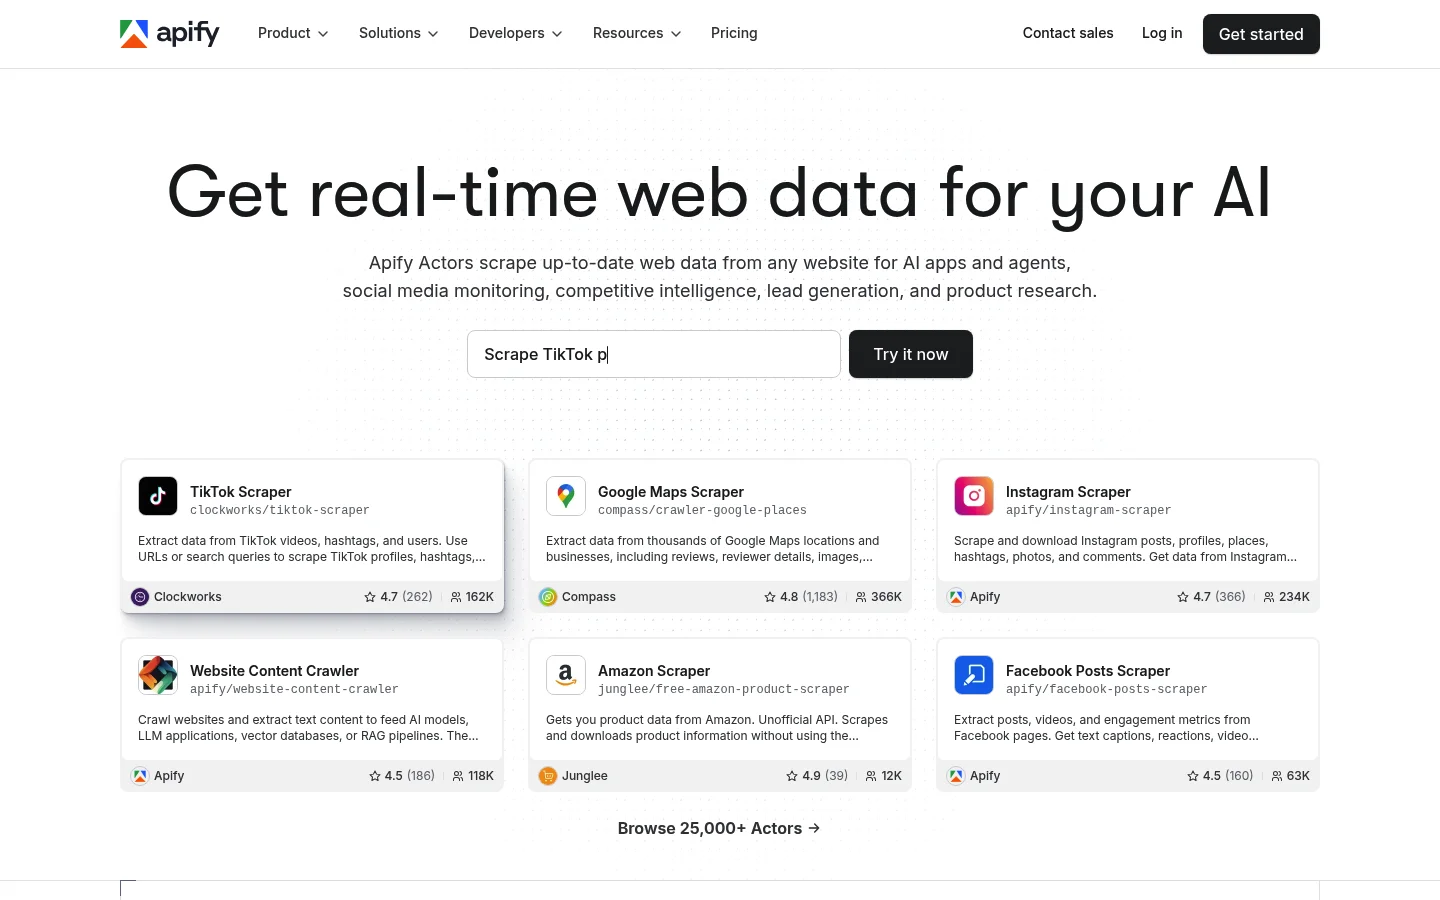
Apifys Actor-Marktplatz bietet die niedrigste technische Einstiegshürde für Nicht-Entwickler auf dieser Liste. Nutzer geben Facebook-URLs oder Suchbegriffe ein, wählen ein Ausgabeformat und laden die Ergebnisse herunter – ohne Proxy-Konfiguration, Browser-Setup oder benutzerdefinierte Parsing-Logik.
Hauptfunktionen:
- Vorgefertigte Facebook-Actors für Seiten, Beiträge, Kommentare, Gruppen, Profile, Anzeigen und Marketplace
- Community-Actor-Marktplatz mit Dutzenden aktiv gepflegter Facebook-Scraper
- Integrierte geplante Ausführungen, Webhook-Zustellung und Datensatzspeicherung in mehreren Formaten
- Programmatischer API-Zugriff für Entwickler, die Actors als automatisierte Pipeline-Schritte auslösen
Preisgestaltung: Der kostenlose Plan enthält 5 $ monatliche Credits (ca. 500 Facebook-Seiten). Starter kostet 49 $/Monat mit 49 $ Credits. Scale kostet 499 $/Monat. Einige Actors berechnen zusätzlich 0,75 $/1K Ergebnisse auf die Platform-Credits.
Am besten für: Nicht-Entwickler und kleine Teams, die strukturierte Facebook-Daten ohne den Aufbau einer Scraping-Pipeline benötigen.
Vorteile:
- Kein Code erforderlich: URLs eingeben und strukturierte Ergebnisse in JSON, CSV, Excel oder HTML herunterladen
- Breite Facebook-Abdeckung: Seiten, Profile, Gruppen, Marketplace, Events, Reels und Anzeigen
- Integrierte Planung, Webhook-Zustellung und Multi-Format-Datensatzexport
Nachteile:
- Standardmäßig Datacenter-Proxys; Residential-IPs kosten extra für stark geschützte Facebook-Seiten
- Community-Actors variieren in der Wartungsqualität und können bei Facebook-DOM-Updates ohne Vorankündigung defekt werden
- Nur Batch-Ausführung schränkt die Feinsteuerung des individuellen Anfrage-Timings ein
3. Oxylabs: Bestes Tool für Enterprise-Skalierung
Oxylabs ist ein allgemeiner Scraping-Infrastrukturanbieter für Enterprise-Daten-Teams.
Die Plattform bietet Enterprise-Zuverlässigkeit und dediziertes Account Management für groß angelegte Deployments. Ein 7-Tage-Test mit 2K Ergebnissen ermöglicht Tests gegen Ihre Facebook-Seitentypen vor der Verpflichtung. KI-gestützte Selector-Konfiguration reduziert die Einrichtungszeit für benutzerdefinierte Parser.
Hauptfunktionen:
- Web-Scraper-API mit KI-gestützter XPath- und CSS-Selector-Konfiguration
- Web Unblocker für Proxy-artigen Facebook-Zugriff mit persistentem Sitzungsmanagement
- Echtzeit- und asynchrone Batch-Ausführung mit Planung für wiederkehrende Workflows
- Dedizierter Account Manager für Enterprise-Pläne
- 150+ Geo-Targeting-Standorte in allen wichtigen Märkten
Preisgestaltung: 7-Tage-Testversion mit 2K Ergebnissen. Abonnementpläne ab 49 $/Monat für bis zu 98K Anfragen. Enterprise-Preise für Mengenrabatte verfügbar.
Am besten für: Große Organisationen, die benutzerdefinierte SLAs, dediziertes Account Management und standortübergreifendes Scraping in Enterprise-Größe benötigen.
Vorteile:
- Enterprise-SLAs mit dediziertem Account Management auf allen Enterprise-Plänen
- Echtzeit- und asynchrone Batch-Modi für flexible Workflow-Integration im gesamten Team
- KI-gestützte Selector-Konfiguration reduziert die Einrichtungszeit für benutzerdefinierte Parser
Nachteile:
- Keine dedizierten Facebook-spezifischen Scraper-Templates; erfordert manuelle Parser-Konfiguration pro Entitätstyp
- Höhere Basiskosten als Pay-per-Success-Alternativen für kleinere Projekte
4. Decodo: Beste Preis-Leistungs-Facebook-Scraping-API
Decodo bietet eine allgemeine Scraping-API mit kostenorientierter Preisgestaltung für budgetbewusste Teams.
Decodo berechnet ca. 0,25 $ pro 1K erfolgreicher Anfragen – der niedrigste Preis pro Anfrage auf dieser Liste. Sein Site Unblocker übernimmt automatisch Proxy-Rotation und Sitzungsmanagement. Der integrierte strukturierte JSON-Parser macht die Konfiguration von XPath- oder CSS-Regeln für Standard-Facebook-Seitentypen überflüssig.
Hauptfunktionen:
- Web-Scraping-API mit Echtzeit- und asynchronen Ausführungsmodi
- Site Unblocker für Proxy-artigen Zugriff mit automatischem Sitzungsmanagement
- Integrierter strukturierter JSON-Parser ohne Selector-Konfiguration
- Länderspezifisches Targeting in 150+ Standorten
- 7-Tage-Testversion mit 1K Ergebnissen und 14-tägiger Geld-zurück-Garantie
Preisgestaltung: Standardplan bei 0,50 $ pro 2K erfolgreicher Anfragen (ca. 0,25 $/1K). Abonnementtarife mit höherem Volumen für größere Workloads verfügbar.
Am besten für: Kleine bis mittelgroße Teams, die Facebook-Daten mit begrenztem Budget benötigen und ihre eigene Nachverarbeitungs- und Parsing-Logik schreiben können.
Vorteile:
- Niedrigste Kosten pro Anfrage aller acht Anbieter auf dieser Liste bei ca. 0,25 $/1K
- 14-tägige Geld-zurück-Garantie reduziert das Testrisiko für neue Nutzer
- Integrierter JSON-Parser erfordert keine XPath- oder CSS-Selector-Einrichtung für Basisseiten
Nachteile:
- Keine dedizierten Facebook-Entitäts-Templates für Beiträge, Profile oder Marketplace-Angebote
- JSON-Ausgabe weniger strukturiert als dedizierte Facebook-APIs für komplexe verschachtelte Daten
5. Zyte: Bester entwicklerorientierter Facebook-Scraper
Zyte ist eine entwicklerorientierte Scraping-Plattform mit einer Cloud-IDE und umfangreichen Browser-Automatisierungsfunktionen.
Zyttes Stärke liegt im Scripting mehrstufiger Browser-Interaktionen – dazu gehören das Erweitern von Kommentar-Threads, das Scrollen unendlicher Newsfeeds und die Navigation durch dynamisch geladene Facebook-Inhalte. Zyte gibt standardmäßig rohes HTML oder Klartext zurück, was Entwicklern vollständige Kontrolle über die Extraktionsschicht und die Datennormalisierungspipeline gibt.
Hauptfunktionen:
- Allgemeine Zyte-API mit automatischer Proxy-Rotation und Ban-Erkennung
- JavaScript-Rendering für dynamische Facebook-Inhalte über verwaltete Headless-Browser
- Cloud-IDE für das Scripting mehrstufiger Browser-Interaktionen einschließlich Infinite Scroll und Kommentar-Erweiterung
- HTTP- und Proxy-Integrationsmodi in einer einheitlichen API verfügbar
- 150+ länderspezifische Geo-Targeting-Standorte
Preisgestaltung: Kostenlose 5 $ Platform-Credits für 30 Tage. Ab 1,01 $ pro 1K Antworten. Browser-Rendering-Anfragen kosten deutlich mehr als einfache HTTP-Anfragen im selben Plan.
Am besten für: Python- und Node.js-Entwickler, die vollständige Kontrolle über Facebook-Browsing-Sequenzen benötigen und benutzerdefinierte Parser schreiben und pflegen können.
Vorteile:
- Cloud-IDE ermöglicht das Scripting komplexer mehrstufiger Facebook-Interaktionen wie Infinite Scroll und Kommentar-Threads
- HTTP- und Browser-Rendering-Modi in einem einheitlichen API-Endpunkt verfügbar
- Transparentes Credit-System pro Anfrage ohne versteckte Zusatzkosten
Nachteile:
- Kein integrierter Facebook-spezifischer Daten-Parser; alle Extraktionslogik muss manuell geschrieben und gepflegt werden
- Browser-Rendering verdoppelt die Kosten pro Anfrage im Vergleich zum einfachen HTTP-Modus
- Steilere Lernkurve für komplexe Facebook-Workflows mit mehrstufiger Navigation
6. ScrapingBee: Bestes Tool für schnelle Einrichtung
ScrapingBee ist eine Echtzeit-Scraping-API mit minimalem Integrationsaufwand.
Der visuelle Request-Builder und die SDKs decken Python, Node.js, PHP und Ruby ab. Ihre erste Facebook-Anfrage kann in unter 10 Minuten gesendet werden. KI-generierte Extraktionsregeln übernehmen grundlegendes Feld-Targeting ohne manuelle CSS- oder XPath-Konfiguration. Eine MCP-Server-Integration fügt Kompatibilität mit KI-Workflow-Tools für Teams hinzu, die LLM-gestützte Pipelines aufbauen.
Hauptfunktionen:
- Echtzeit-API mit JavaScript-Rendering für Facebooks dynamische React-basierte Seiten
- Visueller HTML-Request-Builder mit benutzerdefinierten Headern, Cookies und JavaScript-Szenario-Scripting
- KI-generierte Extraktionsregeln für das Targeting spezifischer Facebook-Datenfelder
- SDK-Unterstützung für Python, Node.js, PHP und Ruby
- MCP-Server-Integration für KI-Workflow- und LLM-Tool-Kompatibilität
Preisgestaltung: 7-Tage-Test mit 1K kostenlosen API-Credits. Pläne ab 49 $/Monat für 250K Credits. Premium- und Stealth-Proxy-Modi verbrauchen 10 bis 75 Mal mehr Credits pro Anfrage als der Basismodus.
Am besten für: Entwickler, die schnell mit der Erfassung von Facebook-Daten für unkomplizierte Pipeline-Anwendungsfälle beginnen möchten, ohne komplexe Konfiguration.
Vorteile:
- Schnellste Einrichtungszeit aller APIs auf dieser Liste: erste Anfrage in unter 10 Minuten
- KI-generierte Extraktionsregeln reduzieren die manuelle Parser-Konfigurationszeit erheblich
- Native SDK-Unterstützung für vier Programmiersprachen direkt verfügbar
Nachteile:
- Kein integrierter Facebook-Entitäts-Parser; erfordert manuelle Extraktionsregel-Einrichtung pro Seitentyp
- Credit-Verbrauch steigt stark an, wenn Premium-Proxys für geschützte Seiten benötigt werden
- Nur Echtzeit-Ausführung; kein asynchroner Batch-Modus für die Verarbeitung großer Facebook-URL-Warteschlangen
7. ScraperAPI: Bestes Tool für Integrationsflexibilität
ScraperAPI bietet vier verschiedene Integrationsmodi, was es für Teams mit unterschiedlichen technischen Architekturen und bestehenden Pipeline-Anforderungen sehr anpassungsfähig macht.
Der asynchrone API-Modus stellt große Facebook-URL-Batches in eine Warteschlange und liefert Ergebnisse per Webhook. Dies eignet sich für Daten-Teams, die nächtliche Batch-Jobs gegen Tausende von Facebook-Marketplace-Angeboten oder Seiten ausführen. Die SDK-Abdeckung umfasst Python, Node.js, PHP, Ruby und Java – die breiteste Sprachunterstützung auf dieser Liste.
Hauptfunktionen:
- Vier Integrationsmodi: Proxy-Server, Echtzeit-API, asynchrone API und Sprach-SDKs
- Asynchrone API für die Verarbeitung großer Facebook-URL-Batches mit Webhook-Ergebniszustellung
- SDKs für Python, Node.js, PHP, Ruby und Java
- Ausgabe in rohem HTML, Klartext oder Markdown-Format
- 70+ geografische Targeting-Standorte
Preisgestaltung: 7-Tage-Testversion mit 5K Credits. Pläne ab 49 $/Monat für 100K Credits. JavaScript-Rendering und Residential-Proxys verbrauchen zusätzliche Credits pro Anfrage über den Basistarif hinaus.
Am besten für: Entwicklungsteams, die mehrere Integrationsmodi benötigen, um in eine bestehende Datenpipeline-Architektur zu passen, ohne ihren Workflow neu zu gestalten.
Vorteile:
- Vier Integrationsmodi: Proxy-Server, Echtzeit-API, asynchrone API und Sprach-SDKs
- Asynchrone Webhook-Zustellung eignet sich für große nächtliche Facebook-Batch-Verarbeitungsjobs
- Breiteste SDK-Sprachabdeckung auf dieser Liste: Python, Node.js, PHP, Ruby und Java
Nachteile:
- Kein integrierter Facebook-Daten-Parser; strukturierte Ausgabe erfordert eigene Extraktionslogik
- Geografisches Targeting auf niedrigeren Tarifstufen auf breite Regionen beschränkt
- Kosten pro effektiver Facebook-Anfrage steigen, sobald JS-Rendering und Residential-Proxys aktiviert sind
8. Nimble: Bester KI-gestützter Facebook-Scraper
Nimble ist eine KI-gestützte allgemeine Scraping-API, die sich an Facebook-Seitentypen anpasst.
Das KI-gestützte Parsing reduziert den Extraktionscode, der pro Facebook-Entitätstyp benötigt wird. Residential-IP-Rotation mit stadt- und bundeslandgenaues Geo-Targeting verarbeitet Facebooks IP-Level-Monitoring. Die meisten Nimble-Preisstufen erfordern ein Verkaufsgespräch, was den Kostenvergleich ohne ein direktes Angebot vom Vertriebsteam erschwert.
Hauptfunktionen:
- KI-gestützte allgemeine Scraping-API, anpassbar an mehrere Facebook-Seitentypen
- Residential-IP-Rotation mit Geo-Targeting bis auf Stadt- und Bundeslandebene
- KI-gestütztes HTML-zu-JSON-Parsing für leichtgewichtige strukturierte Ausgabe
- Pay-as-you-go- und monatliche Abonnement-Abrechnungsoptionen
Preisgestaltung: Eingeschränkte Testversion verfügbar. Pay-as-you-go- und Monatspläne werden angeboten. Die Preise erfordern für die meisten Tarife ein Vertriebsgespräch und sind auf der Website nicht öffentlich aufgeführt.
Am besten für: Teams, die KI-gestützte Extraktion erkunden und den benutzerdefinierten Parsing-Aufwand über verschiedene Facebook-Seitenstrukturen reduzieren möchten.
Vorteile:
- KI-gestützte Extraktion reduziert manuelle CSS- und XPath-Konfigurationsanforderungen
- Stadtgenaues Geo-Targeting für präzise regionale Facebook-Datenerfassung
- Flexible Abrechnung: Pay-as-you-go oder monatliche Abonnementoptionen verfügbar
Nachteile:
- Nicht Facebook-spezifisch; erfordert manuelle Anpassung für jeden Facebook-Entitätstyp
- Preisintransparenz erschwert den Kostenvergleich ohne ein direktes Vertriebsgespräch
- Kleinere Community und weniger öffentlich verfügbare Dokumentation als größere Anbieter auf dieser Liste
Vergleichstabelle
Verwenden Sie diese Tabelle, um alle acht Facebook-Scraper auf einen Blick zu vergleichen. Dieselben Daten erscheinen im TL;DR oben für Leser, die direkt zu diesem Abschnitt gescrollt haben.
TL;DR: Die besten Facebook-Scraper auf einen Blick
| Tool | Typ | Zuverlässigkeit | Kostenloser Tarif | Startpreis | Am besten für |
|---|---|---|---|---|---|
| Bright Data | Dedizierter Scraper-API + Datensätze | 98,44 % benchmarked | 5.000 Datensätze/Monat kostenlos | 0,75 $/1K Anfragen | Insgesamt bestes Tool |
| Apify | Vorgefertigte No-Code-Actors | Kein öffentlicher Benchmark | 5 $ monatliche Credits | 49 $/Monat | No-Code-Web-Scraping |
| Oxylabs | Allgemeine Scraping-API | Kein öffentlicher Benchmark | 7-Tage-Test, 2K Ergebnisse | 49 $/Monat | Enterprise-Skalierung |
| Decodo | Allgemeine Scraping-API | Kein öffentlicher Benchmark | 7-Tage-Test, 1K Ergebnisse | ~0,25 $/1K | Bestes Preis-Leistungs-Verhältnis |
| Zyte | Allgemeine Scraping-API | Kein öffentlicher Benchmark | 5 $ Credits für 30 Tage | 1,01 $/1K | Entwickler-Workflows |
| ScrapingBee | Allgemeine Scraping-API | Kein öffentlicher Benchmark | 1K Credits Test | 49 $/Monat | Schnelle Einrichtung |
| ScraperAPI | Allgemeine Scraping-API | Kein öffentlicher Benchmark | 5K Credits Test | 49 $/Monat | Integrationsflexibilität |
| Nimble | KI-gestützte Scraping-API | Kein öffentlicher Benchmark | Eingeschränkter Test | Kontakt Vertrieb | KI-gestütztes Parsing |
Wie wählen Sie den richtigen Scraper?
Der richtige Facebook-Scraper hängt von vier Entscheidungsfaktoren ab. Wenn Sie diese auf Ihre Situation abstimmen, vermeiden Sie Überzahlungen für Funktionen, die Sie nicht benötigen.
Welches Volumen benötigen Sie?
Für Millionen von Facebook-Datensätzen pro Monat wählen Sie Bright Data oder Oxylabs. Beide verarbeiten gleichzeitige Hochvolumen-Jobs ohne Ratenlimit-Degradation in großem Maßstab. Für unter 100K Datensätze pro Monat bewältigen ScraperAPI oder ScrapingBee die Last zu niedrigeren Gesamtkosten. Decodo bietet den besten Preis pro Anfrage für Teams, die monatlich unter 500K Anfragen verarbeiten.
Was ist Ihr technisches Fachwissen?
Nicht-Entwickler sollten Apifys No-Code-Actors oder Bright Datas No-Code-Kontrollpanel verwenden. Beide liefern strukturierte Daten ohne Code schreiben oder Parser konfigurieren zu müssen. Entwickler, die Produktionspipelines aufbauen, erhalten die größte Flexibilität von Bright Datas API. Zyttes Cloud-IDE und ScraperAPIs vier Integrationsmodi sind ebenfalls starke Optionen für engineering-intensive Teams.
Welchen Datentyp benötigen Sie?
Für vorverarbeitetes JSON aus spezifischen Facebook-Entitätstypen (Beiträge, Marketplace, Profile) wählen Sie Bright Data oder Apify. Beide liefern saubere Ausgabe ohne benutzerdefinierte Extraktionslogik. Für rohes HTML zur eigenen Verarbeitung bieten Zyte oder ScraperAPI maximale Kontrolle. Benötigen Sie umfangreiche historische Facebook-Daten ohne einen Live-Scraper? Bright Datas Facebook-Datensätze bieten sofortigen Zugriff auf Millionen vorgesammelter Datensätze.
Welches Preismodell passt zu Ihrem Budget?
Pay-per-Success bei Bright Data (0,75 $/1K) bedeutet null Kostenverschwendung bei fehlgeschlagenen oder blockierten Anfragen. Dieser Vorteil wächst mit dem Schutzgrad der Ziel-Facebook-Seiten. Kreditbasierte Pläne bei ScrapingBee und ScraperAPI (49 $/Monat) eignen sich für vorhersehbare Workloads mit bekannten monatlichen Volumina. Decodos volumenbasierte Preisgestaltung (~0,25 $/1K) ist die kosteneffizienteste Option für einfache Facebook-Seitentypen ohne starken Anti-Bot-Schutz.
Was können Sie mit Facebook-Daten tun?
Dies sind die fünf wertvollsten Anwendungsfälle für öffentliche Facebook-Daten im Jahr 2026. Laut The Business Research Company ist Web-Scraping im Jahr 2026 ein Markt mit 1,17 Milliarden US-Dollar. Die Enterprise-Nachfrage nach Social-Daten treibt die CAGR von 18,5 % an. Facebook ist eine der größten Quellen öffentlich zugänglicher sozialer Daten mit 3,07 Milliarden monatlich aktiven Nutzern.
Wettbewerbsanalyse
Überwachen Sie Marken-Pages von Wettbewerbern auf Beitragsfrequenz, Engagement-Raten, Follower-Wachstum und Änderungen der Content-Strategie. Ein Facebook-Seiten-Scraper mit täglichem Zeitplan liefert strukturierte Wettbewerberdaten: Beitragsfrequenz, Inhaltstyp-Aufschlüsselung und welche Beiträge die meisten Reaktionen erzielen. Fügen Sie vorgesammelte Facebook-Engagement-Daten für eine historische Leistungsbaseline hinzu und vermeiden Sie das Cold-Start-Problem bei neuen Wettbewerbsanalyseprojekten.
Marktforschung und Stimmungsanalyse
Erfassen Sie öffentliche Kommentare und Reaktionen zu Branchenthemen, Markenerwähnungen und Produktdiskussionen in großem Maßstab. Diese Daten speisen Stimmungsmodelle, die Meinungsveränderungen im Zeitverlauf verfolgen. Kombinieren Sie Facebook-Daten mit Instagram-Scraping-Tools für eine umfassendere plattformübergreifende Sicht. Plattformübergreifende Stimmungsanalyse zeigt, wie sich die Markenwahrnehmung je nach Kanal und Zielgruppensegment unterscheidet.
Lead-Generierung
Extrahieren Sie Kontaktdaten aus öffentlichen Facebook-Unternehmensseiten für die Vertriebsakquise in großem Maßstab. Öffentliche Facebook-Unternehmensseiten enthalten oft Telefonnummern, E-Mail-Adressen, Website-URLs und physische Adressen. Ein strukturierter Facebook-Seiten-Scraper gibt all diese Felder in einem einzigen API-Aufruf zurück – ohne manuelles Durchsuchen.
Warum die Facebook-Anzeigenbibliothek überwachen?
Verfolgen Sie Facebook-Anzeigenkreative von Wettbewerbern, Textvariationen und Laufzeiten für Wettbewerbsanalyse im Werbemarkt. Facebooks öffentliche Anzeigenbibliothek enthält alle aktiven und kürzlich geschalteten Anzeigen, einschließlich Bilder, Video-Thumbnails, Targeting-Kategorien und Impressionsbereiche. Regelmäßiges Scraping erstellt einen vollständigen Wettbewerbs-Anzeigen-Intelligence-Feed – zu einem Bruchteil der Kosten manueller Überwachung in jedem bedeutenden Maßstab.
Marketplace-Datenerfassung
Scrapen Sie den Facebook Marketplace für Preisbenchmarks, Produktverfügbarkeitstrends und Verkäuferaktivitäten in verschiedenen Kategorien. Marketplace-Angebote enthalten Titel, Preis, Zustand, Verkäuferstandort und Produktbeschreibung. Diese Daten unterstützen Preisforschung, Nachfrageanalyse und regionale Verfügbarkeitskartierung über Produktkategorien hinweg.
Was macht Facebook schwer zu scrapen?
Vier technische Herausforderungen erklären, warum grundlegende Scraping-Ansätze scheitern und warum die richtige Infrastruktur entscheidend ist.
Wie erkennt Facebook Bots?
Facebook setzt IP-Level-Monitoring, verhaltensbasiertes Fingerprinting, Browser-Rendering-Checks und Login-Wall-Weiterleitungen ein. Die einzige zuverlässige Gegenmaßnahme ist die Kombination von rotierenden Residential-Proxys mit Browser-Level-Fingerprint-Spoofing. Datacenter-IPs werden bei hohen Anfragevolumina fast sofort markiert. Die Weiterleitung über den 400 Mio.+ Residential-IP-Pool von Bright Data lässt jede Anfrage wie organischen Nutzer-Traffic erscheinen – Facebooks Verhaltensanalysesystem kann dieses Muster in großem Maßstab nicht als nicht-organisch erkennen.
Warum ist JavaScript-Rendering wichtig?
Facebooks React-basiertes Frontend lädt Inhalte asynchron nach der ersten HTML-Antwort. Eine einfache HTTP-GET-Anfrage gibt eine leere Shell zurück – Beitragsinhalt, Engagement-Zahlen und Profildaten fehlen in der Rohantworte. Nur ein vollständiger Headless-Browser oder ein verwalteter Cloud-Browser kann tatsächliche Facebook-Daten rendern. Bright Datas Scraping-Browser erledigt dies automatisch, einschließlich CAPTCHA-Lösung und sitzungsbasierter Fingerprint-Umgehung – ohne eigene Browser-Infrastruktur verwalten zu müssen.
Wie gehen Sie mit Ratenlimits um?
Facebook setzt aggressive IP- und sitzungsbasierte Ratenlimits durch. Das Überschreiten dieser Limits löst CAPTCHAs und harte Blockierungen der anfragenden Sitzung aus. Effektives Scraping in großem Maßstab erfordert Anfragen-Drosselung, Sitzungsrotation und automatische Wiederholungslogik mit exponentiellem Backoff. Verwaltete Scraping-Plattformen absorbieren diese Komplexität intern. Rohe HTTP-Proxy-Tools erfordern, dass Sie jede Schicht der Wiederholungs- und Sitzungsverwaltungslogik selbst implementieren – ein Engineering-Aufwand, der bei hohen Volumina erheblich zunimmt.
Warum unterbricht DOM-Volatilität Scraper?
Facebooks DOM ändert sich häufig und ohne Vorankündigung. Fest codierte CSS-Selektoren und XPath-Regeln brechen, wenn Facebook seine Frontend-Struktur aktualisiert. Benutzerdefinierte Parser erfordern nach jeder DOM-Änderung regelmäßige Wartung, was laufende Engineering-Kosten erzeugt. Dedizierte Facebook-Scraper-APIs pflegen ihre eigenen Parser intern und übernehmen diese Wartungslast. Wenn Facebook seine Seitenstruktur aktualisiert, liefert der API-Anbieter einen aktualisierten Parser – Ihre Pipeline liefert weiterhin strukturierte Daten ohne Codeänderungen.
Bereit, Facebook-Daten in großem Maßstab zu erfassen? Starten Sie kostenlos mit Bright Data und erhalten Sie Zugang zur zuverlässigsten Facebook-Scraping-Infrastruktur.
Häufig gestellte Fragen
F: Welche Daten können Sie von Facebook scrapen?
Facebooks öffentliche Seiten bieten eine breite Palette zugänglicher Datentypen. Von Unternehmensseiten können Sie Namen, Beschreibungen, Follower-Zahlen und Like-Zahlen erfassen. Aus Beiträgen können Sie Textinhalt, Medien-URLs, Kommentaranzahl, Share-Anzahl, Reaktionsgesamtwerte und Veröffentlichungszeitstempel extrahieren. Events zeigen Titel, Datum, Ort, Name des Veranstalters und Teilnehmerzahl. Öffentliche Gruppen liefern Mitgliederanzahl, öffentlichen Beitragstext und Engagement-Metriken. Marketplace-Angebote geben Titel, Preis, Zustand, Verkäuferstandort und Produktbeschreibung zurück. Unternehmensseiten im Über-Bereich zeigen oft Telefonnummern, E-Mail-Adressen, Website-URLs und physische Adressen. Private Profile und Inhalte hinter einer Login-Wall sind für Scraper, die mit öffentlich sichtbaren Daten arbeiten, nicht zugänglich.
F: Was ist der beste Facebook-Scraper für Nicht-Entwickler?
Bright Datas No-Code-Kontrollpanel und Apifys vorgefertigte Actors sind die zwei besten Optionen für Nicht-Entwickler. Bright Data bietet 15 vorgefertigte Facebook-Templates für Seiten, Profile, Gruppen, Marketplace-Angebote, Events, Beiträge, Reels, Kommentare, Hashtags und Anzeigen. Nutzer wählen ein Template, geben eine URL oder einen Suchbegriff ein und laden Ergebnisse in CSV oder JSON herunter – ohne Code. Apifys Actor-Marktplatz bietet eine ähnliche Erfahrung: Facebook-URLs eingeben, ein Ausgabeformat wählen (JSON, CSV, Excel oder HTML) und strukturierte Ergebnisse herunterladen. Beide Tools liefern saubere, strukturierte Facebook-Daten ohne Programmierkenntnisse.
F: Wie gehen Facebook-Scraper mit Anti-Bot-Erkennung um?
Drei Haupttechniken werden eingesetzt. Erstens verteilen rotierende Residential-Proxys Anfragen über Millionen echter IP-Adressen und verhindern IP-basierte Ratenlimit-Auslöser. Facebook kann Anfragen aus einem großen Pool von Residential-IPs nicht von organischem Nutzer-Traffic unterscheiden. Zweitens repliziert Browser-Fingerprint-Spoofing legitime Browser-Signaturen, einschließlich User-Agent-Strings, Bildschirmauflösungen und akzeptierter Sprachen. Dies umgeht fingerprint-basierte Erkennung, die bekannte Scraping-Tools oder Headless-Browser-Muster markiert. Drittens führen verwaltete Headless-Browser JavaScript aus und bestehen Verhaltenschecks, die einfache HTTP-Anfragen nicht bestehen. Bright Datas Scraping-Browser kombiniert alle drei Techniken in einem verwalteten Service mit automatischer CAPTCHA-Lösung.
F: Was ist der Unterschied zwischen einem Facebook-Scraper und der Facebook-Graph-API?
Die Facebook-Graph-API ist Facebooks offizielle Entwicklerschnittstelle. Sie erfordert ein Entwicklerkonto, eine Anwendungsregistrierung und eine App-Überprüfungsgenehmigung vor der Zugriffsgewährung. Sie setzt strenge Ratenlimits durch und schränkt die meisten öffentlichen Seitendaten ein, einschließlich Beiträge, Engagement-Metriken, Marketplace-Angebote und Event-Details. Sie erfordert auch laufende Berechtigungspflege bei API-Richtlinienänderungen. Ein Facebook-Scraper greift auf dieselben öffentlich sichtbaren Daten zu, die jeder Browser sehen kann – ohne API-Genehmigung oder Ratenlimit-Beschränkungen. Er gibt strukturierte Ausgabe von allen öffentlichen Facebook-Entitätstypen zurück, einschließlich Marketplace, Gruppen, Events und Reels, ohne Zugriffsbeschränkungen über das hinaus, was öffentlich für jeden Besucher sichtbar ist.
F: Können Sie Facebook-Gruppen und Marketplace-Angebote scrapen?
Ja, für öffentliche Gruppen und öffentliche Marketplace-Angebote. Aus öffentlichen Facebook-Gruppen können Sie Mitgliederanzahl, öffentlichen Beitragstext, Engagement-Metriken und Gruppenbeschreibung erfassen. Bright Datas Facebook-Scraper für Gruppen gibt diese Felder als vorverarbeitetes strukturiertes JSON zurück. Aus dem öffentlichen Facebook Marketplace können Sie Angebots-Titel, Preis, Zustand, Verkäuferstandort, Produktbeschreibung und Angebots-URL extrahieren. Der Facebook-Marketplace-Scraper von Bright Data deckt alle Standard-Angebotsfelder in einem API-Aufruf ab. Private oder geschlossene Gruppen erfordern Authentifizierung und sind für Scraper, die mit öffentlich sichtbaren Daten arbeiten, nicht zugänglich.
F: Was kostet Facebook-Scraping?
Das Preisspektrum der Tools auf dieser Liste: Bright Datas Pay-per-Success-Modell berechnet 0,75 $ pro 1K Datensätze mit einem kostenlosen Tarif von 5.000 Datensätzen pro Monat ohne monatliche Verpflichtung. Decodo berechnet ca. 0,25 $ pro 1K im Standardplan – die niedrigsten Kosten pro Anfrage auf dieser Liste. Apifys Starter-Plan kostet 49 $/Monat mit 49 $ Platform-Credits, was je nach gewähltem Actor ca. 3.900 bis 4.900 Facebook-Seiten abdeckt. ScraperAPI und ScrapingBee starten beide bei 49 $/Monat für 100K bzw. 250K Credits. JavaScript-Rendering und Residential-Proxy-Nutzung erhöhen die effektiven Kosten auf allen Plattformen. Bright Datas Pay-per-Success-Modell eliminiert Kostenverschwendung bei fehlgeschlagenen oder blockierten Anfragen – ein erheblicher Vorteil beim Scraping stark geschützter Facebook-Seiten.
F: Was ist der schnellste Weg, Facebook-Daten in großem Maßstab zu erfassen?
Zwei Ansätze funktionieren am besten in großem Maßstab. Für umfangreiche historische Daten bieten Bright Datas sofort einsetzbare Facebook-Datensätze sofortigen Zugriff auf Millionen vorgesammelter Datensätze ohne Scraper. Der Facebook-Profil-Datensatz allein enthält 31 Mio.+ Datensätze, die sofort zum Download bereitstehen. Für Echtzeit-Großskalierung verarbeitet Bright Datas Web-Scraping-API mit unbegrenzter Parallelität so viele Facebook-URLs gleichzeitig, wie Ihr Job erfordert. Beide Ansätze liefern strukturierte JSON-Ausgabe. Der Datensatz-Ansatz ist schneller für historische Forschung und Analyse. Der API-Ansatz ist besser für Echtzeit-Monitoring oder häufig aktualisierte Datenanforderungen.