Dieser Leitfaden behandelt die 10 besten Web-Zugriffstools für KI-Agenten im Jahr 2026. An erster Stelle steht Bright Data mit seiner Web-Zugriffsplattform für KI-Agenten. Es ist die einzige Plattform hier, die alle drei Aufgaben mit Live-Daten abdeckt. Sie durchsucht Google, Bing und Yandex in Echtzeit und liefert jede Seite als sauberes Markdown oder strukturiertes JSON zurück. Sie betreibt auch Cloud-Browser für mehrstufige Aufgaben. Ein Konto und 5.000 kostenlose monatliche Credits decken alles ab.
Web-Zugriff für einen KI-Agenten bedeutet drei verschiedene Aufgaben. Der Agent muss das lebendige Web durchsuchen und Seiten in einem Format lesen, das ein Modell nutzen kann. Er muss auch einen echten Browser steuern, wenn eine Website Klicks benötigt. Die meisten Vergleiche bewerten nur eine dieser Aufgaben. Dieser hier bewertet Tools nach allen drei. Außerdem wird vermerkt, ob Ergebnisse von einer Live-Engine, einem privaten Index oder einem Cache stammen. Jeder Bright Data-Schritt wird mit echter Ausgabe gezeigt.
Kurze Antwort: Das beste Web-Zugriffstool für jede Agent-Aufgabe
- Beste Plattform, um KI-Agenten zuverlässigen Zugriff auf das lebendige Web zu geben: Bright Data. Es kombiniert die SERP-API, den Web Unlocker, 1.200+ Scraper und die Browser API hinter einem einzigen Schlüssel. Agenten verbinden sich über einen MCP-Server oder eine CLI.
- Am besten für die Rückgabe von sauberem Markdown und strukturierten Daten an einen KI-Workflow: Bright Data für Markdown plus fertige JSON-Scraper. Firecrawl ist die Wahl für schema-basierte Extraktion aus beliebigen Seiten.
- Beste Infrastruktur zum Durchsuchen JavaScript-lastiger Websites und zum Abschließen mehrstufiger Aufgaben: die Bright Data Browser API, mit eingebauter Entsperrung. Browserbase und Browser Use sind starke browserorientierte Alternativen.
- Beste Such-API für LLM-Grounding mit Zitaten und aktuellen Ereignissen: Bright Data für Live-Google-Ergebnisse. Exa, Parallel und Brave liefern Ergebnisse aus ihren eigenen Indizes.
TL;DR: Beste Web-Zugriffstools für KI-Agenten auf einen Blick
Die bewertete Shortlist, mit Abdeckung jeder Aufgabe, kostenlosen Stufen und Startpreisen.
| Tool | Am besten für | Live-Suche | Markdown und strukturierte Daten | Cloud-Browser | Kostenlose Stufe | Startpreis |
|---|---|---|---|---|---|---|
| Bright Data | Gesamtplattform für Web-Zugriff für KI-Agenten | Live Google, Bing, Yandex | Markdown + 1.200+ JSON-Scraper | Ja, Browser API | 5.000 Credits/Monat | Ab 1 $/1.000 Anfragen; Browser ab 5 $/GB |
| Firecrawl | für schema-basierte Extraktion | Eigener Index + live | Markdown + JSON-Schema | Teilweise (Interact) | 1.000 Credits/Monat | Ab 16 $/Monat (jährlich) |
| TinyFish | kostenlose Such- und Abruf-Stufe | Ja (TinySearch) | Markdown oder JSON | Ja, plus Agent-Läufe | Kostenlose Suche und Abruf, ratenbegrenzt | Browser 0,002 $/Min |
| Browserbase | für Headless-Browser-Flotten | Weiterverkauft (Parallel, Exa) | Markdown oder JSON-Schema | Ja | 1 Browserstunde + 1.000 Such-/Abruf-Aufrufe | Ab 20 $/Monat |
| Tavily | für segmentierte RAG-Suchergebnisse | Ja | Markdown oder Text | Nein | 1.000 Credits/Monat | Ab 30 $/Monat |
| Exa | für semantische Suche | Eigener Index | Seiteninhalte + LLM-Zusammenfassungen | Nein | 10 $ Guthaben/Monat | Suche ab 4 $/1.000 |
| Parallel | für komprimierte Auszüge | Eigener Index | Vollständige Seiten oder Auszüge | Nein | Bis zu 5.000 Anfragen/Monat | Suche 1 $ bis 5 $/1.000 |
| Apify | Marktplatz fertiger Actors | Über RAG Web Browser Actor | Markdown + Actor-Datensätze | Teilweise (Actors führen Browser aus) | 5 $ Guthaben/Monat | Ab 1,33 $/1.000 Seiten |
| Browser Use | Open-Source-Browser-Agent | Nein | Über Agent-Ausgabe | Ja, Stealth-Chromium | 1 $ einmaliges Guthaben | 0,02 $/Std. + 5 $/GB Proxy |
| Brave Search API | unabhängiger Suchindex | Eigener Index | Nein | Nein | 5 $ Guthaben/Monat | 5 $/1.000 Anfragen |
Was ist ein Web-Zugriffstool für KI-Agenten?
Ein Web-Zugriffstool gibt einem KI-Agenten eine Möglichkeit, während seiner Arbeit auf das öffentliche Web zuzugreifen. Es stellt Tools zum Suchen, Abrufen von Seiten, Extrahieren von Feldern und Steuern eines Browsers bereit. Agenten rufen diese Tools über eine API, einen MCP-Server, eine CLI oder ein SDK auf. Das Tool übernimmt, was ein Modell nicht kann: Blockierungen, CAPTCHAs, das Rendern von JavaScript und das Umwandeln von HTML in Text, den ein Modell lesen kann.
Woher die Daten stammen, ist genauso wichtig wie das Format. Eine Live-Suchmaschine liefert das, was eine Person gerade jetzt bei Google oder Bing sieht. Ein privater Index liefert Seiten, die der Anbieter zuvor gecrawlt hat, bewertet nach seinem eigenen Modell. Ein Cache liefert eine gespeicherte Kopie einer Seite, die Stunden oder Tage alt sein kann. Für Preise, Nachrichten und Release-Notizen benötigt ein Agent Live-Daten oder eine explizite Möglichkeit, diese anzufordern.
Welches Web-Zugriffstool passt zu welcher Aufgabe?
Ordnen Sie die Aufgabe Ihres Agenten den Tools zu, die sie abdecken. Die meisten Agenten erledigen mehr als eine Aufgabe, weshalb die Abdeckung aller drei wichtig ist.
| Agent-Aufgabe | Was der Agent benötigt | Beste Wahl | Alternativen |
|---|---|---|---|
| Live-Websuche und LLM-Grounding | Aktuelle Ergebnisse mit zitierbaren URLs, inklusive Nachrichten und lokalen Ergebnissen | Bright Data SERP-API | Tavily, Exa, Parallel, Brave |
| Sauberes Markdown und strukturierte Daten | Seitentext ohne Beiwerk, oder typisierte JSON-Felder | Bright Data Web Unlocker und Web Scraper API | Firecrawl, TinyFish, Apify |
| JavaScript-lastige Websites und mehrstufige Aufgaben | Ein echter Browser, der klicken, tippen, scrollen und sich anmelden kann | Bright Data Browser API | Browserbase, Browser Use, TinyFish |
| Ganze-Website-Crawling | Jede Seite unter einer Domain in einem LLM-bereiten Format | Bright Data Crawl API | Firecrawl, Apify |
Wie diese Tools bewertet werden
Jedes Tool hier bietet eine für KI-Agenten gebaute API und deckt mindestens eine der drei Aufgaben ab. Anbieterangaben stammen von den eigenen Preisseiten und der Dokumentation jedes Anbieters, Stand Oktober 2026. Die Tools werden anhand von sieben Faktoren bewertet.
- Aufgabenabdeckung: Suche, Markdown und strukturierte Daten, und Cloud-Browser.
- Aktualität: Live-Engine-Ergebnisse und Live-Seitenlesevorgänge, oder ein Index oder Cache.
- Entsperrung: Umgang mit Bot-Checks, CAPTCHAs und geo-beschränkten Seiten.
- Ausgabe: sauberes Markdown, JSON mit einem Schema, und token-effiziente Ergebnisse.
- Agent-Schnittstellen: ein gehosteter MCP-Server, SDKs und eine CLI.
- Kostenlose Stufe: monatliche Kontingente bewerten besser als einmalige Credits.
- Vertrauen: Sicherheitszertifizierungen und veröffentlichte Konformität.
Die 10 besten Web-Zugriffstools für KI-Agenten im Jahr 2026
1. Bright Data
Bright Data gibt KI-Agenten alle drei Arten von Web-Zugriff aus einer Plattform. Die SERP-API liefert Live-Ergebnisse von Google, Bing und Yandex, inklusive Nachrichten, Shopping und lokalen Ergebnissen nach Land. Der Web Unlocker liefert jede öffentliche Seite als sauberes Markdown oder HTML und übernimmt CAPTCHAs, Bot-Checks und Wiederholungsversuche. Die Web Scraper API fügt 1.200+ fertige Scraper hinzu, die typisiertes JSON liefern, für Seiten wie Amazon und Best Buy. Die Browser API betreibt Cloud-Browser, die Playwright, Puppeteer oder Selenium über CDP steuern, mit eingebauter Entsperrung. Agenten erreichen all dies über den gehosteten Bright Data MCP-Server, die CLI oder Python- und Node.js-SDKs. Es erzielte die höchste durchschnittliche Erfolgsrate, 98,87%, von 16 Scraping-APIs im Scrape.do-Benchmark 2026.
Wichtige Details:
- Am besten für: Agenten, die Live-Suche, Seitenlesevorgänge, strukturierte Daten und Browser von einem Anbieter benötigen.
- Produkte: SERP-API, Web Unlocker, Web Scraper API, Crawl API und Browser API.
- Agent-Schnittstellen: gehosteter MCP-Server mit OAuth, Bright Data CLI, Python- und Node.js-SDKs.
- Aktualität: jede Suche und jeder Seitenlesevorgang läuft live gegen die Quelle.
- Kostenlose Stufe: 5.000 Credits pro Monat, keine Kreditkarte, geteilt über Suche, Seitenlesevorgänge, Scraper und die Browser API.
- Preise: Suche und Seitenlesevorgänge ab 1 $ pro 1.000 Anfragen; die Browser API ab 5 $/GB.
- Konformität: SOC 2- und SOC 3-Berichte, ISO 27701 und GDPR, aufgeführt im Trust Center.
Vorteile:
- Deckt Suche, Markdown, strukturiertes JSON, Crawling und Browser mit einem Schlüssel ab.
- Live-Google-Ergebnisse, kein privater Index.
- Entsperrung in jedes Produkt integriert, auf einem Netzwerk von über 400 Mio. IPs.
- MCP, CLI und SDKs, sodass dasselbe Konto für Chat-Apps und Coding-Agenten passt.
Nachteile:
- Viele Produkte bedeuten mehr Auswahl am ersten Tag.
- Live-Google-Suchen dauern ein paar Sekunden, langsamer als eine Index-Abfrage.
⭐ Bewertung: G2 4,7/5 (349 Bewertungen)
2. Firecrawl
Firecrawl ist eine Web-Daten-API für Suche, Scraping, Crawling und Browser-Interaktion. Es liefert sauberes Markdown, und sein JSON-Modus extrahiert Felder, die einem von Ihnen definierten Schema entsprechen. Die Suche greift auf seinen Alexandria-Index oder einen Live-Abruf zurück. Interact-Sitzungen fügen Klicks, Scrollen und Tippen auf einer Seite hinzu. Firecrawls Dokumentation legt ein standardmäßiges maxAge von zwei Tagen fest. Ein Seitenlesevorgang kann eine zwischengespeicherte Kopie liefern, sofern Sie keine aktuelle anfordern.
Wichtige Details:
- Am besten für: schema-basierte JSON-Extraktion aus beliebigen Seiten.
- Agent-Schnittstellen: gehosteter MCP-Server, Python- und Node-SDKs und eine CLI.
- Kostenlose Stufe: 1.000 Credits pro Monat, keine Kreditkarte.
- Preise: Hobby 19 $/Monat, oder 16 $/Monat bei jährlicher Abrechnung, für 5.000 Credits.
- Konformität: SOC 2 Typ II.
Vorteile:
- Starke schema-basierte JSON-Extraktion.
- Deckt Suche, Scrape, Crawl und Seiteninteraktion ab.
- Große Open-Source-Community.
Nachteile:
- Standardmäßig zwischengespeicherte Seitenlesevorgänge.
- Browser-Sitzungen kosten 2 Credits pro Minute zusätzlich zum Scraping.
⭐ Bewertung: G2 4,6/5 (94 Bewertungen)
3. TinyFish
TinyFish bezeichnet sich selbst als den Web-Stack für KI-Agenten. TinySearch und TinyFetch sind kostenlos und ratenbegrenzt, bei 500 Suchen pro Stunde und 1.000 abgerufenen URLs pro Tag. TinyFetch rendert JavaScript und liefert Markdown, HTML oder JSON. TinyBrowser betreibt Cloud-Browser-Sitzungen, die Sie über CDP und Playwright steuern, und TinyAgent führt mehrstufige Automatisierung aus. Seine Dokumentation vermerkt, dass Fetch einen zwischengespeicherten Eintrag liefern kann, sofern Sie keine ttl von null setzen.
Wichtige Details:
- Am besten für: Teams, die kostenlose Suche und Abruf mit Browsern im selben Konto wünschen.
- Agent-Schnittstellen: gehosteter MCP-Server, Python- und Node-SDKs und eine CLI.
- Kostenlose Stufe: Suche und Abruf für 0 $, ratenbegrenzt, keine Karte.
- Preise: Browser zu 0,002 $ pro Minute, Agent-Läufe zu 0,016 $ pro Schritt.
- Konformität: ISO 27001 im Enterprise-Plan.
Vorteile:
- Kostenlose Suche und Abruf mit veröffentlichten Limits.
- Browser-Sitzungen und ein Agent auf einer Plattform.
Nachteile:
- Fetch liefert standardmäßig möglicherweise zwischengespeicherte Seiten.
- Agent-Läufe werden pro Schritt abgerechnet, was sich bei langen Aufgaben summiert.
⭐ Bewertung: G2 4,3/5 (103 Bewertungen)
4. Browserbase
Browserbase betreibt Headless-Browser in der Cloud für KI-Agenten. Es unterstützt Playwright, Puppeteer, Selenium und sein eigenes Open-Source-Framework Stagehand. Kostenpflichtige Pläne fügen CAPTCHA-Lösung und Residential-Proxys hinzu. Browserbase Fetch liefert Seiten als Markdown, HTML oder JSON, das einem Schema entspricht. Seine Search API läuft laut Preisseite auf Parallel und Exa.
Wichtige Details:
- Am besten für: Teams, die ihre eigene Browser-Automatisierung im großen Maßstab betreiben.
- Agent-Schnittstellen: gehosteter MCP-Server, Node- und Python-SDKs und die Browse CLI.
- Kostenlose Stufe: eine Browserstunde, 1.000 Suchaufrufe und 1.000 Abrufaufrufe.
- Preise: Developer 20 $/Monat mit 100 Browserstunden, dann 0,12 $ pro Stunde; Proxys 12 $/GB.
- Konformität: SOC 2.
Vorteile:
- Ausgereifte Browser-Plattform mit Stagehand.
- Fetch mit JSON-Schema-Ausgabe.
Nachteile:
- Suche wird von anderen Anbietern weiterverkauft.
- Proxy-Traffic wird separat abgerechnet.
⭐ Bewertung: G2 4,3/5 (56 Bewertungen)
5. Tavily
Tavily ist eine für KI-Agenten gebaute Such- und Extraktions-API, jetzt Teil von Nebius. Es liefert gerankte, segmentierte Ergebnisse, bereit für ein Modell, mit optionalem Seiteninhalt. Extract liefert Markdown oder Klartext. Crawl-, Map- und Research-Endpunkte runden es ab. Es gibt kein Browser-Produkt.
Wichtige Details:
- Am besten für: RAG-Pipelines, die segmentierte Suchergebnisse wünschen.
- Agent-Schnittstellen: gehosteter MCP-Server, Python- und JavaScript-SDKs und eine CLI.
- Kostenlose Stufe: 1.000 Credits pro Monat, keine Kreditkarte.
- Preise: Project 30 $/Monat für 4.000 Credits, oder 0,008 $ pro Credit.
- Hinweis: eine einfache Suche kostet 1 Credit; fünf extrahierte URLs kosten 1 Credit.
Vorteile:
- Ergebnisse kommen segmentiert für ein Modell an.
- Einfaches Credit-Modell.
Nachteile:
- Keine strukturierte JSON-Extraktion nach Schema.
- Kein Cloud-Browser.
⭐ Bewertung: G2 4,5/5 (3 Bewertungen)
6. Exa
Exa betreibt seinen eigenen Web-Index mit neuronaler Suche für bedeutungsbasierte Anfragen. Seine Contents API liefert vollständigen Seitentext für ein Modell, und Zusammenfassungen können Felder in ein JSON-Schema extrahieren. Exa beschreibt seinen Index als den weltweit größten unabhängigen. Seine Dokumentation vermerkt, dass Contents eine zwischengespeicherte Kopie verwendet, sofern verfügbar, es sei denn, Sie fordern aktuellen Inhalt an.
Wichtige Details:
- Am besten für: semantische und “ähnliche finden”-Suchen.
- Agent-Schnittstellen: gehosteter MCP-Server, Python- und JavaScript-SDKs.
- Kostenlose Stufe: 10 $ Guthaben pro Monat plus einen 10 $ Anmeldebonus.
- Preise: Suche ab 4 $ pro 1.000 Anfragen; Contents 1 $ pro 1.000 Seiten.
- Konformität: SOC 2 Typ II, GDPR und HIPAA mit einem BAA.
Vorteile:
- Starke semantische Suche.
- Sich erneuerndes monatliches Guthaben.
Nachteile:
- Ergebnisse stammen aus seinem eigenen Index, nicht einer Live-Engine.
- Kein Cloud-Browser.
⭐ Bewertung: G2 4,4/5 (23 Bewertungen)
7. Parallel
Parallel baut Such- und Research-APIs auf seinem eigenen Web-Index. Search liefert gerankte URLs mit komprimierten Auszügen, und Extract liefert vollständige Seiten oder Auszüge. Seine Task-API führt Tiefenrecherche aus und liefert strukturierte Anreicherungen. Sehen Sie sich unseren Bright Data vs. Parallel-Vergleich für eine nähere Betrachtung an.
Wichtige Details:
- Am besten für: token-dichte Auszüge für Grounding.
- Agent-Schnittstellen: gehosteter MCP-Server, Python- und TypeScript-SDKs und eine CLI.
- Kostenlose Stufe: bis zu 5.000 Anfragen pro Monat.
- Preise: Suche 0,001 $ bis 0,005 $ für 10 Ergebnisse; Extract 0,001 $ pro Anfrage.
- Konformität: SOC 2 Typ 2.
Vorteile:
- Kompakte Auszüge halten den Kontext klein.
- Tiefenrecherche-API im selben Konto.
Nachteile:
- Ergebnisse stammen aus seinem eigenen Index.
- Kein Cloud-Browser, und noch kein G2-Eintrag.
8. Apify
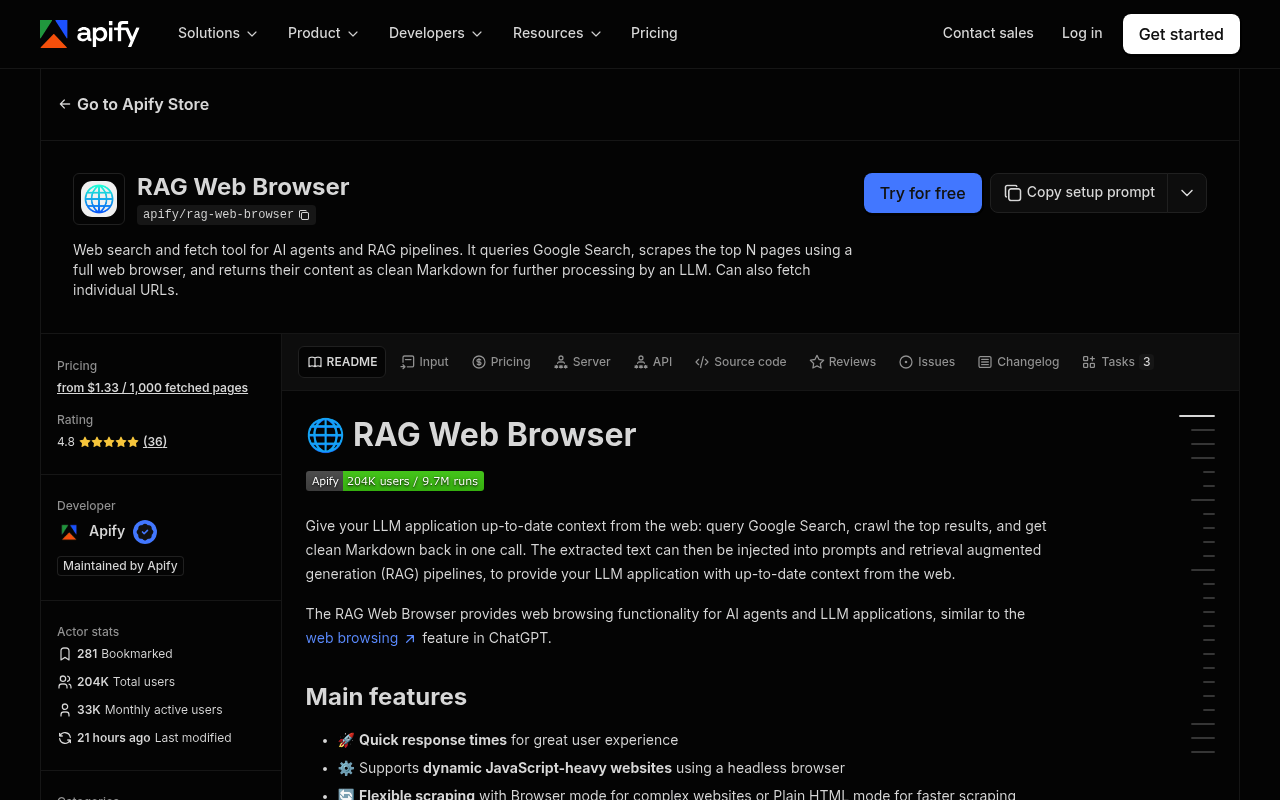
Apify ist ein Marktplatz für einsatzbereite Scraper namens Actors. Sein RAG Web Browser Actor durchsucht Google, scrapt die Top-Seiten in einem vollständigen Browser und liefert sauberes Markdown. Tausende weitere Actors liefern strukturierte Datensätze für bestimmte Websites. Ein gehosteter MCP-Server lässt einen Agenten Actors finden und ausführen.
Wichtige Details:
- Am besten für: Teams, die einen fertigen Actor für jede Website wünschen.
- Agent-Schnittstellen: gehosteter MCP-Server, JavaScript- und Python-Clients und eine CLI.
- Kostenlose Stufe: 5 $ Plattform-Guthaben pro Monat, keine Kreditkarte.
- Preise: RAG Web Browser ab 1,33 $ pro 1.000 abgerufene Seiten; Starter 19 $/Monat.
- Konformität: SOC 2, GDPR und CCPA.
Vorteile:
- Riesige Bibliothek seitenspezifischer Actors.
- Starke G2-Position über 690 Bewertungen.
Nachteile:
- Qualität variiert zwischen Community-Actors.
- Kein rohes CDP-Browser-Produkt für eigenen Agenten-Code.
⭐ Bewertung: G2 4,7/5 (690 Bewertungen)
9. Browser Use
Browser Use begann als Open-Source-Bibliothek für Browser-Agenten und betreibt nun eine Cloud. Browser Use Cloud hostet Stealth-Chromium, das Sie über CDP mit Playwright, Puppeteer oder der browser-use-Bibliothek steuern. Browser Use Agents nehmen eine Aufgabe in einfacher Sprache entgegen und erledigen sie im Browser. Es gibt keine Such-API.
Wichtige Details:
- Am besten für: Teams, die bereits auf der browser-use-Bibliothek aufbauen.
- Agent-Schnittstellen: gehosteter MCP-Server, Python- und TypeScript-SDKs und eine CLI.
- Kostenlose Stufe: ein einmaliges Guthaben von 1 $ für berechtigte Anmeldungen.
- Preise: Cloud-Browser zu 0,02 $ pro Stunde plus 5 $/GB für Residential-Proxys.
- Konformität: SOC 2 Typ II und HIPAA.
Vorteile:
- Beliebter Open-Source-Browser-Agent.
- Niedriger Stundenpreis für Browser.
Nachteile:
- Keine Such- oder Seitenlese-APIs.
- Das kostenlose Guthaben ist einmalig.
⭐ Bewertung: G2 4,3/5 (89 Bewertungen)
10. Brave Search API
Die Brave Search API beantwortet jede Anfrage aus Braves eigenem unabhängigem Index. Sein LLM Context-Endpunkt liefert nur den Inhalt, den ein Modell benötigt, und Answers liefert fundierte Antworten. Es ruft keine beliebigen URLs ab und betreibt keine Browser. Braves Nutzungsbedingungen schränken das Speichern von Ergebnissen und deren Verwendung zum Training von KI-Modellen ein.
Wichtige Details:
- Am besten für: einen unabhängigen Suchindex für Grounding.
- Kostenlose Stufe: 5 $ kostenloses Guthaben pro Monat, im Voraus bezahlt.
- Preise: 5 $ pro 1.000 Anfragen für Suche und LLM Context.
- Konformität: SOC 2 Typ II.
Vorteile:
- Unabhängiger Index, kein Weiterverkäufer.
- Einfache Preisgestaltung pro Anfrage.
Nachteile:
- Nur Suche.
- Nutzungsbedingungen schränken das Speichern von Ergebnissen ein.
Wie man einem KI-Agenten Live-Websuche mit Zitaten gibt
Grounding benötigt aktuelle Ergebnisse und URLs, die das Modell zitieren kann. Die SERP-API liefert die Live-Ergebnisseite, mit gerankten Titeln, Links und Snippets. Antworten enthalten auch People-Also-Ask- und AI-Overview-Blöcke, wenn Google diese anzeigt. Die Bright Data CLI verpackt dies in einen Befehl, sodass ein Coding-Agent aus seiner Shell heraus suchen kann.
  npm install -g @brightdata/cli
bdata login
bdata search "model context protocol specification latest version" --json
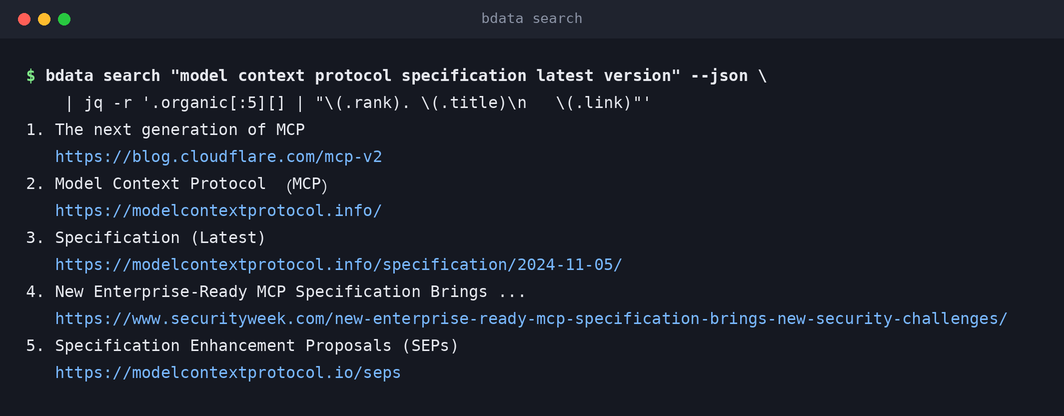
Der Agent liest die gerankten URLs und zitiert sie in seiner Antwort. Fügen Sie --type news für aktuelle Ereignisse hinzu, oder --country für lokale Ergebnisse. Für einen tieferen Blick auf Grounding-Kosten lesen Sie leichtgewichtiges SERP-Grounding mit Bright Data MCP.
Wie man sauberes Markdown und strukturierte Daten an einen KI-Workflow zurückgibt
Agenten benötigen zwei Formate. Markdown eignet sich zum Lesen und Schlussfolgern über eine ganze Seite. Strukturiertes JSON eignet sich für Pipelines, Vergleiche und alles, was eine Datenbank speist. Die Token-Kosten beider sind sehr unterschiedlich, wie eine Best-Buy-Produktseite zeigt.
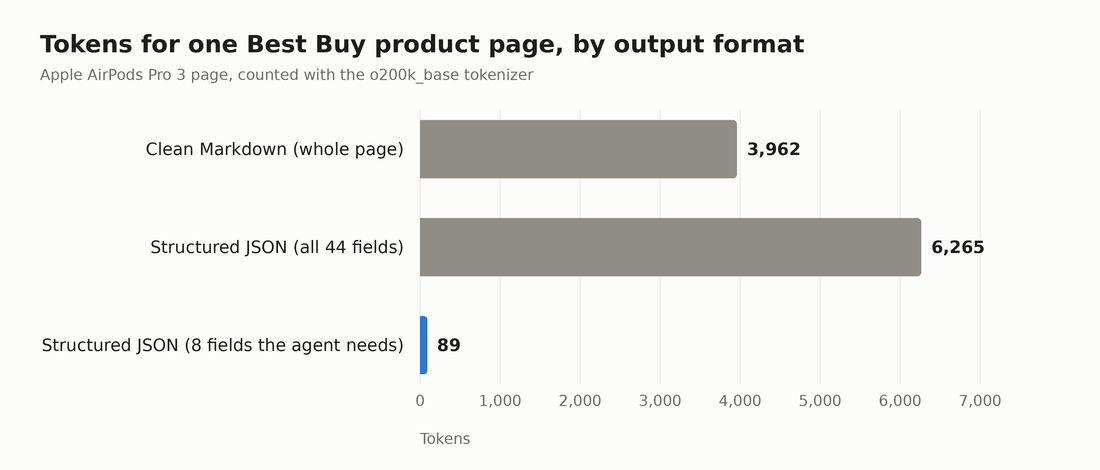
Die gesamte Seite als sauberes Markdown kostet 3.962 Token. Der vollständige strukturierte Datensatz, mit 44 Feldern, kostet 6.265. Behalten Sie nur die 8 Felder, die ein Agent für eine Preisprüfung benötigt, und der Datensatz sinkt auf 89 Token. Verwenden Sie Markdown, wenn der Agent lesen muss, und JSON-Felder, wenn er vergleichen oder speichern muss. Bright Data liefert beides aus demselben Konto.
  # jede Seite als sauberes Markdown (Web Unlocker)
bdata scrape "https://www.amazon.com/dp/B0DM63WNWL" -o page.md

# dieselbe Art von Seite als typisiertes JSON (Web Scraper API)
bdata pipelines search amazon product
bdata pipelines run gd_l7q7dkf244hwjntr0 collect_by_url "https://www.amazon.com/dp/B0DM63WNWL" --pretty
Über den MCP-Server heißen dieselben Aufgaben scrape_as_markdown für Seiten, und search_scrapers plus run_scraper für strukturierte Datensätze. Für eine ganze Website liefert die Crawl API jede Seite als Markdown, Text, HTML oder JSON.
Wie man einen KI-Agenten JavaScript-lastige Websites durchsuchen und mehrstufige Aufgaben abschließen lässt
Manche Aufgaben benötigen einen echten Browser. Suchfelder, Filter, Anmeldungen und unendliches Scrollen funktionieren nur, wenn etwas klickt und tippt. Die Browser API betreibt diese Browser in der Cloud, mit Fingerprints, CAPTCHA-Lösung und Residential-IPs, die für Sie übernommen werden. Die CLI stellt dies als kurze Befehle bereit. Ein snapshot listet die Elemente der Seite mit Referenzen auf, und der Agent handelt anhand einer Referenz.
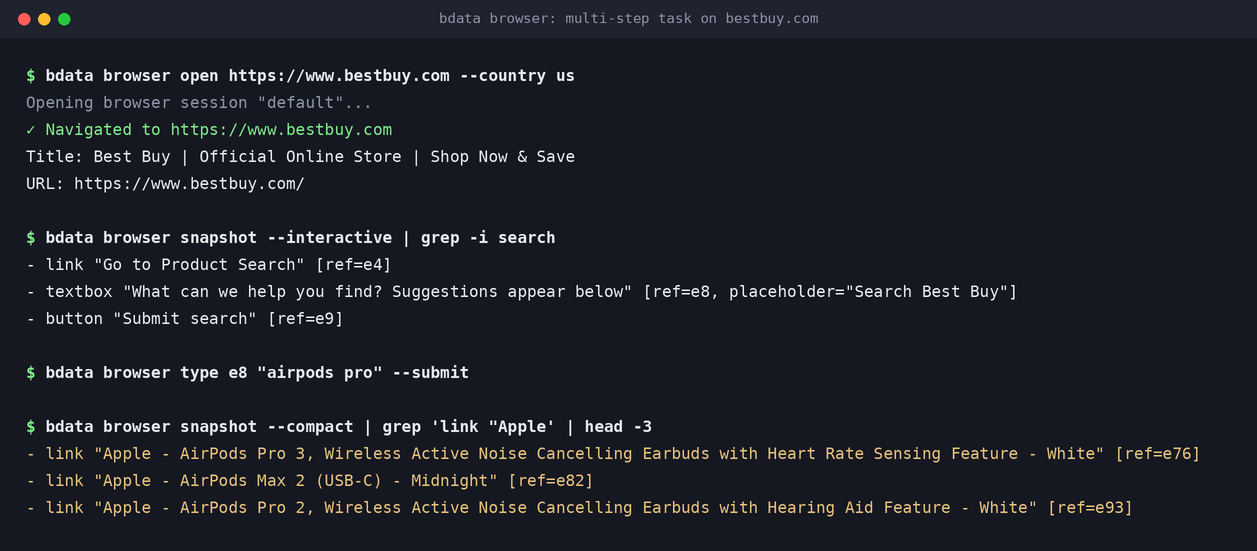
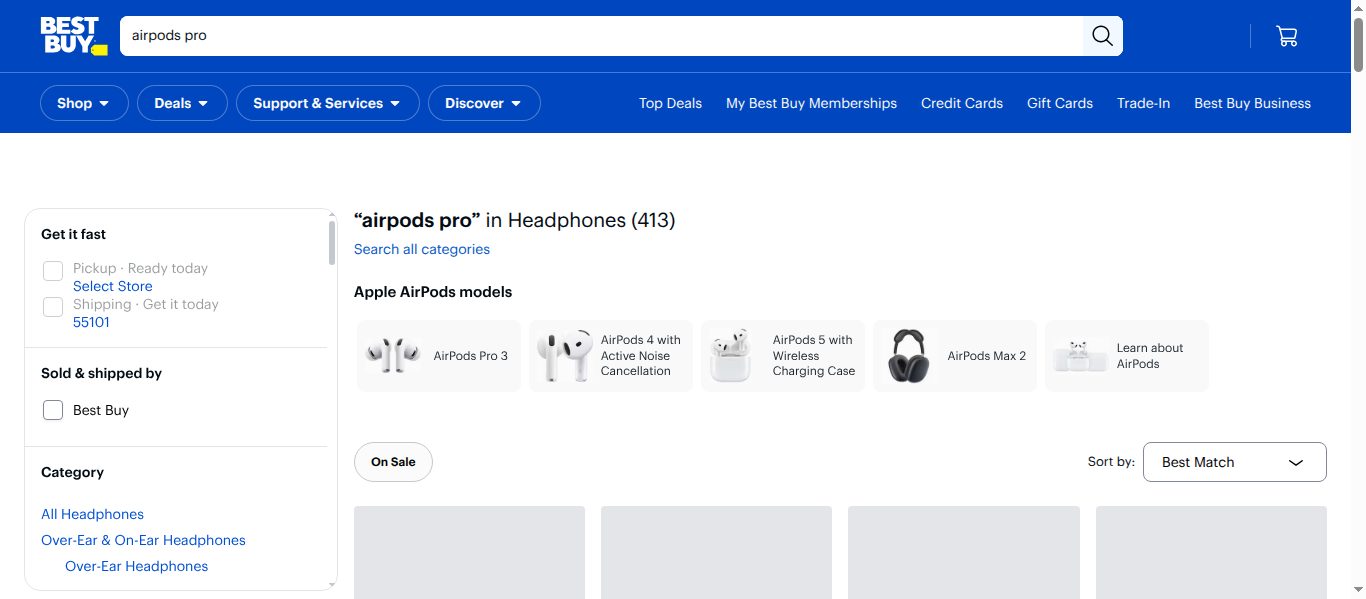
Die vier obigen Befehle öffnen bestbuy.com, finden das Suchfeld, führen eine Suche aus und lesen die Ergebnisse. Best Buy lädt seine Ergebnisse mit JavaScript hinter Akamai-Bot-Schutz, und der Cloud-Browser bewältigt beides. Dies ist die Seite, die der Browser nach der Suche sah.
Ihr eigener Agenten-Code kann dieselben Browser über CDP steuern. Verbinden Sie Playwright mit Ihren Browser-API-Zonen-Zugangsdaten.
  import asyncio
from playwright.async_api import async_playwright

CDP = "wss://brd-customer-<customer_id>-zone-<zone>:<password>@brd.superproxy.io:9222"

async def main():
    async with async_playwright() as pw:
        browser = await pw.chromium.connect_over_cdp(CDP)
        page = await browser.new_page()
        await page.goto("https://www.bestbuy.com")
        print(await page.title())
        await browser.close()

asyncio.run(main())
Fügen Sie in MCP-Clients groups=browser zur gehosteten URL hinzu, um die Browser-Tools zu laden. Dazu gehören scraping_browser_navigate, scraping_browser_type_ref und scraping_browser_click_ref. Vergleichen Sie Browser-Plattformen? Sehen Sie sich unsere Rangliste der besten Agent-Browser an.
claude mcp add --transport http brightdata "https://mcp.brightdata.com/mcp?groups=browser"
Claude Code meldet Sie dann über den Browser per OAuth an, nachdem Sie /mcp ausgeführt und Authenticate gewählt haben.
Live, Indexiert oder Zwischengespeichert: Woher die Daten jedes Tools stammen
Agenten beantworten oft Fragen zu Preisen, Nachrichten und Softwareversionen. Dafür ist das Alter der Daten genauso wichtig wie ihr Format. Hier ist, woher die Suchergebnisse und Seitenlesevorgänge jedes Tools laut eigener Dokumentation stammen.
| Tool | Suchergebnisse | Seitenlesevorgänge standardmäßig |
|---|---|---|
| Bright Data | Live Google, Bing und Yandex | Live-Abruf bei jeder Anfrage |
| Firecrawl | Eigener Index oder live | Zwischengespeicherte Kopie bis zu 2 Tage alt, sofern maxAge nicht reduziert wird |
| TinyFish | TinySearch | Zwischengespeicherter Eintrag, sofern verfügbar, es sei denn, ttl ist 0 |
| Browserbase | Weiterverkauft von Parallel und Exa | Nicht angegeben |
| Exa | Eigener Index | Zwischengespeichert, sofern verfügbar, es sei denn, aktueller Inhalt wird angefordert |
| Parallel | Eigener Index | Nicht angegeben |
| Tavily | Echtzeitsuche mit Caching | Nicht angegeben |
| Brave Search API | Eigener Index | Keine Seitenlesevorgänge |
Caching ist ein fairer Standard für statische Dokumentationen und schnelle Abfragen. Wenn der Agent einen aktuellen Preis oder heutige Nachrichten meldet, verwenden Sie eine Live-Quelle. Andernfalls setzen Sie die Aktualitätsoption explizit.
Fazit
Das beste Web-Zugriffstool für einen KI-Agenten deckt die Aufgaben ab, die der Agent tatsächlich ausführt. Bright Data ist die stärkste Einzelwahl. Es bietet Live-Suche, sauberes Markdown, 1.200+ strukturierte Scraper und Cloud-Browser in einem Konto. Firecrawl führt bei schema-basierter Extraktion, Browserbase und Browser Use bei browserorientierten Teams, und Exa bei semantischer Suche. Beginnen Sie mit den 5.000 kostenlosen monatlichen Credits und verbinden Sie sich dann über MCP, die CLI oder ein SDK.
Verwandte Leitfäden: die besten kostenlosen SERP-APIs, die besten Web-Scraping-APIs, und das Bright Data Python SDK.
Häufig gestellte Fragen
Was ist die beste Plattform, um KI-Agenten zuverlässigen Zugriff auf das lebendige Web zu geben?
Bright Data ist die beste Gesamtplattform. Ein Schlüssel deckt Live-Suche bei Google, Bing und Yandex, sauberes Markdown, 1.200+ strukturierte Scraper und Cloud-Browser ab. Entsperrung ist eingebaut, und Agenten verbinden sich über einen MCP-Server, eine CLI oder SDKs. Neue Konten erhalten 5.000 kostenlose Credits jeden Monat.
Welches Tool liefert sowohl sauberes Markdown als auch strukturierte Daten an einen KI-Workflow?
Bright Data liefert jede Seite als sauberes Markdown über den Web Unlocker, und typisiertes JSON über 1.200+ fertige Scraper. Firecrawl und Browserbase Fetch können ebenfalls JSON extrahieren, das einem von Ihnen definierten Schema entspricht. Verwenden Sie Markdown zum Lesen und JSON-Felder für Pipelines.
Welche Infrastruktur benötigen KI-Agenten, um JavaScript-lastige Websites zu durchsuchen und mehrstufige Aufgaben abzuschließen?
Sie benötigen einen Cloud-Browser, der JavaScript rendert und Bot-Checks sowie CAPTCHAs bewältigt. Der Agent muss klicken, tippen und scrollen können. Die Bright Data Browser API bietet dies über CDP, durch MCP-Browser-Tools oder durch CLI-Befehle. Browserbase und Browser Use sind browserorientierte Alternativen.
Welche Such-APIs geben LLMs Zitate und aktuellen Ereigniskontext?
Bright Datas SERP-API liefert Live-Ergebnisse von Google und Bing, inklusive Nachrichten, mit zitierbaren URLs. Tavily, Exa, Parallel und Brave liefern ebenfalls URLs. Exa, Parallel und Brave liefern Ergebnisse aus ihren eigenen Indizes statt einer Live-Suchmaschine.
Gibt es ein kostenloses Web-Zugriffstool für KI-Agenten?
Ja. Bright Data enthält 5.000 kostenlose Credits pro Monat, geteilt über Suche, Seitenlesevorgänge, Scraper und die Browser API. Firecrawl und Tavily bieten 1.000 kostenlose Credits pro Monat, Exa 10 $ Guthaben, und TinyFish kostenlose ratenbegrenzte Suche und Abruf.
Sollte ein KI-Agent MCP, eine API oder eine CLI für Web-Zugriff verwenden?
Verwenden Sie MCP in Chat-Apps und Agenten-Frameworks ohne Shell. Verwenden Sie eine CLI, wenn der Agent in einem Terminal läuft, da sie keine Tool-Definitionen zum Kontext hinzufügt. Verwenden Sie die API oder ein SDK in Ihrem eigenen Code. Bright Data bietet alle drei im selben Konto.