In diesem Artikel erfahren Sie:
- Warum zuverlässige Web-Datenbeschaffung ein entscheidender Teil einer KI-fähigen Datenpipeline ist, und wie Bright Data das bewältigen kann.
- Wie der Bright Data + Snowflake-Workflow helfen kann, die Kosten der Datenpipeline zu optimieren.
- Wie das Filtern und Senden nur relevanter Web-Daten den Snowflake-Speicheraufwand reduziert und unnötige Rechenzyklen eliminiert.
- Wie man Bright Data Web-Datensätze an Snowflake liefert und sie durch Cortex Agents in Erkenntnisse verwandelt.
- Wie man zwischen persistenten Batch-Datensätzen und Live-Web-Zugriff (Bright Data MCP) für Ihre KI-Architektur wählt.
- Was jede Snowflake Cortex-Komponente (Analyst, Search, Sense und Agents) im Workflow macht.
- Wie Bright Data und Snowflake zusammenarbeiten können, um Live-Web-Daten über MCP und CoCo CLI zu sammeln.
Lassen Sie uns eintauchen!
Von Web-Daten zu KI-fähiger Intelligenz
Für viele Unternehmen ist das Web eine der reichhaltigsten verfügbaren Quellen für externe Daten. Produktinformationen, Unternehmensprofile, Marktsignale, Social-Media-Aktivitäten, Bewertungen, Preise und andere öffentliche Informationen können wertvollen Kontext für Geschäftsentscheidungen liefern.
Die Herausforderung besteht darin, auf diese Daten zuverlässig in hohem Volumen zuzugreifen. Web-Daten sind über Millionen von Websites verteilt, ändern sich ständig und erfordern oft spezialisierte Infrastruktur, um sie zu sammeln, zu strukturieren und aktuell zu halten. Der interne Aufbau dieser Fähigkeit kann erheblichen technischen Aufwand erfordern.
Hier kommt die Datenbeschaffungsinfrastruktur von Bright Data ins Spiel. Die Plattform ist darauf ausgelegt, Web-Daten im großen Maßstab zu sammeln, mit der Abdeckung, Zuverlässigkeit und Echtzeitverfügbarkeit, die für Unternehmens-Workloads benötigt werden.
Anstatt Ihre eigene Infrastruktur zur Web-Datenerfassung aufzubauen und zu pflegen, können Sie Bright Data nutzen, um die Komplexität der Sammlung und Vorbereitung der von Ihrem Anwendungsfall benötigten Daten zu bewältigen.
Snowflake bietet dann die Umgebung, in der diese externen Daten gespeichert werden können. Sie können auch verarbeitet und dann mit vorhandenen Unternehmensdaten durch Cortex AI konsolidiert werden.
Das Ergebnis ist ein klarer Weg von externen Web-Daten zu Business Intelligence, wobei Bright Data die Komplexität des Web-Datenabrufs übernimmt und Snowflake die Infrastruktur für Analyse und KI-gestützte Aktivierung bereitstellt.
Bright Data als Datenschicht für Snowflake
Bevor Web-Daten in Snowflake analysiert werden können, müssen sie gesammelt und für die Nutzung vorbereitet werden. Bright Data adressiert diese Herausforderung mit Enterprise-Infrastruktur für die Web-Datenerfassung.
Die Plattform von Bright Data umfasst mehr als 400 Millionen Residential-IPs, was hohe Skalierbarkeit und Gleichzeitigkeit ermöglicht, mit 99,99% Verfügbarkeit und einer Erfolgsrate von 99,95%.
Wenn es um Web-Daten geht, bietet Bright Data Hunderte von Datensätzen mit über 21 Milliarden Datensätzen, über 1.000 fertige Web Scraper APIs und über 90 PB an zwischengespeicherten Daten, die über APIs abfragbar sind.
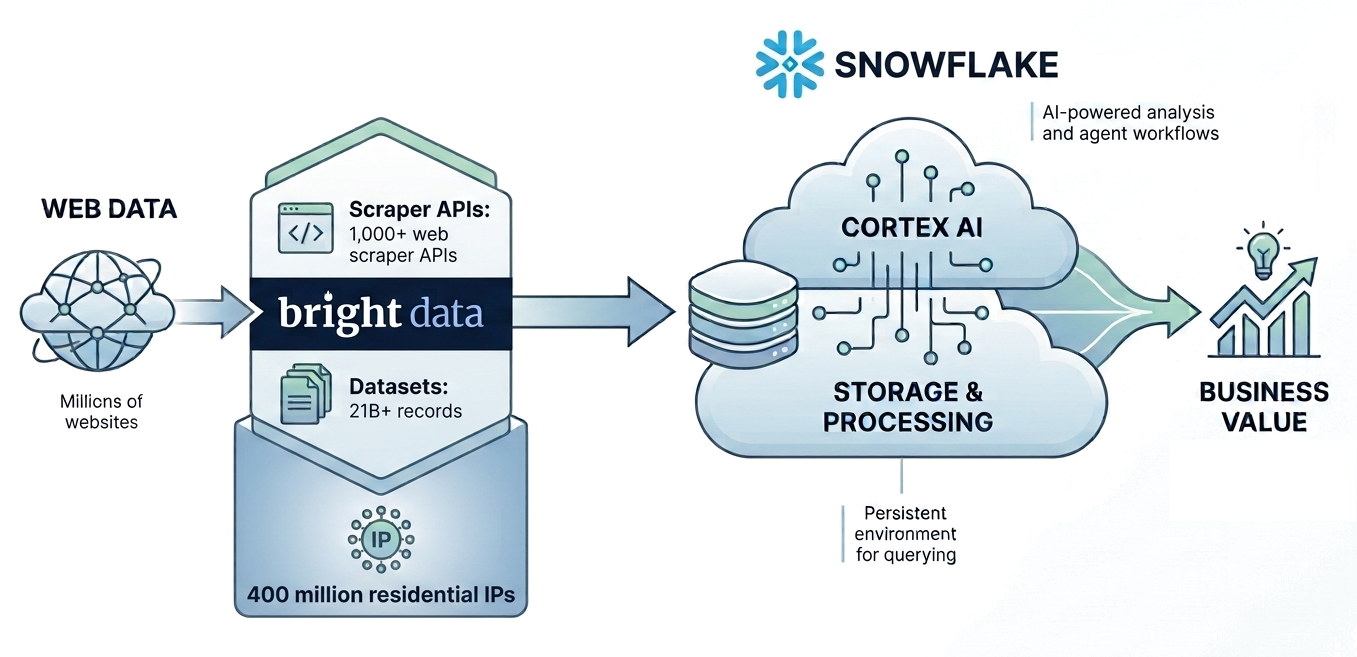
Zusammen decken Bright Data und Snowflake zwei sich ergänzende Fähigkeiten ab:
- Die richtigen externen Daten mit Bright Data beschaffen: Identifizieren Sie die Web-Daten, die Ihr Unternehmen benötigt, und sammeln Sie sie im erforderlichen Umfang und in der erforderlichen Aktualität.
- In Snowflake speichern, zusammenführen und aktivieren: Führen Sie diese externen Daten mit Ihren aktuellen Snowflake-Daten zusammen und nutzen Sie die Verarbeitungs- und KI-Fähigkeiten von Snowflake, um sie in umsetzbare Erkenntnisse zu verwandeln.
Dieser Ansatz ermöglicht es Ihnen auch, die Datenpipeline vorgelagert zu optimieren. Anstatt automatisch komplette Datensätze in Snowflake zu verschieben, helfen Ihnen die Filter- und Anpassungsfunktionen von Bright Data, nur die Daten auszuwählen, die Sie benötigen. Das bedeutet weniger unnötige Daten zum Speichern, während die für die nachfolgende Verarbeitung benötigten Informationen erhalten bleiben.
Persistente Datensätze oder Live-Web-Zugriff? Die Wahl Ihres Ingress-Musters
Bevor Sie Ihren Agenten erstellen, entscheiden Sie, wie Sie auf Web-Daten zugreifen und sie speichern möchten. Sollten Sie gescrapte Daten in Snowflake laden und dort abfragen, oder sollte Ihr Cortex Agent Daten zur Inferenzzeit dynamisch aus dem Web abrufen?
Bright Data unterstützt beide Muster, und jedes eignet sich für unterschiedliche Anwendungsfälle.
| Persistente Batch-Datensätze | Live-Ingress über Bright Data MCP | |
|---|---|---|
| Wie es funktioniert | Ein gefilterter Datensatz wird einmalig oder nach einem Zeitplan an Snowflake-Tabellen geliefert. | Der Cortex Agent ruft Bright Data-Tools für Suche, Scraping oder Browser-Automatisierung auf, wenn er eine Antwort benötigt. |
| Wo die Daten liegen | In Snowflake, zusammen mit Ihren Geschäftsdaten. | Bei Bedarf abgerufen und nicht gespeichert, es sei denn, Sie persistieren es ausdrücklich. |
| Aktualität | Aktuell zum Zeitpunkt der letzten Datenlieferung. | Frische Web-Daten, zum Zeitpunkt der Abfrage abgerufen. |
| Latenz pro Anfrage | Niedrig, da Abfragen direkt gegen das Warehouse ausgeführt werden. | Höher, da Daten aus dem Web abgerufen werden müssen und Seiten möglicherweise gerendert werden müssen. |
| Bestes Abfragemuster | Wiederholbare, aggregierte und join-intensive Analyse. | Ad-hoc-, zeitkritische oder Long-Tail-Abfragen. |
| Joins mit internen Daten | Native SQL-Joins mit Ihren vorhandenen Warehouse-Daten. | Der Agent kombiniert Web-Ergebnisse mit anderen Informationen in seinem Kontext. |
| Reproduzierbarkeit und Prüfbarkeit | Hoch, da derselbe Datensatz-Snapshot dasselbe Ergebnis liefern kann. | Niedrig, da sich Webseiten und ihre Inhalte zwischen Anfragen ändern können. |
| Kostenprofil | Datenlieferung plus Snowflake-Speicher- und Rechenkosten. | Nutzung pro Anfrage, die mit der Agentenaktivität skaliert. |
| Typische Beispiele | Influencer-Bewertung, Marktgrößenbestimmung, Datenanreicherung und BI-Dashboards. | Preisprüfungen, Nachrichtenüberwachung, Faktenprüfung und das Lesen bestimmter URLs. |
Als Faustregel für die Wahl des richtigen Ansatzes gilt: Wenn Sie erwarten, wiederholt dieselben Fragetypen über eine definierte Population zu stellen, speichern Sie die Daten. Wenn die Antwort davon abhängt, was das Web gerade jetzt sagt oder von einer Seite, die Sie nicht im Voraus vorhersagen können, rufen Sie die Daten bei Bedarf ab.
In den folgenden Abschnitten sehen Sie zunächst, wie man mit dem persistenten Datensatz-Ansatz arbeitet, und erkunden dann, wie man Live-Web-Zugriff mit Bright Data MCP hinzufügt.
Von Speicherung zu KI: Das Snowflake-Verbrauchsmodell verstehen
Nachdem Sie nun gesehen haben, wie Bright Data und Snowflake zusammenpassen, stellt sich natürlich die Frage nach den Kosten. Datenpipelines können mehrere Verbrauchsebenen umfassen, von der Beschaffung von Web-Daten bis zur Speicherung, Verarbeitung und Analyse mit KI.
Das Einbringen von Web-Daten in Snowflake umfasst mehrere Verbrauchsebenen. Je nach Workflow können Kosten durch Datenbeschaffung über Bright Data, Snowflake-Speicher und -Rechenleistung sowie genutzte KI-Dienste zur Analyse der Daten entstehen.
Die Preise von Bright Data hängen vom Produkt, der Datenquelle, dem Volumen und den Sammlungsanforderungen ab. Die aktuellen Preise und verfügbaren Optionen finden Sie auf der Bright Data Preisseite.
Sobald Daten in Snowflake ankommen, hängt der Verbrauch davon ab, wie viele Daten Sie speichern, verarbeiten, abfragen und aktivieren. Das Preismodell von Snowflake umfasst Speicherung, Rechenleistung und zusätzliche Dienste, einschließlich KI-Fähigkeiten. Für aktuelle Preisdetails siehe Snowflakes Preisoptionen.
Möchten Sie eine detaillierte Kostenaufschlüsselung? Wenden Sie sich an [email protected].
Wie man Bright Data Web-Daten in Snowflake liefert und mit Cortex AI aktiviert
In diesem Schritt-für-Schritt-Abschnitt lernen Sie, wie man mit Bright Data gesammelte Web-Daten zur Speicherung und Verarbeitung an Snowflake sendet. Konkret sehen Sie dann, wie man diese Daten mit einem Snowflake Cortex AI-Agenten zur Analyse verbindet.
Diese Anleitung verwendet das oben beschriebene Muster persistenter Batch-Datensatz. Es passt zu diesem Anwendungsfall, da die Influencer-Bewertung eine wiederholbare Analyse über eine definierte Population ist, die von Joins mit internen Kampagnendaten profitiert.
Voraussetzungen
Um diesem Tutorial zu folgen, stellen Sie sicher, dass Sie Folgendes haben:
- Ein Snowflake-Konto mit einer konfigurierten Datenbank und einem Schema, bereit für die Datenerfassung.
- Ein Bright Data-Konto.
Vertrautheit mit den Bright Data Datenlieferoptionen für Snowflake wird ebenfalls hilfreich sein.
Schritt #1: Den Bright Data Datensatz auswählen
Alle Bright Data-Datensätze können für die Erfassung in Snowflake sowie in mehreren anderen Cloud-Plattformen konfiguriert werden.
Beginnen Sie damit, sich bei Ihrem Bright Data-Konto anzumelden und zu “Datasets > Dataset Marketplace” zu navigieren:
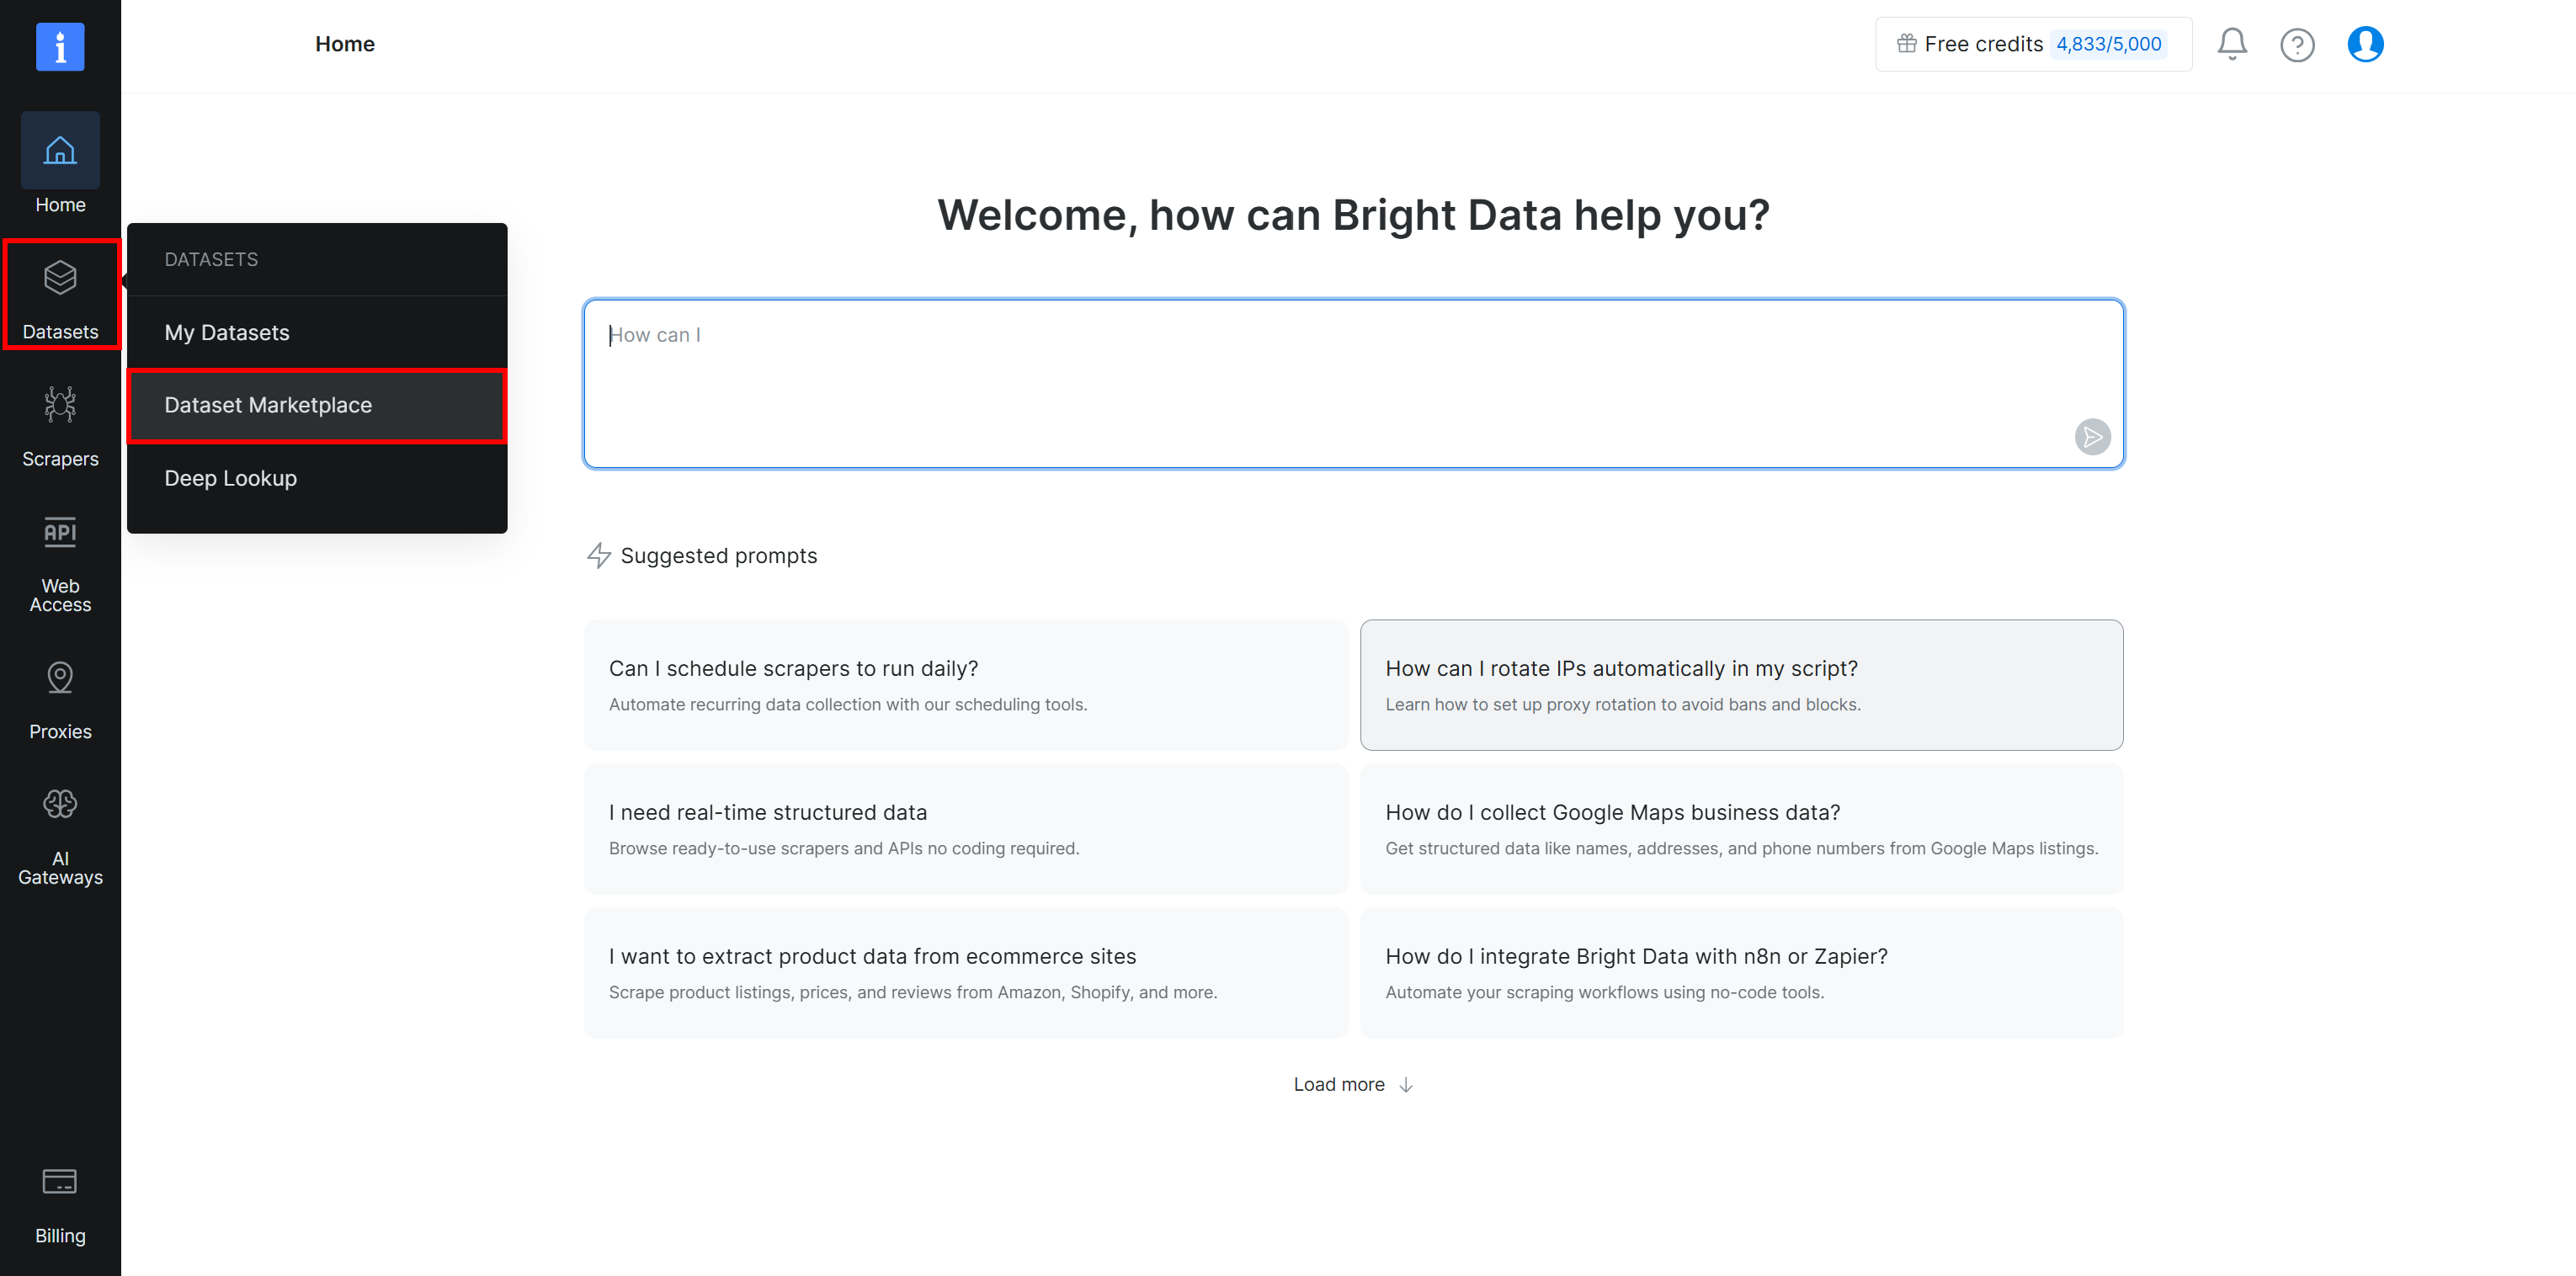 Dataset Marketplace””/>
Suchen Sie auf der Seite “Dataset Marketplace” nach dem Datensatz, der Sie interessiert.
In diesem Tutorial nutzen wir Instagram-Profildaten, um Influencer zu identifizieren, die gut geeignet wären, um ein Hautpflegeprodukt zu sponsern.
Der Bright Data-Datensatz liefert externe Informationen über die Influencer, während Ihre bereits vorhandenen Snowflake-Datensätze internen Kontext wie Produktinformationen, Zielgruppen, Kampagnenanforderungen oder frühere Kampagnenleistung bereitstellen können. Ein Cortex Agent kann dann diese Quellen zusammenführen, um zu bestimmen, welche Influencer am besten zu einer bestimmten Kampagne passen.
Suchen Sie also nach “instagram” und wählen Sie den Datensatz “Instagram – Profiles” aus:
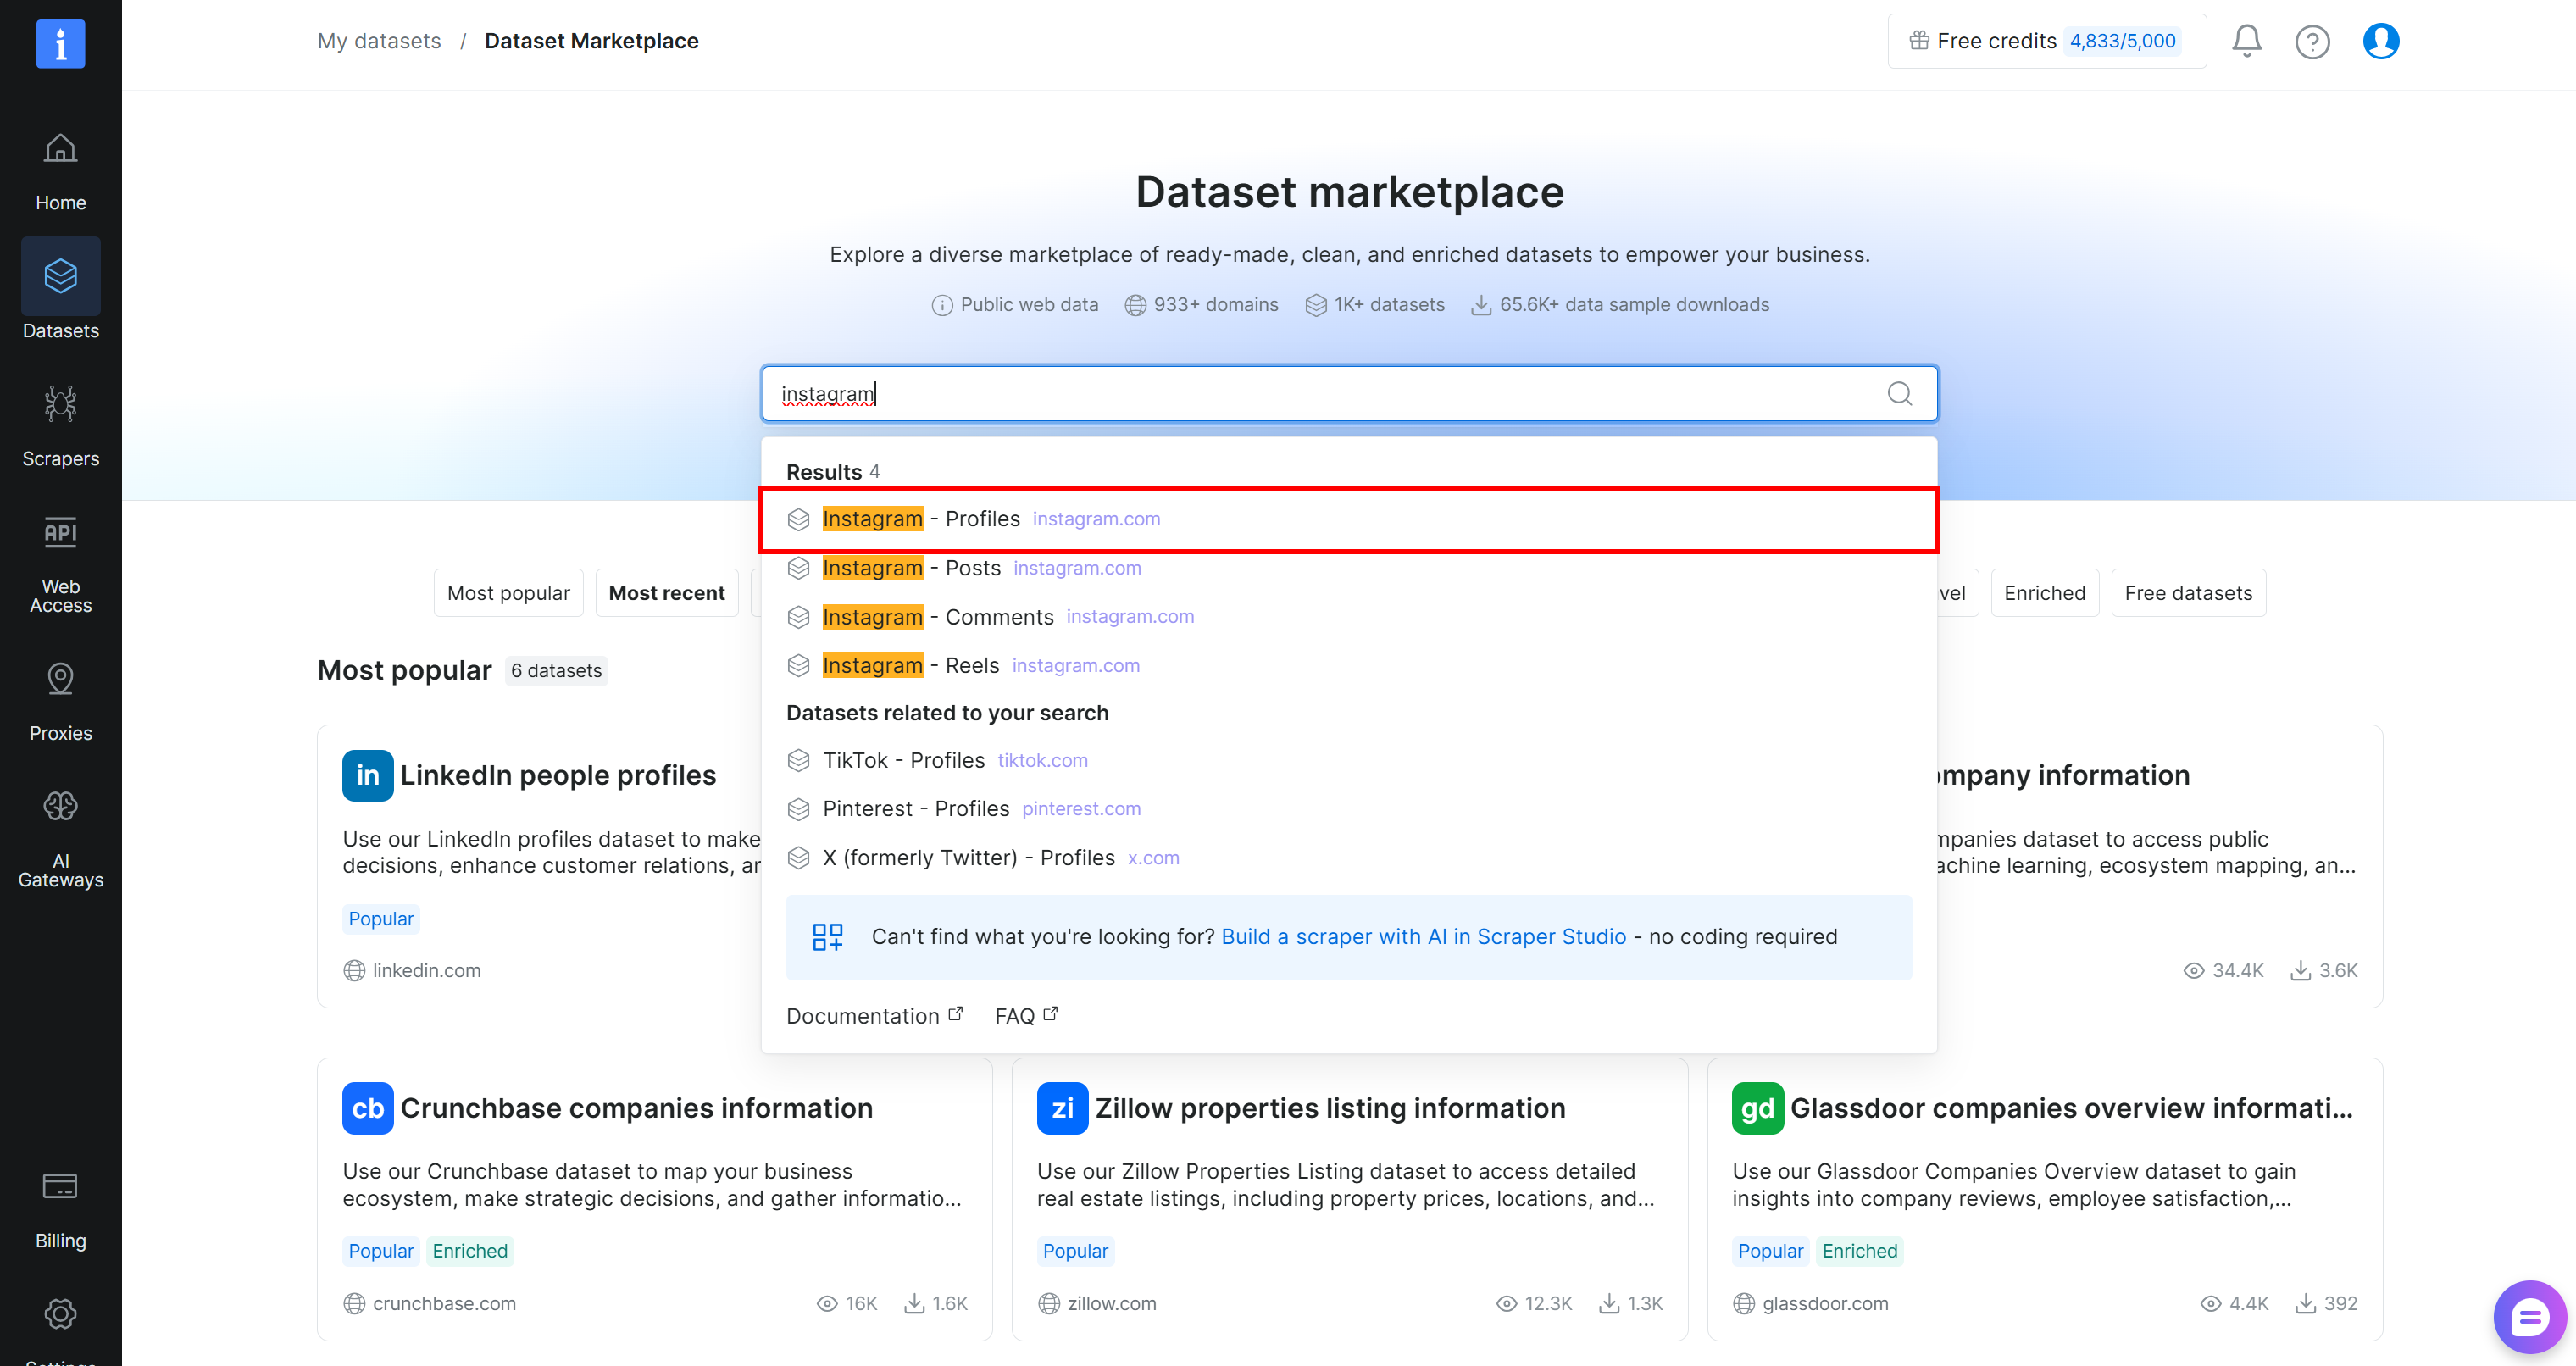
Gut gemacht! Sie werden dann zur Datensatzseite weitergeleitet, wo Sie mit dem Kauf fortfahren können.
Alternativer Ansatz: Sie können Bright Data-Dienste auch direkt über den Snowflake Marketplace beziehen:
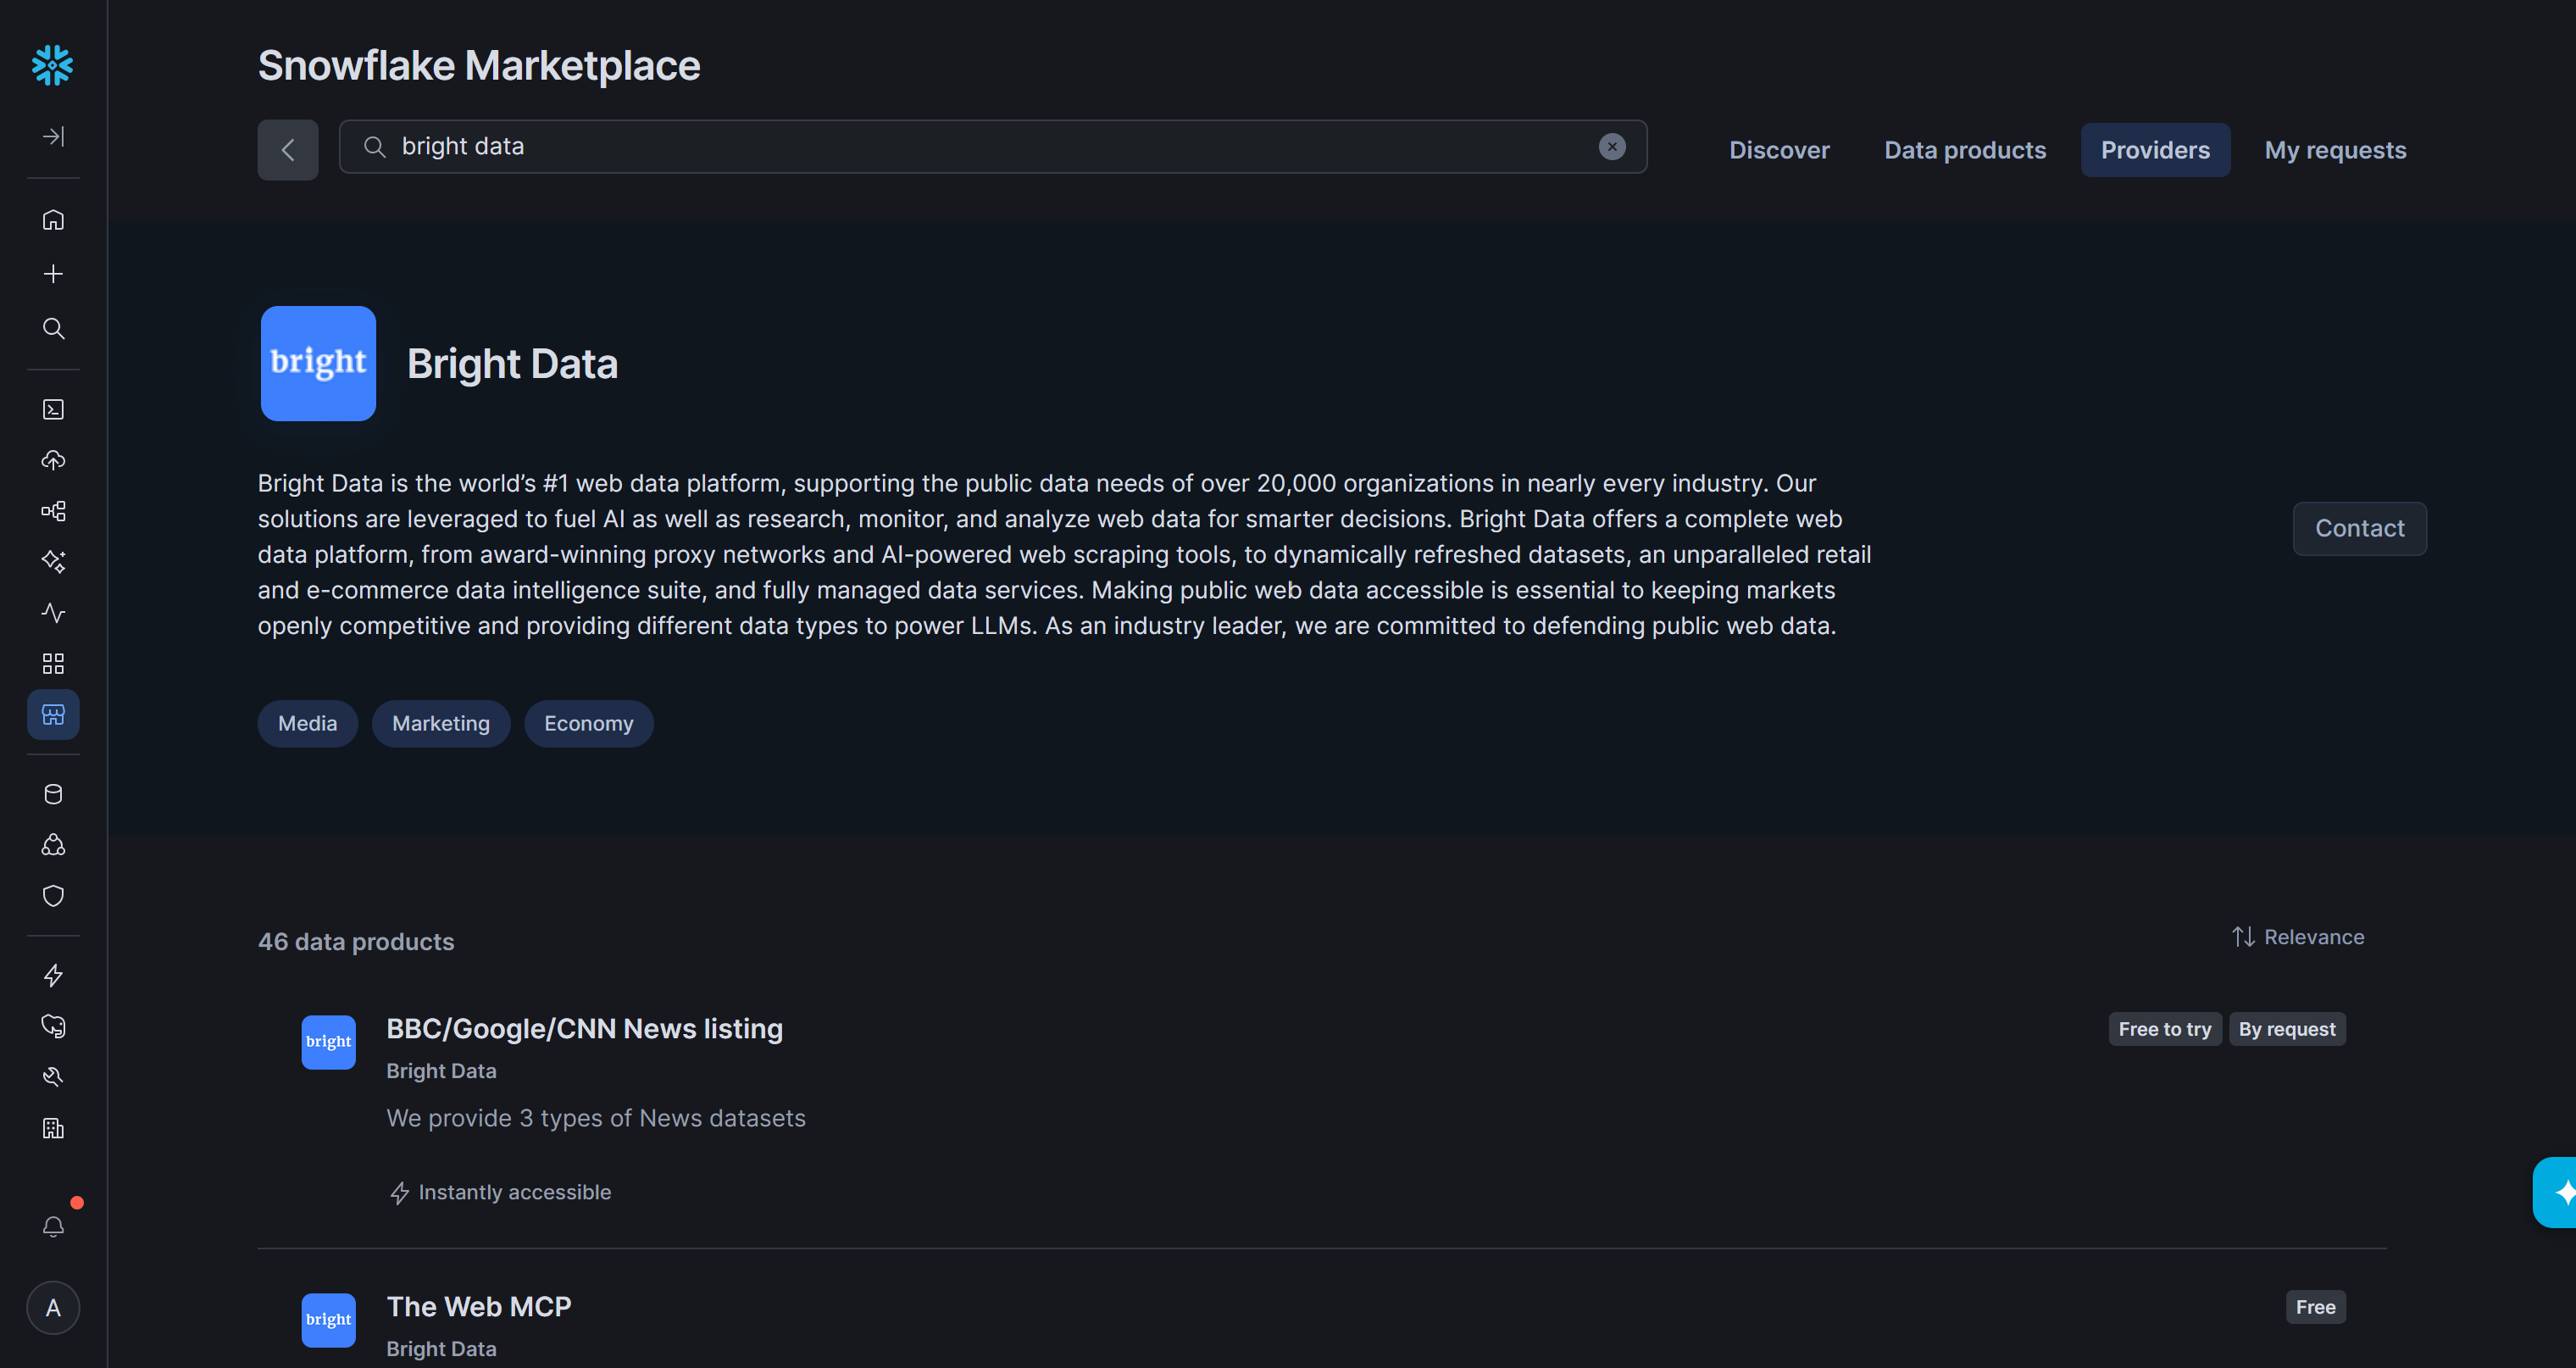
Denken Sie daran, dass Bright Data ein offizieller Snowflake-Anbieter und -Partner ist.
Schritt #2: Die relevanten Daten abrufen
Der Bright Data-Datensatz “Instagram – Profiles” enthält mehr als 650 Millionen Datensätze. In den meisten Fällen benötigen Sie jedoch nur eine Teilmenge des gesamten Datensatzes. Deshalb verfügt Bright Data über integrierte Filteroptionen.
Klicken Sie auf der Seite des Datensatzes “Instagram – Profiles” links auf “Filters”:
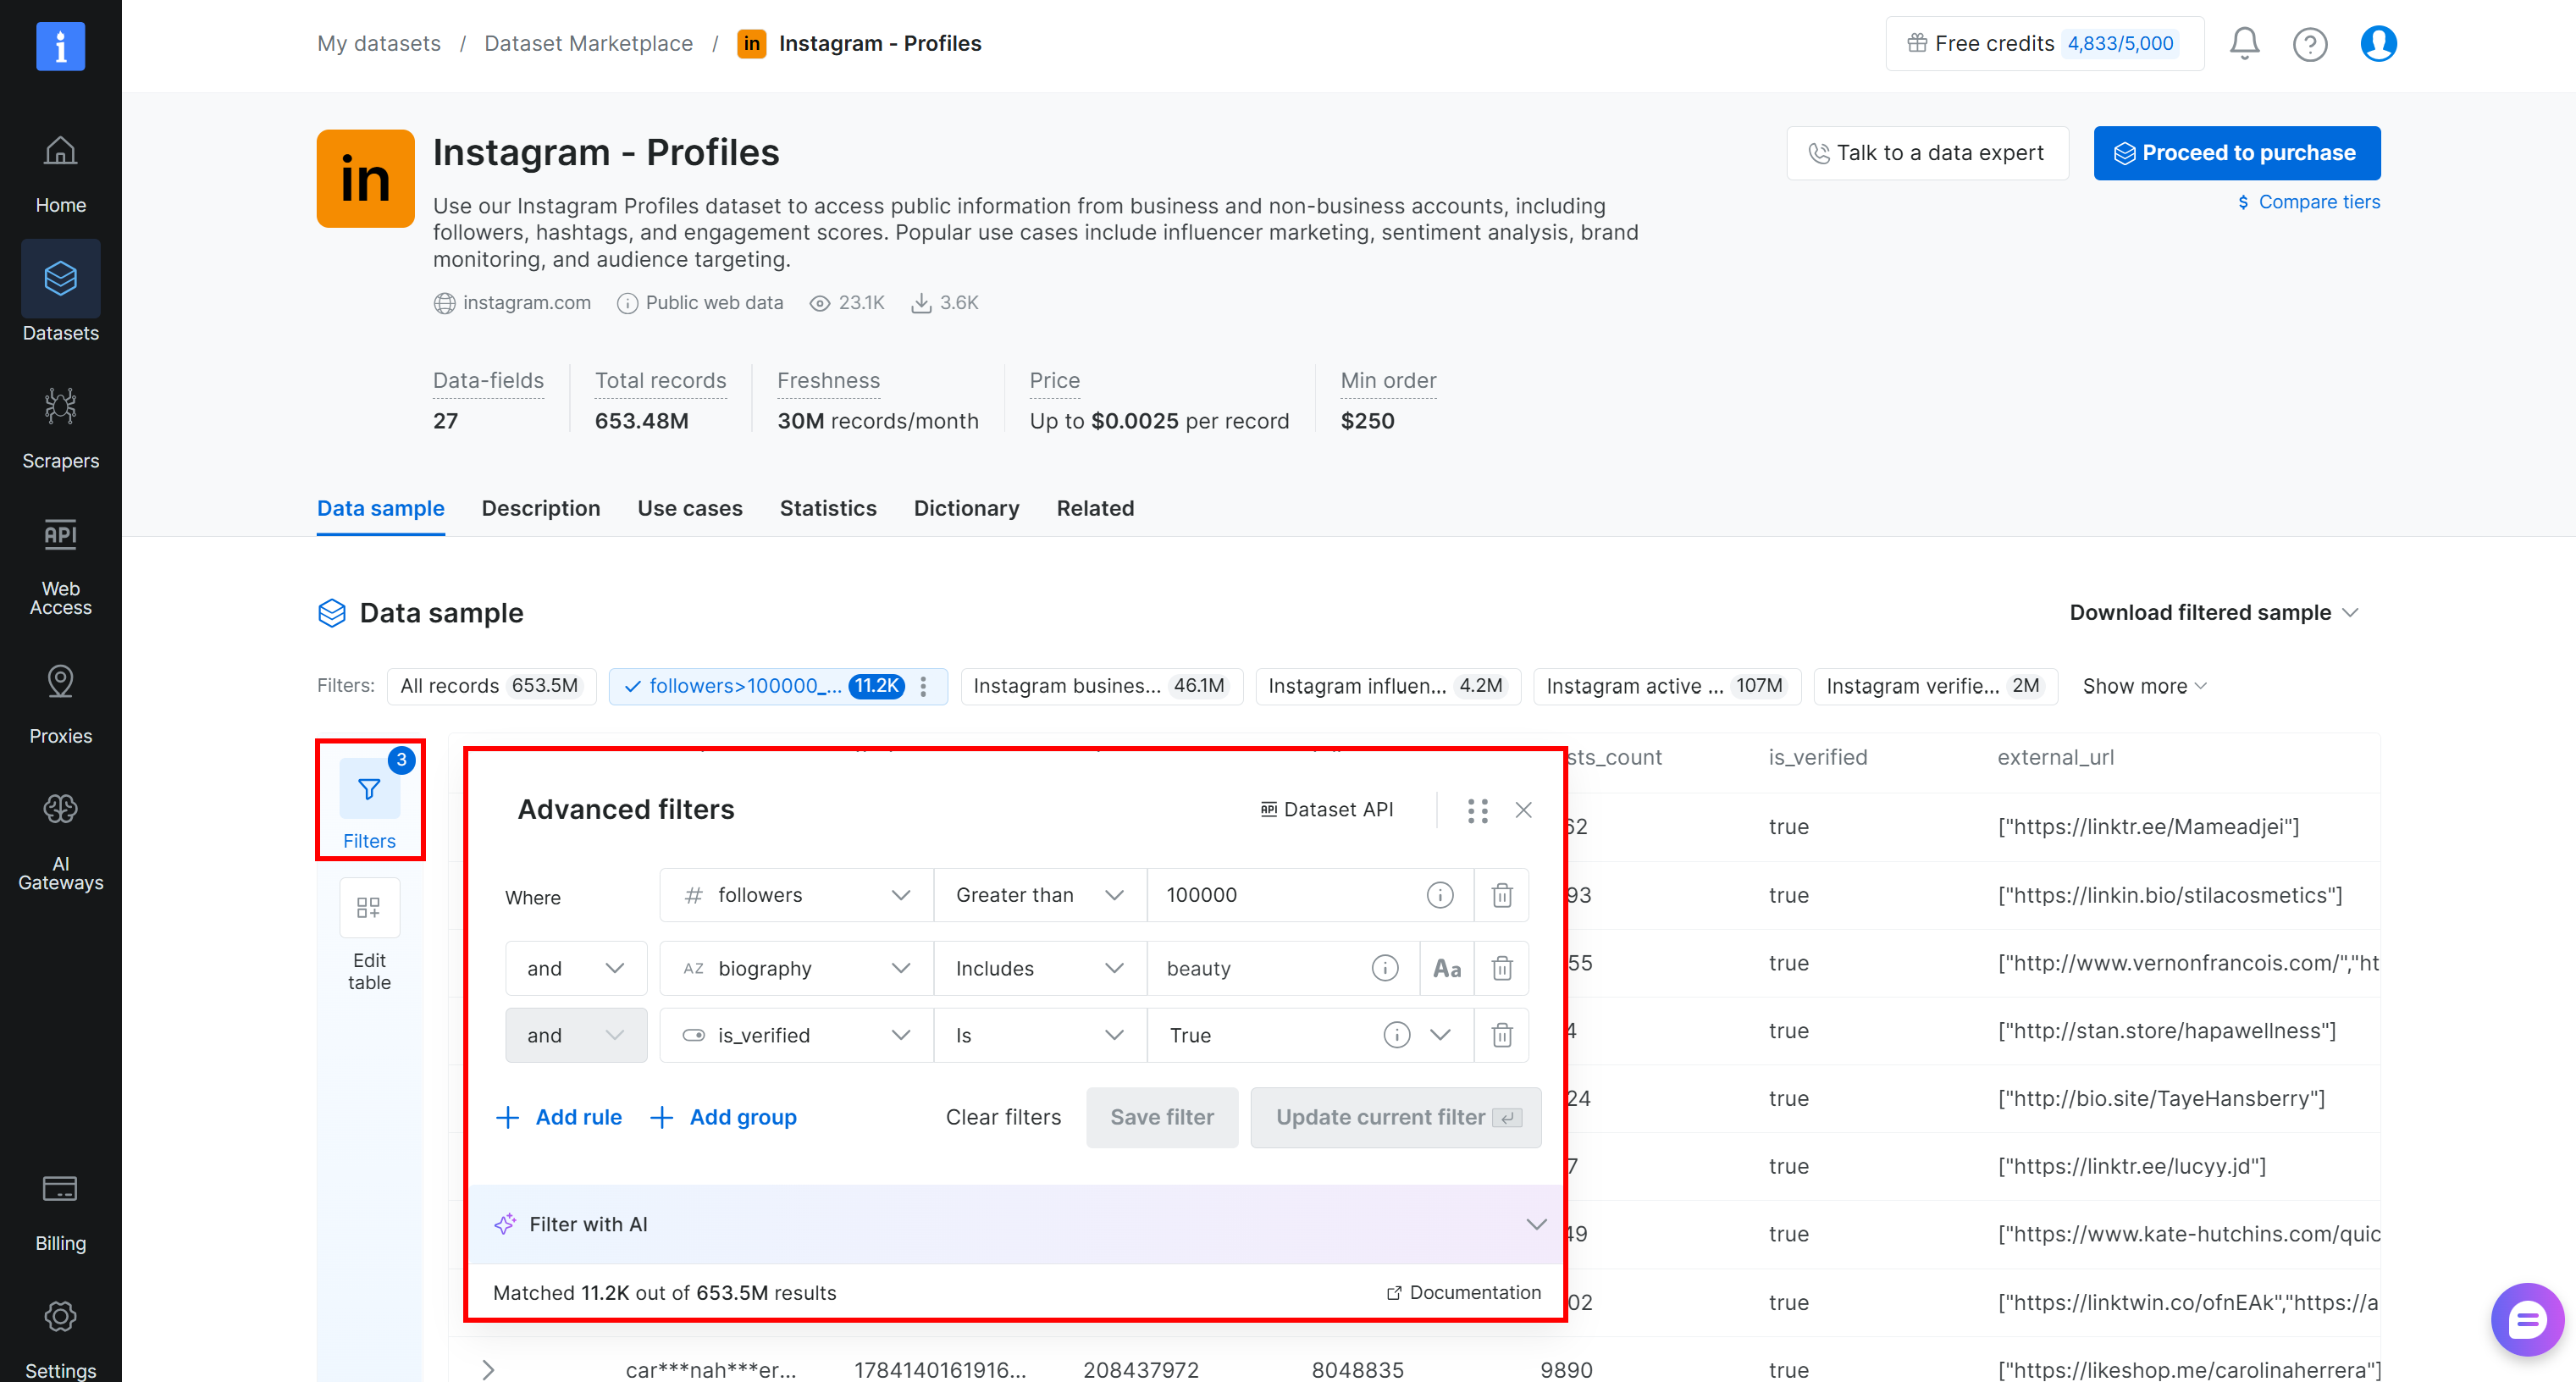
Nehmen wir nun an, Sie möchten Instagram-Profile, die:
- Mehr als 100.000 Follower haben.
- Das Wort “beauty” in ihrer Biografie enthalten.
- Verifiziert sind.
Dieser Filterschritt ist auch aus Sicht der Dateneffizienz wichtig. Anstatt den gesamten Datensatz mit 653,5 Millionen Datensätzen nach Snowflake zu verschieben, können Sie ihn zunächst auf die benötigten Datensätze eingrenzen. Hier reduziert die Filterung von Bright Data den Datensatz auf etwa 11,2K Profile, was hilft, Speicheraufwand zu vermeiden.
Wenden Sie die Filter an. Sie können die gefilterten Profile auch direkt im Bright Data-Kontrollpanel erkunden oder eine Stichprobe von bis zu 1K Datensätzen herunterladen (mit einigen unkenntlich gemachten Feldern).
Sobald Sie mit den Filtern und Ergebnissen zufrieden sind, klicken Sie auf “Proceed to purchase” und wählen Sie eine Lieferfrequenz. Sie können zwischen einem einmaligen Kauf oder regelmäßigen Aktualisierungen der ausgewählten Daten wählen (monatlich, vierteljährlich oder halbjährlich):
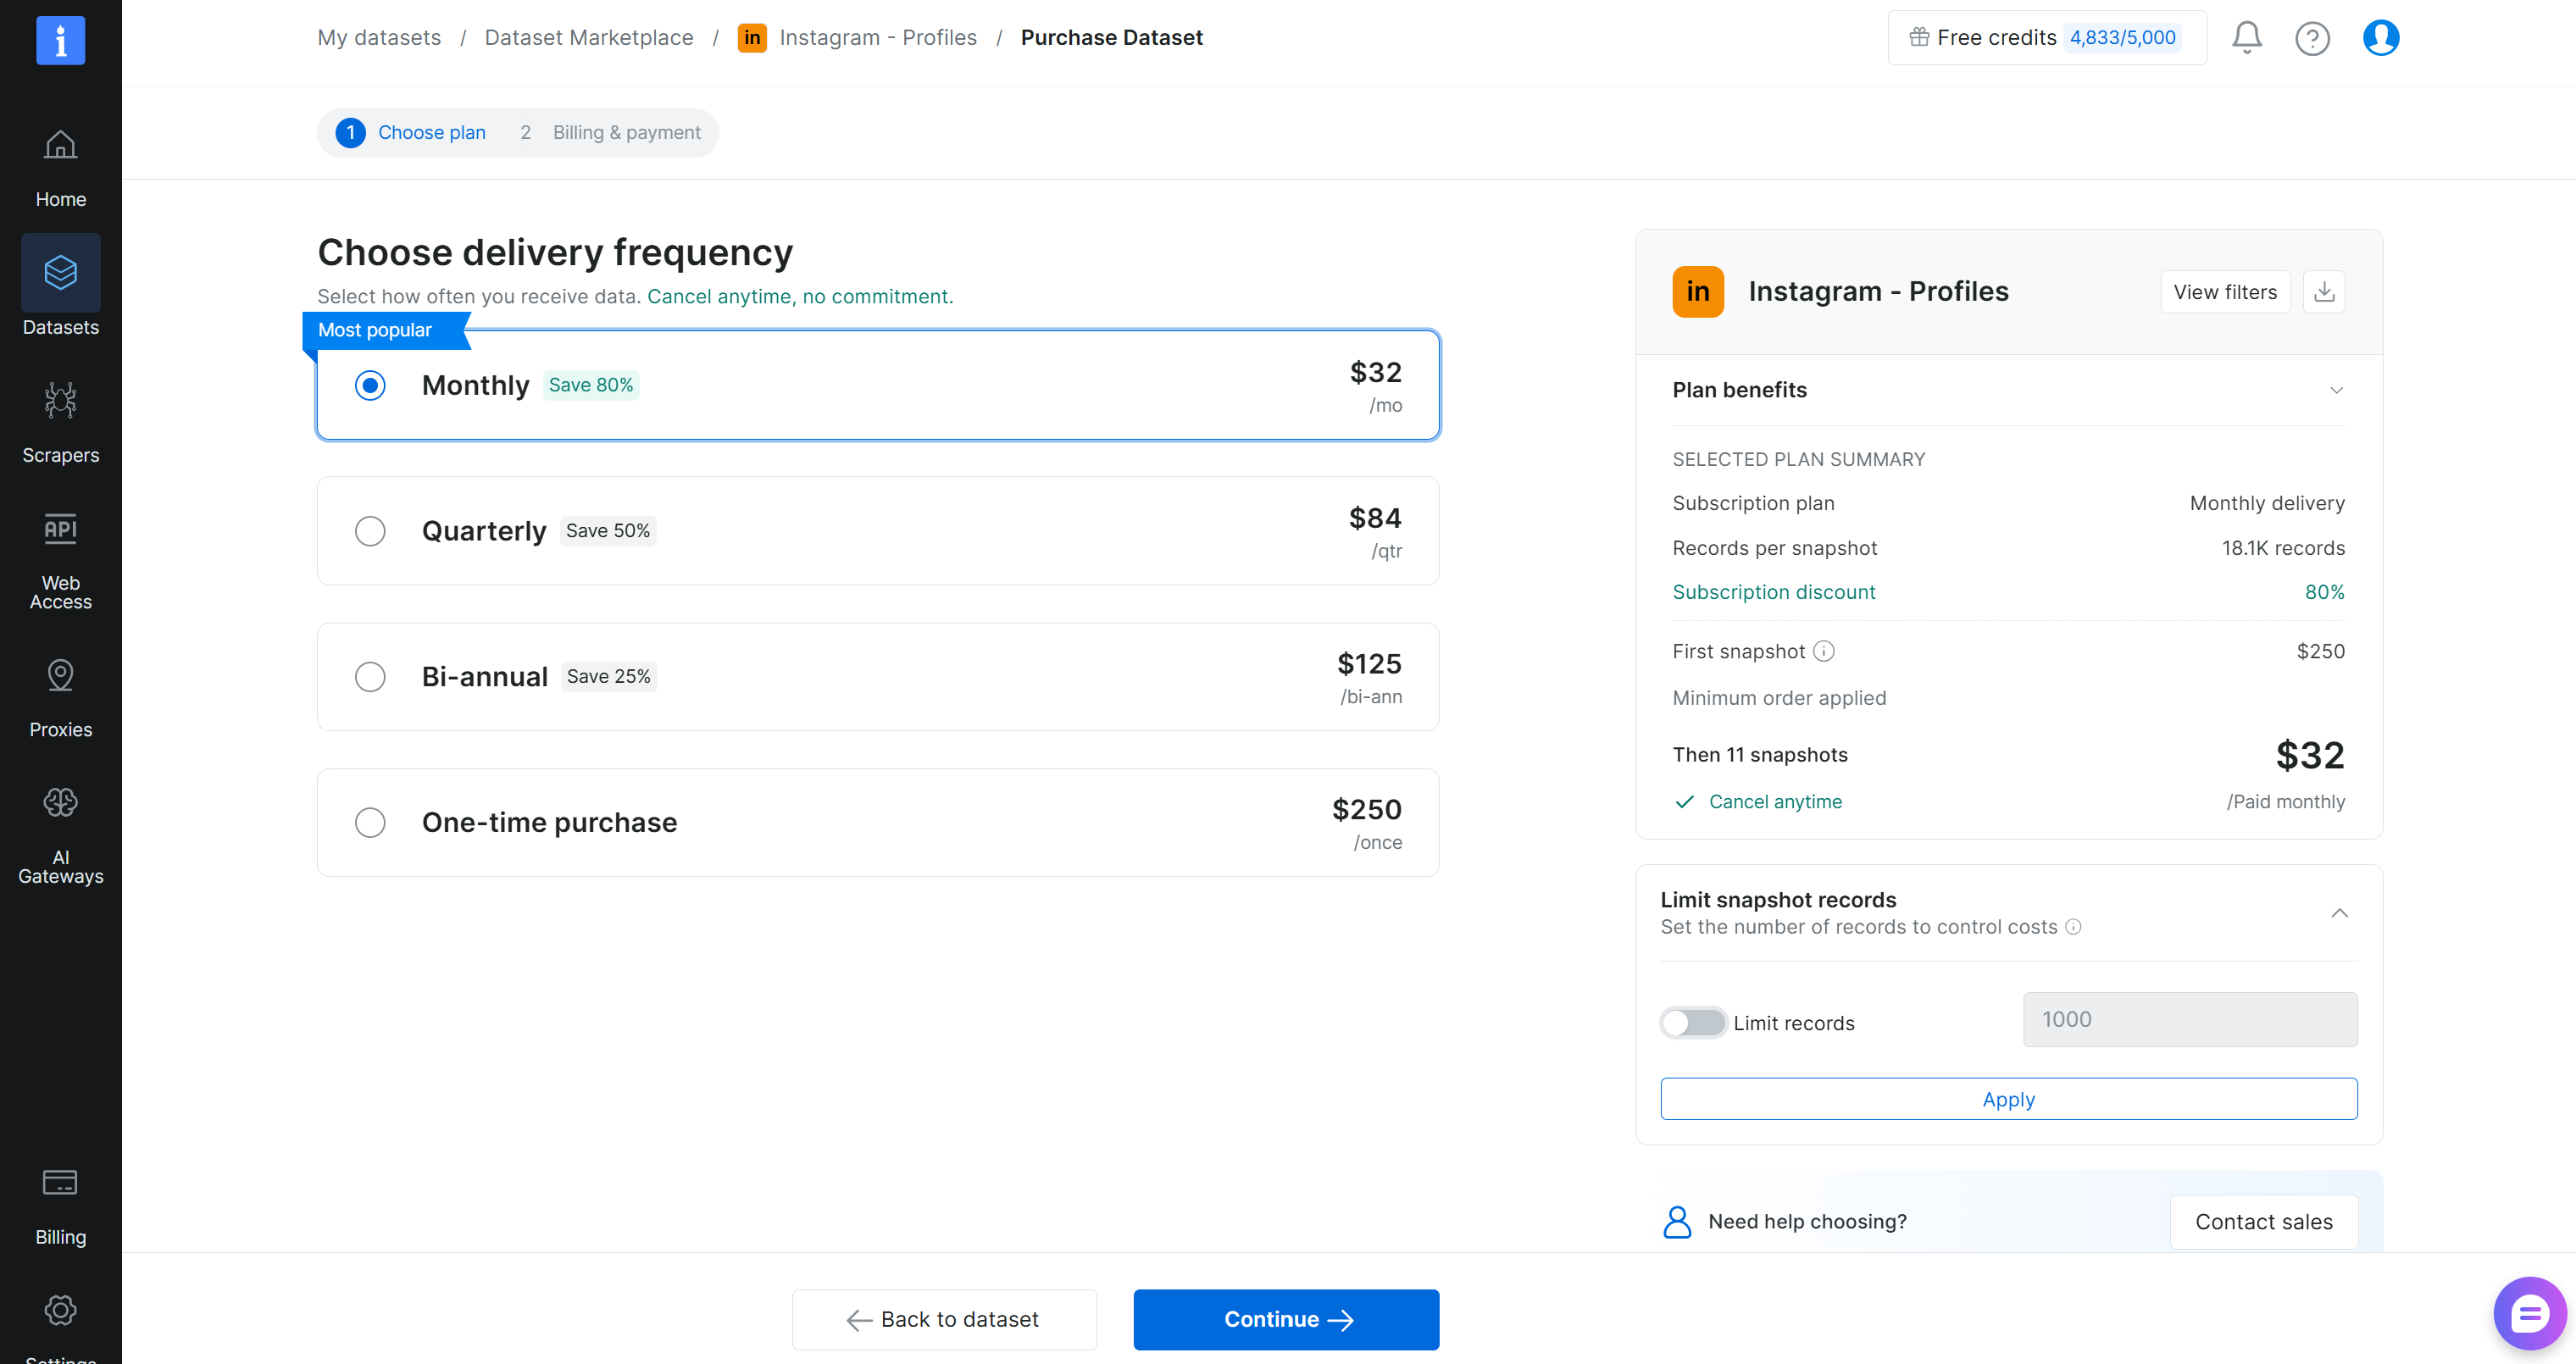
Schließen Sie den Zahlungsvorgang ab und warten Sie, bis der Datensatz vorbereitet ist. Sobald der Datensatz-Snapshot bereit ist, erhalten Sie eine E-Mail mit einem Link dazu:
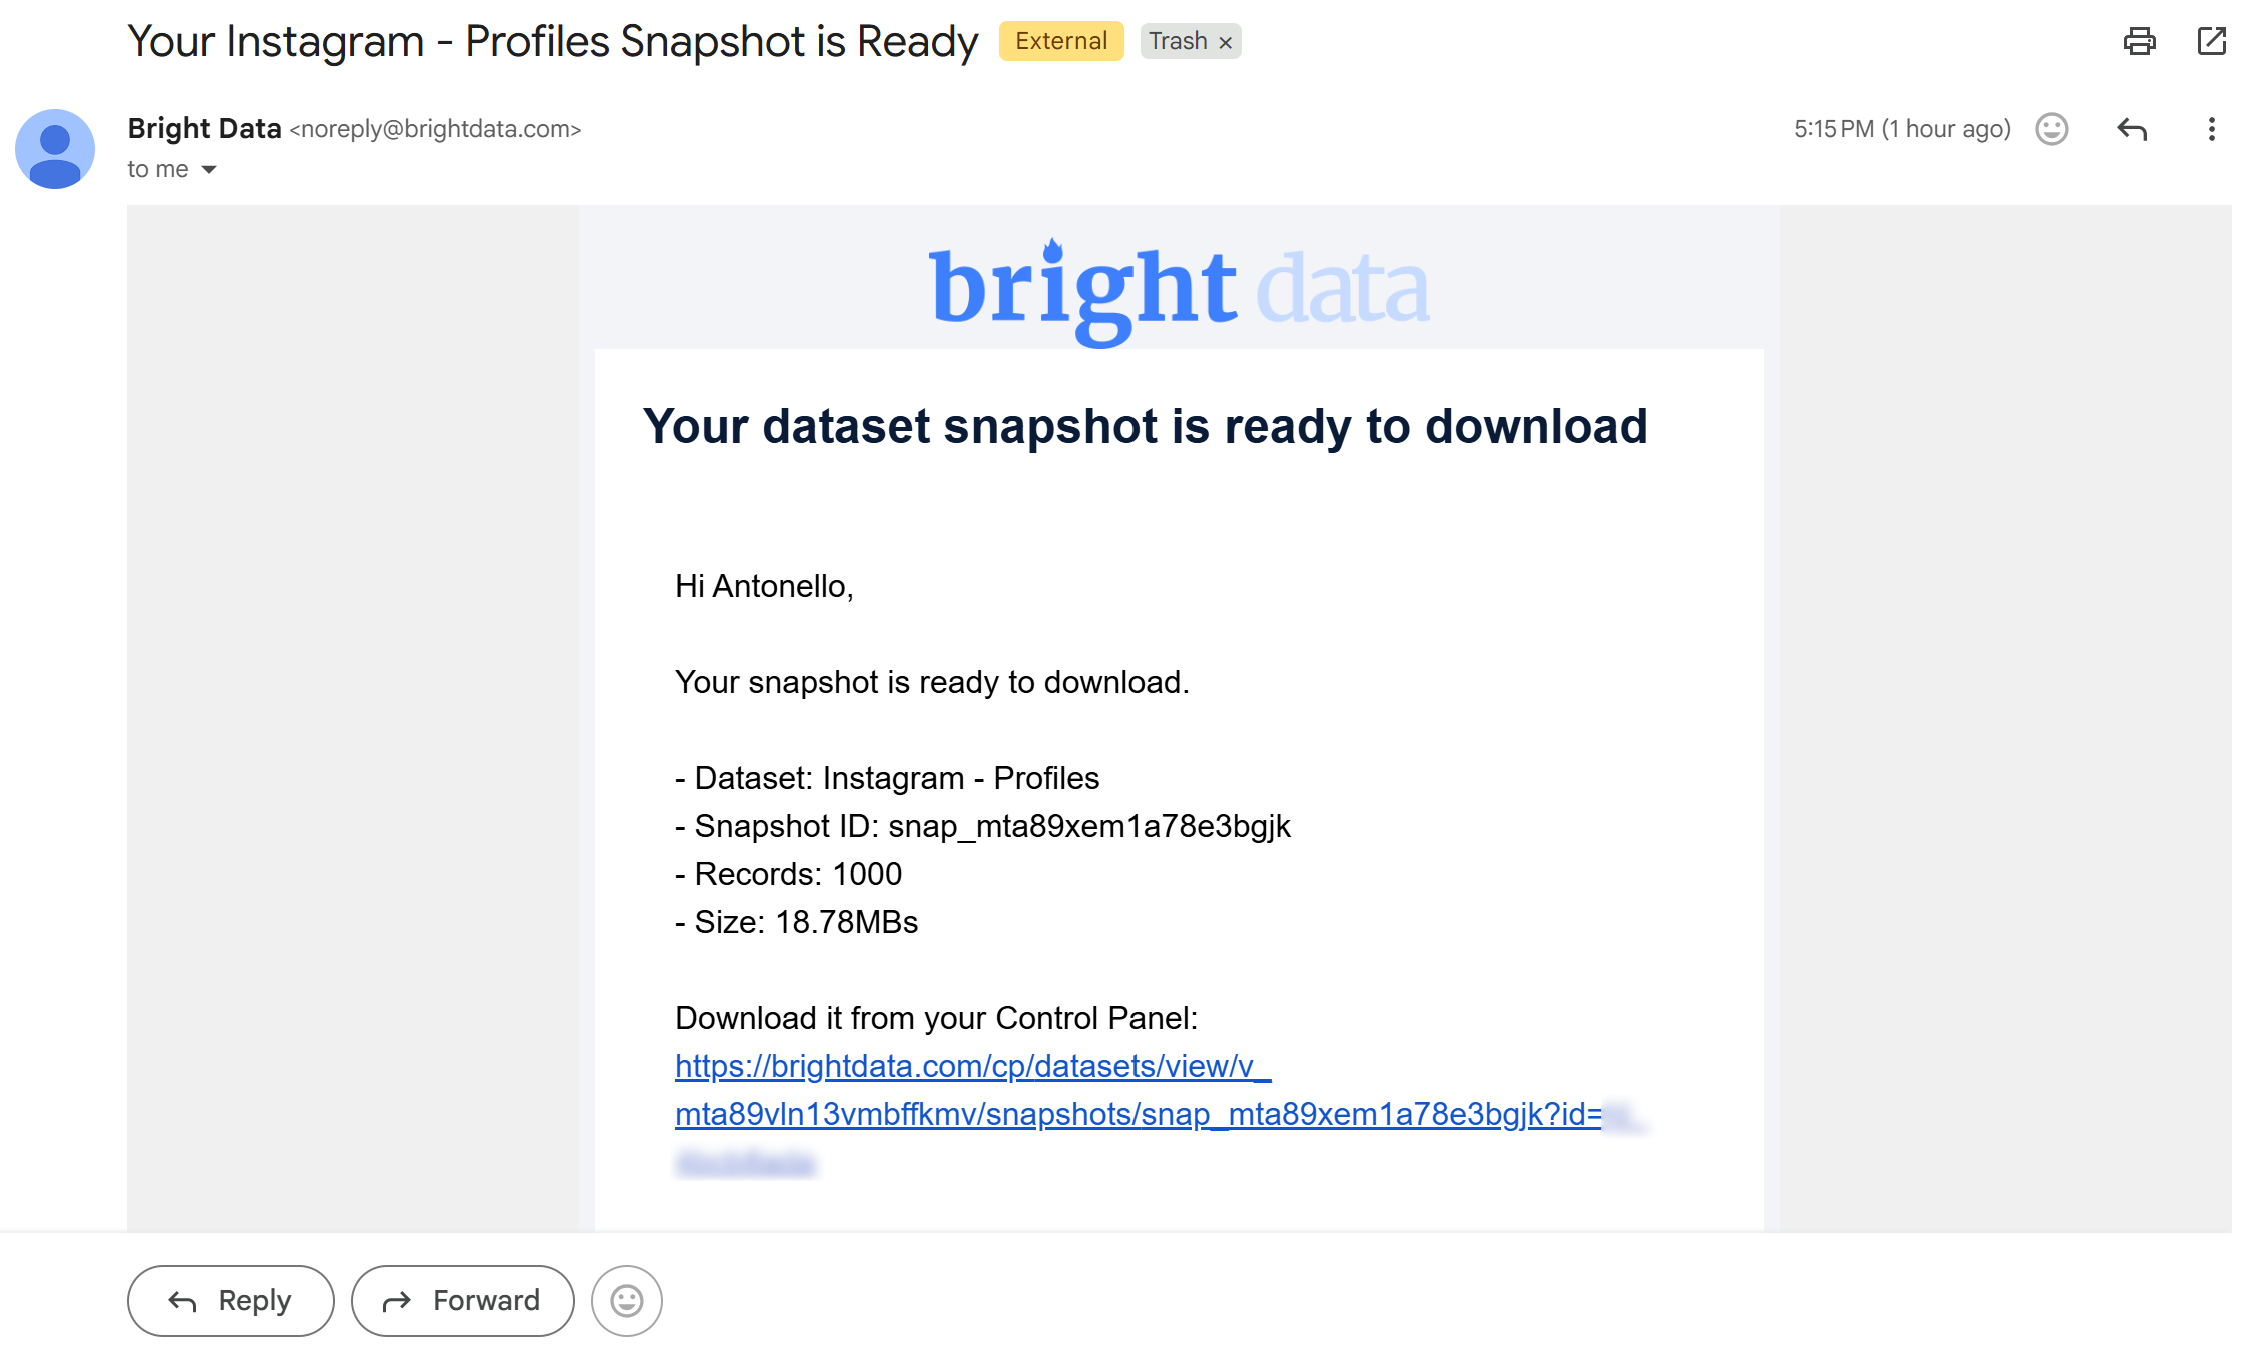
Klicken Sie auf die URL in der E-Mail, um die Snapshot-Seite zu öffnen:
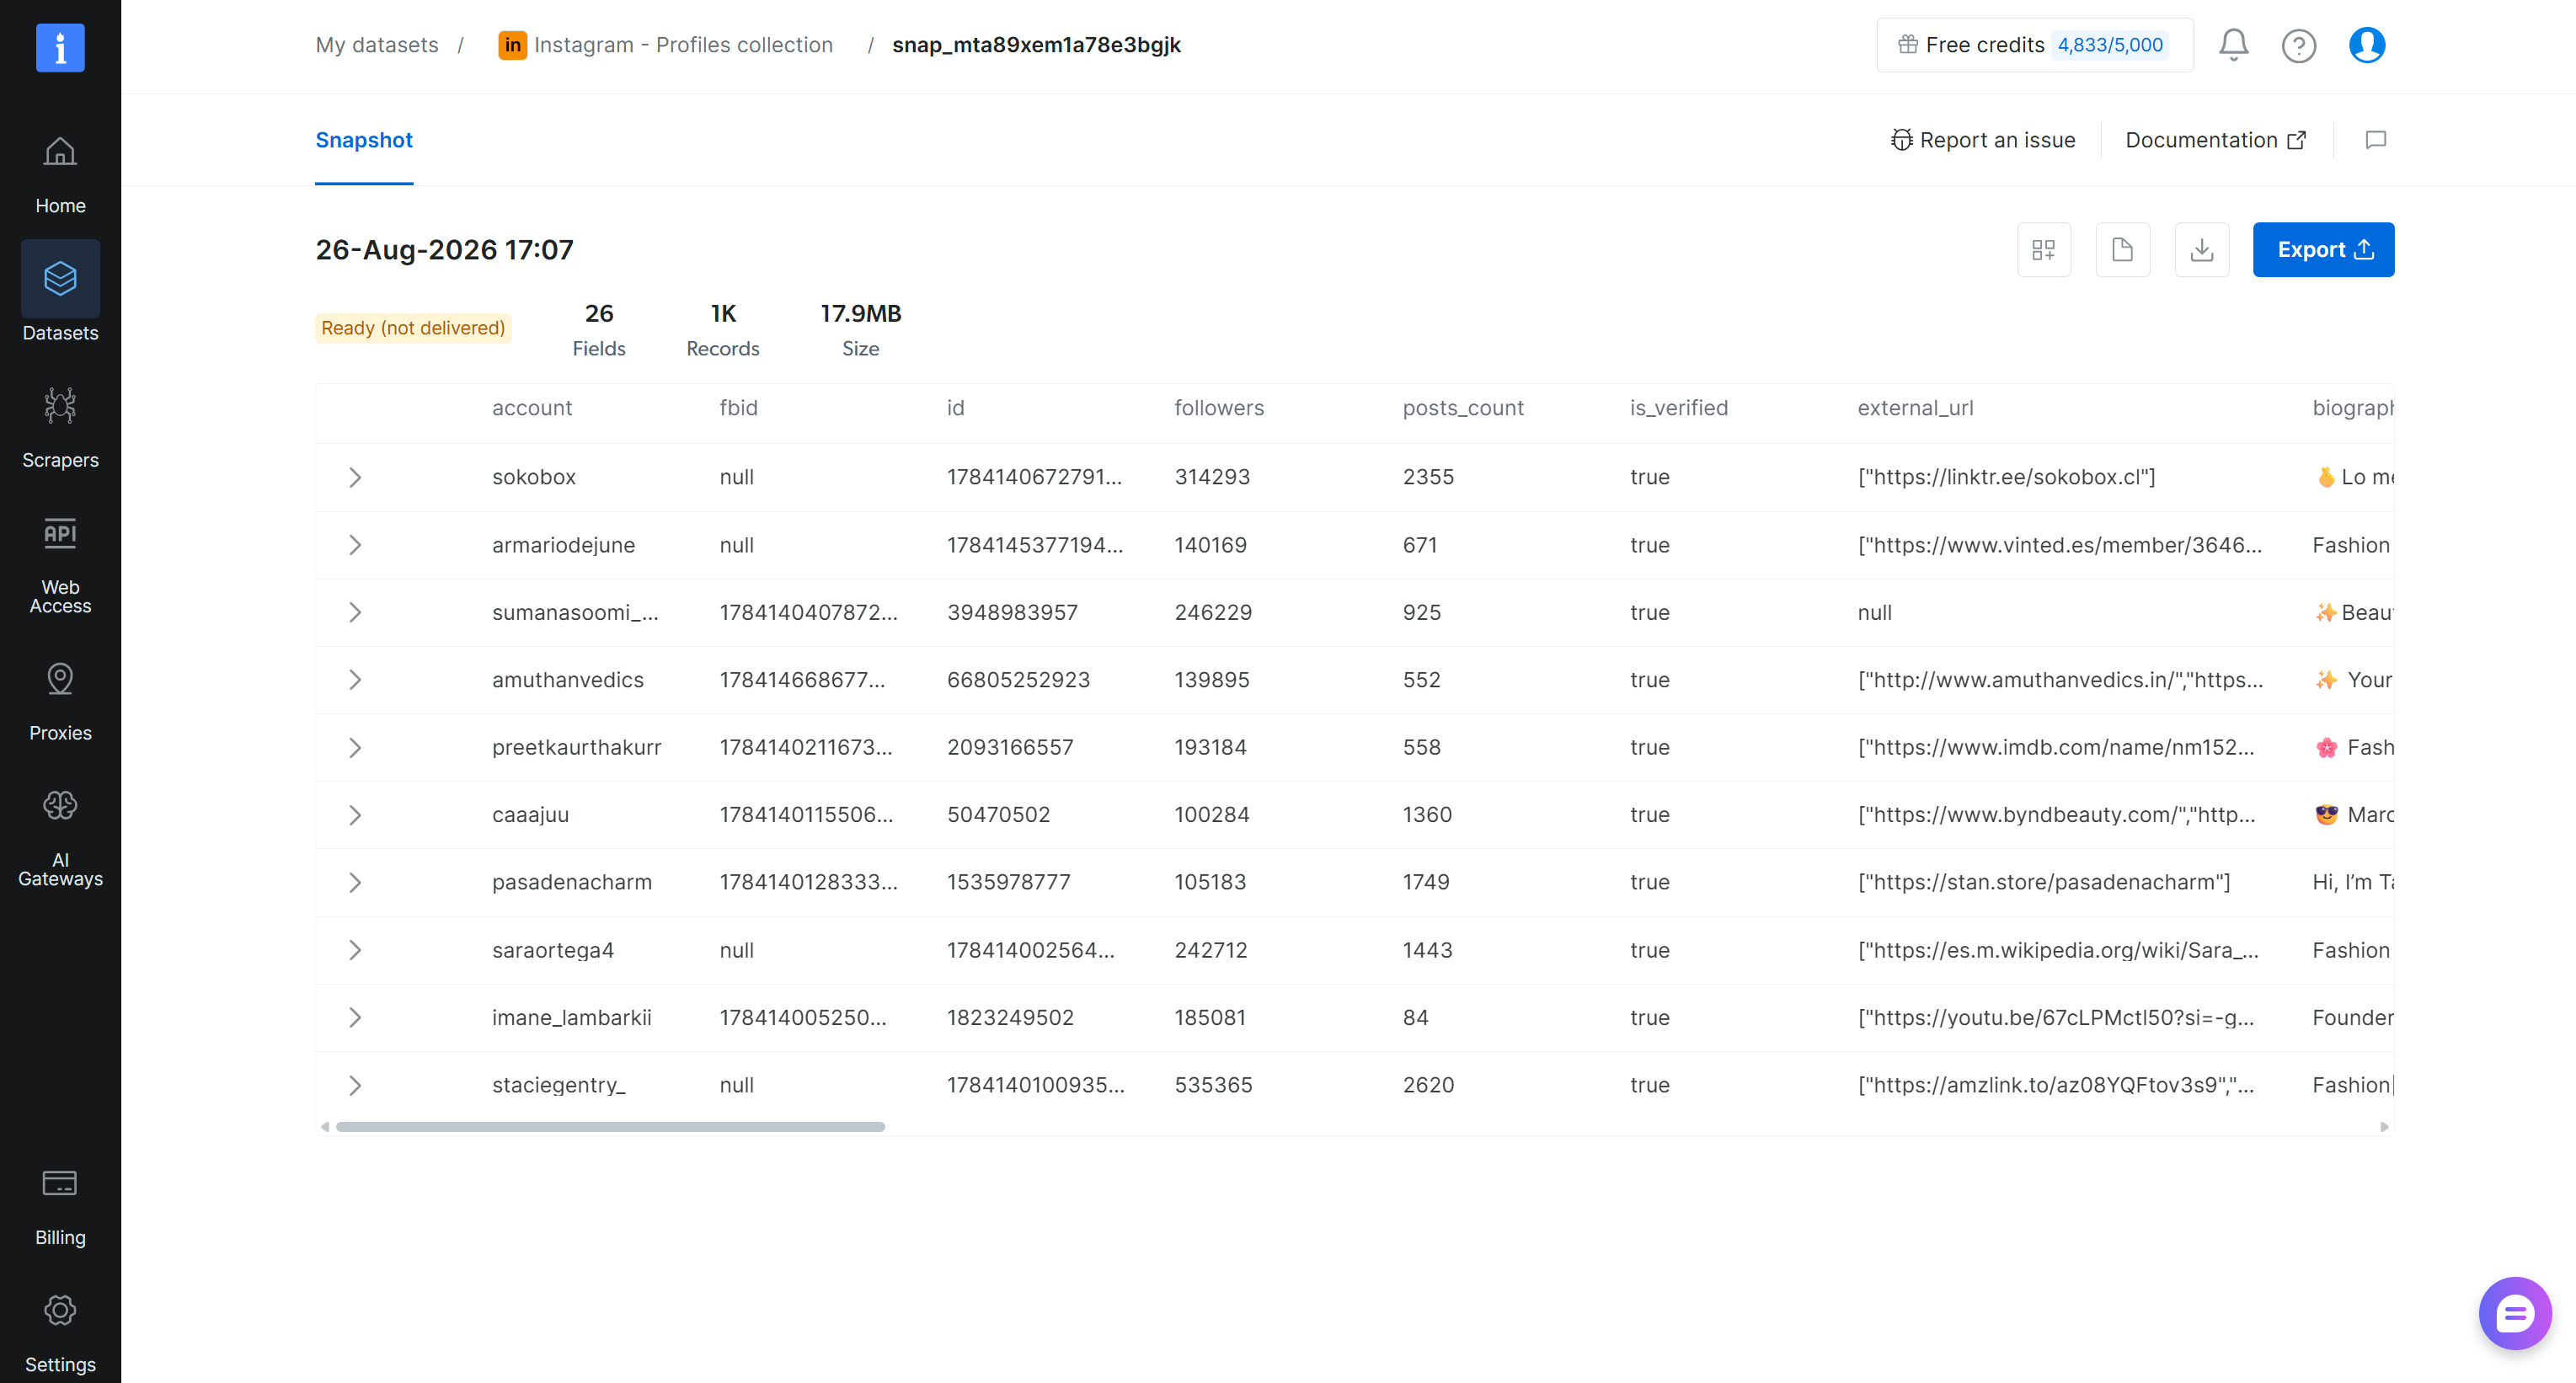
Hier können Sie einen Teil der Daten vorschauen und einen Bericht mit Details wie Kosten und Anzahl der Datensätze einsehen. Am wichtigsten ist, dass Sie den Datensatz herunterladen oder direkt nach Snowflake sowie an andere unterstützte Ziele exportieren können.
Hinweis: In diesem Beispiel haben wir die Anzahl der gekauften Datensätze der Einfachheit halber auf 1K begrenzt. Deshalb ist die Anzahl der Datensätze auf 1K statt 11,2K gesetzt.
Schritt #3: Die Bright Data Web-Daten an Snowflake senden
Um den gefilterten Datensatz an Snowflake zu senden, beginnen Sie damit, auf der Snapshot-Seite des Datensatzes auf die Schaltfläche “Export” zu klicken:
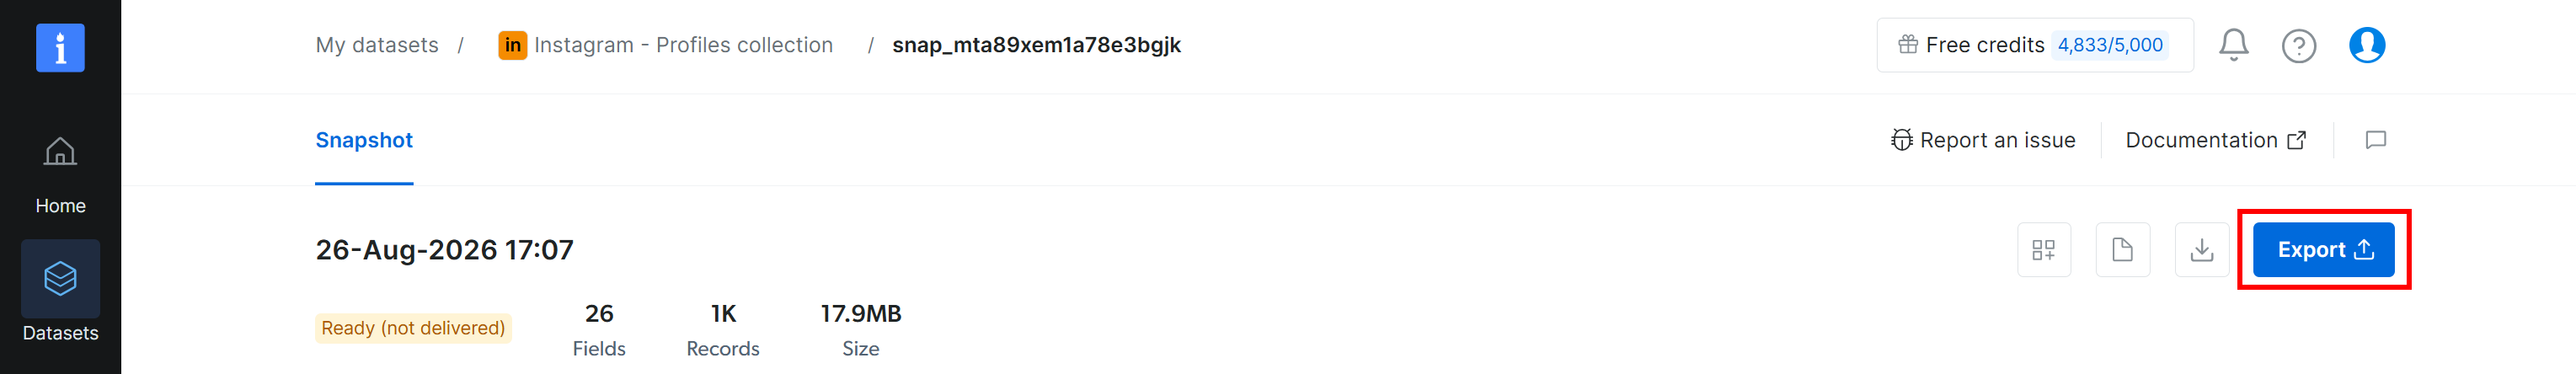
Wählen Sie “Snowflake” aus und füllen Sie die erforderlichen Felder aus, um die Datenlieferung zu konfigurieren:
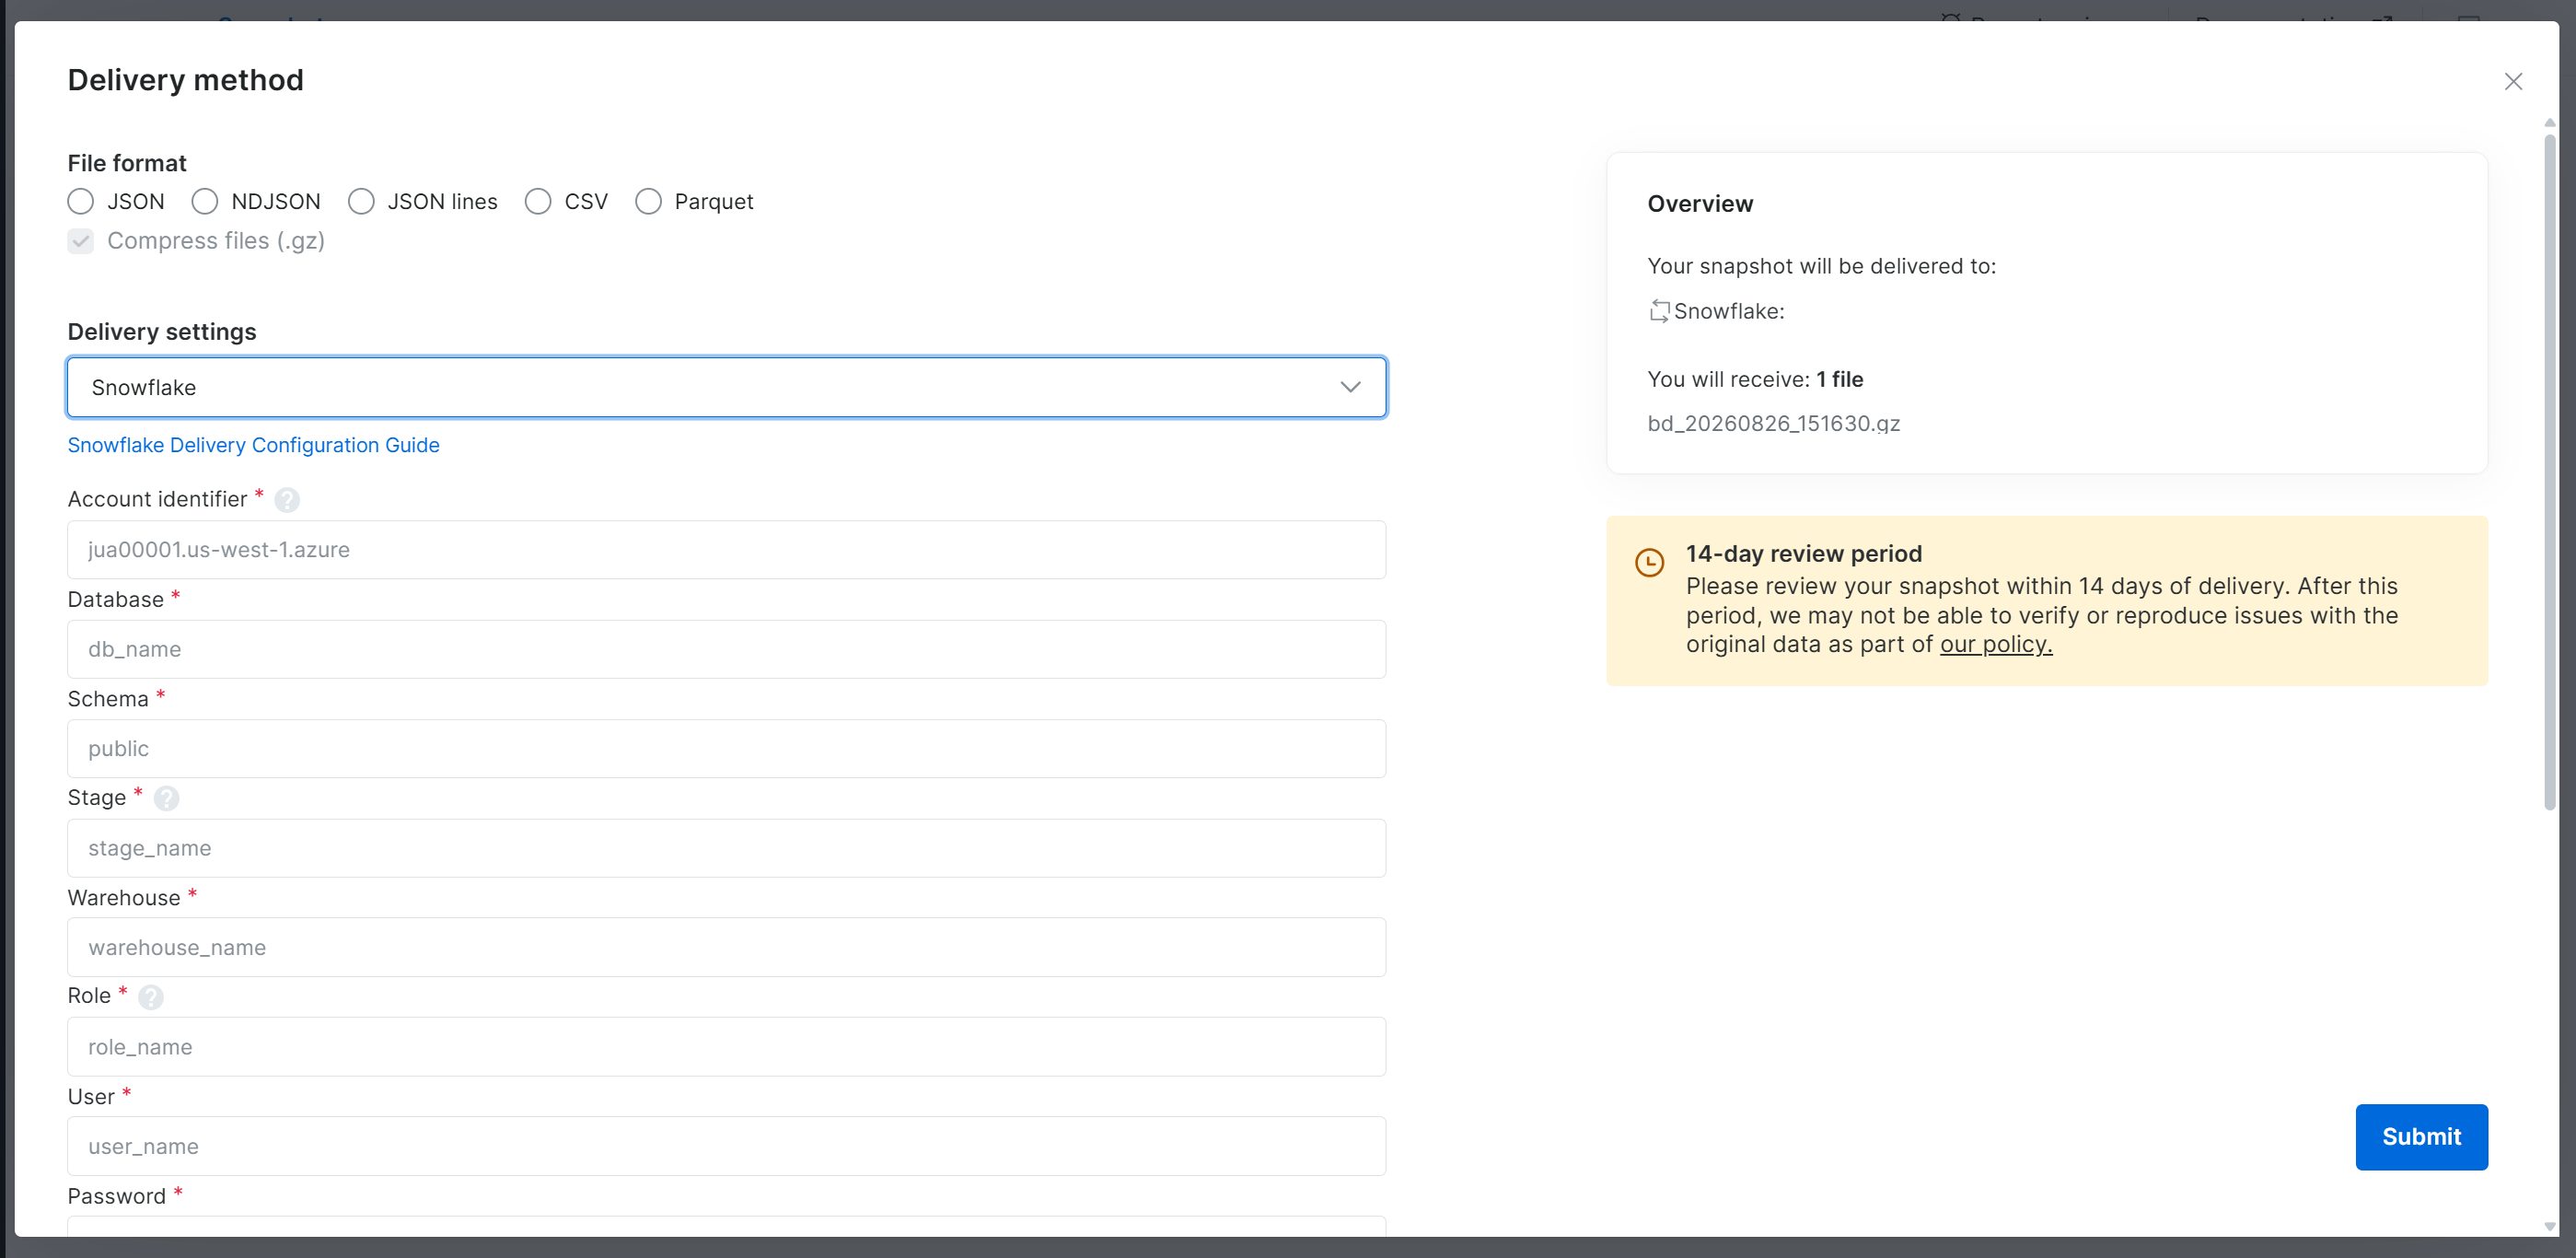
Wenn Sie mit diesen Einstellungen nicht vertraut sind, lesen Sie unseren vollständigen Leitfaden zum Erfassen von Bright Data-Datensätzen in Snowflake. Dort finden Sie alle Anweisungen zur Konfiguration von Snowflake für die Bright Data-Datensatzlieferung sowie Anleitungen zum Ausfüllen der erforderlichen Felder.
Nehmen wir für dieses Beispiel an, dass Sie die Lieferung so konfiguriert haben, dass die Daten in die Tabelle SNOWFLAKE_INTELLIGENCE.PUBLIC.INSTAGRAM_PROFILES importiert werden. Sobald die Erfassung abgeschlossen ist, können Sie die importierten Daten direkt in Snowflake erkunden:
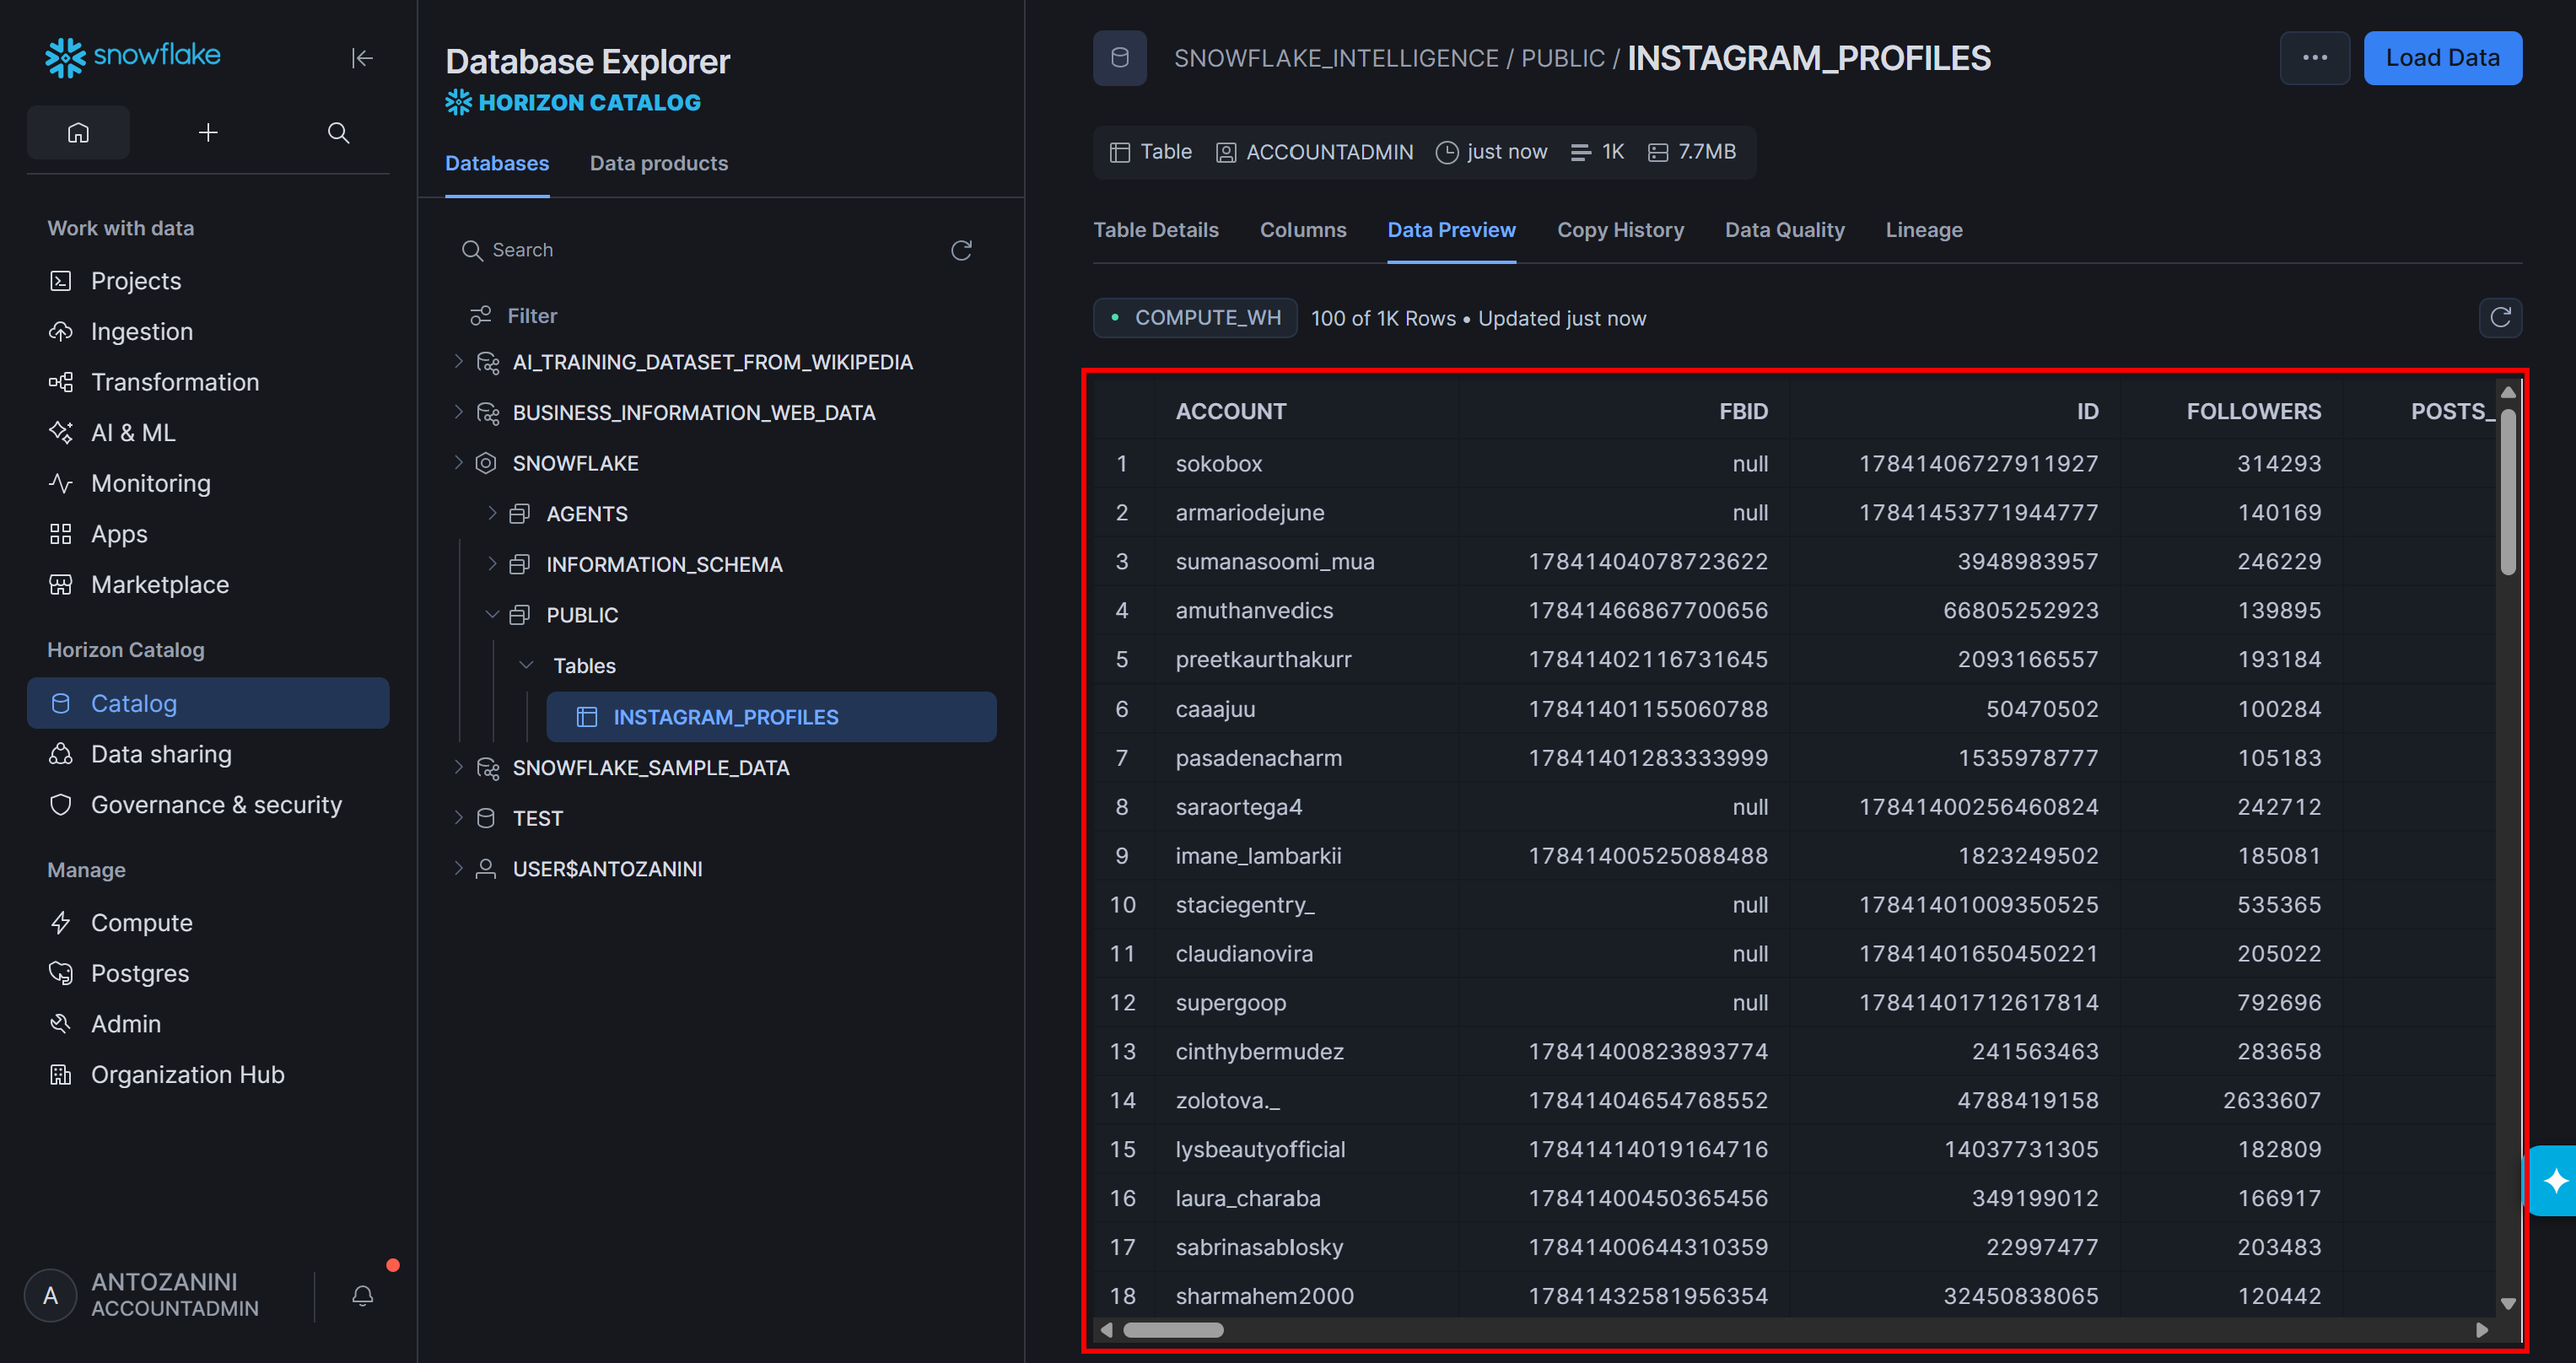
Beachten Sie, dass die Tabelle dieselben gefilterten Instagram-Profildaten enthält, die Sie aus dem Bright Data-Datensatz ausgewählt haben. Die Daten sind nun zusammen mit Ihren Geschäftsdaten in Snowflake verfügbar, sodass ein Cortex AI-Agent beide Quellen gemeinsam analysieren kann.
Schritt #4: Einen Cortex Agent erstellen
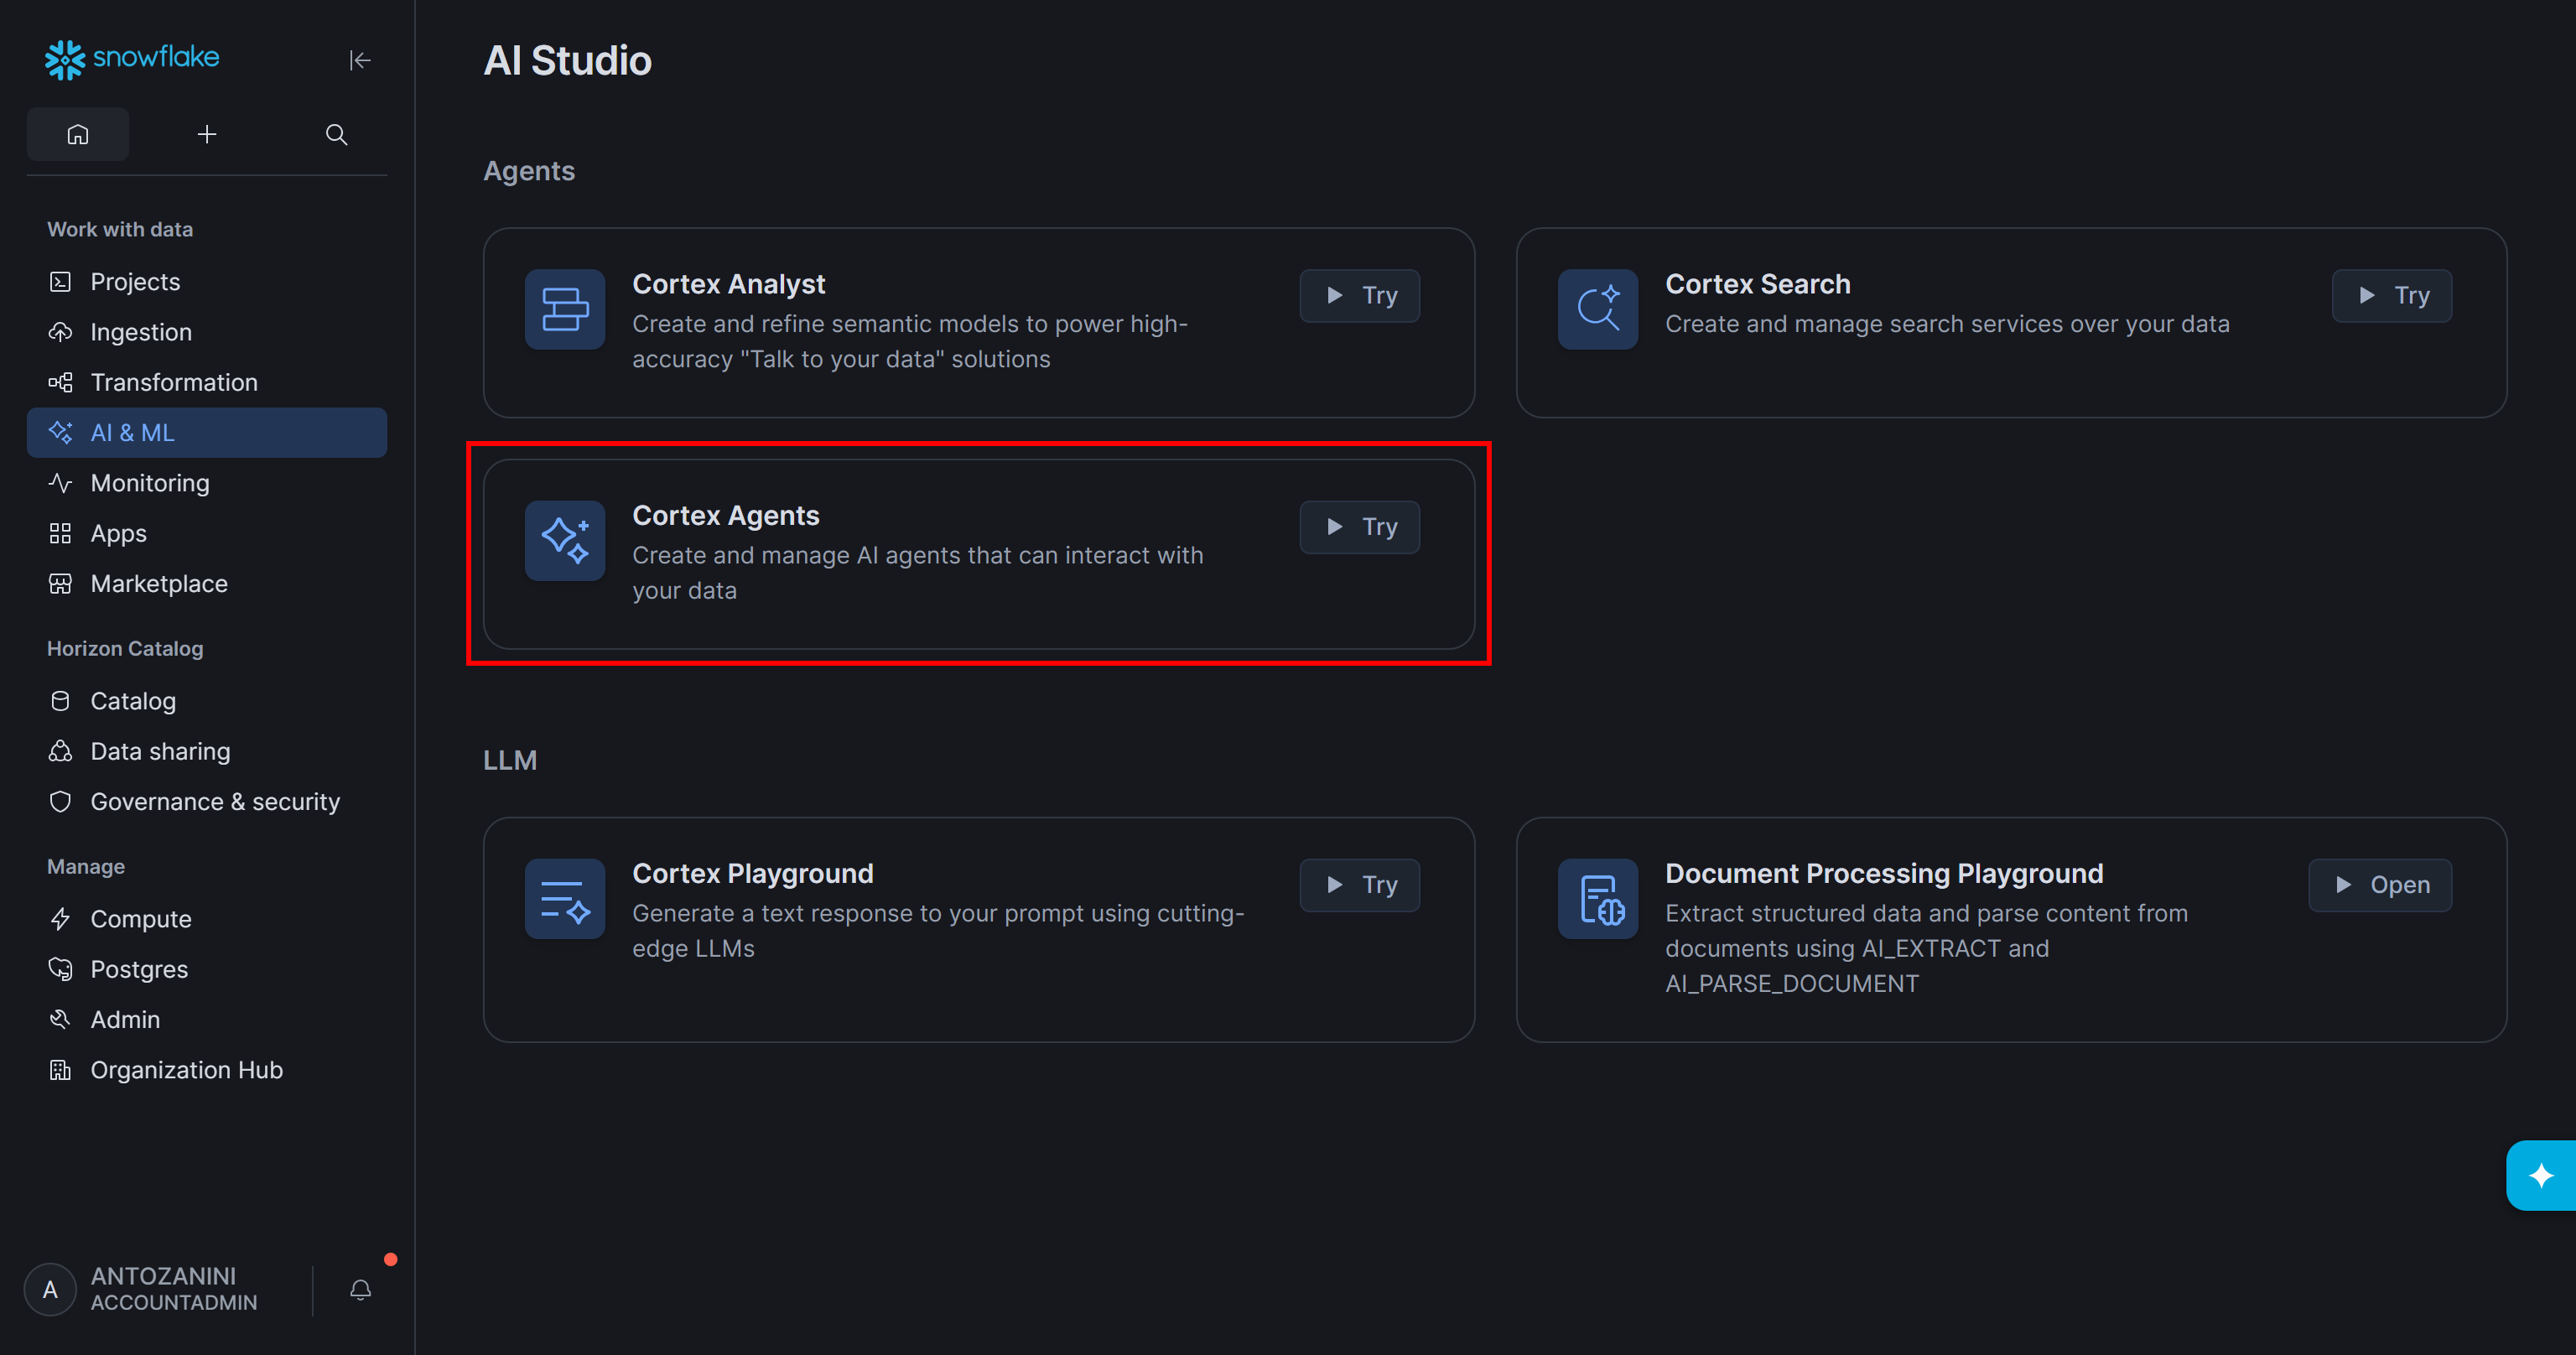
Um einen neuen Cortex Agent zu Ihrem Snowflake-Warehouse hinzuzufügen, gehen Sie zur Seite “AI & ML” und wählen Sie die Karte “Cortex Agents” aus:
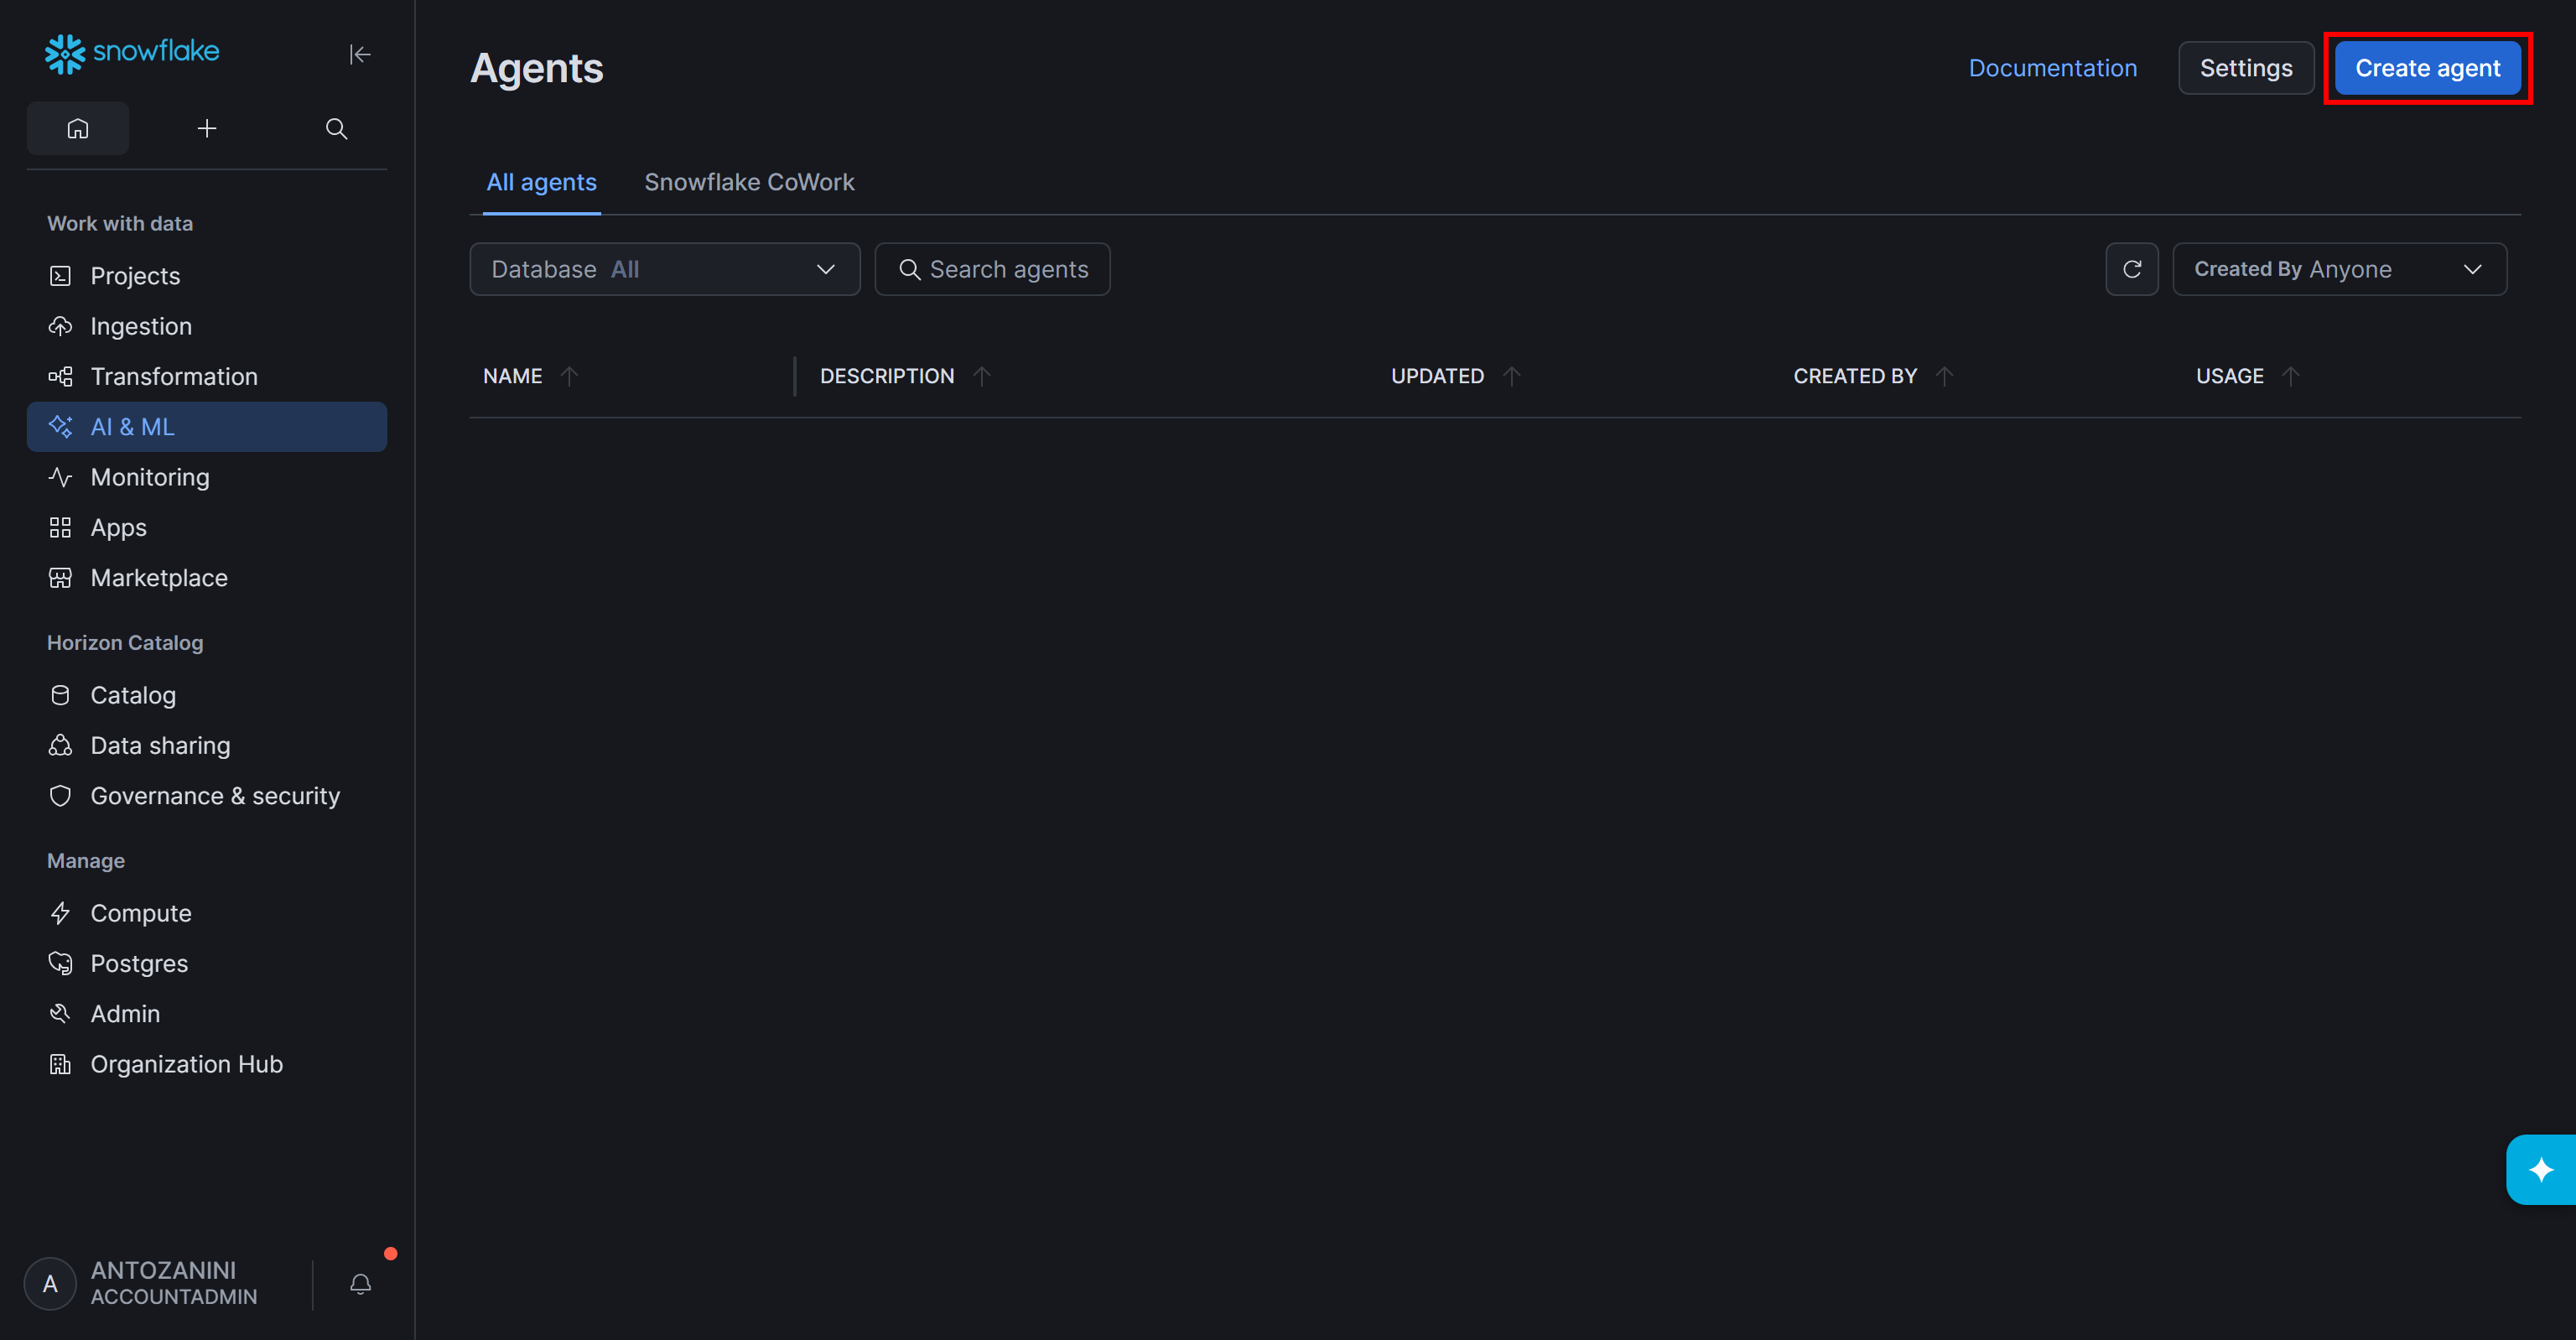
Klicken Sie auf der Seite “Agents” auf “Create agent”:
Wählen Sie die Datenbank und das Schema aus, die Ihren importierten Bright Data-Datensatz enthalten (zusammen mit anderen wertvollen Geschäftsdaten). Geben Sie dann Ihrem Agenten einen Namen (z. B. “Influencer_Analyzer”):
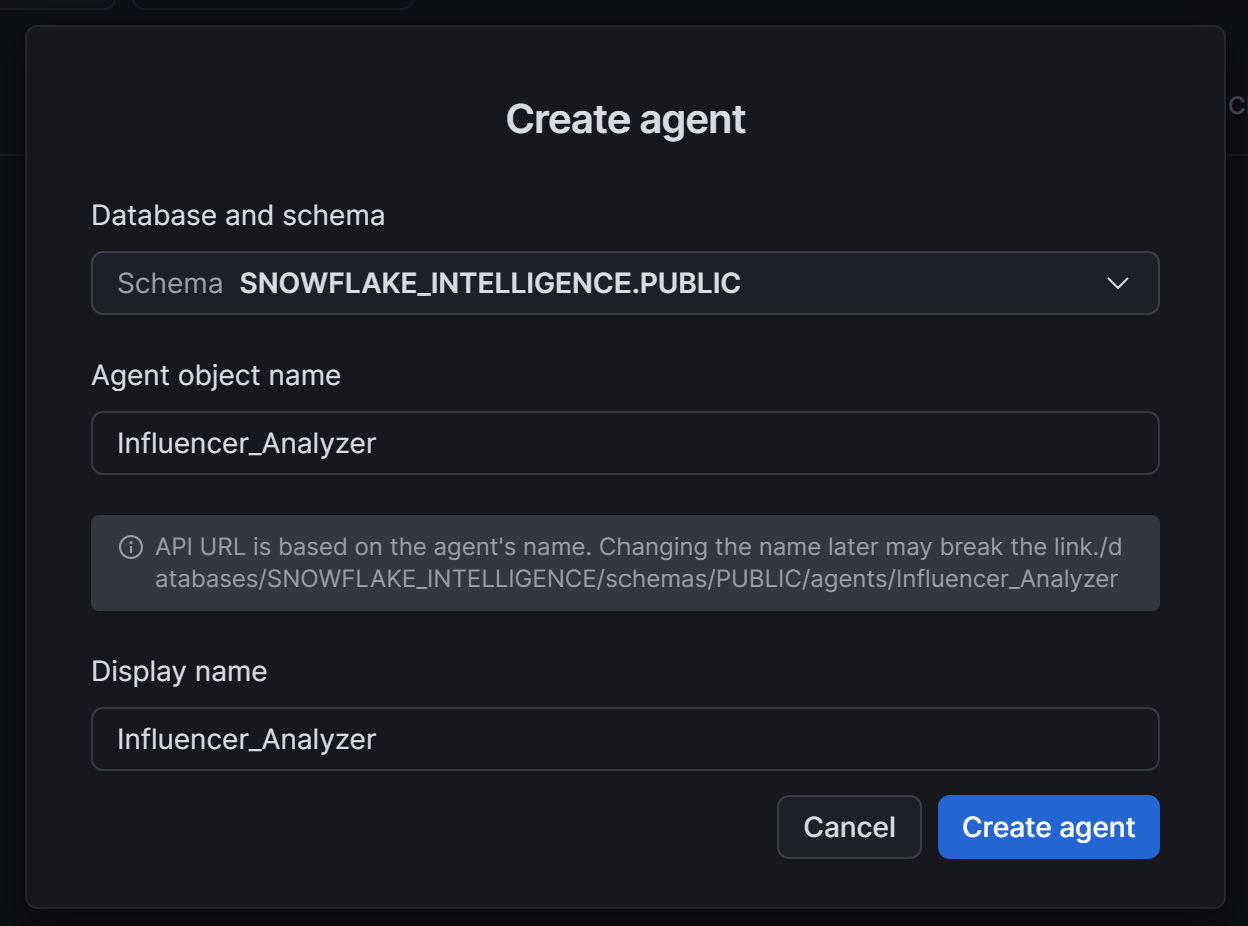
Klicken Sie schließlich auf die Schaltfläche “Create agent”, um die Einrichtung Ihres Cortex Agent abzuschließen.
Schritt #5: Die Agentenkonfiguration abschließen
Starten Sie auf der Cortex Agent-Seite die geführte Einrichtung über Snowflake CoCo, indem Sie auf “Connect” klicken:
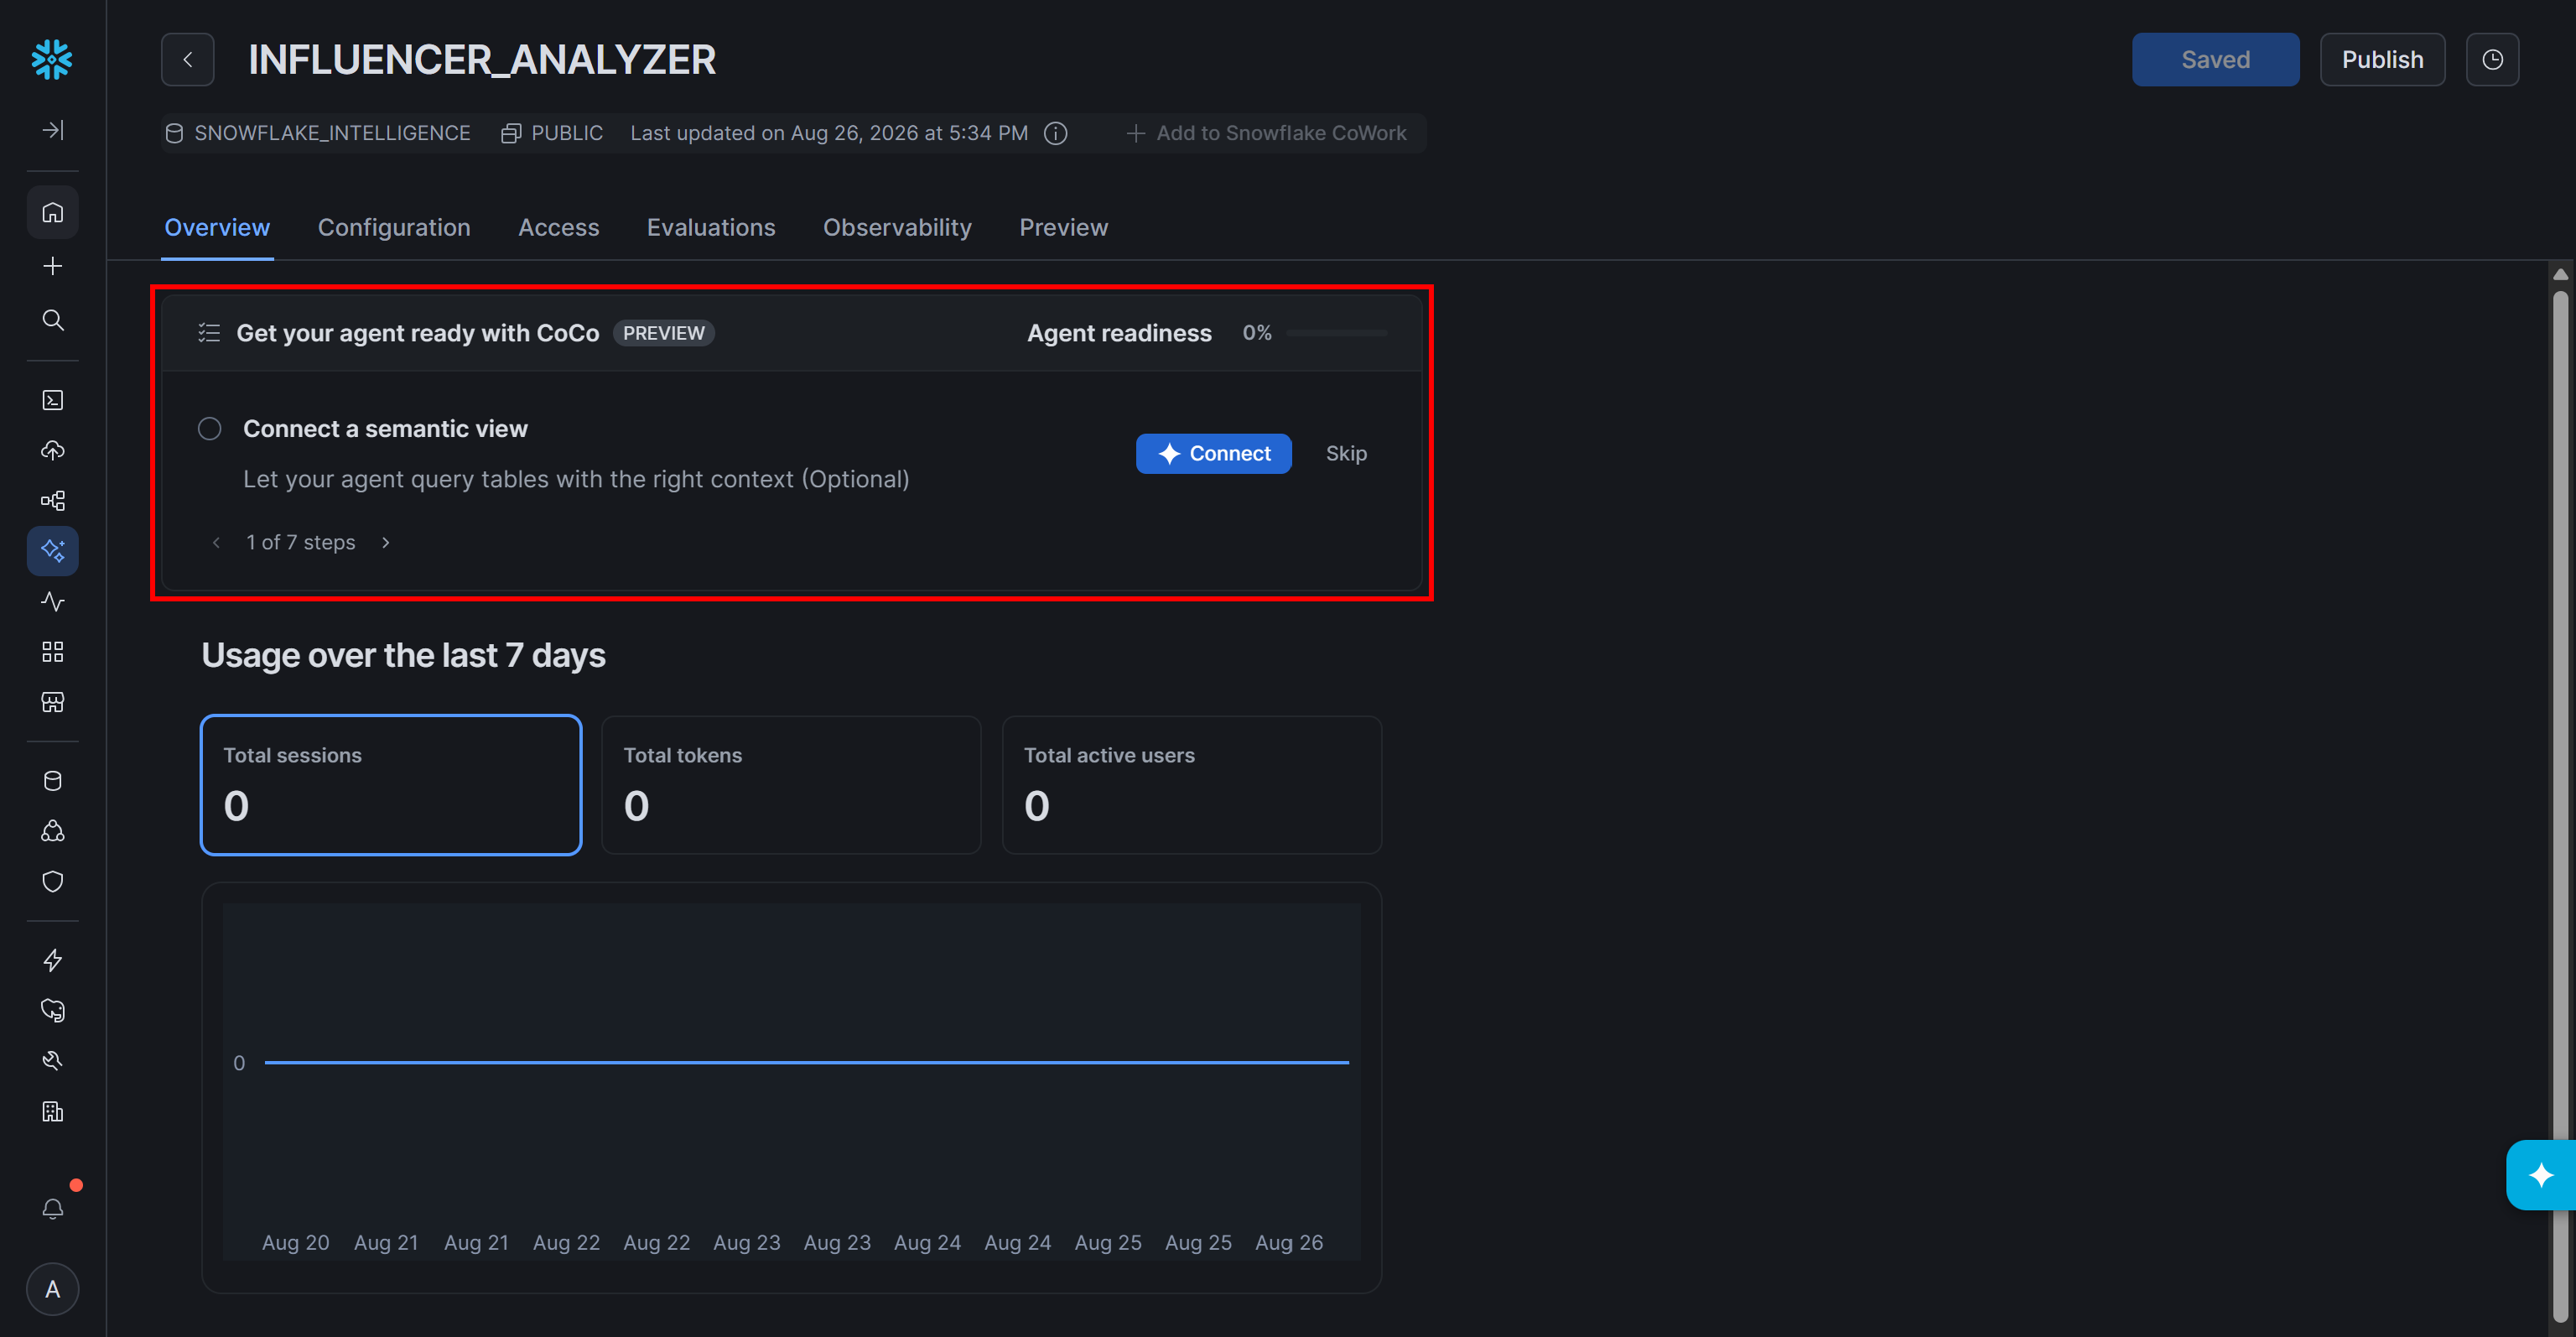
Im CoCo-Chat werden Sie durch den Konfigurationsprozess geführt, einschließlich der Erstellung der semantischen Ansicht des Agenten und der Verbindung eines Suchdienstes:
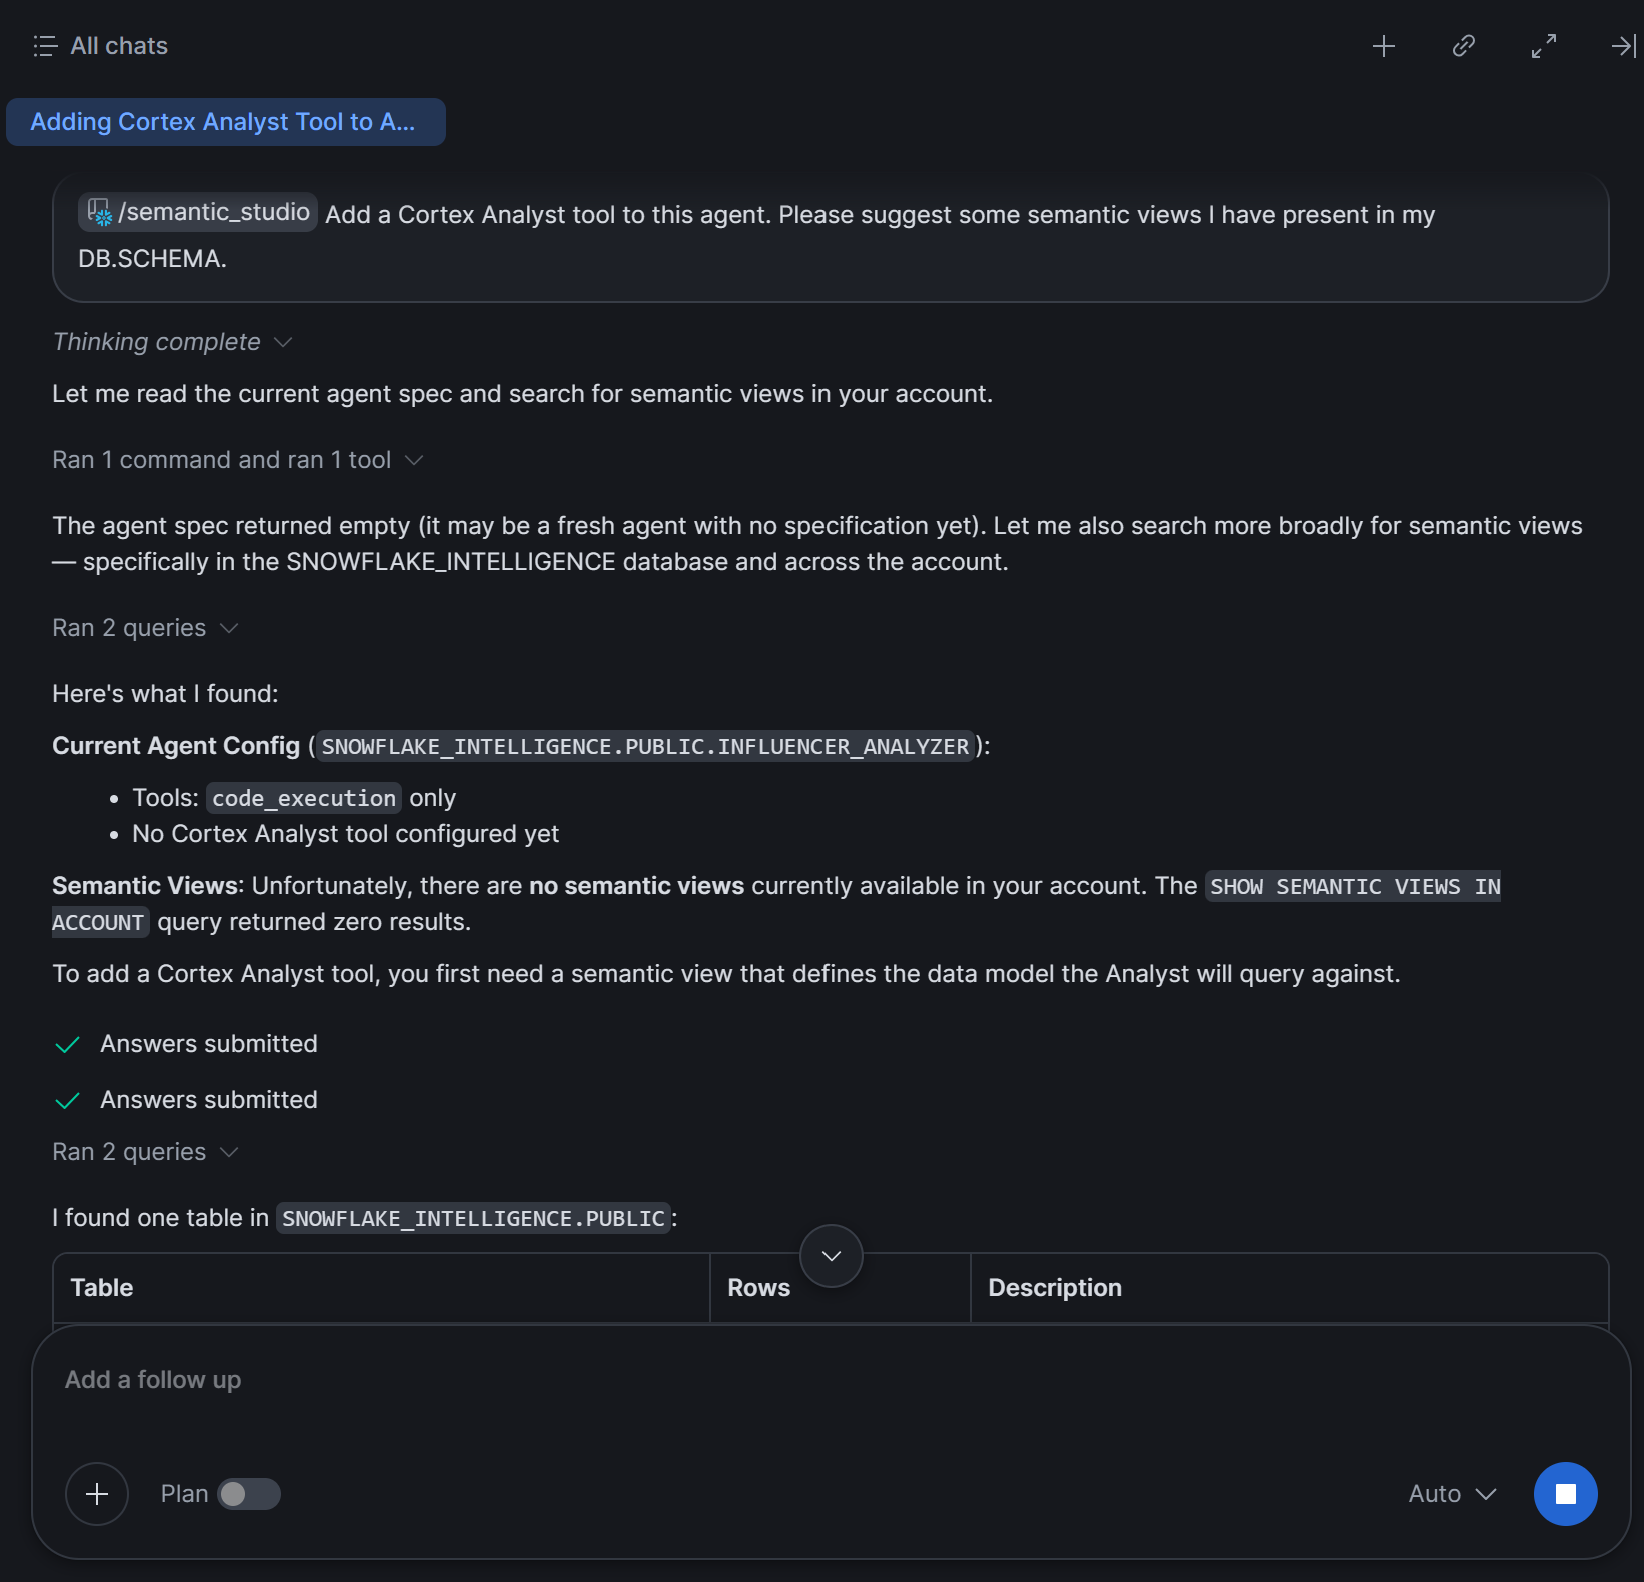
CoCo verbindet auch die erforderlichen Snowflake Cortex-Komponenten, zu denen gehören:
| Komponente | Was sie macht |
|---|---|
| Cortex Analyst | Wandelt natürlichsprachliche Fragen in SQL über strukturierte Tabellen um. Es wird von einer semantischen Ansicht (oder einem YAML-semantischen Modell) geleitet, die Metriken, Dimensionen und Beziehungen definiert. |
| Cortex Search | Erstellt Hybrid-Indizes, die Vektor-(semantische) und Stichwortsuche über unstrukturiertem Text kombinieren, sodass der Agent Informationen sowohl nach Bedeutung als auch nach genauen Begriffen abrufen kann. |
| Cortex Sense | Eine Laufzeit-Kontextschicht, die Geschäftsdefinitionen, Metriken und Tabellenbeziehungen aus dem Abfrageverlauf und Metadaten lernt und den Agenten verankert, ohne dass Sie eine semantische Ansicht manuell pflegen müssen. |
| Cortex Agents | Der Orchestrator, der eine Aufgabe plant und jeden Schritt an das passende Tool weiterleitet. |
Öffnen Sie als Nächstes den Tab “Configuration”, um die Beschreibung und Anweisungen des Agenten festzulegen und Tools, Fähigkeiten und MCP-Integrationen hinzuzufügen:
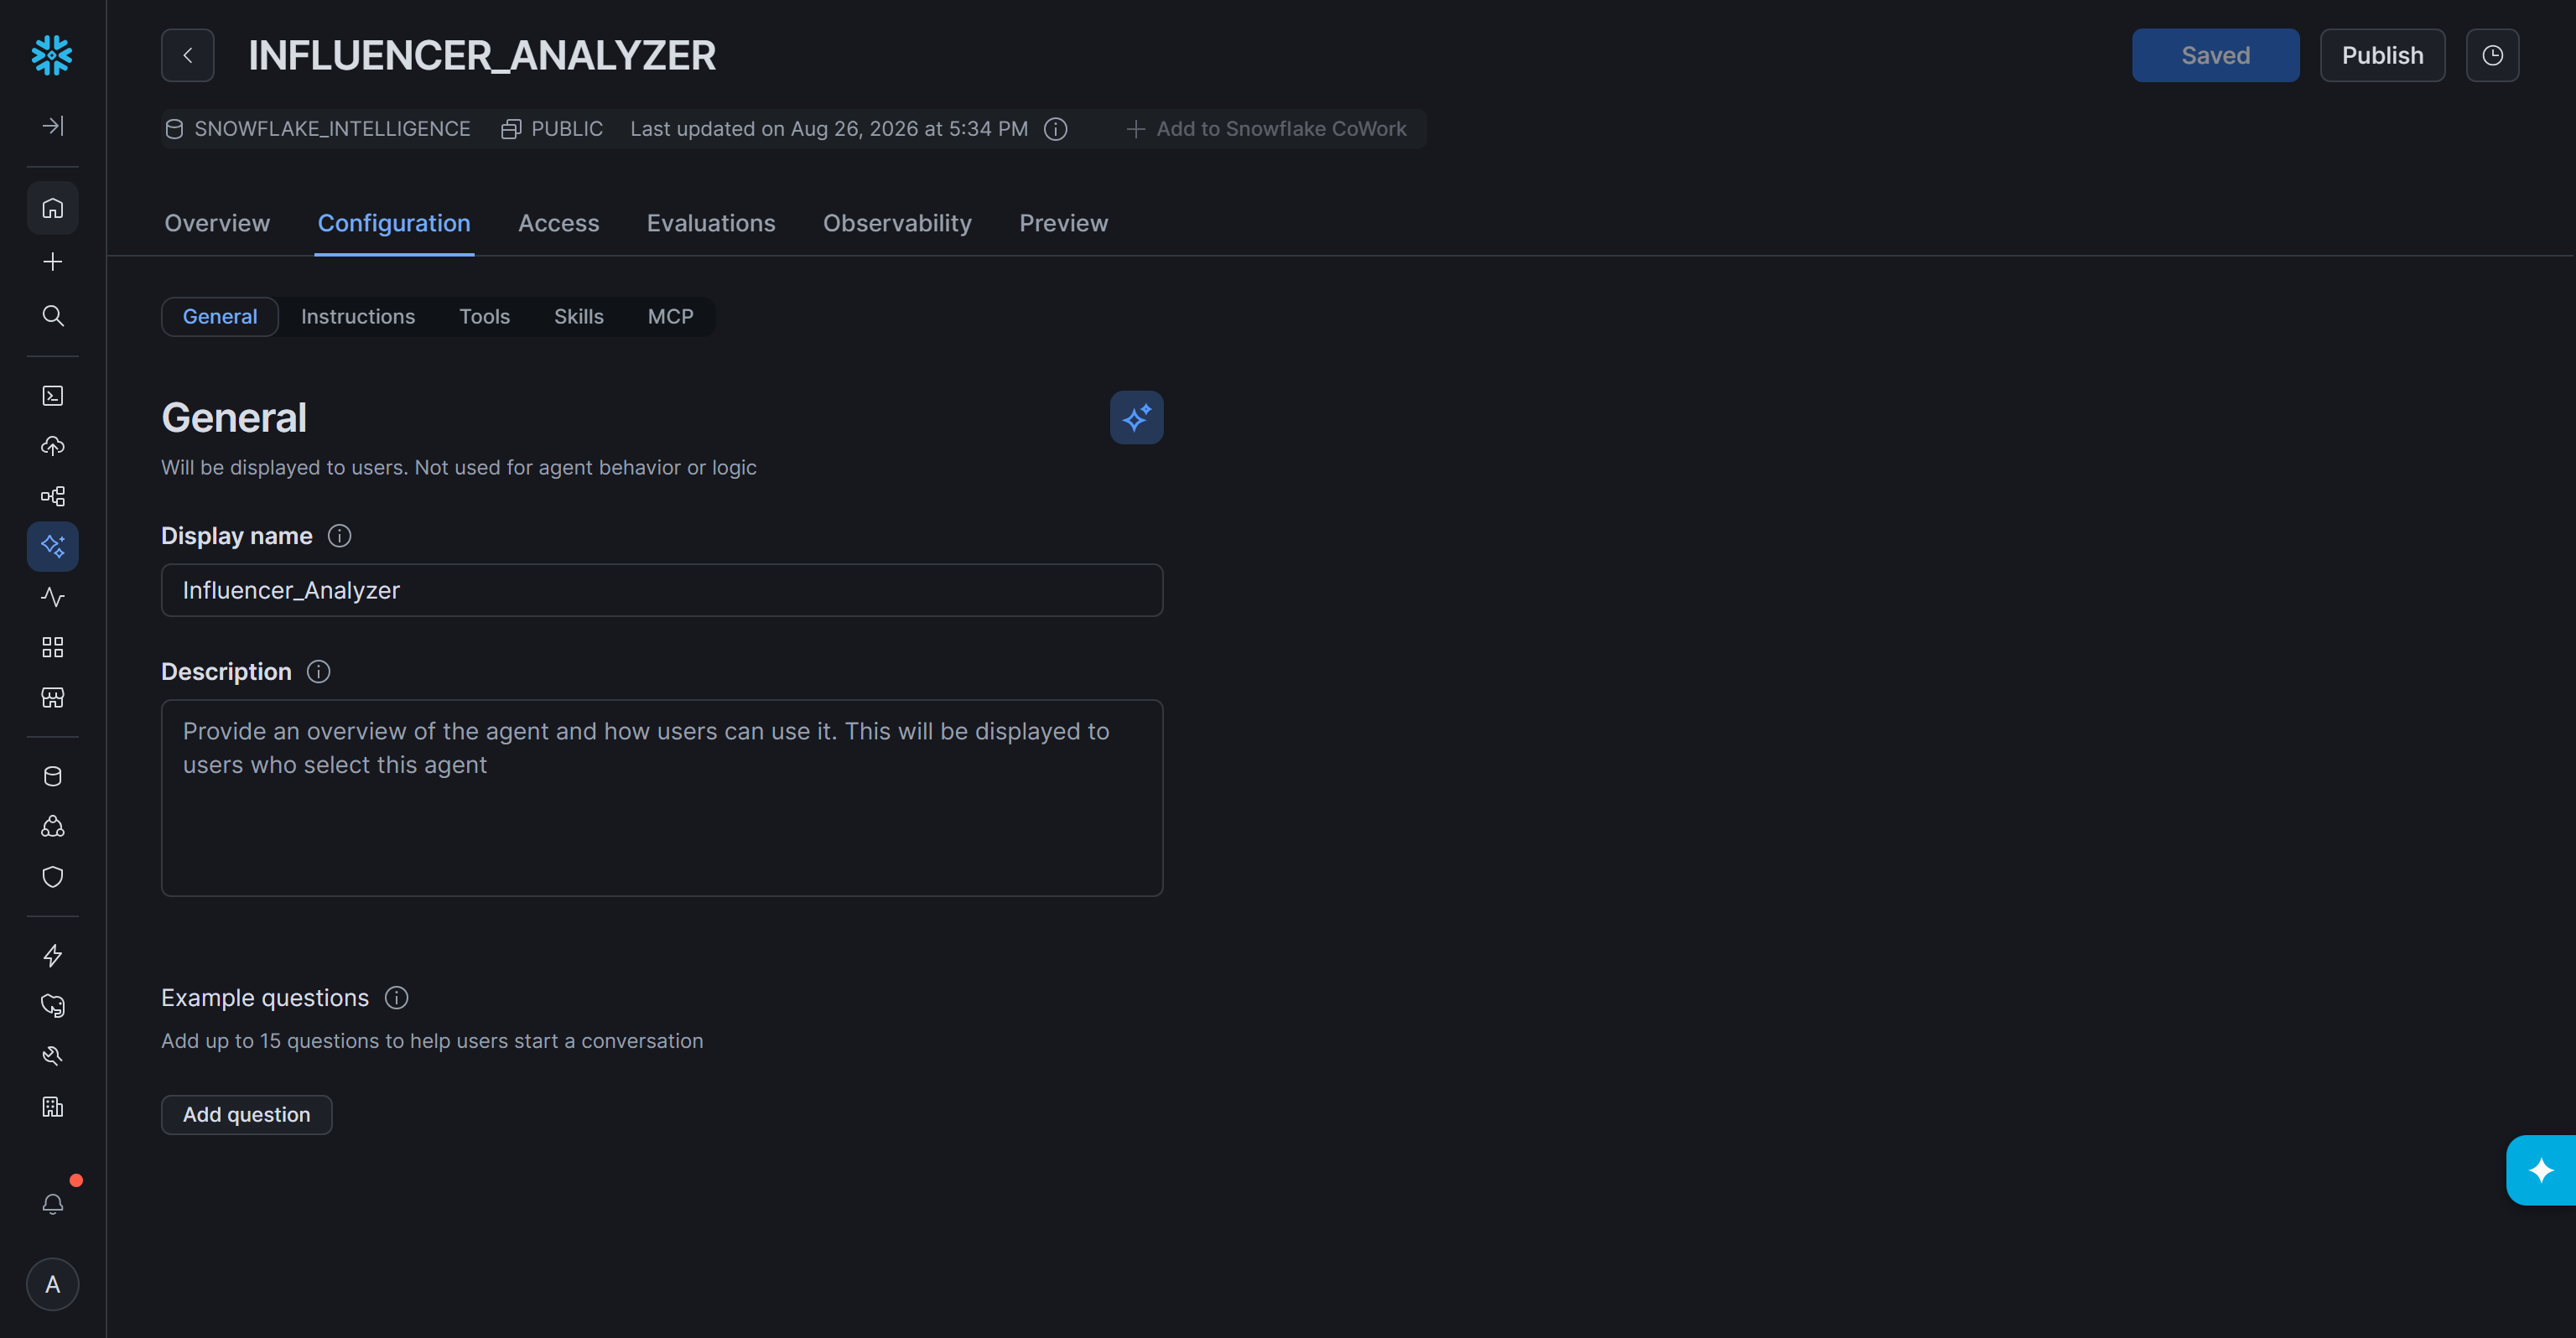
Ihr Agent kann nun die im konfigurierten Snowflake-Schema gespeicherten Daten abfragen, darüber nachdenken und sie verarbeiten.
Schritt #6: Den Agenten testen
Sobald konfiguriert, wechseln Sie zum Tab “Preview”, um Ihren Agenten zu testen. Geben Sie beispielsweise einen Prompt wie diesen ein:
Retrieve the top 5 Spanish-speaking influencers from the list to promote our revolutionary skincare product targeting female teenagers. Give each influencer a suitability score.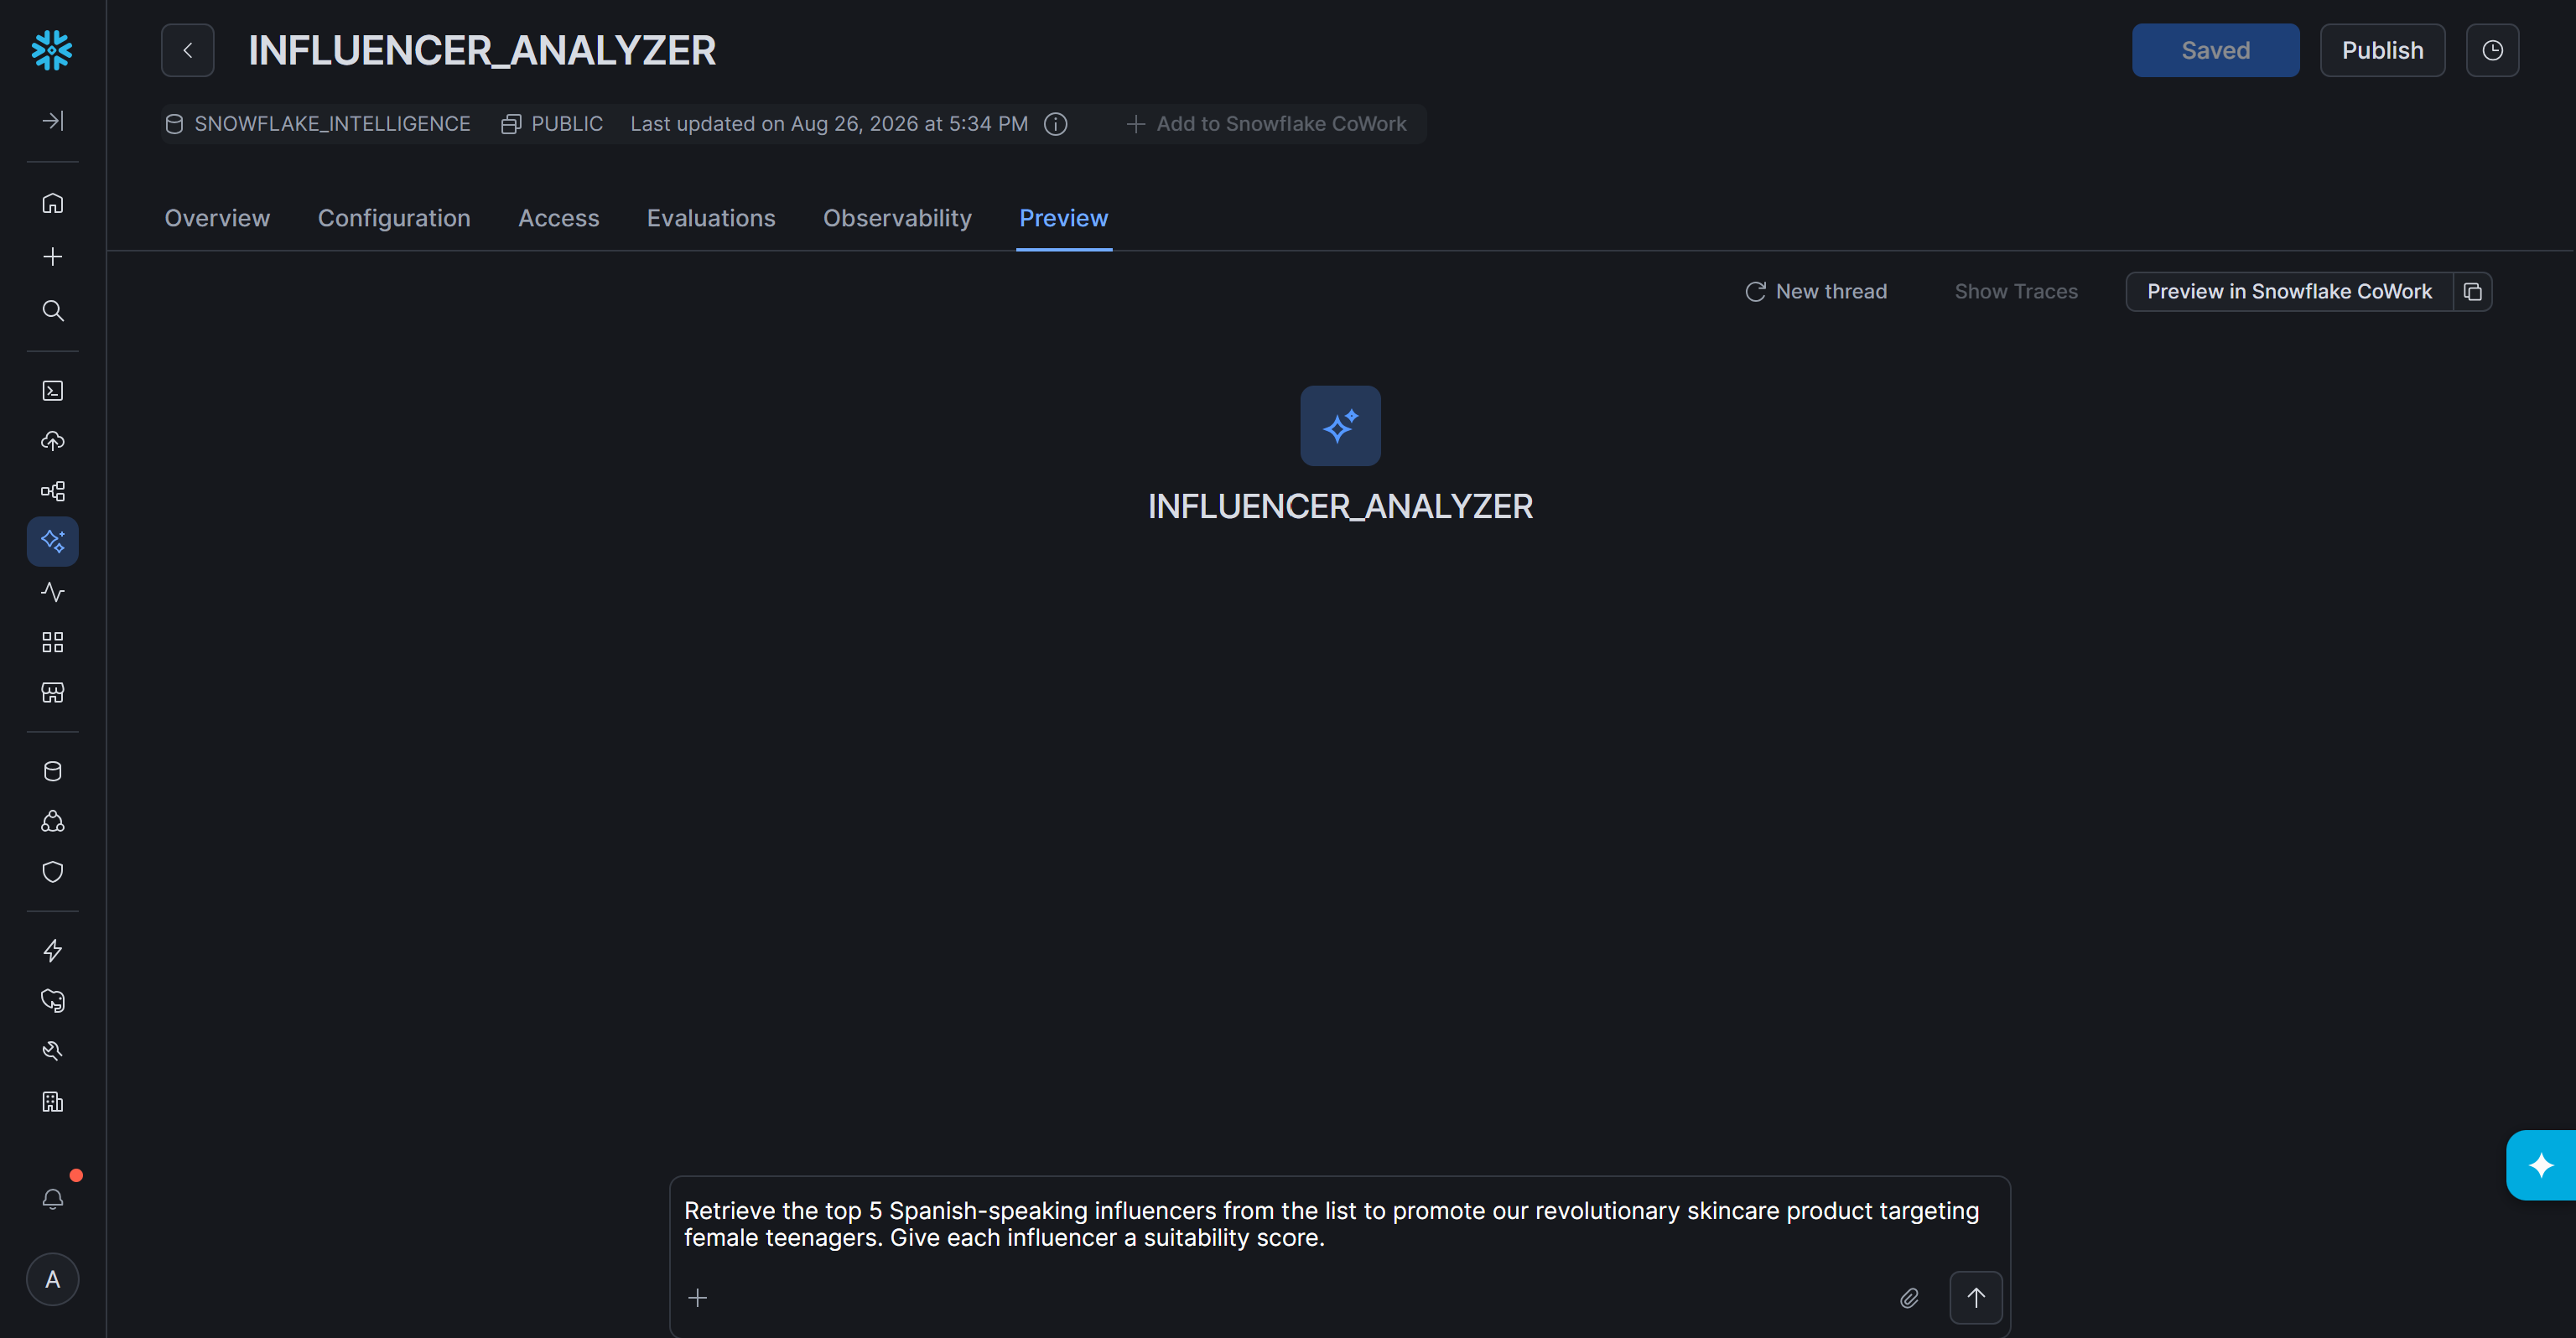
Der Agent fragt die Instagram-Profildaten in Ihrer Snowflake-Tabelle ab und liefert die fünf am besten geeigneten Influencer zusammen mit einem Eignungswert für jeden Einzelnen zurück. Im Hintergrund kann er Cortex Analyst für strukturierte Filterung (wie Sprache und Profilattribute) und Cortex Search verwenden, um die Eignung von Biografie und Beschriftung vor der Bewertung zu beurteilen. In einem realistischeren Szenario könnten Sie dem Agenten auch Kontext zu Ihren Produktdaten geben, um ihm zu helfen, die Ergebnisse besser zu verfeinern.
Live-Web-Zugriff mit Bright Data MCP hinzufügen
Der obige Workflow deckt das Muster des persistenten Batch-Datensatzes ab. Wie die Vergleichsmatrix zeigt, ist das andere Muster Live-Ingress: Anstatt Web-Daten zuerst zu speichern, ruft Ihr Agent sie zur Inferenzzeit ab.
Sie können Bright Data über MCP mit Cortex Agents verbinden oder es mit CoCo CLI (früher bekannt als Cortex Code CLI) integrieren.
Live-Web-Daten durch Bright Data MCP erhalten
Nicht jeder Workflow benötigt denselben Typ von Web-Daten. Persistente Datensätze sind hilfreich, wenn Sie wiederholt eine definierte Sammlung strukturierter Informationen analysieren, während andere KI-Anwendungen Zugriff auf Live-Informationen benötigen. Im Influencer-Beispiel könnten Sie den 1K-Profile-Datensatz für das Ranking behalten und dann MCP verwenden, um die neuesten Beiträge eines in die engere Wahl gezogenen Influencers vor der Kontaktaufnahme zu prüfen.
Bright Data MCP bietet die ergänzende Live-Datenschicht. Anstatt zuerst einen Web-Datensatz in Snowflake zu speichern, können Agenten über MCP mit API-basierten Lösungen von Bright Data interagieren, um nach aktuellen Web-Inhalten zu suchen, sie zu scrapen und mit ihnen zu interagieren.
Dies verleiht der Integration von Bright Data + Snowflake zwei Daten-Ingress-Muster: persistente, gefilterte Datensätze für wiederholbare Analysen und Live-Web-Zugriff für zeitkritische Fragen.
Beachten Sie, dass die Bright Data MCP-App auch direkt über den Snowflake Marketplace verfügbar ist:
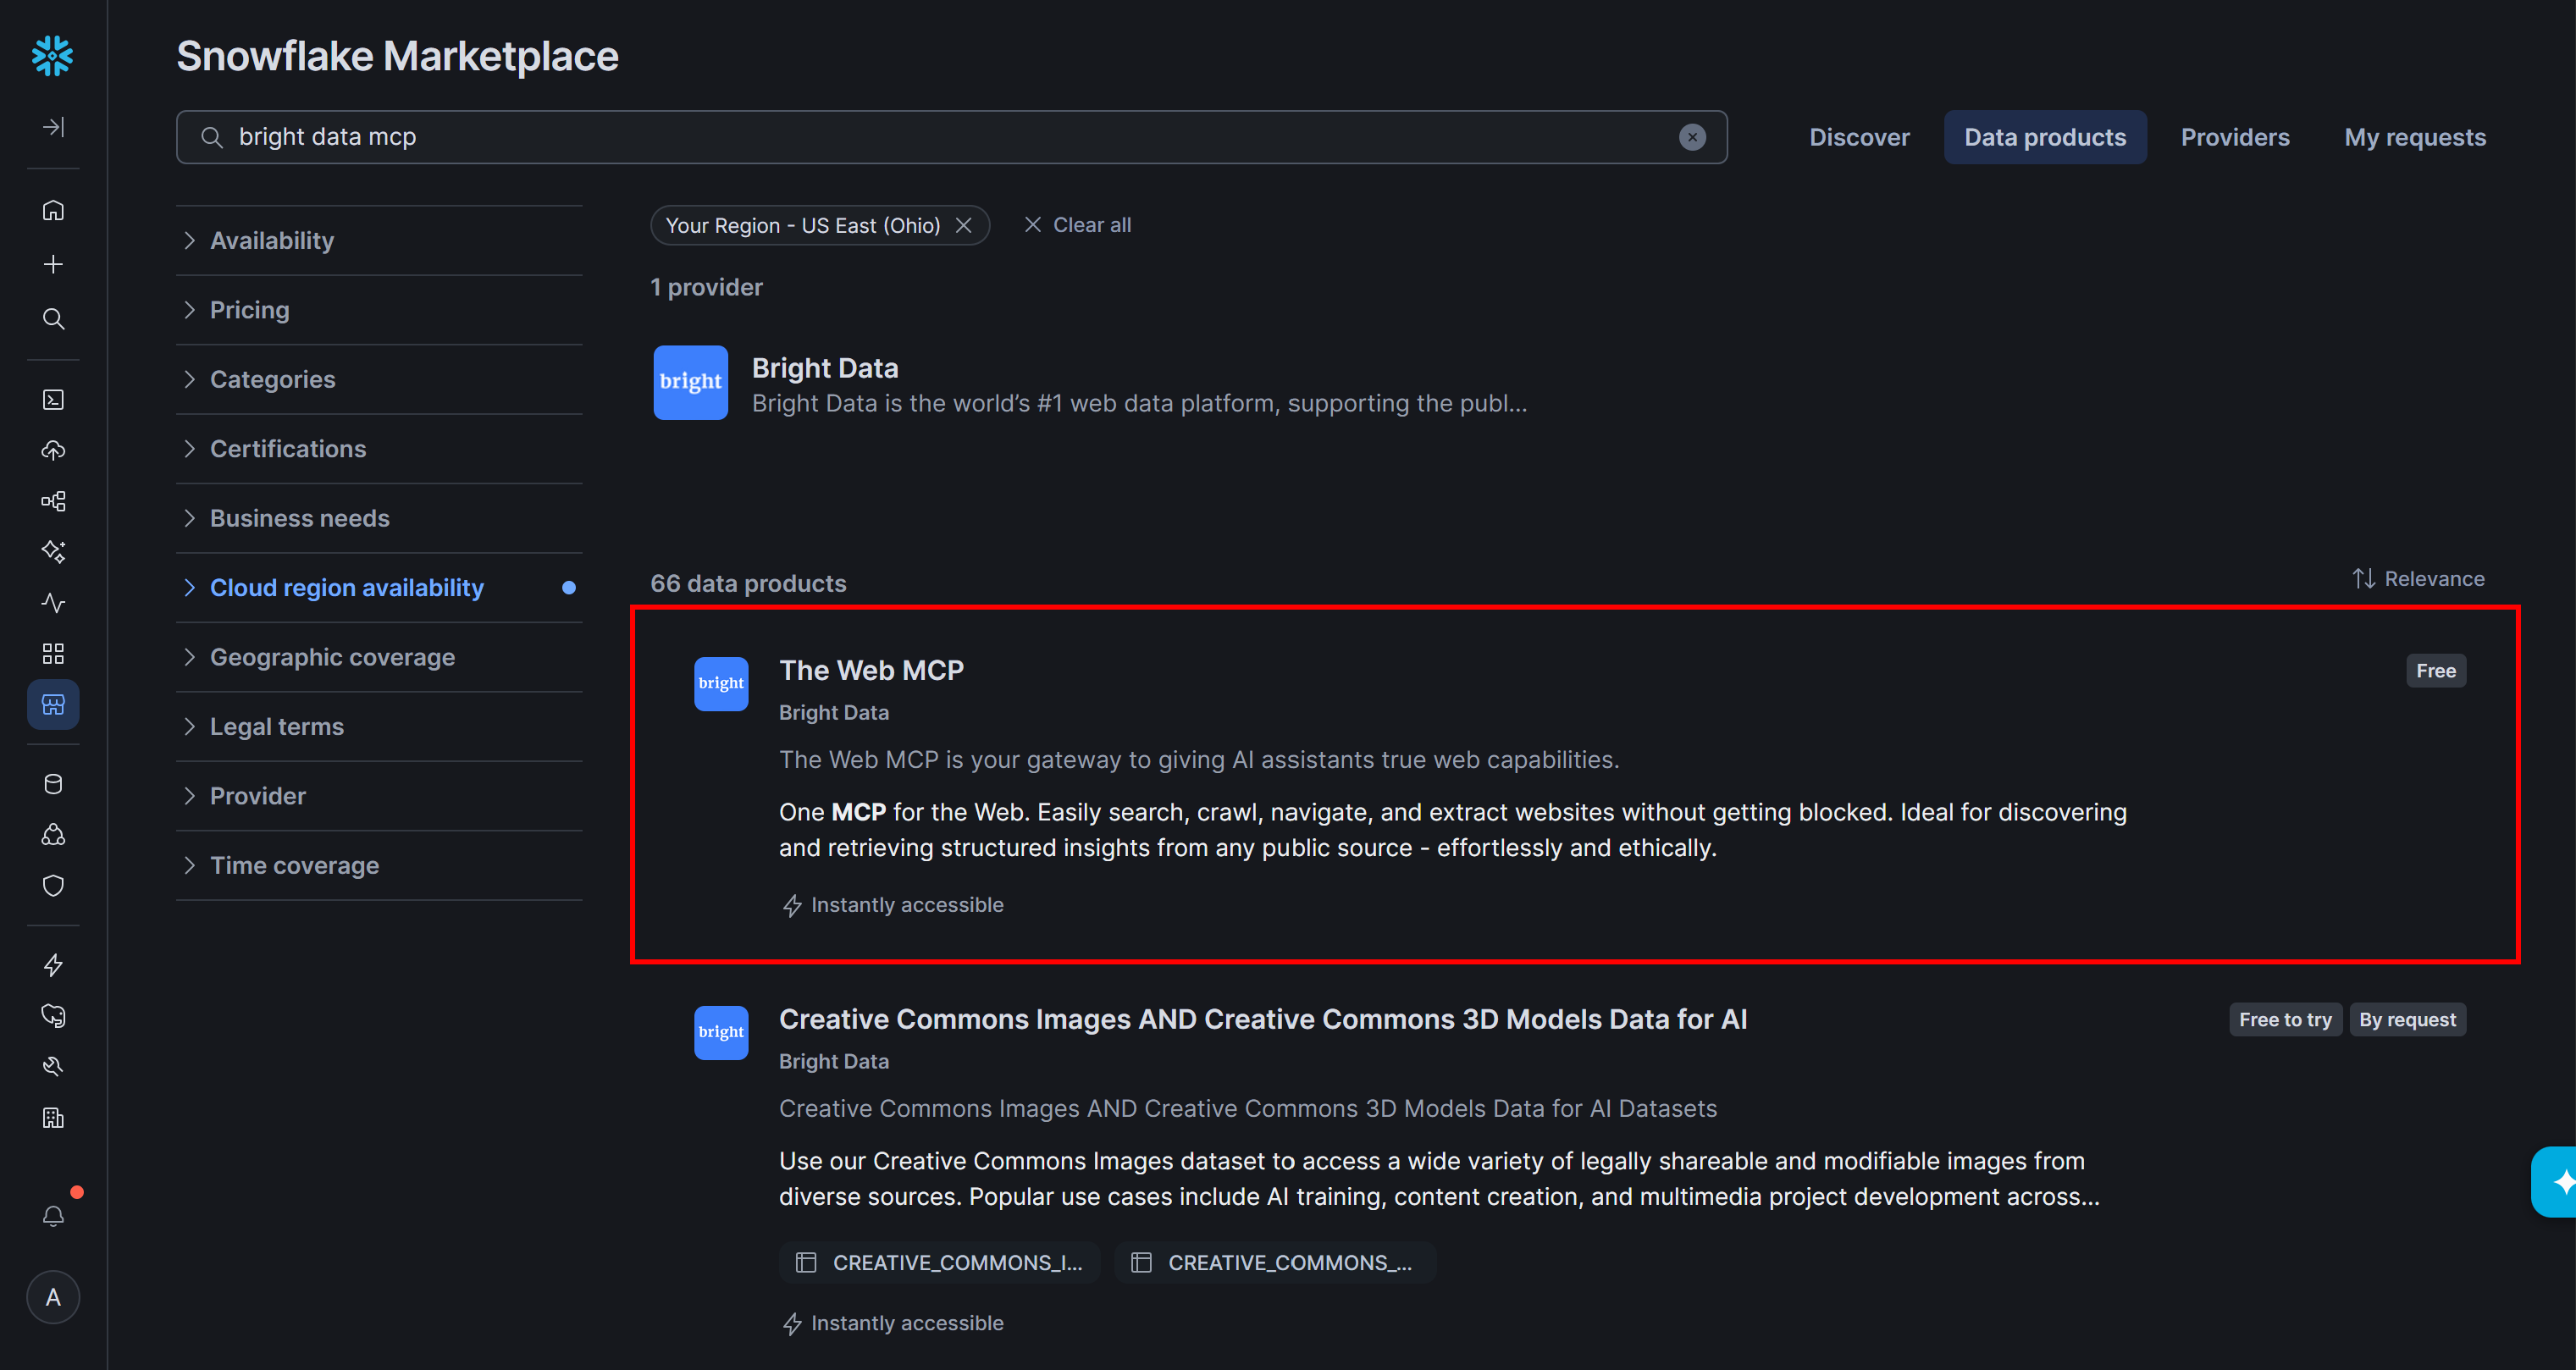
Alternativ können Sie den MCP-Server manuell einrichten.
Einige der interessantesten von Bright Data MCP unterstützten Szenarien umfassen:
| Anwendungsfall | Bright Data MCP-Fähigkeit |
|---|---|
| Seiteninhalt abrufen | Markdown-Scraping-Tools |
| Auf den neuesten Informationen basieren | Suchmaschinen-Abfragetools + Markdown-Scraping-Tools |
| Strukturierte Informationen extrahieren | Plattformspezifische Extraktionstools |
| Mit dynamischen Websites interagieren | Browser-Automatisierung |
Kurz gesagt, Datensätze bieten Ihnen wiederholbare Analysen über einen gespeicherten Snapshot, während Bright Data MCP Ihrem Agenten Live-Zugriff auf das Web ermöglicht. Viele ausgereifte Architekturen nutzen beides.
Bright Data mit CoCo CLI verbinden
Bright Data MCP und Agentenfähigkeiten können die Snowflake-basierten Fähigkeiten von CoCo CLI um Enterprise-Web-Zugriff erweitern. Dies ist nützlich, wenn Sie einen KI-Assistenten möchten, der Snowflake-Operationen mit Echtzeit-Webrecherche, Scraping und Browser-Automatisierung zusammenführen kann.
Für weitere Anleitungen lesen Sie unseren speziellen Artikel über Snowflake CoCo CLI mit Bright Data.
Fazit
In diesem Blogbeitrag haben Sie gelernt, wie die Integration von Bright Data + Snowflake zuverlässige Web-Datenbeschaffung mit Enterprise-Analytik und KI verbindet.
Bright Data bietet die Infrastruktur, um aussagekräftige Web-Daten im großen Maßstab abzurufen, während seine Filter- und Anpassungsfunktionen es Ihnen ermöglichen, diese Daten zu verfeinern, bevor Sie sie in Snowflake einbringen. Dies kann dazu beitragen, unnötige Daten aus nachgelagerter Speicherung und Rechenleistung herauszuhalten.
Sobald sich der Datensatz in Snowflake befindet, kann er mit Ihren vorhandenen Daten kombiniert und über Analytik- und KI-Workloads hinweg genutzt werden. Für Workloads, die von aktuellen Informationen abhängen, ermöglicht Bright Data MCP Agenten, Live-Web-Daten zur Inferenzzeit abzurufen, entweder allein oder zusammen mit persistenten Datensätzen in einer hybriden Architektur.
Zusammen bieten Bright Data und Snowflake einen flexiblen Weg von Web-Daten zu KI-fähiger Intelligenz: Wählen Sie das richtige Ingress-Muster (persistente Datensätze, Live-MCP-Zugriff oder beides), bringen Sie die Daten in die Umgebung, in der Ihre Geschäftsdaten bereits leben, und aktivieren Sie sie mit Cortex AI-Fähigkeiten wie Analyst, Search und Agents.
Erstellen Sie noch heute ein Bright Data-Konto und beginnen Sie damit, relevante Web-Daten für KI-gestützte Analysen in Snowflake zu bringen!