In diesem Leitfaden erfahren Sie:
- Was ein KI-Web-Scraping-Tool ist
- Wichtige Faktoren bei der Wahl des besten KI-Scraping-Tools für Ihren Anwendungsfall
- Die Top 9 KI-Web-Scraping-Tools, die 2026 verfügbar sind
- Eine zusammenfassende Vergleichstabelle zur schnellen Bewertung jeder Lösung
Legen wir los!
Was ist ein KI-Web-Scraping-Tool?
Ein KI-Web-Scraping-Tool nutzt künstliche Intelligenz, um die Extraktion von Daten aus Websites zu automatisieren. Es kann eine Cloud-Plattform mit KI-gestützten Scraping-APIs, eine Python- oder JavaScript-Bibliothek oder ein vollständiges No-Code-Produkt auf Basis eines visuellen Workflows sein.
Der Vorteil von KI-gestütztem Scraping gegenüber herkömmlichen Scrapern liegt in der Fähigkeit, sich ohne ständige Code-Aktualisierungen an Layout-Änderungen anzupassen, was den Wartungsaufwand reduziert und die Genauigkeit verbessert. Der Nachteil ist, dass KI-Verarbeitung Latenz hinzufügt und bei LLM-basierter Extraktion gelegentlich halluzinierte Ausgaben erzeugen kann.
Moderne KI-Web-Scraping-Tools umfassen in der Regel Funktionen wie:
- Eingabeaufforderungen in natürlicher Sprache zur Auswahl bestimmter Datenfelder
- Integration mit LLM-Anbietern (OpenAI, Anthropic, Gemini und andere)
- Vorgefertigte Konnektoren für beliebte Websites und Marktplätze
- JavaScript-Rendering für dynamische Single-Page-Anwendungen
- Anti-Bot-Umgehung und Proxy-Verwaltung, um Scraping-Sperren zu vermeiden
Wie wir die besten KI-Scraping-Tools ausgewählt haben
Bei der Bewertung der führenden KI-Web-Scraping-Lösungen sind folgende Schlüsselelemente zu beachten:
- Funktionsumfang: Die Bandbreite der vom Tool unterstützten Features und Funktionalitäten, von der einfachen Seitenextraktion bis hin zum vollständigen Site-Crawling und strukturierten Datenpipelines.
- Art: Ob es sich um ein kommerzielles SaaS-Produkt, Open-Source oder ein hybrides Angebot handelt.
- Unterstützte Programmiersprachen: Die Sprachen und Frameworks, mit denen die Lösung integriert werden kann, und ob ein No-Code-Pfad existiert.
- Unterstützte KI-Anbieter: Die KI-Modelle, mit denen das Tool verbunden ist, oder ob es intern proprietäre KI verwendet.
- Preisgestaltung: Pläne und Preise direkt von der Website des jeweiligen Tools, zum Zeitpunkt der Veröffentlichung überprüft.
- GitHub-Sterne: Community-Akzeptanz für Open-Source-Projekte als Signal für Reife und Dynamik.
Top 9 KI-Web-Scraping-Tools
Hier ist eine TL;DR-Vergleichstabelle der Top 9 KI-Scraping-Tools, gefolgt von ausführlichen Bewertungen zu jedem Tool:
| Tool | Typ | Open-Source | No-Code | Einstiegspreis | GitHub-Sterne |
|---|---|---|---|---|---|
| Bright Data | Vollständige Infrastruktur | ✔️ (MCP, LangChain-Integrationen) | ✔️ | Ab $0,75/1.000 Datensätze | N/A |
| Firecrawl | Entwickler-API | ✔️ | ❌ | Kostenlos bis $599/Monat | 125.000+ |
| Crawl4AI | Open-Source-Bibliothek | ✔️ | ❌ | Kostenlos | 66.700+ |
| Browse AI | No-Code-Plattform | ❌ | ✔️ | $19/Monat (jährlich) | N/A |
| Apify | Actor-Marktplatz | ✔️ (Actors) | ✔️ | Kostenlos bis $999/Monat | N/A |
| ScrapeGraphAI | Open-Source + API | ✔️ | ❌ | Kostenlos bis $425/Monat | 26.300+ |
| Diffbot | Enterprise-KI | ❌ | ✔️ | Kostenlos bis $899/Monat | N/A |
| Browserbase | Cloud-Browser-Infrastruktur | ✔️ (Stagehand SDK) | ❌ | Kostenlos bis $99/Monat | N/A |
| Octoparse | No-Code Desktop + Cloud | ❌ | ✔️ | Kostenlos bis $69/Monat | N/A |
1. Bright Data
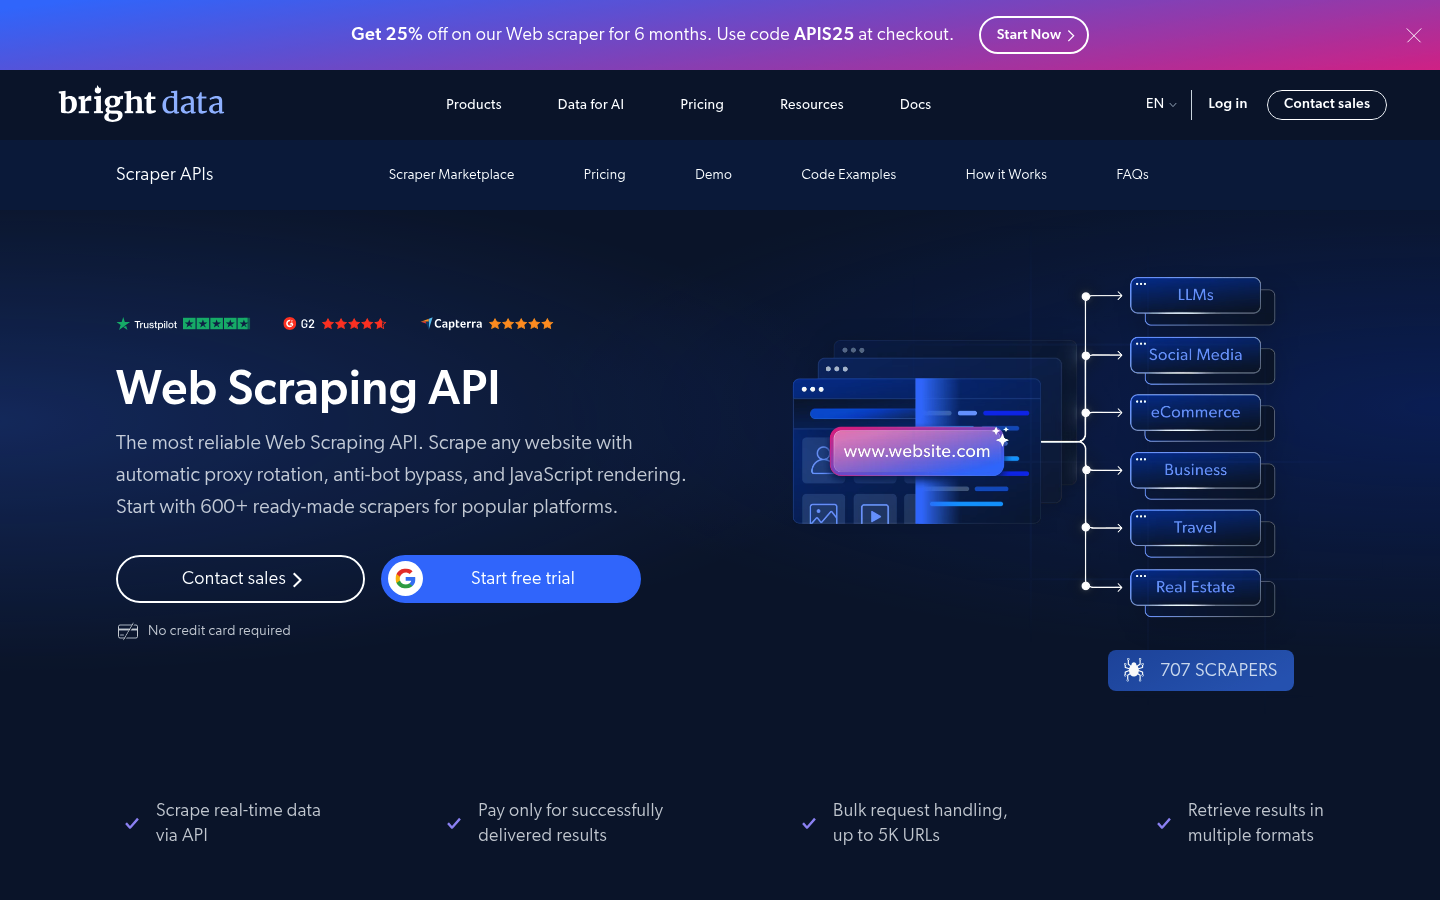
Bright Data ist eine Web-Daten-Infrastruktur, die auf Leistung, Skalierbarkeit und Compliance ausgelegt ist. Das von 50,000+ Kunden vertraute Unternehmen bietet eine vollständige Suite von KI-Scraping-Tools, unterstützt durch eines der weltweit größten Proxy-Netzwerke: über 100 Millionen IPs aus Residential-, Datacenter- und ISP-Pools.
Die Infrastruktur ist darauf ausgelegt, Echtzeit-Web-Daten, die für LLMs bereit sind, für KI-Agenten, RAG-Pipelines, Modelltraining und branchenspezifische Informationsgewinnung bereitzustellen. Jedes Scraping-Produkt wird durch branchenführende Anti-Bot-Bypass-Technologie unterstützt, sodass Sie sich auf Ihre Anwendung konzentrieren können, anstatt Sperren zu verwalten.
Zu den verfügbaren KI-Scraping-Tools von Bright Data gehören:
- SERP-API: Echtzeit-, LLM-bereite Suchmaschinenergebnisse von Google, Bing und anderen, optimiert für KI-Agenten und RAG-Systeme.
- Unlocker API: Umgeht CAPTCHAs und Bot-Erkennungssysteme im großen Maßstab und ermöglicht nahtlosen Zugriff auf jede öffentliche Webseite.
- Agent Browser: Serverlose Stealth-Browser für mehrstufige, agentenbasierte Workflows mit dynamischem Content-Loading und integriertem Entsperren.
- AI Scraper Studio: Erstellen und implementieren Sie benutzerdefinierte Scraping-Endpunkte für jede Website mit einem visuellen No-Code-Builder, der strukturierte Daten auf Abruf und in großem Maßstab liefert.
- Dataset Marketplace: Sofort einsatzbereite, kontinuierlich aktualisierte strukturierte Datensätze für Modelltraining, Wissensgraph-Entwicklung und sofortige Bereitstellung.
Open-Source-Integrationen umfassen langchain-brightdata für LangChain-Pipelines und @brightdata/mcp für KI-Agenten auf Basis des Model Context Protocol.
Preisgestaltung:
- AI Scraper Studio: Ab $0,75/1.000 Datensätze (25 % Aktionsrabatt, regulärer Preis $1/1.000)
- Unlocker API: Ab $1/1.000 Anfragen
- Agent Browser: Ab $5/GB
- Residential-Proxys: Ab $2,50/GB (50 % Aktionsrabatt, regulär $5/GB)
- Datacenter-Proxys: Ab $0,90/IP
- Kostenlose Testversion verfügbar, keine Kreditkarte erforderlich
2. Firecrawl
Firecrawl ist eine entwicklerorientierte Web-Scraping-API, die jede URL in sauberes, LLM-bereites Markdown oder strukturiertes JSON umwandelt. Mit über 125.000 GitHub-Sternen ist es seit seinem Launch eines der am weitesten verbreiteten KI-Scraping-Tools in der Entwickler-Community.
Firecrawl verarbeitet JavaScript-Rendering, CAPTCHA-Herausforderungen und dynamische Inhalte automatisch, was die Integration in KI-Pipelines und LLM-Anwendungen unkompliziert macht. Die API ist für Python, Node.js, Go, Rust und jede Sprache über REST verfügbar. Für Vergleiche mit Bright Datas Tools siehe Bright Data vs. Firecrawl.
Zu den wichtigsten Funktionen gehören:
- Scrape: Jede einzelne URL mit einem einzigen API-Aufruf in Markdown, HTML oder strukturiertes JSON umwandeln
- Crawl: Gesamte Websites rekursiv scrapen und Links über Unterseiten hinweg verfolgen
- Search: Websuche mit sofortiger Inhaltsextraktion aus den Ergebnissen
- Extract: LLM-gestützte strukturierte Datenextraktion mithilfe von Schemata in natürlicher Sprache
- JavaScript-Rendering: Vollständige Headless-Browser-Unterstützung für SPAs und dynamische Seiten
Preisgestaltung:
- Kostenlos: 1.000 Credits/Monat (1 Credit = 1 Seite)
- Hobby: $16/Monat (jährliche Abrechnung): 5.000 Credits/Monat
- Standard: $83/Monat (jährliche Abrechnung): 100.000 Credits/Monat
- Growth: $333/Monat (jährliche Abrechnung): 500.000 Credits/Monat
- Scale: $599/Monat: 1.000.000 Credits/Monat
- Enterprise: Benutzerdefinierte Credits und Ratenlimits
3. Crawl4AI
Crawl4AI ist eine Open-Source-Python-Bibliothek, die speziell für LLM-freundliches Web-Scraping entwickelt wurde. Mit über 66.700 GitHub-Sternen ist sie eines der am schnellsten wachsenden Open-Source-Scraping-Projekte, die heute verfügbar sind.
Im Gegensatz zu universellen Scrapern wurde Crawl4AI von Grund auf für KI-Workflows entwickelt: Es gibt sauberes Markdown aus, das für Token-Effizienz optimiert ist, unterstützt Chunking-Strategien für die RAG-Verarbeitung und integriert sich direkt mit gängigen LLM-Anbietern über seine Extraktionspipeline.
Zu den wichtigsten Funktionen gehören:
- Async-First-Architektur: Auf asyncio und Playwright aufgebaut für hochdurchsatzfähiges gleichzeitiges Scraping
- LLM-optimierte Markdown-Ausgabe: Entfernt Navigation, Werbung und Boilerplate, um saubere Inhalte für die KI-Verarbeitung zu erzeugen
- Extraktionsstrategien: CSS-Selektoren, XPath, LLM-basierte Extraktion und Cosinus-Ähnlichkeits-Content-Filterung
- Multi-Browser-Unterstützung: Chromium, Firefox und WebKit über Playwright
- JavaScript-Ausführung: Führt benutzerdefiniertes JS vor der Extraktion aus, verarbeitet dynamische Inhalte und lazy-geladene Seiten
- KI-Anbieter-Integrationen: OpenAI, Anthropic, Gemini, Ollama, Groq und andere über die Extraktionspipeline
Preisgestaltung: Crawl4AI ist vollständig kostenlos und Open-Source unter der Apache-2.0-Lizenz. Optionale Cloud- und Support-Stufen sind für Teams verfügbar, die verwaltete Infrastruktur oder dedizierten Support wünschen.
4. Browse AI
Browse AI ist eine No-Code-Web-Scraping- und Monitoring-Plattform, die es Benutzern ermöglicht, Daten von jeder Website zu extrahieren und zu verfolgen, ohne eine einzige Zeile Code zu schreiben. Von Teams in großen Unternehmen für die Automatisierung wiederkehrender Datenerfassungs-Workflows vertraut.
Der visuelle Trainingsmodus von Browse AI ermöglicht es Ihnen, per Zeigen und Klicken zu definieren, welche Datenfelder die KI extrahieren soll. Einmal konfiguriert, läuft der Bot nach einem Zeitplan und überträgt die Ergebnisse direkt an Google Sheets, Airtable oder eine der über 7.000 Integrationen via Zapier, Make und Webhooks.
Zu den wichtigsten Funktionen gehören:
- 250+ vorgefertigte Bots: Sofort einsatzbereite Scraper für LinkedIn, Amazon, Twitter/X und andere beliebte Seiten
- Website-Monitoring: KI-gestützte Änderungserkennung mit Benachrichtigungen bei aktualisierten Inhalten
- 7.000+ Integrationen: Native Verbindungen zu Google Sheets, Airtable, Zapier, Make, Slack und mehr
- Massen-Scraping: Mehrere URLs in einer einzigen Aufgabe mithilfe einer URL-Liste oder CSV-Eingabe ausführen
- API-Zugriff: Bot-Ausführungen programmatisch über REST-API auslösen und abrufen
Preisgestaltung:
- Starter: $19/Monat: 12.000 Credits/Jahr
- Professional: $69/Monat: 60.000 Credits/Jahr
- Team: $500/Monat: angepasste Credits und Team-Limits
- Monatliche Abrechnung zu leicht erhöhten Preisen verfügbar
5. Apify
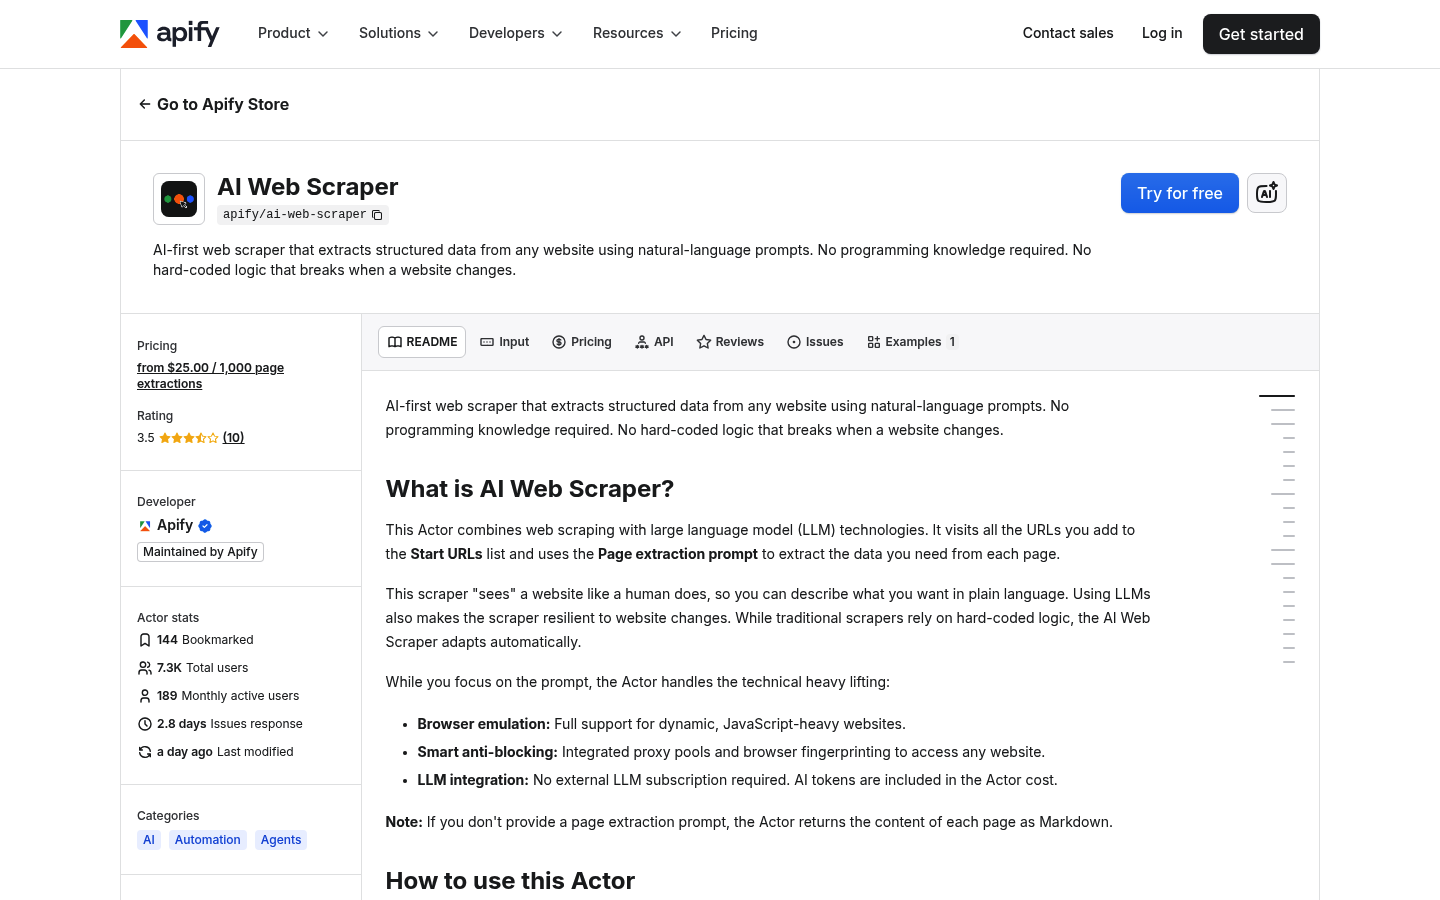
Apify ist eine Full-Stack-Web-Scraping- und Automatisierungsplattform, die auf einem Marktplatz mit über 33.000 wiederverwendbaren ‘Actors’ (serverlose Programme, die in der Cloud laufen) basiert, die geplant, per API ausgelöst oder zu Pipelines verknüpft werden können.
Das herausragende KI-Angebot ist der AI Web Scraper Actor, der eine Eingabeaufforderung in natürlicher Sprache akzeptiert (z. B. ‘Produktnamen und Preise von dieser Seite extrahieren’) und strukturiertes JSON zurückgibt, ohne Code oder CSS-Selektoren zu benötigen. Dies macht Apify für nicht-technische Nutzer zugänglich, während es für Entwickler, die benutzerdefinierte Actors in JavaScript oder Python erstellen, hochgradig erweiterbar bleibt.
Zu den wichtigsten Funktionen gehören:
- 33.000+ Actors: Vorgefertigte Scraper für alle wichtigen Plattformen, von sozialen Medien über E-Commerce bis hin zu Immobilien
- AI Web Scraper: Extraktion auf Basis natürlicher Sprache ohne Code-Kenntnisse
- Scheduler und Webhooks: Actors nach einem Cron-Zeitplan ausführen oder programmatisch auslösen
- Datensatz-Speicherung: Integrierte Key-Value-Stores und Datensätze zum Speichern und Exportieren von Ergebnissen
- Proxy-Verwaltung: Integrierte Residential- und Datacenter-Proxy-Rotation bei allen Ausführungen
Preisgestaltung:
- Kostenlos: $0: $5 in Plattform-Credits, $0,20/Compute-Einheit
- Starter: $29/Monat: $29 in Plattform-Credits, $0,20/Compute-Einheit
- Scale: $199/Monat: $199 in Plattform-Credits, $0,16/Compute-Einheit (ermäßigter Tarif)
- Business: $999/Monat: $999 in Plattform-Credits
6. ScrapeGraphAI
ScrapeGraphAI ist eine KI-native Web-Scraping-Bibliothek und Cloud-API, die LLMs nutzt, um strukturierte Daten von jeder Webseite mithilfe einer Eingabeaufforderung in natürlicher Sprache zu extrahieren. Die Open-Source-Bibliothek hat über 26.300 GitHub-Sterne angesammelt und die kommerzielle API ist SOC-2-Typ-II-zertifiziert.
Eines der herausragenden Merkmale von ScrapeGraphAI ist die Flexibilität bei LLM-Anbietern: Es unterstützt OpenAI, Anthropic, Google Gemini, Azure, Groq, Ollama (lokale Modelle) und mehrere andere. Dies macht es praktisch für Teams mit spezifischen Modellpräferenzen oder On-Premise-Anforderungen.
Zu den wichtigsten Funktionen gehören:
- Scrape: Jede URL in sauberes Markdown, HTML oder Screenshots umwandeln, mit optionalem Stealth-Modus
- Extract: LLM-gestützte strukturierte Datenextraktion von Webseiten mithilfe von Schemata in natürlicher Sprache
- Search: Websuche mit integrierter Inhaltsextraktion in einem einzigen Aufruf
- Crawl: Vollständiges Site-Crawling mit seitenweiser Extraktion in konfigurierbarer Tiefe
- Monitor: Webseiten auf Änderungen überwachen und Webhook-Benachrichtigungen empfangen
- Mehrere KI-Anbieter: OpenAI, Anthropic, Gemini, Azure, Groq, Ollama und andere
Preisgestaltung:
- Kostenlos: $0: 500 Credits/Monat
- Starter: $17/Monat: 10.000 Credits/Monat
- Growth: $85/Monat: 100.000 Credits/Monat
- Pro: $425/Monat: 750.000 Credits/Monat
- Enterprise: Benutzerdefinierte Credits und dedizierter Support
7. Diffbot
Diffbot ist eine KI-Extraktionsplattform für Unternehmen, die automatisch den Typ jeder Webseite (Artikel, Produkt, Person, Organisation, Bewertung, Veranstaltung) erkennt und vollständig strukturiertes JSON zurückgibt, ohne Template-Konfiguration. Gegründet 2012, ist es eines der etabliertesten KI-Web-Daten-Unternehmen auf dem Markt.
Über die Extraktion auf Seitenebene hinaus betreibt Diffbot einen Knowledge Graph mit über 31 Milliarden realen Entitäten, was es für Anwendungsfälle wie Entitätsauflösung, Beziehungsmapping und großangelegte Wissensbasis-Konstruktion geeignet macht.
Zu den wichtigsten Funktionen gehören:
- Automatische Typerkennung: Erkennt Artikel, Produkte, Personen, Veranstaltungen und andere Seitentypen ohne Konfiguration
- Knowledge Graph: 31+ Milliarden Entitäten mit Beziehungsdaten für Entitätsauflösung und semantische Abfragen
- Crawl-API: Gesamte Domains crawlen und Extraktionsregeln auf alle entdeckten Seiten anwenden
- Natural Language API: NLP-gestützte Fakten- und Beziehungsextraktion aus Texten
- Kein Programmieraufwand: REST-API ohne Selektor-Konfiguration für unterstützte Seitentypen
Preisgestaltung:
- Kostenlos: $0: 10.000 Credits/Monat (1 Credit = 1 Seitenextraktion)
- Startup: $299/Monat: 250.000 Credits/Monat ($0,001 pro Credit)
- Scale: $899/Monat: 1.000.000 Credits/Monat ($0,0009 pro Credit)
- Enterprise: Benutzerdefiniertes Credit-Kontingent und Preisgestaltung
8. Browserbase
Browserbase ist eine cloud-gehostete Headless-Browser-Infrastruktur, die für KI-Agenten und automatisierte Workflows konzipiert ist. Anstatt einer Scraping-API im herkömmlichen Sinne bietet sie skalierbare Remote-Browser, die Ihr Agent oder Skript über Playwright, Puppeteer oder Selenium steuert, mit integriertem Stealth-Modus und Proxy-Rotation auf Infrastrukturebene.
Browserbase ist besonders nützlich für KI-Agenten-Entwickler, die zuverlässige, beobachtbare Browser-Sitzungen in großem Maßstab benötigen. Die Session-Replay- und Debugging-Tools bieten vollständige Transparenz darüber, was jede Browser-Sitzung getan hat, was für die Diagnose von Fehlern in komplexen mehrstufigen Workflows entscheidend ist.
Zu den wichtigsten Funktionen gehören:
- Stealth-Browser: Cloud-Browser mit integriertem Fingerprint-Management und Bot-Erkennungsumgehung
- Playwright/Puppeteer/Selenium-kompatibel: Direkter Ersatz für lokale Headless-Browser, keine Code-Änderungen erforderlich
- Session-Replay: Vollständige visuelle Wiedergabe jeder Browser-Sitzung zum Debuggen und Auditieren
- Integrierte Proxys: Residential-Proxy-Rotation mit GB-basierter Abrechnung, in allen kostenpflichtigen Plänen enthalten
- Stagehand SDK: Open-Source-KI-Agenten-Framework auf Basis von Browserbase für Browser-Automatisierung in natürlicher Sprache
Preisgestaltung:
- Kostenlos: $0: begrenzte Sitzungen zum Prototyping
- Developer: $20/Monat: dann $0,12/Browser-Stunde
- Production: $99/Monat: dann $0,10/Browser-Stunde, 5 GB Proxys inklusive
- Enterprise: Benutzerdefinierte Preise mit dedizierter Infrastruktur
9. Octoparse
Octoparse ist eine etablierte No-Code-Web-Scraping-Plattform, die sowohl als Windows/Mac-Desktop-Anwendung als auch als Cloud-Service verfügbar ist. Sie ist seit 2014 auf dem Markt und wird von Business-Analysten, Marktforschern und Operations-Teams, die strukturierte Daten ohne Programmieraufwand benötigen, weit verbreitet eingesetzt.
Octoparse nutzt KI, um beim Laden einer Seite in den visuellen Scraper automatisch Datenfelder und Paginierungsmuster zu erkennen, was die Einrichtungszeit im Vergleich zur manuellen Konfiguration von Selektoren erheblich reduziert. Die Bibliothek mit über 250 Templates deckt viele beliebte Websites und Datentypen direkt ab.
Zu den wichtigsten Funktionen gehören:
- Visueller Zeigen-und-Klicken-Scraper: Keine CSS-Selektoren oder XPath: klicken Sie einfach auf die gewünschten Daten auf der Live-Seite
- 250+ Templates: Vorgefertigte Scraper für Amazon, LinkedIn, Tripadvisor und andere wichtige Websites
- Automatische Paginierungserkennung: KI erkennt und verarbeitet mehrseitige Datensätze automatisch
- Cloud-Extraktion: Aufgaben rund um die Uhr auf Octoparses Cloud-Servern ausführen, in Excel, CSV, JSON oder Datenbanken exportieren
- IP-Rotation: Integrierte Proxy-Rotation zur Reduzierung von Sperren bei umfangreichen Ausführungen
- Geplante Ausführungen: Scraper nach einem festen Zeitplan ohne manuelle Eingriffe ausführen lassen
Preisgestaltung:
- Kostenlos: $0: 10 Scraping-Aufgaben, 50.000 Zeilen/Monat exportiert, lokale Ausführung
- Standard: Ab $69/Monat: 100 Aufgaben, Cloud-Extraktion, 3 gleichzeitige Cloud-Ausführungen
- Enterprise: Ab $399: benutzerdefinierte Aufgabenlimits, dedizierte Cloud-Ressourcen, Priority-Support
- 5-tägige Geld-zurück-Garantie für alle kostenpflichtigen Pläne
Fazit
Die KI-Web-Scraping-Landschaft hat sich 2026 erheblich diversifiziert, mit starken Optionen auf allen Ebenen: von Open-Source-Python-Bibliotheken wie Crawl4AI und ScrapeGraphAI bis hin zu vollständigen Enterprise-Plattformen wie Bright Data und Diffbot sowie No-Code-Tools wie Browse AI und Octoparse für nicht-technische Nutzer.
Das richtige Tool hängt von Ihren Prioritäten ab. Wenn Sie maximale Skalierbarkeit, Zuverlässigkeit und Zugang zur breitesten Proxy-Infrastruktur benötigen, ist Bright Datas Suite aus Unlocker API, Agent Browser und Web Scraper API die vollständigste verfügbare Option. Für entwicklerorientierte LLM-Pipelines bieten Firecrawl und Crawl4AI die beste Integrationserfahrung mit modernen KI-Frameworks. Für Teams, die einen fertigen Actor-Marktplatz benötigen, verkürzen Apifys 33.000+ vorgefertigte Scraper die Zeit bis zur Datenverfügbarkeit erheblich.
Achten Sie bei der Wahl Ihres Tools darauf, dass es Proxy-Rotation und Anti-Bot-Bypass nativ unterstützt: Sie sind für jeden produktiven Scraping-Workflow nicht mehr optional.