Die Parallel Web Search API beantwortet die Anfrage eines Agenten aus Parallels eigenem Index, mit gerankten URLs und Markdown-Auszügen. Die SERP-API von Bright Data ruft die Live-Suchergebnisseite (SERP) von Google und anderen Suchmaschinen ab. Sie liefert die Seite zurück, die ein Nutzer in einem gewählten Land oder einer Stadt sehen würde.
Googles erstes Ergebnis für “emergency plumber” in Chicago war ein Map Pack mit 3 lokalen Unternehmen. Parallel lieferte gerankte Seiten ohne Map Pack, sodass der Agent verpassen würde, was Chicago-Nutzer zuerst sehen.
Dieser Leitfaden vergleicht beide hinsichtlich Ergebnissen, Standort, Preisen und vollständigem Seiteninhalt, mit ausführbarem Code.
TL;DR
- Wählen Sie Bright Data, wenn die Antwort davon abhängt, was Google anzeigt. Es liefert Googles Seite zurück, und Parallels Advanced-Modus lieferte bei 30 Abfragen 35 bis 43 % der URLs dieser Seite.
- Wählen Sie Parallel, wenn Googles Ranking keine Rolle spielt. Der Advanced-Modus lieferte einen Median von 4.082 Token an Auszügen pro 10 Ergebnissen.
- Lokale Ergebnisse ändern sich oft je nach Stadt. Googles Seiten für 3 Städte teilten sich bei 3 von 4 Abfragen keine organischen URLs, und Parallels Standorteinstellung akzeptierte Länder, nicht Städte.
- Das Hinzufügen von Bright Data erfordert nur einen MCP-Konfigurationseintrag. Ein Schlüssel funktioniert für Suche und Scraping. Die kostenlose Stufe benötigt keine Kreditkarte.
Was Bright Data und Parallel liefern
Bright Data und Parallel beantworten dieselbe Agentenanfrage aus unterschiedlichen Quellen. Bright Data ruft die Live-Ergebnisseite der Suchmaschine ab, während Parallel seinen eigenen Suchindex abfragt.
Mit einem Live-SERP kann der Agent außerdem die vollständigen Seiten abrufen, die er auswählt:
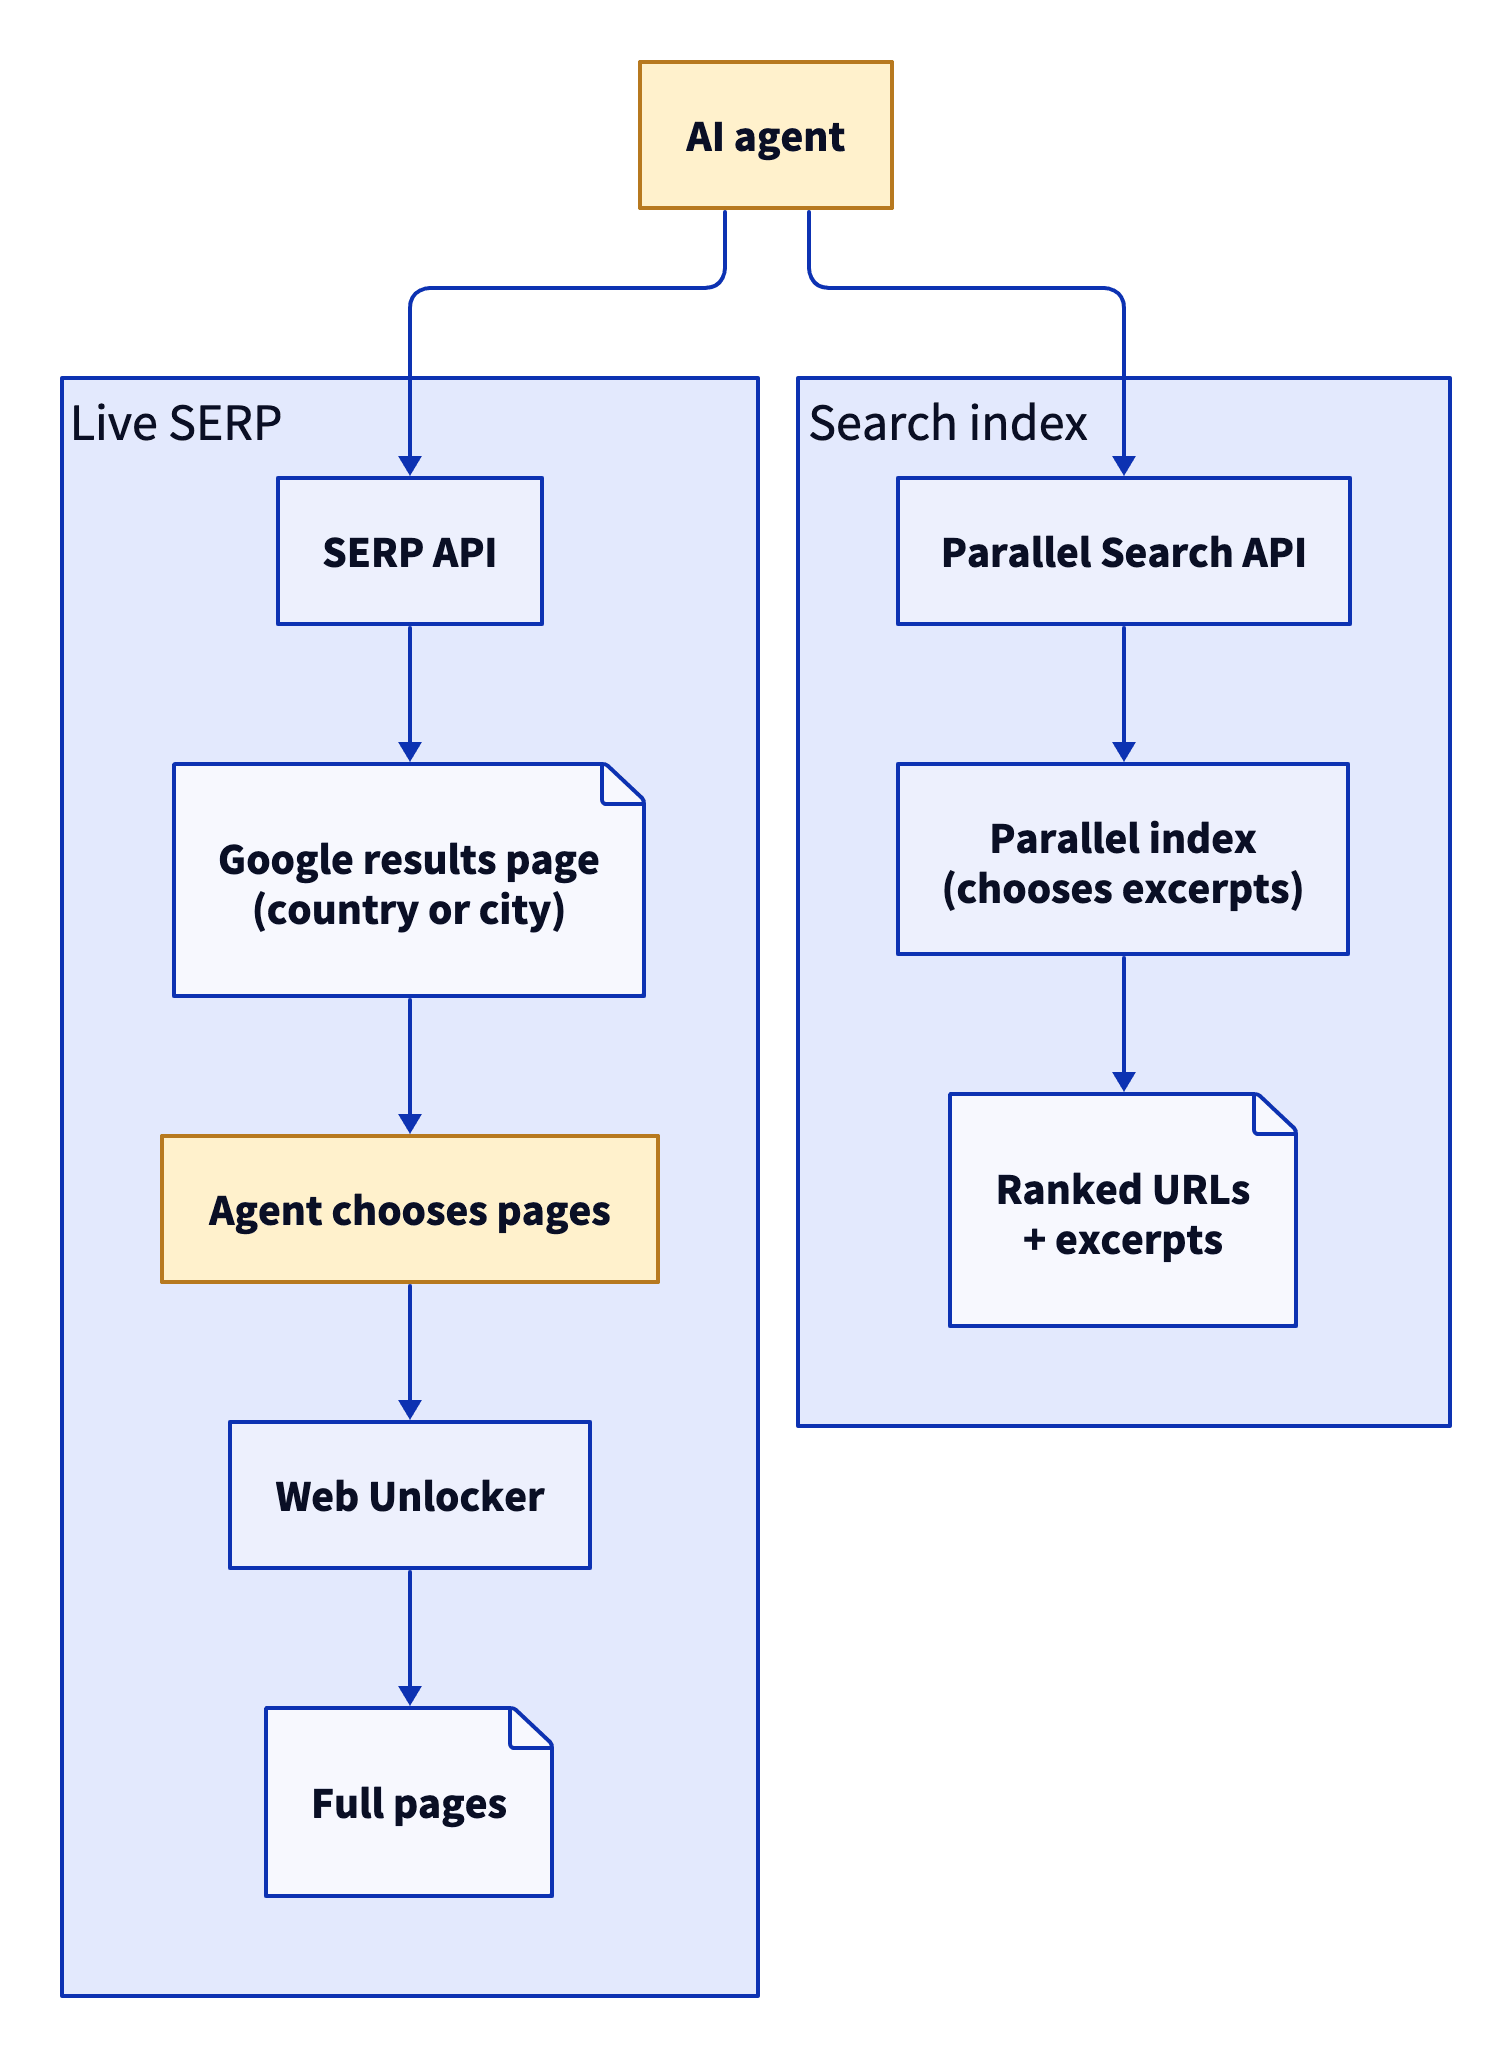
Mit einem Live-SERP wählt der Agent aus, welche Seiten er liest. Mit einem Suchindex wählt der Index die Auszüge aus.
Bright Data: Live-Ergebnisse und vollständige Seiten für Agenten
Die SERP-API liefert die Live-Ergebnisseite als geparstes JSON, rohes HTML oder Markdown zurück, einschließlich SERP-Features wie dem Map Pack (Googles lokale Unternehmenseinträge) und AI Overview. Web Unlocker ruft die Seiten ab, auf die diese Ergebnisse verlinken, und ist für Seiten mit Bot-Schutz konzipiert. Der Bright Data MCP-Server verpackt Suche und Scraping als Model Context Protocol (MCP)-Tools für Agenten, und beide Tools verwenden einen API-Schlüssel.
Parallel: Gerankte Auszüge aus dem eigenen Index
Die Search API von Parallel akzeptiert ein natürlichsprachliches objective plus kurze search_queries und liefert gerankte URLs mit Markdown-Auszügen zurück, die für das Ziel ausgewählt wurden. Die Modi turbo, fast, basic und advanced bieten eine Wahl zwischen Latenz und Qualität, und advanced war beim Testen die Standardeinstellung. Parallel verkauft außerdem eine Extract API für vollständige Seiteninhalte sowie weitere Agenten-APIs.
Bright Data vs. Parallel: Direkter Vergleich
Bright Data liefert die Live-Ergebnisseite der Suchmaschine plus die verlinkten Seiten, während Parallel Seiten aus seinem eigenen Suchindex rankt. Jede Angabe zu Parallel in dieser Tabelle stammt aus Parallels eigener Dokumentation oder Preisseite, überprüft während des Testens. Die SERP-API-Seite listet Bright Datas aktuelle Suchmaschinen, Standorte und Pläne auf.
| Bright Data | Parallel | |
|---|---|---|
| Ergebnisquelle | Live-Ergebnisseite der Suchmaschine | Parallels eigener Index, mit Live-Abruf, wenn die zwischengespeicherte Kopie älter als ein konfiguriertes Höchstalter ist |
| Ranking | Das eigene Ranking der Suchmaschine | Parallels Relevanz-Ranking für das Ziel |
| Suchmaschinen | Google, Bing und andere wichtige Suchmaschinen | Eigener Index |
| Standort | Länder- und stadtbasiertes Targeting | Ländercode aus einer festen Liste. Andere Codes werden mit einer Warnung ignoriert |
| Ausgabe | Geparstes JSON, HTML oder Markdown der vollständigen Ergebnisseite | URL, Titel, Veröffentlichungsdatum, Markdown-Auszüge |
| SERP-Features | Organisch, Map Pack, AI Overview, People Also Ask, Shopping, Anzeigen | Nicht zutreffend (nur gerankte Liste) |
| Seiteninhalt | Vollständiges Markdown der Seite über Web Unlocker oder den MCP-Server | Auszüge im selben Aufruf, Volltext über Extract |
| Seiten mit Bot-Schutz | Web Unlocker, konzipiert für bot-geschützte Websites | Kein Unblocker, laut Parallel kein Zugriff auf blockierende Websites |
| MCP-Server | Gehostetes oder lokales MCP, kostenloser Start ohne Kreditkarte | Search MCP, kostenlos ohne API-Schlüssel |
Der Vergleich mit der Brave Search API und der Vergleich mit Exa testen dieselben 2 Ansätze mit anderen Index-APIs. Für eine breitere Auswahl siehe die besten SERP- und Web-Search-APIs und die besten Suchtools für KI-Agenten.
Preise und Ratenbegrenzungen: Bright Data SERP-API vs. Parallel Search API
Die SERP-API berechnet nur erfolgreiche Anfragen, sodass Sie nur für die erhaltenen Ergebnisse zahlen. Sie können mit Self-Service-, Bezahlung-pro-Nutzung-Preisen beginnen, und größere monatliche Pläne senken den Preis pro 1.000 Anfragen. Parallel bepreiste beim Testen jede Suche je nach Modus, und der standardmäßige Advanced-Modus kostete das 5-Fache von Turbo und Fast.
Prüfen Sie die Parallel-Preisseite und die Bright Data SERP-API-Preisseite auf aktuelle Preise, bevor Sie Ihr Budget planen:
| Bright Data SERP-API | Parallel (Listenpreise beim Testen) | |
|---|---|---|
| Suchpreis | Self-Service-Bezahlung-pro-Nutzung-Preise oder monatliche Scale-Pläne mit niedrigerem Preis bei wachsendem Volumen (aktuelle Preise auf der Preisseite) | 1 $ pro 1.000 Anfragen für Turbo und Fast, 5 $ pro 1.000 für Basic und Advanced. Jeder Preis beinhaltete 10 Ergebnisse, zusätzliche Ergebnisse kosteten 1 $ pro 1.000 |
| Vollständiger Seiteninhalt | Web Unlocker, über den MCP-Server oder die eigene API (aktuelle Preise) | Extract zu 1 $ pro 1.000 URLs |
| Kostenlose Stufe | Wiederkehrende monatliche kostenlose Stufe, keine Kreditkarte erforderlich (aktuelles Kontingent auf der Preisseite) | 5 $ an Guthaben pro Monat, für Organisationen mit hinterlegter Kreditkarte |
| Abrechnung | Nur erfolgreiche Anfragen werden berechnet | Pro 1.000 Anfragen, je nach Modus |
| Ratenbegrenzungen und Parallelität | Scale-Pläne listen unbegrenzte Parallelität | Standardmäßig 600 Anfragen pro Minute, individuell bei Enterprise-Plänen |
Der Stückpreis ist nur ein Teil der Rechnung eines Agenten. Jedes Ergebnis, jeder Auszug und jede Seite, die das Modell liest, fügt der Rechnung ebenfalls Modell-Token hinzu. In einer Schleife, die sucht, liest und erneut sucht, liest das Modell frühere Ergebnisse bei jeder Runde erneut, und diese Token werden erneut berechnet. Vergleichen Sie die Kosten pro Antwort, die aus API-Ausgaben plus Modell-Token-Kosten bestehen, geteilt durch die Antworten, die Ihr Agent tatsächlich verwendet.
Zum Beispiel macht ein Agent, der 3 Suchen durchführt und 3 Seiten liest, 6 API-Aufrufe pro Antwort. Multiplizieren Sie diese Aufrufe mit den aktuellen Preisen jeder API und addieren Sie dann die vom Agenten gelesenen Modell-Token, um die Kosten pro Antwort zu vergleichen.
Gleiche Abfrage, unterschiedliche Ergebnisse: Parallels Überschneidung mit Google
Parallels standardmäßiger Advanced-Modus lieferte 35 bis 43 % der URLs auf Googles erster Seite zurück. Die Modi Turbo und Fast lieferten 6 bis 18 %.
Ich sendete die gleichen 30 US-Abfragen an Google über die SERP-API und an alle 4 Parallel-Modi, dann verglich ich die obersten 10 URLs. Die Tabelle zeigt den Anteil von Googles Top-URLs, den jeder Parallel-Modus ebenfalls zurücklieferte, mit der Abfrageanzahl jeder Gruppe in Klammern. Googles erste Seite änderte sich zwischen den Durchläufen, daher zeigt ein Bereich die Ergebnisse von 2 Durchläufen:
| Gruppe (Abfragen) | Advanced | Basic | Fast | Turbo |
|---|---|---|---|---|
| Faktisch (5) | 35 bis 61% | 33 bis 53% | 15 bis 18% | 11 bis 17% |
| Technische Dokumentation (5) | 50 bis 63% | 64% | 27% | 11% |
| Nachrichten (4) | 25 bis 36% | 31 bis 42% | 26 bis 39% | 5 bis 8% |
| Marke und SEO (6) | 21 bis 42% | 29 bis 52% | 12 bis 16% | 3 bis 8% |
| Kommerziell (6) | 35 bis 52% | 37 bis 53% | 8 bis 10% | 0 bis 2% |
| Lokal (4) | 17 bis 25% | 17% | 0% | 0% |
| Alle Abfragen (30) | 35 bis 43% | 39 bis 45% | 15 bis 18% | 6% |
Parallels SDK empfahl ein natürlichsprachliches Ziel sowie 2 oder 3 Suchabfragen pro Aufruf. Mit diesen Einstellungen lieferte der Advanced-Modus 34 % und der Fast-Modus 11 %, die empfohlenen Einstellungen erhöhten die Überschneidung also nicht. Jede Gruppe hat 4 bis 6 Abfragen, behandeln Sie daher jede Gruppenzeile als groben Indikator und die 30-Abfragen-Zeile als Gesamtwert.
Parallel rankt Seiten nach dem Ziel, was gut für offene Rechercheanfragen funktioniert. Rank-Tracking, KI-Sichtbarkeits-Tracking, Markenüberwachung und Anzeigenüberwachung benötigen die Seite, die Nutzer tatsächlich sehen. Diese Seite ist Googles Ergebnisseite, die die SERP-API zurückliefert.
Stadtbasiertes Targeting: Googles Ergebnisse in Chicago, Austin und Seattle
Googles Ergebnisse änderten sich beim Testen je nach Stadt bei 3 von 4 lokalen Abfragen, und Parallels Standorteinstellung akzeptierte Länder, nicht Städte. Die SERP-API rief Googles erste Seite für 4 Abfragen mit lokaler Absicht in Chicago, Austin und Seattle ab:
| Abfrage | Organische URLs zwischen beliebigen 2 Städten geteilt | Geteilte Map-Pack-Unternehmen |
|---|---|---|
| emergency plumber | Keine | Keine |
| best pizza | Keine | Keine |
| dentist open saturday | Keine | Keine |
| car insurance quotes | 6 von 9 | Google zeigte kein Map Pack |
Oberhalb des Map Packs zeigt Googles Seite für Chicago den angewendeten Standort:
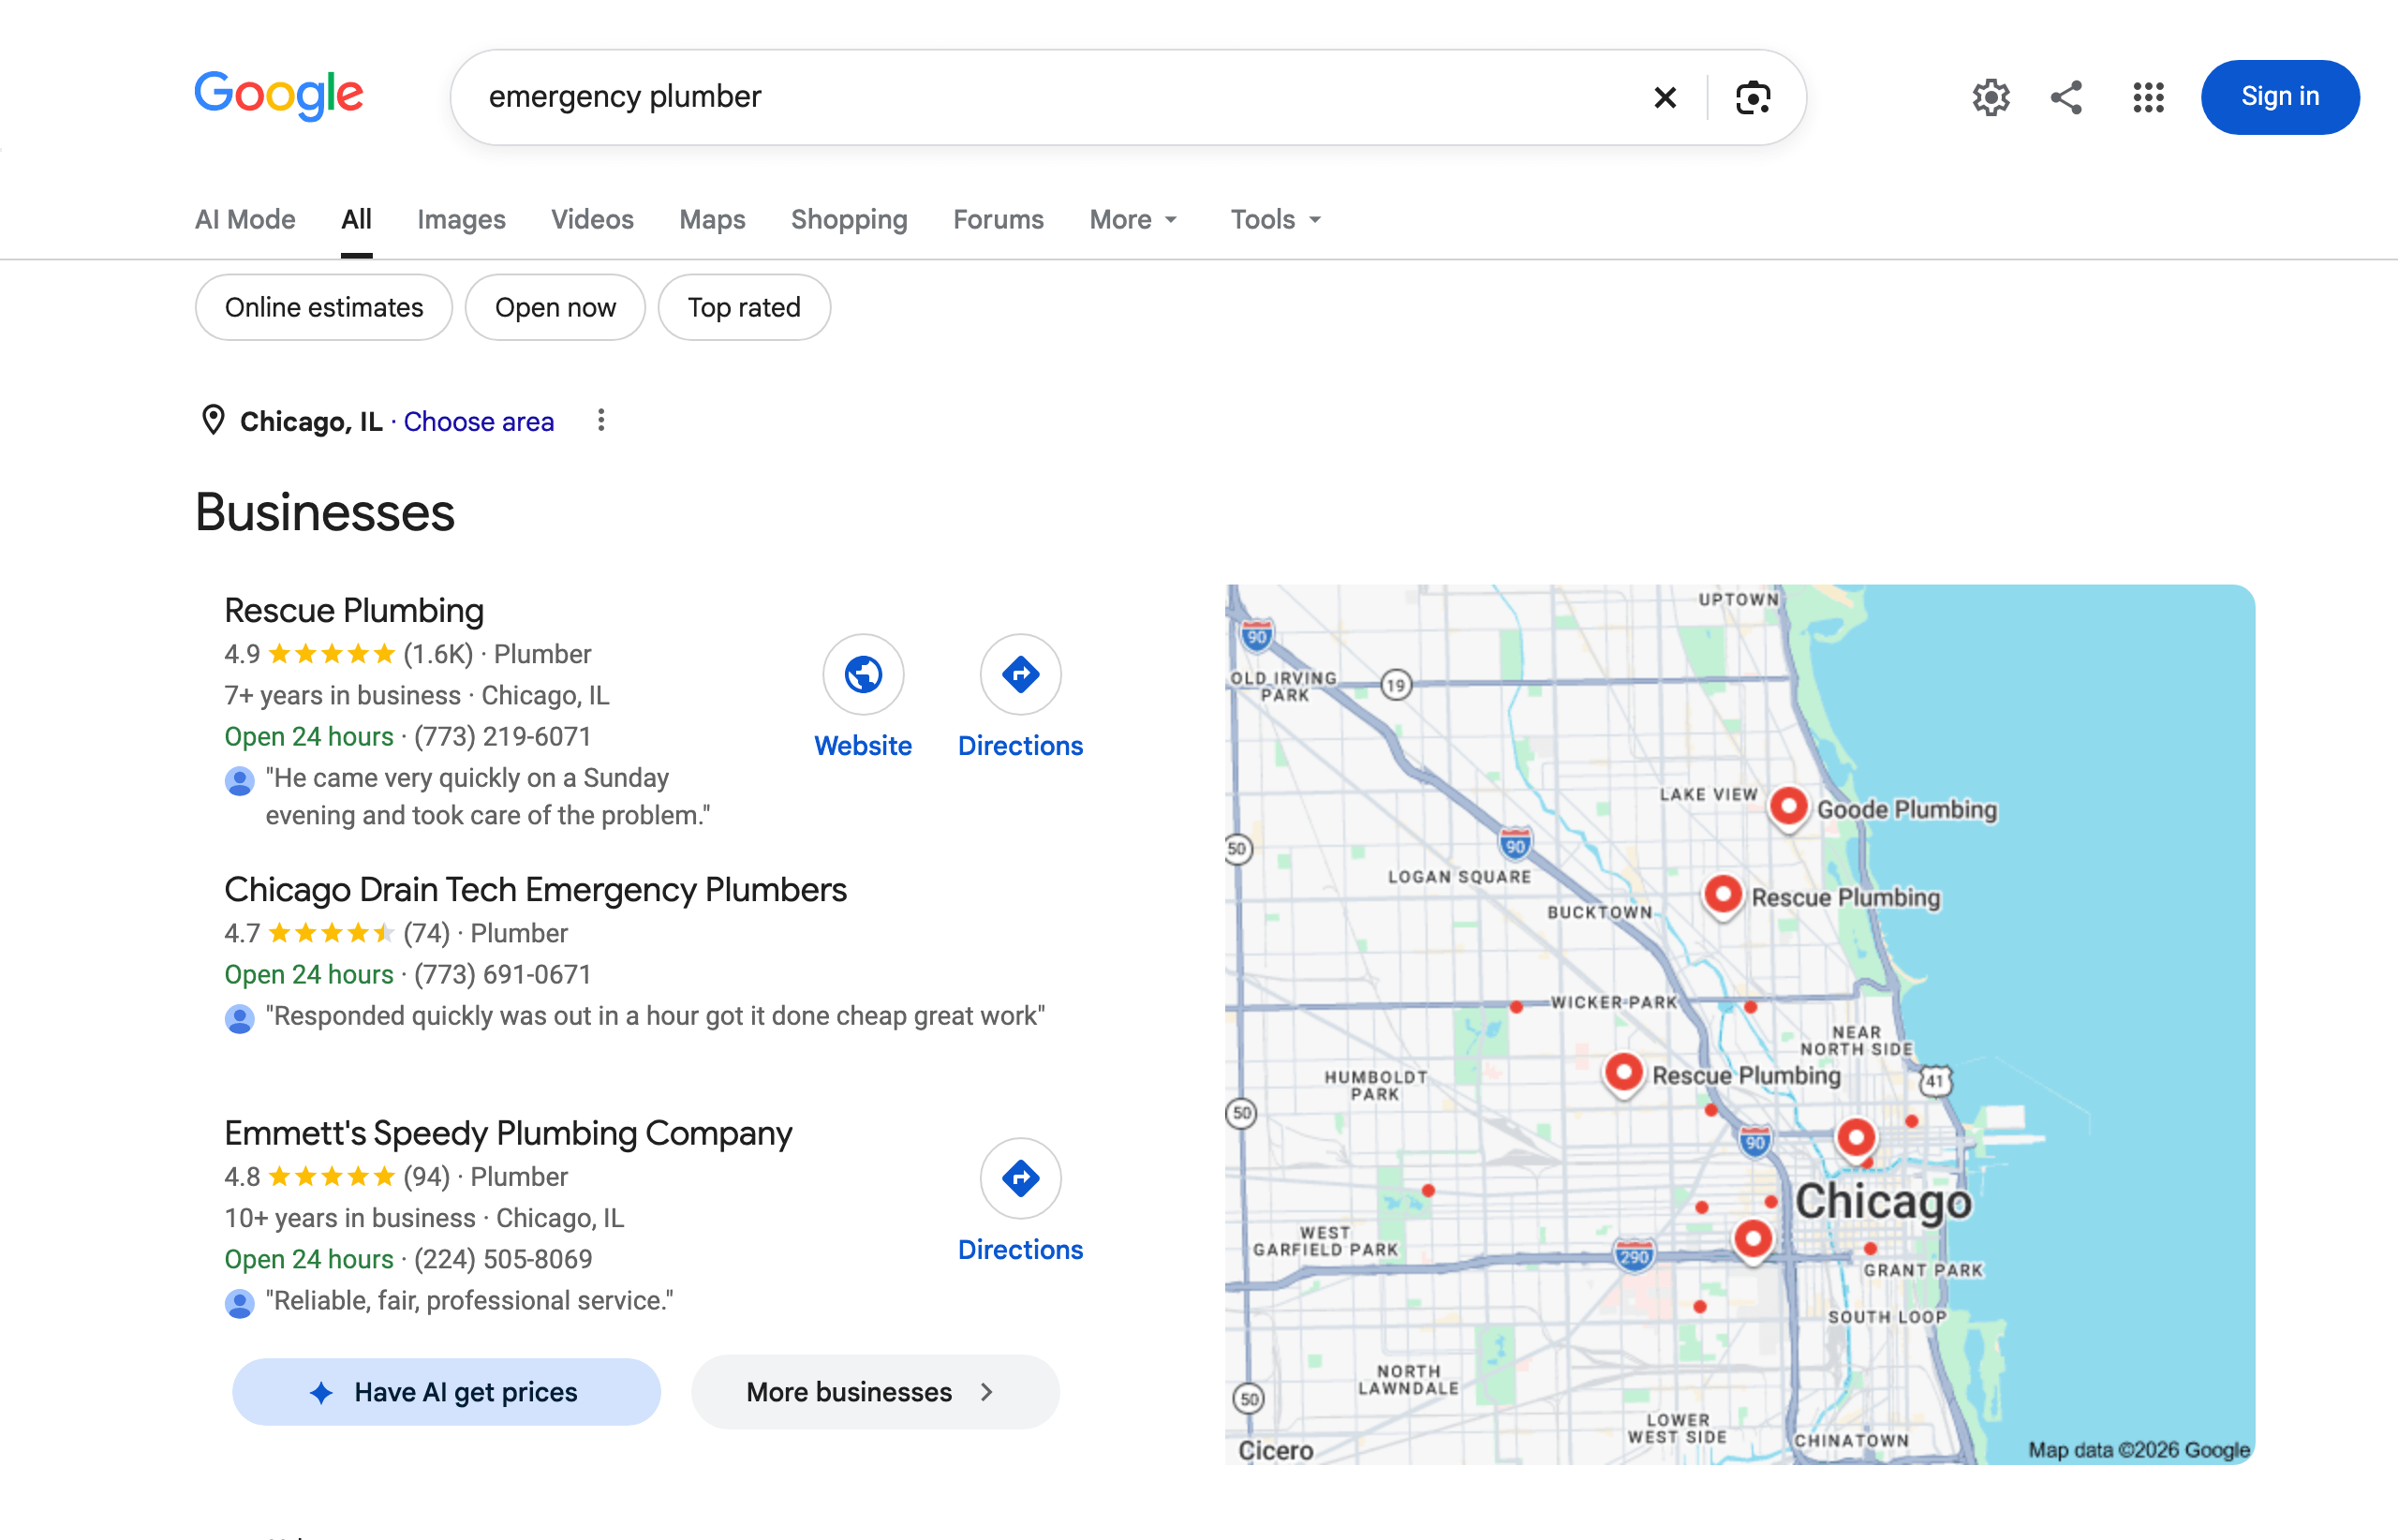
Die Standortangabe bestätigt das Targeting.
Austins Seite für dieselbe Abfrage listet andere Unternehmen:
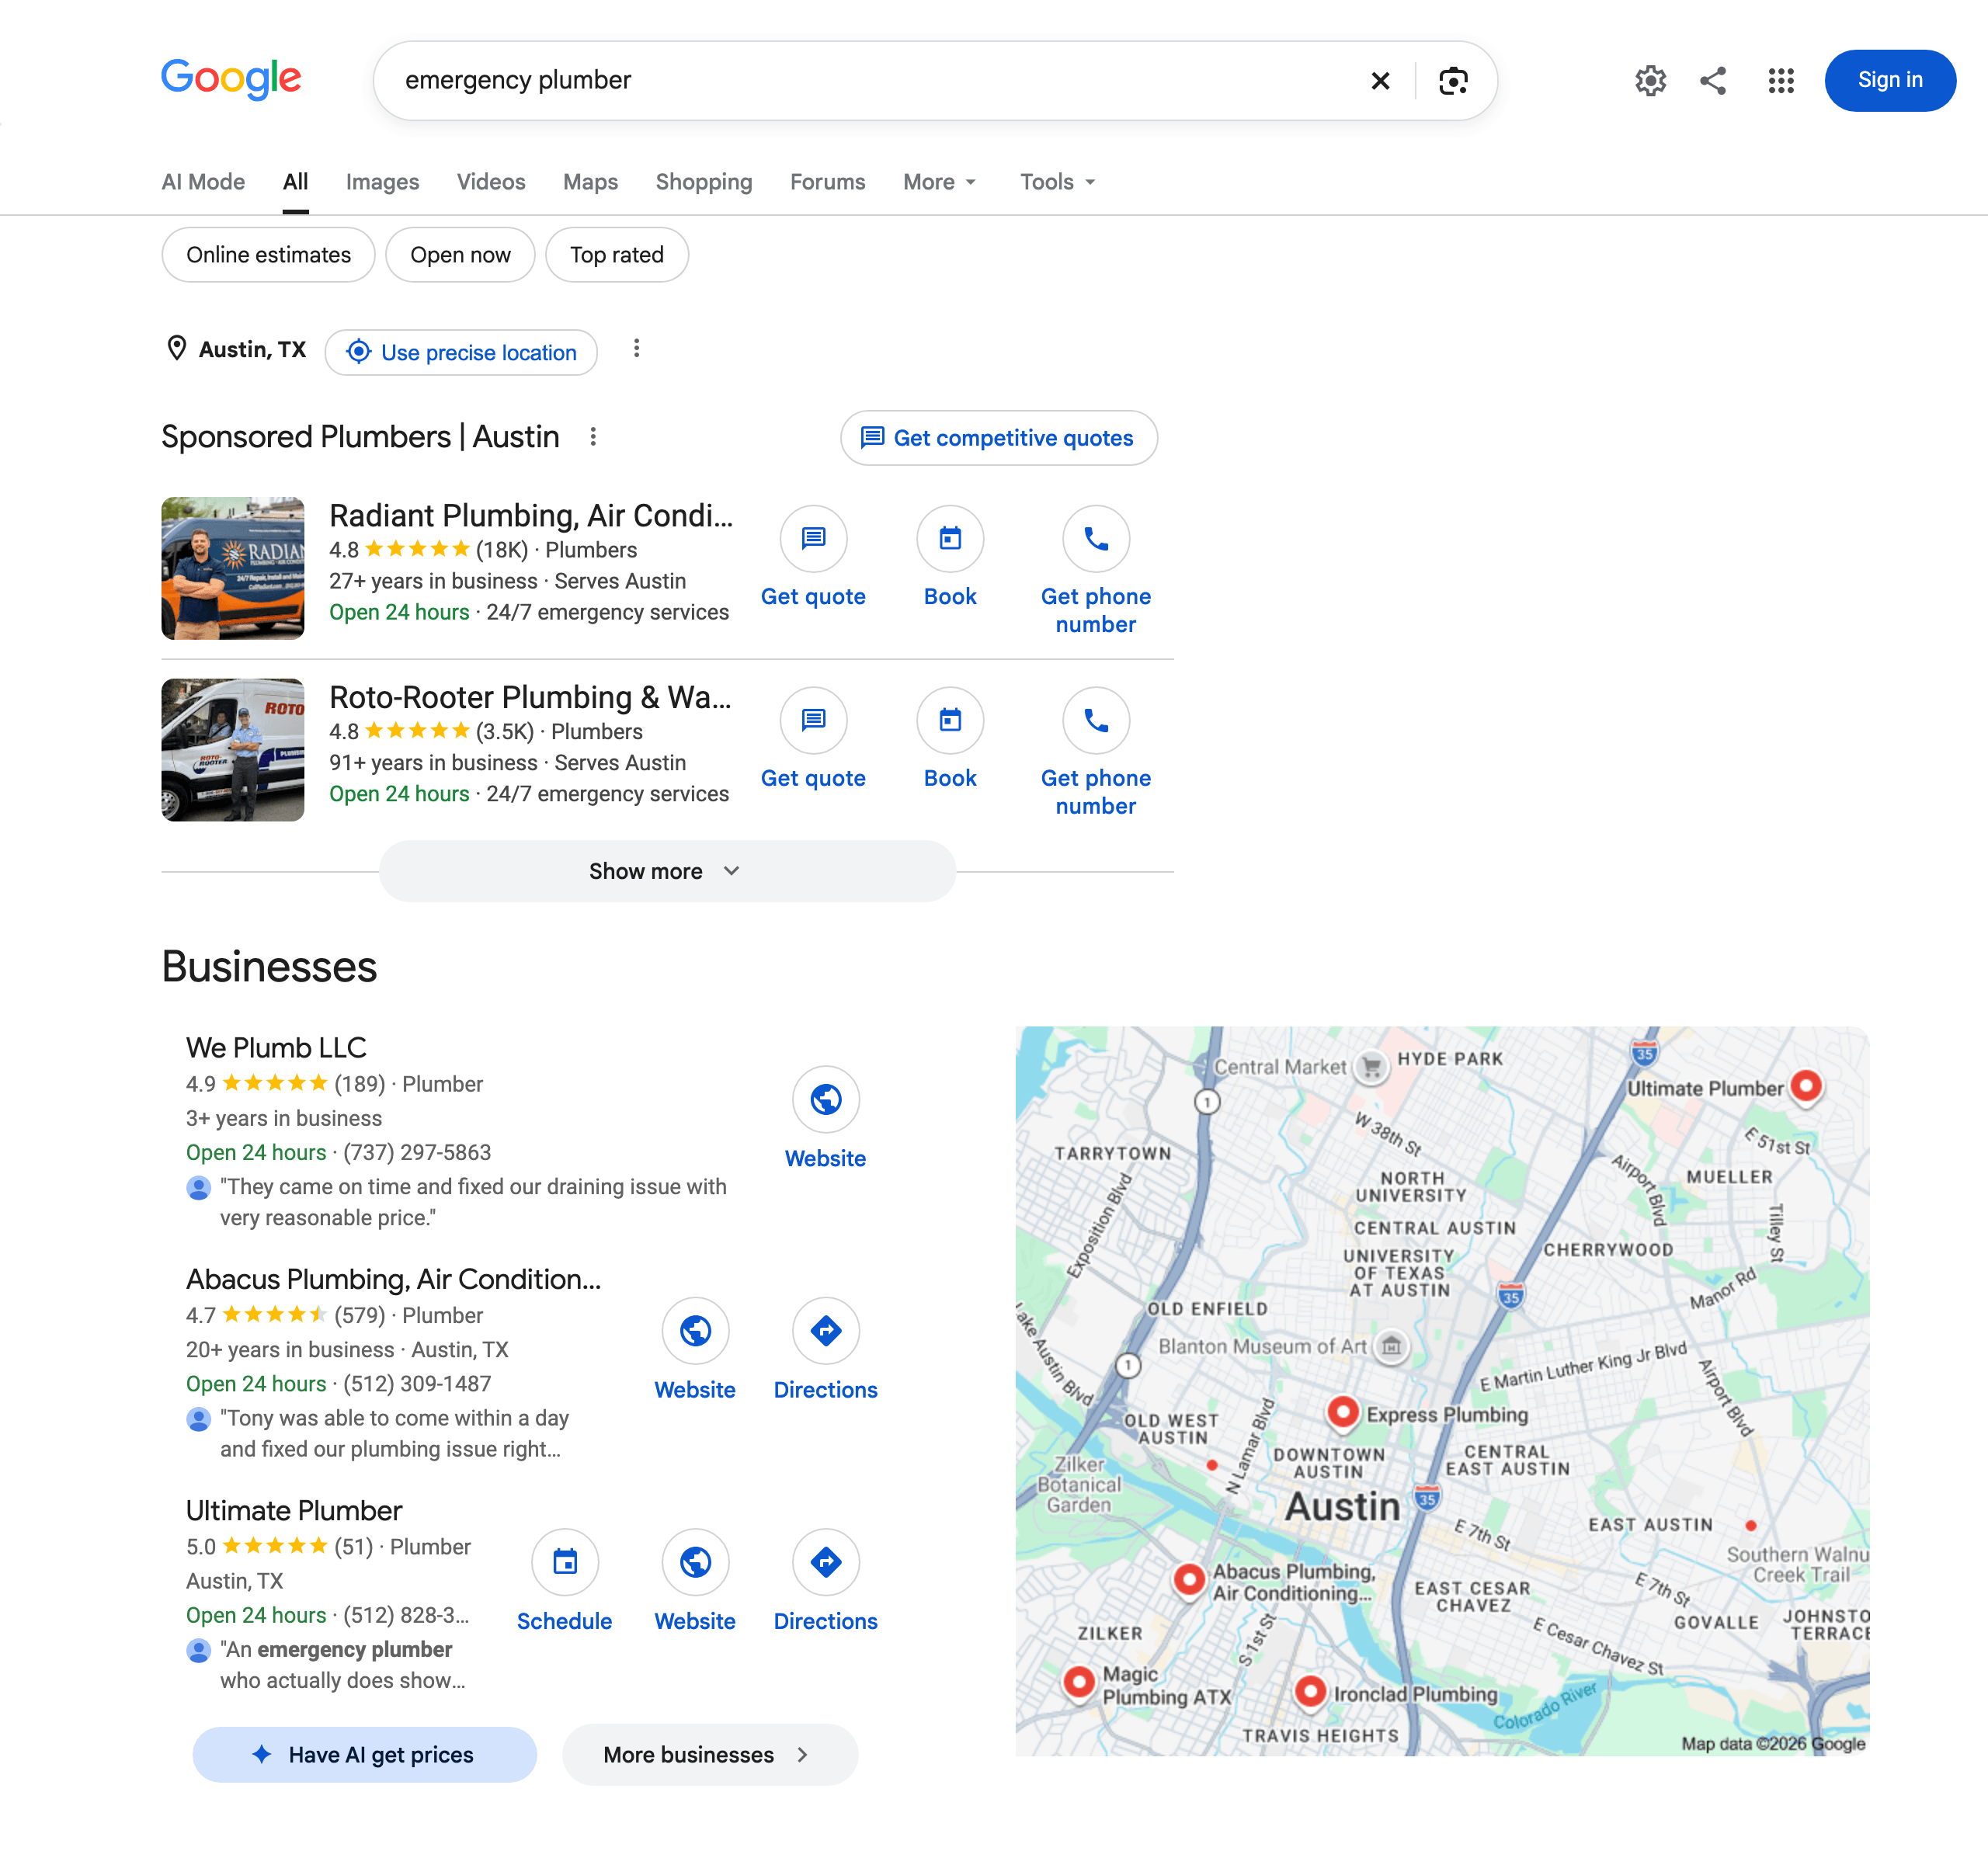
Gleiche Abfrage und Suchmaschine, keine gemeinsamen Unternehmen. Eine Einstellung auf Länderebene kann die Seite keiner der beiden Städte anfordern.
Für “dentist open saturday” mit dem Standort USA enthielten Parallels Ergebnisse eine Seite aus Los Angeles und eine Yelp-Suche für Port St. Lucie, Florida. Das Hinzufügen des Stadtnamens zum Abfragetext half Parallel, mehr von Googles lokalen Ergebnissen zu treffen. Mit dem hinzugefügten Stadtnamen zu jeder Abfrage lieferte der Advanced-Modus 39 der 107 URLs auf Googles stadtbasierten Seiten zurück. Parallels Auszüge nannten 4 der 27 Unternehmen in Googles Map Packs.
Mit dem Standort VAE, Vietnam oder Nigeria lieferte Parallel weiterhin Ergebnisse, plus eine Warnung, dass der Standort “derzeit nicht unterstützt wird. Der Standortparameter wird ignoriert.” Wenn Sie Parallel verwenden, prüfen Sie das Feld warnings, da für diese Ergebnisse kein Land angewendet wurde. Die SERP-API wendet das Land bei jeder Anfrage an, und dieselbe Abfrage lieferte lokale Map Packs in allen 3 Ländern zurück.
Stadtbasiertes Targeting in der SERP-API verwendet Googles uule-Parameter. Die SERP-API akzeptiert einen einfachen kanonischen Standortnamen, wie Chicago,Illinois,United States, ohne zusätzliche Kodierung. Fügen Sie der Such-URL brd_mobile=1 hinzu, um die mobile Ergebnisseite zu erhalten, da viele Rank-Tracker mobile und Desktop-Ergebnisse getrennt melden.
SERP-Features, die ein Suchindex nicht zurückliefert
Über die 30 Testabfragen hinweg zeigten Googles Seiten diese SERP-Features, und Parallels Index lieferte keines davon zurück:
| SERP-Feature | Abfragen, die es zeigten |
|---|---|
| People Also Ask | 21 von 30 |
| AI Overview | 15 von 30 |
| Video-Ergebnisse | 8 von 30 |
| Map Pack | 4 von 30 |
| Shopping-Ergebnisse | 4 von 30 |
| Anzeigen | 3 von 30 |
Ein Agent, der berichtet, was Google den Nutzern mitteilt, benötigt das AI Overview selbst. Das Overview für “best crm for small business” empfahl HubSpot, Pipedrive und Zoho und listete seine Quellen in einem Panel neben der Antwort auf:
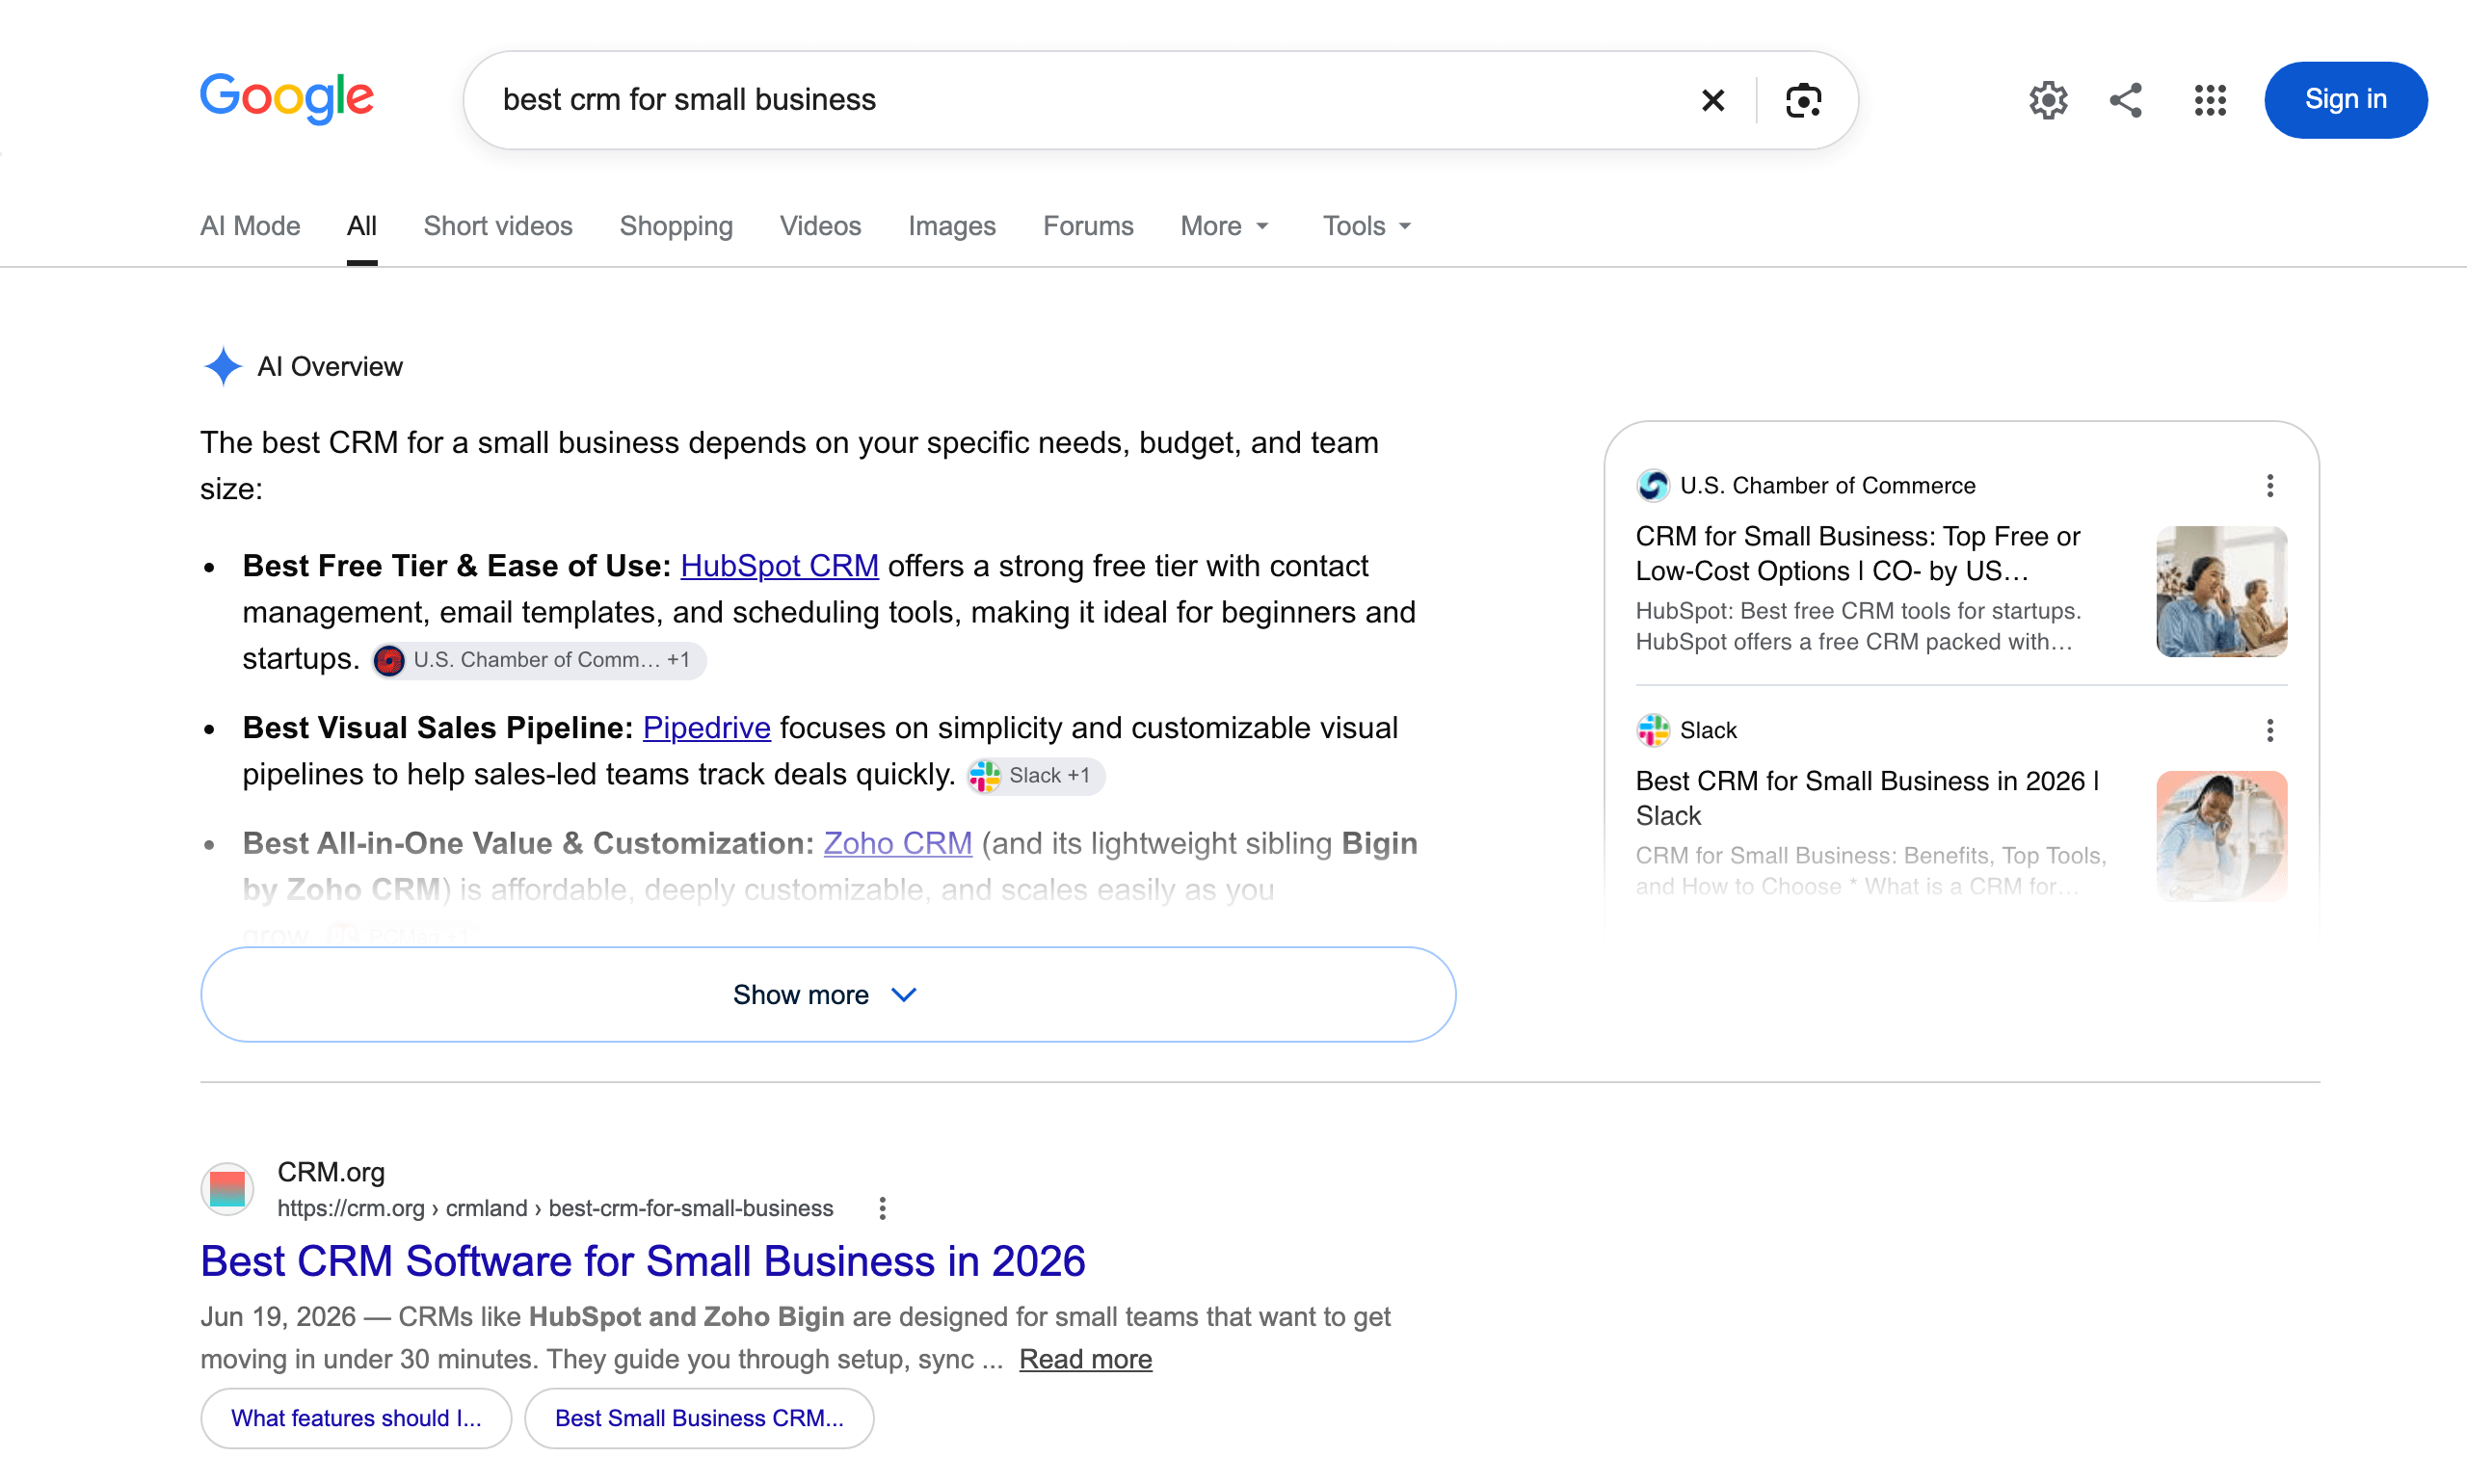
Google aktualisiert das Overview im Laufe der Zeit, sodass sich die Antwort zwischen den Durchläufen ändern kann.
Die 15 Overviews zitierten 64 Quellen, und Parallels Fast- und Advanced-Ergebnisse für dieselben Abfragen enthielten 7 davon. Etwa 9 von 10 Seiten, die Googles KI zitierte, waren nicht in Parallels Ergebnissen enthalten.
Die SERP-API mit brd_json=1 liefert die vollständige Seite als geparstes JSON zurück, mit dem Overview in einem ai_overview-Feld und seinen Quellen unter references. Ein Agent kann das Overview zitieren und prüfen, welche Seiten Google zitiert hat.
Live-SERP vs. Suchindex: Aktualität, zwischengespeicherte Kopien und blockierte Seiten
Die SERP-API ruft Googles Seite zum Zeitpunkt der Anfrage ab, sodass ihre Ergebnisse neue Meldungen enthalten, sobald Google sie anzeigt. Für 14 Nachrichtenmeldungen, die Google News als 20 Minuten bis 17 Stunden alt kennzeichnete, fragte ich Parallel mit Schlüsselbegriffen aus jeder Überschrift ab. Der Advanced-Modus lieferte die exakte Meldungs-URL für 9 von 14, darunter eine 55 Minuten zuvor veröffentlichte Meldung. Der Fast-Modus lieferte 6, und beide Modi zusammen fanden 10.
Die 14 Meldungen stammten über die SERP-API von Google News, mit tbm=nws für Nachrichtenergebnisse und tbs=qdr:d für den letzten Tag. Für die Nachrichtenüberwachung, bei der jede verpasste Meldung zählt, fragen Sie Google News auf dieselbe Weise ab.
Für vollständige Seiten lieferte Parallels Extract API Inhalte für 15 von 18 Einzelhandels-, Reise- und Angebotsseiten in 2,1 Sekunden oder weniger. Parallels Preisseite listete 1 bis 3 Sekunden für zwischengespeicherte Seiten und 60 bis 90 Sekunden für Live-Abrufe. Diese Zeitangabe passt zu zwischengespeicherten Kopien, und eine zwischengespeicherte Kopie kann den falschen Standort für Ihren Nutzer anzeigen.
Die von Extract zurückgelieferten Kopien zeigten einen Lieferstandort, der nicht angefragt wurde. Die Target-Seite zeigte “Ship to 51503 Council Bluffs” nahe dem oberen Rand, und die Walmart-Seite zeigte “Sacramento, 95829” an derselben Stelle. Wenn ein Agent Preise, Bestand oder Lieferzeiten für einen Nutzer in Austin zitiert, benötigt der Agent die Seite für den Standort dieses Nutzers. Die SERP-API akzeptiert bei jeder Anfrage das Land oder die Stadt, und Web Unlocker ruft die Seite zum Zeitpunkt der Anfrage aus dem von Ihnen gewählten Land ab.
Parallels Website beschrieb Parallel als unfähig, “eine Website zu erreichen, die sich entschieden hat, Sie zu blockieren”, und ohne Unblocker für diese Websites. Web Unlocker ist für Seiten mit Bot-Schutz konzipiert, und die Tools scrape_as_markdown und scrape_batch des MCP-Servers leiten Anfragen darüber.
Vollständige Seiten über den MCP-Server: Der Agent wählt, was er liest
Im Bright Data MCP-Server liefert search_engine Googles Ergebnisliste zurück. scrape_batch liefert dann die vom Agenten ausgewählten Seiten als vollständiges Markdown in einem einzigen Aufruf zurück. Ein API-Schlüssel und eine kostenlose Stufe funktionieren für beide Tools.
Die Ergebnisliste ist kompakt, mit Link, Titel und Beschreibung pro Ergebnis. Über die 30 Testabfragen hinweg hatte die Liste einen Median von etwa 720 Token mit dem o200k_base-Tokenizer. Parallel lieferte stattdessen bei jeder Suche Auszüge zurück. Eine Antwort mit 10 Ergebnissen hatte im Fast-Modus einen Median von 5.438 Token und im Advanced-Modus 4.082 Token.
Mit Auszügen fügt jede Suche den Auszugstext dem Kontext hinzu. Mit der kompakten Ergebnisliste fügen nur die vom Agenten geöffneten Seiten Seitentext hinzu. Der Agent entscheidet, wie viele Seiten er öffnet, und steuert so, wie viel Seitentext jede Antwort hinzufügt.
Vollständige Seiten behalten die Tabellen, Code-Blöcke und Preise, die ein Auszug möglicherweise auslässt. Teilen Sie lange Seiten in Abschnitte auf und behalten Sie die relevantesten, bevor das Modell die Antwort schreibt. Das Kontextfenster enthält dann, was die Frage benötigt.
Verbinden Sie den gehosteten MCP-Server und laden Sie nur die 2 Tools, die dieser Workflow verwendet. Jedes geladene Tool fügt seine Definition vor dem ersten Aufruf dem Kontext des Agenten hinzu, daher halten weniger Tools den Kontext klein.
Diese .mcp.json für Claude Code liest den Schlüssel aus der Umgebungsvariable BRIGHTDATA_API_KEY. Der Schlüssel wird nicht in der Datei gespeichert oder in protokollierten URLs angezeigt:
{
  "mcpServers": {
    "bright-data": {
      "type": "http",
      "url": "https://mcp.brightdata.com/mcp?tools=search_engine,scrape_batch",
      "headers": {
        "Authorization": "Bearer ${BRIGHTDATA_API_KEY}"
      }
    }
  }
}
Speichern Sie sie als .mcp.json im Stammverzeichnis Ihres Projekts. Clients, die benutzerdefinierte Header unterstützen, akzeptieren dieselbe URL und denselben Header in ihrem eigenen Konfigurationsformat. Beziehen Sie einen API-Schlüssel aus Ihren Bright Data Kontoeinstellungen. Die MCP-Tools-Referenz dokumentiert die Tools und Tool-Gruppen.
Beim Testen verpackte der gehostete Server die Ausgabe von search_engine und scrape_batch in Markierungen, die sie als nicht vertrauenswürdige Webdaten kennzeichnen. Die Markierungen weisen das Modell an, jede Seite als Daten statt als Anweisungen zu behandeln. Sie fügen eine zusätzliche Schutzschicht gegen Prompt Injection hinzu, die zusammen mit den eigenen Abwehrmechanismen des Agenten funktioniert.
Wann Sie Bright Data oder Parallel wählen sollten
Die richtige Wahl hängt von der Aufgabe ab, die das Suchtool innerhalb Ihres Agenten erfüllt.
Wählen Sie Bright Data, wenn der Agent die Live-Ergebnisseite oder die vollständige Seite benötigt:
- Was Google zum Zeitpunkt der Anfrage anzeigt, einschließlich Rankings, AI Overviews, People Also Ask, Anzeigen, Shopping-Ergebnissen und dem Map Pack
- Ergebnisse für ein bestimmtes Land oder eine Stadt
- Suchmaschinen über Google hinaus, wie Bing, Baidu, Yandex und Naver
- Hochvolumige Batch-Jobs, mit unbegrenzter Parallelität bei Scale-Plänen
- Vollständige Seiten über Web Unlocker, konzipiert für bot-geschützte Websites, mit demselben Schlüssel wie die Suche
Wählen Sie Parallel, wenn der Agent gerankte Auszüge zum Beantworten benötigt:
- Gerankte Seiten mit Auszügen in einem einzigen Aufruf
- Latenzarme Turbo- und Fast-Modi
- Ein niedriger Preis pro Suche in Turbo und Fast
- Offene Rechercheanfragen, bei denen Googles Ranking keine Rolle spielt
Manche Agenten erfüllen beide Aufgaben. In diesem Fall verpacken Sie beide in einem einzigen Suchtool, das jede Abfrage nach Absicht weiterleitet. Lokale, kommerzielle und “was zeigt Google”-Fragen gehen an die SERP-API, offene Rechercheanfragen gehen an Parallel. Derselbe Wrapper ist ein guter Ort, um jeden Aufruf zu protokollieren und Ausgabenlimits festzulegen.
Manche Fragen benötigen keine Suche. Wenn der Agent dieselben bekannten Seiten nach einem Zeitplan prüft, wie eine Preisseite jeden Morgen, rufen Sie diese direkt über Web Unlocker ab. Ein direkter Abruf vermeidet die Bezahlung derselben Suche bei jeder Prüfung.
Beide starten kostenlos. Die SERP-API bietet eine wiederkehrende monatliche kostenlose Stufe ohne erforderliche Kreditkarte. Parallel bot beim Testen 5 $ an Guthaben pro Monat.
Testmethodik
Die Überschneidungs- und SERP-Feature-Ergebnisse stammen aus einem Aufbau:
- Dieselben 30 Abfragen, in 6 Gruppen, gingen über die SERP-API an Google und an alle 4 Parallel-Modi.
- Der Standort war auf die USA eingestellt, und Google lieferte englische Desktop-Ergebnisse zurück.
- Jede Abfrage war Parallels Ziel und ihre einzige Suchabfrage.
- Der Vergleich verwendete die obersten 10 URLs jeder API, nach Entfernung von Tracking-Tags wie Googles
srsltid. - Jeder Überschneidungswert ist der durchschnittliche Anteil pro Abfrage in einem Durchlauf. Advanced und Fast liefen zweimal, Turbo und Basic einmal, einige Stunden später.
- Die SERP-Feature-Zählungen stammen aus dem ersten Durchlauf. Im zweiten Durchlauf enthielten Parallels Ergebnisse 6 der 61 Quellen, die die AI Overviews zitierten.
Überschneidung mit Google bei Ihren eigenen Abfragen messen
Parallels Überschneidung mit Google hängt von den Abfragen ab. Stichproben Sie 100 oder mehr Abfragen aus den Protokollen Ihres Agenten, unterteilt nach Typ wie lokal, kommerziell und technisch. Protokollierte Abfragen enthalten die Vielfalt, die handgeschriebene Testabfragen vermissen lassen. Verwenden Sie die kostenlose Stufe der SERP-API für den Google-Teil des Tests.
Bevor Sie das Skript ausführen, besorgen Sie sich einen Parallel-API-Schlüssel und den Namen Ihrer SERP-API-Zone. Eine Zone ist die benannte Produktkonfiguration, die jede Bright Data-Anfrage angibt. Um eine hinzuzufügen, öffnen Sie das Bright Data Control Panel und wählen Sie Create API > SERP API. Kopieren Sie den Zonennamen aus dessen Overview-Tab:
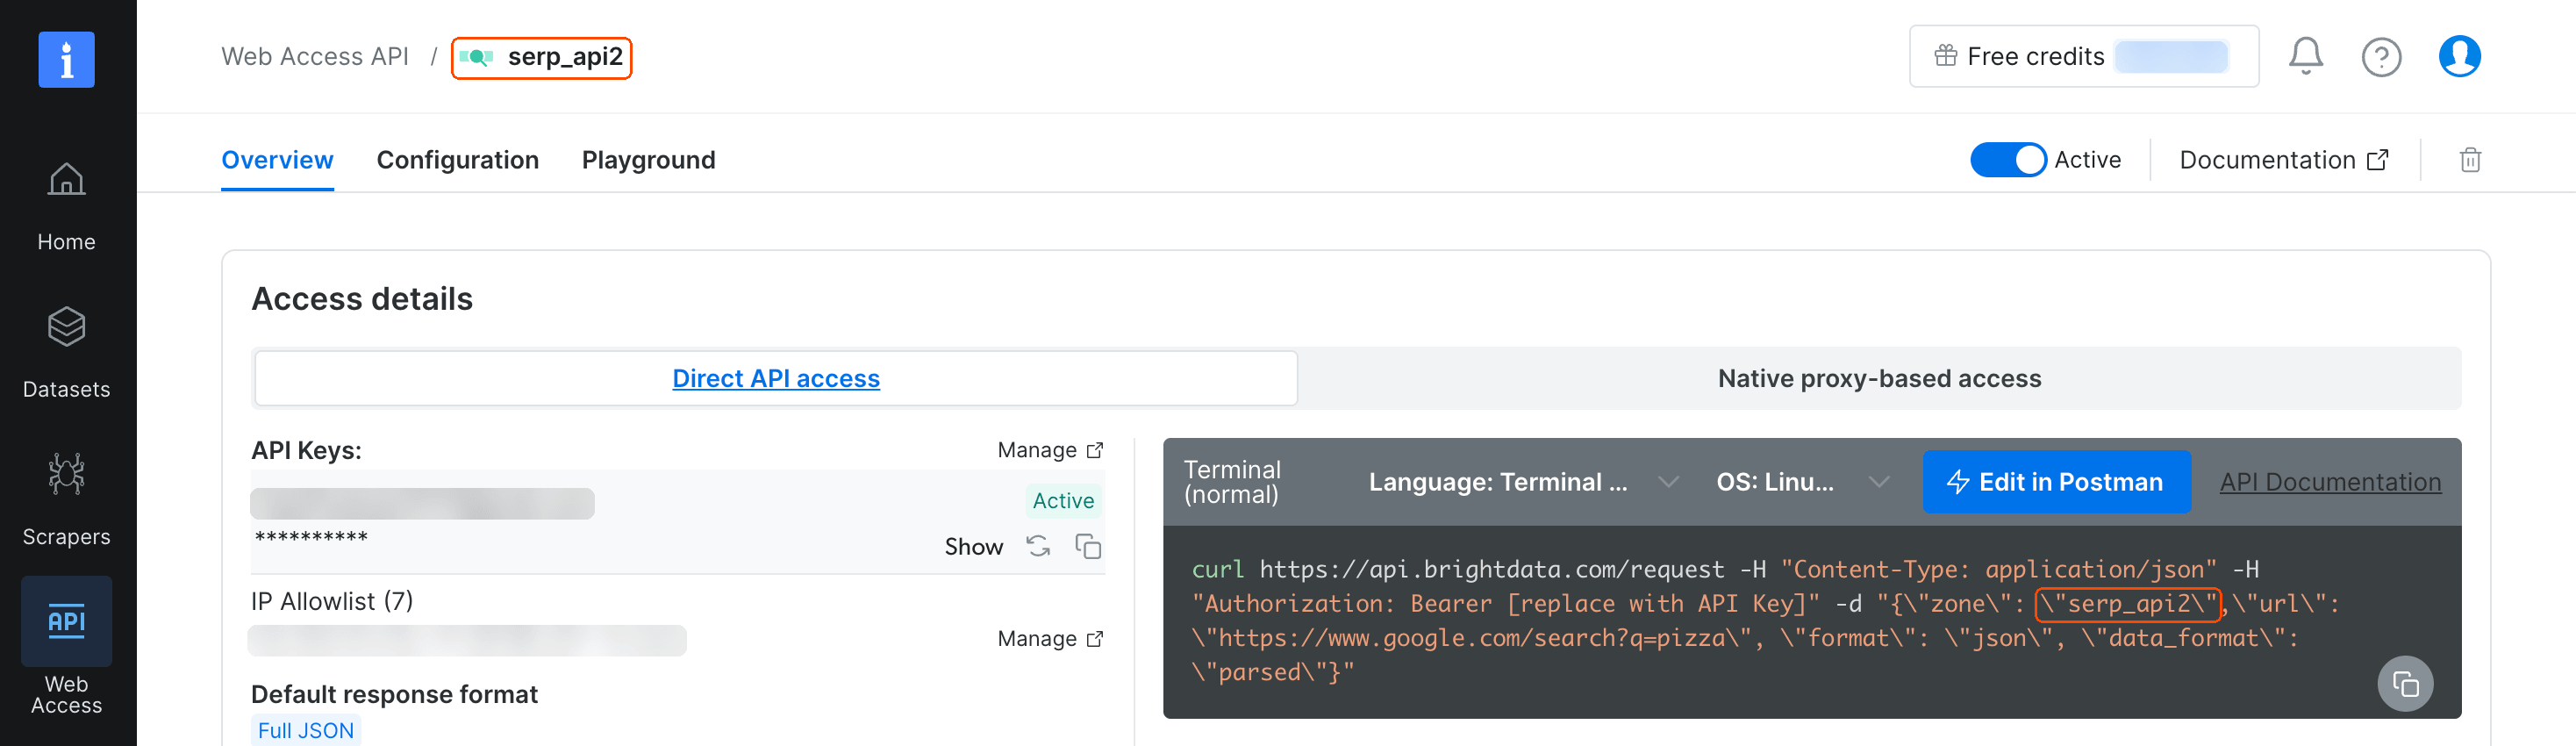
Der API-Schlüssel stammt vom Manage-Link auf derselben Seite.
Speichern Sie dieses Skript als overlap_check.py. Es akzeptiert Abfragen als Argumente und gibt aus, wie viele von Googles Top-URLs auch in Parallels Top 10 erscheinen:
# /// script
# requires-python = ">=3.9"
# dependencies = ["requests"]
# ///
# Gibt aus, wie viele von Googles Top-10-URLs (von der Bright Data SERP-API)
# auch in Parallels Top 10 erscheinen. Benötigt BRIGHTDATA_API_KEY,
# BRIGHTDATA_SERP_ZONE und PARALLEL_API_KEY in der Umgebung.
import json
import os
import sys
import time
import urllib.parse
from concurrent.futures import ThreadPoolExecutor

import requests
from requests.adapters import HTTPAdapter
from urllib3.util import Retry

BRIGHTDATA_API_KEY = os.environ["BRIGHTDATA_API_KEY"]
BRIGHTDATA_SERP_ZONE = os.environ["BRIGHTDATA_SERP_ZONE"]
PARALLEL_API_KEY = os.environ["PARALLEL_API_KEY"]
MODE = os.environ.get("PARALLEL_MODE", "advanced")
# Optionaler kanonischer Standortname, z.B. "Chicago,Illinois,United States"
LOCATION = os.environ.get("GOOGLE_LOCATION", "")


session = requests.Session()
# Wiederholt 429 (zu viele Anfragen) und wartet so lange, wie Retry-After verlangt
session.mount("https://", HTTPAdapter(max_retries=Retry(
    total=3, status_forcelist=[429], allowed_methods=None,
    backoff_factor=1, raise_on_status=False)))


def post(url, headers, body, timeout):
    resp = session.post(url, headers=headers, json=body, timeout=timeout)
    resp.raise_for_status()
    return resp


def key(url):
    # Vergleicht URLs ohne Schema, "www.", Fragment, abschließenden Schrägstrich oder
    # Tracking-Tags wie Googles srsltid, die zwischen Anfragen variieren können
    parts = urllib.parse.urlsplit(url.lower().split("#")[0])
    query = urllib.parse.urlencode(
        [(k, v) for k, v in urllib.parse.parse_qsl(parts.query)
         if not k.startswith(("utm", "srsltid"))])
    host = parts.netloc.removeprefix("www.")
    return (host + parts.path).rstrip("/") + ("?" + query if query else "")


def google_top10(query):
    params = {"q": query, "gl": "us", "hl": "en", "brd_json": "1"}
    if LOCATION:
        params["uule"] = LOCATION
    body = {"zone": BRIGHTDATA_SERP_ZONE, "format": "raw",
            "url": "https://www.google.com/search?"
                   + urllib.parse.urlencode(params)}
    headers = {"Authorization": f"Bearer {BRIGHTDATA_API_KEY}"}
    resp = post("https://api.brightdata.com/request", headers, body, 120)
    # Bright Data meldet den Anfragestatus im x-brd-error-Header
    if resp.headers.get("x-brd-error"):
        raise RuntimeError(resp.headers["x-brd-error"])
    serp = resp.json()
    # Bestätigt, dass Google den Standort angewendet hat, bevor die Ergebnisse verwendet werden
    city = LOCATION.split(",")[0]
    applied = serp.get("general", {}).get("location", "")
    if city and not applied.startswith(city):
        raise RuntimeError(f"Google hat den Standort {LOCATION} nicht angewendet")
    return [r["link"] for r in serp.get("organic", [])][:10]


def parallel_top10(query):
    body = {"objective": query, "search_queries": [query], "mode": MODE,
            "advanced_settings": {"location": "us", "max_results": 10}}
    resp = post("https://api.parallel.ai/v1/search",
                {"x-api-key": PARALLEL_API_KEY}, body, 60)
    return [r["url"] for r in resp.json()["results"]][:10]


def with_retries(fetch, query, attempts=3, pause=15):
    # Wiederholt beide APIs einige Male, mit einer Pause zwischen den Versuchen
    for attempt in range(attempts):
        try:
            return fetch(query)
        except (RuntimeError, requests.RequestException) as err:
            # Eine 4xx-Antwort bedeutet, dass die Anfrage selbst behoben werden muss
            response = getattr(err, "response", None)
            if response is not None and response.status_code < 500:
                raise
            if attempt == attempts - 1:
                raise
            time.sleep(pause)


def compare(query):
    google = with_retries(google_top10, query)
    parallel = with_retries(parallel_top10, query)
    shared = {key(u) for u in google} & {key(u) for u in parallel}
    return {"query": query, "mode": MODE, "location": LOCATION,
            "shared": len(shared), "total": len({key(u) for u in google}),
            "google": google, "parallel": parallel}


def safe_compare(query):
    # Behält die Ergebnisse der anderen Abfragen, wenn eine Abfrage fehlschlägt
    try:
        return compare(query)
    except (RuntimeError, requests.RequestException) as err:
        return {"query": query, "error": str(err)}


# Abfragen kommen aus den Argumenten oder eine pro Zeile von stdin
queries = sys.argv[1:] or [line.strip() for line in sys.stdin if line.strip()]
# Führt die Abfragen gleichzeitig aus und gibt die Ergebnisse in Eingabereihenfolge aus
with ThreadPoolExecutor(max_workers=8) as pool:
    results = list(pool.map(safe_compare, queries))
# Behält die rohen URLs, damit die Ergebnisse ohne neue Anfragen neu bewertet werden können
with open("overlap_results.jsonl", "a") as f:
    f.writelines(json.dumps(r) + "\n" for r in results)
ok = [r for r in results if "error" not in r]
for r in results:
    if "error" in r:
        print(f"Fehler ({r['error']}): {r['query']}")
    else:
        print(f"{r['shared']}/{r['total']} von Googles Top-URLs auch in "
              f"Parallel ({MODE}): {r['query']}")
mean = sum(r["shared"] / max(r["total"], 1) for r in ok) / max(len(ok), 1)
noun = "Abfrage" if len(ok) == 1 else "Abfragen"
print(f"Durchschnitt über {len(ok)} {noun}: {mean:.0%} von Googles Top-"
      "URLs auch in Parallel")
Das Skript besteht aus 6 Teilen:
google_top10ruft Googles erste Seite über die SERP-API mitbrd_json=1ab und prüft, ob Google den Standort angewendet hat.parallel_top10sendet dieselbe Abfrage an Parallels Search API im von Ihnen gewählten Modus.keynormalisiert jede URL, sodass dieselbe Seite übereinstimmt, auch wenn sich Tracking-Tags unterscheiden.with_retrieswiederholt beide APIs einige Male, mit einer Pause zwischen den Versuchen.comparezählt die geteilten URLs pro Abfrage, und die letzten Zeilen geben die Ergebnisse aus und speichern die rohen URLs.safe_compareerfasst den Fehler, wenn eine Abfrage fehlschlägt, sodass die Ergebnisse der anderen Abfragen erhalten bleiben.
Übergeben Sie Abfragen als Argumente, oder leiten Sie eine Datei mit einer Abfrage pro Zeile in das Skript. uv installiert beim ersten Durchlauf requests aus dem Header des Skripts. Ohne uv installieren Sie requests in einer virtuellen Umgebung und führen Sie das Skript mit python statt uv run aus. Legen Sie den Zonennamen und beide API-Schlüssel fest und führen Sie dann das Skript aus:
export BRIGHTDATA_API_KEY="ihr-bright-data-api-schluessel"
export BRIGHTDATA_SERP_ZONE="ihr-serp-zonenname"
export PARALLEL_API_KEY="ihr-parallel-api-schluessel"
uv run overlap_check.py "best crm for small business" \
  "postgres jsonb index performance" "dentist open saturday"
# Um stattdessen eine Abfrage pro Zeile aus einer Datei zu lesen, führen Sie aus:
# uv run overlap_check.py < queries.txt
# Um einen anderen Parallel-Modus zu testen, legen Sie ihn zuerst fest, zum Beispiel:
# export PARALLEL_MODE=fast
Wenn eine Zeile einen 4xx-Fehler zeigt, überprüfen Sie den Zonennamen und beide API-Schlüssel. Für diese 3 Abfragen druckte ein Durchlauf:
2/9 von Googles Top-URLs auch in Parallel (advanced): best crm for small business
4/9 von Googles Top-URLs auch in Parallel (advanced): postgres jsonb index performance
1/9 von Googles Top-URLs auch in Parallel (advanced): dentist open saturday
Durchschnitt über 3 Abfragen: 26% von Googles Top-URLs auch in Parallel
Die letzte Zeile mittelt den Anteil pro Abfrage, dasselbe Maß wie die Überschneidungstabelle. Die 9 in jeder Zeile ist die Anzahl der organischen Ergebnisse auf Googles erster Seite für diese Abfrage. Ergebnisse ändern sich zwischen den Durchläufen, und die Postgres-Abfrage teilte 0 bis 6 URLs über 9 Durchläufe hinweg. Stützen Sie eine Entscheidung auf viele Abfragen und führen Sie jede Abfrage mehr als einmal aus.
Jeder Durchlauf hängt außerdem die rohen URLs an overlap_results.jsonl an. Sie können diese Ergebnisse später neu bewerten, zum Beispiel mit einer anderen URL-Abgleichsregel, ohne für neue Anfragen zu bezahlen. Wenn sich Ihr Agent oder sein Traffic ändert, führen Sie die Prüfung erneut mit einer neuen Stichprobe aus Ihren Protokollen durch.
Legen Sie GOOGLE_LOCATION auf einen kanonischen Standortnamen fest, um die Prüfung für eine einzelne US-Stadt auszuführen:
GOOGLE_LOCATION="Chicago,Illinois,United States" \
  uv run overlap_check.py "emergency plumber"
Mit Chicago druckte das Skript:
0/9 von Googles Top-URLs auch in Parallel (advanced): emergency plumber
Durchschnitt über 1 Abfrage: 0% von Googles Top-URLs auch in Parallel
Fügen Sie bei offenen Rechercheabfragen, bei denen Googles Ranking keine Rolle spielt, 2 weitere Prüfungen zum Überschneidungsmaß hinzu. Prüfen Sie, ob die abgerufenen Seiten die für die Antwort benötigten Belege enthalten und ob die Antwort vollständig ist. Verwenden Sie einen LLM-Richter mit einer schriftlichen Bewertungsrichtlinie und prüfen Sie den Richter anhand einer Stichprobe menschlicher Bewertungen.
Abschließende Gedanken
Bright Datas SERP-API liefert die Seite zurück, die eine Person in einer bestimmten Stadt sehen würde, mit Features wie dem Map Pack und AI Overview. Bei 30 zweimal durchgeführten Abfragen lieferte Parallels Advanced-Modus 35 bis 43 % von Googles erster-Seite-URLs zurück, sodass Ihre Wahl beeinflusst, was Ihr Agent liest.
Für vollständige Seiteninhalte ruft der MCP-Server Seiten mit demselben API-Schlüssel über Web Unlocker ab, der für Websites mit Bot-Schutz konzipiert ist. Parallels gerankte Auszüge eignen sich gut für offene Rechercheanfragen, bei denen Googles Ranking keine Rolle spielt. Führen Sie das Überschneidungsskript mit der kostenlosen Stufe der SERP-API auf den protokollierten Abfragen Ihres Agenten aus und verbinden Sie dann den MCP-Server mit Ihrem Agenten.
FAQ
Was ist Parallel Web Search?
Parallel Web Search ist eine Search API, die Parallel Web Systems für KI-Agenten entwickelt hat. Sie beantwortet Abfragen aus ihrem eigenen Web-Index mit gerankten URLs und Markdown-Auszügen, in mehreren Geschwindigkeits- und Qualitätsmodi. Bright Datas SERP-API liefert stattdessen Googles Live-Ergebnisseite für ein gewähltes Land oder eine Stadt zurück.
Ist die Parallel-Suche kostenlos?
Teilweise. Parallels Preisseite listete beim Testen 5 $ an kostenlosem Guthaben pro Monat auf, genug für bis zu 5.000 Turbo- oder Fast-Suchen. Das Guthaben erforderte eine hinterlegte Kreditkarte, und Parallels gehostetes Search MCP war ohne API-Schlüssel kostenlos. Bright Datas SERP-API beinhaltet eine wiederkehrende monatliche kostenlose Stufe, ohne erforderliche Kreditkarte.
Wie viel kostet die Parallel Search API?
Parallels Preisseite listete beim Testen 1 $ pro 1.000 Anfragen für Turbo und Fast sowie 5 $ pro 1.000 für Basic und Advanced auf. Jeder Preis beinhaltete 10 Ergebnisse, zusätzliche Ergebnisse kosteten 1 $ pro 1.000. Parallels Extract API kostete 1 $ pro 1.000 URLs. Bright Datas SERP-API ist Self-Service und berechnet nur erfolgreiche Anfragen, mit aktuellen Plänen auf der Preisseite.
Ist Bright Data oder Parallel besser für KI-Agenten?
Keine der beiden APIs ist für jede Aufgabe besser. Wählen Sie Bright Data, wenn der Agent Googles Live-Ergebnisseite, stadtbasiertes Targeting, AI Overviews oder Seiten mit Bot-Schutz benötigt. Wählen Sie Parallel, wenn Googles Ranking keine Rolle spielt, wie bei offenen Rechercheanfragen. Bei 30 zweimal durchgeführten Testabfragen lieferte Parallels Advanced-Modus 35 bis 43 % von Googles erster-Seite-URLs zurück.
Welche API ist die beste für die Websuche?
Für Agenten, die Googles Ergebnisseite benötigen, verwenden Sie eine SERP-API wie die von Bright Data. Sie liefert die Live-Ergebnisseite mit stadtbasiertem Targeting und SERP-Features wie AI Overviews zurück. Für offene Recherche liefert eine Index-API wie Parallel für ein Ziel gerankte Auszüge zurück.