TL;DR
Ein KI-Agent kann ein Bright Data-Konto erstellen und ein funktionierendes API-Token erhalten, ohne dass ein Mensch ein Anmeldeformular ausfüllt. Das Protokoll liegt unter https://brightdata.com/auth.md und wird in Discovery-Metadaten unter einem agent_auth-Block beworben.
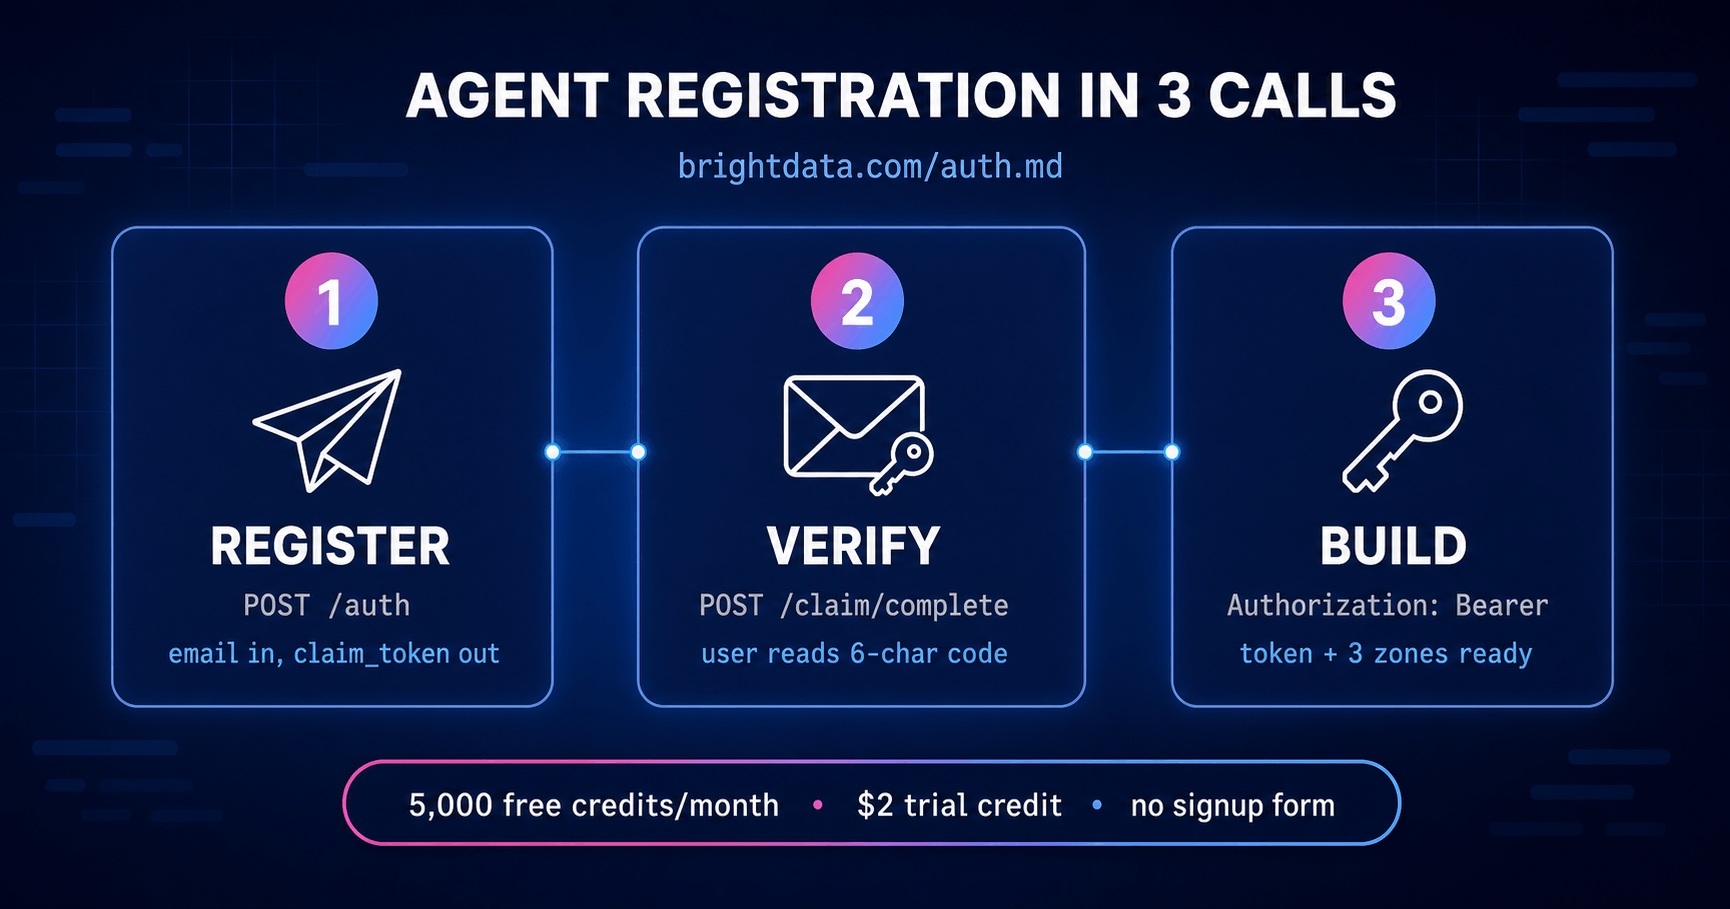
Drei Aufrufe:
POST /users/auth/agent_registration/authmit der E-Mail-Adresse des Nutzers. Gibt einclaim_tokenzurück. Noch keine Anmeldeinformation.- Der Nutzer liest einen 6-stelligen Code aus seinem Postfach und gibt ihn dem Agenten.
POST /users/auth/agent_registration/claim/completemit demclaim_tokenund dem Code. Gibt das API-Token zurück.
Das Konto startet mit 5.000 kostenlosen Credits pro Monat, einem 7 Tage gültigen Testguthaben von 2 $ und drei vorab erstellten Zonen: agent_serp, agent_unlocker, agent_browser_api. Der erste Aufruf einer davon funktioniert ohne jede Einrichtung.
Das Problem
Jedes Anmeldeformular setzt einen Menschen voraus. Einen Plan auswählen, einen Bestätigungslink anklicken, ein Dashboard öffnen, Einstellungen finden, einen Schlüssel kopieren, ihn irgendwo einfügen.
Das bricht zusammen, wenn das Ding, das den Schlüssel braucht, ein Agent ist. Ein Coding-Agent, der Preise von 40 Händlern abrufen soll, kann den Scraper schreiben, Wiederholungen handhaben und die Ausgabe parsen. Er kann keinen Button in einem Browser klicken, den er nicht hat.
Also stoppt er bei Schritt null. Und der Stopp ist schwerwiegender, als es aussieht, denn das Hindernis ist keine Frage der Fähigkeit.
Der Agent darf nicht, auch wenn er könnte
Der naheliegende Einwand ist, dass Browser-Automatisierung das löst. Gib dem Agenten eine Chrome-Erweiterung oder eine Playwright-Sitzung und er kann ein Anmeldeformular ausfüllen wie jeder andere.
Er kann es. Er darf es nicht.
Anthropics Browser-Agenten ist es untersagt, im Namen eines Nutzers Konten zu erstellen. Das ist keine sanfte Präferenz und kein Berechtigungshinweis. Kontoerstellung steht auf der verbotenen Liste neben der Handhabung von Bankdaten und dem Durchführen dauerhafter Löschungen, was bedeutet, dass sie verweigert wird, selbst wenn der Nutzer ausdrücklich darum bittet und Erlaubnis erteilt. Die Anweisung lautet, den Nutzer anzuweisen, das Konto selbst zu erstellen.
Zwei weitere Regeln machen ein Anmeldeformular selbst ohne diese eine praktisch unbrauchbar. Claude respektiert Bot-Erkennung und Systeme zur menschlichen Verifizierung und löst diese nicht im Namen eines Nutzers. Und das Akzeptieren von Bedingungen, Konditionen oder Vereinbarungen erfordert jedes Mal eine ausdrückliche Nutzerzustimmung, gemäß Anthropics veröffentlichter Sicherheitsdokumentation. Ein Standard-Anmeldeformular verlangt von einem Agenten alle drei gleichzeitig: ein Konto erstellen, ein CAPTCHA lösen und eine Nutzungsbedingung akzeptieren.
Das ist eine vernünftige Grenze. Ein Agent, der still Konten gegen beliebige E-Mail-Adressen registrieren kann, ist eine Missbrauchsmaschine. Die Einschränkung besteht aus guten Gründen und wird nicht gelockert werden.
Die Konsequenz für einen Datenanbieter ist konkret. Ein Anmeldeformular ist für einen Agenten kein langsamer Weg. Es ist ein geschlossener. Dem Agenten einen Browser zu geben hilft nicht, denn der Browser war nie das Hindernis.
auth.md platziert die Zustimmung dort, wo die Richtlinie sie braucht. Der Ablauf verlangt vom Agenten nie, einen Menschen vorzutäuschen. Der Agent macht HTTP-Aufrufe. Der Mensch holt einen Einmalcode aus seinem eigenen Postfach und gibt ihn weiter. Das Konto kann nicht ohne die aktive Mitwirkung des Nutzers erstellt werden, daher kann dem Nutzer nicht entgehen, dass es passiert ist. Der Agent ist ein Client, kein Stellvertreter.
Deshalb ist der OTP-Schritt Teil des Protokolls und wurde nicht wegtechnisiert. Er ist keine übrig gebliebene Reibung aus einem menschlichen Anmeldeablauf. Er ist der Zustimmungsmechanismus, und er ist es, was dies zu etwas macht, das ein Agent erledigen darf, statt nur erledigen zu können.
Wie ein Agent es findet
Ein Agent, der Bright Data nie zuvor gesehen hat, kann den Ablauf über Standard-Metadaten erreichen.
GET https://brightdata.com/.well-known/oauth-authorization-serverDie Antwort trägt einen agent_auth-Block:
{
  "agent_auth": {
    "skill": "https://brightdata.com/auth.md",
    "register_uri": "https://brightdata.com/users/auth/agent_registration/auth",
    "claim_uri": "https://brightdata.com/users/auth/agent_registration/claim",
    "identity_types_supported": ["identity_assertion"],
    "identity_assertion": {
      "assertion_types_supported": ["verified_email"],
      "credential_types_supported": ["api_key"]
    }
  }
}
Dieser Block ist der Vertrag. github_token und anonymous werden dort erscheinen, falls und wenn sie veröffentlicht werden. Verwende nur die Methoden, die die Metadaten auflisten, nicht Methoden aus einer älteren Kopie des Dokuments.
Es gibt auch geschützte Ressourcen-Metadaten für die API:
GET https://api.brightdata.com/.well-known/oauth-protected-resource{
"resource": "https://api.brightdata.com/",
"resource_name": "Bright Data API",
"authorization_servers": ["https://brightdata.com"],
"scopes_supported": ["serp", "unlocker", "wsapi", "scraper_studio",
"discover", "browser", "usage:read"],
"bearer_methods_supported": ["header"]
}Die Endpunkte dokumentieren sich zur Laufzeit selbst. GET https://brightdata.com/users/auth/agent_registration gibt eine maschinenlesbare Markdown-Kopie der Endpunktverträge und der Fehlertabelle zurück. Falls diese Antwort und auth.md jemals voneinander abweichen, ist die Endpunktantwort die aktuelle Wahrheit. Sie kann unabhängig abgeschaltet werden, in welchem Fall sie instructions_disabled mit einem 404 zurückgibt und der Agent auf auth.md zurückfällt.
Vier Wege hinein
Programmatische Registrierung ist der vollständig automatisierte Weg. Es ist nicht der einzige.
| Weg | Was der Mensch tut | Verwenden wenn |
|---|---|---|
| E-Mail-Registrierung | Liest einen Code aus seinem Postfach | Der Agent braucht eine eigene Anmeldeinformation und es gibt keine Browser-Sitzung |
| API-Token | Fügt einmal ein Token ein | Der Nutzer hat bereits ein Konto. Token von https://brightdata.com/cp/setting/users |
| Gehostetes MCP mit OAuth | Schließt OAuth in einem Browser ab | Ein Browser ist verfügbar. Verbindung zu https://mcp.brightdata.com/mcp |
| CLI-Login | Klickt durch Browser- oder Geräte-Flow | Terminal-Kontext. npx @brightdata/cli login, oder brightdata login --github, falls die GitHub-CLI authentifiziert ist |
Der Rest dieser Anleitung behandelt den ersten Weg.
Schritt 1: Entdecken
Lies die Metadaten des Autorisierungsservers und bestätige, welche Assertion-Typen aktiv sind. Heute ist das nur verified_email.
curl https://brightdata.com/.well-known/oauth-authorization-serverSchritt 2: Registrieren
Verwende die echte Postfachadresse des Nutzers. Wegwerfdomains und Plus-Alias-Adressen wie [email protected] werden abgelehnt.
curl -X POST https://brightdata.com/users/auth/agent_registration/auth \
  -H "Content-Type: application/json" \
  -d '{
    "type": "identity_assertion",
    "assertion_type": "verified_email",
    "assertion": "[email protected]",
    "client": "claude-code"
  }'
client ist optional, aber empfohlen. Die Angabe des Agentennamens, bis zu 100 Zeichen, gibt Support und Diagnose etwas, womit sie arbeiten können.
Die Antwort enthält keine Anmeldeinformation:
{
  "claim_token": "<uuid-v4>",
  "state": "pending",
  "otp_expires_at": "<ISO 8601 timestamp>",
  "claim_token_expires_at": "<ISO 8601, 24 hours from registration by default>"
}
claim_token ist eine UUID v4 und ist die eigene Kennung der Registrierung. Es gibt keine separate registration_id. Behalte sie im Speicher und übergib sie Schritt 3 unverändert.
Bevor eine Nutzeridentität gesendet wird, zeige dem Nutzer den Dienstnamen, Bright Data, und was das Konto können wird. Der Aufruf dieser Endpunkte bestätigt die Annahme der Bright Data Nutzungsbedingungen und Richtlinie zur akzeptablen Nutzung im Namen der angegebenen E-Mail-Adresse.
Schritt 3: Verifizieren
Bright Data sendet dem Nutzer per E-Mail einen 6-stelligen alphanumerischen Code mit Groß- und Kleinschreibung, standardmäßig 10 Minuten gültig. Bitte den Nutzer, ihn vorzulesen.
curl -X POST https://brightdata.com/users/auth/agent_registration/claim/complete \
  -H "Content-Type: application/json" \
  -d '{
    "claim_token": "<uuid-v4>",
    "otp": "aB3xY9"
  }'
Die Anmeldeinformation wird hier ausgestellt:
{
  "claim_token": "<uuid-v4>",
  "credential": { "token": "<api_token>", "id": "<token_id>" },
  "zones": {
    "serp":        { "zone_id": "agent_serp",        "status": "success" },
    "unlocker":    { "zone_id": "agent_unlocker",    "status": "success" },
    "browser_api": { "zone_id": "agent_browser_api", "status": "success" }
  }
}
Um den Code erneut zu senden, poste das claim_token an /users/auth/agent_registration/claim. Das macht den vorherigen Code ungültig, setzt die verbleibende Versuchszahl nicht zurück und ist auf 3 erneute Sendungen pro Registrierung mit einem Mindestintervall von 60 Sekunden begrenzt.
Das Konto ist nun aktiv mit der kostenlosen Stufe plus dem 2 $-Testguthaben. Ausstehende Registrierungen, die nie verifiziert werden, laufen nach 24 Stunden ab.
Schritt 4: Die Anmeldeinformation verwenden
Websuche über die SERP-Zone:
curl -X POST https://api.brightdata.com/request \
  -H "Authorization: Bearer <api_token>" \
  -H "Content-Type: application/json" \
  -d '{
    "zone": "agent_serp",
    "url": "https://www.google.com/search?q=web+scraping+tools",
    "format": "json"
  }'
Eine geschützte Seite über Web Unlocker scrapen:
curl -X POST https://api.brightdata.com/request \
  -H "Authorization: Bearer <api_token>" \
  -H "Content-Type: application/json" \
  -d '{
    "zone": "agent_unlocker",
    "url": "https://example.com",
    "format": "raw"
  }'
Für die Browser API verbinde Playwright, Puppeteer oder Selenium über CDP mit der agent_browser_api-Zone. Das verbraucht das 2 $-Testguthaben. Die Einrichtung ist unter https://docs.brightdata.com/scraping-automation/scraping-browser/quickstart.
Für den vollständigen MCP-Toolsatz nutze https://mcp.brightdata.com/mcp?token=<api_token>.
Web Scraper APIs sind nicht zonenbasiert und werden durch die Registrierung nicht automatisch bereitgestellt. Sie laufen über einen separaten Trigger-, Abfrage- und Download-Mechanismus, dokumentiert unter https://docs.brightdata.com/datasets/introduction.
Was das Konto erhält
| Element | Detail |
|---|---|
| Kostenlose Credits | 5.000 pro Monat, monatlich erneuert. Deckt Web Unlocker, SERP, Web Scraper APIs, Scraper Studio |
| Testguthaben | 2 $ einmalig, 7 Tage gültig, jedes Produkt einschließlich Browser API. Das Hinzufügen einer Zahlungsmethode gewährt weitere 5 $ und verlängert die Testphase auf 30 Tage |
| Zonen | agent_serp, agent_unlocker, agent_browser_api, vorab erstellt |
| Nutzung und Abrechnung | Nur lesend. Guthaben prüfen, kein Zugriff auf Zahlungsmethoden oder Rechnungen |
| Token-Lebensdauer | Standardmäßig in der Größenordnung von einem Jahr. Genaues Ablaufdatum wird nicht zurückgegeben |
Nicht enthalten: Proxy-Netzwerke, Kontoverwaltung sowie Erstellen oder Bearbeiten von Zonen. Residential-Proxys erfordern immer ein KYC-verifiziertes Geschäftskonto über das Control Panel. Der Mensch kann dort jederzeit Guthaben hinzufügen und Einschränkungen aufheben.
Das Berechtigungsprofil des Tokens ist bewusst minimal. Es ist nur lesend für Admin und Abrechnung und kann keine Zonen erstellen oder bearbeiten, weshalb die drei benötigten vorab bereitgestellt sind.
Sieben Verhaltensweisen, die naive Implementierungen zum Scheitern bringen
Das sind die Teile, die ein Agent falsch macht, wenn er den Ablauf wie ein generisches Anmeldeformular behandelt.
Ein 200 bei Schritt 2 ist kein Beweis, dass die E-Mail neu ist. Wenn die Adresse bereits zu einem Bright Data-Konto gehört oder während eines kontrollierten Rollouts durch eine Domain- oder E-Mail-Zulassungsliste gefiltert wird, ist die Antwortform identisch mit Erfolg und kein Code wird gesendet. Der Besitzer des bestehenden Kontos erhält stattdessen eine separate Benachrichtigungs-E-Mail. Das ist beabsichtigt und nicht von Erfolg unterscheidbar. Wenn ein Nutzer meldet, nie einen Code erhalten zu haben, bitte ihn, den Spam-Ordner zu prüfen und zu bestätigen, dass er nicht bereits ein Konto hat, statt in einer Schleife erneut zu versuchen.
Das Wiederholen von Schritt 2 startet nichts neu. Erneutes Aufrufen von /auth für dieselbe E-Mail-Adresse, während eine Registrierung aussteht, gibt dasselbe claim_token und unveränderte Ablaufzeitstempel zurück. Nutze den Endpunkt zum erneuten Senden für einen frischen Code.
Die Zonenbereitstellung erfolgt pro Produkt und schlägt unabhängig fehl. Überprüfe jeden Eintrag unter zones. Wenn ein Produkt "status": "failed" meldet, während die anderen erfolgreich sind, bedeutet das, dieses Produkt später erneut zu versuchen, nicht dass die gesamte Registrierung fehlgeschlagen ist.
/claim/complete ist idempotent. Ein erneuter Versuch mit demselben claim_token und Code nach einem Timeout oder Netzwerkfehler gibt dasselbe Ergebnis zurück. Es wird weder ein zweites Konto erstellt, noch eine zweite Anmeldeinformation ausgestellt, noch Berechtigungen doppelt vergeben. Sicher wiederholbar.
Die Anmeldeinformation ist ein Geheimnis. Niemals credential.token in Chat-Ausgaben, Transkripte, Befehlszeilenargumente oder eine Datei drucken, protokollieren oder ausgeben, die eine unbeabsichtigte Partei lesen könnte. Speichere es in einem Secret-Manager, einem Betriebssystem-Anmeldeinformationsspeicher oder einer .env-Datei, die von der Versionskontrolle mit restriktiven Berechtigungen ausgeschlossen ist. Nicht im Klartext-Quellcode, in der Shell-Historie oder in Protokollen.
Ratenbegrenzungen gelten über fünf Dimensionen. Standardwerte: 3 Registrierungsstarts pro Stunde pro E-Mail, 60 pro Stunde pro Quell-IP, 30 pro Stunde pro Netzwerkbereich, 50 pro Stunde pro E-Mail-Domain, 1.000 pro Stunde global. Das Überschreiten einer dieser Grenzen gibt rate_limited zurück. Registrierungen durchlaufen zudem eine Betrugsprüfung.
Ein 401 bei einer funktionierenden Anmeldeinformation bedeutet, die Entdeckung neu zu starten. Verwirf die Anmeldeinformation und gehe zurück zu Schritt 1. Den Aufruf nicht wiederholen.
Fehlercodes
Jede Nicht-2xx-Antwort von /auth, /claim und /claim/complete verwendet dieselbe Form: {"error": "<code>", "error_description": "<umsetzbarer nächster Schritt>"}. Die Beschreibung ist ein nächster Schritt, keine Prosa. Interne Betrugsschwellen, Scores oder Anbieternamen werden niemals einbezogen.
| Code | HTTP | Wo | Was zu tun ist |
|---|---|---|---|
invalid_request |
400 | alle drei | JSON-Body korrigieren |
email_not_accepted |
400 | /auth |
Wegwerf-, Alias- oder ungültige Adresse. Nach dem echten Postfach fragen |
registration_denied |
403 | /auth, /claim/complete |
Abgelehnt. Nicht wiederholen. Alternativen Weg mit anwesendem Menschen nutzen |
browser_signup_required |
403 | /auth |
Diese E-Mail muss sich im Browser anmelden. Nicht wiederholen. Den Menschen bitten, sich im Control Panel mit derselben Adresse anzumelden |
fraud_check_unavailable |
503 | /auth |
Wiederholbar. Mindestens Retry-After Sekunden warten, identische Anfrage wiederholen, Wartezeit bei jedem Fehlschlag verdoppeln, insgesamt 3 Versuche, dann auf einen menschlichen Weg zurückfallen |
rate_limited |
429 | beliebig | Zurückziehen und später erneut versuchen |
invalid_claim_token |
400 | /claim, /claim/complete |
Ungültig, unbekannt oder erschöpft (5 OTP-Versuche oder 3 erneute Sendungen). Registrierung neu starten |
otp_invalid |
400 | /claim/complete |
Den Nutzer bitten, den Code erneut zu lesen. Nach 5 falschen Versuchen wird der Claim dauerhaft ungültig |
otp_expired |
400 | /claim/complete |
Erneut senden über /claim. Codes gelten standardmäßig 10 Minuten |
claim_expired |
400 | /claim/complete |
Ausstehende Registrierung hat 24 Stunden überschritten. Neu starten |
registration_disabled |
503 | /auth |
Neue Registrierungen vorübergehend deaktiviert. Alternativen Weg nutzen |
instructions_disabled |
404 | GET Discovery-Endpunkt | Selbstdokumentierender Endpunkt ist aus. Auf auth.md verlassen |
invalid_github_token |
401 | /auth |
Reserviert. Wird heute nicht zurückgegeben |
email_unverified |
401 | /auth |
Reserviert. Wird heute nicht zurückgegeben |
5xx mit exponentiellem Backoff wiederholen. Dieselbe 4xx-Nutzlast nicht wiederholen, es sei denn, die Tabelle sagt es so.
Widerruf
Agenten leiten keinen Widerruf ein. Es gibt keinen Endpunkt, über den ein Agent eine Anmeldeinformation zurückgeben kann.
Wenn eine Anmeldeinformation nicht mehr funktioniert und die API 401 zurückgibt, verwirf sie und starte die Entdeckung ab Schritt 1 neu. Das ist der gesamte Vertrag. Ein Agent, der ein totes Token hält, sollte es nicht erneut versuchen, nicht versuchen, es zu erneuern, und nicht annehmen, dass das Konto verschwunden ist. Er sollte zu den Metadaten zurückkehren und von vorn beginnen.
Das Konto später beanspruchen
Ein Mensch kann später die Standardregistrierung abschließen, mit Passwort, GitHub oder Google, unter Verwendung derselben E-Mail-Adresse, und vollen Zugriff auf dasselbe Konto erhalten. Es wird kein Duplikat erstellt und die Anmeldeinformation, die der Agent bereits verwendet, wird nicht ungültig gemacht. Ein Passwort-Reset für diese Adresse ist der Weg ins Control Panel bei einem kalten Start.
Noch nicht verfügbar
Ausdrücklich angegeben, damit Agenten es nicht versuchen und eine Anfrage verschwenden.
GitHub-Token-Assertion ist geplant und nicht terminiert. Das Design liest das Token aus einer authentifizierten GitHub-CLI, validiert es serverseitig gegen GitHub, liest die verifizierte primäre E-Mail und schlüsselt das Konto anhand der numerischen GitHub-ID. Das Token wird einmal verwendet und niemals gespeichert. Da die Identität bereits verifiziert ist, wird die Anmeldeinformation sofort zurückgegeben, ohne Code-Schritt. Minimale Scopes wären read:user und user:email, und ein GitHub-Konto ohne verifizierte primäre E-Mail würde abgelehnt.
Nichts davon ist implementiert. Der Server akzeptiert nur verified_email und lehnt alles andere als invalid_request ab. Die Codes invalid_github_token und email_unverified sind reserviert und werden heute nicht zurückgegeben.
Anonyme Registrierung ist geplant und nicht terminiert.
Die Regel ist für beide dieselbe: assertion_types_supported aus den Metadaten lesen und nur das verwenden, was aufgelistet ist. Wenn diese verfügbar werden, erscheinen sie zuerst in den Metadaten.
Referenz
Jede URL im Protokoll:
| URL | Zweck |
|---|---|
https://brightdata.com/auth.md |
Das Protokolldokument. Kanonisch |
https://brightdata.com/.well-known/oauth-authorization-server |
Metadaten des Autorisierungsservers mit dem agent_auth-Block |
https://api.brightdata.com/.well-known/oauth-protected-resource |
Metadaten geschützter Ressourcen, Scopes und Bearer-Methoden |
https://brightdata.com/users/auth/agent_registration |
Live selbstdokumentierender Spiegel der Verträge und Fehler |
.../agent_registration/auth |
Registrierung starten |
.../agent_registration/claim |
Den Code erneut senden |
.../agent_registration/claim/complete |
Den Code einreichen, das Token erhalten |
https://api.brightdata.com/request |
SERP- und Web-Unlocker-Aufrufe |
https://mcp.brightdata.com/mcp |
Gehostetes MCP, vollständiger Toolsatz |
https://brightdata.com/cp/setting/users |
Wo ein Mensch ein bestehendes API-Token findet |
https://docs.brightdata.com |
API-Referenz |
https://docs.brightdata.com/llms.txt |
Dokumentationsindex |
https://docs.brightdata.com/scraping-automation/scraping-browser/quickstart |
Browser-API-Einrichtung |
https://docs.brightdata.com/datasets/introduction |
Web Scraper APIs, Trigger, Abfrage, Download |
CLI: npm install -g @brightdata/cli
SDKs: npm install @brightdata/sdk oder pip install brightdata-sdk
FAQ
Kann ein KI-Agent ein Bright Data-Konto ohne einen Menschen erstellen?
Fast vollständig. Der Agent macht jeden HTTP-Aufruf. Die einzige Aktion des Menschen ist, einen 6-stelligen Code aus seiner E-Mail zu lesen und ihn dem Agenten zu geben. Kein Formular, kein Dashboard, kein Browser.
Warum kann der Agent nicht einfach das normale Anmeldeformular mit einem Browser-Tool ausfüllen?
Weil es nicht erlaubt ist. Anthropic untersagt seinen Browser-Agenten, im Namen eines Nutzers Konten zu erstellen, selbst mit ausdrücklicher Nutzererlaubnis, und weist sie separat an, keine CAPTCHAs oder menschliche Verifizierung abzuschließen. Ein Anmeldeformular verlangt beides. Der auth.md-Ablauf vermeidet dies, indem der Agent nie gebeten wird, als Mensch aufzutreten.
Wo ist das Protokoll dokumentiert?
https://brightdata.com/auth.md, gespiegelt in maschinenlesbarer Form unter https://brightdata.com/users/auth/agent_registration.
Wie entdeckt ein Agent die Endpunkte?
Über den agent_auth-Block in https://brightdata.com/.well-known/oauth-authorization-server.
Was erhält der Agent?
Ein Standard-Bright Data-API-Token, 5.000 kostenlose Credits pro Monat, ein 7 Tage gültiges Testguthaben von 2 $ und drei vorab bereitgestellte Zonen für SERP, Web Unlocker und Browser API.
Läuft das Token ab?
Standardmäßig in der Größenordnung von einem Jahr. Das genaue Ablaufdatum wird in der Registrierungsantwort nicht zurückgegeben.
Kann der Agent eigene Zonen erstellen?
Nein. Das Token ist für Admin und Abrechnung nur lesend. Die drei benötigten Zonen sind vorab bereitgestellt.
Kann der Agent seine eigene Anmeldeinformation widerrufen?
Nein. Agenten leiten keinen Widerruf ein. Wenn eine Anmeldeinformation 401 zurückgibt, verwirf sie und starte die Entdeckung neu.
Kann der Agent Residential-Proxys nutzen?
Nein. Diese erfordern immer ein KYC-verifiziertes Geschäftskonto über das Control Panel.
Ist das ID-JAG?
Nein. Es ist ein proprietärer Bright Data-Ablauf zur Agentenregistrierung.
Jetzt ausprobieren
Richte einen Agenten auf https://brightdata.com/auth.md und bitte ihn, sich zu registrieren. Drei Aufrufe später hat er ein Token, drei funktionierende Zonen und 5.000 kostenlose Credits im Monat.