


Threads Crawler
Crawlen Sie Threads im großen Maßstab über Beiträge und Profile hinweg. Sammeln Sie öffentliche Daten wie Beitrags-URL, Beitrags-ID, Inhalt, Veröffentlichungsdatum, Benutzername des Autors, Profil-URL des Autors, Follower-Anzahl, Antwortenanzahl, Repost-Anzahl, Likes, zitierte Beiträge, angehängte Medien und vieles mehr.

- Scrape auf Abruf via API oder No-Code Scraper
- Dedizierter Account Manager
- Massenanfragenbearbeitung, bis zu 5K URLs
- Ergebnisse in mehreren Formaten abrufen
Weltweit vertrauen 50,000+ Kunden auf uns.


Verfügbare Threads Crawler
 383+
 14+
Möchten Sie nur Threads-Daten? Überspringen Sie das Crawling.
Kaufen Sie einen Threads-Datensatz
Threads Crawler-Preise
Zahlen Sie nur für das, was erfolgreich geliefert wurde. Keine versteckten Gebühren, keine Kosten für fehlgeschlagene Lieferungen.

- Nur für Erfolg bezahlen, keine versteckten Gebühren
- Starte gratis mit 5.000 monatlichen Credits
- Keine Vorabverpflichtung, jederzeit kündbar
- 24/7-Expertensupport und Enterprise-Funktionen

CODE-BEISPIELE
Crawlen Sie ganz einfach Threads-Daten, ohne sich um Sperrungen sorgen zu müssen.
curl -H "Authorization: Bearer API_TOKEN" -H "Content-Type: application/json" -d '[{"url":"https://www.threads.com/@dividendology_yt/post/DML_enxRaOq?hl=en"},{"url":"https://www.threads.com/@sanantoniozoo/post/DMLlEMux-wk?hl=en"}]' "https://api.brightdata.com/datasets/v3/trigger?dataset_id=gd_md75myxy14rihbjksa&format=json&uncompressed_webhook=true"[
{
"timestamp": "2026-10-22",
"post_id": "DewYeislPSJ",
"url": "https:\/\/www.threads.com\/@itsmenanaali\/post\/DewYeislPSJ",
"post_time": "2026-10-21T12:13:57.000Z",
"profile_name": "itsmenanaali",
"profile_url": "https:\/\/www.threads.com\/@itsmenanaali",
"post_content": null,
"number_of_likes": 0
},
{
"timestamp": "2026-10-22",
"post_id": "DexZ5RunNBP",
"url": "https:\/\/www.threads.com\/@repdeluzio\/post\/DexZ5RunNBP",
"post_time": "2026-10-21T21:45:35.000Z",
"profile_name": "repdeluzio",
"profile_url": "https:\/\/www.threads.com\/@repdeluzio",
"post_content": "The Iran War has cost the average American family more than $2,000. \n\nWe are ALL paying for this reckless war that Trump...",
"number_of_likes": 16
},
{
"timestamp": "2026-10-22",
"post_id": "DevYd84jNvX",
"url": "https:\/\/www.threads.com\/@borrisbrandonramirez\/post\/DevYd84jNvX",
"post_time": "2026-10-21T02:54:38.000Z",
"profile_name": "borrisbrandonramirez",
"profile_url": "https:\/\/www.threads.com\/@borrisbrandonramirez",
"post_content": "God sees beyond the walls of our church. \nGod delights in our discipline and obedience even in the marketplace. \n\nWe don...",
"number_of_likes": 4
},
{
"timestamp": "2026-10-22",
"post_id": "DewWpKsnHzd",
"url": "https:\/\/www.threads.com\/@gregsedwards\/post\/DewWpKsnHzd",
"post_time": "2026-10-21T11:57:55.000Z",
"profile_name": "gregsedwards",
"profile_url": "https:\/\/www.threads.com\/@gregsedwards",
"post_content": "\u0022Intentionally suffering is just another form of indulgence.\u0022 - @markmanson",
"number_of_likes": 0
},
{
"timestamp": "2026-10-22",
"post_id": "DexJsOIAJl1",
"url": "https:\/\/www.threads.com\/@anirban.mitra93\/post\/DexJsOIAJl1",
"post_time": "2026-10-21T19:23:59.000Z",
"profile_name": "anirban.mitra93",
"profile_url": "https:\/\/www.threads.com\/@anirban.mitra93",
"post_content": "Pujo ends. The longing stays.\nAnother Pujo in the archives, another piece of my heart left behind.",
"number_of_likes": 0
}
]curl -H "Authorization: Bearer API_TOKEN" -H "Content-Type: application/json" -d '[{"url":"https://www.threads.com/@abc7la"},{"url":"https://www.threads.com/@adriellereinaauthor"}]' "https://api.brightdata.com/datasets/v3/trigger?dataset_id=gd_mde7jg3ld2h3hnnf2&format=json&uncompressed_webhook=true"[
{
"timestamp": "2026-10-22",
"url": "https:\/\/www.threads.com\/@doctorkowj",
"profile_name": "柯文哲",
"profile_id": "63439331208",
"about_formatted": "心存善念,盡力而為",
"number_of_followers": 612514,
"website": "https:\/\/www.facebook.com\/DoctorKoWJ",
"instagram_profile_url": "https:\/\/www.instagram.com\/doctorkowj"
},
{
"timestamp": "2026-10-22",
"url": "https:\/\/www.threads.com\/@wen_shih_cheng",
"profile_name": "温世政 Wen Shih-Cheng",
"profile_id": "80177097255",
"about_formatted": "南投縣長候選人|牙醫師\n草屯囡仔|南投温顧|世代幸福",
"number_of_followers": 30237,
"website": "https:\/\/www.facebook.com\/wEnShihheng\/",
"instagram_profile_url": "https:\/\/www.instagram.com\/wen_shih_cheng"
},
{
"timestamp": "2026-10-22",
"url": "https:\/\/www.threads.com\/@huang.guochang",
"profile_name": "黃國昌",
"profile_id": "63274537854",
"about_formatted": "溫暖而富有人性的國蔥老師",
"number_of_followers": 75800,
"website": null,
"instagram_profile_url": "https:\/\/www.instagram.com\/huang.guochang"
},
{
"timestamp": "2026-10-22",
"url": "https:\/\/www.threads.com\/@su.chiaohui",
"profile_name": "蘇巧慧",
"profile_id": "63447798401",
"about_formatted": "2026新北市長候選人\n立法委員|樹林、鶯歌、新莊西盛\n主任委員|民主進步黨新北市黨部\n【Podcast節目】搜尋訂閱:水獺媽媽巧巧話\n#新時代 #新市長\n#溫暖 #創新 #會做事",
"number_of_followers": 190787,
"website": "https:\/\/donate.newebpay.com\/chiao\/huiwin2026",
"instagram_profile_url": "https:\/\/www.instagram.com\/su.chiaohui"
},
{
"timestamp": "2026-10-22",
"url": "https:\/\/www.threads.com\/@chiayionefish",
"profile_name": "蔡易餘",
"profile_id": "63097833574",
"about_formatted": "#蔡易餘家己人\n#靈活ㄉ胖子 #專業立委\n#重力嘉速度\n📩 陳情、服務案件請私訊「蔡易餘家己人」FB",
"number_of_followers": 61093,
"website": "https:\/\/portaly.cc\/chiayionefish",
"instagram_profile_url": "https:\/\/www.instagram.com\/chiayionefish"
}
]API für nahtlosen Threads-Datenzugriff
Umfassende, skalierbare und konforme Web-Datenextraktion
API für nahtlosen Threads-Datenzugriff
Auf Ihren Workflow zugeschnitten
Erhalten Sie strukturierte Daten in JSON-, NDJSON- oder CSV-Dateien per Webhook- oder API-Lieferung.
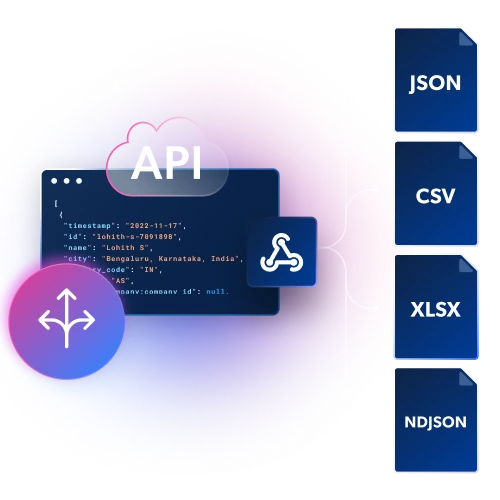
Integrierte Infrastruktur und Entsperrung
Maximale Kontrolle und Flexibilität ohne Wartung von Proxy- und Entsperrungsinfrastruktur. Scrapen Sie mühelos Daten aus beliebigen Geo-Standorten und umgehen Sie dabei CAPTCHAs und Sperren.
Bewährte Infrastruktur
Die Plattform von Bright Data unterstützt über 20.000 Unternehmen weltweit und bietet 99,99 % Betriebszeit sowie Zugang zu über 150 Millionen echten Nutzer-IPs in 195 Ländern.
Branchenführende Compliance
Unsere Datenschutzpraktiken entsprechen den Datenschutzgesetzen, einschließlich des EU-Datenschutzrahmens, der GDPR und der CCPA.
API für nahtlosen Threads-Datenzugriff


Vereinfachtes Threads-Crawling
Anwendungsfälle für Threads-Crawling
Verbraucherstimmung und Markenüberwachung
Trend- und Gesprächsverfolgung
Creator- und Wettbewerbsanalyse
Wegweisend bei ethischer Webdatenerfassung
Wir haben den Goldstandard für ethische und konforme Webdatenpraktiken gesetzt. Unser Peer-Netzwerk basiert auf Vertrauen, wobei sich jedes Mitglied persönlich dafür entscheidet und die Garantie besteht, dass keine persönlichen Daten erfasst werden. Wir setzen uns für die Erfassung ausschließlich öffentlich verfügbarer Daten ein, unterstützt durch einen branchenführenden Know-Your-Customer-Prozess und eine transparente Richtlinie zur zulässigen Nutzung. Unser globales, mehrsprachiges Compliance- und Ethikteam, das erste seiner Art, stellt sicher, dass wir regulatorischen Änderungen und Best Practices stets einen Schritt voraus sind.
Warum 50,000+ Kunden Bright Data wählen

100% konform

24/7 globaler Support

Vollständige Datenabdeckung

Unübertroffene Datenqualität

Leistungsstarke Infrastruktur

Maßgeschneiderte Lösungen
Bright Data wird von den weltweit führenden Marken genutzt



Threads Crawler FAQs
Was ist der Threads-Crawler?
Der Threads-Crawler ist ein automatisiertes Tool, das öffentliche Daten von Threads im großen Umfang findet und sammelt. Sie benötigen keine vollständige Liste von URLs. Sie können mit einem Schlüsselwort, einer Kategorie, einer Such-URL oder einer bestimmten Seite starten. Der Crawler findet die passenden Einträge und liefert die Daten in strukturiertem Format zurück.
Was ist der Unterschied zwischen dem Crawlen und Scrapen von Threads?
Beim Crawlen geht es um das Auffinden von Seiten. Beim Scrapen geht es um die Extraktion bestimmter Felder von einer Seite, die bereits bekannt ist. Ein Scraper benötigt die Angabe, welche URL besucht werden soll. Ein Crawler findet die Einträge selbstständig und extrahiert dann die Daten. Nutzen Sie den Crawler, wenn Sie nicht die vollständige Liste der URLs haben oder wenn sich die Liste ständig ändert, etwa bei jedem Artikel einer Kategorie oder jedem Ergebnis für ein Schlüsselwort. Wenn Sie bereits die genauen URLs haben, ist die Erfassung per URL die direktere Option.
Wie unterscheidet sich der Threads-Crawler von einem Threads-Datensatz?
Ein Datensatz besteht aus bereits gesammelten Daten, die Sie als fertige Datei kaufen. Der Crawler sammelt frische Daten, wenn Sie ihn ausführen, basierend auf Ihren eigenen Eingaben. Wählen Sie einen Datensatz, wenn Sie sofort eine breite Abdeckung ohne Einrichtung wünschen. Wählen Sie den Crawler, wenn Sie einen bestimmten Umfang, die neuesten Daten oder eine Erfassung nach einem selbst festgelegten Zeitplan benötigen.
Wie unterscheidet sich der Threads-Crawler von der Nutzung von Proxys?
Proxys sind Infrastruktur. Sie leiten Ihre Anfragen über verschiedene IP-Adressen, aber Sie müssen trotzdem den Crawler, den Parser und die Entsperrung selbst erstellen und pflegen. Der Threads-Crawler enthält all das bereits: Proxy-Verwaltung, vollständiges Browser-Rendering, CAPTCHA-Lösung, Datenparsing und Lieferung. Wählen Sie Proxys, wenn Sie den Code selbst schreiben und besitzen möchten. Wählen Sie den Crawler, wenn Sie einfach nur die Daten möchten.
Ist der Threads-Crawler dasselbe wie die Crawl API von Bright Data?
Nein. Die Crawl API funktioniert auf jeder öffentlichen Website. Sie geben eine Root-URL an, und sie liefert den Inhalt der Website als Markdown, Text, HTML oder JSON zurück. Der Threads-Crawler ist ausschließlich für Threads entwickelt. Er liefert einsatzbereite Felder speziell für Threads, sodass Sie keine eigene Parsing-Logik schreiben müssen.
Welche Eingaben kann ich verwenden, um einen Crawl zu starten?
Das hängt vom gewählten Crawler ab. Übliche Ausgangspunkte sind eine direkte URL, ein Schlüsselwort, eine Kategorie-URL, eine Such-URL oder eine Profil-, Verkäufer- oder Shop-URL. Sie können bis zu 5.000 URLs in einer einzigen Sammelanfrage senden.
Kann ich wiederkehrende Crawls von Threads planen?
Ja. Der Crawler unterstützt Batch- und geplante Erfassung, sodass Sie denselben Crawl in regelmäßigen Abständen erneut ausführen können. Das ist nützlich, um Veränderungen über die Zeit zu verfolgen, etwa Preise, Verfügbarkeit, Rankings oder Interaktionszahlen, ohne jeden Durchlauf manuell zu starten.
Muss ich mich um Sperren, CAPTCHAs oder JavaScript-Rendering kümmern?
Nein. Proxy-Verwaltung, CAPTCHA-Lösung und vollständiges Browser-Rendering sind alle integriert. Der Crawler läuft auf dem Netzwerk von Bright Data mit über 400 Millionen echten Nutzer-IPs in 195 Ländern, sodass Sie Threads von jedem Standort aus crawlen können, ohne eine eigene Entsperrungslösung zu pflegen.
Wie wird der Threads-Crawler bepreist?
Sie zahlen nur für erfolgreich gelieferte Einträge. Fehlgeschlagene Lieferungen werden nie berechnet. Sie können mit der kostenlosen Stufe mit 5.000 Einträgen pro Monat ohne Kreditkarte starten und dann je nach Skalierung zu Bezahlung pro Nutzung oder einem monatlichen Plan wechseln. Details zu den Plänen finden Sie im obigen Preisbereich.
Ist es legal, Threads zu crawlen?
Der Crawler sammelt ausschließlich öffentlich verfügbare Daten. Die Datenschutzpraktiken von Bright Data folgen den Datenschutzgesetzen, einschließlich GDPR und CCPA. Es gibt zudem einen KYC-Überprüfungsprozess und eine öffentliche Richtlinie zur akzeptablen Nutzung. Sie sind weiterhin selbst dafür verantwortlich sicherzustellen, dass Ihre eigene Nutzung der Daten den für Sie geltenden Gesetzen entspricht.
Möchten Sie mehr erfahren?
Sprechen Sie mit einem Experten über Ihre Threads-Crawling-Anforderungen