


 854+
 38+

- Anfragen in jeder Sprache erstellen
- Mit Schedulern und Webhooks automatisieren
- JSON-, NDJSON- oder CSV-Lieferung


Creative Commons Scraper API
Scrapen Sie Creative Commons-Bilder und 3D-Modelle. Sammeln Sie Creative Commons-Daten wie Titel, Beschreibung, Lizenztyp, Erstellerdetails, Bild-URLs, Keywords, Medientyp und mehr.
5.000 kostenlose Datensätze/Monat · Keine Kreditkarte erforderlich
Vertraut von 50,000+ Kunden weltweit


Verfügbare Creative Commons Scraper
Wählen Sie einen Creative Commons Scraper und rufen Sie ihn auf. Jeder Creative Commons Scraper listet seine Ausgabefelder, Liefervolumen und Live-Erfolgsrate auf.
Tausende produktionsreife Scraper entdecken
Zahlen Sie nur für erfolgreiche Ergebnisse, keine Überraschungen – Proxys, Entsperrung, Browser und Wiederholungen sind integriert.
Creative Commons Scraper API Preise
Zahlen Sie nur für erfolgreich zugestellte Inhalte. Keine versteckten Gebühren, keine Kosten für fehlgeschlagene Zustellungen.

Erhalten Sie 25% Rabatt auf die Scraper API für 3 Monate. Verwenden Sie den Code APIS25 beim Checkout.
Wir akzeptieren diese Zahlungsmethoden:
Nur Daten gewünscht? Scraping überspringen.
Kaufen Sie einen Creative Commons Datensatz
So funktioniert es
In 3 Schritten zu Creative Commons-Daten
Keine Proxys zu konfigurieren, keine Infrastruktur zu verwalten. Auswählen, aufrufen und empfangen.
-
Scraper auswählen
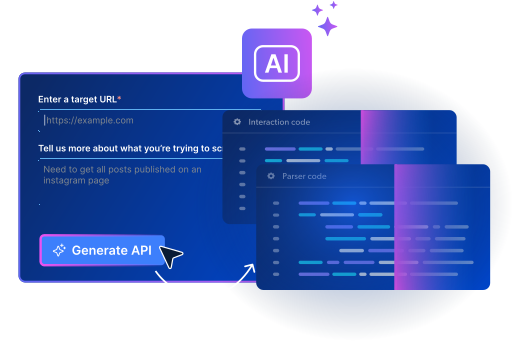
Wählen Sie aus den [current_scraper_name}-Scrapern oben oder erstellen Sie Ihren eigenen mit KI in wenigen Minuten.
-
API aufrufen
Ein API-Aufruf mit bis zu 5.000 Ziel-URLs. Python- und Node.js-SDKs, CLI, MCP-Server oder ein beliebiger HTTP-Client.
-
Strukturierte Daten erhalten
Empfangen Sie saubere, geparste [current_scrper_name]-Daten in JSON, NDJSON oder CSV. Zugestellt per API, Webhook oder Cloud-Speicher.
Scraper API-Aufruf
curl -H "Authorization: Bearer API_TOKEN" -H "Content-Type: application/json" -d '[{"url":"https://openverse.org/image/70ee48a3-6c6d-464c-9db7-75a507555979?q=beach","keyword":""},{"url":"https://openverse.org/image/62319cc3-12e4-43d4-b218-bee28f524e59?q=beach","keyword":""},{"url":"https://openverse.org/image/e7ae9471-7196-4767-bdf1-8a080d3a7134?q=beach","keyword":""},{"url":"https://openverse.org/image/ed2c0630-2837-400e-bfa1-c9333dd58331?q=beach","keyword":""}]' "https://api.brightdata.com/datasets/v3/trigger?dataset_id=gd_m23cxdw82ct6k022y3&format=json&uncompressed_webhook=true"
Antwortpayload
[
  {
    "timestamp": "2026-06-15",
    "url": "https:\/\/www.google.com\/imgres?q=mural+art\u0026imgurl=https%3A%2F%2Fupload.wikimedia.org%2Fwikipedia%2Fcommons%2F5%2F5e%2FWal...",
    "title": "File:Wall painting - female painter - Pompeii (VI 1 10) - Napoli ...",
    "description": null,
    "image_url": "https:\/\/upload.wikimedia.org\/wikipedia\/commons\/5\/5e\/Wall_painting_-_female_painter_-_Pompeii_%28VI_1_10%29_-_Napoli_MAN_...",
    "creators": null,
    "license": null,
    "keyword": null
  },
  {
    "timestamp": "2026-06-15",
    "url": "https:\/\/www.google.com\/imgres?q=gymnastics\u0026imgurl=https%3A%2F%2Fupload.wikimedia.org%2Fwikipedia%2Fcommons%2F3%2F30%2F20...",
    "title": "File:2022-06-26 Budapest Cup Age-group III apparatus finals Vault ...",
    "description": null,
    "image_url": "https:\/\/upload.wikimedia.org\/wikipedia\/commons\/3\/30\/2022-06-26_Budapest_Cup_Age-group_III_apparatus_finals_Vault_%28Mart...",
    "creators": null,
    "license": null,
    "keyword": null
  },
  {
    "timestamp": "2026-06-16",
    "url": "https:\/\/www.google.com\/imgres?q=Aztec+pyramids\u0026imgurl=https%3A%2F%2Fupload.wikimedia.org%2Fwikipedia%2Fcommons%2Fc%2Fc8%...",
    "title": "File:Teotihuacan, Pyramid of the Moon, Cerro Gordo, and the Avenue ...",
    "description": null,
    "image_url": "https:\/\/live.staticflickr.com\/5758\/20660408766_5b6202a239_o.jpg",
    "creators": null,
    "license": null,
    "keyword": null
  },
  {
    "timestamp": "2026-06-16",
    "url": "https:\/\/www.google.com\/searchviewer\/7?hl=en\u0026svid=EpMBMg5oXy02WEltaDVRWlFCTToOZG5rWVZJUkRIaWYxU01KcWh0dHBzOi8vaW1hZ2VzLnB...",
    "title": "Close-up of a Carved Wall in an Ancient Temple · Free Stock Photo",
    "description": null,
    "image_url": "https:\/\/images.pexels.com\/photos\/15929091\/pexels-photo-15929091.jpeg?cs=srgb\u0026dl=pexels-sergk1-15929091.jpg\u0026fm=jpg",
    "creators": null,
    "license": null,
    "keyword": null
  },
  {
    "timestamp": "2026-06-16",
    "url": "https:\/\/www.google.com\/imgres?q=Buenos+Aires\u0026imgurl=https%3A%2F%2Fupload.wikimedia.org%2Fwikipedia%2Fcommons%2F8%2F8f%2F...",
    "title": "File:Palacio del Congreso in Buenos Aires (6370115601).jpg ...",
    "description": null,
    "image_url": "https:\/\/live.staticflickr.com\/6042\/6370115601_0c5ec4f945_o.jpg",
    "creators": null,
    "license": null,
    "keyword": null
  }
]
Scraper API-Aufruf
curl -H "Authorization: Bearer API_TOKEN" -H "Content-Type: application/json" -d '[{"url":"https://www.thingiverse.com/thing:6863579"},{"url":"https://www.thingiverse.com/thing:6854751"},{"url":"https://www.thingiverse.com/thing:6856939"},{"url":"https://www.thingiverse.com/thing:6855436"}]' "https://api.brightdata.com/datasets/v3/trigger?dataset_id=gd_m4jr2hyr2kfhtvba6e&format=json&uncompressed_webhook=true"
Antwortpayload
[
  {
    "timestamp": "2024-12-19",
    "url": "https:\/\/www.thingiverse.com\/thing:6719448",
    "id": "6719448",
    "domain": "https:\/\/www.thingiverse.com\/",
    "title": "cap container box (fallout)",
    "description": "This object was made in Tinkercad. for the cap container lid",
    "license": "Creative Commons - Attribution - Share Alike",
    "images": [
      "https:\/\/cdn.thingiverse.com\/assets\/1b\/ff\/9d\/38\/82\/0ace2eef-aa0f-409e-88af-591c5df4c49c.png",
      "https:\/\/cdn.thingiverse.com\/assets\/1d\/d2\/02\/d6\/e9\/257948e0-f6c3-462c-83a9-97e0c1fc0f11.png",
      "https:\/\/cdn.thingiverse.com\/assets\/a2\/61\/22\/d7\/93\/ef59239a-ef44-4ac1-9af2-32bf50bc87bb.png",
      "https:\/\/cdn.thingiverse.com\/assets\/2d\/46\/20\/42\/27\/0ca0e1b0-0e44-4eb6-824d-08e3484ef248.png",
      "https:\/\/cdn.thingiverse.com\/assets\/fc\/f9\/c7\/c5\/ce\/f1bd7ab9-9384-4a08-b8eb-6b5010c70e15.png",
      "https:\/\/cdn.thingiverse.com\/assets\/50\/4b\/1e\/9e\/7c\/cb4fcb1e-375c-492b-a698-634753e1fc6e.png"
    ]
  },
  {
    "timestamp": "2024-12-19",
    "url": "https:\/\/www.thingiverse.com\/thing:6190826",
    "id": "6190826",
    "domain": "https:\/\/www.thingiverse.com\/",
    "title": "Oddish Planter",
    "description": "Oddish Planter\r\n\r\n4\u0022 high\r\n8.5\u0022 base\r\n5.5\u0022 top opening\r\n\r\nPrinted with PLA\r\n\r\nhttps:\/\/youtu.be\/qK1jMLIY4T0",
    "license": "Creative Commons - Attribution",
    "images": [
      "https:\/\/cdn.thingiverse.com\/assets\/8d\/0e\/75\/f9\/d8\/1e9aae24-1845-4dd5-b7b2-18d314cfd937.JPG",
      "https:\/\/cdn.thingiverse.com\/assets\/c4\/a4\/9b\/79\/1c\/7426c817-10b2-45f7-b1c5-b9c662a1bda2.png",
      "https:\/\/cdn.thingiverse.com\/assets\/3b\/6c\/f5\/1b\/6e\/f127f3f4-ac03-4860-a909-9e200224a9ca.png"
    ]
  },
  {
    "timestamp": "2024-12-19",
    "url": "https:\/\/www.thingiverse.com\/thing:6006827",
    "id": "6006827",
    "domain": "https:\/\/www.thingiverse.com\/",
    "title": "Berg Buddy Pushbar",
    "description": "This thing let you use Bergtoys Buzzy pushbar on your Berg Buddy. ",
    "license": "Creative Commons - Attribution",
    "images": [
      "https:\/\/cdn.thingiverse.com\/assets\/41\/1c\/0b\/2f\/32\/22f074e9-a77f-496b-a9cc-cf8278665535.png",
      "https:\/\/cdn.thingiverse.com\/assets\/6b\/13\/fc\/bd\/85\/7fb0aa80-4f1f-4b99-9255-4cbcd66485b6.jpeg"
    ]
  },
  {
    "timestamp": "2024-12-19",
    "url": "https:\/\/www.thingiverse.com\/thing:4908700",
    "id": "4908700",
    "domain": "https:\/\/www.thingiverse.com\/",
    "title": "Lanzador MM40",
    "description": null,
    "license": "Creative Commons - Public Domain Dedication",
    "images": [
      "https:\/\/cdn.thingiverse.com\/assets\/2b\/9f\/94\/d1\/f7\/contenedor.png",
      "https:\/\/cdn.thingiverse.com\/assets\/41\/d4\/2f\/5a\/88\/cajon.png"
    ]
  },
  {
    "timestamp": "2024-12-19",
    "url": "https:\/\/www.thingiverse.com\/thing:6782075",
    "id": "6782075",
    "domain": "https:\/\/www.thingiverse.com\/",
    "title": "Holder for IDEAL 45-163 Abmantelwerkzeug 3.2mm - 5.5mm",
    "description": "IDEAL 45-163 Abmantelwerkzeug 3.2mm - 5.5mm",
    "license": "Creative Commons - Attribution - Share Alike",
    "images": [
      "https:\/\/cdn.thingiverse.com\/assets\/e4\/74\/68\/ed\/bc\/Klamme_Halter.png",
      "https:\/\/cdn.thingiverse.com\/assets\/a3\/e7\/04\/1f\/c5\/gggg.jpg",
      "https:\/\/cdn.thingiverse.com\/assets\/be\/93\/cc\/03\/8a\/Klamme_Halter.png"
    ]
  }
]Alles inklusive, direkt integriert
Sie zahlen für Ergebnisse. Proxys, Rendering, Parallelität und Lieferung sind in jedem Plan enthalten.

Direkt zur Quelle
Jede Anfrage läuft über die Bright Data-Infrastruktur. 400 Mio.+ IPs, Entsperrung und Browser sind integriert.

Sofort auf Millionen von Seiten skalieren
Unbegrenzte parallele Anfragen senden – keine Infrastruktur zu verwalten, keine Konfigurationen zu ändern.

Scraper reparieren sich automatisch bei Seitenänderungen
KI-gestützte Selbstheilung erkennt Seitenänderungen und repariert Scraper. Ihre Pipelines laufen weiter.

Tausende verifizierter Scraper
Jeder Scraper wird von Bright Data erstellt, getestet und gepflegt. Kein Community-Rätselraten.

Pro Ergebnis bezahlen, keine Extras
Ein Preis pro Datensatz. Proxys, Wiederholungen, Rendering, Entsperrung – alles inklusive, keine Überraschungen.

Konform und vollständig unterstützt
GDPR- & CCPA-konform. 24/7 menschlicher Support in jedem Plan, auch im kostenlosen.
Beginnen Sie in Minuten mit der Erfassung von Creative Commons-Daten
Rufen Sie die API aus dem Code auf, navigieren Sie durch das Kontrollpanel oder übergeben Sie es Ihrem KI-Agenten.


Creative Commons-Daten-Scraping-Anwendungsfälle
Echtzeit-Creative Commons-Intelligenz für Ihr Unternehmen.
Lizenzbasierte KI-Trainingsdaten
Lizenzen
Medien
Attribution
Entdeckung von Medien-Assets
Medien
Formate
Kategorien
Ersteller- und Attributionsverfolgung
Ersteller
Attribution
Lizenzen
Analyse der Sammlungszusammensetzung
Sammlungen
Lizenzen
Formate
Bright Data im Vergleich zu anderen
Web Scraper API vs. andere Anbieter
Fähigkeit
Bright Data
Andere Scraper-Anbieter
Auto-Skalierungs-Infrastruktur
Unbegrenzt
Teilweise
Anti-Bot- & CAPTCHA-Umgehung
Integriert
Teilweise
Residential Proxy Netzwerk
über 400 Mio. IPs
Begrenzter Pool
Vorgefertigte Scraper
über 1.400
50–200
Automatische Wartung (Website-Änderungen)
24/7
Hängt davon ab, wer es gebaut hat
Preismodell
Ein All-in-Preis pro Datensatz
Rechenleistung, Proxy und Speicher getrennt abgerechnet
Fehlgeschlagene Anfragen
Kostenlos, nur bei Erfolg bezahlen
Oft abgerechnet
Benutzerdefinierte Seiten (kein vorgefertigter Scraper)
KI baut es in Minuten, inklusive Selbstheilung
Community-erstellte Scraper, kein SLA
Compliance (GDPR, CCPA, SOC 2)
Vollständig
Teilweise
Strukturierte Ausgabe (JSON/CSV)
Automatisch
Support
24/7 Experten, sogar im kostenlosen Tarif
Community-Forum
Kostenloser Tarif
5.000 Einträge/Monat
Variiert
compliance
Wegweisend bei der ethischen Erfassung von Webdaten
Nur öffentlich zugängliche Daten. ISO 27001 zertifiziert, SOC 2-Kontrollen, GDPR- & CCPA-konform. Jeder Anwendungsfall wird von einem dedizierten Compliance- & Ethik-Team geprüft, unterstützt durch einen dokumentierten Know-Your-Customer-Prozess und eine Richtlinie zur zulässigen Nutzung.

Bright Data wird von den weltweit führenden Marken genutzt


Creative Commons Scraper API FAQs
Was ist die Creative Commons Scraper API?
Die Creative Commons Scraper API ist ein leistungsstarkes Tool zur Automatisierung der Datenextraktion von der Creative Commons-Website, mit dem Nutzer effizient große Datenmengen für verschiedene Anwendungsfälle sammeln und verarbeiten können.
Wie funktioniert die Creative Commons Scraper API?
Die Creative Commons Scraper API sendet automatisierte Anfragen an die Zielwebsite, extrahiert die benötigten Datenpunkte und liefert sie in strukturiertem Format. Dieser Prozess gewährleistet eine präzise und schnelle Datenerfassung.
Erfüllt die Creative Commons Scraper API die Datenschutzbestimmungen?
Ja, die Creative Commons Scraper API wurde entwickelt, um Datenschutzbestimmungen wie GDPR und CCPA einzuhalten. Sie stellt sicher, dass alle Datenerfassungsaktivitäten ethisch und rechtmäßig durchgeführt werden.
Kann ich die Creative Commons Scraper API für die Konkurrenzanalyse nutzen?
Absolut! Die Creative Commons Scraper API eignet sich hervorragend für die Wettbewerbsanalyse und ermöglicht es Ihnen, Einblicke in die Aktivitäten, Trends und Strategien Ihrer Konkurrenten zu gewinnen.
Wie kann ich die Creative Commons Scraper API in meine bestehenden Systeme integrieren?
Die Creative Commons Scraper API bietet eine reibungslose Integration mit verschiedenen Plattformen und Tools. Sie können sie mit Ihren bestehenden Datenpipelines, CRM-Systemen oder Analyse-Tools nutzen, um Ihre Datenverarbeitungsfähigkeiten zu verbessern.
Gibt es eine kostenlose Stufe für die Creative Commons Scraper API?
Ja! Jedes neue Bright Data-Konto enthält automatisch 5.000 kostenlose Credits pro Monat (ca. 7,50 $ Wert) — keine Kreditkarte erforderlich, kein Promo-Code, keine Verpflichtung. Diese Credits gelten für Scraper (einschließlich der Creative Commons Scraper API) sowie für die Unlocker API und SERP API. Credits werden am 1. jedes Monats erneuert, und Sie können sofort nach der Anmeldung API-Aufrufe tätigen.
Was passiert, wenn meine kostenlosen Credits während der Nutzung der Creative Commons Scraper API aufgebraucht sind?
Wenn Ihre 5.000 kostenlosen monatlichen Credits aufgebraucht sind, hängt das Verhalten von Ihrem Kontostand ab. Wenn Sie Guthaben hinterlegt haben, läuft die Nutzung nahtlos zu den Standard-PAYG-Tarifen weiter, ohne Unterbrechung. Wenn Sie kein Guthaben hinterlegt haben, geben Anfragen einen Fehler zurück, bis Sie Guthaben hinzufügen oder bis Ihre Credits am 1. des Folgemonats erneuert werden. Beachten Sie, dass ungenutzte kostenlose Credits nicht übertragen werden.
Um Unterbrechungen zu vermeiden, können Sie die automatische Aufladung in Ihren Abrechnungseinstellungen unter brightdata.com/cp/billing/settings aktivieren.
Welche Nutzungsgrenzen gelten für die Creative Commons Scraper API?
Es gibt keine spezifischen Nutzungsgrenzen für die Creative Commons Scraper API, sodass Sie die Flexibilität haben, bei Bedarf zu skalieren.
Bieten Sie Support für die Creative Commons Scraper API an?
Ja, wir bieten dedizierten Support für die Creative Commons Scraper API. Unser Support-Team steht Ihnen rund um die Uhr zur Verfügung, um Ihnen bei Fragen oder Problemen während der Nutzung der API zu helfen.
Welche Übertragungsmethoden sind verfügbar?
Amazon S3, Google Cloud Storage, Google PubSub, Microsoft Azure Storage, Snowflake und SFTP.
Welche Dateiformate sind verfügbar?
JSON, NDJSON, JSON Lines, CSV und .gz-Dateien (komprimiert).
Können KI-Agenten die Creative Commons Scraper API nutzen?
Ja. Verbinden Sie jeden Agenten über den gehosteten MCP-Server, richten Sie einen Coding-Agenten über brightdata.com/SKILL.md ein oder nutzen Sie die CLI. Agenten authentifizieren sich einmalig über Browser-OAuth und können beliebige Creative Commons-Scraper ausführen.