Yahoo Finance bietet kostenlose Kurse, Kurshistorien, Finanzberichte und Analystenschätzungen, aber keine offizielle API. Seine Kursseiten enthalten diese Daten als JSON im HTML, sodass eine Python-Pipeline sie ohne Browser lesen kann.
Code aus vielen älteren Tutorials scheiterte auf 2 Arten. Mit seinem Standard-User-Agent erhielt Pythons requests-Bibliothek bei der ersten Anfrage 429 Too Many Requests. Wenn eine Anfrage erfolgreich war, trafen die alten Selektoren nichts oder den Kurs des S&P 500 statt den der Aktie.
Dieser Leitfaden zeigt Ihnen, wie Sie Yahoo Finance aus diesem JSON scrapen, die 429 vermeiden und auf einen Server umziehen.
TL;DR
- Yahoos 429 bei der ersten Anfrage hängt vom Client ab, nicht von der Anfragerate. Mit einer Chrome-Imitation forderte curl_cffi 503 S&P-500-Kursseiten an, ohne eine 429 zu erhalten.
- Eine einzige Anfrage liefert die vollständige Kurshistorie eines Tickers. Mit period1=0 lieferte der Reiter für historische Daten von MSFT jeden Tagesbalken seit 1986.
- Validieren Sie jede Seite, auch wenn sie 200 zurückgibt. FB, Metas altes Symbol, lieferte einen ProShares-ETF, und der Londoner Kurs von Vodafone war in Pence.
- Wechseln Sie zu einem Server, indem Sie die Abruffunktion austauschen. Die Web Unlocker API von Bright Data fügt IP-Rotation und automatische Wiederholungen hinzu. Oder Bright Datas Yahoo Finance Scraper API liefert strukturierte Datensätze.
Wo Yahoo Finance seine Daten speichert
Die Zahlen auf einer Kursseite sind als JSON im HTML eingebettet. Yahoo rendert die Seiten serverseitig mit SvelteKit, einem JavaScript-Framework, und ruft während des Renderns seine eigenen JSON-APIs auf. SvelteKit bindet jede Antwort in das HTML ein, sodass der Browser sie wiederverwenden kann, ohne sie erneut abzurufen. Jede Antwort steht in einem eigenen Script-Tag, das ein data-sveltekit-fetched-Attribut und die Quell-API-URL in data-url enthält.
Ein Tag aus dem MSFT-Übersichtsreiter sieht so aus, mit gekürztem JSON-Inhalt:
<script type="application/json" data-sveltekit-fetched
data-url="https://query1.finance.yahoo.com/v1/finance/quoteType/MSFT?formatted=true&enablePrivateCompany=true&overnightPrice=true&lang=en-US&region=US"
data-hash="1ibomen" data-ttl="1800">
{"status":200,"statusText":"","headers":{"cache-control":"public, max-age=1800, stale-while-revalidate=1800"},"body":"{\"quoteType\":{\"result\":[{\"symbol\":\"MSFT\",\"quoteType\":\"EQUITY\",\"exchange\":\"NMS\",\"longName\":\"Microsoft Corporation\"}],\"error\":null}}"}
</script>Das Feld body enthält die API-Antwort als JSON-String. Das Parsen eines Tags benötigt 2 json.loads()-Aufrufe. Der erste Aufruf parst den Wrapper, der zweite parst den body-String. Jeder Reiter einer Kursseite bettet einen anderen Satz von API-Antworten ein:
| Reiter | Eingebettete API-Antwort | Was Sie daraus lesen können |
|---|---|---|
/quote/MSFT/ |
v10/finance/quoteSummary und v7/finance/spark |
Kurs, Marktkapitalisierung, KGV, Dividende, 52-Wochen-Spanne, Analysten-Kursziele, bis zu 24 Stunden 5-Minuten-Schlusskurse |
/quote/MSFT/history/ |
v8/finance/chart |
Tägliche, wöchentliche oder monatliche Kurse, bereinigter Schlusskurs, Splits, Dividenden |
/quote/MSFT/financials/, balance-sheet/, cash-flow/ |
ws/fundamentals-timeseries |
Jährliche und rollierende 12-Monats-Posten |
/quote/MSFT/analysis/ |
v10/finance/quoteSummary mit earningsTrend |
EPS- und Umsatzschätzungen, Analystenanzahl, Gewinnüberraschungen |
/quote/MSFT/key-statistics/ |
ws/fundamentals-timeseries |
Quartalsweise Marktkapitalisierung, Unternehmenswert und Bewertungskennzahlen |
/quote/MSFT/profile/ |
v10/finance/quoteSummary mit assetProfile |
Schlüsselmanager, Mitarbeiteranzahl, Branche, SEC-Einreichungen |
/quote/MSFT/holders/ |
v10/finance/quoteSummary mit Eigentümer-Modulen |
Institutionelle, Fonds- und Insider-Anteilseigner |
/quote/MSFT/options/ |
v7/finance/options |
Die Optionskette für den nächsten Verfallstermin sowie die Liste der Verfallstermine |
Yahoos API-Hosts, query1.finance.yahoo.com und query2.finance.yahoo.com, liefern dasselbe JSON, und die Open-Source-Bibliothek yfinance ruft sie direkt auf. Auf diesen Hosts gaben die Endpunkte quote, quoteSummary und options 401 zurück, wenn eine Anfrage keinen Crumb hatte. Ein Crumb ist ein Token, das Yahoo mit jedem Session-Cookie ausgibt und als crumb=-Abfrageparameter erwartet.
Der alte CSV-Download gab 401 User is not logged in zurück. Auf beiden API-Hosts verbietet robots.txt jeden Pfad (Disallow: /). Die in die Kursseite eingebetteten Antworten benötigen weder Cookie, noch Crumb, noch Zugriff auf den API-Host:
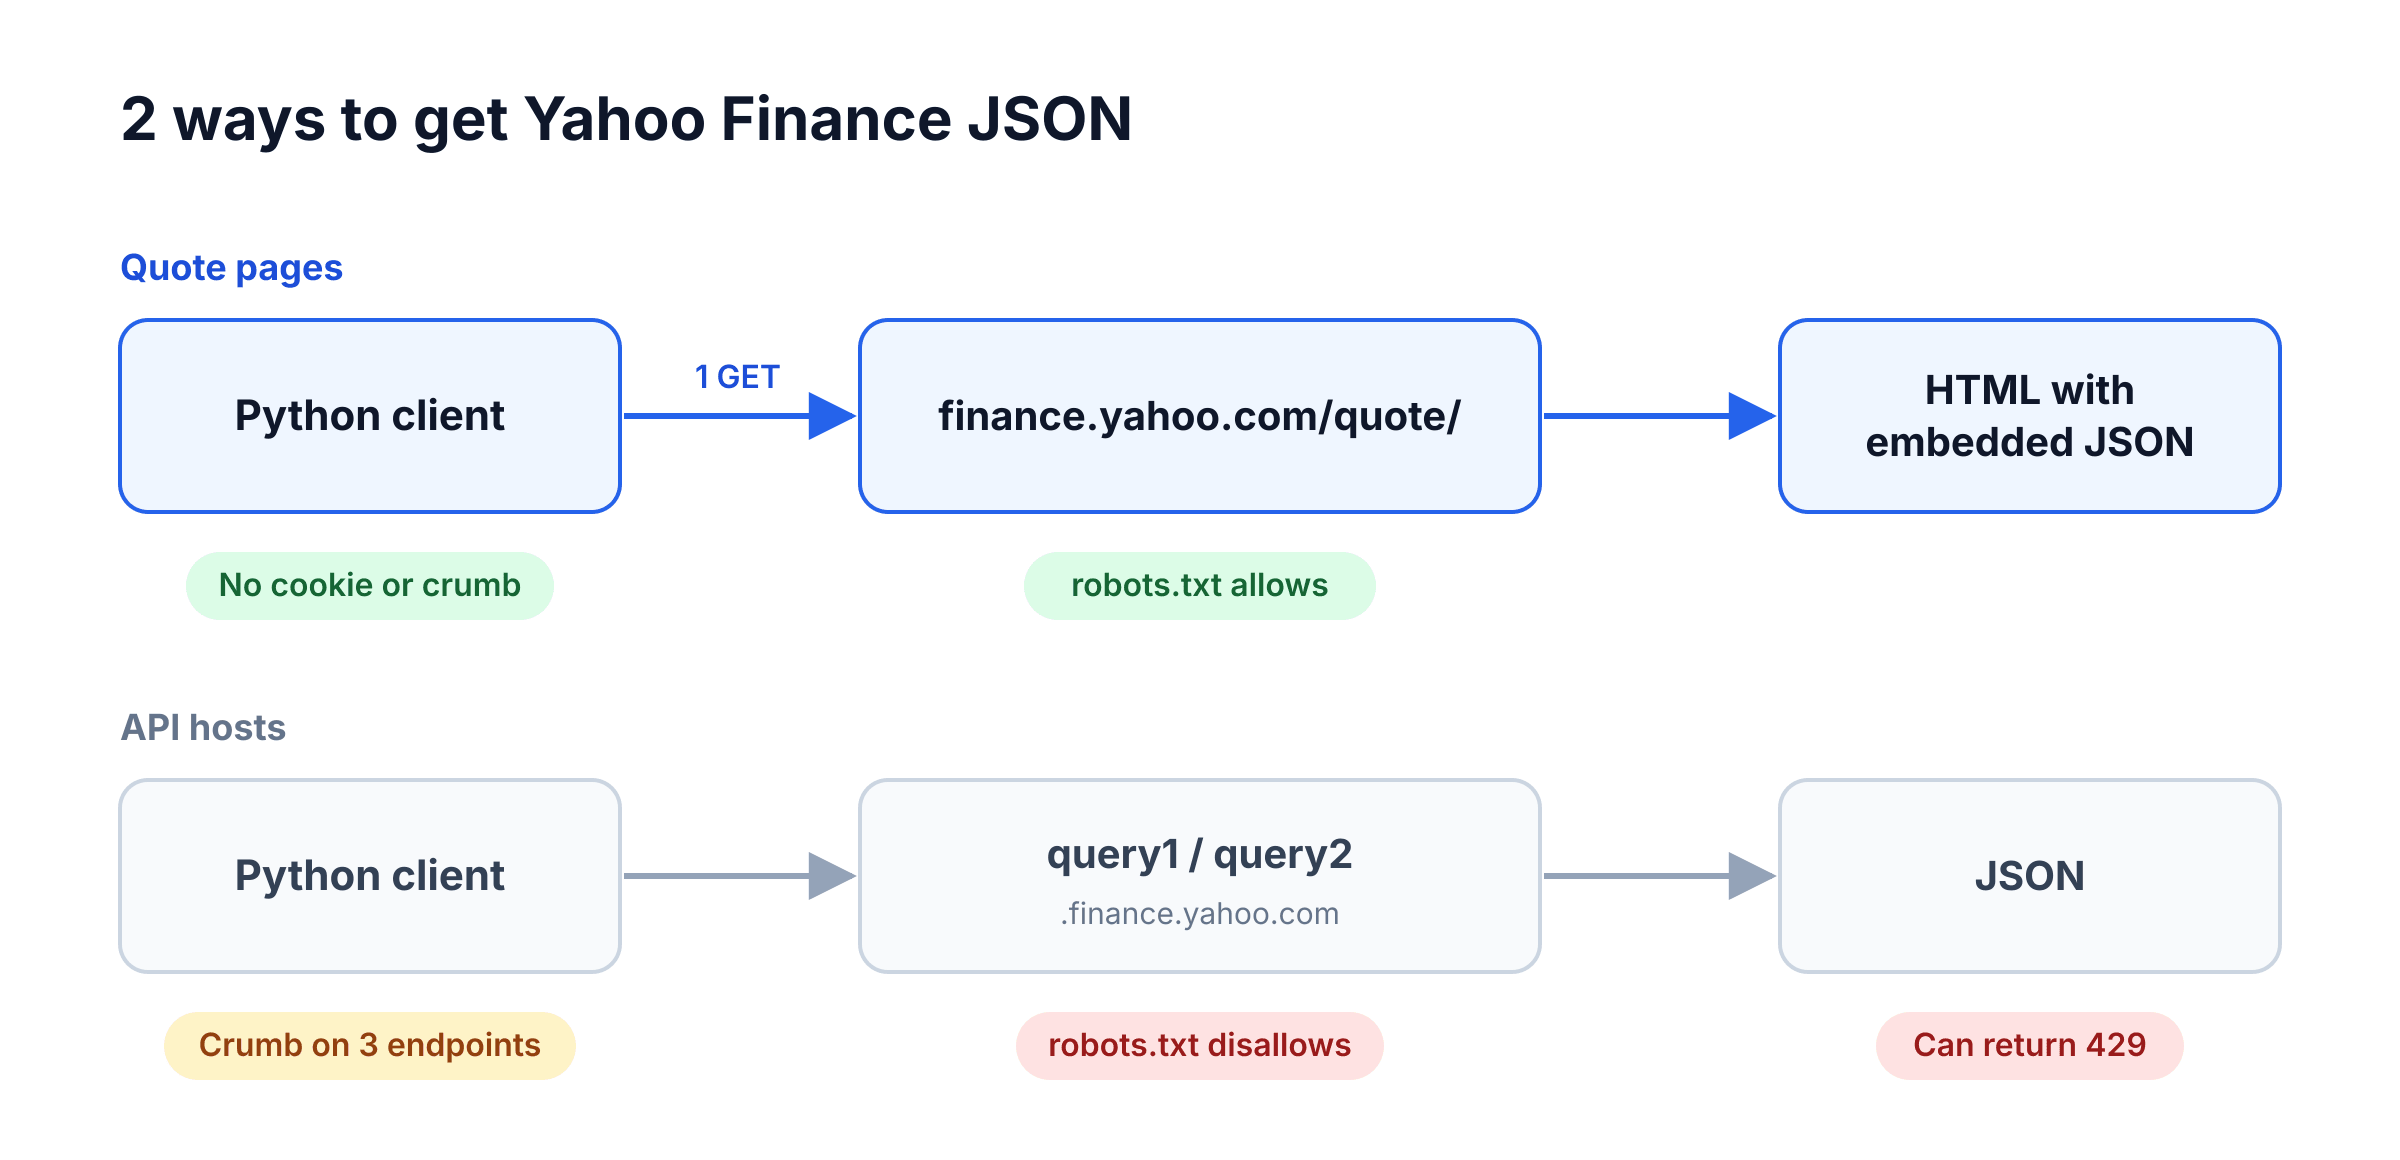
Die Skripte lesen nur die Kursseiten, rufen also nie die API-Hosts auf.
Viele ältere Tutorials lesen Kurse mit CSS-Selektoren, die nicht mehr funktionieren. Auf der MSFT-Seite trafen [data-symbol="MSFT"][data-field="regularMarketPrice"] und #quote-summary [data-test="PREV_CLOSE-value"] 0 Elemente. Der weniger spezifische Selektor fin-streamer[data-field="regularMarketPrice"] traf 9, und der erste Treffer enthielt den Kurs des S&P 500 aus der Marktübersicht der Seite.
Andere Tutorials automatisieren einen Browser. Das eingebettete JSON macht einen Browser für Kurse, Tageshistorie, Jahresabschlüsse und Schätzungen überflüssig, da 1 HTTP-Anfrage pro Reiter dieselben Daten liefert.
Falls Sie einen Browser verwenden, lesen Sie die rohe HTML-Antwort, da der clientseitige Code von SvelteKit jedes Script-Tag nach dem Lesen entfernt. Bei 2 von 4 Testseitenaufrufen lieferte page.content() die Seite ohne die Tags. Bei einem davon las der Scraper die Seite, sobald DOMContentLoaded ausgelöst wurde.
Warum Yahoo Finance bei der ersten Anfrage 429 zurückgeben kann
Yahoos Antworten hingen vom User-Agent des Clients und dem TLS-Handshake ab, sodass ein Client schon bei der ersten Anfrage eine 429 erhalten kann. Der server: ATS-Header in den Antworten identifiziert Apache Traffic Server. Mit Standardeinstellungen erhielt Pythons requests-Bibliothek bei der ersten Anfrage eine 429. Die 429-Antworten hatten 2 Formen:
- Mit dem Standard-User-Agent
python-requests/2.34.2erhielt jeder TLS-Stack in der Tabelle unten eine 23-Byte-AntwortEdge: Too Many Requests. Pythons requests-Bibliothek erhielt dieselbe Antwort auffinance.yahoo.com. - Auf den API-Hosts erhielten manche Browser-User-Agents über Pythons TLS-Stack eine 19-Byte-Antwort
Too Many Requests.
Die Tabelle zeigt, wie query1, der API-Host, den yfinance verwendet, auf Chart-Anfragen reagierte, die von 1 Residential-Verbindung im Abstand von mindestens 1,5 Sekunden gesendet wurden. Die Bibliothek curl_cffi, ein Python-HTTP-Client, kann den TLS-Handshake eines Browsers imitieren. Jede Zeile paart einen TLS-Stack mit einem User-Agent-Header:
| TLS-Stack | User-Agent-Header | Erhielt 429 |
|---|---|---|
| Python requests (OpenSSL) | python-requests/2.34.2, der Standard |
5 von 5 |
| Python requests (OpenSSL) | Chrome 140 auf macOS | 26 von 26 |
| Python requests (OpenSSL) | Firefox 147 auf Windows | 16 von 17 |
| Python requests (OpenSSL) | Safari 26 auf macOS | 8 von 11 |
| Python requests (OpenSSL) | Chrome 150 auf macOS | 3 von 6 |
| Python requests (OpenSSL) | Chrome 150 auf Windows | 0 von 11 |
| Python requests (OpenSSL) | Mozilla/5.0 allein |
0 von 11 |
| curl_cffi (Chrome-, Firefox- oder Safari-Handshake) | Chrome 140 oder 150, Firefox 147, Safari 26, oder Mozilla/5.0 |
0 von 80 |
| curl_cffi (dieselben 3 Handshakes) | python-requests/2.34.2 |
15 von 15 |
Warum ist der TLS-Handshake wichtig?
Yahoos Antwort hing vom TLS-Stack ab, selbst wenn der User-Agent gleich war. In einem kontrollierten Test sendeten requests und curl_cffi denselben User-Agent (Chrome 140 auf macOS) und denselben Accept-Header über HTTP/1.1 von derselben IP-Adresse. Nur der HTTP-Client und sein TLS-Stack änderten sich. Über Pythons requests-Bibliothek gelangen 0 von 8 Anfragen, über curl_cffis Chrome-TLS-Stack gelangen 8 von 8.
Die 2 Stacks unterscheiden sich schon, bevor überhaupt ein Header gesendet wird. Ein JA4-Fingerabdruck, eine gängige Form des TLS-Fingerprintings, fasst das ClientHello zusammen, die erste Nachricht, die ein Client in einem TLS-Handshake sendet. Pythons OpenSSL-Handshake erzeugte t13d1812h1_85036bcba153_b26ce05bbdd6, und curl_cffis chrome-Ziel erzeugte t13d1516h2_8daaf6152771_806a8c22fdea, was zu Chromes Chiffren-Suiten passt. Fordern Sie https://tls.peet.ws/api/all von Ihrem eigenen Client an, um zu sehen, was er sendet.
Jedes Ergebnis hing von der Kombination aus TLS-Stack und User-Agent ab. Der String Mozilla/5.0 allein war 11 von 11 Mal über Pythons TLS erfolgreich. Chrome 140 auf macOS scheiterte 26 von 26 Mal, und Firefox 147 scheiterte 16 von 17 Mal. Ein realistischer Browser-User-Agent kann Pythons requests-Bibliothek also häufiger scheitern lassen.
Mit dem TLS-Handshake eines Browsers über curl_cffi waren die Browser-User-Agents in der Tabelle bei 80 von 80 Anfragen erfolgreich. In einem kleineren Test akzeptierte finance.yahoo.com selbst den Chrome-140-String über Pythons TLS und blockierte den Standard-String python-requests. Der Scraper-Code verwendet curl_cffi auch auf finance.yahoo.com, sodass User-Agent und TLS-Handshake beide zu Chrome passen.
Wenn Sie den User-Agent eines Browsers senden, senden Sie auch dessen TLS-Handshake mit.
Spielt die Anfragerate eine Rolle?
Nicht für die 429-Fehler bei ersten Anfragen, die vom Client abhängen. Bei 8 Threads forderte curl_cffi alle 503 S&P-500-Kursseiten an, dann 501 Seiten mit historischen Daten, ohne eine 429. Das entspricht dem Volumen einer täglichen S&P-500-Aktualisierung. Falls bei höherem Volumen eine 429 auftaucht, führt der Scraper-Code ein Backoff durch und wiederholt die Anfrage.
Ein im Issue-Tracker von yfinance geposteter Rate-Limiting-Codeschnipsel begrenzt den Traffic auf 60 Anfragen pro Minute, 360 pro Stunde und 8.000 pro Tag. Diese Zahlen stammen von der Rate-Limit-Seite von Yahoos DSP Traffic API. Yahoo DSP ist eine Demand-Side-Plattform für den Anzeigenkauf, der Codeschnipsel verwendet also die Limits eines anderen Produkts.
Die yfinance-Bibliothek erhielt ebenfalls 429-Fehler von Yahoo, die sie als YFRateLimitError('Too Many Requests. Rate limited. Try after a while.') auslöste. Nachdem ein Issue-Thread über 429-Fehler mehr als 140 Kommentare erhalten hatte, übernahmen die Maintainer von yfinance dieselbe Lösung: einen Browser-TLS-Handshake. Version 0.2.58 (2025) stellte die Bibliothek auf curl_cffi um, und Version 1.7.0 erstellt ihre Standard-Session mit impersonate="chrome".
Funktioniert der Code von einem Cloud-Server aus?
Ja, auf 3 GitHub-Actions-Runnern mit Microsoft-Azure-IP-Adressen. Auf jedem Runner lieferte curl_cffis erste Anfrage eine Kursseite für jedes von 20 Symbolen, von US-Aktien und ETFs bis zu Krypto und ausländischen Notierungen. In einem zweiten Durchlauf forderte jeder Runner alle 503 S&P-500-Kursseiten an, ohne eine 429.
Die Skripte lieferten dieselbe Historie, Berichte und Schätzungen wie von zu Hause aus. Auf den Runnern erhielt Pythons requests-Bibliothek mit ihrem Standard-User-Agent dieselbe 23-Byte-429-Antwort, während yfinance MSFTs vollständige Tageshistorie abrief.
Gemeldete Cloud-Fehler betrafen ältere Clients und geteilte IP-Bereiche, testen Sie die Skripte also von Ihrem eigenen Server aus, bevor Sie einen Job planen. Im Jahr 2025, bevor yfinance auf curl_cffi umstieg, entfernten dessen Maintainer ihren GitHub-Actions-Testjob, nachdem er fehlgeschlagen war, Daten von Yahoo abzurufen. Ein anderer Entwickler führte 401-“Invalid Crumb”-Antworten auf den geteilten Free-Tier-IP-Bereich von Render, einer Cloud-Plattform, zurück. Dieselben Aufrufe funktionierten von einer Residential-IP aus.
Das eingebettete JSON aus einer Kursseite extrahieren
Sie benötigen Python 3.11 oder höher und 5 Pakete. Der Code wurde unter Python 3.11, 3.13 und 3.14 mit curl_cffi 0.16.3, beautifulsoup4 4.15.0, lxml 6.1.3, pandas 3.0.6 und requests 2.34.2 getestet. Installieren Sie sie mit pip:
pip install curl_cffi beautifulsoup4 lxml pandas requestsGrundlagen zum Python-Scraping finden Sie in unserem Leitfaden zum Web-Scraping mit Python. Das Kernmodul ruft einen einzelnen Reiter ab, prüft, ob Yahoo eine Kursseite zurückgegeben hat, und liefert die eingebetteten Antworten, indiziert nach ihrer API-URL. Speichern Sie es als yahoo_embedded.py, da die Skripte, die Yahoos Seiten lesen, davon abhängen:
import json
import random
import threading
import time
from urllib.parse import quote

from bs4 import BeautifulSoup
from curl_cffi import requests

QUOTE_URL = "https://finance.yahoo.com/quote"
_local = threading.local()


class SymbolNotFound(Exception):
    """Yahoo returned its lookup page or a soft 404 instead of a quote page."""


def page_url(symbol: str, tab: str = "") -> str:
    return (
        f"{QUOTE_URL}/{quote(symbol.upper(), safe='')}/{tab}"  # ^GSPC becomes %5EGSPC
    )


def embedded(html: str) -> dict[str, dict]:
    """Map the API URLs the page was rendered from to their JSON bodies."""
    soup = BeautifulSoup(html, "lxml")
    found = {}
    for tag in soup.select('script[type="application/json"][data-sveltekit-fetched]'):
        try:
            wrapper = json.loads(tag.string)
            found[tag["data-url"]] = json.loads(wrapper["body"])
        except (TypeError, KeyError, ValueError):
            continue  # an embedded response whose body isn't JSON
    return found


def pick(found: dict[str, dict], path: str) -> dict:
    """Return the first embedded response whose URL contains `path`."""
    for url, body in found.items():
        if path in url:
            return body
    raise LookupError(f"no embedded response for {path}")


def is_quote_page(html: str, symbol: str) -> bool:
    """True for a quote page, False otherwise, SymbolNotFound for an unknown symbol."""
    found = embedded(html)
    if any("/v1/finance/lookup" in url for url in found):
        raise SymbolNotFound(symbol)
    for url, body in found.items():
        if "/v1/finance/quoteType/" in url:
            result = (body.get("quoteType") or {}).get("result") or [{}]
            if not result[0].get("exchange"):
                # A soft 404, as for BRK.B (Yahoo spells it BRK-B)
                raise SymbolNotFound(symbol)
            return True
    return False


def _session() -> requests.Session:
    # One Chrome-impersonating session per thread, as curl_cffi recommends.
    if not hasattr(_local, "session"):
        _local.session = requests.Session(impersonate="chrome")
    return _local.session


def fetch_page(
    symbol: str, tab: str = "", params: dict | None = None, attempts: int = 4
) -> str:
    """Return the HTML of a quote page, for example tab="history/"."""
    for attempt in range(attempts):
        if attempt:
            time.sleep(2**attempt + random.random())  # back off before each retry
        try:
            response = _session().get(
                page_url(symbol, tab), params=params, timeout=30, allow_redirects=False
            )
        except requests.RequestException:
            continue  # timeout or dropped connection
        if response.is_redirect:
            location = response.headers.get("location", "")
            if "/lookup" in location:
                raise SymbolNotFound(symbol)
            # For example, a tab that doesn't exist
            raise LookupError(f"{symbol} {tab}: Yahoo redirected to {location}")
        if response.status_code == 200 and is_quote_page(response.text, symbol):
            return response.text
        if 400 <= response.status_code < 500 and response.status_code != 429:
            response.raise_for_status()
    # Every attempt timed out or got a 429, a 5xx, or a page without quote data
    raise RuntimeError(f"{symbol} {tab}: no quote data after {attempts} attempts")


if __name__ == "__main__":
    from urllib.parse import urlsplit

    found = embedded(fetch_page("MSFT"))
    print(len(found), "embedded responses")
    for url in found:
        if url.startswith("https://"):
            print(urlsplit(url).netloc, urlsplit(url).path)
Das Modul behandelt 3 Sonderfälle:
allow_redirects=Falsestoppt den Client bei einer Weiterleitung, anstatt ihr zu folgen. Eine 302 zu/lookup/bedeutet ein unbekanntes Symbol, daher löst das ModulSymbolNotFoundaus. Es ruft die Lookup-Seite nicht ab, die robots.txt verbietet. Jede andere Weiterleitung, etwa ein Reiter, den ein ETF nicht hat, löst beim ersten VersuchLookupErroraus.is_quote_page()prüft auf diequoteType-Antwort, da ein Status 200 allein nicht beweist, dass die Seite Daten enthält. Alle 11 MSFT-Reiter betteten sie ein, einschließlichnews/. EinquoteTypeohne Börse bedeutet einen Soft-404, eine Seite mit Status 200, aber ohne Kursdaten. Yahoo lieferte diese Art von Seite fürBRK.B, da es das Symbol alsBRK-Bschreibt.quote(symbol.upper(), safe='')setzt das Symbol in Großbuchstaben und prozentkodiert Indexsymbole wie^GSPC, da^erst nach Kodierung ein gültiges URL-Zeichen ist.
Für MSFT listet das Modul die Yahoo-APIs auf, die die Seite aufruft:
23 embedded responses
query1.finance.yahoo.com /ws/obi-integration/v1/premiumTiersMeta
query1.finance.yahoo.com /v1/finance/quoteType/MSFT
query1.finance.yahoo.com /v7/finance/spark
query1.finance.yahoo.com /v6/finance/quote/marketSummary
query1.finance.yahoo.com /v7/finance/quote
query1.finance.yahoo.com /v7/finance/quote
query1.finance.yahoo.com /v6/finance/recommendationsbysymbol/MSFT
query1.finance.yahoo.com /v6/finance/markettime
query1.finance.yahoo.com /v7/finance/spark
query1.finance.yahoo.com /v10/finance/quoteSummary/MSFT
query1.finance.yahoo.com /v1/finance/trending/US
query1.finance.yahoo.com /v7/finance/quote
query1.finance.yahoo.com /v1/finance/screener/predefined/saved
Die Statistiken des Übersichtsreiters stammen aus v10/finance/quoteSummary, das für MSFT etwa 223 KB JSON über 17 Module enthielt. Die Auflistung zeigt die 13 absoluten API-URLs, und die übrigen 10 Antworten stammten von Yahoos eigenen /xhr/-Endpunkten. Die meisten der 23 liefern Daten für Seiten-Widgets wie Trend-Ticker und Marktübersichten. Die Anzahl variiert: Von US-Cloud-Runnern aus bettete dieselbe Seite 26 Antworten ein, und die zusätzlichen enthielten price-insights.
Kurs-, Bewertungs- und Rating-Felder parsen
Viele Zahlen innerhalb von quoteSummary sind {"raw": 516.17, "fmt": "516.17"}-Paare, daher behält eine Hilfsfunktion den Rohwert. Diese Funktion liefert 20 Kursfelder. Speichern Sie sie als quote_summary.py, da die Skripte für Schätzungen und Stapelverarbeitung sie wiederverwenden:
import json

from yahoo_embedded import embedded, fetch_page, pick


def raw(module: dict, key: str):
    """Many numbers are {"raw": 516.17, "fmt": "516.17"} pairs. Keep the raw value."""
    value = module.get(key)
    return value.get("raw") if isinstance(value, dict) else value


def quote_summary(symbol: str, fetch=fetch_page) -> dict:
    found = embedded(fetch(symbol))
    result = pick(found, "/v10/finance/quoteSummary/")["quoteSummary"]["result"][0]
    price = result.get("price", {})
    detail = result.get("summaryDetail", {})
    stats = result.get("defaultKeyStatistics", {})
    analysts = result.get("financialData", {})
    return {
        "symbol": price.get("symbol"),
        "name": price.get("longName") or price.get("shortName"),
        "quote_type": price.get("quoteType"),
        "currency": price.get("currency"),
        "price": raw(price, "regularMarketPrice"),
        "change_pct": raw(price, "regularMarketChangePercent"),
        "market_time": raw(price, "regularMarketTime"),
        "market_state": price.get("marketState"),
        "delay_minutes": price.get("exchangeDataDelayedBy"),
        "market_cap": raw(price, "marketCap"),
        "trailing_pe": raw(detail, "trailingPE"),
        "forward_pe": raw(detail, "forwardPE"),
        "dividend_yield": raw(detail, "dividendYield"),
        "beta": raw(detail, "beta"),
        "week52_low": raw(detail, "fiftyTwoWeekLow"),
        "week52_high": raw(detail, "fiftyTwoWeekHigh"),
        "eps_ttm": raw(stats, "trailingEps"),
        "target_mean": raw(analysts, "targetMeanPrice"),
        "recommendation": analysts.get("recommendationKey"),
        "reporting_currency": analysts.get("financialCurrency"),
    }


if __name__ == "__main__":
    print(json.dumps(quote_summary("MSFT"), indent=2))
Für MSFT druckte die Funktion Rohwerte für alle 20 Felder nach Börsenschluss:
{
  "symbol": "MSFT",
  "name": "Microsoft Corporation",
  "quote_type": "EQUITY",
  "currency": "USD",
  "price": 516.17,
  "change_pct": 0.0366316,
  "market_time": 1790366401,
  "market_state": "CLOSED",
  "delay_minutes": 0,
  "market_cap": 3832843862016,
  "trailing_pe": 28.739979,
  "forward_pe": 21.801512,
  "dividend_yield": 0.0076,
  "beta": 1.108,
  "week52_low": 349.2,
  "week52_high": 553.72,
  "eps_ttm": 17.96,
  "target_mean": 577.26135,
  "recommendation": "strong_buy",
  "reporting_currency": "USD"
}
Der Übersichtsreiter zeigte dieselben Zahlen formatiert, etwa eine Marktkapitalisierung von 3,833T, ein KGV von 28,74 und eine Dividendenrendite von 0,76%:
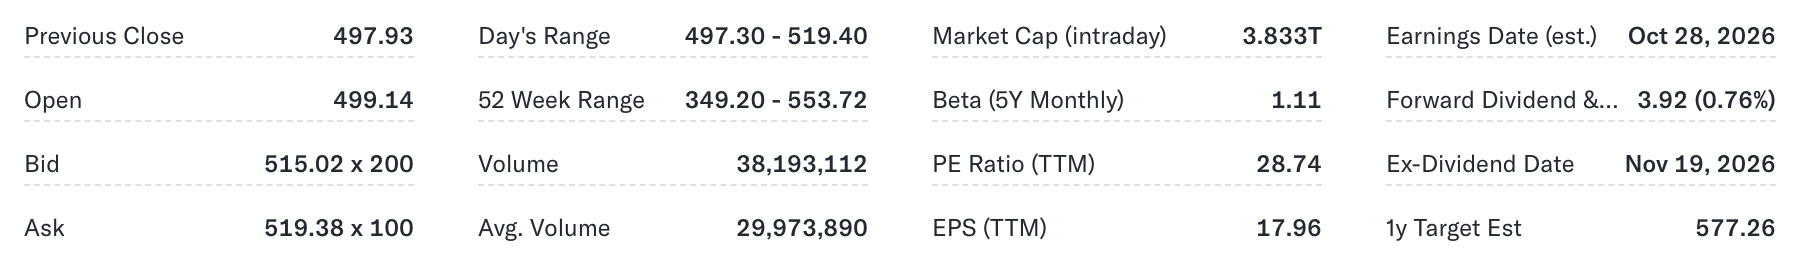
Das JSON enthält stattdessen die Rohwerte, etwa 3832843862016 für die Marktkapitalisierung von 3,833T.
In den Rohwerten sind Prozentsätze Bruchzahlen, daher ist ein change_pct von 0,0366316 eine Bewegung von 3,66%, und eine dividend_yield von 0,0076 entspricht 0,76%. Die Funktion liest jedes Modul mit .get(), da die eingebetteten Module je nach Anlageklasse unterschiedlich sind. SPY, ^GSPC, BTC-USD und EURUSD=X lieferten alle Kurse ohne das Modul financialData, daher waren ihre Analystenfelder None. SPY enthielt stattdessen fundProfile und topHoldings.
Die vollständige Kurshistorie in 1 Anfrage herunterladen
Der Reiter für historische Daten (history/) gibt die Parameter period1, period2 und frequency aus seiner eigenen URL an die eingebettete Chart-Anfrage weiter. Beide Zeitraum-Parameter sind Unix-Zeitstempel, daher fragt ein period1 von 0 nach jedem Balken seit dem 1. Januar 1970. Die Datumsauswahl beginnt dann an diesem Datum, und frequency=1d zeigt tägliche Zeilen:
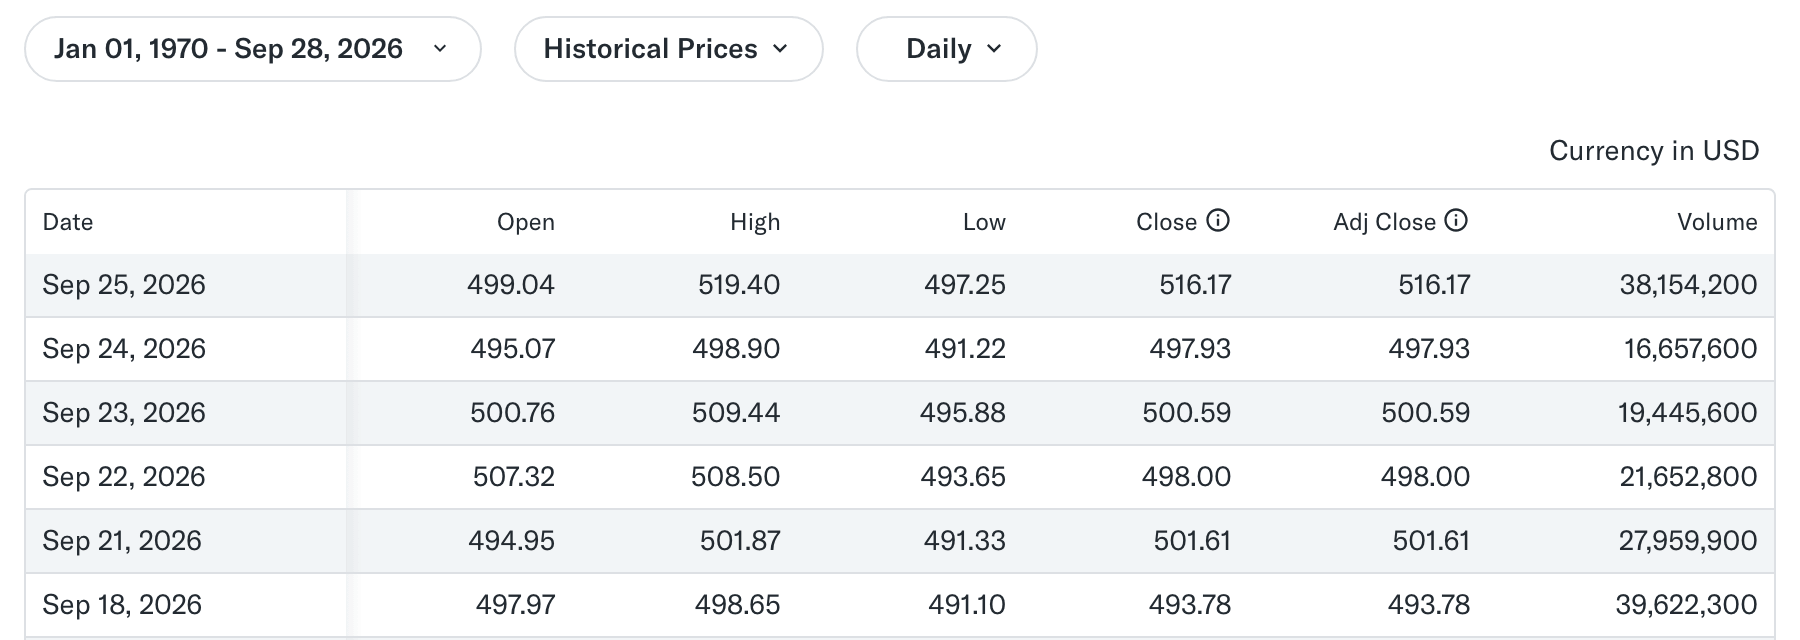
Die neueste Zeile der Tabelle entspricht der letzten Zeile, die price_history() unten druckt.
Die Funktion price_history() wandelt die eingebettete Chart-Antwort in einen DataFrame um, der nach Datumswerten in der Zeitzone der Börse indiziert ist. Speichern Sie sie als price_history.py:
import time

import pandas as pd

from yahoo_embedded import embedded, fetch_page, pick


def price_history(
    symbol: str, frequency: str = "1d", fetch=fetch_page
) -> tuple[pd.DataFrame, dict]:
    """Every bar since 1970 at 1d, 1wk or 1mo, plus split and dividend events."""
    params = {"period1": 0, "period2": int(time.time()), "frequency": frequency}
    found = embedded(fetch(symbol, "history/", params))
    result = pick(found, "/v8/finance/chart/")["chart"]["result"][0]
    bars, meta = result["indicators"]["quote"][0], result["meta"]
    utc = pd.to_datetime(result["timestamp"], unit="s", utc=True)
    index = utc.tz_convert(meta["exchangeTimezoneName"]).tz_localize(None).normalize()
    frame = pd.DataFrame(
        {
            "open": bars["open"],
            "high": bars["high"],
            "low": bars["low"],
            "close": bars["close"],
            "adj_close": result["indicators"]["adjclose"][0]["adjclose"],
            "volume": bars["volume"],
        },
        index=index,
    )
    if frequency != "1d" and result["timestamp"][-1] == meta.get("regularMarketTime"):
        frame = frame.iloc[:-1]  # Yahoo appends the latest session as an extra bar
    return frame.dropna(how="all"), result.get("events", {})


if __name__ == "__main__":
    history, events = price_history("MSFT")
    print(history.tail(3).round(2).to_string())
    print(
        f"{len(history):,} daily bars from {history.index[0]:%Y-%m-%d} "
        f"to {history.index[-1]:%Y-%m-%d}"
    )
    splits = sorted(
        pd.Timestamp(s["date"], unit="s").date()
        for s in events.get("splits", {}).values()
    )
    if splits:
        print(f"{len(splits)} splits, the last one on {splits[-1]}")
Eine einzige Anfrage lieferte die vollständige Historie von MSFT:
              open    high     low   close  adj_close    volume
2026-09-23  500.76  509.44  495.88  500.59     500.59  19445600
2026-09-24  495.07  498.90  491.22  497.93     497.93  16657600
2026-09-25  499.04  519.40  497.25  516.17     516.17  38154200
10,213 daily bars from 1986-03-13 to 2026-09-25
9 splits, the last one on 2003-02-18
Über den API-Host lieferte yfinance dieselben 10.213 Balken für diesen Zeitraum. Beachten Sie diese 5 Details in einer Historie-Pipeline:
- In den Tests begann die Historie nie vor 1970. Yahoos Hilfeseite zu historischen Daten besagt, dass Kurse in der Regel nicht früher beginnen. Coca-Cola wird seit 1919 gehandelt, aber die vollständige Historie begann am 02.01.1970. Ein negatives
period1lieferte 404. frequencyunterstützt1d,1wkund1mo. Bei1wkund1mohängte Yahoo die letzte Sitzung als zusätzlichen Balken an, und die Funktion entfernt ihn. Ohne diesen Balken kann der letzte wöchentliche oder monatliche Balken die letzte Handelssitzung ausschließen, holen Sie aktuelle Schlusskurse also aus Tagesbalken.- Intraday-Werte wie
1h,5mund1mlieferten stattdessen Tagesbalken. Der Übersichtsreiter bettet bis zu 24 Stunden 5-Minuten-Schlusskurse aus/v7/finance/sparkein. Er bettet auch eine zweite Spark-Antwort für die Marktübersicht ein, wählen Sie also die Antwort aus, derensymbols-Parameter zu Ihrem Ticker passt. Die Kursseiten enthalten nur diese 24 Stunden Intraday-Daten, da längere Intraday-Historien von den API-Hosts stammen, die robots.txt verbietet. - Yahoo bereinigt
closeum Splits undadj_closeum Splits und Dividenden. Alte Balken ändern sich nach jedem neuen Split oder jeder Dividende, speichern Sie die Split- und Dividendenereignisse also bei jedem Download. - Die Seitengröße wächst mit dem Datumsbereich. Bei vollständigem Datumsbereich war der Reiter für historische Daten von MSFT 4,9 MB HTML, der Übersichtsreiter etwa 1,1 MB. Setzen Sie für eine tägliche Aktualisierung
period1auf einen aktuellen Zeitstempel, und laden Sie den vollständigen Bereich nach jedem neuen Split oder jeder Dividende erneut herunter.
Finanzberichte und Analystenschätzungen abrufen
Berichte und Schätzungen befinden sich auf verschiedenen Reitern, daher erhält jeder seine eigene Funktion.
Jährliche Finanzberichte abrufen
Finanzberichte stammen aus der fundamentals-timeseries-Antwort auf den Reitern für Gewinn- und Verlustrechnung, Bilanz und Kapitalfluss. Auf dem Finanzen-Reiter von MSFT enthielt diese Antwort 96 jährliche Serien und 96 rollierende 12-Monats-Serien. statement() behält die jährlichen Serien bei und pivotiert sie in eine Tabelle mit 1 Spalte pro Geschäftsjahr. Speichern Sie sie als statements.py:
import pandas as pd

from yahoo_embedded import embedded, fetch_page, pick


def statement(symbol: str, tab: str = "financials/", fetch=fetch_page) -> pd.DataFrame:
    """Annual line items from the financials/, balance-sheet/ or cash-flow/ tab."""
    found = embedded(fetch(symbol, tab))
    series = pick(found, "/fundamentals-timeseries/")["timeseries"]["result"]
    rows = []
    for item in series:
        name = item["meta"]["type"][0]  # for example "annualTotalRevenue"
        if not name.startswith("annual"):
            continue  # skip non-annual series, such as trailing 12 months
        for point in item.get(name) or []:
            if point:
                rows.append(
                    {
                        "line_item": name.removeprefix("annual"),
                        "fiscal_year_end": point["asOfDate"],
                        "value": point["reportedValue"]["raw"],
                    }
                )
    table = pd.DataFrame(rows).pivot(
        index="line_item", columns="fiscal_year_end", values="value"
    )
    return table.sort_index(axis=1)


if __name__ == "__main__":
    income = statement("MSFT")
    billions = (
        income.loc[["TotalRevenue", "GrossProfit", "OperatingIncome", "NetIncome"]].T
        / 1e9
    )
    billions["DilutedEPS"] = income.loc["DilutedEPS"]
    print(billions.round(2).to_string())
    print(f"{len(income)} line items")
Das Skript druckte 4 Geschäftsjahre der Gewinn- und Verlustrechnung, in Milliarden Dollar außer beim EPS:
line_item        TotalRevenue  GrossProfit  OperatingIncome  NetIncome  DilutedEPS
fiscal_year_end
2023-06-30             211.92       146.05            88.52      72.36        9.68
2024-06-30             245.12       171.01           109.43      88.14       11.80
2025-06-30             281.72       193.89           128.53     101.83       13.64
2026-06-30             331.84       225.46           155.24     133.75       17.95
47 line items
Auf dem Finanzen-Reiter zeigt Yahoo dieselben Zahlen in Tausend, sodass der Umsatz von 331,84B im Output als 331.839.000 erscheint:
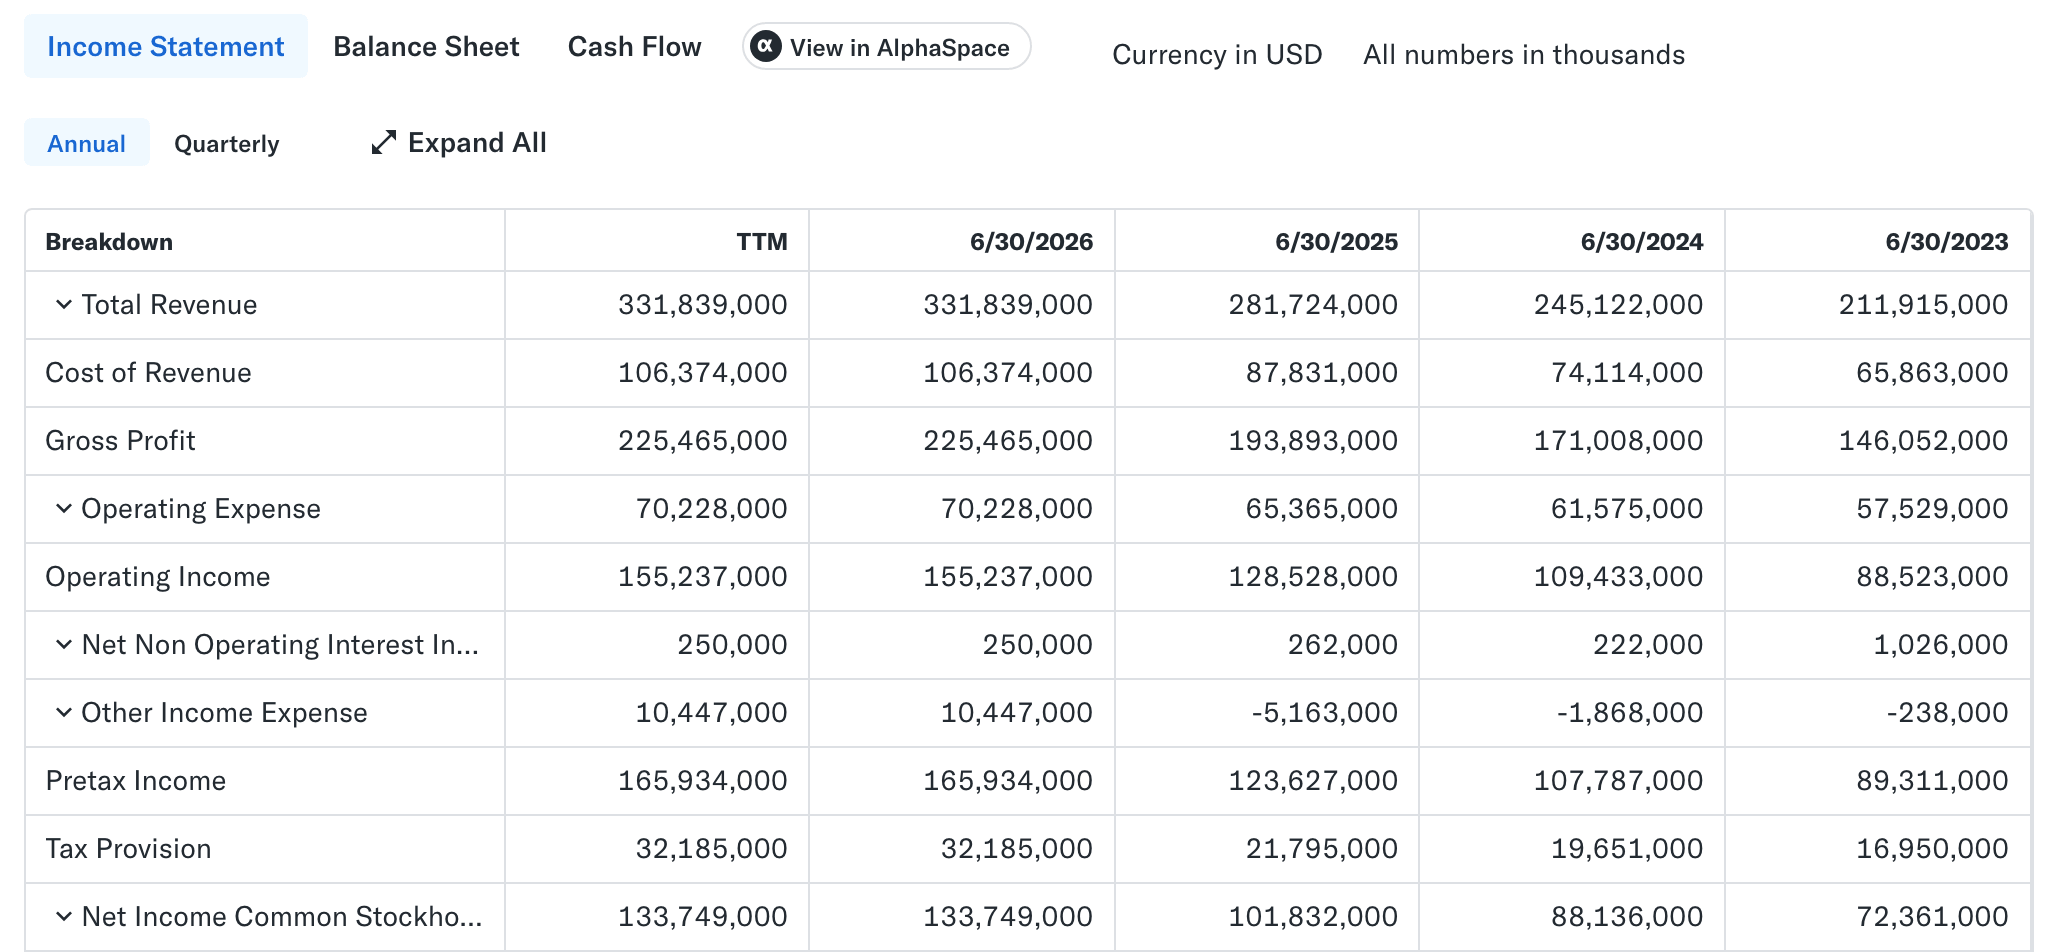
Die Ansichten Gewinn- und Verlustrechnung, Bilanz und Kapitalfluss sind die Reiter financials/, balance-sheet/ und cash-flow/, die statement() liest.
Für MSFT hatten 47 der 96 jährlichen Serien Werte. Die leeren Serien waren Posten wie Versicherungsansprüche, Vorzugsdividenden und Verbrauchsteuern. Für diese 4 Jahre lieferte die Funktion 79 Posten aus balance-sheet/ und 59 Posten aus cash-flow/. Quartalsberichte laden nur, nachdem Sie den Umschalter Quarterly ausgewählt haben, und kein getesteter URL-Parameter änderte das.
Überspringen Sie die Module incomeStatementHistory und balanceSheetHistory in quoteSummary. Deren Ertragszeilen hatten tatsächliche Werte nur für Gesamtumsatz und Nettogewinn, sowohl in der jährlichen als auch in der quartalsweisen Version. Die Bilanzzeilen hatten nur Daten. Andere Ertragsfelder enthielten 0 als Platzhalter, sodass ein Parser, der diese vertraut, einen Bruttogewinn von 0 speichern würde.
Analystenschätzungen abrufen
Der Analyse-Reiter bettet earningsTrend ein, das Konsens-EPS und -Umsatz für das laufende Quartal, das nächste Quartal, das laufende Jahr und das nächste Jahr enthält. estimates() flacht das in 1 Zeile pro Zeitraum ab. Speichern Sie sie als estimates.py:
import pandas as pd

from quote_summary import raw
from yahoo_embedded import embedded, fetch_page, pick


def estimates(symbol: str, fetch=fetch_page) -> pd.DataFrame:
    """Consensus EPS and revenue for the current and next quarter and year."""
    found = embedded(fetch(symbol, "analysis/"))
    result = pick(found, "/v10/finance/quoteSummary/")["quoteSummary"]["result"][0]
    rows = []
    for period in result["earningsTrend"]["trend"]:
        eps, revenue = period["earningsEstimate"], period["revenueEstimate"]
        revenue_avg = raw(revenue, "avg")
        rows.append(
            {
                "period": period["period"],  # 0q, +1q, 0y, +1y
                "ends": period["endDate"],
                "eps_avg": raw(eps, "avg"),
                "eps_low": raw(eps, "low"),
                "eps_high": raw(eps, "high"),
                "eps_analysts": raw(eps, "numberOfAnalysts"),
                "revenue_avg_bn": None if revenue_avg is None else revenue_avg / 1e9,
                "revenue_analysts": raw(revenue, "numberOfAnalysts"),
            }
        )
    return pd.DataFrame(rows).set_index("period")


if __name__ == "__main__":
    print(estimates("MSFT").round(2).to_string())
Für MSFT stammte jede Schätzung von 25 bis 51 Analysten:
              ends  eps_avg  eps_low  eps_high  eps_analysts  revenue_avg_bn  revenue_analysts
period
0q      2026-09-30     4.72     4.43      4.83            25           90.66                38
+1q     2026-12-31     4.82     4.72      5.02            25           95.49                37
0y      2027-06-30    19.76    19.21     20.70            33          391.04                50
+1y     2028-06-30    23.68    22.08     26.00            32          467.27                51
Auf dem Analyse-Reiter zeigt die Earnings-Estimate-Tabelle dieselben EPS-Zahlen. Ihre Spalten Current Qtr., Next Qtr., Current Year und Next Year entsprechen den Zeilen 0q, +1q, 0y und +1y:
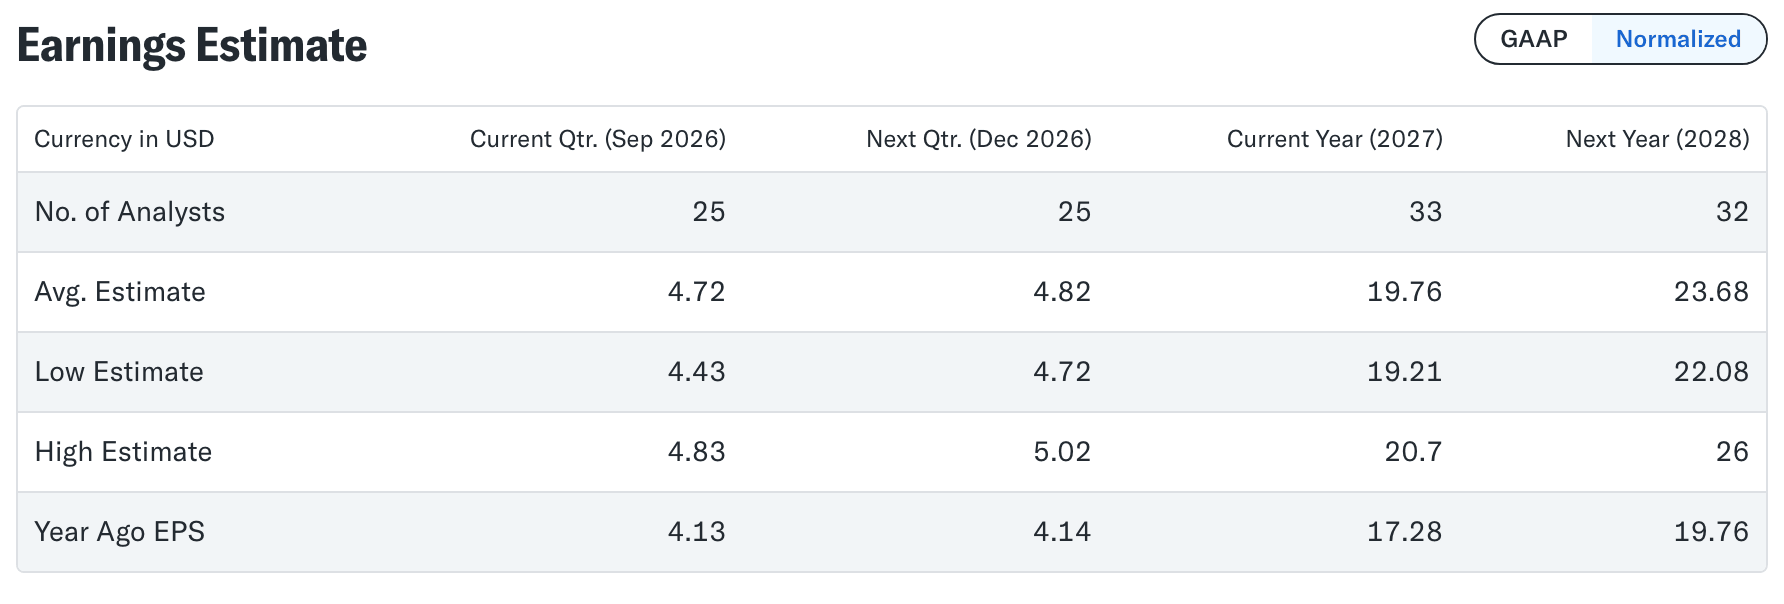
Die Normalized-Ansicht der Tabelle zeigt dieselben Zahlen, die earningsTrend enthält.
Dieselbe Anfrage liefert auch epsTrend und epsRevisions für jeden Zeitraum sowie earningsHistory mit den letzten 4 gemeldeten Quartalen und deren Überraschungsprozentsätzen.
Yahoo Finance für hunderte Ticker scrapen
Viele Produktions-Tickerlisten enthalten alte Symbole, Indizes und ausländische Notierungen, daher muss Ihr Stapelskript Probleme melden und fortfahren. Speichern Sie das nächste Skript als batch.py. Es läuft standardmäßig mit 8 Threads, erfasst fehlende und fehlgeschlagene Symbole getrennt und konvertiert kleine Währungseinheiten:
from concurrent.futures import ThreadPoolExecutor

import pandas as pd

from quote_summary import quote_summary
from yahoo_embedded import SymbolNotFound, fetch_page

# Yahoo quotes many London, Johannesburg, and Tel Aviv prices in minor units.
# Market cap stays in major units.
MINOR_UNITS = {"GBp": ("GBP", 100), "ZAc": ("ZAR", 100), "ILA": ("ILS", 100)}
PRICE_FIELDS = ("price", "week52_low", "week52_high", "target_mean")


def to_major_units(row: dict) -> dict:
    unit = MINOR_UNITS.get(row["currency"])
    if unit is None:
        return row
    currency, divisor = unit
    prices = {key: row[key] / divisor for key in PRICE_FIELDS if row[key] is not None}
    return {**row, **prices, "currency": currency}


def collect(symbols: list[str], fetch=fetch_page, workers: int = 8):
    """Quote rows for many symbols, plus the symbols that were missing or failed."""
    # " msft" and "MSFT" are the same ticker
    symbols = list(dict.fromkeys(s.strip().upper() for s in symbols))
    missing, failed = [], {}

    def one(symbol: str) -> dict | None:
        try:
            return to_major_units(quote_summary(symbol, fetch=fetch))
        except SymbolNotFound:
            missing.append(symbol)
        except Exception as error:  # keep the batch running, report at the end
            failed[symbol] = repr(error)
        return None

    with ThreadPoolExecutor(max_workers=workers) as pool:
        rows = [row for row in pool.map(one, symbols) if row]
    return pd.DataFrame(rows), missing, failed


if __name__ == "__main__":
    tickers = "AAPL MSFT SQ ^GSPC SPY BTC-USD 7203.T SAP.DE VOD.L NPN.JO".split()
    table, missing, failed = collect(tickers)
    cols = "symbol price currency market_cap delay_minutes reporting_currency".split()
    print(table[cols].to_string(index=False))
    print("missing:", missing, "| failed:", failed)
Eine gemischte Liste von 10 Symbolen war in 2,5 Sekunden fertig:
 symbol     price currency   market_cap  delay_minutes reporting_currency
   AAPL   341.070      USD 4.977637e+12              0                USD
   MSFT   516.170      USD 3.832844e+12              0                USD
  ^GSPC  7743.410      USD          NaN              0                NaN
    SPY   771.350      USD          NaN              0                NaN
BTC-USD 85011.320      USD 1.707212e+12              0                NaN
 7203.T  2989.500      JPY 3.540116e+13             20                JPY
 SAP.DE   185.920      EUR 2.145897e+11             15                EUR
  VOD.L     1.258      GBP 2.907280e+10             15                EUR
 NPN.JO   709.380      ZAR 5.307029e+11             15                USD
missing: ['SQ'] | failed: {}
Der Stapel meldete SQ als fehlend, da Block, Inc. sein Symbol zu XYZ geändert hat. Yahoo leitet das alte Symbol auf seine Lookup-Seite um, aber ein wiederverwendetes Symbol scheitert lautlos. FB, Metas altes Symbol, lieferte mit Status 200 einen ProShares-ETF, vergleichen Sie also jeden name mit Ihrer Tickerliste. Die FB-Kursseite sieht wie jede andere Kursseite aus:
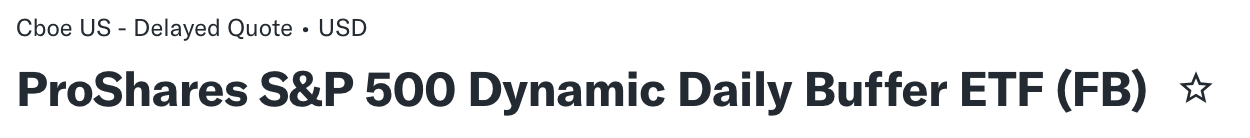
Ein wiederverwendetes Symbol liefert eine normale Kursseite, der Name ist also das klarste Zeichen der Änderung.
Einheiten, Währungen und Verzögerungen prüfen
Eine reine Statuscode-Prüfung erkennt 3 weitere Probleme nicht:
- Kleine Währungseinheiten. Yahoo meldete den Kurs von VOD.L als 125,8 in
GBp(Pence) und die Marktkapitalisierung als 29,07B in Pfund. Der Kurs von NPN.JO war 70.938 inZAc(Cent).to_major_units()teilt nur die Kursfelder, die Marktkapitalisierung behält also ihre großen Einheiten. - Berichtswährung. Berichtswerte verwenden die Berichtswährung des Unternehmens, und die Zeitreihen-Datenpunkte enthalten diese Währung in einem Feld
currencyCode. Vodafone (VOD.L) wird in Pence gehandelt, berichtet aber in Euro, und Naspers (NPN.JO) wird in Rand gehandelt, berichtet aber in US-Dollar. Kennzahlen können die 2 Währungen vermischen. Das Forward-KGV von TEVA.TA lag bei 43,5, während TEVA, seine New Yorker Notierung, bei 12,9 lag. Yahoo hatte den Schekel-Kurs von TEVA.TA durch eine Dollar-EPS-Schätzung geteilt. - Börsenverzögerung.
delay_minuteswar 0 für die US-Notierungen und Bitcoin. Die Xetra-, London- und Johannesburg-Kurse hatten eine 15-minütige Verzögerung, und der Tokio-Kurs hatte eine 20-minütige Verzögerung. Behalten Siedelay_minutesundmarket_timebei jeder Zeile, bevor Sie Kurse über Börsen hinweg vergleichen.
Größere Stapel ausführen
Mit seinen standardmäßig 8 Threads verarbeitete collect() alle 503 S&P-500-Symbole in 74 Sekunden über die Residential-Verbindung, ohne eine 429 oder einen Wiederholungsversuch. Nur BRK.B und BF.B fehlten, da Wikipedias S&P-500-Liste sie mit Punkten schreibt und Yahoo BRK-B und BF-B verwendet. Mit period1 auf 7 Tage zurück gesetzt, aktualisierten sich alle 501 Historien in 48 Sekunden. Die mittlere Seitengröße lag unter 1 MB, verglichen mit 4,9 MB für MSFTs vollständige Historie.
Mit exponentiellem Backoff wiederholt fetch_page() bereits Timeouts, 429-Fehler, 5xx-Antworten und Seiten ohne Kursdaten. Unser Leitfaden zum Wiederholen fehlgeschlagener Anfragen in Python erklärt Backoff mit urllib3s Retry und Tenacity.
Falls Sie zu asyncio wechseln, prüfen Sie zuerst das Limit Ihres Clients für die Antwort-Header-Größe. Die Antwort für den MSFT-Übersichtsreiter hatte etwa 37 KB Header, einschließlich einer 8.765-Byte-Content-Security-Policy und eines 27.039-Byte-Link-Headers. Mit Standardeinstellungen löste aiohttp 3.14.3 einen ClientResponseError auf einer Seite aus, die Yahoo mit Status 200 ausgeliefert hatte. Seine Meldung begann mit 400, message='Got more than 8190 bytes when reading.
Die Übergabe von max_field_size=65536 an aiohttp.ClientSession behob den Fehler. Sowohl httpx als auch curl_cffis AsyncSession behandelten die Seite mit Standardeinstellungen. Unser Vergleich von requests, httpx und aiohttp erklärt die weiteren Kompromisse zwischen ihnen.
Denselben Parser von einem Server aus mit Web Unlocker API ausführen
Unsere Web Unlocker API nimmt eine URL entgegen und liefert die Seite. Sie übernimmt IP-Rotation, CAPTCHA-Lösung und automatische Wiederholungen auf unseren Servern, sodass derselbe Parser von Ihrem Server läuft, während wir die Entsperrung übernehmen. fetch_page_unlocker() nimmt dieselben Argumente symbol, tab und params wie fetch_page() entgegen, sodass quote_summary(), price_history(), statement() und estimates() es alle über ihren Parameter fetch akzeptieren. Speichern Sie sie als unlocker.py:
import os
from urllib.parse import urlencode

import requests

from yahoo_embedded import page_url

API_URL = "https://api.brightdata.com/request"


def fetch_page_unlocker(symbol: str, tab: str = "", params: dict | None = None) -> str:
    """Takes the same symbol, tab, and params as fetch_page(), via Web Unlocker API."""
    url = page_url(symbol, tab) + (f"?{urlencode(params)}" if params else "")
    response = requests.post(
        API_URL,
        headers={"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"},
        json={
            "zone": os.environ["BRIGHTDATA_UNLOCKER_ZONE"],
            "url": url,
            "format": "json",  # Yahoo's status, headers, and HTML, wrapped in JSON
            "country": "us",
        },
        timeout=120,
    )
    response.raise_for_status()
    return response.json()["body"]
Sie liest Ihren API-Schlüssel und den Namen Ihrer Web Unlocker API Zone aus 2 Umgebungsvariablen. Eine Zone ist eine benannte Produktkonfiguration in Ihrem Konto. Den Schlüssel finden Sie auf der Kontoeinstellungsseite und die Schritte zum Erstellen einer Zone im Web Unlocker API Schnellstart. Sobald die Zone existiert, zeigt ihr Overview-Reiter beide Werte:
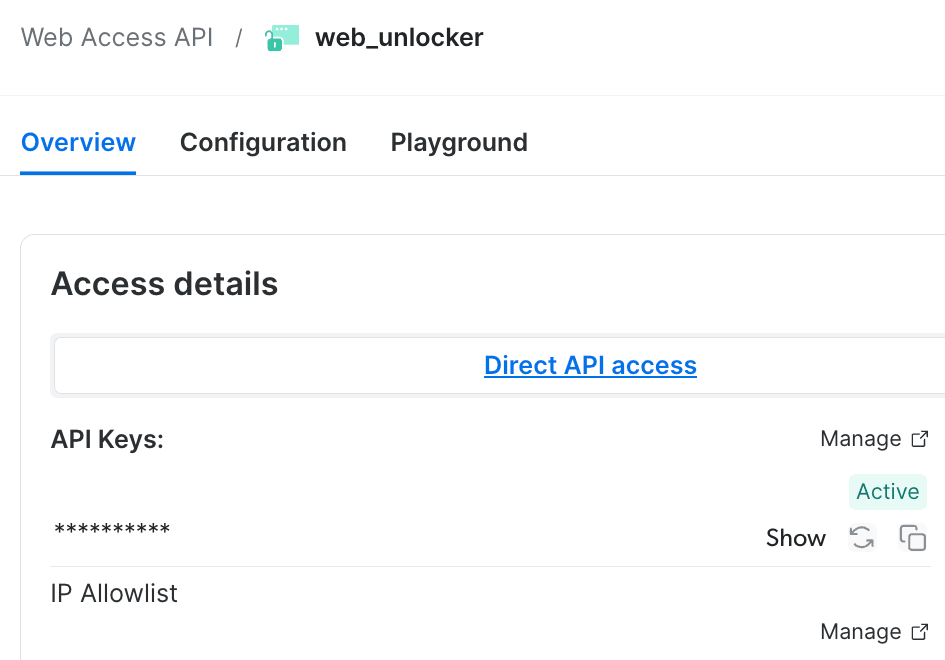
Der Zonenname, hier web_unlocker, steht oben, und die Kopier-Schaltfläche unter API Keys kopiert Ihren Schlüssel.
Setzen Sie beide in Ihrer Shell, bevor Sie das nächste Skript ausführen:
export BRIGHTDATA_API_KEY="your-api-key"
export BRIGHTDATA_UNLOCKER_ZONE="your-zone-name"
Um quote_summary(), price_history(), statement() oder estimates() über Web Unlocker API zu leiten, übergeben Sie fetch_page_unlocker als Argument fetch. Speichern Sie dieses Skript als unlocker_demo.py:
from price_history import price_history
from unlocker import fetch_page_unlocker

history, events = price_history("MSFT", fetch=fetch_page_unlocker)
print(
    f"{len(history):,} daily bars from {history.index[0]:%Y-%m-%d} "
    f"to {history.index[-1]:%Y-%m-%d}"
)
Es druckte dieselbe Historie wie price_history.py:
10,213 daily bars from 1986-03-13 to 2026-09-25Eine einzige Anfrage lieferte die vollständige Seite mit historischen Daten, und der Parser benötigte keine Änderungen, um sie zu lesen. Das Stapelskript akzeptiert dieselbe Funktion über collect(tickers, fetch=fetch_page_unlocker).
Beachten Sie diese 3 Details:
- Verwenden Sie
"format": "json". Die Antwort enthält dann Yahoos Statuscode, Header und vollständiges HTML in einem einzigen JSON-Objekt. Die Funktion liefert das HTML aus seinembody-Feld. - Kodieren Sie Sonderzeichen.
page_url()prozentkodiert bereits Indexsymbole wie^GSPCals%5EGSPC, sodass jede von ihr erstellte URL gültig ist. - Oder verwenden Sie unser Python-SDK. Installieren Sie
brightdata-sdkmitpip install brightdata-sdk, und übergeben Sieresponse_format="json"anscrape_url(), um Yahoos Statuscode mit der Seite zu erhalten.
Jeder Reiter ist eine separate Anfrage, und Sie zahlen nur für erfolgreiche Anfragen.
Strukturierte Datensätze von der Yahoo Finance Scraper API erhalten
Unsere Yahoo Finance Scraper API liefert einen strukturierten Datensatz pro Ticker, mit integrierten Proxys, Entsperrung und Wiederholungen. Es ist ein vorgefertigter Scraper in unserer Web Scraper API. Ein Datensatz kombiniert die Übersichtsfelder, Unternehmensprofil, Schlüsselmanager, jährliche Finanzdaten und Analysten-Kursziele, die die Produktseite des Scrapers Feld für Feld auflistet. Das Control Panel zeigt die synchronen und asynchronen Modi des Scrapers sowie den Endpunkt, den der folgende Code aufruft:
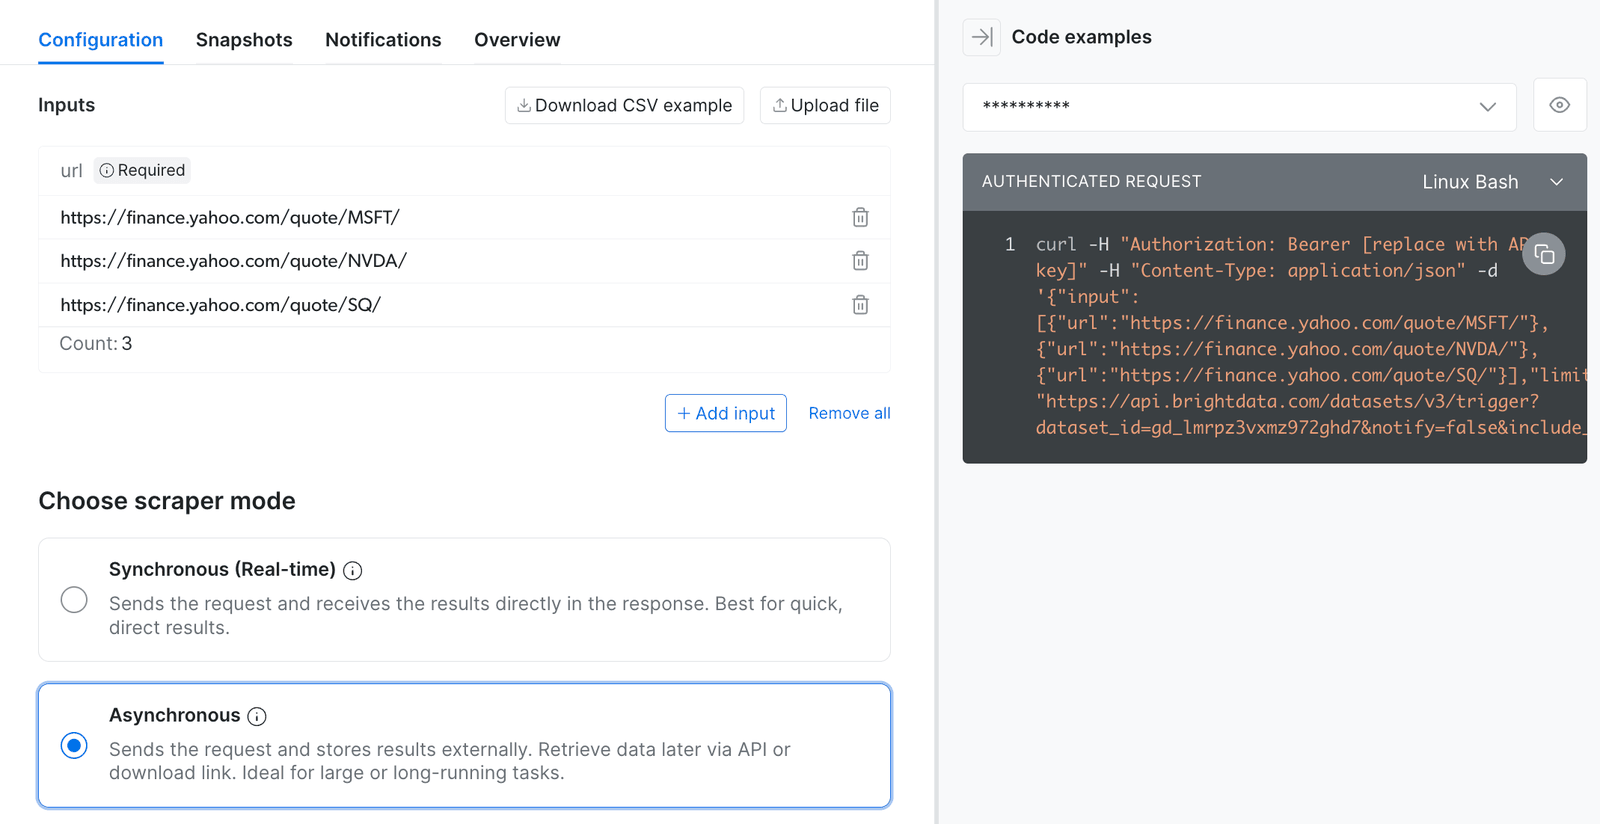
Das curl-Beispiel des Panels verwendet dieselben Kurs-URLs, Trigger-Endpunkt und Dataset-ID wie scraper_api.py, und der Asynchronous-Modus eignet sich am besten für geplante Stapeljobs.
Einen Job auslösen und die Datensätze herunterladen
Speichern Sie das nächste Skript als scraper_api.py. Es löst einen Job für eine Liste von URLs aus, fragt dessen Fortschritt ab, lädt die Datensätze herunter und meldet die Symbole, die Yahoo nicht mehr listet:
import os
import time

import requests

API = "https://api.brightdata.com/datasets/v3"
DATASET_ID = "gd_lmrpz3vxmz972ghd7"  # Yahoo Finance business information
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}
# The API returns only these fields, so the list keeps input, error, and error_code.
FIELDS = (
    "input|error|error_code|stock_ticker|closing_price|"
    "market_cap|pe_ratio|currency|timestamp"
)


def job_status(snapshot_id: str) -> str:
    progress = requests.get(
        f"{API}/progress/{snapshot_id}", headers=HEADERS, timeout=60
    )
    return progress.json()["status"]


def run_batch(urls: list[str], poll_seconds: int = 30) -> list[dict]:
    """Trigger one collection job, wait until it's ready, and return its records."""
    trigger = requests.post(
        f"{API}/trigger",
        params={
            "dataset_id": DATASET_ID,
            "include_errors": "true",
            "custom_output_fields": FIELDS,
        },
        headers=HEADERS,
        json={"input": [{"url": url} for url in urls]},
        timeout=60,
    )
    trigger.raise_for_status()
    snapshot_id = trigger.json()["snapshot_id"]

    while job_status(snapshot_id) != "ready":
        time.sleep(poll_seconds)

    records = requests.get(
        f"{API}/snapshot/{snapshot_id}",
        params={"format": "json"},
        headers=HEADERS,
        timeout=300,
    )
    records.raise_for_status()
    return records.json()


def collect_records(urls: list[str]) -> tuple[list[dict], dict[str, str]]:
    """Run one job and split its records into results and per-URL errors."""
    records = run_batch(list(dict.fromkeys(urls)))  # drop duplicate URLs
    done = [record for record in records if not record.get("error")]
    errors = {
        record["input"]["url"]: f'{record.get("error_code")}: {record["error"]}'
        for record in records
        if record.get("error")
    }
    return done, errors


if __name__ == "__main__":
    urls = [f"https://finance.yahoo.com/quote/{s}/" for s in ("MSFT", "NVDA", "SQ")]
    records, errors = collect_records(urls)
    for record in records:
        print(record)
    print("errors:", errors)
Es druckte 2 Datensätze und einen Fehler für SQ:
{'input': {'url': 'https://finance.yahoo.com/quote/MSFT/'}, 'stock_ticker': 'MSFT', 'closing_price': 516.17, 'market_cap': 3832843862016, 'pe_ratio': 28.739979, 'currency': 'USD', 'timestamp': '2026-09-27T16:15:44.789Z'}
{'input': {'url': 'https://finance.yahoo.com/quote/NVDA/'}, 'stock_ticker': 'NVDA', 'closing_price': 225.07, 'market_cap': 5434765213696, 'pe_ratio': 28.489874, 'currency': 'USD', 'timestamp': '2026-09-27T16:16:02.513Z'}
errors: {'https://finance.yahoo.com/quote/SQ/': 'dead_page: Target quote not found on lookup page'}
Der Scraper markierte SQ als dead_page, da Yahoo SQ auf seine Lookup-Seite umleitet, und fetch_page() löst im selben Fall SymbolNotFound aus.
Eine geplante Pipeline einrichten
Führen Sie die Scraper API als Stapeljob aus. Senden Sie viele Ticker bei jedem Trigger-Aufruf, und fragen Sie dann den Fortschritts-Endpunkt ab oder warten Sie auf einen Webhook.
Der synchrone Endpunkt /scrape liefert Datensätze direkt in seiner Antwort. Für einen längeren Job liefert der Endpunkt stattdessen eine snapshot_id zum Abfragen, wie die synchrone API-Referenz beschreibt.
Der Trigger-Aufruf akzeptiert einige Einstellungen, die für eine geplante Pipeline wichtig sind. Die asynchrone API-Referenz listet sie auf, und das Control Panel bietet dieselben Optionen unter Scraper settings:
- Fehlerbericht.
include_errors=truefügt jeder Eingabe ohne Ergebnis einenerrorund einenerror_codehinzu, etwa einem Symbol, das Yahoo nicht mehr listet.collect_records()meldet diese Eingaben nach URL. - Ausgabefelder.
custom_output_fieldsbehält nur die von Ihnen aufgelisteten Felder, getrennt durch|, fügen Sie alsoinput,errorunderror_codehinzu, um den Fehlerbericht zu behalten. - Datensatzlimits.
limit_per_inputbegrenzt die Datensätze pro Eingabe, undlimit_multiple_resultsbegrenzt die Datensätze pro Job. Beide Limits steuern die Kosten einer Discover by keyword-Suche. - Zustellung und Webhooks.
endpointliefert die Datensätze an Ihre Webhook-URL.notify=truesendet eine Benachrichtigung, wenn der Job abgeschlossen ist, sodass ein Scheduler nicht/progressabfragen muss. Übergeben Sieuncompressed_webhook=true, um Webhook-Payloads unkomprimiert zu erhalten. Delivery settings im Panel kann Ergebnisse auch in Amazon S3, Google Cloud Storage oder Snowflake schreiben, wie die Dokumentation zur Datenzustellung beschreibt. - Zeitpläne. Das Control Panel kann dieselbe Sammlung nach einem wiederkehrenden Zeitplan ausführen, etwa einer täglichen Ticker-Aktualisierung.
Bei einer längeren Tickerliste markierte der Scraper auch MMC, BK und FI als dead_page. Diese Unternehmen hatten ihre Symbole zu MRSH, BNY und FISV geändert. Sie zahlen nur für erfolgreich zugestellte Datensätze.
Nach Schlüsselwort suchen oder über die CLI ausführen
Der Modus Discover by keyword findet Notierungen, die über Börsen und Anlageklassen hinweg zu einem Schlüsselwort passen. Eine Abfrage nach WIX fand Wix.com, Wickes Group (WIX.L) und WIX-Optionskontrakte, und eine Abfrage nach MSFT fand auch Microsofts Toronto-Notierung und Einzelaktien-ETFs. Filtern Sie nach entity_type und stock_ticker, um die gewünschten Notierungen zu behalten.
Die Yahoo Finance Scraper API läuft auch von einem Terminal aus als brightdata pipelines yahoo_finance_business <url> in der Bright Data CLI. Über das Tool web_data_yahoo_finance_business kann ein KI-Agent den Datensatz für eine von Ihnen angegebene Kurs-URL abrufen. Das Tool läuft auf unserem Yahoo Finance MCP Server, nachdem Sie dessen finance-Tool-Gruppe aktiviert haben.
Den richtigen Ansatz für Ihre Pipeline wählen
Beginnen Sie damit, die Kursseiten kostenlos zu lesen, und fügen Sie Web Unlocker API für geplante Serverjobs hinzu. Für strukturierte Datensätze verwenden Sie die Scraper API oder das Yahoo Finance Dataset:
| Option | Am besten geeignet für | Was Sie selbst übernehmen | Preisgestaltung |
|---|---|---|---|
| yfinance | Persönliche Recherche, wie die README besagt | Bibliotheks-Updates, blockierte IPs | Kostenlos |
| Kursseiten mit curl_cffi | Hunderte Ticker pro Tag von zu Hause oder einem GitHub-Actions-Runner | Parser, Wiederholungen, blockierte IPs | Kostenlos |
| Kursseiten mit Web Unlocker API | Geplante Serverjobs, die jeden Reiter lesen | Parser | Pro erfolgreicher Anfrage |
| Playwright mit Browser API | Quartalsberichte und andere Daten, die erst nach Auswahl eines Umschalters erscheinen | Browserskript, Parser | Pro GB Traffic |
| Yahoo Finance Scraper API | Geparste Datensätze, geplant geliefert | Liste der Ausgabefelder | Pro geliefertem Datensatz |
| Yahoo Finance Dataset | Fertige Dateien von Unternehmen, Fonds und Indizes | Zustellungseinstellungen | Pro Datensatz |
Um ein monatliches Budget zu schätzen, zählen Sie 1 Web-Unlocker-API-Anfrage pro Reiter, pro Ticker, pro Aktualisierung. Die Yahoo Finance Scraper API benötigt 1 Datensatz pro Ticker pro Aktualisierung. Multiplizieren Sie eines der beiden Volumina mit dem aktuellen Preis auf der Web Unlocker API Preisseite oder der Web Scraper API Preisseite.
Für Quartalsberichte kann ein Playwright- oder Puppeteer-Skript den Quarterly-Umschalter des Finanzen-Reiters in unserer Browser API auswählen. Sie führt Chromium in der Cloud aus, und CAPTCHA-Lösung und JavaScript-Rendering sind integriert. Unser Leitfaden zum Scrapen dynamischer Websites mit Python zeigt diesen Arbeitsablauf Schritt für Schritt.
Unser Yahoo Finance Dataset verpackt dieselbe Art von Datensätzen wie die Scraper API in fertige JSON-, NDJSON-, CSV- oder Parquet-Dateien. Es umfasst Aktien, Investmentfonds, Indizes, ETFs, Währungen und Geldmarktfonds, filtern Sie also nach entity_type, um die gewünschten Anlageklassen zu behalten.
Sie können eine Teilmenge mit nur den benötigten Datenpunkten kaufen und Updates nach einem täglichen, wöchentlichen, monatlichen oder individuellen Zeitplan erhalten. Jede Lieferung kann nur neue oder aktualisierte Datensätze enthalten und direkt an Amazon S3, Google Cloud, Azure, Snowflake oder SFTP gehen. Die Dataset-Seite zeigt die aktuelle Datensatzanzahl und Preisgestaltung, und Sie können eine Beispieldatei in JSON oder CSV herunterladen, bevor Sie kaufen.
Für andere Marktdatenquellen siehe unsere Leitfäden zum Scrapen von Finanzdaten und Scrapen von Google Finance. Unsere anderen Scraper und Datensätze bieten mehr Aktiendaten und weitere Yahoo-Ergebnisse:
- Stock Market Scraper sammelt Aktiendaten von Seiten wie Yahoo Finance, Google Finance und TradingView.
- Google Finance Scraper und TradingView Scraper sammeln Aktienkurse und Markttrends von diesen 2 Seiten.
- Nasdaq Scraper sammelt Nasdaq-Daten wie Eröffnungskurs, Schlusskurs und Handelsvolumen.
- Stocktwits Scraper sammelt Stocktwits-Beiträge, Stimmung und Trend-Symbole.
- Financial Data Scraper API liefert Felder wie Unternehmensname, Aktien-Ticker, Börse und Schlusskurs.
- Stock Market Dataset, Stock Prices Dataset und Financial Dataset liefern Unternehmensprofile, Aktien-Ticker und Kurse als fertige Dateien.
- Google Finance Datasets, Historical Financial Data und Financial News Dataset liefern Google-Finance-Daten, historische Finanzdaten und Finanznachrichten als fertige Dateien.
- Yahoo News API und Yahoo Search API liefern Yahoo-News- und Yahoo-Suchergebnisse.
Abschließende Gedanken
Die Kursseiten von Yahoo Finance enthalten ihre eigenen API-Antworten als JSON, sodass 1 Anfrage pro Reiter die Daten ohne Browser, Cookie oder Crumb liefert. Beheben Sie den Client, bevor Sie Verzögerungen hinzufügen, denn Yahoos 429-Fehler bei ersten Anfragen hingen vom TLS-Handshake und User-Agent des Clients ab. Parsen Sie die eingebetteten Antworten, validieren Sie jede Seite, vergleichen Sie jeden Namen mit Ihrer Tickerliste und konvertieren Sie kleine Währungseinheiten innerhalb des Parsers.
Für geplante Serverjobs leiten Sie denselben Parser über Web Unlocker API, oder lassen Sie die Yahoo Finance Scraper API strukturierte Datensätze liefern. Unsere monatlichen kostenlosen Credits gelten für beide, sodass Sie beides mit Ihrer eigenen Tickerliste ausprobieren können.
FAQ
Gibt es eine offizielle Yahoo Finance API?
Nein. Yahoo sagt, dass es den API-Zugriff auf Kursdaten deaktiviert hat, da seine Datenanbieter die Weiterverbreitung in API-Form ‘derzeit nicht autorisieren’. Die internen API-Hosts, die yfinance verwendet, sind undokumentiert und in robots.txt verboten. Yahoos Kursseiten betten dieselben Daten als JSON ein.
Ist yfinance noch nutzbar?
Ja, von zu Hause und 3 GitHub-Actions-Runnern aus rief yfinance die vollständige Tageshistorie von MSFT in unter 1,5 Sekunden ab. Es verwendet curl_cffis Chrome-TLS-Handshake. Die README bezeichnet die Yahoo API als ‘nur für den persönlichen Gebrauch bestimmt’. Entwickler meldeten 401er und fehlgeschlagene Abrufe von manchen Cloud-Hosts, testen Sie es also von Ihrem eigenen Server aus.
Blockiert Yahoo Finance Web-Scraping?
Ja, für manche Clients. Yahoo blockierte Pythons Standard-requests-Client bei dessen erster Anfrage. Mit Chromes TLS-Handshake erhielt curl_cffi keine 429er über eine Residential-Verbindung oder 3 GitHub-Actions-Runner. Für geplante Jobs ruft Bright Datas Web Unlocker API dieselben Seiten mit IP-Rotation und automatischen Wiederholungen ab.
Kann man Daten von Yahoo Finance herunterladen?
Ja, aber Yahoos Hilfeseite beschränkt den CSV-Download auf zahlende Yahoo-Finance-Abonnenten. Im Code lieferte eine einzige Anfrage an den Reiter für historische Daten jeden täglichen MSFT-Balken seit 1986. Für Massendateien liefert Bright Datas Yahoo Finance Dataset Datensätze für Unternehmen, Fonds und Indizes nach dem von Ihnen gewählten Zeitplan.
Ist die Yahoo Finance API kostenlos?
Nicht offiziell. Yahoos interne Endpunkte kosten nichts beim Aufruf, sind aber undokumentiert und für Crawler verboten. Yahoos Hilfeseite beschränkt CSV-Downloads auf zahlende Abonnenten. Bright Datas Yahoo Finance Scraper API liefert strukturierte Datensätze, und neue Konten erhalten monatliche kostenlose Credits zum Testen.