Walmart zu scrapen gibt Pricing-Teams die Preise, Lagerbestände und Bewertungen, die Käufer sehen, gesammelt von Tausenden von Seiten nach Zeitplan.
Walmarts Bot-Prüfung ist nur das erste Problem. Als ich Produktseiten von rotierenden IPs abrief, bepreiste Walmart jede Seite für ein anderes Geschäft. Wenn dein Scraper keine Postleitzahl oder Filiale festlegt, wählt Walmart eine Filiale basierend auf der IP-Adresse. Deine Preistabelle vermischt dann Filialen, und kein Fehler warnt dich davor.
Dieser Leitfaden erklärt Walmarts Abwehrmechanismen und Listing-Limits, welche Methode zu wählen ist, und wie man filialspezifische Preise in Python sammelt.
Kurzfassung
- Die Filiale kann den Preis ändern. Über 8 Postleitzahlen hinweg reichte derselbe Liter Milch von 2,42 $ bis 6,28 $.
- Das Festlegen der Filiale pro Anfrage funktionierte. Mit einer Filial-ID lieferte Bright Datas Walmart Scraper API genau die Preise, die der Browser bei beiden verglichenen Filialen zeigte.
- Ein Walmart-Kategorie-Listing stoppte bei etwa 390 einzigartigen Produkten. Es behauptete rund 2.450 Artikel, zeigte aber nur 389, und das Aufteilen in 9 Preisbereiche fand 2.069.
- Ein 200-Status bedeutete nicht Erfolg. Walmart lieferte seine “Roboter oder Mensch?”-Herausforderung mit HTTP 200, also prüfe Inhalt und Filial-ID jedes Datensatzes.
Wie Walmart Scraper erkennt
Walmarts Produktseiten waren durch Akamai, HUMAN und eine F5 Web Application Firewall (WAF) geschützt. Die Header, Cookies und Runtime-Konfiguration einer einzelnen Produktseiten-Antwort zeigten alle 3:
| Schicht | Wie ich es erkannte | Was Skripte erhielten |
|---|---|---|
| Akamai Edge | x-ak-protocol und server-timing: ak_p Header, das akavpau_p2 Cookie, und die Bot-Manager-Cookies ak_bmsc und bm_sv in Browser-Sitzungen |
418 Access Denied für GraphQL-Aufrufe ohne Walmarts Client-Header |
| HUMAN, früher PerimeterX | Ein First-Party-Sensor unter /px/PXu6b0qd2S/init.js und die Cookies _pxhd, _px3 und _pxvid |
Eine 307-Weiterleitung zu /blocked, dann eine “Roboter oder Mensch?”-Press-and-Hold-Seite mit Status 200 |
| F5 WAF | 6 mit TS beginnende Cookies in einer Browser-Sitzung, wie TS012768cf |
Keine Blockierungsantwort darauf zurückgeführt |
Ein einfaches Headless Chrome, gestartet mit Playwright, erhielt beide Male, als ich es versuchte, HUMANs Press-and-Hold-CAPTCHA. Die Herausforderungsseite sah wie eine normale Walmart-Seite aus und lieferte Status 200 zurück:
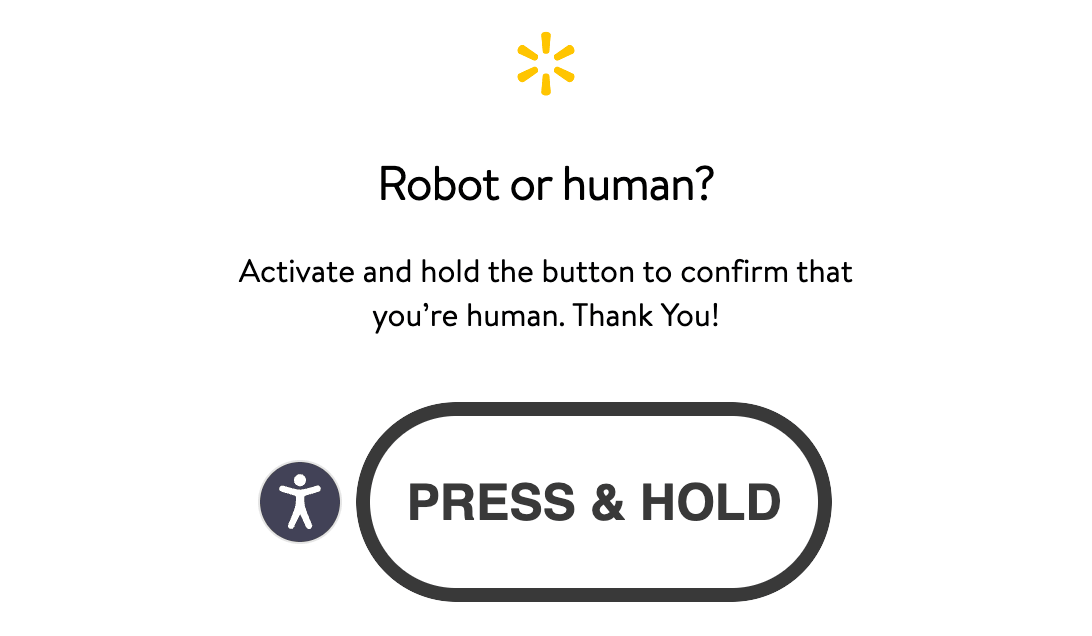
Ein Scraper, der nur den Statuscode prüft, würde diese Seite als Erfolg speichern.
Dieselbe Runtime-Konfiguration aktivierte ThreatMetrix, einen Geräteprofiling-Dienst, nur auf Konto-Seiten wie Warenkorb, Bestellungen, Wallet und Abonnements. Diese Liste enthielt keine Produkt-, Kategorie- oder Bewertungsseiten, also die, die Preisüberwachung benötigt.
Walmarts eigenes Bot-Flag zeigte nicht, ob eine Anfrage durchkam. Jede Produktseite bettete ein psych-Objekt mit Feldern wie isAkamaiBot ein. Dieses Feld war "1" sogar auf Seiten, die Walmart vollständig auslieferte, also beurteile eine Antwort anhand ihres Inhalts und ihrer Filial-ID.
Welche HTTP-Clients herausgefordert wurden
Bei derselben IP hing es vom HTTP-Client ab, ob Walmart eine Herausforderung zeigte. Ich fragte dieselben 5 Walmart-Produkt-URLs mit 6 HTTP-Clients von einer nicht-US-Heim-Breitband-IP ab, 1 URL pro Runde. In jeder Runde fragten die Clients diese URL nacheinander ab, im Abstand von 2 Sekunden, und jeder behielt sein eigenes Cookie-Jar.
Von den 5 URLs waren 3 tot, und sie gaben trotzdem ein klares Signal. Ein Client, der durchkam, erhielt Walmarts 404-Seite, während ein herausgeforderter Client die Herausforderungsseite erhielt:
| Client | Herausforderungsseiten in 5 Anfragen |
|---|---|
| curl mit LibreSSL | 4 |
Python requests |
2 |
httpx mit HTTP/2 |
1 |
curl_cffi, Firefox imitierend |
2 |
curl_cffi, Chrome imitierend |
0 |
curl_cffi, Safari imitierend |
0 |
In den 2 Runden mit lebenden Produkt-URLs erhielten curl, requests und das Firefox-Profil die Herausforderung. In denselben Runden, Sekunden später, erhielten die Chrome- und Safari-Profile die Produktseite.
Unser curl_cffi-Leitfaden behandelt das Imitations-Setup, und unser TLS-Fingerprinting-Artikel behandelt, was der Handshake offenlegt.
Über eine US-Sitzung auf Bright Datas Residential-Proxys stellten dieselben 6 Clients 30 Anfragen ohne eine einzige Herausforderungsseite. Jeder Client erhielt eine US-Residential-IP. Ergebnisse hängen von jeder Client- und Proxy-Kombination ab, also teste deine gegen Walmart bei der Parallelität, die du planst.
Wo Walmart-Seiten ihre Daten aufbewahren
Walmart rendert Produkt-, Such-, Kategorie- und Bewertungsseiten mit dem Next.js Pages Router. Jede Seite bettete ihr Datenmodell als JSON in ein __NEXT_DATA__-Script-Tag ein. Auf einer Süßigkeiten-Produktseite waren diese JSON-Daten 401 KB der 592 KB HTML. Diese JSON-Pfade enthielten die wichtigen Felder:
- Produktseiten:
props.pageProps.initialData.data.product, einschließlich Preis, Verfügbarkeit, Verkäufer und einemlocation-Objekt - Such- und Kategorieseiten:
props.pageProps.initialData.searchResult.itemStacks[].items, mit der gemeldeten Gesamtzahl insearchResult.aggregatedCount - Bewertungsseiten:
props.pageProps.initialData.data.reviews, mit eigenem Paginierungsblock
Das Tag hatte ein nonce-Attribut, also gleiche es per id mit einem Muster ab, das zusätzliche Attribute zulässt.
Im Browser lieferte Walmarts GraphQL-API Daten, die die Seite nicht einbettete, wie Artikeldetails weiter unten auf der Seite. Die API nutzte persistente Abfragen, also gespeicherte Abfragen, die der Client über einen SHA-256-Hash in der URL aufruft:
/orchestra/pdp/graphql/ItemByIdBtf/<sha256-hash>/ip/<item-id>Walmart blockierte skriptgesteuerte Wiederholungen dieser GraphQL-Aufrufe. Ohne Walmarts x-o-* Client-Header erhielt ein skriptgesteuerter Aufruf an /orchestra/home/graphql Akamais 418. Mit den Headern erhielt er eine HUMAN-Blockierung als JSON mit Status 412.
Diese Header enthielten auch die Web-App-Version, die sich mit Walmarts Releases ändert, sodass in älteren Open-Source-Scrapern hartcodierte Werte veraltet werden.
Das untenstehende Skript ruft eine Produktseite über Bright Datas Web Unlocker API ab und liest dann die Produktdaten und die Filiale, für die bepreist wurde. Es benötigt Python 3.9 oder höher und requests, deinen API-Schlüssel in BRIGHTDATA_API_TOKEN, und deinen Web Unlocker-Zonen-Namen in BRIGHTDATA_UNLOCKER_ZONE:
import json
import os
import re

import requests

API_KEY = os.environ["BRIGHTDATA_API_TOKEN"]
ZONE = os.environ["BRIGHTDATA_UNLOCKER_ZONE"]  # Dein Web Unlocker-Zonenname
NEXT_DATA = re.compile(r'<script id="__NEXT_DATA__"[^>]*>(.*?)</script>', re.S)


def fetch(url: str) -> tuple[str, str]:
    """Gibt Statuscode und HTML der Seite zurück."""
    r = requests.post(
        "https://api.brightdata.com/request",
        headers={"Authorization": f"Bearer {API_KEY}"},
        json={"zone": ZONE, "url": url, "format": "raw", "country": "us"},
        timeout=180,
    )
    r.raise_for_status()
    # Web Unlocker meldet den Statuscode der Zielseite in diesem Header.
    return r.headers.get("x-brd-status-code", ""), r.text


def parse_product(html: str) -> dict:
    if "Robot or human" in html:
        raise RuntimeError("Herausforderungsseite, keine Produktseite")
    match = NEXT_DATA.search(html)
    if match is None:
        raise RuntimeError("kein __NEXT_DATA__-Block auf der Seite")
    data = json.loads(match.group(1))["props"]["pageProps"]["initialData"]
    product = data["data"]["product"]
    location = product.get("location") or {}
    price = (product.get("priceInfo") or {}).get("currentPrice") or {}
    return {
        "us_item_id": product.get("usItemId"),
        "name": product.get("name"),
        "price": price.get("price"),
        "availability": product.get("availabilityStatus"),
        "seller": product.get("sellerName"),
        "store_id": (location.get("storeIds") or [None])[0],
        "zip": location.get("postalCode"),
    }


status, html = fetch("https://www.walmart.com/ip/10450114")
if status != "200":
    raise RuntimeError(f"Seitenstatus {status}, nicht 200")
print(status, json.dumps(parse_product(html), indent=2))
Ein Durchlauf lieferte ein lebendes Produkt zurück, bepreist für eine Filiale, die das Skript nie angefragt hatte. Dein Durchlauf wird wahrscheinlich eine andere Filiale zeigen:
200 {
  "us_item_id": "10450114",
  "name": "Great Value Whole Vitamin D Milk, Gallon",
  "price": 3.32,
  "availability": "IN_STOCK",
  "seller": "Walmart.com",
  "store_id": "3081",
  "zip": "95829"
}
Die Web Unlocker API meldet Walmarts eigenen Statuscode im x-brd-status-code-Header, wie es die Fehlercode-Seite beschreibt. Das Skript prüft diesen Header, bevor es die Seite parst.
Parse zuerst das eingebettete JSON. Für Daten, die die Seite nicht einbettet, rufe GraphQL aus einer Browser-Sitzung auf, da skriptgesteuerte Aufrufe blockiert wurden.
Warum ein Walmart-Preis von der Filiale abhängt
Walmarts Affiliate Marketing API-Dokumentation besagte, dass Preis und Verfügbarkeit eines Artikels von Postleitzahl und Filial-ID der Anfrage abhängen. Zu Preisen im Geschäft sagte ein Walmart-Sprecher gegenüber CNBC, dass “der Preis, den du siehst, für jeden in einer bestimmten Filiale gleich ist.” Jede Produktseite war für eine bestimmte Filiale bepreist.
Die Seite nannte diese Filiale in ihrem “Abholung von”-Text, und der Preis variierte je nach Filiale. Derselbe Liter Milch kostete 3,32 $ in der von Walmart zugewiesenen Sacramento-Filiale und 3,03 $ in einer von mir manuell ausgewählten Atlanta-Filiale:
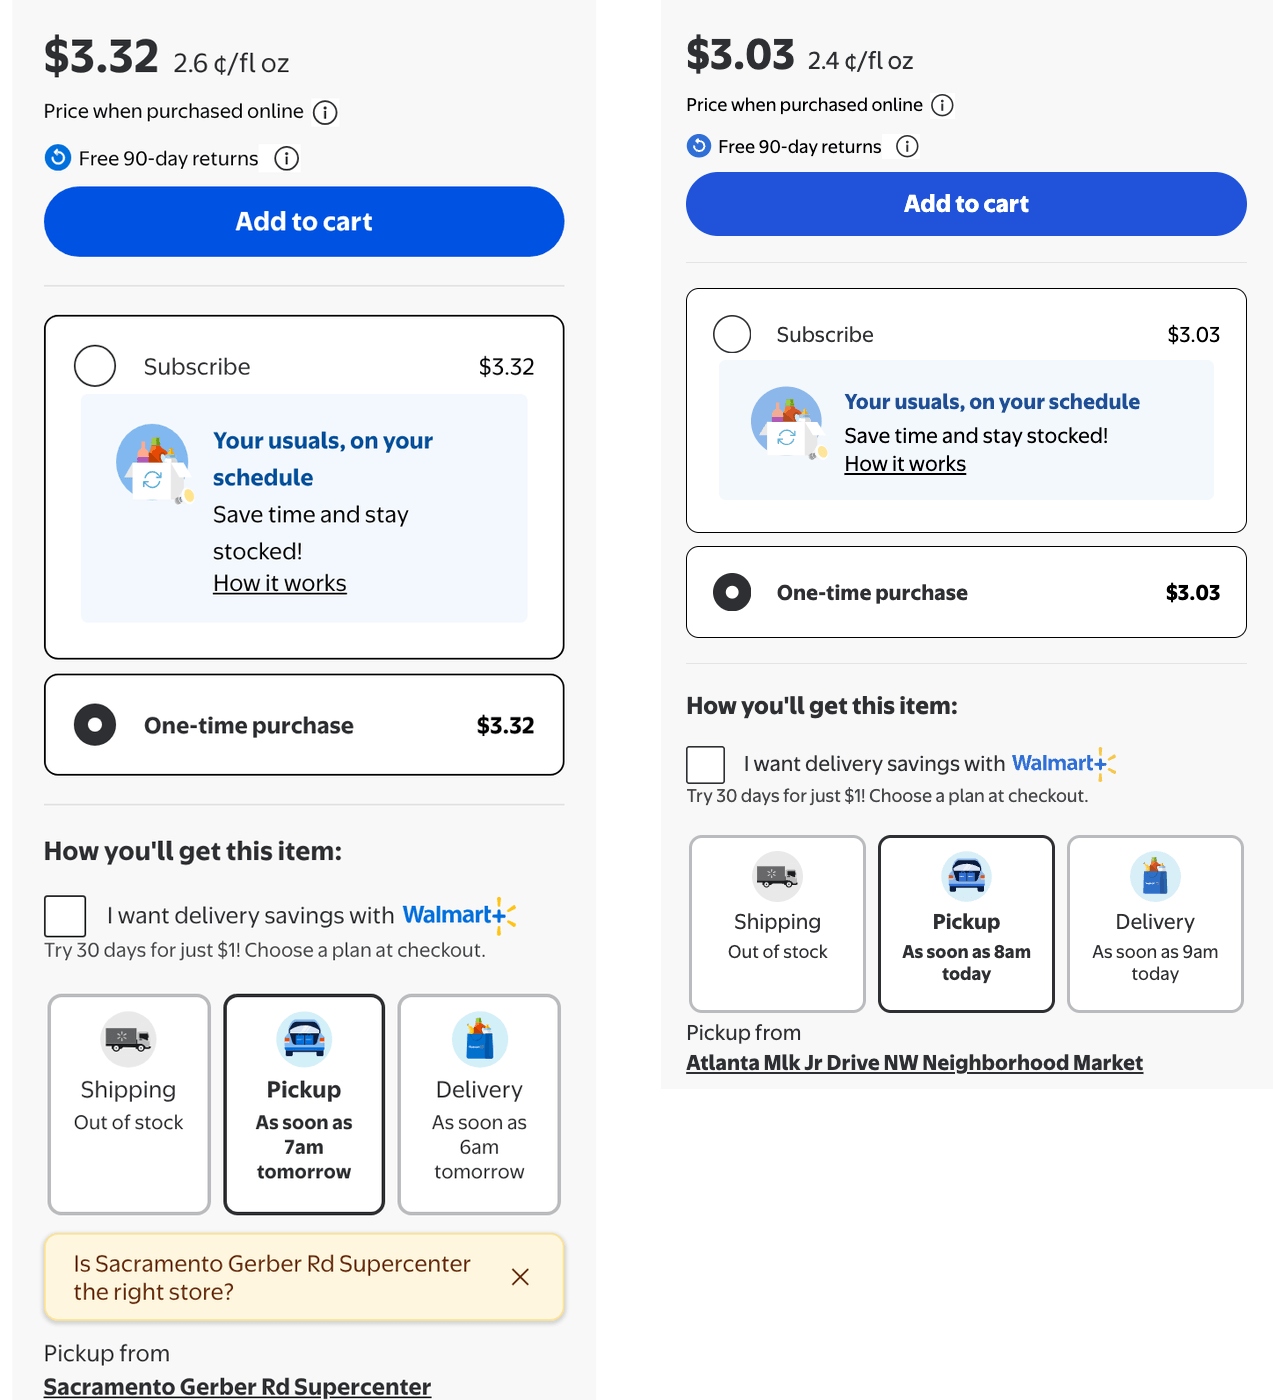
Ohne die Filiale in jedem Datensatz würden diese 2 Preise für dieselbe Milch wie eine Preisänderung aussehen.
Wenn eine Anfrage keinen Standort enthielt, wählte Walmart eine Filiale, verzeichnete sie im location-Objekt der Seite und markierte die Wahl als IMPLICIT. Einige Verbindungen erhielten eine Standardfiliale, Filiale 3081 in Sacramento, Postleitzahl 95829, die Filiale in der Skript-Ausgabe. Walmart basierte die Filiale auf der Exit-IP, sodass rotierende IPs auch die Filiale änderten:
- Rotierende IPs: jede der 48 Produktseiten war für eine andere Filiale bepreist.
- Andere Verbindungen: eine nicht-US-Breitband-IP und eine Satelliten-IP erhielten beide die Standardfiliale. Walmart verortete eine andere Sitzung in Big Water, Utah, Postleitzahl 84741, und gab ihr ebenfalls die Standardfiliale.
Warum das Festlegen der Filiale per Skript unzuverlässig war
Ich probierte 2 Wege, und beide überließen die Filialwahl Walmart:
- Standort-Cookies: Ich setzte
assortmentStoreIdund ein selbst erstellteslocGuestData-Cookie. Von 9 Anfragen mit den Cookies erhielten 6 die Herausforderungsseite, während 0 von 3 Anfragen ohne sie das taten. Die 3, die durchkamen, behielten die Filiale der IP. - Wahl der Exit-IP: Walmart verwendete seine eigene IP-Geolokalisierung. Diese Geolokalisierung stimmte nur bei 5 von 11 Seiten mit der Postleitzahl einer Standard-IP-Abfrage überein, sodass die Postleitzahl einer IP die Filiale nicht vorhersagte.
Wie eine Postleitzahl oder Filial-ID die Filiale festlegt
Der zipcode-Input von Bright Datas Walmart Scraper API legt den Standort für jede Anfrage fest. Ich sammelte 4 Lebensmittel in jeder von 8 Postleitzahlen, und derselbe Liter Great Value Vollmilch zeigte 8 verschiedene Preise:
| Postleitzahl | Filial-ID im Datensatz | Preis |
|---|---|---|
| 60614, Chicago, IL | 5402 | 2,42 $ |
| 75201, Dallas, TX | 5823 | 2,46 $ |
| 72712, Bentonville, AR | 100 | 2,72 $ |
| 33177, Miami-Gebiet, FL | 6397 | 2,92 $ |
| 94103, San Francisco, CA | 2648 | 3,32 $ |
| 10001, New York, NY | 3520, Secaucus Supercenter, NJ | 4,07 $ |
| 99504, Anchorage, AK | 4359 | 4,98 $ |
| 96813, Honolulu, HI | 3478 | 6,28 $ |
Bananen reichten von 0,13 $ in Bentonville bis 0,42 $ in Honolulu. Eier kosteten 1,67 $ in allen 8 Postleitzahlen, aber Abholung war in 3 davon nicht verfügbar. Zeichne Verfügbarkeit pro Filiale auf, genau wie den Preis.
Das Festlegen der Filiale war immer noch wichtig für Proteinpulver, das weniger als Milch variierte. Ich sammelte 387 seiner Produkte zweimal, zuerst ohne Postleitzahl und dann mit Bentonvilles Postleitzahl. Die Datensätze des ersten Durchlaufs stammten von 170 verschiedenen Filialen, und 24 Produkte änderten ihren Preis zwischen den 2 Durchläufen.
Eine Postleitzahl ist keine Filiale. Postleitzahl 10001 in Manhattan löste sich zum Secaucus Supercenter in New Jersey auf, Filiale 3520. Walmarts Filialauswahl listete mehrere Filialen für Postleitzahl 30303 in Atlanta auf:
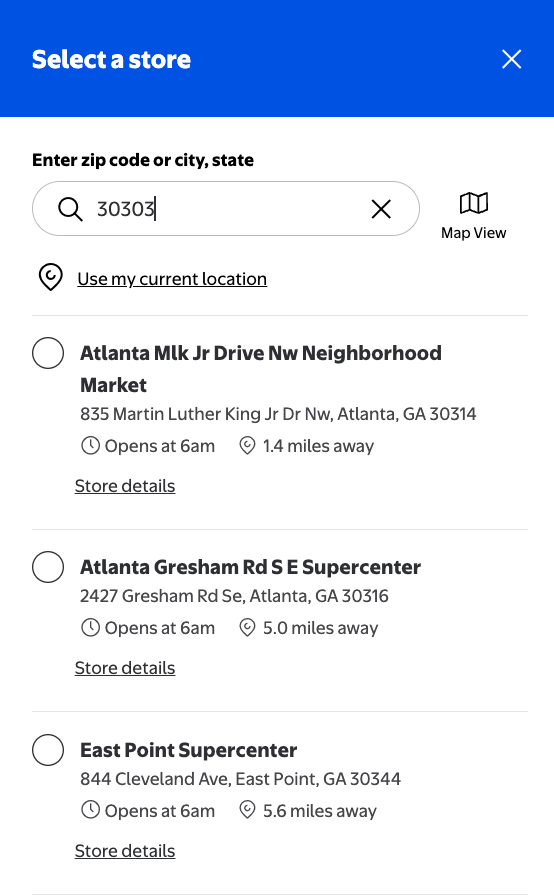
Die ersten 3 für Postleitzahl 30303 aufgelisteten Filialen. Eine Postleitzahl zeigt auf ein Gebiet, und eine Filial-ID zeigt auf eine Filiale.
Wenn du eine bestimmte Filiale brauchst, nimmt die Walmart Scraper API auch eine store_id. Die Seiten-URL jeder Filiale auf walmart.com enthielt ihre ID, wie 100 in walmart.com/store/100-bentonville-ar. Walmarts Filial-Sitemap, walmart.com/sitemap_store_main.xml, listete diese URLs nach Filialtyp auf, einschließlich Seiten für 3.582 Supercenter und 675 Neighborhood Markets. Als ich die 2 Filialen aus den Milch-Screenshots festlegte, lieferte die API die Preise zurück, die der Browser zeigte, 3,32 $ in Sacramento und 3,03 $ in Atlanta.
Wiederholte Durchläufe für dieselbe Postleitzahl lieferten dieselben Preise zurück. Chicago-Milch kostete in 2 späteren Durchläufen innerhalb von 90 Minuten wieder 2,42 $. In Bentonville lieferten 2 gleichzeitig laufende Jobs dieselben Preise für alle 39 Produkte, die beide Jobs sammelten. Einen Tag später löste sich Postleitzahl 72712 immer noch zu Filiale 100 auf, und die Milch dort kostete immer noch 2,72 $.
Was bei jedem Preis aufzuzeichnen ist
Beide Milchpreise in den Screenshots hatten Walmarts Kennzeichnung “Preis beim Online-Kauf”, also behandle gescrapte Preise als die Online-Preise jeder Filiale.
Verfügbarkeit hängt auch von der Erfüllungsmethode ab. Auf der Milchseite zeigte Versand als nicht vorrätig, während Abholung und Lieferung von derselben Filiale als vorrätig angezeigt wurden. Walmart Scraper API-Datensätze hatten dafür separate Abhol- und Lieferflags. Ihr Feld Fulfillment_type benannte, wer die Bestellung erfüllte, etwa der Verkäufer oder Walmart Fulfillment Services.
Walmarts Einzelpreise verwendeten ebenfalls unterschiedliche Einheiten. Derselbe Liter zeigte einen unit_price von 0,023 pro Flüssigunze in Miami und 1,02 pro Quart in New York. Berechne Einzelpreise aus der Packungsgröße neu. Für die Milch listete der vollständige Datensatz die Packungsgröße unter specifications als 128 Flüssigunzen auf.
Preise ändern sich auch mit der Zeit. Walmart meldete mehr als 11.000 Rollbacks, sein Begriff für vorübergehende Preissenkungen, in einem einzigen Quartal.
Schlüssle jeden Preis nach Filial-ID, Postleitzahl und Zeitstempel, und zeichne Verfügbarkeit für jede Erfüllungsmethode auf. Verwirf jeden Datensatz, der für einen Standort bepreist ist, den du nicht angefragt hast.
Wie man innerhalb von Walmarts Listing- und Bewertungslimits arbeitet
Walmarts Proteinpulver-Kategorieseite meldete etwa 2.450 Artikel und eine maxPage von 25. Seiten 1 bis 10 hielten etwa 50 Produktplätze je, von denen etwa 10 gesponsert waren. Seiten nach Seite 11 hatten keine Produkte:
| Kategorieseite | Zurückgegebene Produktplätze |
|---|---|
| 1 bis 10 | 47 bis 50 pro Seite |
| 11 | 13 in einem Durchlauf, 0 in einem anderen |
| 12 bis 25 | 0 |
Seiten 1 bis 11 hatten insgesamt 501 Plätze, und sie hielten 389 einzigartige Produkte. Dieses Paginierungslimit stammte von Walmarts Listing selbst, also erschien es in jeder Sitzung, die ich ausführte, auf dieselbe Weise.
In einem Desktop-Browser erreichten die Seitenzahlen immer noch 25, und Seite 12 lieferte Walmarts Nicht-gefunden-Seite zurück:
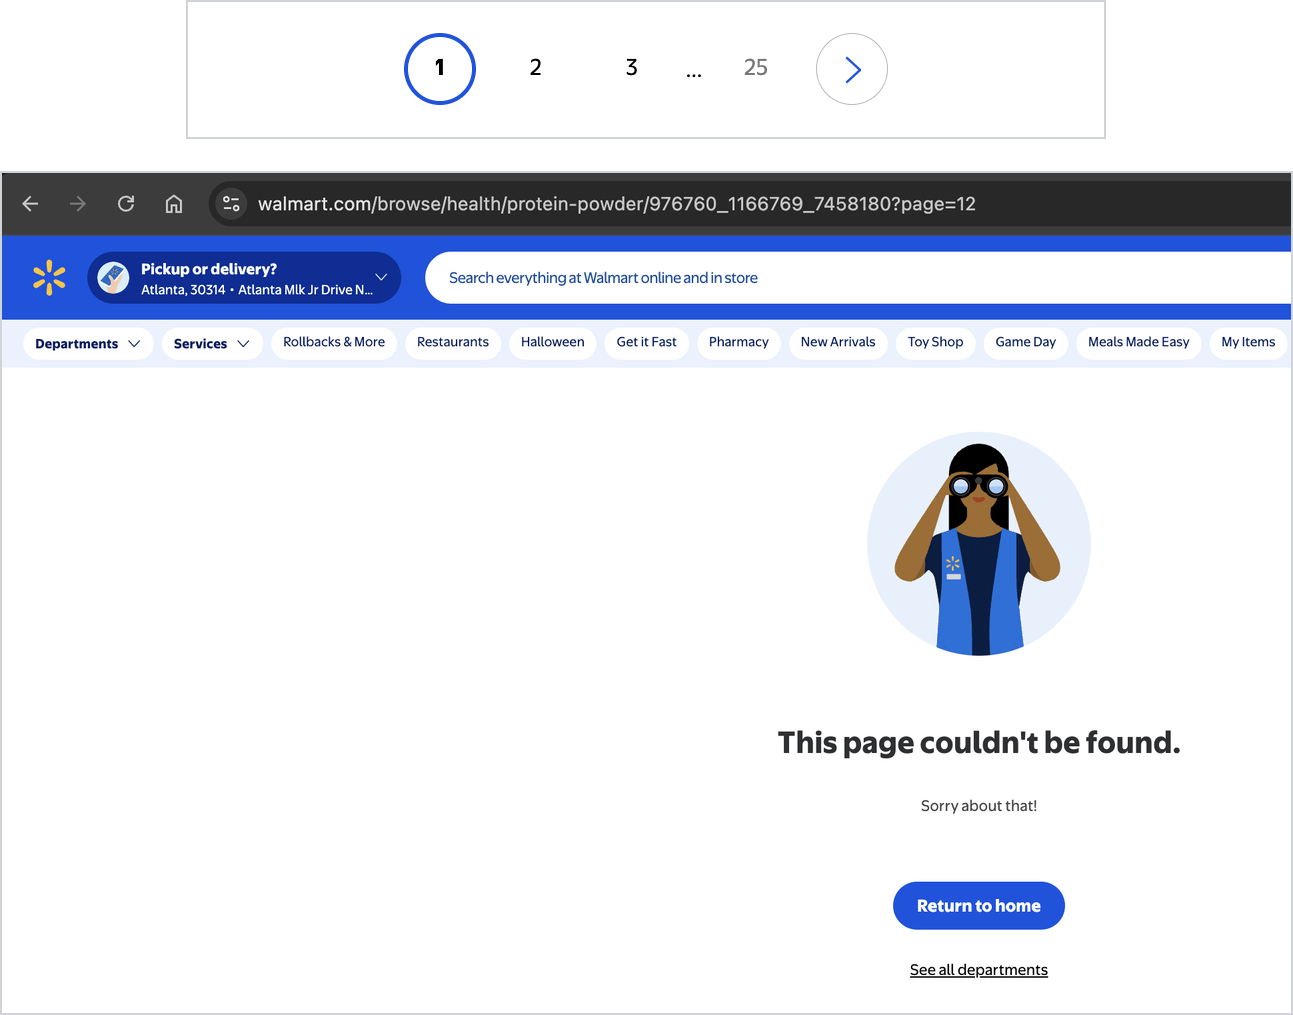
Ein Scraper, der den Seitenzahlen bis 25 folgte, erhielt nichts mehr nach Seite 11.
Wie man eine Kategorie in Preisbereiche aufteilt
Die Kategorie-Erkennung der Walmart Scraper API akzeptiert Kategorie-URLs mit Walmarts Preisfiltern, sodass du eine Kategorie bereichsweise sammeln kannst. Als Basislinie lieferte die ungefilterte Kategorie-URL 393 einzigartige Produkte zurück, nahe an den 389, die das Listing zeigte.
Walmarts URL-Parameter min_price und max_price teilten die Kategorie in Preisbereiche auf, und jeder Bereich meldete seine eigene Anzahl. Ich teilte die Kategorie zuerst bei 15 $, 25 $, 35 $, 50 $ und 75 $. Dann teilte ich die 3 Bereiche, die mehr als 500 Produkte meldeten, bei 42 $, 62 $ und 100 $, und führte die Erkennung bei allen 9 Bereichen aus:
| Preisbereich | Von Walmart gemeldete Produkte | Entdeckte einzigartige Produkte |
|---|---|---|
| 0 $ bis 15 $ | 75 | 60 |
| 15 $ bis 25 $ | 230 | 189 |
| 25 $ bis 35 $ | 429 | 330 |
| 35 $ bis 50 $, als 2 Bereiche | 718 | 569 |
| 50 $ bis 75 $, als 2 Bereiche | 592 | 484 |
| 75 $ und mehr, als 2 Bereiche | 519 | 444 |
Die 9 Bereiche lieferten 2.069 einzigartige Produkte zurück, was etwa dem 5-Fachen der Basislinie entsprach. Die Spalte summiert sich auf 2.076, da einige Produkte in 2 Bereichen erschienen. Kein Bereich lieferte mehr als 330 einzigartige Produkte zurück, sodass jeder unter dem Paginierungslimit blieb.
Walmarts gemeldete Zahlen waren 17% bis 30% höher als die einzigartigen Produkte, die jede Zeile zurücklieferte. Im Bereich 0 $ bis 15 $ zeigten die 2 Listing-Seiten nur 62 einzigartige Produkte, nicht die von Walmart gemeldeten 75. Die Erkennung lieferte 60 zurück, nahe an den 62 auf den Seiten. Behandle Walmarts gemeldete Zahl als Obergrenze.
Teile jede Kategorie in Preisbereiche auf, bis jeder Bereich weniger einzigartige Produkte zurückliefert als sein Paginierungslimit, das bei Proteinpulver bei etwa 390 lag.
Walmarts Produkt-Sitemaps listeten weit mehr Produkte auf als ein Kategorie-Listing. Über die Web Unlocker API rief ich einen Produkt-Sitemap-Index ab, der auf 5.916 Sitemap-Dateien zeigte. Allein die erste Datei enthielt 50.000 Produkt-URLs aus gemischten Kategorien, und jede URL hatte nur ein Datum der letzten Änderung. Nutze Sitemaps für katalogweite URL-Listen, und nutze Preisbereiche für die Kategorien, die du verfolgst.
Wo Suchergebnisse und Bewertungen aufhören
Die Suche hatte ihr eigenes Seitenlimit. Eine Suche nach “Laptop” meldete 20.251 Ergebnisse, aber eine maxPage von 14, bei 40 Ergebnissen pro Seite, sodass höchstens 560 Ergebnisse erreichbar waren. Wo möglich, entdecke Produkte über Kategorien oder Sitemaps.
Wenn du die Suchergebnisse selbst brauchst, wie beim Share-of-Shelf-Tracking, nutze den Walmart-Produktsuche-Scraper, dessen Datensätze gesponserte Ergebnisse kennzeichnen. Eine Suche nach “Proteinpulver” lieferte 568 Datensätze zurück, darunter 164 gesponserte. Unter diesen Datensätzen erschienen 55 Artikel-IDs mehr als einmal, und 52 davon waren sowohl gesponserte als auch organische Ergebnisse. Behalte beide Platzierungen für Share-of-Shelf, und entferne Duplikate nach Artikel-ID für eine Produktliste.
Bewertungen hatten ihr eigenes Paginierungslimit. Die Milchseite zeigte 399.133 Bewertungen, von denen 27.412 geschriebenen Text hatten. Unter der Standardsortierung zeigte ihre Paginierung 10 Bewertungen pro Seite und stoppte bei 10.000. Seite 1001 schlug nicht fehl, sondern lieferte wieder Seite 1 zurück, also stoppe bei der von Walmart gemeldeten Seitenzahl, statt auf eine leere Seite zu warten.
Der Walmart-Bewertungs-Scraper nimmt einen sort_by-Input für die Bewertungsreihenfolge. Für ein Süßigkeiten-Produkt mit 127 Bewertungen lieferte er alle 41 geschriebenen Bewertungen zurück.
Warum deine URL-Liste regelmäßige Aktualisierungen braucht
Etwa 1 von 7 alten Produkt-URLs waren tot. Von 150 etwa 2 Jahre alten Produkt-URLs lieferten 22 404 oder 410 zurück, und weitere 37 lebende Seiten hatten keinen Preis.
Führe die Erkennung oft genug erneut aus, um deine URL-Liste aktuell zu halten, sodass jeder Job lebende Produkte sammelt.
Wie man eine Methode zum Scrapen von Walmart wählt
Jede untenstehende Methode erledigt einen unterschiedlichen Teil der Arbeit für dich, von rohem Seitenzugriff bis zu fertigen Datensätzen. Die Pricing-Seite jedes Produkts listet aktuelle Preise:
| Methode | Was sie für dich übernimmt | Abrechnungsgrundlage | Filialauswahl | Aktuelle Preisgestaltung |
|---|---|---|---|---|
| Rotierende Residential-Proxys mit eigenem Parser | Rotierende Residential-IPs für deinen eigenen Client und Parser | Pro GB Traffic | Von Walmart anhand der Exit-IP festgelegt | Residential-Proxys Preise |
| Web Unlocker API mit eigenem Parser | Entsperrung, mit Walmarts Statuscode in einem Antwort-Header | Pro erfolgreicher Anfrage | Von Walmart anhand der Exit-IP festgelegt | Web Unlocker Preise |
| Walmart Scraper API | Erkennung, Sammlung und geparste Datensätze mit Filialfeldern | Pro geliefertem Datensatz | Pro Anfrage mit zipcode und store_id festgelegt |
Web Scraper API Preise |
| Browser API | Ein vollständiger Browser mit eingebautem CAPTCHA-Löser, für interaktive Abläufe | Pro GB Traffic | Durch Auswahl einer Filiale auf der Seite festgelegt | Browser API Preise |
| Walmart-Datensätze | Fertige Walmart-Produkt-, Bewertungs- und Verkäuferdaten | Pro Datensatz | Zum Sammlungszeitpunkt festgelegt | Datensätze Preise |
Residential-Proxys und die Web Unlocker API liefern die rohe Seite, sodass dein Team das Parsing und die Filialvalidierung durchführt. Die Walmart Scraper API liefert geparste Datensätze zurück, die du direkt validieren kannst.
Residential-Proxys geben dir volle Kontrolle über jede Anfrage. Du wählst Client, Header und Parser, was Teams passt, die bereits ihren eigenen Stack betreiben.
Die Web Unlocker API übernimmt den Zugriff, sodass du dich auf das Parsing konzentrieren kannst. Sie rief auch Walmarts Produkt-Sitemaps für katalogweite URL-Listen ab.
Die Walmart Scraper API passt für filialspezifische Arbeit im großen Umfang. Ihre Inputs zipcode und store_id legen den Standort fest, und ihre Datensätze melden die Filiale, für die bepreist wurde, sodass deine Pipeline jeden Datensatz überprüfen kann.
Nutze die Browser API für interaktive Abläufe. Sie betreibt einen vollständigen Browser, der sich zum Erkunden einer Seite und Erfassen neuer Endpunkte eignet. Für katalogweiten Umfang kombiniere sie mit der Walmart Scraper API oder der Web Unlocker API.
Datensätze passen für Backfills und katalogweite Analysen. Die Walmart-Datensätze bieten eine Auswahl an Aktualisierungszeitplänen.
Agenten können Einzelprodukt-Abfragen ausführen. Die Bright Data CLI hat eine walmart_product-Pipeline, und der Bright Data MCP-Server hat ein web_data_walmart_product-Tool. Von einer Produkt-URL lieferte die CLI-Pipeline einen Datensatz mit demselben Schema wie Walmart Scraper API-Datensätze zurück.
Vergleiche jede Methode nach Kosten pro gültigem Datensatz, denn eine für die falsche Filiale bepreiste Seite ist kein brauchbarer filialspezifischer Datensatz.
Wie man eine filialspezifische Preis-Pipeline mit der Walmart Scraper API baut
Um Walmart in großem Maßstab zu scrapen, entdecke URLs nach Preisbereich, lege auf jeder eine Postleitzahl oder Filial-ID fest, und prüfe die Filial-ID jedes Datensatzes. Die Walmart Scraper API hat separate Scraper für Produkte, Bewertungen, Verkäufer und Suche, alle über dieselbe REST-API verfügbar. Neue Konten können mit der kostenlosen Stufe beginnen. Jeder Scraper hat seine eigene Datensatz-ID und Inputs:
| Scraper | Datensatz-ID | Haupt-Inputs | Nutze es für |
|---|---|---|---|
| Walmart Produkte | gd_l95fol7l1ru6rlo116 |
url mit zipcode und optionaler store_id, oder Erkennung nach category_url, keyword oder sku |
Filialspezifische Preise, Produktdetails und Bilder |
| Walmart Produkte Postleitzahlen | gd_m693oc1r1gebnayxq |
url mit zip_code und optionaler store_id, oder Erkennung nach Kategorie oder Stichwort |
Abholfiliale, Lagermenge und Lieferzeitpunkt |
| Walmart Bewertungen | gd_mpql1v8g2o8o6l1wzd |
url mit optionalem sort_by |
Geschriebene Bewertungen |
| Walmart Verkäuferinfos | gd_m7ke48w81ocyu4hhz0 |
Verkäuferseite url |
Verkäuferprofile |
| Walmart Produktsuche | gd_m7khey0wb7wviejgj |
Suchseite url |
Suchergebnisse mit Sponsoring-Flags |
Im Control Panel nahm der Walmart-Produkte-Scraper eine Postleitzahl und eine store_id mit jeder URL:
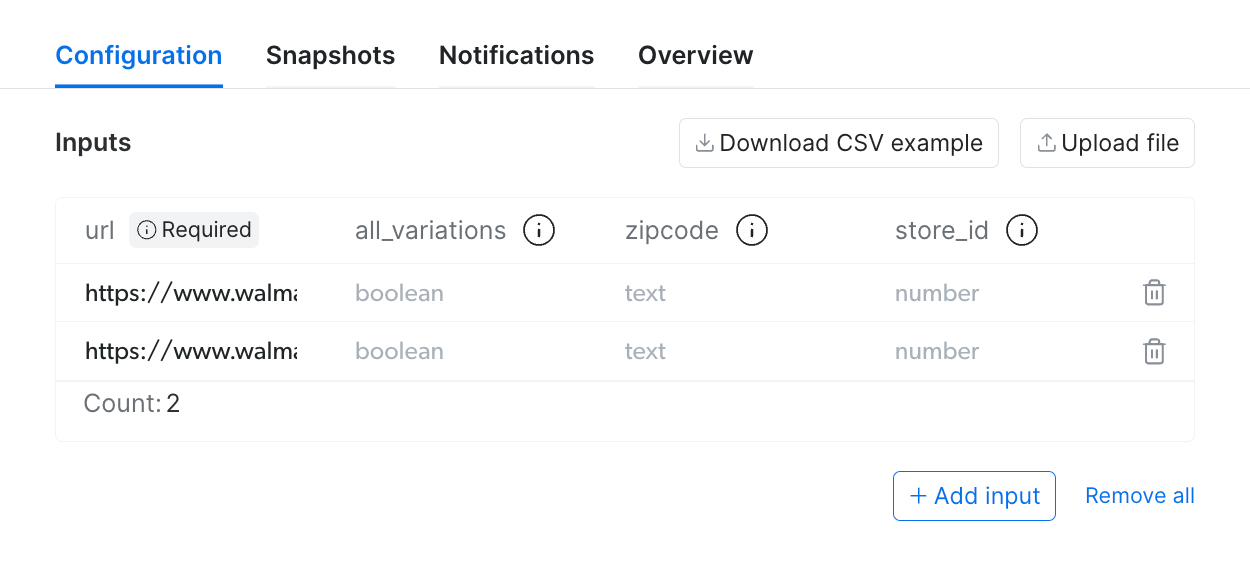
Die Spalten zipcode und store_id fragen eine Filiale für jeden Datensatz an.
Erstelle die gemeinsamen Hilfsfunktionen
Diese Hilfsfunktionen benötigen einen API-Schlüssel in BRIGHTDATA_API_TOKEN. Die Funktion post berücksichtigt Retry-After, sodass dein Client wartet und erneut versucht, wenn er die asynchronen Anfragelimits erreicht:
import os
import time

import requests

API = "https://api.brightdata.com/datasets/v3"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_TOKEN']}"}
WALMART_PRODUCTS = "gd_l95fol7l1ru6rlo116"


def post(url, **kwargs):
    """POST, das Retry-After berücksichtigt, um innerhalb der Ratenlimits zu bleiben."""
    for attempt in range(6):
        r = requests.post(url, headers=HEADERS, timeout=120, **kwargs)
        if r.status_code != 429:
            r.raise_for_status()
            return r
        time.sleep(int(r.headers.get("Retry-After") or 2 ** (attempt + 1)))
    r.raise_for_status()


def wait_and_download(snapshot_id, every=30):
    while True:
        r = requests.get(f"{API}/progress/{snapshot_id}", headers=HEADERS,
                         timeout=60)
        r.raise_for_status()
        status = r.json()["status"]
        if status == "ready":
            break
        if status in ("failed", "canceled"):
            raise RuntimeError(f"{snapshot_id} endete als {status}")
        time.sleep(every)
    while True:  # 202 bedeutet, die Datei wird noch zusammengestellt
        r = requests.get(f"{API}/snapshot/{snapshot_id}", headers=HEADERS,
                         params={"format": "json"}, timeout=300)
        if r.status_code == 200:
            return r.json()
        r.raise_for_status()
        time.sleep(10)
Die untenstehenden Erkennungs- und Sammlungsblöcke verwenden post, wait_and_download, API und HEADERS erneut, also halte alle 3 Blöcke in derselben Datei.
Produkt-URLs nach Preisbereich entdecken
Diese Funktionen teilen eine Kategorie in Preisbereiche auf und liefern eine sortierte Liste einzigartiger URLs zurück:
def price_ranges(category_url, edges):
    """Ein Erkennungs-Input pro Preisbereich.

    Wähle Grenzen, die jeden Bereich unter dem Paginierungslimit halten.
    """
    sep = "&" if "?" in category_url else "?"
    urls = [f"{category_url}{sep}min_price={lo}&max_price={hi}"
            for lo, hi in zip(edges, edges[1:])]
    return [{"category_url": u, "all_variations": False} for u in urls]


def discover(category_url, edges, per_range=600):
    body = {"input": price_ranges(category_url, edges),
            "limit_per_input": per_range}
    params = {"dataset_id": WALMART_PRODUCTS, "type": "discover_new",
              "discover_by": "category_url", "include_errors": "true"}
    job = post(f"{API}/trigger", params=params, json=body)
    records = wait_and_download(job.json()["snapshot_id"])
    urls = {r["url"].split("?")[0] for r in records if r.get("url")}
    return sorted(urls)
Mit per_range=600 lieferte ein einzelner Erkennungsjob über die 9 Proteinpulver-Preisbereiche 2.069 einzigartige Produkt-URLs zurück.
Fehlerdatensätze hatten eine beschreibende error-Meldung neben ihrem error_code, wie den Status 410 Gone, den Walmart für entfernte Produkte zurücklieferte. discover behält nur Datensätze mit einer url, also lies Fehlerdatensätze aus dem rohen Snapshot, wenn du einen Durchlauf überprüfst.
Filialspezifische Datensätze sammeln und validieren
Sammle dann jede URL mit einer Postleitzahl, und validiere jeden Datensatz, bevor er dein Data Warehouse erreicht. Nimm input, error und error_code in die Feldliste auf, sodass jeder Datensatz seinen Input und etwaige Fehlerdetails behält. Füge specifications hinzu, wenn du Einzelpreise aus der Packungsgröße neu berechnest:
FIELDS = "|".join([
    "product_id", "product_name", "final_price", "currency", "unit_price",
    "available_for_pickup", "available_for_delivery", "store_id",
    "store_name", "store_location", "seller", "timestamp",
    "input", "error", "error_code",  # Input und Fehlerdetails behalten
])


def collect(urls, zipcode, store_id=None, webhook=None):
    """Startet einen asynchronen Job für eine Postleitzahl. Liefert die Snapshot-ID zurück."""
    params = {"dataset_id": WALMART_PRODUCTS, "include_errors": "true",
              "format": "json", "custom_output_fields": FIELDS}
    if webhook:  # Bright Data sendet die fertigen Datensätze per POST an diese URL
        params |= {"endpoint": webhook, "uncompressed_webhook": "true",
                   "auth_header": os.environ["WEBHOOK_AUTH_HEADER"]}
    row = {"zipcode": zipcode} | ({"store_id": store_id} if store_id else {})
    body = {"input": [{"url": u, **row} for u in urls]}
    job = post(f"{API}/trigger", params=params, json=body)
    return job.json()["snapshot_id"]


def validate(records, zipcode, store_id=None):
    """Behält Datensätze, die für die angefragte Filiale bepreist sind. Leitet den Rest nach Grund um."""
    valid, rejected, seen = [], [], set()
    for rec in records:
        url = rec["input"]["url"]
        if rec.get("error_code"):
            rejected.append((url, rec["error_code"]))
            continue
        where = rec.get("store_location") or ""
        if store_id:  # store_location zeigt dann die eigene Postleitzahl der Filiale
            matched = bool(where) and str(rec.get("store_id")) == str(store_id)
        else:  # store_location sollte die angefragte Postleitzahl zeigen
            matched = where.endswith(", " + zipcode)
        if not matched:
            rejected.append((url, f"bepreist für {where or 'keine Filiale'}"))
            continue
        try:
            price = float(rec["final_price"])
        except (KeyError, TypeError, ValueError):
            rejected.append((url, "kein Preis, Verfügbarkeit prüfen"))
            continue
        key = (rec["product_id"], rec["store_id"])
        if key not in seen:
            seen.add(key)
            valid.append(rec | {"final_price": price})
    return valid, rejected


if __name__ == "__main__":
    category = ("https://www.walmart.com/browse/health/protein-powder/"
                "976760_1166769_7458180")
    edges = [0, 15, 25, 35, 42, 50, 62, 75, 100, 100000]
    urls = discover(category, edges, per_range=5)
    print(len(urls), "Produkt-URLs entdeckt")
    records = wait_and_download(collect(urls, zipcode="72712"))
    valid, rejected = validate(records, "72712")
    print(len(valid), "gültige Datensätze,", len(rejected), "abgelehnt")
Ein Durchlauf mit 5 Produkten pro Bereich und Bentonvilles Postleitzahl, 72712, gab die untenstehenden Zahlen aus. Während die Erkennungs- und Sammlungsjobs laufen, fragt das Skript ihre Ergebnisse ab. Deine Zahlen werden abweichen, da sie von Walmarts Listings am Tag abhängen, an dem du die Pipeline ausführst:
42 Produkt-URLs entdeckt
41 gültige Datensätze, 1 abgelehnt
Alle 41 gültigen Datensätze waren für Filiale 100 in Bentonville bepreist. Walmart listete das verbleibende Produkt ohne Preis auf. Die rejected-Liste zeichnet auf, warum jeder Datensatz abgelehnt wurde.
Mit nur einer Postleitzahl zeigte store_location die angefragte Postleitzahl, sodass validate jeden Datensatz gegen diese Postleitzahl bestätigt. Für eine bestimmte Filiale, sende ihre store_id mit einer Postleitzahl, bei der diese Filiale verfügbar ist, etwa die eigene Postleitzahl der Filiale. Der Datensatz zeigte dann die eigene Postleitzahl der Filiale, also übergib dieselbe store_id an validate, das Filial-IDs vergleicht. Die API prüfte die Paarung, sodass Filiale 3520 in Secaucus, gesendet mit Bentonvilles 72712, einen Fehlerdatensatz erzeugte, der die Diskrepanz benannte.
Im Katalogmaßstab lief ein einzelner Job mit Postleitzahl 72712 alle 2.069 entdeckten URLs, und validate prüfte den gemeldeten Standort jedes Datensatzes.
Die Pipeline im großen Umfang ausführen
Im großen Umfang machen 4 Praktiken die Pipeline vorhersehbarer.
URLs in Jobs bündeln. Jobs laufen asynchron, also lass wait_and_download auf das Ergebnis warten. Nutze den asynchronen Trigger für jeden Job. Wenn ein Job mehr Zeit braucht, liefert der synchrone Endpunkt eine Snapshot-ID zum Abfragen zurück, sodass der asynchrone Start einen einzigen Codepfad beibehält.
Einzigartige Inputs zählen. Die API dedupliziert wiederholte Inputs, sodass ein Job mit 34 Inputs mit 2 Wiederholungen 32 Datensätze zurücklieferte. Dieselbe URL, gesendet mit 3 Postleitzahlen, zählte als 3 Inputs, und jede war für ihre eigene Filiale bepreist.
Fehlerdatensätze prüfen, bevor du es erneut versuchst. Fehlerdatensätze benannten ihre Ursache, also entferne tote Produkt-URLs aus deiner Liste und sende den Rest erneut.
An deinen Speicher liefern. Rufe collect(urls, zipcode, webhook=URL) auf, und setze den vollständigen Header-Wert, wie Bearer <secret>, in WEBHOOK_AUTH_HEADER. Bright Data sendet die fertigen Datensätze per POST an die Webhook-URL mit diesem Wert als Authorization-Header. Der Lieferleitfaden behandelt die Bestätigung, die dein Endpunkt sendet, die auf die Positivliste zu setzenden Quell-IPs, und Ziele wie Amazon S3, Google Cloud Storage und Snowflake.
Behalte die Filialvalidierung in deiner Pipeline, sodass jeder Datensatz in deinem Data Warehouse einen verifizierten Standort hat.
Abschließende Gedanken
Walmart in großem Maßstab zu scrapen ist ebenso sehr ein Filialstandort-Problem wie ein Zugriffsproblem. Jeder Preis gehört zu der Filiale, für die er bepreist wurde, und ein Erfolgsstatus sagt dir nicht, welche Filiale das war. Lege bei jeder Sammelanfrage eine Postleitzahl oder Filial-ID fest, und teile die Erkennung in Preisbereiche auf, die jeweils unter dem Paginierungslimit bleiben.
Wenn du einen Backfill statt täglicher Filialpreise brauchst, beginne mit einem Walmart-Datensatz. Andernfalls führe ein paar Preisbereiche und Postleitzahlen über die Walmart Scraper API auf der kostenlosen Stufe aus, und skaliere dann hoch, sobald die Filialvalidierung erfolgreich ist.
FAQ
Wie scrapt man Walmart-Preise nach Postleitzahl?
Sende eine Postleitzahl mit jeder Produkt-URL, statt dich auf die Exit-IP zu verlassen, die Walmart sonst zur Filialwahl nutzt. Eine Postleitzahl kann sich zu einer Filiale in einem anderen Bundesstaat auflösen, also füge eine Filial-ID hinzu, wenn du eine bestimmte Filiale brauchst. Bright Datas Walmart Scraper API nimmt beides entgegen und meldet die Filiale für jeden Datensatz.
Hat Walmart eine öffentliche API?
Als ich nachsah, waren Walmarts APIs für Partner gedacht. Die Affiliate Marketing API lieferte Preis und Verfügbarkeit nach Postleitzahl für Apps, die Empfehlungsgebühren verdienen. Filialabfragen benötigten zusätzliche Genehmigung. Die Marketplace-APIs deckten nur die eigenen Kataloge der Verkäufer ab, sodass filialspezifische Preisverfolger öffentliche Produktseiten sammeln.
Kann man Walmart-Bewertungen scrapen?
Ja. Auf einer Milch-Produktseite zeigte Walmarts Bewertungspaginierung 10 Bewertungen pro Seite und stoppte bei 10.000 unter der Standardsortierung. Seite 1001 lieferte wieder Seite 1 zurück, also stoppe bei der von Walmart gemeldeten Seitenzahl. Bright Datas Walmart-Bewertungs-Scraper sammelt geschriebene Bewertungen und nimmt einen sort_by-Input für die Bewertungsreihenfolge.
Gibt es einen Walmart-Produktdatensatz?
Ja. Bright Data bietet fertige Walmart-Datensätze für Produkte, Bewertungen und Verkäufer nach einem von dir gewählten Aktualisierungszeitplan an. Sie eignen sich für Backfills und katalogweite Analysen. Für tägliche filialspezifische Preise sammle aktuelle Datensätze für eine Postleitzahl oder Filial-ID mit der Walmart Scraper API.