


Proxys sind IP-Adressen eines Servers, der stellvertretend für Sie eine Verbindung zum Internet herstellt. Anstatt Ihre Anfragen direkt an Websites zu senden, leiten Proxys diese über einen Server weiter und verbergen so Ihre ursprüngliche IP-Adresse und Ihren Standort. Dies schützt Ihre Privatsphäre, verhindert Tracking und vermeidet Blockierungen. Proxys verschlüsseln außerdem Ihre Daten für zusätzliche Sicherheit.
In diesem Artikel erfahren Sie, wie man Proxys mit Python Requests verwendet, insbesondere für Web-Scraping. Beim Web-Scraping werden Daten von Websites extrahiert, doch viele Seiten haben Einschränkungen. Proxys helfen dabei, diese zu umgehen, indem sie Ihre IP-Adresse und Ihren Standort ändern, wodurch es für Websites schwieriger wird, Sie zu erkennen und zu blockieren. Sie können auch mehrere Proxys verwenden, um Anfragen zu verteilen und den Prozess zu beschleunigen.
Als Nächstes erfahren Sie, wie Sie einen Proxy in Ihrem Projekt mithilfe des Python-Pakets Requests implementieren.
Verwendung eines Proxys mit einem Python-Request
Um einen Proxy mit einem Python-Request zu verwenden, müssen Sie auf Ihrem Computer ein neues Python-Projekt erstellen, um die Python-Skripte für das Web-Scraping zu schreiben und auszuführen. Erstellen Sie ein Verzeichnis (zB web_scrape_project), in dem Sie Ihre Quellcode-Dateien speichern.
Alle Codes für dieses Tutorial finden Sie in diesem GitHub-Repository.
Pakete installieren
Nachdem Sie Ihr Verzeichnis erstellt haben, müssen Sie die folgenden Python-Pakete installieren, um Anfragen an die Webseite zu senden und die Links zu sammeln:
- Bright Datas Webseite
Komponenten einer Proxy-IP-Adresse
Bevor Sie einen Proxy verwenden, sollten Sie dessen Komponenten verstehen. Im Folgenden finden Sie die drei wichtigsten Komponenten eines Proxyservers:
- Protokoll zeigt die Art der Inhalte, auf die Sie im Internet zugreifen können. Die häufigsten Protokolle sind HTTP und HTTPS.
- Adresse zeigt, wo sich der Proxyserver befindet. Die Adresse kann eine IP (zB
192.167.0.1) oder ein DNS-Hostname (zBproxyprovider.com) sein. - Port wird verwendet, um den Traffic zum richtigen Serverprozess zu leiten, wenn mehrere Dienste auf einem einzigen Rechner laufen (zB Portnummer
2000).
Unter Verwendung all dieser drei Komponenten würde eine Proxy-IP-Adresse so aussehen: 192.167.0.1:2000 oder proxyprovider.com:2000.
So legen Sie Proxys direkt in Requests fest
Es gibt mehrere Möglichkeiten, Proxys in Python Requests festzulegen, und in diesem Artikel werden drei verschiedene Szenarien betrachtet. In diesem ersten Beispiel erfahren Sie, wie Sie Proxys direkt im Requests-Modul festlegen.
Zunächst müssen Sie die Pakete Requests und Beautiful Soup in Ihrer Python-Datei für das Web-Scraping importieren. Erstellen Sie dann ein Verzeichnis namens proxies, das Proxyserver-Informationen enthält, um Ihre IP-Adresse beim Scrapen der Webseite zu verbergen. Hier müssen Sie sowohl die HTTP- als auch die HTTPS-Verbindung zur Proxy-URL definieren.
Sie müssen außerdem die Python-Variable definieren, um die URL der Webseite festzulegen, von der Sie die Daten scrapen möchten. Für dieses Tutorial lautet die URL https://brightdata.com/
Als Nächstes müssen Sie mit der Methode request.get() eine GET-Anfrage an die Webseite senden. Die Methode nimmt zwei Argumente entgegen: die URL der Website und die Proxys. Die Antwort der Webseite wird dann in der Variable response gespeichert.
Um die Links zu sammeln, verwenden Sie das Beautiful Soup-Paket, um den HTML-Inhalt der Webseite zu parsen, indem Sie response.content und html.parser als Argumente an die Methode BeautifulSoup() übergeben.
Verwenden Sie dann die Methode find_all() mit a als Argument, um alle Links auf der Webseite zu finden. Extrahieren Sie schließlich das href-Attribut jedes Links mit der Methode get().
Im Folgenden finden Sie den vollständigen Quellcode, um Proxys direkt in Requests festzulegen:
# import packages.
import requests
from bs4 import BeautifulSoup

# Define proxies to use.
proxies = {
    'http': 'http://proxyprovider.com:2000',
    'https': 'http://proxyprovider.com:2000',
}

# Define a link to the web page.
url = "https://brightdata.com/"

# Send a GET request to the website.
response = requests.get(url, proxies=proxies)

# Use BeautifulSoup to parse the HTML content of the website.
soup = BeautifulSoup(response.content, "html.parser")

# Find all the links on the website.
links = soup.find_all("a")

# Print all the links.
for link in links:
    print(link.get("href"))
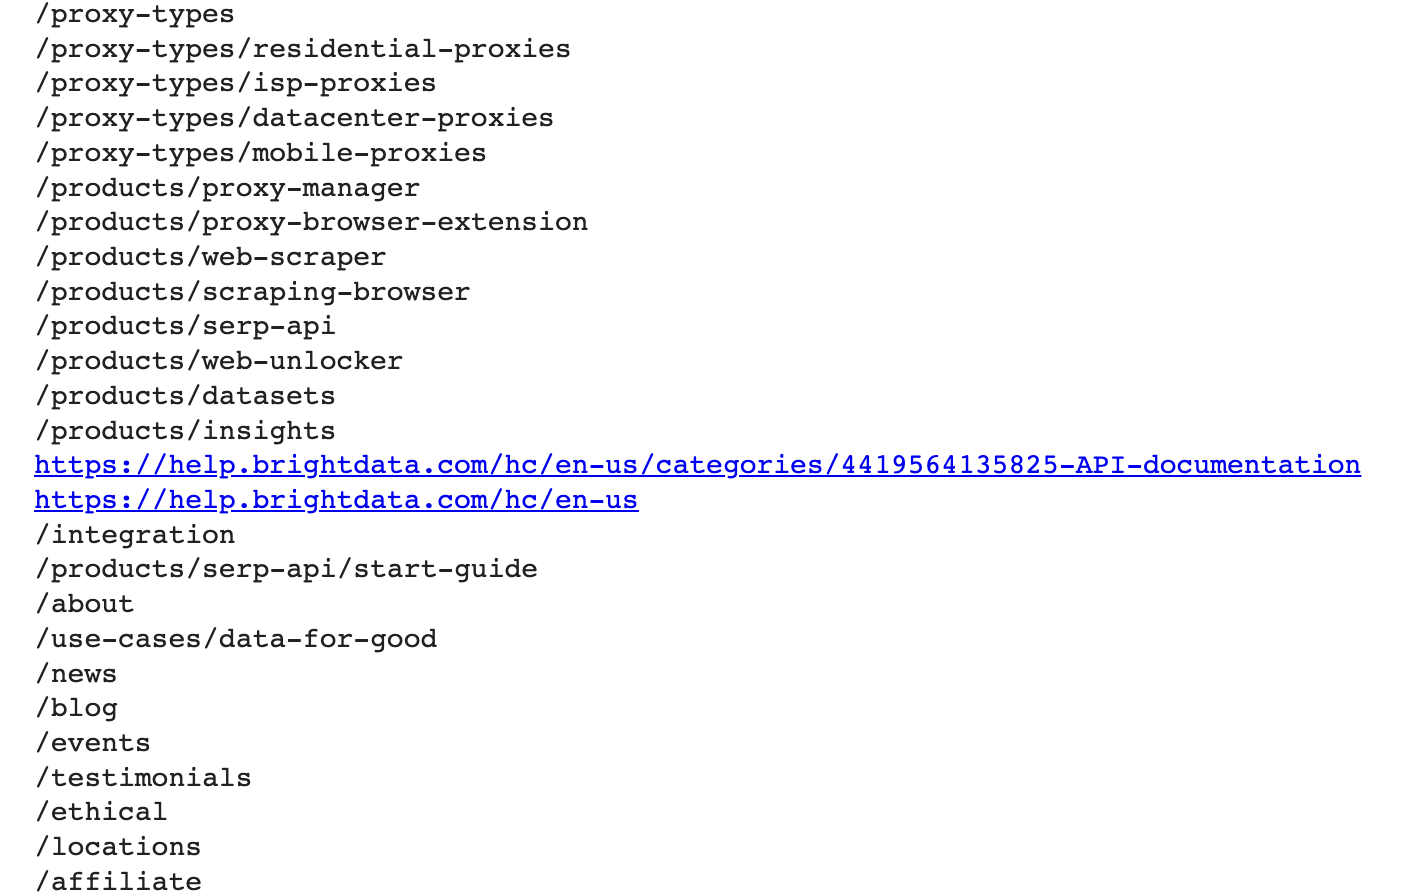
Wenn Sie diesen Codeblock ausführen, sendet er eine Anfrage an die definierte Webseite unter Verwendung der Proxy-IP-Adresse und gibt dann die Antwort zurück, die alle Links zu dieser Webseite enthält:
So legen Sie Proxys über Umgebungsvariablen fest
Manchmal müssen Sie denselben Proxy für alle Ihre Anfragen an verschiedene Webseiten verwenden. In diesem Fall ist es sinnvoll, Umgebungsvariablen für Ihren Proxy festzulegen.
Um die Umgebungsvariablen für den Proxy jedes Mal verfügbar zu machen, wenn Sie Skripte in der Shell ausführen, führen Sie den folgenden Befehl in Ihrem Terminal aus:
export HTTP_PROXY='http://proxyprovider.com:2000'
export HTTPS_PROXY='https://proxyprovider.com:2000'
Hier legt die Variable HTTP_PROXY den Proxyserver für HTTP-Anfragen fest, und die Variable HTTPS_PROXY legt den Proxyserver für HTTPS-Anfragen fest.
Zu diesem Zeitpunkt besteht Ihr Python-Code nur aus wenigen Codezeilen und verwendet die Umgebungsvariablen, wann immer Sie eine Anfrage an die Webseite stellen:
# import packages.
import requests
from bs4 import BeautifulSoup

# Define a link to the web page.
url = "https://brightdata.com/"

# Send a GET request to the website.
response = requests.get(url)

# Use BeautifulSoup to parse the HTML content of the website.
soup = BeautifulSoup(response.content, "html.parser")

# Find all the links on the website.
links = soup.find_all("a")

# Print all the links.
for link in links:
    print(link.get("href"))
So rotieren Sie Proxys mit einer benutzerdefinierten Methode und einem Array von Proxys
Das Rotieren von Proxys ist entscheidend, da Websites den Zugriff für Bots und Scraper oft blockieren oder einschränken, wenn sie eine große Anzahl von Anfragen von derselben IP-Adresse erhalten. In diesem Fall vermuten Websites möglicherweise böswillige Scraping-Aktivitäten und ergreifen daraufhin Maßnahmen, um den Zugriff zu blockieren oder einzuschränken.
Durch das Rotieren verschiedener Proxy-IP-Adressen können Sie vermeiden, erkannt zu werden, als mehrere organische Nutzer erscheinen und die meisten auf der Website implementierten Anti-Scraping-Maßnahmen umgehen.
Um Proxys zu rotieren, müssen Sie einige Python-Bibliotheken importieren: Requests, Beautiful Soup und Random.
Erstellen Sie dann eine Liste von Proxys, die während des Rotationsprozesses verwendet werden sollen. Diese Liste muss die URLs der Proxyserver in diesem Format enthalten: http://proxyserver.com:port:
# List of proxies
proxies = [
    "http://proxyprovider1.com:2010", "http://proxyprovider1.com:2020",
    "http://proxyprovider1.com:2030", "http://proxyprovider2.com:2040",
    "http://proxyprovider2.com:2050", "http://proxyprovider2.com:2060",
    "http://proxyprovider3.com:2070", "http://proxyprovider3.com:2080",
    "http://proxyprovider3.com:2090"
]
Erstellen Sie dann eine benutzerdefinierte Methode namens get_proxy(). Diese Methode wählt mit der Methode random.choice() zufällig einen Proxy aus der Liste der Proxys aus und gibt den ausgewählten Proxy im Dictionary-Format zurück (sowohl HTTP- als auch HTTPS-Schlüssel). Diese Methode verwenden Sie jedes Mal, wenn Sie eine neue Anfrage senden:
# Custom method to rotate proxies
def get_proxy():
    # Choose a random proxy from the list
    proxy = random.choice(proxies)
    # Return a dictionary with the proxy for both http and https protocols
    return {'http': proxy, 'https': proxy}
Sobald Sie die Methode get_proxy() erstellt haben, müssen Sie eine Schleife erstellen, die eine bestimmte Anzahl von GET-Anfragen mit den rotierten Proxys sendet. Bei jeder Anfrage verwendet die Methode get() einen zufällig ausgewählten Proxy, der von der Methode get_proxy() festgelegt wird.
Dann müssen Sie die Links aus dem HTML-Inhalt der Webseite mit dem Beautiful Soup-Paket sammeln, wie im ersten Beispiel erklärt.
Schließlich fängt der Python-Code alle Ausnahmen ab, die während des Anfrageprozesses auftreten, und gibt die Fehlermeldung an die Konsole aus.
Hier ist der vollständige Quellcode für dieses Beispiel:
# import packages
import requests
from bs4 import BeautifulSoup
import random

# List of proxies
proxies = [
    "http://proxyprovider1.com:2010", "http://proxyprovider1.com:2020",
    "http://proxyprovider1.com:2030", "http://proxyprovider2.com:2040",
    "http://proxyprovider2.com:2050", "http://proxyprovider2.com:2060",
    "http://proxyprovider3.com:2070", "http://proxyprovider3.com:2080",
    "http://proxyprovider3.com:2090"
]


# Custom method to rotate proxies
def get_proxy():
    # Choose a random proxy from the list
    proxy = random.choice(proxies)
    # Return a dictionary with the proxy for both http and https protocols
    return {'http': proxy, 'https': proxy}


# Send requests using rotated proxies
for i in range(10):
    # Set the URL to scrape
    url = 'https://brightdata.com/'
    try:
        # Send a GET request with a randomly chosen proxy
        response = requests.get(url, proxies=get_proxy())

        # Use BeautifulSoup to parse the HTML content of the website.
        soup = BeautifulSoup(response.content, "html.parser")

        # Find all the links on the website.
        links = soup.find_all("a")

        # Print all the links.
        for link in links:
            print(link.get("href"))
    except requests.exceptions.RequestException as e:
        # Handle any exceptions that may occur during the request
        print(e)
Verwendung des Bright Data Proxy-Dienstes mit Python
Wenn Sie einen zuverlässigen, schnellen und stabilen Proxy für Ihre Web-Scraping-Aufgaben suchen, dann sind Sie bei Bright Data genau richtig, einer Web-Datainfrastruktur, die verschiedene Arten von Proxys für eine Vielzahl von Anwendungsfällen anbietet.
Bright Data verfügt über ein großes Netzwerk von mehr als 400M+ monthly Residential-Proxy-IPs und mehr als 770.000 Datacenter-Proxys, die es ihnen ermöglichen, zuverlässige und schnelle Proxy-Lösungen anzubieten. Ihre Proxy-Angebote sind darauf ausgelegt, Ihnen zu helfen, die Herausforderungen des Web-Scraping, der Anzeigenüberprüfung und anderer Online-Aktivitäten zu bewältigen, die eine anonyme und effiziente Erfassung von Webdaten erfordern.
Die Integration von Bright Datas Proxys in Ihre Python Requests ist einfach. Verwenden Sie beispielsweise die Datacenter-Proxys, um eine Anfrage an die in den vorherigen Beispielen verwendete URL zu senden.
Wenn Sie noch kein Konto haben, melden Sie sich bei Bright Data an und fügen Sie dann Ihre Daten hinzu, um Ihr Konto zu registrieren.
Sobald Sie fertig sind, folgen Sie diesen Schritten, um Ihren ersten Proxy zu erstellen:
Klicken Sie auf der Willkommensseite auf View proxy product, um die verschiedenen Arten von Proxys zu sehen, die Bright Data anbietet:

Wählen Sie Datacenter Proxies, um einen neuen Proxy zu erstellen, und fügen Sie auf der nachfolgenden Seite Ihre Daten hinzu und speichern Sie diese:

Sobald Ihr Proxy erstellt ist, können Sie die wichtigen Parameter (zB Host, Port, Benutzername und Passwort) einsehen, um mit dem Zugriff und der Nutzung zu beginnen:
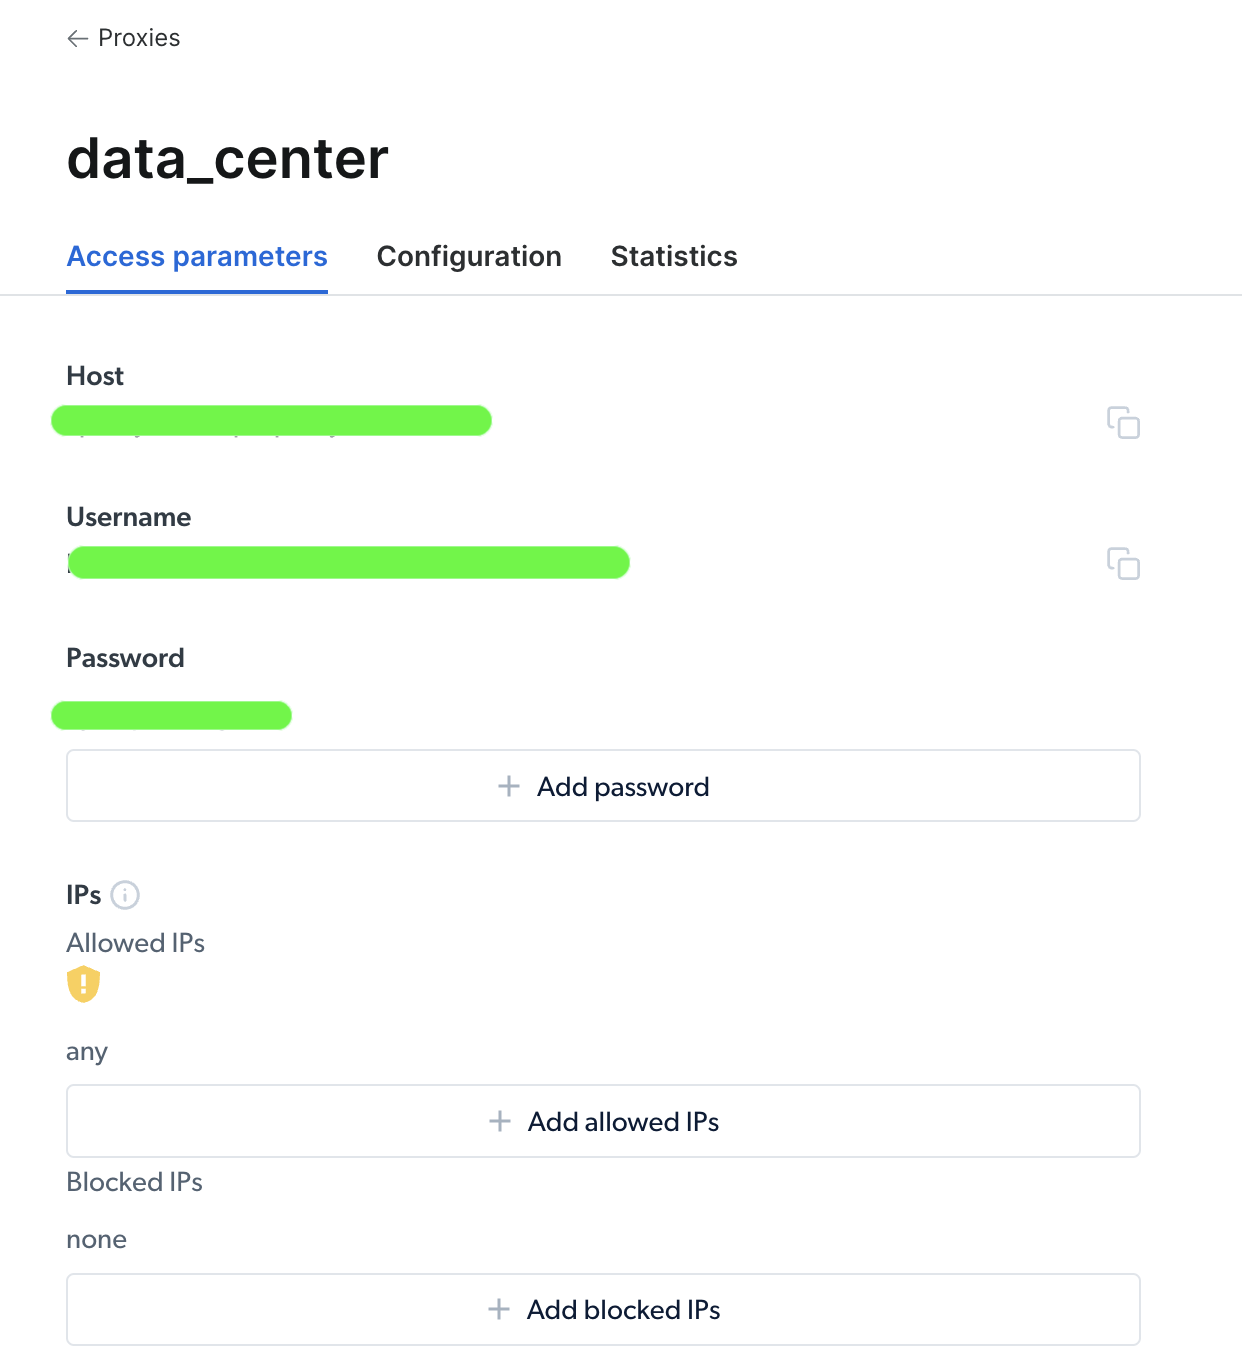
Sobald Sie auf Ihren Proxy zugegriffen haben, können Sie die Parameterinformationen verwenden, um Ihre Proxy-URL zu konfigurieren und eine Anfrage mit dem Python-Paket Requests zu senden. Das Format der Proxy-URL lautet username-(session-id)-password@host:port.
Hinweis: Die
session-idist eine Zufallszahl, die mit einem Python-Paket namensrandomerstellt wird.
Im Folgenden sehen Sie, wie Ihr Codebeispiel aussehen würde, um Ihren Proxy von Bright Data in einem Python-Request festzulegen:
import requests
from bs4 import BeautifulSoup
import random

# Define parameters provided by Brightdata
host = 'brd.superproxy.io'
port = 33335
username = 'username'
password = 'password'
session_id = random.random()

# format your proxy
proxy_url = ('http://{}-session-{}:{}@{}:{}'.format(username, session_id,
                                                     password, host, port))

# define your proxies in dictionary
proxies = {'http': proxy_url, 'https': proxy_url}

# Send a GET request to the website
url = "https://brightdata.com/"
response = requests.get(url, proxies=proxies)

# Use BeautifulSoup to parse the HTML content of the website
soup = BeautifulSoup(response.content, "html.parser")

# Find all the links on the website
links = soup.find_all("a")

# Print all the links
for link in links:
    print(link.get("href"))
Hier importieren Sie die Pakete und definieren die Variablen für Proxy-Host, Port, Benutzername, Passwort und session_id. Dann erstellen Sie ein proxies-Dictionary mit den Schlüsseln http und https sowie den Proxy-Zugangsdaten. Schließlich übergeben Sie den Parameter proxies an die Funktion requests.get(), um die HTTP-Anfrage zu stellen und die Links von der URL zu sammeln.
Und das war’s! Sie haben gerade erfolgreich eine Anfrage mit dem Proxy-Dienst von Bright Data gestellt.
Fazit
In diesem Artikel haben Sie erfahren, warum Sie Proxys benötigen und auf welche verschiedenen Arten Sie diese verwenden können, um mit dem Python-Paket Requests eine Anfrage an eine Webseite zu senden.
Mit der Web-Infrastruktur von Bright Data erhalten Sie zuverlässige Proxys für Ihr Projekt, die jedes Land oder jede Stadt der Welt abdecken. Sie bieten mehrere Möglichkeiten, die benötigten Daten über verschiedene Arten von Proxys und Tools für das Web-Scraping zu erhalten, die auf Ihre spezifischen Bedürfnisse zugeschnitten sind.
Egal, ob Sie Marktforschungsdaten sammeln, Online-Bewertungen überwachen oder die Preisgestaltung der Konkurrenz verfolgen möchten, Bright Data verfügt über die Ressourcen, die Sie benötigen, um die Aufgabe schnell und effizient zu erledigen.


