---
title: "Was ist cURL?"
slug: what-is-curl
date: 2026-02-18T06:44:06+00:00
modified: 2026-02-18T06:44:07+00:00
permalink: https://brightdata.de/blog/web-data-de/what-is-curl
type: blog
---
[ Blog ](https://brightdata.de/blog "Blog") / [Web Data](https://brightdata.de/blog/web-data-de)
[Web Data](https://brightdata.de/blog/web-data-de)
# Was ist cURL?
Informieren Sie sich über die Verwendung und Vorteile von curl. Dank wichtiger Befehle ist curl ein unverzichtbares Tool für HTTP-Anfragen und API-Tests.
11 min lesen
[  ](https://brightdata.com/blog/authors/martina-caccamo)
[Martina Caccamo
](https://brightdata.com/blog/authors/martina-caccamo)

curl, kurz für „client URL”, ist ein Befehlszeilentool, das zur Übertragung von Daten an einen bestimmten Server über dessen URL verwendet wird. curl ist sehr leicht zugänglich: Es erfordert lediglich eine Befehlszeilenschnittstelle (CLI) und eine Internetverbindung, weshalb es häufig in Routern, Druckern, Autos und medizinischen Geräten zum Einsatz kommt. Es [wird sogar auf dem Mars verwendet](https://daniel.haxx.se/blog/2021/12/03/why-curl-is-used-everywhere-even-on-mars/).
Für die meisten Entwickler ist curl ein hervorragendes Tool, um einen Backend-Dienst schnell und direkt von jedem Betriebssystem aus zu testen.
In diesem Artikel erfahren Sie mehr über curl und seine Verwendung.
## Geschichte von curl
Ursprünglich wurde curl 1996 vom brasilianischen Entwickler Rafael Sagula entwickelt und vertrieben. Daniel Stenberg übernahm das Projekt kurz nach der ersten Veröffentlichung und nahm einige Anpassungen vor, die es Stenberg ermöglichten, Wechselkurse automatisch aus dem Internet abzurufen.
Aufgrund seiner Funktion wurde curl ursprünglich *httpget* genannt. Als die Anzahl der unterstützten Protokolle zunahm, wurde der Name in *urlget* geändert. Als das Projekt 1998 so weit gewachsen war, dass es Upload-Funktionen unterstützte, wurde es schließlich in curl umbenannt.
Das Wachstum hörte damit nicht auf. Im Laufe der Jahre hat curl über 25 Protokolle und mehrere Funktionen unterstützt und verarbeitet monatlich Hunderte Millionen von Anfragen. Heute ist curl ein Open-Source-Projekt, das von einer Gemeinschaft freiwilliger Mitglieder weltweit gepflegt wird.
## Was curl leistet
Das Befehlszeilentool von curl ist unter Entwicklern für seine Fähigkeit bekannt, schnelle HTTP-Anfragen auszuführen, um Ihre Test- und Debugging-Aufgaben zu vereinfachen. Durch die Ausführung einfacher Befehle über das Terminal Ihres Computers kann curl GET-, POST- oder andere HTTP-Anfragen ausführen, die von der angegebenen API unterstützt werden.
Während Benutzer am häufigsten mit dem Befehlszeilentool von curl interagieren, wird der schwierigste Teil der Arbeit von seiner Entwicklungsbibliothek namens `libcurl` übernommen, einer riesigen Bibliothek, die die meisten Codebasen unterstützt. Dieser Kernteil des curl-Projekts arbeitet im Hintergrund und verarbeitet Anfragen und Antworten.
## So verwenden Sie curl
Um curl-Befehlszeilen zu verwenden, benötigen Sie eine CLI zu deren Ausführung – Mac Terminal für macOS, Command Prompt für Windows oder Bash für Linux – sowie eine Internetverbindung, damit Ihr Rechner sie ausführen, das Ergebnis anzeigen und die Antwort lesen kann, sofern vorhanden.
Jeder curl-Befehl folgt einer einfachen Syntax:
```none
curl [OPTIONEN] [URL]
```
In diesem Schema ist `[URL]` der Endpunkt, an den Sie die Anfrage senden, während `[OPTIONS]` der Befehl ist, der die Art der HTTP-Anfrage bestimmt, die Sie stellen möchten. Das Standardformat ist ein Bindestrich gefolgt von einem Buchstaben (*z. B.* `-d`) oder, in einer ausführlicheren Form, ein Doppelbindestrich gefolgt von einem Wort (*z. B.* `--data`). Zusätzlich können Sie HTTP-Methoden mit der Syntax `-X [METHODE]` (*z. B.* `-X POST`) angeben.
Hier sind einige Curl-Befehle, die jeder Entwickler kennen sollte.
### Senden von GET-Anfragen
Die häufigste Form der HTTP-Anfrage ist eine GET-Anfrage. Sie wird meist verwendet, um Daten – sei es als Text, Bild oder Datei – von der angegebenen Adresse abzurufen. Die Standard-Syntax für einen [curl-GET-Anfragebefehl](/faqs/curl/curl-get-requests) lautet `curl [URL]`. Hier wird keine Option angegeben, da GET das implizierte Standardverhalten ist, das für einen curl-Befehl definiert ist.
Unter Verwendung der Beispiel-URL `https://dummyjson.com/products` sieht eine GET-Anfrage, die mit curl an diesen Endpunkt gesendet wird, wie folgt aus:
```none
curl https://dummyjson.com/products
```
Das Ergebnis für diesen Befehl sieht in etwa so aus:
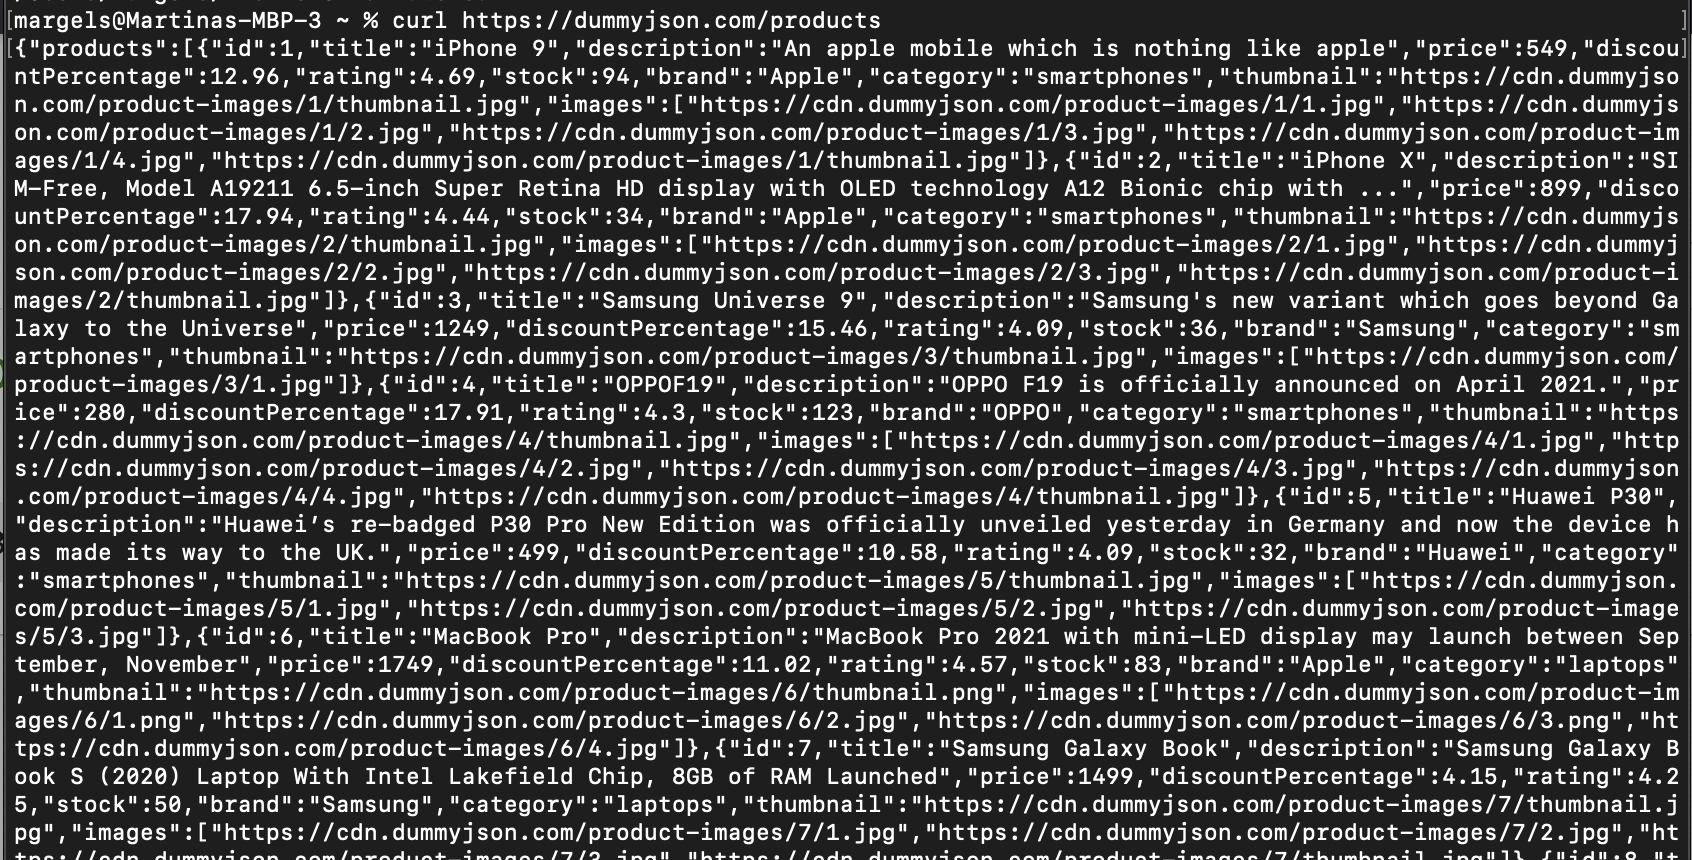Allerdings sind nicht alle GET-Anfragen so einfach durchzuführen. Einige erfordern Parameter, und obwohl diese in der URL angegeben werden können, ist es einfacher, die entsprechende Syntax von curl zu verwenden. Fügen Sie `-G` hinzu, um eine GET-Anfrage anzugeben, gefolgt von `-d „Parameter1=Wert1“` für so viele Parameter wie erforderlich. Die Syntax sollte wie folgt aussehen: `curl -G -d „Parameter1=Wert1” -d „Parameter2=Wert2” https://yoururl.com/yourendpoint`.
Wenn Sie eine GET-Anfrage an dieselbe URL wie zuvor senden, aber die Begrenzungszahl auf nur `1` setzen, sollte sie wie folgt aussehen:
```none
curl -G -d "limit=1" https://dummyjson.com/products
```
curl verwendet diesen Befehl, um die vollständige URL `https://dummyjson.com/products?limit=1` unter Verwendung der Basis-URL und des von Ihnen festgelegten Parameters zu bilden, um eine GET-Anfrage zu senden.
Dies wäre die Ausgabe:
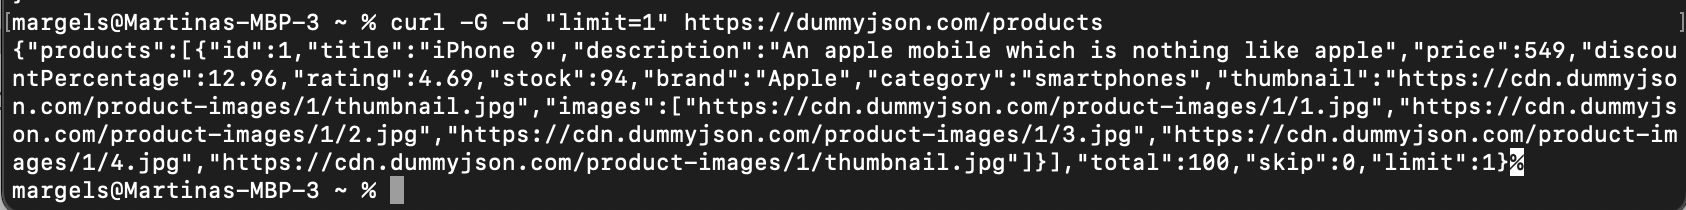Curl ist zwar leistungsstark, formatiert jedoch nicht die Ausgabe, die es von der Anfrage erhält. Auf einem Mac können Sie die Antwort verschönern, indem Sie `| json_pp` zu Ihrer Befehlszeile hinzufügen:
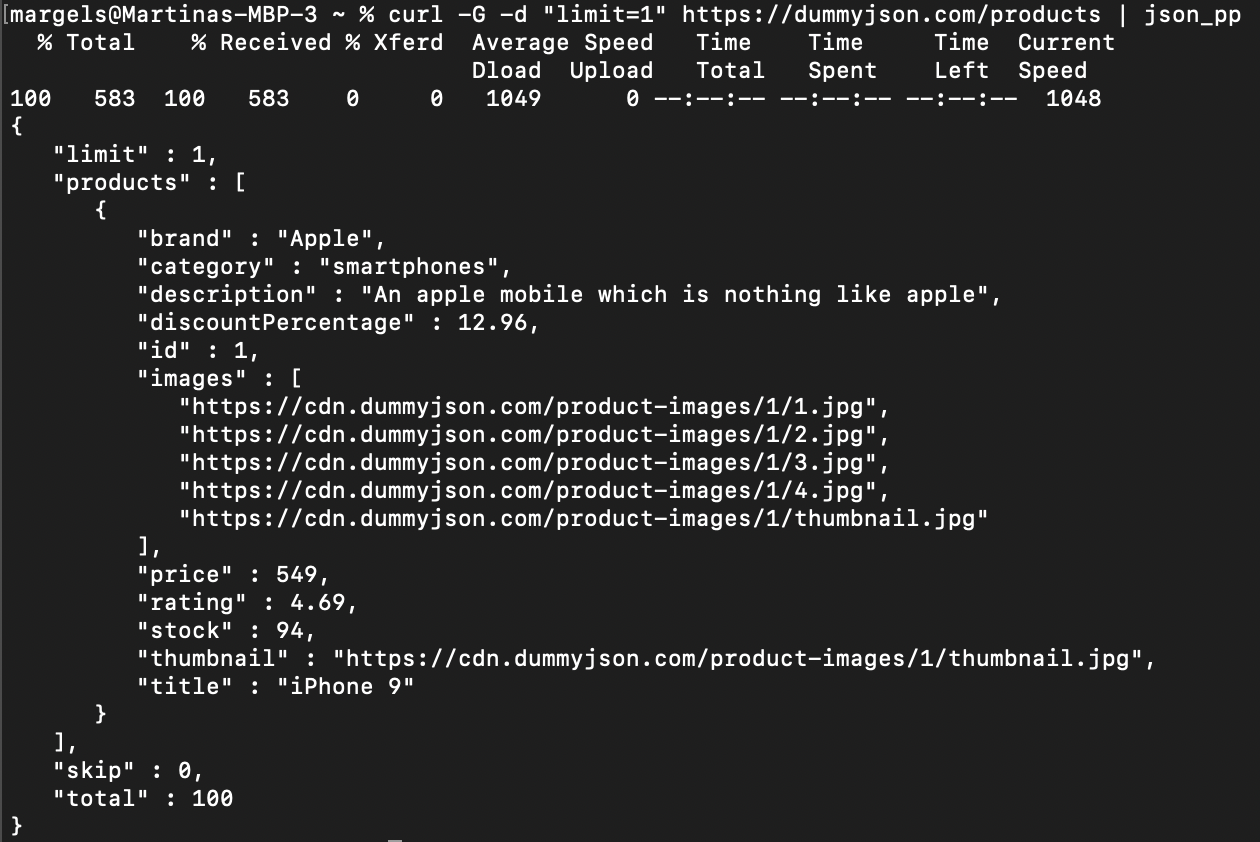Windows verfügt nicht über ein solches vorinstalliertes Tool, daher müssen Sie ein Tool wie [jq](https://jqlang.github.io/jq/) installieren und dessen Verknüpfung `| jq` verwenden, um schön formatierte JSONs zu erhalten.
Beachten Sie auch, dass Sie Curl-Anfragen mit Ihrer integrierten Programmiersprache bearbeiten können. Weitere Informationen zum Verwalten von GET-Anfragen mit PHP finden Sie beispielsweise in diesem [Blog](/blog/how-tos/curl-get-request-with-php).
### Senden von POST-Anfragen
Ein weiteres häufig verwendetes HTTP ist POST, das Daten an einen Server sendet und aktualisiert.
Die Grundsyntax für eine POST-Anfrage mit curl lautet `curl -X POST [URL]`. Diese Art von Anfrage sendet eine POST-Anfrage ohne den Hauptteil der Daten, was nützlich sein kann, wenn die Anfrage ausschließlich dazu dient, den Status eines Elements in der Datenbank zu aktualisieren. Mit der Beispiel-URL `https://httpbin.org/anything` können Sie beispielsweise eine einfache POST-Anfrage mit dem folgenden Befehl ausführen:
```none
curl -X POST https://httpbin.org/anything
```
In den meisten Fällen müssen Sie Daten hochladen. Dazu müssen Sie curl zunächst mitteilen, wie der Hauptteil der zu sendenden Daten gelesen werden soll, indem Sie dessen Format angeben. Fügen Sie einen Header mit dem Befehl `-H 'HEADER: VALUE'` hinzu und fügen Sie dann den Text Ihrer Anfrage mit dem Befehl `-d 'VALUE'` ein `.` Die vollständige Syntax lautet `curl -X POST -H 'HEADER: VALUE' -d 'VALUE' [URL]`.
Wenn Sie einen JSON-Body mit Vor- und Nachnamen senden möchten, können Sie mit `Content-Type` Ihren Inhaltstyp als JSON-Format definieren und einen einfachen JSON als Ihre Daten festlegen:
```none
curl -X POST -H "Content-Type: application/json" -d "{
"FirstName": "Joe",
"LastName": "Soap"
}" https://httpbin.org/anything
```
Hier ist die Ausgabe für den vorangehenden Befehl:
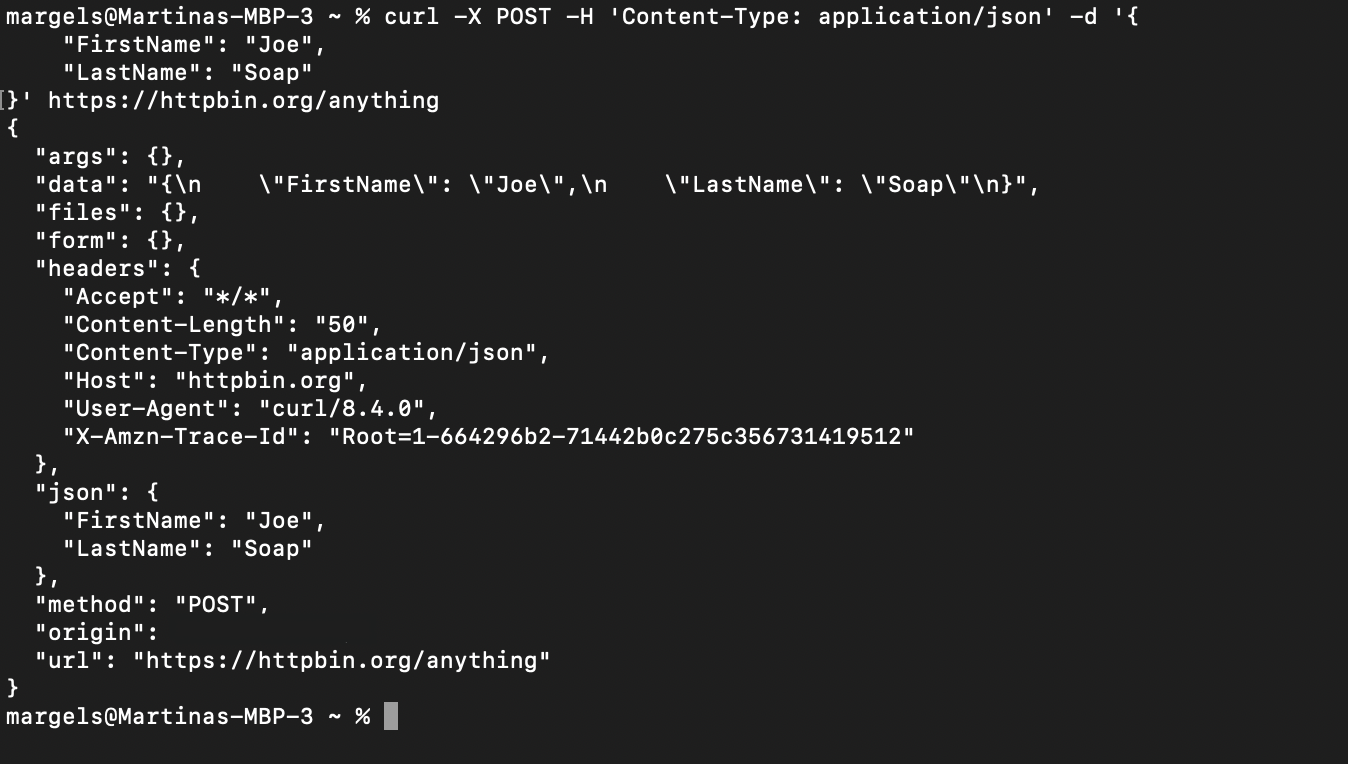Wie Sie sehen können, enthält das `Datenfeld` den Text der Daten, die Sie in Ihrer Anfrage gesendet haben.
Ab Version 7.82 hat curl auch die Abkürzung `--json` eingeführt, die Ihre POST-Anfragen mit einem JSON-Body zu `curl --json '[JSON BODY]' [URL]` vereinfacht. Der Befehl, um die gleiche Aufgabe wie zuvor mit der Abkürzung `--json` auszuführen, wäre der folgende:
```none
curl --json '{"FirstName": "Joe", "LastName": "Soap"}' https://httpbin.org/anything
```
Wenn Sie einen langen JSON-Body haben, den Sie lieber als lokale Datei speichern möchten, können Sie diesen stattdessen mit der Syntax `curl --json @[FILENAME].txt [URL]` hochladen:
```none
curl --json @file-name.txt https://httpbin.org/anything
```
Sie haben mehrere Möglichkeiten, Daten auf Ihren Server hochzuladen. Beispielsweise benötigen Sie möglicherweise ein anderes Format oder möchten Dateien ins Internet hochladen. Weitere Informationen zu POST-Anfragen mit curl finden Sie [hier](/blog/how-tos/curl-post-request-guide).
### Verbindung über Proxys
Viele Entwickler verwenden [Proxy-Server](/proxy-types/proxy-servers), um die Sicherheit zu verbessern. Genau wie eine Firewall schützt ein zuverlässiger Proxy-Server seine Benutzer und deren Netzwerk vor potenziellen Bedrohungen im Internet. Außerdem bietet er einen besseren Datenschutz.
Um einen Proxy-Server korrekt zu verwenden, benötigen Sie die folgenden Informationen über Ihren Proxy:
- Das Protokoll, z. B. `http://`
- Der Host, in der Regel vier durch Punkte getrennte Zahlen, z. B. `71.00.00.00`
- Den Port, normalerweise eine vierstellige Zahl, z. B. `0000`
- Anmeldedaten (optional) in Form eines Benutzernamens und eines Passworts
Die Syntax Ihrer Proxy-URL folgt dem Schema `[PROTOKOLL]://[[BENUTZERNAME]:[PASSWORT]][HOST]:[PORT]` oder, wenn der Proxy nicht durch Anmeldedaten geschützt ist, `[PROTOKOLL]://[HOST]:[PORT]`.
Sobald Sie die Proxy-URL haben, können Sie sie mit dem Befehl `-x` in curl einrichten. Beachten Sie, dass sich dieser Befehl von `-X` unterscheidet, der sich auf eine benutzerdefinierte HTTP-Anforderungsmethode bezieht. (Denken Sie daran, dass curl zwischen Groß- und Kleinschreibung unterscheidet.) Sie können auch die ausführlichere Option `--proxy` verwenden, wenn Sie diese leichter merken können. Auf jeden Befehl sollte die Proxy-URL und die endgültige URL folgen.
Unter Berücksichtigung der genannten Punkte sollte Ihr curl-Befehl zum Einrichten einer Proxy-URL in etwa so aussehen:
```none
curl --Proxy "http://71.00.00.00:0000" https://httpbin.org/ip
```
Ihre Antwort sollte ein `Origin` -Objekt enthalten, dessen Wert mit der Host-IP-Adresse Ihres Proxys übereinstimmen sollte:
```none
{
"origin": "71.00.00.00"
}
```
Das bedeutet, dass die Website davon ausgeht, dass die Anfrage von der IP-Adresse Ihres Proxys und nicht von der Ihres Computers stammt.
Weitere Informationen zur Verwendung von curl mit Proxys finden Sie in [diesem Blog](/blog/proxy-101/curl-with-proxies).
### Verwendung von Headern
Wie Sie vielleicht bemerkt haben, benötigen einige HTTP-Anfragen zusätzliche Informationen, um eine Aufgabe korrekt auszuführen. Beispielsweise haben Sie zuvor in Ihrer POST-Anfrage den Header `„Content-Type“` verwendet, um curl mitzuteilen, wie der Textkörper der von Ihnen hochgeladenen Daten zu lesen ist.
Header, denen immer der Befehl `-H` vorangestellt ist, können auch in verschiedenen anderen Fällen verwendet werden.
Ein gängiger Header-Typ ist `„Authorization: Bearer [TOKEN]`“, der ein Bearer-Token zur Authentifizierung und zum Zugriff auf eine geschützte URL angibt. Ein weiterer häufig verwendeter Header ist `„Accept: application/json“`, der eine JSON-Antwortpräferenz angibt.
Wenn Sie eine Liste der Antwort-Header für eine URL erhalten möchten, können Sie den Befehl `-I` curl in Ihrem Terminal wie folgt verwenden:
```none
curl -I https://dummyjson.com/products
```
Sie können auch `-i` verwenden, um die Antwort auf die Anfrage zusammen mit den Headern anzuzeigen.
Weitere Informationen zu Headern in curl finden Sie in diesem [Blog](/blog/how-tos/http-headers-with-curl).
### Ausgaben speichern
Manchmal reicht es nicht aus, Daten nur zu lesen, sondern Sie müssen diese Ausgaben auch irgendwo auf Ihrem Computer speichern. Wie bereits erwähnt, kann curl auch Daten verarbeiten, die nicht im Textformat vorliegen. So kann es beispielsweise ganze Dateien herunterladen oder hochladen.
Mit dem Befehl `-o` können Sie den Namen und den Speicherort der Datei angeben, die Sie speichern möchten. Wenn Sie beispielsweise den Inhalt [dieser Seite](/blog) im TXT-Format auf Ihrem Desktop speichern möchten, können Sie diesen Befehl verwenden:
```none
curl -o /Users/User/Desktop/file.txt https://brightdata.com/blog
```
Führen Sie diesen Befehl aus und öffnen Sie Ihren Desktop, um die neu gespeicherte Datei anzuzeigen.
### Dateien hochladen
Genauso wie curl Dateien aus dem Internet herunterladen kann, können Sie damit auch Dateien hochladen. Um curl mitzuteilen, dass Sie keine Daten in Textform, sondern als tatsächliche Datei hochladen, müssen Sie das Symbol `@` vor den Dateinamen setzen.
Viele Entwickler machen den Fehler, nur das Flag `-X POST` zu verwenden, weil sie denken, dass dies der richtige Befehl zum Hochladen von Dateien auf einen Server mit curl ist. Für das Hochladen von Dateien ist jedoch in der Regel der Inhaltstyp `multipart/form-data` erforderlich, da die Dateien als Teil eines Formulars angehängt werden. Sie müssen also zusammen mit dem Flag `-X POST` den richtigen Header-Typ festlegen. Das Flag `-F` setzt den richtigen Content-Type-Header und das Flag `-X POST` automatisch, was zu einem kürzeren, einfacheren Befehl für Sie führt.
Mit dem Flag `-F` können Sie ein Formular absenden, indem Sie die Werte der Formularfelder angeben. Um eine Datei als Formularfeld anzuhängen, verwenden Sie das Symbol `@` vor dem Dateinamen.
Die korrekte Syntax lautet `curl -F "file=@[DATEIPFAD]/[DATEINAME].txt" [URL]`, wobei `„file”` der Name des Dateifelds im Formular ist. Angenommen, Sie möchten die zuvor heruntergeladene Datei auf eine Dummy-URL wie `https://example.com/upload` hochladen, dann sollte Ihr Befehl wie folgt aussehen:
```none
curl -F "file=@/Users/User/Desktop/file.txt" https://example.com/upload
```
Wenn Sie mehr als eine Datei hochladen möchten, können Sie die Befehlssyntax `-F` vor der Definition der URL so oft wiederholen, wie Sie möchten.
## Anwendungsfälle für curl
Aufgrund seiner hohen Kompatibilität und Vielseitigkeit kann curl in einer Vielzahl unterschiedlicher Szenarien eingesetzt werden.
Am häufigsten wird curl als HTTP-Client für API-Tests, die Interaktion mit Webdiensten und die Durchführung verschiedener HTTP-Operationen wie GET oder POST verwendet. Zahlreiche Programmiersprachen verwenden `libcurl` auch, um HTTP-Anfragen intern durchzuführen.
Während curl in erster Linie auf die Ausführung von HTTP-Anfragen und das Abrufen ihrer Antworten ausgerichtet ist, kann es auch mit anderen Tools oder Skripten zum Parsing und Verarbeiten empfangener Inhalte kombiniert werden. Beispielsweise kann es [den HTML-Inhalt](/blog/how-tos/how-to-use-curl-for-web-scraping) einer Webseite als Teil des [Web-Scrapings](/blog/how-tos/what-is-web-scraping) [abrufen](/blog/how-tos/how-to-use-curl-for-web-scraping).
## Vorteile von curl
curl bietet viele Vorteile. Am bemerkenswertesten sind seine hohe Kompatibilitätsrate, wodurch es auf fast jedem Gerät verwendet werden kann, und seine Syntax, die einfach zu erlernen und zu beherrschen ist.
curl ist außerdem funktionsreich, vielseitig, schnell und besonders leichtgewichtig, sodass es Aufgaben ausführen kann, ohne Ihre CPU zu überlasten.
## Fazit
In diesem Artikel haben Sie mehr über die Geschichte von curl, seine Funktionsweise, seine Anwendungsfälle und seine Vorteile erfahren. Außerdem haben Sie gesehen, wie Sie einige der grundlegendsten Befehle mit curl ausführen können.
Wenn Sie an schnelleren Möglichkeiten für das Web-Scraping interessiert sind, sollten Sie sich unbedingt die [Bright Data Web Scraper API](/products/web-scraper) ansehen. Melden Sie sich jetzt für eine kostenlose Testversion an!
Vertrieb kontaktierenGratis testen
Inhaltsverzeichnis
Dedicated Scraper APIs & No-Code Scrapers
Over 1000 scrapers for all popular domains. Simplify your web scraping.
[See pricing](/pricing/web-scraper "See pricing")
Just want data? Skip scraping.
Hundreds of ready-to-use datasets from all popular domains.
[See pricing](/pricing/datasets "See pricing")
[ ](https://news.ycombinator.com/submitlink?t=Was+ist+cURL%3F&u=https://brightdata.de/blog/web-data-de/what-is-curl) [ ](https://www.linkedin.com/shareArticle?mini=true&title=Was+ist+cURL%3F&url=https://brightdata.de/blog/web-data-de/what-is-curl) [ ](http://www.reddit.com/submit?title=Was+ist+cURL%3F&url=https://brightdata.de/blog/web-data-de/what-is-curl)
## Das könnte Sie auch interessieren
[  ](https://brightdata.de/blog/proxys-101/what-is-a-headless-browser "Was ist ein Headless Browser und wozu wird er verwendet?")
[Proxy 101

Aviv Besinsky
### Was ist ein Headless Browser und wozu wird er verwendet?
Headless-Browser können für eine effizientere Datenerfassung genutzt werden, da sie grafische Elemente überspringen und direkt zu den „Befehlszeilen” übergehen. Das Hinzufügen eines Automatisierungselements trägt dazu bei, die Erfolgsquote der Zielwebsite zu erhöhen, die User-Agent-Rotation zu übernehmen und die Erfassung von Cookie-Datenbanken überflüssig zu machen.
08-Feb-2026
4 min lesen
](https://brightdata.de/blog/proxys-101/what-is-a-headless-browser)
[  ](https://brightdata.de/blog/web-data-de/what-is-a-web-crawler "Was ist ein Webcrawler?")
[Web Data

Ella Siman
Product Marketing Manager
### Was ist ein Webcrawler?
Webcrawler sind ein wichtiger Teil der Infrastruktur des Internets. In diesem Artikel geht es um Folgendes: Webcrawler – Definition Ein Webcrawler ist ein Software-Roboter, der das Internet durchsucht und die gefundenen Daten herunterlädt. Die meisten Webcrawler werden von Suchmaschinen wie Google, Bing, Baidu und DuckDuckGo betrieben. Suchmaschinen wenden ihre Suchalgorithmen auf die gesammelten Daten an, […]
15-Jan-2023
5 min lesen
](https://brightdata.de/blog/web-data-de/what-is-a-web-crawler)