---
title: "Web-Scraping mit Parsel in Python: Leitfaden 2026"
slug: web-scraping-with-parsel
date: 2026-02-16T07:21:47+00:00
modified: 2026-02-16T07:21:48+00:00
permalink: https://brightdata.de/blog/web-data-de/web-scraping-with-parsel
type: blog
---
[ Blog ](https://brightdata.de/blog "Blog") / [Web Data](https://brightdata.de/blog/web-data-de)
[Web Data](https://brightdata.de/blog/web-data-de)
# Web-Scraping mit Parsel in Python: Leitfaden 2026
Meistern Sie das Web-Scraping mit Parsel! Lernen Sie, wie Sie Daten mit XPath- und CSS-Selektoren extrahieren, Paginierung handhaben und fortgeschrittene Scraping-Szenarien bewältigen.
15 min lesen
[  ](https://brightdata.com/blog/authors/federico-trotta)
[Federico Trotta
Technical Writer
](https://brightdata.com/blog/authors/federico-trotta)

In diesem Leitfaden zum Web-Scraping mit Parsel in Python erfahren Sie:
- Was Parsel ist
- Warum man es für Web-Scraping verwenden sollte
- Eine Schritt-für-Schritt-Anleitung, die zeigt, wie man Parsel für Web-Scraping verwendet
- Fortgeschrittene Scraping-Szenarien mit Parsel in Python
Lassen Sie uns loslegen!
## Was ist Parsel?
[Parsel](https://pypi.org/project/parsel/) ist eine Python-Bibliothek für das Parsing und Extrahieren von Daten aus HTML-, XML- und JSON-Dokumenten. Es baut auf [`lxml`](https://pypi.org/project/lxml/) auf und bietet eine höherwertige und benutzerfreundlichere Oberfläche für das Web-Scraping. Im Detail bietet es eine intuitive API, die den Prozess der Datenextraktion aus HTML- und XML-Dokumenten vereinfacht.
## Warum Parsel für das Web-Scraping verwenden?
Parsel bietet interessante Funktionen für das Web-Scraping, darunter
- **Unterstützung für XPath- und CSS-Selektoren**: Verwenden Sie entweder XPath- oder CSS-Selektoren, um Elemente in HTML- oder XML-Dokumenten zu finden. Weitere Informationen finden Sie in unserem Leitfaden zu [XPath- und CSS-Selektoren für das Web-Scraping](/blog/web-data/xpath-vs-css-selectors).
- **Datenextraktion**: Rufen Sie Text, Attribute oder andere Inhalte aus den ausgewählten Elementen ab.
- **Verkettung von Selektoren**: Verketten Sie mehrere Selektoren, um Ihre Datenextraktion zu verfeinern.
- **Skalierbarkeit**: Die Bibliothek eignet sich sowohl für kleine als auch für große Scraping-Projekte.
Beachten Sie, dass die Bibliothek eng in [Scrapy](https://scrapy.org/) integriert ist, das sie zum Parsing und Extrahieren von Daten aus Webseiten verwendet. Parsel kann jedoch auch als eigenständige Bibliothek verwendet werden.
## Verwendung von Parsel in Python für das Web-Scraping: Eine Schritt-für-Schritt-Anleitung
In diesem Abschnitt erfahren Sie, wie Sie mit Parsel in Python das Web-Scraping durchführen können. Die Zielseite ist[„Hockey Teams: Forms, Searching and Pagination](https://www.scrapethissite.com/pages/forms/)”:
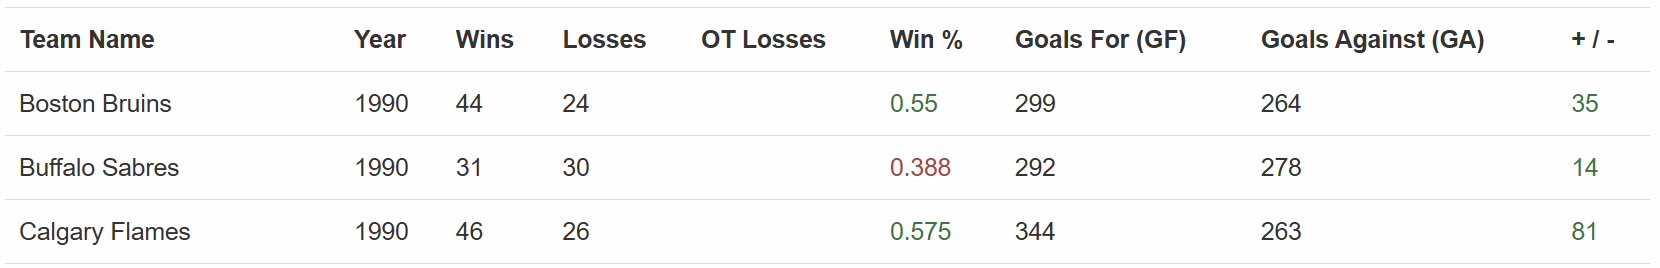Der Parsel-Scraper extrahiert alle Daten aus der obigen Tabelle. Befolgen Sie die folgenden Schritte und sehen Sie, wie Sie ihn erstellen können!
### Voraussetzungen und Abhängigkeiten
Um dieses Tutorial nachzuvollziehen, muss [Python 3.10.1 oder höher](https://www.python.org/downloads/) auf Ihrem Rechner installiert sein. Beachten Sie insbesondere, dass Parsel kürzlich die Unterstützung für Python 3.8 eingestellt hat.
Angenommen, Sie nennen den Hauptordner Ihres Projekts `parsel_scraping/.` Am Ende dieses Schritts hat der Ordner die folgende Struktur:
```none
parsel_scraping/
├── parsel_scraper.py
└── venv/
```
Dabei gilt:
- `parsel_scraper.py` die Python-Datei ist, die die Scraping-Logik enthält.
- `venv/` enthält die virtuelle Umgebung.
Sie können das Verzeichnis [der virtuellen Umgebung](https://docs.python.org/3/library/venv.html) `venv/` wie folgt erstellen:
```none
python -m venv venv
```
Um sie zu aktivieren, führen Sie unter Windows Folgendes aus:
```none
venvScriptsactivate
```
Entsprechend führen Sie unter macOS und Linux Folgendes aus:
```none
source venv/bin/activate
```
Installieren Sie in einer aktivierten virtuellen Umgebung die Abhängigkeiten mit:
```none
pip install parsel requests
```
Diese beiden Abhängigkeiten sind:
- [`parsel`](https://pypi.org/project/parsel/): Eine Bibliothek für das Parsing von HTML und das Extrahieren von Daten.
- [`requests`](https://pypi.org/project/requests/): Erforderlich, da `parsel` nur ein HTML-Parser ist. Um Web-Scraping durchzuführen, benötigen Sie außerdem einen [HTTP-Client wie Requests](/blog/web-data/python-requests-guide), um die HTML-Dokumente der Seiten abzurufen, die Sie scrapen möchten.
Großartig! Jetzt haben Sie alles, was Sie benötigen, um Web-Scraping mit Parsel in Python durchzuführen.
### Schritt 1: Definieren Sie die Ziel-URL und führen Sie das Parsing des Inhalts durch
Als ersten Schritt dieses Tutorials müssen Sie die Bibliotheken importieren:
```none
import requests
from parsel import Selector
```
Definieren Sie dann die Zielwebseite, rufen Sie den Inhalt mit Requests ab und führen Sie das Parsing mit Parsel aus:
```none
url = "https://www.scrapethissite.com/pages/forms/"
response = requests.get(url)
selector = Selector(text=response.text)
```
Der obige Ausschnitt instanziiert die Klasse [`Selector()`](https://parsel.readthedocs.io/en/latest/parsel.html#parsel.selector.Selector) aus Parsel. Diese führt das Parsing des HTML-Codes durch, der aus der Antwort der mit [`get()`](https://requests.readthedocs.io/en/latest/user/quickstart/) durchgeführten HTTP-Anfrage gelesen wurde.
### Schritt 2: Extrahieren Sie alle Zeilen aus der Tabelle
Wenn Sie die Tabelle auf der Zielwebseite im Browser untersuchen, sehen Sie den folgenden HTML-Code:
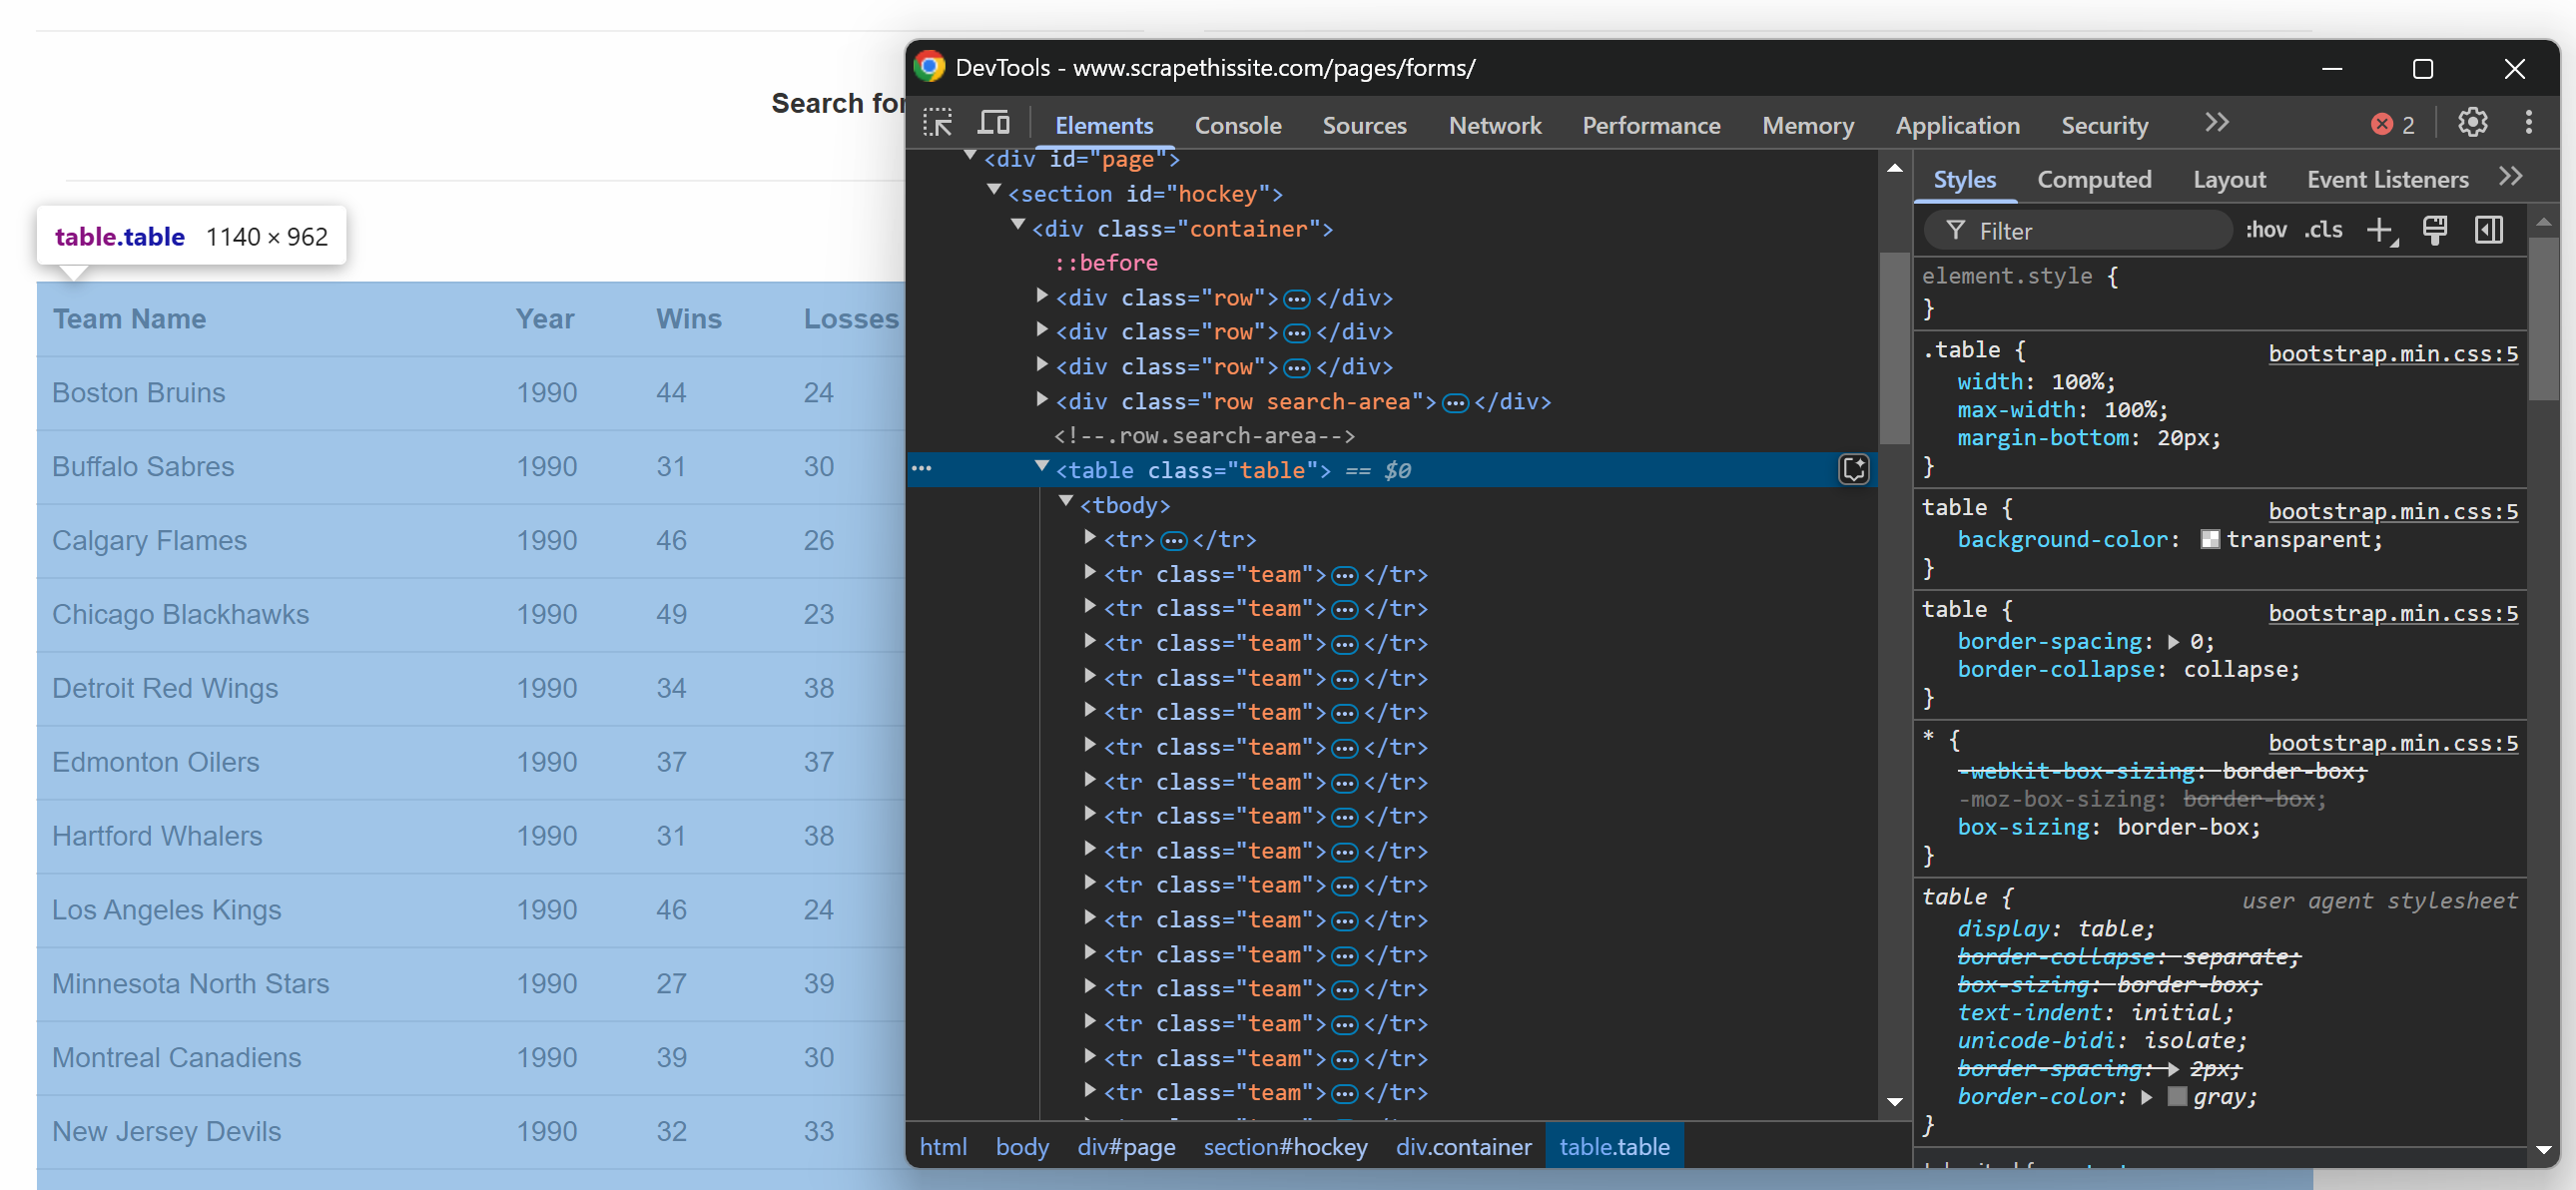Da die Tabelle mehrere Zeilen enthält, initialisieren Sie ein Array, in dem die gescrapten Daten gespeichert werden sollen:
```none
data = []
```
Beachten Sie nun, dass die HTML-Tabelle eine `.table` -Klasse hat. Um alle Zeilen aus der Tabelle auszuwählen, können Sie die folgende Codezeile verwenden:
```none
rows = selector.css("table.table tr.team")
```
Hierbei wird die Methode [`css()`](https://parsel.readthedocs.io/en/latest/parsel.html#parsel.selector.Selector.css) verwendet, um den CSS-Selektor auf die geparste HTML-Struktur anzuwenden.
Jetzt ist es an der Zeit, die ausgewählten Zeilen zu durchlaufen und Daten daraus zu extrahieren!
### Schritt 3: Durchlaufen der Zeilen
Überprüfen Sie wie zuvor eine Zeile innerhalb der Tabelle:
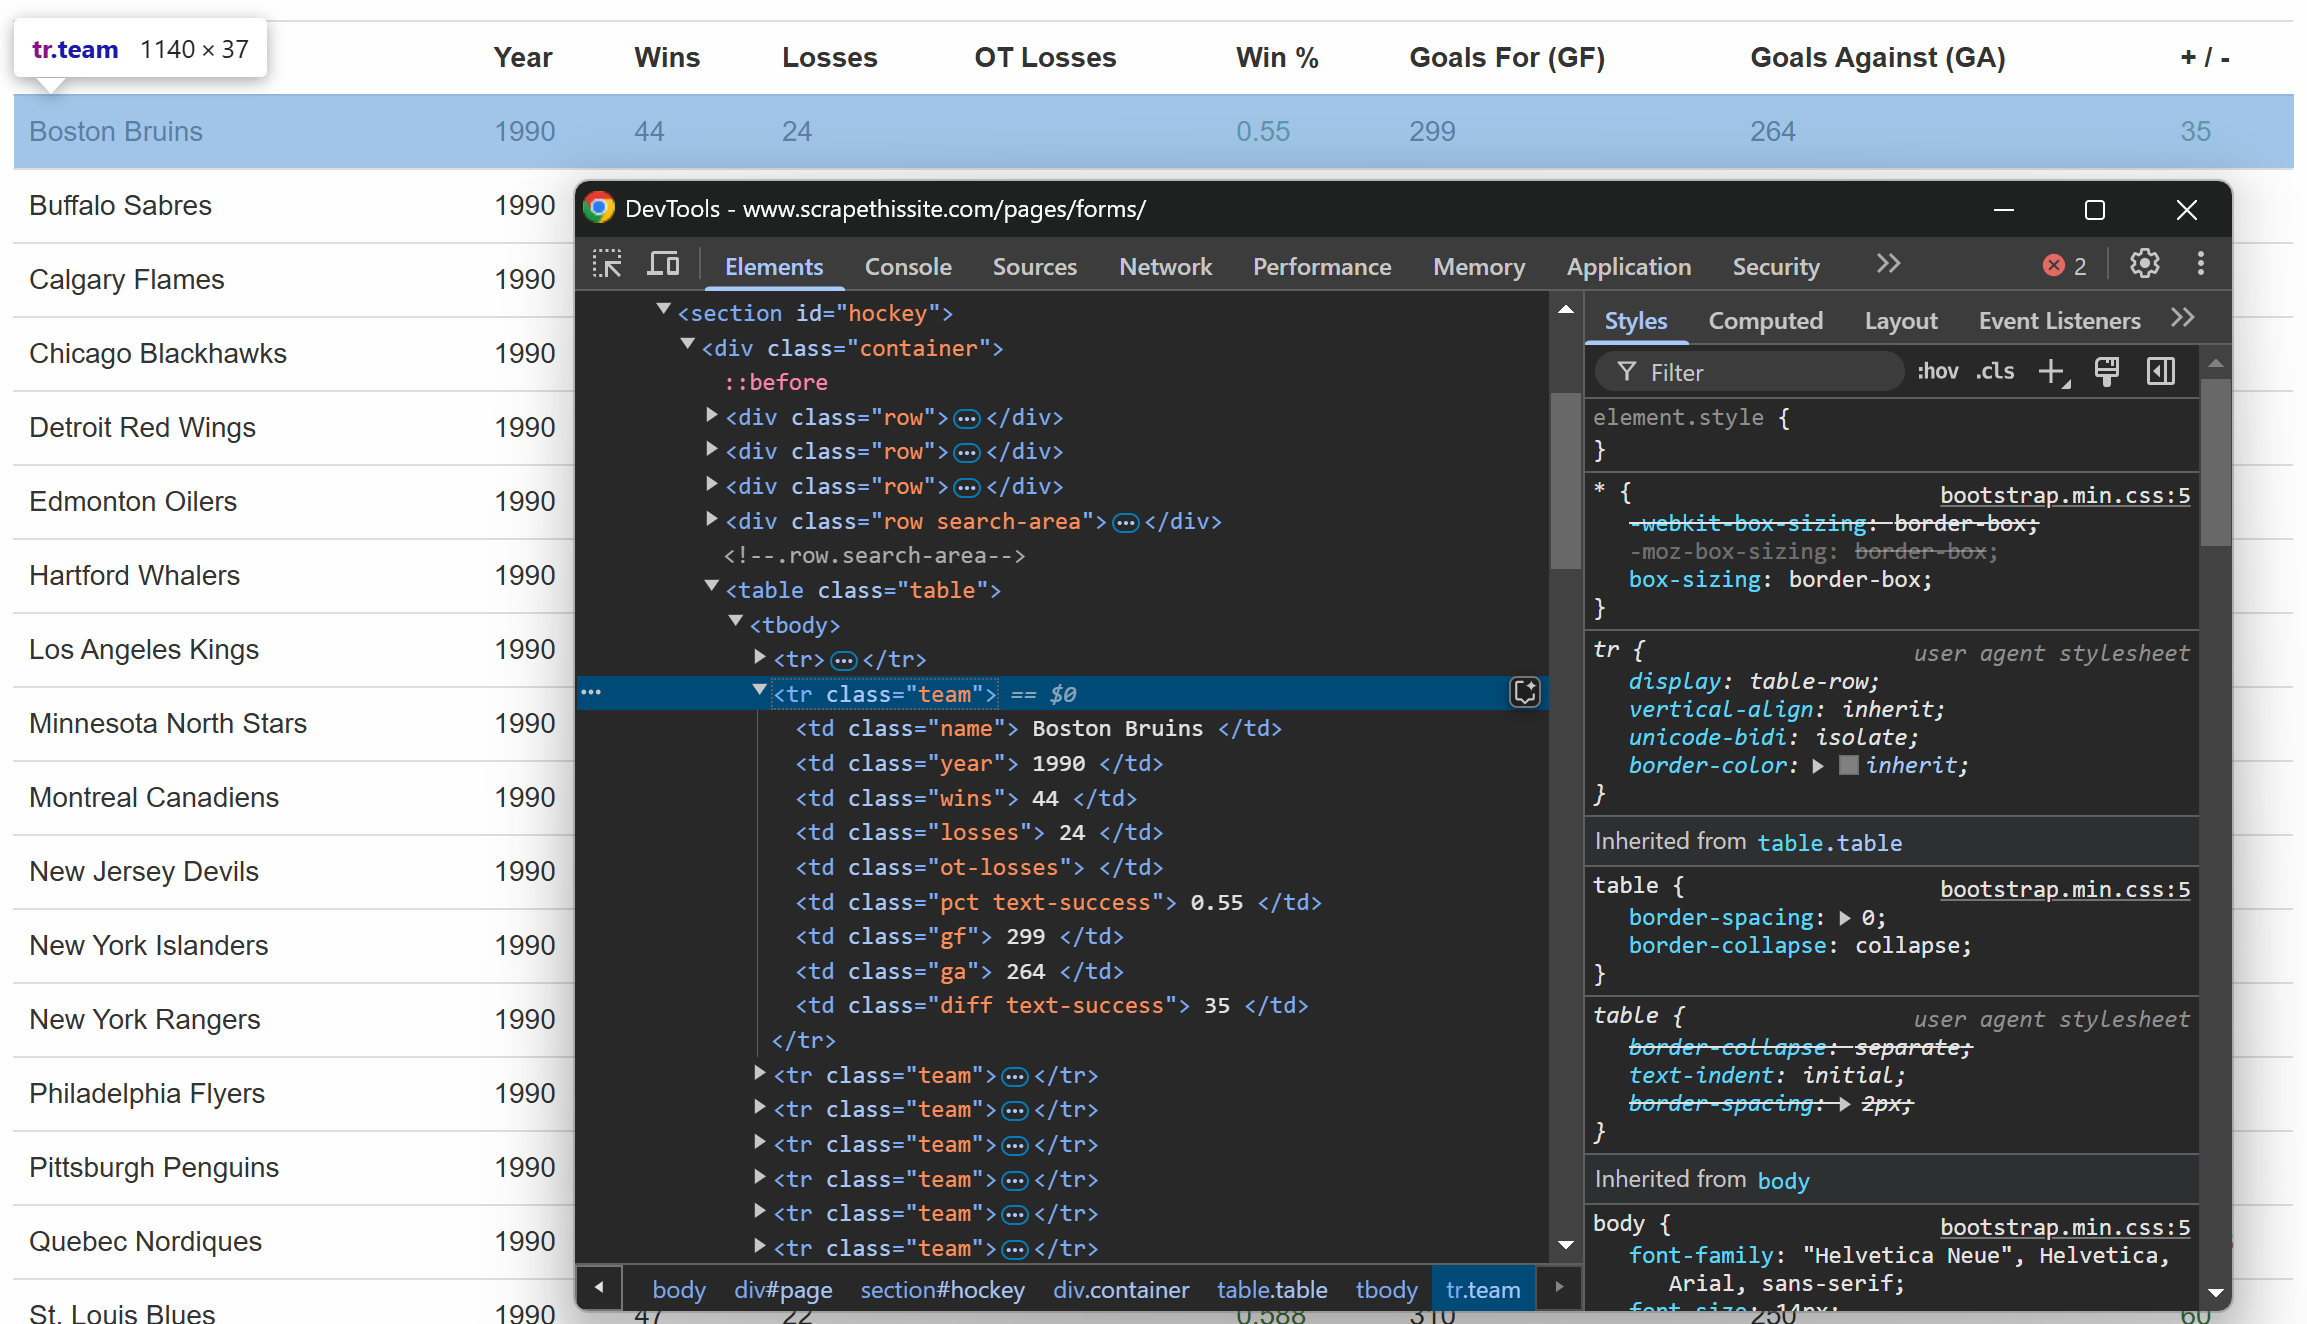Sie werden feststellen, dass jede Zeile die folgenden Informationen in speziellen Spalten enthält:
- Teamname → innerhalb des Elements `.name`
- Saisonjahr → im Element `.year`
- Anzahl der Siege → im Element `.wins`
- Anzahl der Niederlagen → im Element `.losses`
- Niederlagen in der Verlängerung → im Element `.ot-losses`
- Gewinnquote → innerhalb des Elements `.pct`
- Erzielte Tore (Goals For – GF) → innerhalb des Elements `.gf`
- Gegentore (Goals Against – GA) → innerhalb des Elements `.ga`
- Tordifferenz → innerhalb des Elements `.diff`
Sie können alle diese Informationen mit der folgenden Logik extrahieren:
```none
for row in rows:
# Daten aus jeder Spalte extrahieren
name = row.css("td.name::text").get()
year = row.css("td.year::text").get()
wins = row.css("td.wins::text").get()
losses = row.css("td.losses::text").get()
ot_losses = row.css("td.ot-losses::text").get()
pct = row.css("td.pct::text").get()
gf = row.css("td.gf::text").get()
ga = row.css("td.ga::text").get()
diff = row.css("td.diff::text").get()
# Die extrahierten Daten anhängen
data.append({
"name": name.strip(),
"year": year.strip(),
"wins": wins.strip(),
"losses": losses.strip(),
"ot_losses": ot_losses.strip(),
"pct": pct.strip(),
"gf": gf.strip(),
"ga": ga.strip(),
"diff": diff.strip()
})
```
Der obige Code bewirkt Folgendes:
1. Die Methode [`get()`](https://parsel.readthedocs.io/en/latest/parsel.html#parsel.selector.SelectorList.get) wählt Textknoten mithilfe von CSS3-Pseudo-Elementen aus.
2. Die Methode [`strip()`](https://docs.python.org/3/library/stdtypes.html#str.strip) entfernt alle führenden und nachfolgenden Leerzeichen.
3. Die Methode [`append()`](https://docs.python.org/3/tutorial/datastructures.html) hängt den Inhalt an die `Daten` liste an.
Großartig! Die Logik zum Parsen der Daten ist fertig.
### Schritt 4: Daten ausgeben und Programm ausführen
Als letzten Schritt drucken Sie die gescrapten Daten in der CLI aus:
```none
# Extrahierte Daten ausgeben
print("Daten von der Seite:")
for entry in data:
print(entry)
```
Führen Sie das Programm aus:
```none
python parsel_scraper.py
```
Dies ist das erwartete Ergebnis:

Erstaunlich! Das sind genau die Daten auf der Seite, jedoch in einem strukturierten Format.
### Schritt 5: Paginierung verwalten
Bis zum vorherigen Schritt haben Sie die Daten von der Hauptseite der Ziel-URL abgerufen. Was ist, wenn Sie nun alle Daten abrufen möchten? Dazu müssen Sie [die Paginierung verwalten](/blog/web-data/pagination-web-scraping), indem Sie einige Änderungen am Code vornehmen.
Zunächst müssen Sie den vorherigen Code in eine Funktion wie diese einkapseln:
```none
def scrape_page(url):
# Seiteninhalt abrufen
response = requests.get(url)
# HTML-Inhalt parsen
selector = Selector(text=response.text)
# Scraping-Logik...
return data
```
Sehen Sie sich nun das HTML-Element an, das die Paginierung verwaltet:

Dieses enthält eine Liste aller Seiten, wobei jede Seite eine in ein `` -Element eingebettete URL hat. Kapseln Sie die Logik zum Abrufen aller Paginierungs-URLs in einer Funktion:
```none
def get_all_page_urls(base_url="https://www.scrapethissite.com/pages/forms/"):
# Die erste Seite abrufen, um Paginierungslinks zu extrahieren
response = requests.get(base_url)
# Die Seite analysieren
selector = Selector(text=response.text)
# Extrahieren Sie alle Seitenlinks aus dem Paginierungsbereich.
page_links = selector.css("ul.pagination li a::attr(href)").getall() # Passen Sie den Selektor basierend auf der HTML-Struktur an.
unique_links = list(set(page_links)) # Entferne gegebenenfalls Duplikate
# Erstelle vollständige URLs für alle Seiten
full_urls = [urljoin(base_url, link) for link in unique_links]
return full_urls
```
Diese Funktion führt Folgendes aus:
- Die Methode [`getall()`](https://parsel.readthedocs.io/en/latest/parsel.html#parsel.selector.Selector.getall) ruft alle Paginierungslinks ab.
- Die Methode `list(set())` entfernt Duplikate, um zu verhindern, dass dieselbe Seite zweimal aufgerufen wird.
- Die Methode [`urljoin()`](https://docs.python.org/3/library/urllib.parse.html#urllib.parse.urljoin) aus der Bibliothek `urlib.parse` konvertiert alle relativen URLs in absolute URLs, damit sie für weitere HTTP-Anfragen verwendet werden können.
Damit der obige Code funktioniert, müssen Sie `urljoin` aus der Python-Standardbibliothek importieren:
```none
from urllib.parse import urljoin
```
Jetzt kannst du alle Seiten mit folgendem Code scrapen:
```none
# Speicherort für die gescrapten Daten
data = []
# Alle Seiten-URLs abrufen
page_urls = get_all_page_urls()
# Durchlaufen Sie sie und wenden Sie die Scraping-Logik an
for url in page_urls:
# Scrapen Sie die aktuelle Seite
page_data = scrape_page(url)
# Fügen Sie die gescrapten Daten zur Liste hinzu
data.extend(page_data)
# Drucken Sie die extrahierten Daten
print("Daten von allen Seiten:")
for entry in data:
print(entry)
```
Der obige Ausschnitt:
1. Ruft alle Seiten-URLs ab, indem die Funktion `get_all_page_urls()` aufgerufen wird.
2. Scrape die Daten von jeder Seite, indem die Funktion `scrape_page()` aufgerufen wird. Anschließend werden die Ergebnisse mit der Methode [`extend()`](https://docs.python.org/3/tutorial/datastructures.html) zusammengefasst.
3. Gibt die gescrapten Daten aus.
Fantastisch! Die Parsel-Paginierungslogik ist nun implementiert.
### Schritt 6: Alles zusammenfügen
Nachfolgend finden Sie den aktuellen Inhalt der Datei `parsel_scraper.py`:
```none
import requests
from parsel import Selector
from urllib.parse import urljoin
def scrape_page(url):
# Seiteninhalt abrufen
response = requests.get(url)
# HTML-Inhalt analysieren
selector = Selector(text=response.text)
# Speicherort für die extrahierten Daten
data = []
# Alle Zeilen im Tabellenkörper auswählen
rows = selector.css("table.table tr.team")
# Jede Zeile durchlaufen und Daten daraus scrapen
for row in rows:
# Daten aus jeder Spalte extrahieren
name = row.css("td.name::text").get()
year = row.css("td.year::text").get()
wins = row.css("td.wins::text").get()
losses = row.css("td.losses::text").get()
ot_losses = row.css("td.ot-losses::text").get()
pct = row.css("td.pct::text").get()
gf = row.css("td.gf::text").get()
ga = row.css("td.ga::text").get()
diff = row.css("td.diff::text").get()
# Die extrahierten Daten an die Liste anhängen
data.append({
"name": name.strip(),
"year": year.strip(),
"wins": wins.strip(),
"losses": losses.strip(),
"ot_losses": ot_losses.strip(),
"pct": pct.strip(),
"gf": gf.strip(),
"ga": ga.strip(),
"diff": diff.strip(),
})
return data
def get_all_page_urls(base_url="https://www.scrapethissite.com/pages/forms/"):
# Die erste Seite abrufen, um die Paginierungslinks zu extrahieren
response = requests.get(base_url)
# Die Seite analysieren
selector = Selector(text=response.text)
# Extrahieren aller Seitenlinks aus dem Paginierungsbereich
page_links = selector.css("ul.pagination li a::attr(href)").getall() # Selektor basierend auf HTML-Struktur anpassen
unique_links = list(set(page_links)) # Duplikate entfernen, falls vorhanden
# Vollständige URLs für alle Seiten erstellen
full_urls = [urljoin(base_url, link) for link in unique_links]
return full_urls
# Speicherort für die gescraped Daten
data = []
# Alle Seiten-URLs abrufen
page_urls = get_all_page_urls()
# Diese durchlaufen und die Scraping-Logik anwenden
for url in page_urls:
# Aktuelle Seite scrapen
page_data = scrape_page(url)
# Die gescrapten Daten zur Liste hinzufügen
data.extend(page_data)
# Die extrahierten Daten ausgeben
print("Daten von allen Seiten:")
for entry in data:
print(entry)
```
Sehr gut! Sie haben Ihr erstes Scraping-Projekt mit Parsel abgeschlossen.
## Fortgeschrittene Web-Scraping-Szenarien mit Parsel in Python
Im vorherigen Abschnitt haben Sie gelernt, wie Sie Parsel in Python verwenden, um Daten aus einer Zielwebseite mithilfe von CSS-Selektoren zu extrahieren. Nun ist es an der Zeit, einige fortgeschrittenere Szenarien zu betrachten!
### Elemente anhand von Text auswählen
Parsel bietet verschiedene Abfragemethoden, um den Text aus HTML mithilfe von [XPath](https://parsel.readthedocs.io/en/latest/usage.html#some-xpath-tips) abzurufen. In diesem Fall wird die Funktion `text()` verwendet, um den Textinhalt eines Elements zu extrahieren.
Stellen Sie sich vor, Sie haben folgenden HTML-Code:
```none
Willkommen bei Parsel
Dies ist ein Absatz.
Ein weiterer Absatz.
```
Sie können den gesamten Text wie folgt abrufen:
```none
from parsel import Selector
html = """
Willkommen bei Parsel
Dies ist ein Absatz.
Ein weiterer Absatz.
"""
selector = Selector(text=html)
# Text aus dem -Tag extrahieren
h1_text = selector.xpath("//h1/text()").get()
print("H1-Text:", h1_text)
# Text aus allen
-Tags extrahieren
p_texts = selector.xpath("//p/text()").getall()
print("Absatz-Textknoten:", p_texts)
```
Dieser Ausschnitt lokalisiert die Tags `
` und `
` und extrahiert den Text aus ihnen mit `text()`, was zu folgendem Ergebnis führt:
```none
H1-Text: Willkommen bei Parsel
Absatz-Textknoten: ['Dies ist ein Absatz.', 'Ein weiterer Absatz.']
```
Eine weitere nützliche Funktion ist `contains()`, mit der Elemente gefunden werden können, die einen bestimmten Text enthalten. Angenommen, Sie haben folgenden HTML-Code:
```none
Dies ist ein Testabsatz.
Ein weiterer Testabsatz.
Unabhängiger Inhalt.
```
Sie möchten nun den Text aus den Absätzen extrahieren, die nur das Wort „test“ enthalten. Dazu können Sie den folgenden Code verwenden:
```none
from parsel import Selector
# html = """..."""
selector = Selector(text=html)
# Absätze extrahieren, die das Wort „test” enthalten
test_paragraphs = selector.xpath("//p[contains(text(), 'test')]/text()").getall()
print("Absätze, die 'test' enthalten": test_paragraphs)
```
Der Xpath `p[contains(text(), 'test')]/text()` sorgt dafür, dass nur der Absatz abgefragt wird, der „test“ enthält. Das Ergebnis lautet:
```none
Absätze, die „test” enthalten: ['Dies ist ein Testabsatz.', 'Ein weiterer Testabsatz.']
```
Was aber, wenn Sie den Text abfangen möchten, der mit einem bestimmten Wert einer Zeichenfolge beginnt? Nun, Sie können die Funktion `starts-with()` verwenden! Betrachten Sie diesen HTML-Code:
```none
Start here.
Start again.
End here.
```
Um den Text aus den Absätzen abzurufen, die mit dem Wort „start” beginnen, verwenden Sie `p[starts-with(text(), 'Start')]/text()` wie folgt:
```none
from parsel import Selector
# html = """..."""
selector = Selector(text=html)
# Extrahieren Sie Absätze, deren Text mit „Start” beginnt.
start_paragraphs = selector.xpath("//p[starts-with(text(), 'Start')]/text()").getall()
print("Absätze, die mit 'Start' beginnen": start_paragraphs)
```
Der obige Ausschnitt erzeugt:
```none
Absätze, die mit „Start” beginnen: ['Start here.', 'Start again.']
```
Erfahren Sie mehr über [CSS- und XPath-Selektoren.](/blog/web-data/xpath-vs-css-selectors)
### Verwendung regulärer Ausdrücke
Mit Parsel können Sie Text für erweiterte Bedingungen abrufen, indem Sie [reguläre Ausdrücke](https://parsel.readthedocs.io/en/latest/usage.html#regular-expressions) mit der Funktion `re:test()` verwenden.
Betrachten Sie diesen HTML-Code:
```none
Artikel 12345
Artikel ABCDE
Ein Absatz
2026 ist das aktuelle Jahr
```
Um den Text aus den Absätzen zu extrahieren, die nur numerische Werte enthalten, können Sie `re:test()` wie folgt verwenden:
```none
from parsel import Selector
# html = """..."""
selector = Selector(text=html)
# Extrahieren Sie Absätze, deren Text einem numerischen Muster entspricht.
numeric_items = selector.xpath("//p[re:test(text(), 'd+')]/text()").getall()
print("Numerische Elemente:", numeric_items)
```
Das Ergebnis lautet:
```none
Numerische Elemente: ['Element 12345', '2026 ist das aktuelle Jahr']
```
Eine weitere typische Verwendung von regulären Ausdrücken ist das Abfangen von E-Mail-Adressen. Damit kann Text aus Absätzen extrahiert werden, die nur E-Mail-Adressen enthalten. Betrachten Sie beispielsweise den folgenden HTML-Code:
```none
Kontaktieren Sie uns unter [email protected]
Senden Sie eine E-Mail an [email protected]
Hier keine E-Mail-Adresse.
```
Im Folgenden wird gezeigt, wie Sie mit `re:test()` Knoten auswählen können, die E-Mail-Adressen enthalten:
```none
from parsel import Selector
selector = Selector(text=html)
# Absätze extrahieren, die E-Mail-Adressen enthalten
emails = selector.xpath("//p[re:test(text(), '[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+.[a-zA-Z]{2,}')]/text()").getall()
print("E-Mail-Übereinstimmungen:", emails)
```
Das Ergebnis lautet:
```none
E-Mail-Übereinstimmungen: ['Kontaktieren Sie uns unter [email protected]', 'Senden Sie eine E-Mail an [email protected]']
```
### Navigieren in der HTML-Struktur
Mit Parsel können Sie mit XPath [durch den HTML-Baum navigieren](https://parsel.readthedocs.io/en/latest/parsel.html#module-parsel.csstranslator), egal wie verschachtelt dieser ist.
Betrachten Sie diesen HTML-Code:
```none
```
Sie können alle übergeordneten Elemente des Knotens `` wie folgt abrufen:
```none
from parsel import Selector
selector = Selector(text=html)
# Wählen Sie das übergeordnete Element des
-Tags aus.
parent_of_p = selector.xpath("//p/parent::*").get()
print("Übergeordnetes Element von
:", parent_of_p)
```
Ergebnis:
```none
Übergeordnetes Element von
:
```
Auf ähnliche Weise können Sie auch gleichrangige Elemente verwalten. Angenommen, Sie haben den folgenden HTML-Code:
```none
- Element 1
- Element 2
- Element 3
```
Mit `following-sibling` können Sie Geschwisterknoten wie folgt abrufen:
```none
from parsel import Selector
selector = Selector(text=html)
# Wählen Sie das nächste Geschwisterelement des ersten -Elements aus.
next_sibling = selector.xpath("//li[1]/following-sibling::li[1]/text()").get()
print("Nächstes Geschwisterelement des ersten :", next_sibling)
# Wählen Sie alle Geschwisterelemente des ersten -Elements aus.
all_siblings = selector.xpath("//li[1]/following-sibling::li/text()").getall()
print("Alle Geschwisterelemente des ersten :", all_siblings)
```
Das Ergebnis lautet:
```none
Nächstes Geschwisterelement des ersten : Element 2
Alle Geschwisterelemente des ersten : ['Element 2', 'Element 3']
```
## Parsel-Alternativen für HTML-Parsing in Python
Parsel ist eine der in [Python](/blog/how-tos/web-scraping-with-python) verfügbaren Bibliotheken [für Web-Scraping](/blog/how-tos/web-scraping-with-python), aber es ist nicht die einzige. Nachfolgend finden Sie weitere bekannte und weit verbreitete Bibliotheken:
- [**Beautiful Soup**](https://code.launchpad.net/beautifulsoup): Eine Python-Bibliothek, die das Scraping von Informationen aus Webseiten vereinfacht. In unserem Leitfaden zum [Web-Scraping mit Beautiful Soup](https://code.launchpad.net/beautifulsoup) erfahren Sie, wie Sie diese Bibliothek verwenden können.
- **[`lxml`](https://github.com/lxml/lxml)**: Eine Python-Bindung für die Bibliotheken `libxml2` und `libxslt`. Sehen Sie sich die Funktionsweise in unserem Tutorial zu [lxml für das Parsing von Webdaten](/blog/web-data/lxml-web-scraping) an.
- [**PyQuery**](https://github.com/dsc/pyquery): Eine Bibliothek, mit der Sie jQuery-Abfragen für XML-Dokumente durchführen können. Damit gehört sie zu den [fünf besten Python-HTML-Parsern](/blog/web-data/best-python-html-parsers).
- [**Scrapy**](https://scrapy.org/): Ein Open-Source- und kollaboratives Framework zum Extrahieren der benötigten Daten aus Websites. Erfahren Sie, wie Sie [Scrapy für das Web-Scraping](/blog/how-tos/web-scraping-with-scrapy) verwenden.
- **[`html.parser`](https://docs.python.org/3/library/html.parser.html)**: Ein Modul aus der Python-Standardbibliothek, das eine Klasse für das Parsing von Text-HTML- und XTHML-Inhalten bereitstellt.
- **[`html5-parser`](https://html5-parser.readthedocs.io/en/latest/)**: Eine schnelle Implementierung von HTML 5 in Python.
## Fazit
In diesem Artikel haben Sie etwas über Parsel in Python gelernt und erfahren, wie Sie es für das Web-Scraping verwenden können. Sie haben mit den Grundlagen begonnen und dann komplexere Szenarien erkundet.
Unabhängig davon, welche Python-Scraping-Bibliothek Sie verwenden, besteht die größte Hürde darin, dass die meisten Websites ihre Daten mit Anti-Bot- und Anti-Scraping-Maßnahmen schützen. Diese Abwehrmaßnahmen können automatisierte Anfragen identifizieren und blockieren, wodurch herkömmliche Scraping-Techniken unwirksam werden.
Glücklicherweise bietet Bright Data eine Reihe von Lösungen, um solche Probleme zu vermeiden:
- [**Web Unlocker**](/products/web-unlocker): Eine API, die Anti-Scraping-Schutzmaßnahmen umgeht und mit minimalem Aufwand sauberen HTML-Code von jeder Webseite liefert.
- [**Scraping-Browser**](/products/scraping-browser): Ein cloudbasierter, steuerbarer Browser mit JavaScript-Rendering. Er übernimmt automatisch CAPTCHAs, Browser-Fingerprinting, Wiederholungsversuche und vieles mehr für Sie. Er lässt sich nahtlos in Panther oder Selenium PHP integrieren.
- [**Web Scraper APIs**](/products/web-scraper): Endpunkte für den programmatischen Zugriff auf strukturierte Webdaten aus Dutzenden beliebter Domains.
Sie möchten sich nicht mit Web-Scraping beschäftigen, sind aber dennoch an Online-Daten interessiert? [Entdecken Sie unsere gebrauchsfertigen Datensätze!](/products/datasets)
Melden Sie sich jetzt bei Bright Data an und starten Sie die Gratis-Testversion, um unsere Scraping-Lösungen zu testen.
Vertrieb kontaktierenGratis testen
Inhaltsverzeichnis
Dedicated Scraper APIs & No-Code Scrapers
Over 1000 scrapers for all popular domains. Simplify your web scraping.
[See pricing](/pricing/web-scraper "See pricing")
Just want data? Skip scraping.
Hundreds of ready-to-use datasets from all popular domains.
[See pricing](/pricing/datasets "See pricing")
[ ](https://news.ycombinator.com/submitlink?t=Web-Scraping+mit+Parsel+in+Python%3A+Leitfaden+2026&u=https://brightdata.de/blog/web-data-de/web-scraping-with-parsel) [ ](https://www.linkedin.com/shareArticle?mini=true&title=Web-Scraping+mit+Parsel+in+Python%3A+Leitfaden+2026&url=https://brightdata.de/blog/web-data-de/web-scraping-with-parsel) [ ](http://www.reddit.com/submit?title=Web-Scraping+mit+Parsel+in+Python%3A+Leitfaden+2026&url=https://brightdata.de/blog/web-data-de/web-scraping-with-parsel)
## Das könnte Sie auch interessieren
[  ](https://brightdata.de/blog/ai/openhuman-with-bright-data "Produktionsreifer Web-Zugriff in OpenHuman über die Bright Data CLI")
[AI

Antonello Zanini
Technical Writer
### Produktionsreifer Web-Zugriff in OpenHuman über die Bright Data CLI
Integrieren Sie die Bright Data CLI mit OpenHuman, um produktionsreifen Web-Zugriff und Datenerhebung für KI-Agenten zu ermöglichen.
09-Sep-2026
12 min lesen
](https://brightdata.de/blog/ai/openhuman-with-bright-data)
[  ](https://brightdata.de/blog/web-data-de/multimodal-web-scraping-with-minimax "Multimodales Web-Scraping mit MiniMax")
[Web Data

Antonello Zanini
Technical Writer
### Multimodales Web-Scraping mit MiniMax
Kombinieren Sie Bright Data Web Unlocker mit MiniMax M3 Vision, um strukturierte Daten aus Bildern und Webseiten-Screenshots zu extrahieren.
09-Sep-2026
4 min lesen
](https://brightdata.de/blog/web-data-de/multimodal-web-scraping-with-minimax)
[  ](https://brightdata.de/blog/ai/best-cli-tools-for-codex "Die 10 besten CLI-Tools für Codex im Jahr 2026 – Getestet & Bewertet")
[AI

Daniel Shashko
Web Data & AI Expert
### Die 10 besten CLI-Tools für Codex im Jahr 2026 – Getestet & Bewertet
Die 10 CLI-Tools, die Codex schneller und leistungsfähiger machen, beginnend mit dem Bright Data CLI für echten Web-Zugriff aus der Sandbox heraus.
06-Sep-2026
20 min lesen
](https://brightdata.de/blog/ai/best-cli-tools-for-codex)