---
title: "Scrapy vs. Requests: Was eignet sich besser für das Web-Scraping?"
slug: scrapy-vs-requests
date: 2026-02-16T08:04:49+00:00
modified: 2026-04-27T09:04:03+00:00
permalink: https://brightdata.de/blog/web-data-de/scrapy-vs-requests
type: blog
---
[ Blog ](https://brightdata.de/blog "Blog") / [Web Data](https://brightdata.de/blog/web-data-de)
[Web Data](https://brightdata.de/blog/web-data-de)
# Scrapy vs. Requests: Was eignet sich besser für das Web-Scraping?
Vergleichen Sie Scrapy und Requests für das Web-Scraping, um das für Ihre Anforderungen am besten geeignete Tool zu finden.
16 min lesen
[  ](https://brightdata.com/blog/authors/federico-trotta)
[Federico Trotta
Technical Writer
](https://brightdata.com/blog/authors/federico-trotta)

In diesem Leitfaden zu Scrapy vs. Requests erfahren Sie:
- Was Scrapy und Requests sind
- Ein Vergleich zwischen Scrapy und Requests für das Web-Scraping
- Einen Vergleich zwischen Scrapy und Requests in einem Paginierungsszenario
- Häufige Einschränkungen von Scrapy und Requests in Web-Scraping-Szenarien
Lassen Sie uns eintauchen!
## Was ist Requests?
[Requests](https://pypi.org/project/requests/)ist eine Python-Bibliothek zum Senden von HTTP-Anfragen. Sie wird häufig beim Web-Scraping verwendet, in der Regel in Verbindung mit HTML-Parsing-Bibliotheken wie[BeautifulSoup](https://pypi.org/project/beautifulsoup4/).
Zu den wichtigsten Funktionen von Requests für das Web-Scraping gehören:
- **Unterstützung für HTTP-Methoden**: Sie können alle wichtigen HTTP-Methoden wie`GET`,`POST`,`PUT`,`PATCH` und`DELETE` verwenden, die für die Interaktion mit Webseiten und APIs unerlässlich sind.
- **Benutzerdefinierte Header**: Legen Sie benutzerdefinierte Header (z. B.[`User-Agent`und andere](/blog/web-data/http-headers-for-web-scraping)) fest, um einen echten Browser nachzuahmen oder die Basisauthentifizierung zu verarbeiten.
- **Sitzungsverwaltung**: Mit dem Objekt`requests.Session()`können Sie Cookies und Header über mehrere Anfragen hinweg beibehalten. Dies ist nützlich für das Scraping von Websites, die eine Anmeldung erfordern oder den Sitzungsstatus beibehalten müssen.
- **Timeouts und Fehlerbehandlung**: Sie können Timeouts festlegen, um hängende Anfragen zu vermeiden, und Ausnahmen für ein robustes Scraping behandeln.
- **Proxy-Unterstützung**: Sie können Ihre Anfragen über Proxys leiten, was hilfreich ist, um IP-Sperren zu umgehen und auf geografisch eingeschränkte Inhalte zuzugreifen.
## Was ist Scrapy?
[Scrapy](https://scrapy.org/)ist ein Open-Source-Web-Scraping-Framework, das in Python geschrieben ist. Es wurde entwickelt, um Daten aus Websites auf schnelle, effiziente und skalierbare Weise zu extrahieren.
Scrapy bietet ein komplettes Framework zum Crawlen von Websites, zum Extrahieren von Daten und zum Speichern dieser Daten in verschiedenen Formaten (z. B. JSON, CSV usw.). Es ist besonders nützlich für groß angelegte Web-Scraping-Projekte, da es komplexe Crawling-Aufgaben und gleichzeitige Anfragen unter Einhaltung der Crawling-Regeln bewältigen kann.
Zu den wichtigsten Funktionen von Scrapy für das Web-Scraping gehören:
- **Integriertes Web-Crawling**: Scrapy ist als[Web-Crawler](/blog/web-data/what-is-a-web-crawler) konzipiert. Das bedeutet, dass es automatisch Links auf einer Webseite verfolgen kann, sodass Sie mit minimalem Aufwand mehrere Seiten oder ganze Websites scrapen können.
- **Asynchrone Anfragen**: Es verwendet eine asynchrone Architektur, um mehrere Anfragen gleichzeitig zu bearbeiten. Dadurch ist es viel schneller als[Python-HTTP-Clients](/blog/web-data/best-python-http-clients)wie`Requests`.
- **Selektoren für die Datenextraktion**: Scrapy bietet die Möglichkeit, Daten aus HTML mithilfe von XPaths und CSS-Selektoren zu extrahieren.
- **Middleware zur Anpassung**: Es unterstützt Middleware, um die Verarbeitung von Anfragen und Antworten anzupassen.
- **Automatische Drosselung**: Es kann Anfragen automatisch drosseln, um eine Überlastung des Zielservers zu vermeiden. Das bedeutet, dass es die Crawling-Geschwindigkeit basierend auf den Antwortzeiten und der Auslastung des Servers anpassen kann.
- **Umgang mit`robots.txt`**: Es respektiert die[`robots.txt-Datei`für das Web-Scraping](/blog/how-tos/robots-txt-for-web-scraping-guide) und stellt sicher, dass Ihre Scraping-Aktivitäten den Regeln der Website entsprechen.
- **Proxy- und User-Agent-Rotation**: Scrapy unterstützt[Proxy-Rotation](/solutions/rotating-proxies)und[`User-Agent`-Rotation](/blog/how-tos/user-agents-for-web-scraping-101)über Middlewares, wodurch IP-Sperren und -Erkennung vermieden werden können.
## Scrapy vs. Requests: Funktionsvergleich für das Web-Scraping
Nachdem Sie nun gelernt haben, was Requests und Scrapy sind, ist es an der Zeit, ihre Verwendung für das Web-Scraping eingehend zu vergleichen:
**Funktion****Scrapy****Requests****Anwendungsfall**Groß angelegte und komplexe Scraping-ProjekteEinfachere Web-Scraping-Aufgaben und Prototypen**Asynchrone Anfragen**Integrierte Unterstützung für asynchrone AnfragenKeine integrierte Unterstützung**Crawling**Folgt automatisch Links und crawlt mehrere SeitenManuelle Implementierung für Crawling erforderlich**Datenextraktion**Integrierte Unterstützung für XPath- und CSS-SelektorenErfordert externe Bibliotheken zur Verwaltung der Datenextraktion**Parallelität**Verarbeitet mehrere Anfragen gleichzeitig ohne zusätzliche AnpassungenErfordert externe Integrationen zur Verwaltung von Parallelitätsanfragen**Middleware**Anpassbare Middleware für die Verwaltung von Proxys, Wiederholungsversuchen und HeadernKeine integrierte Middleware**Drosselung**Integrierte automatische Drosselung zur Vermeidung von ServerüberlastungenKeine integrierte Drosselung**Proxy-Rotation**Unterstützt Proxy-Rotation über MiddlewareMuss manuell implementiert werden**Fehlerbehandlung**Integrierte Wiederholungsmechanismen für fehlgeschlagene AnfragenErfordert manuelle Implementierung**Datei-Downloads**Unterstützt Datei-Downloads, erfordert jedoch zusätzliche EinrichtungEinfache und unkomplizierte Unterstützung für Dateidownloads### Anwendungsfälle
Scrapy ist ein vollwertiges Web-Scraping-Framework für große und komplexe Scraping-Projekte. Es eignet sich ideal für Aufgaben, die das Crawlen mehrerer Seiten, gleichzeitige Anfragen und den Datenexport in strukturierten Formaten umfassen.
Requests hingegen ist eine Bibliothek, die HHTP-Anfragen verwaltet. Daher eignet sie sich besser für einfache Aufgaben wie das Abrufen einer einzelnen Webseite, die Interaktion mit APIs oder das Herunterladen von Dateien.
### Asynchrone Anfragen und Parallelität
Scrapy basiert auf[Twisted](https://docs.scrapy.org/en/latest/topics/architecture.html#event-driven-networking), einem ereignisgesteuerten Netzwerk-Framework für Python. Das bedeutet, dass es asynchrone und mehrere Anfragen gleichzeitig verarbeiten kann, was es für groß angelegtes Scraping viel schneller macht.
Requests hingegen unterstützt asynchrone oder parallele Anfragen nicht nativ. Wenn Sie asynchrone HTTP-Anfragen stellen möchten, können Sie es mit[GRequests](https://github.com/spyoungtech/grequests) integrieren.
### Crawling
Wenn die Einstellung[`ROBOTSTXT_OBEY`](https://docs.scrapy.org/en/latest/topics/settings.html#robotstxt-obey)auf`„True”` gesetzt ist, liest Scrapy die Datei`robots.txt`, folgt automatisch den zulässigen Links auf einer Webseite und crawlt die zulässigen Seiten.
Requests verfügt über keine integrierten Crawling-Funktionen, sodass Sie Links manuell definieren und zusätzliche Anfragen stellen müssen.
### Datenextraktion
Scrapy bietet integrierte Unterstützung für die Datenextraktion mit[XPath- und CSS-Selektoren](/blog/web-data/xpath-vs-css-selectors), wodurch das Parsing von HTML und XML vereinfacht wird.
Requests verfügt über keine Funktionen zur Datenextraktion. Sie müssen externe Bibliotheken wie[BeautifulSoup zum Parsing und Extrahieren von Daten](/blog/how-tos/beautiful-soup-web-scraping) verwenden.
### Middleware
Scrapy bietet anpassbare Middlewares für die Verarbeitung von[Proxys](https://docs.scrapy.org/en/2.11/_modules/scrapy/downloadermiddlewares/httpproxy.html),[Wiederholungsversuchen](https://docs.scrapy.org/en/2.11/_modules/scrapy/downloadermiddlewares/retry.html),[Headern](https://docs.scrapy.org/en/2.11/_modules/scrapy/downloadermiddlewares/defaultheaders.html) und mehr. Dadurch ist es für fortgeschrittene Scraping-Aufgaben sehr gut erweiterbar.
Requests bietet hingegen keine Middleware-Unterstützung, sodass Sie Funktionen wie[Proxy-Rotation](/blog/proxy-101/proxy-with-python-requests)oder Wiederholungsversuche manuell implementieren müssen.
### Drosselung
Scrapy verfügt über eine integrierte automatische Drosselungsfunktion, mit der die Crawling-Geschwindigkeit basierend auf den Antwortzeiten und der Auslastung des Servers angepasst werden kann. Auf diese Weise können Sie vermeiden, dass der Zielserver mit HTTP-Anfragen überflutet wird.
Requests verfügt über keine integrierte Drosselungsfunktion. Wenn Sie eine Drosselung implementieren möchten, müssen Sie manuell Verzögerungen zwischen den Anfragen hinzufügen, beispielsweise mit der Methode `time.sleep()`.
### Proxy-Rotation
Scrapy unterstützt die Proxy-Rotation über Middlewares, wodurch IP-Sperren leicht vermieden und Websites anonym gecrawlt werden können.
Requests bietet keine integrierte Funktion für die Proxy-Rotation. Wenn Sie Proxys mit`Requests` verwalten möchten, müssen Sie Proxys manuell konfigurieren und benutzerdefinierte Logik schreiben,[wie in unserer Anleitung erläutert](/blog/how-tos/python-ip-rotation).
### Fehlerbehandlung
Scrapy enthält integrierte Wiederholungsmechanismen für[fehlgeschlagene Anfragen](https://docs.scrapy.org/en/2.10/_modules/scrapy/downloadermiddlewares/retry.html), wodurch es robust im Umgang mit Netzwerkfehlern oder Serverproblemen ist.
Im Gegensatz dazu müssen Sie bei Requests Fehler und Ausnahmen manuell behandeln, beispielsweise mithilfe des[`try-except-Blocks`](https://docs.python.org/3/tutorial/errors.html#handling-exceptions). Ziehen Sie auch Bibliotheken wie[`retry-requests`](https://pypi.org/project/retry-requests/) in Betracht.
### Datei-Downloads
Scrapy unterstützt Dateidownloads über die[`FilesPipeline`](https://docs.scrapy.org/en/latest/topics/media-pipeline.html), erfordert jedoch zusätzliche Einstellungen für die Verarbeitung großer Dateien oder Streaming.
Requests bietet eine einfache und unkomplizierte Unterstützung für Dateidownloads mit dem Parameter `stream=True` in der Methode `requests.get()`.
## Scrapy vs. Requests: Vergleich der beiden Bibliotheken anhand eines Paginierungsszenarios
Sie wissen nun, was Requests und Scrapy sind. Machen Sie sich bereit für einen schrittweisen Tutorial-Vergleich für ein bestimmtes Web-Scraping-Szenario!
Der Schwerpunkt liegt auf dem Vergleich dieser beiden Bibliotheken in einem Paginierungsszenario.[Die Handhabung der Paginierung beim Web-Scraping](/blog/web-data/pagination-web-scraping)erfordert eine benutzerdefinierte Logik für das Verfolgen von Links und die Datenextraktion auf mehreren Seiten.
Die Zielseite ist[Quotes to Scrape](https://quotes.toscrape.com/), die Zitate berühmter Autoren auf verschiedenen Seiten bereitstellt:
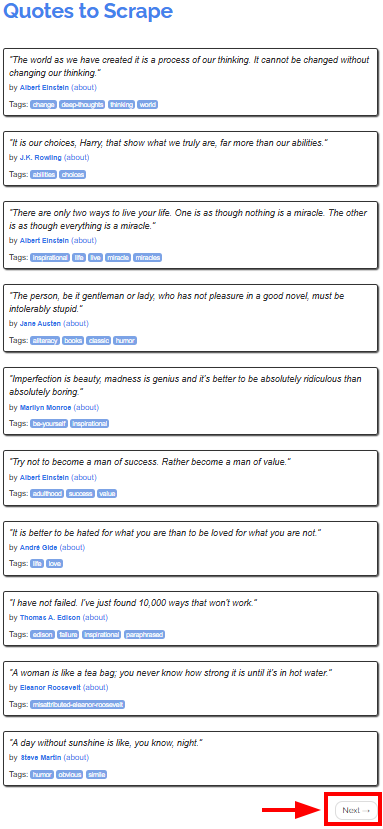Das Ziel des Tutorials ist es, zu zeigen, wie man mit Scrapy und Requests die Zitate von allen Seiten abruft. Wir beginnen mit Requests, da dessen Verwendung möglicherweise komplexer ist als die von Scrapy.
### Voraussetzungen
Um die Tutorials für Scrapy und Requests nachzuvollziehen, muss[Python 3.7 oder höher](https://www.python.org/downloads/)auf Ihrem Rechner installiert sein.
## Verwendung von Requests für das Web-Scraping
In diesem Kapitel lernen Sie, wie Sie mit Requests alle Zitate von der Zielseite scrapen können.
Beachten Sie, dass Sie Requests nicht allein verwenden können, um Daten direkt von Webseiten zu scrapen. Sie benötigen außerdem einen[HTML-Parser wie BeautifulSoup](/blog/web-data/best-html-parsers).
### Schritt 1: Einrichten der Umgebung und Installieren der Abhängigkeiten
Angenommen, Sie nennen den Hauptordner Ihres Projekts `requests_scraper/.` Am Ende dieses Schritts hat der Ordner die folgende Struktur:
```none
requests_scraper/
├── requests_scraper.py
└── venv/
```
Dabei ist
- `requests_scraper.py`die Python-Datei ist, die den gesamten Code enthält
- `venv/`die virtuelle Umgebung enthält
Sie können das Verzeichnis`venv/`für[die virtuelle Umgebung](https://docs.python.org/3/library/venv.html)wie folgt erstellen:
```none
python -m venv venv
```
Um sie zu aktivieren, führen Sie unter Windows Folgendes aus:
```none
venvScriptsactivate
```
Entsprechend führen Sie unter macOS und Linux Folgendes aus:
```none
source venv/bin/activate
```
Jetzt können Sie die erforderlichen Bibliotheken installieren mit:
```none
pip install requests beautifulsoup4
```
### Schritt 2: Einrichten der Variablen
Sie können nun damit beginnen, Code in die Datei `requests_scraper.py` zu schreiben.
Richten Sie zunächst die Variablen wie folgt ein:
```none
base_url = "https://quotes.toscrape.com"
all_quotes = []
```
Hier haben Sie Folgendes definiert:
- `base_url`als Start-URL der Website, die gecrawlt werden soll
- `all_quotes`als leere Liste, in der alle gescrapten Angebote gespeichert werden
### Schritt 3: Erstellen Sie die Scraping-Logik
Sie können die Scraping- und Crawling-Logik mit dem folgenden Code implementieren:
```none
url = base_url
while url:
# Senden Sie eine GET-Anfrage an die aktuelle Seite.
response = requests.get(url)
# Analysieren Sie den HTML-Code der Seite.
soup = BeautifulSoup(response.text, "html.parser")
# Finden Sie alle Zitatblöcke
quotes = soup.select(".quote")
for quote in quotes:
text = quote.select_one(".text").get_text(strip=True)
author = quote.select_one(".author").get_text(strip=True)
tags = [tag.get_text(strip=True) for tag in quote.select(".tag")]
all_quotes.append({
"text": text,
"author": author,
"tags": ",".join(tags)
})
# Nach der Schaltfläche „Weiter” suchen
next_button = soup.select_one("li.next")
if next_button:
# Extrahieren Sie die URL aus der Schaltfläche „Weiter“ und
# legen Sie sie als nächste zu scrapend Seite fest.
next_page = next_button.select_one("a")["href"]
url = base_url + next_page
else:
url = None
```
Dieser Code:
- Instanziiert eine`while`-Schleife, die so lange ausgeführt wird, bis alle Seiten gescrapt sind
- Unter der`while`-Schleife:
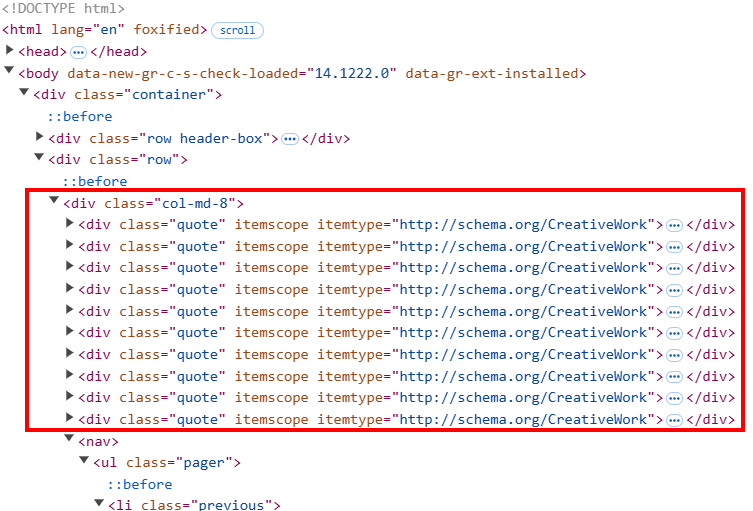
- `soup.``select``()`fängt alle HTML-Elemente mit Zitaten auf der Seite ab. Der HTML-Code der Seite ist so strukturiert, dass jedes Zitat-Element eine Klasse namens`„quote“` hat.
- Der`for-`Zyklus durchläuft alle`quote`-Klassen, um den Text, den Autor und die Tags aus den Zitaten mit den Scraping-Methoden von Beautiful Soup zu extrahieren. Hier benötigen Sie eine benutzerdefinierte Logik für Tags, da jedes quote-Element mehr als ein Tag enthalten kann.
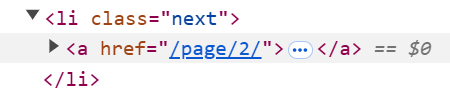
- Nach dem Scraping der gesamten Seite sucht das Skript nach der Schaltfläche`„Weiter`”. Wenn die Schaltfläche vorhanden ist, extrahiert es den Link zur nächsten Seite. Anschließend wird die Basis-URL über die Variable`url = base_url + next_page` auf die nächste URL aktualisiert. Wenn der Prozess die letzte Seite erreicht, wird die nächste URL auf`„None”` gesetzt und der Prozess beendet.
### Schritt 4: Anhängen der Daten an eine CSV-Datei
Nachdem Sie nun alle Daten gescrapt haben, können Sie sie wie folgt an eine CSV-Datei anhängen:
```none
with open("quotes.csv", mode="w", newline="", encoding="utf-8") as file:
writer = csv.DictWriter(file, fieldnames=["text", "author", "tags"])
writer.writeheader()
writer.writerows(all_quotes)
```
Dieser Teil des Skripts verwendet die[`CSV`](https://docs.python.org/3/library/csv.html)-Bibliothek, um:
- Den Namen der CSV-Ausgabedatei als`quotes.csv` festzulegen.
- Öffnen der CSV-Datei im Schreibmodus (`mode="w"`) und:
- Schreibt die Kopfzeile in die CSV-Datei
- Schreibt alle gescrapten Zitate in die Datei
### Schritt 5: Alles zusammenfügen
Dies ist der gesamte Code für diesen Teil des Tutorials zu Scrapy vs. Requests:
```none
import requests
from bs4 import BeautifulSoup
import csv
# URL der Website
base_url = "https://quotes.toscrape.com"
# Liste zum Speichern aller Zitate
all_quotes = []
# Beginne mit dem Scraping auf der ersten Seite
url = base_url
while url:
# Sende eine GET-Anfrage an die aktuelle Seite
response = requests.get(url)
# Parse den HTML-Code der Seite
soup = BeautifulSoup(response.text, "html.parser")
# Alle Zitatblöcke finden
quotes = soup.select(".quote")
for quote in quotes:
text = quote.select_one(".text").get_text(strip=True)
author = quote.select_one(".author").get_text(strip=True)
tags = [tag.get_text(strip=True) for tag in quote.select(".tag")]
all_quotes.append({
"text": text,
"author": author,
"tags": ",".join(tags)
})
# Nach der Schaltfläche „Weiter” suchen
next_button = soup.select_one("li.next")
if next_button:
# URL aus der Schaltfläche „Weiter“ extrahieren und
# als nächste zu scrapend Seite festlegen
next_page = next_button.select_one("a")["href"]
url = base_url + next_page
else:
url = None
# Speichern Sie die Zitate in einer CSV-Datei
with open("quotes.csv", mode="w", newline="", encoding="utf-8") as file:
writer = csv.DictWriter(file, fieldnames=["text", "author", "tags"])
writer.writeheader()
writer.writerows(all_quotes)
```
Führen Sie das obige Skript aus:
```none
python requests_scraper.py
```
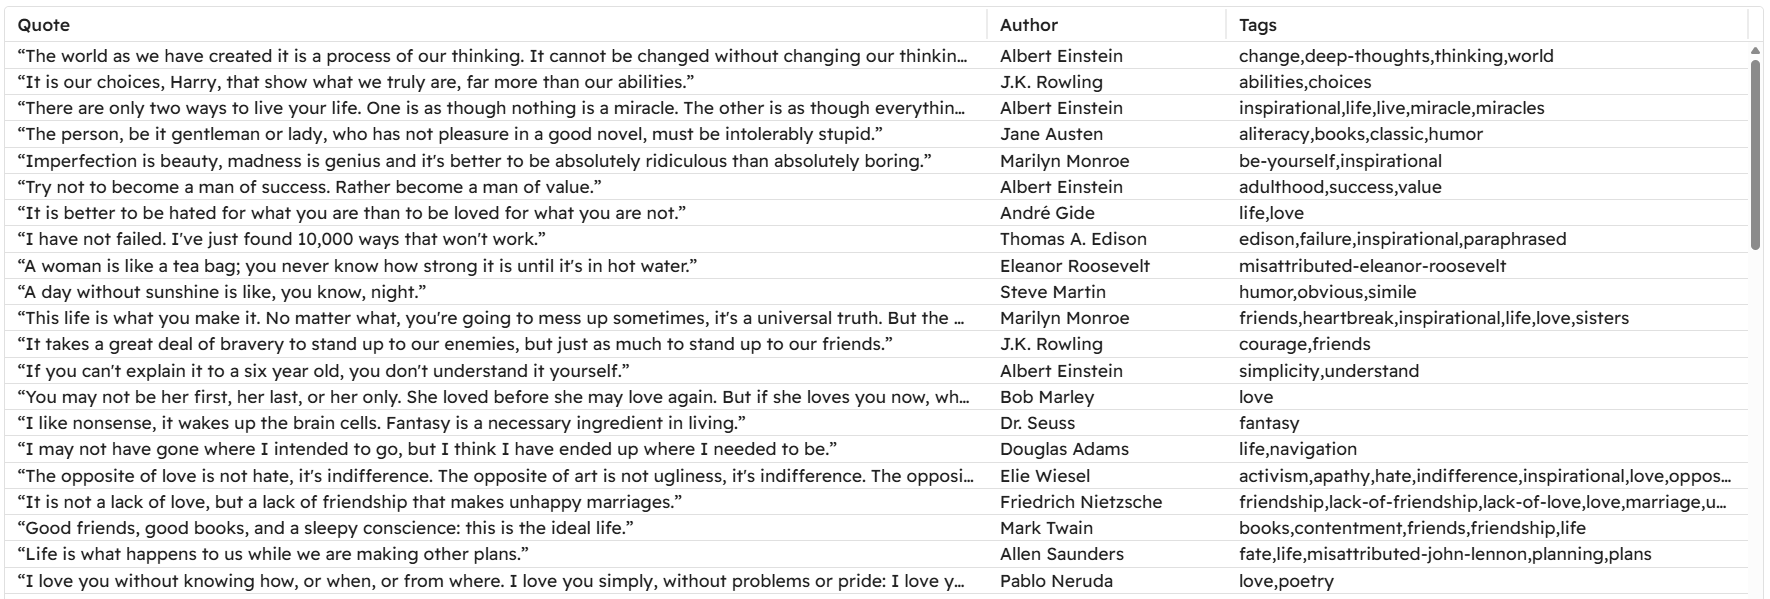
Eine Datei namens`quotes.csv`wird im Projektordner angezeigt:
## So verwenden Sie Scrapy für das Web-Scraping
Nachdem Sie nun gelernt haben, wie Sie Requests für das Web-Scraping verwenden, können Sie sich ansehen, wie Sie Scrapy mit derselben Zielseite und demselben Ziel verwenden.
### Schritt 1: Einrichten der Umgebung und Installieren der Abhängigkeiten
Angenommen, Sie möchten den Hauptordner Ihres Projekts `scrapy_scraper/` aufrufen `.`
Erstellen und aktivieren Sie zunächst eine virtuelle Umgebung wie zuvor gezeigt und installieren Sie Scrapy:
```none
pip install scrapy
```
Starten Sie Scrapy, um den Hauptordner mit vordefinierten Dateien in `quotes_scraper/` zu füllen, mit:
```none
scrapy startproject quotes_scraper
```
Dies ist die resultierende Struktur Ihres Projekts:
```none
scrapy_scraper/
├── quotes_scraper/ # Hauptordner des Scrapy-Projekts
│ ├── __init__.py
│ ├── items.py # Definiert die Datenstruktur für gescrapte Elemente
│ ├── middlewares.py # Benutzerdefinierte Middlewares
│ ├── pipelines.py # Verarbeitet die Nachbearbeitung der gescrapten Daten
│ ├── settings.py # Projekteinstellungen
│ └── spiders/ # Ordner für alle Spider
├── venv/
└── scrapy.cfg # Scrapy-Konfigurationsdatei
```
### Schritt 2: Definieren Sie die Elemente
Die Datei `items.py` definiert die Struktur der Daten, die Sie scrapen möchten. Da Sie die Zitate, Autoren und Tags abrufen möchten, definieren Sie diese wie folgt:
```none
import scrapy
class QuotesScraperItem(scrapy.Item):
quote = scrapy.Field()
author = scrapy.Field()
tags = scrapy.Field()
```
### Schritt 3: Definieren Sie den Haupt-Spider
Erstellen Sie im Ordner `spiders/` die folgenden Python-Dateien:
- `__init__.py`, die das Verzeichnis als Python-Paket kennzeichnet
- `quotes_spider.py`
Die Datei `quotes_spider.py` enthält die eigentliche Scraping-Logik:
```none
import scrapy
from scrapy.linkextractors import LinkExtractor
from scrapy.spiders import CrawlSpider, Rule
from ..items import QuotesScraperItem
class QuotesSpider(CrawlSpider):
name = "quotes"
allowed_domains = ["quotes.toscrape.com"]
start_urls = ["https://quotes.toscrape.com/"]
# Regeln für das Folgen von Paginierungslinks definieren
rules = (
Rule(LinkExtractor(restrict_css="li.next a"), callback="parse_item", follow=True),
)
def parse_item(self, response):
# Zitate, Autoren und Tags extrahieren
for quote in response.css("div.quote"):
item = QuotesScraperItem()
item["quote"] = quote.css("span.text::text").get()
item["author"] = quote.css("small.author::text").get()
item["tags"] = quote.css("div.tags a.tag::text").getall()
yield item
```
Der obige Ausschnitt definiert die Klasse `QuotesSpider()`, die Folgendes tut:
- Definiert die zu scrapend URL.
- Definiert die Regel für die Paginierung mit der Klasse`Rule()`, sodass der Crawler alle folgenden Seiten verfolgen kann.
- Extrahiert das Zitat, den Autor und das Tag mit der Methode`parse_item()`.
### Schritt 4: Definieren Sie die Einstellungen
Das Anhängen der Daten an eine CSV-Datei erfordert einige spezielle Konfigurationen in Scrapy. Öffnen Sie dazu die Datei `settings.py` und fügen Sie die folgenden Variablen zur Datei hinzu:
```none
FEED_FORMAT = "csv"
FEED_URI = "quotes.csv"
```
Diese Einstellungen haben folgende Funktionen:
- `FEED_FORMAT`definiert das Ausgabeformat der Datei ([das verschiedene Typen haben kann](https://docs.scrapy.org/en/latest/topics/feed-exports.html#topics-feed-format-csv)).
- `FEED_URI`definiert den Namen der Ausgabedatei
### Schritt 5: Crawler ausführen
Die Python-Dateien, die in den vorherigen Schritten nicht erwähnt wurden, sind für dieses Tutorial nicht relevant, sodass Sie sie mit den Standarddaten belassen können.
Um den Crawler zu starten, gehen Sie in den Ordner `quotes_scraper/`:
```none
cd quotes_scraper
```
Führen Sie dann den Crawler aus:
```none
scrapy crawl quotes
```
Dieser Befehl instanziiert die Klasse `QuotesSpider()` in der Datei `quotes_spider.py`, die den Crawler startet. Die endgültige CSV-Datei, die Sie erhalten, ist identisch mit der, die Sie mit Requests und BeautifulSoup erhalten haben!
Dieses Beispiel zeigt also:
- Wie Scrapy aufgrund seiner Eigenschaften besser für große Projekte geeignet ist.
- Wie die Verwaltung der Paginierung mit Scrapy einfacher ist, da Sie nur eine Regel verwalten müssen, anstatt wie im vorherigen Fall eine benutzerdefinierte Logik zu schreiben.
- Wie das Anhängen von Daten an eine CSV-Datei mit Scrapy einfacher ist. Das liegt daran, dass Sie nur zwei Einstellungen hinzufügen müssen, anstatt die klassische benutzerdefinierte Logik zu erstellen, die Sie beim Schreiben eines Python-Skripts erstellen würden, das dies tut.
## Gemeinsame Einschränkungen von Scrapy und Requests
Obwohl Scrapy und Requests in Web-Scraping-Projekten weit verbreitet sind, haben sie auch einige Nachteile.
Im Einzelnen ist eine der allgemeinen Einschränkungen, denen jede Scraping-Bibliothek oder jedes Scraping-Framework unterliegt,[die IP-Sperre](/blog/proxy-101/how-to-bypass-an-ip-ban). Sie haben gelernt, dass Scrapy eine Drosselung bietet, mit der Sie die Geschwindigkeit anpassen können, mit der der Server angefordert wird. Dennoch reicht dies oft nicht aus, um zu verhindern, dass Ihre IP gesperrt wird.
Die Lösung, um zu verhindern, dass Ihre IP gesperrt wird, besteht darin, Proxys in Ihren Code zu implementieren. Schauen wir uns an, wie das geht!
### Verwendung von Proxys mit Requests
Wenn Sie einen einzelnen Proxy in Requests verwenden möchten, verwenden Sie die folgende Logik:
```none
Proxy = {
"http": "",
"https": ""
}
response = requests.get(url, proxies=Proxy)
```
Weitere Informationen zu Proxys und Rotierenden Proxys in `Requests` finden Sie in diesen Anleitungen in unserem Blog:
- [Anleitung zur Verwendung eines Proxys mit Python Requests](/blog/proxy-101/proxy-with-python-requests)
- [Verwendung von Proxys zur Rotation von IP-Adressen in Python](/blog/how-tos/python-ip-rotation)
### Verwendung von Proxys in Scrapy
Wenn Sie einen einzelnen Proxy in Ihren Code implementieren möchten, fügen Sie die folgenden Einstellungen zur Datei `settings.py` hinzu:
```none
# Einen einzelnen Proxy konfigurieren
HTTP_PROXY = ""
# HttpProxyMiddleware aktivieren und die standardmäßige UserAgentMiddleware deaktivieren
DOWNLOADER_MIDDLEWARES = {
'scrapy.downloadermiddlewares.httpproxy.HttpProxyMiddleware': 110,
'scrapy.downloadermiddlewares.useragent.UserAgentMiddleware': None,
}
```
Mit diesen Einstellungen werden alle Anfragen über den angegebenen Proxy geleitet. Weitere Informationen finden Sie in unserem[Leitfaden zur Scrapy-Proxy-Integration](/integration/scrapy).
Wenn Sie stattdessen rotierende Proxys implementieren möchten, können Sie die[Bibliothek`scrapy-rotating-proxies`](https://pypi.org/project/scrapy-rotating-proxies/) verwenden. Ebenso können Sie einen automatisch rotierenden Residential-Proxy verwenden.
Wenn Sie auf der Suche nach zuverlässigen Proxys sind, denken Sie daran, dass das Proxy-Netzwerk von Bright Data von Fortune-500-Unternehmen und über 20.000 Kunden weltweit geschätzt wird. Dieses umfangreiche Netzwerk umfasst:
- [**Residential-Proxys**](/proxy-types/residential-proxies): Über 72 Millionen Residential-IPs in mehr als 195 Ländern.
- [**Datacenter-Proxys**](/proxy-types/datacenter-proxies): Über 770.000 Datacenter-IPs.
- [**ISP-Proxys**](/proxy-types/isp-proxies): Über 700.000 ISP-IPs.
- [**Mobile-Proxy**](/proxy-types): Über 7 Millionen mobile IPs.
## Fazit
In diesem Blogbeitrag zum Vergleich von Scrapy und Requests haben Sie mehr über die Rolle der beiden Bibliotheken beim Web-Scraping erfahren. Sie haben ihre Funktionen für das Abrufen von Seiten und die Datenextraktion kennengelernt und ihre Leistung in einem realistischen Szenario mit Seitenumbruch verglichen.
Requests erfordert mehr manuelle Logik, bietet jedoch größere Flexibilität für benutzerdefinierte Anwendungsfälle, während Scrapy etwas weniger anpassungsfähig ist, aber die meisten Tools bereitstellt, die für strukturiertes Scraping erforderlich sind.
Sie haben auch ihre Einschränkungen entdeckt, wie z. B. potenzielle [IP-Sperren](/blog/proxy-101/how-to-bypass-an-ip-ban) und Probleme mit geografisch eingeschränkten Inhalten. Glücklicherweise lassen sich diese Herausforderungen[mit Proxys](/proxy-types)oder speziellen Web-Scraping-Lösungen wie[den Web Scrapers](/products/web-scraper) von Bright Data überwinden.
Die Scrapers lassen sich nahtlos in Scrapy und Requests integrieren, sodass Sie öffentliche Daten von großen Websites ohne Einschränkungen extrahieren können.
Erstellen Sie noch heute ein kostenloses Bright Data-Konto, um unsere Proxy- und Scraper-APIs zu erkunden und gratis zu testen!
Vertrieb kontaktierenGratis testen
Inhaltsverzeichnis
Dedicated Scraper APIs & No-Code Scrapers
Over 1000 scrapers for all popular domains. Simplify your web scraping.
[See pricing](/pricing/web-scraper "See pricing")
Just want data? Skip scraping.
Hundreds of ready-to-use datasets from all popular domains.
[See pricing](/pricing/datasets "See pricing")
[ ](https://news.ycombinator.com/submitlink?t=Scrapy+vs.+Requests%3A+Was+eignet+sich+besser+f%C3%BCr+das+Web-Scraping%3F&u=https://brightdata.de/blog/web-data-de/scrapy-vs-requests) [ ](https://www.linkedin.com/shareArticle?mini=true&title=Scrapy+vs.+Requests%3A+Was+eignet+sich+besser+f%C3%BCr+das+Web-Scraping%3F&url=https://brightdata.de/blog/web-data-de/scrapy-vs-requests) [ ](http://www.reddit.com/submit?title=Scrapy+vs.+Requests%3A+Was+eignet+sich+besser+f%C3%BCr+das+Web-Scraping%3F&url=https://brightdata.de/blog/web-data-de/scrapy-vs-requests)
## Das könnte Sie auch interessieren
[  ](https://brightdata.de/blog/ai/openhuman-with-bright-data "Produktionsreifer Web-Zugriff in OpenHuman über die Bright Data CLI")
[AI

Antonello Zanini
Technical Writer
### Produktionsreifer Web-Zugriff in OpenHuman über die Bright Data CLI
Integrieren Sie die Bright Data CLI mit OpenHuman, um produktionsreifen Web-Zugriff und Datenerhebung für KI-Agenten zu ermöglichen.
09-Sep-2026
12 min lesen
](https://brightdata.de/blog/ai/openhuman-with-bright-data)
[  ](https://brightdata.de/blog/web-data-de/multimodal-web-scraping-with-minimax "Multimodales Web-Scraping mit MiniMax")
[Web Data

Antonello Zanini
Technical Writer
### Multimodales Web-Scraping mit MiniMax
Kombinieren Sie Bright Data Web Unlocker mit MiniMax M3 Vision, um strukturierte Daten aus Bildern und Webseiten-Screenshots zu extrahieren.
09-Sep-2026
4 min lesen
](https://brightdata.de/blog/web-data-de/multimodal-web-scraping-with-minimax)
[  ](https://brightdata.de/blog/ai/best-cli-tools-for-codex "Die 10 besten CLI-Tools für Codex im Jahr 2026 – Getestet & Bewertet")
[AI

Daniel Shashko
Web Data & AI Expert
### Die 10 besten CLI-Tools für Codex im Jahr 2026 – Getestet & Bewertet
Die 10 CLI-Tools, die Codex schneller und leistungsfähiger machen, beginnend mit dem Bright Data CLI für echten Web-Zugriff aus der Sandbox heraus.
06-Sep-2026
20 min lesen
](https://brightdata.de/blog/ai/best-cli-tools-for-codex)