---
title: "Wie man Alibaba mit Python im Jahr 2026 scrapt"
slug: how-to-scrape-alibaba
date: 2026-02-23T09:53:02+00:00
modified: 2026-02-23T09:53:03+00:00
permalink: https://brightdata.de/blog/web-data-de/how-to-scrape-alibaba
type: blog
---
[ Blog ](https://brightdata.de/blog "Blog") / [Web Data](https://brightdata.de/blog/web-data-de)
[Web Data](https://brightdata.de/blog/web-data-de)
# Wie man Alibaba mit Python im Jahr 2026 scrapt
Erfahren Sie, wie Sie einen Python-basierten Alibaba-Scraper erstellen, um Produktdetails, Preise und mehr zu extrahieren. Perfekt für die effiziente Automatisierung der Datenerfassung.
9 min lesen
[  ](https://brightdata.com/blog/authors/antonello-zanini)
[Antonello Zanini
Technical Writer
](https://brightdata.com/blog/authors/antonello-zanini)
In diesem Leitfaden erfahren Sie:
- Was ein Alibaba-Scraper ist und wie er funktioniert
- Welche Arten von Daten Sie automatisch von Alibaba abrufen können
- Wie Sie mit Python ein Alibaba-Scraping-Skript erstellen
Lassen Sie uns loslegen!
## Was ist ein Alibaba-Scraper?
Ein [Alibaba-Scraper](/products/web-scraper/alibaba) ist ein[Web-Scraping-Bot](/blog/how-tos/what-is-a-scraping-bot), der automatisch Daten aus den Seiten von Alibaba extrahiert. Er simuliert das Surfverhalten eines Benutzers, um durch die Seiten von Alibaba zu navigieren. Er verarbeitet Interaktionen wie Paginierung und ruft strukturierte Informationen wie Produktdetails, Preise und Unternehmensdaten ab.
## Daten, die Sie von Alibaba scrapen können
Alibaba ist eine Fundgrube für wertvolle Informationen, wie zum Beispiel:
- **Produktdetails**: Namen, Beschreibungen, Bilder, Preisklassen, Verkäuferinformationen und mehr.
- **Unternehmensinformationen**: Firmennamen, Herstellerangaben, Kontaktinformationen und Bewertungen.
- **Kundenfeedback**: Bewertungen, Produktrezensionen und mehr.
- **Logistik und Verfügbarkeit**: Lagerbestand, Mindestbestellmengen, Versandoptionen und mehr.
- **Kategorien und Tags**: Produktkategorien, relevante Tags oder Labels.
Erfahren Sie, wie Sie diese Daten extrahieren können!
## Alibaba in Python scrapen: Schritt-für-Schritt-Anleitung
In diesem Abschnitt lernen Sie in einem geführten Tutorial, wie Sie einen Alibaba-Scraper erstellen.
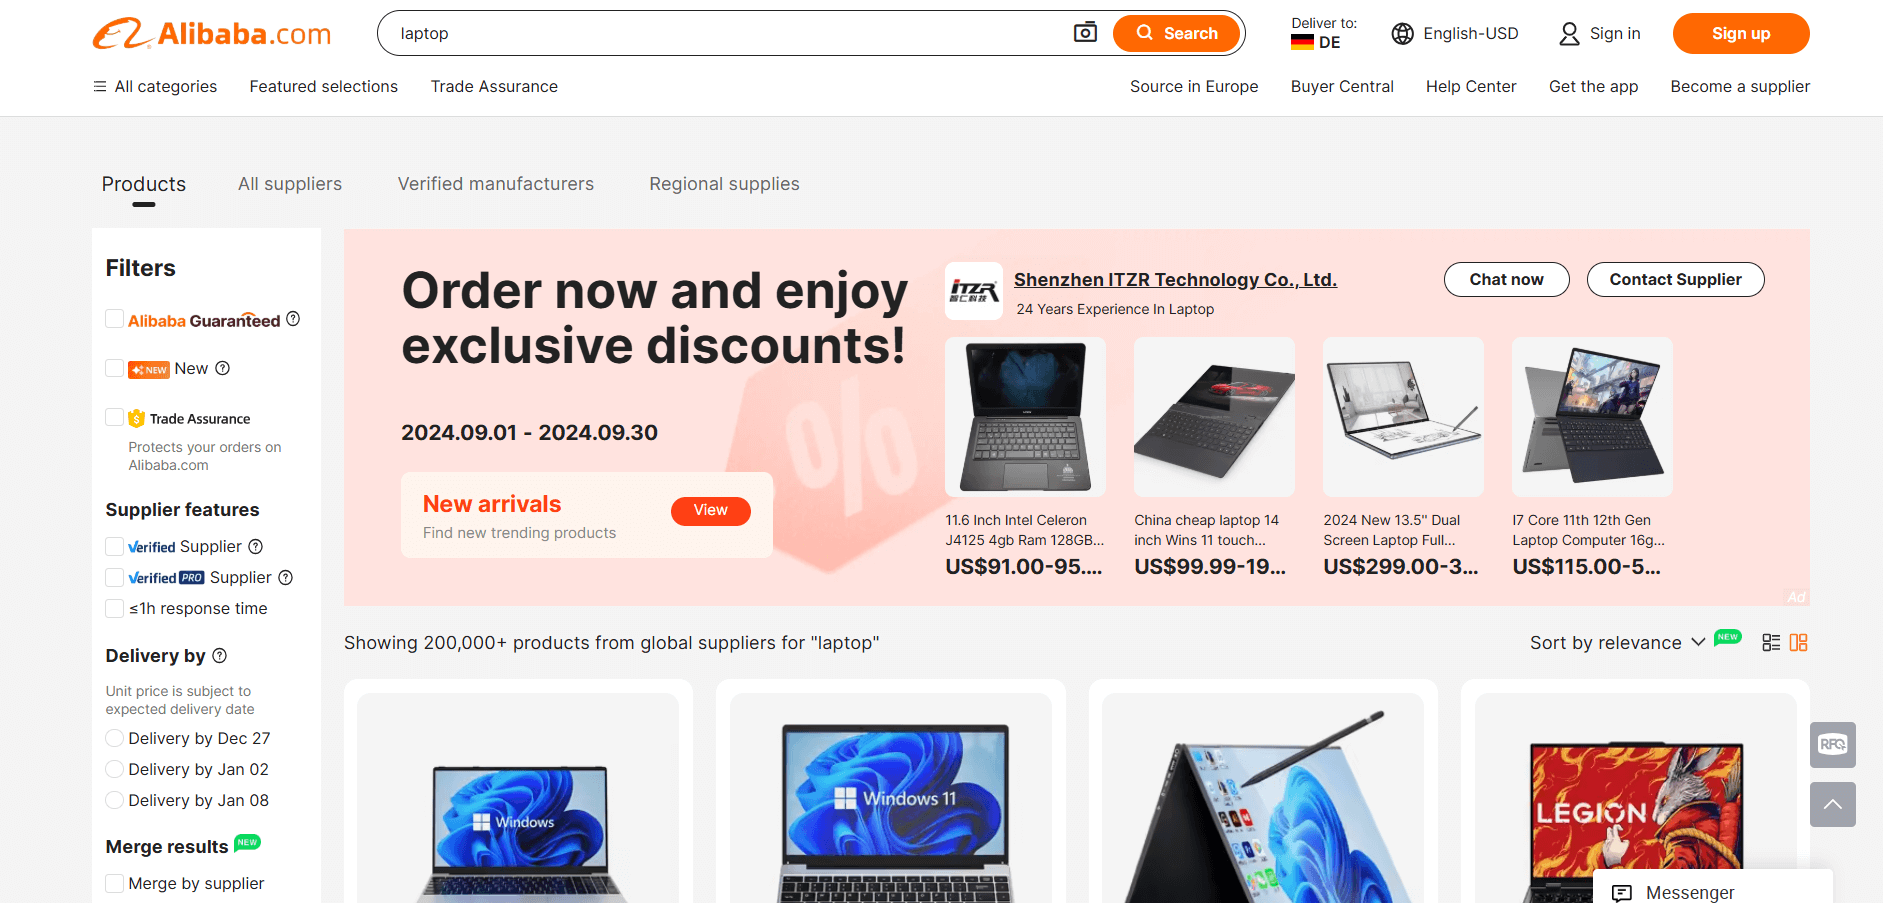
Das Ziel ist es, Sie durch die Erstellung eines Python-Skripts zu führen, das automatisch Daten aus der Alibaba-Seite „Laptop” extrahiert:
Sind Sie bereit? Befolgen Sie die folgenden Schritte!
### Schritt 1: Projekt einrichten
Vergewissern Sie sich zunächst, dass Python 3 auf Ihrem Rechner installiert ist. Ist dies nicht der Fall, [laden Sie es herunter](https://www.python.org/downloads/) und folgen Sie den Anweisungen des Installationsassistenten.
Erstellen Sie nun mit dem folgenden Befehl ein Verzeichnis für Ihr Projekt:
```none
mkdir alibaba-scraper
```
Der Ordner `„alibaba-scraper”` ist der Speicherort für den Python-Alibaba-Scraper.
Geben Sie ihn in das Terminal ein und erstellen Sie darin eine [virtuelle Umgebung](https://docs.python.org/3/library/venv.html):
```none
cd alibaba-Scraper
python -m venv env
```
Laden Sie den Projektordner in Ihre bevorzugte Python-IDE, z. B. [Visual Studio Code mit der Python-Erweiterung](https://code.visualstudio.com/docs/languages/python) oder [PyCharm Community Edition](https://www.jetbrains.com/pycharm/download/#section=windows).
Erstellen Sie eine Datei `scraper.py` im Projektverzeichnis, das nun folgende Dateistruktur aufweisen sollte:
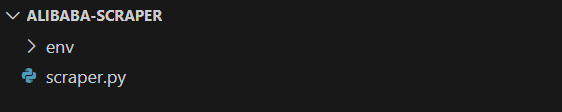`scraper.py` ist derzeit ein leeres Python-Skript, wird aber bald die gewünschte Scraping-Logik enthalten.
Aktivieren Sie die virtuelle Umgebung im Terminal der IDE. Führen Sie unter Linux oder macOS diesen Befehl aus:
```none
./env/bin/activate
```
Unter Windows führen Sie stattdessen folgenden Befehl aus:
```none
env/Scripts/activate
```
Großartig, Ihre Python-Umgebung für das Web-Scraping von Alibaba ist bereit!
### Schritt 2: Wählen Sie die Scraping-Bibliothek aus
Das Ziel ist nun, festzustellen, ob Alibaba dynamische oder statische Seiten verwendet. Öffnen Sie dazu die [Alibaba-Zielseite](https://www.alibaba.com/trade/search?spm=a2700.product_home_newuser.home_new_user_first_screen_fy23_pc_search_bar.keydown__Enter&tab=all&SearchText=laptop) in Ihrem Browser im Inkognito-Modus. Klicken Sie dann mit der rechten Maustaste auf den Hintergrund, wählen Sie „Untersuchen“, gehen Sie zur Registerkarte „Netzwerk“, filtern Sie nach „Fetch/XHR“ und laden Sie die Seite neu:
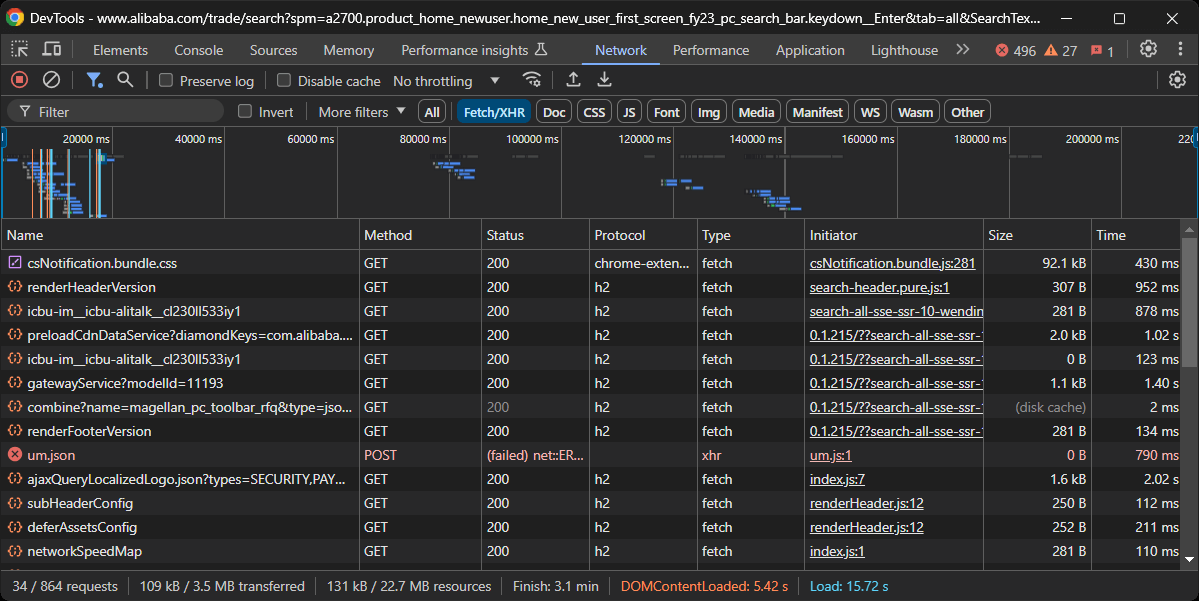Beobachten Sie in diesem Abschnitt der DevTools, ob die Seite signifikante dynamische Anfragen stellt. In diesem Fall ist dies der Fall, was darauf hindeutet, dass die Seite dynamisch ist. Eine weitere Analyse zeigt, dass die Seite JavaScript für das Rendering verwendet.
Mit anderen Worten: Sie benötigen ein Browser-Automatisierungstool wie [Selenium](https://www.selenium.dev/), um Alibaba effektiv zu scrapen. Weitere Informationen finden Sie in unserem Tutorial zum [Selenium-Web-Scraping](/blog/how-tos/using-selenium-for-web-scraping).
Mit Selenium können Sie einen Webbrowser programmgesteuert steuern, Benutzerinteraktionen simulieren und von JavaScript gerenderte Inhalte scrapen. Installieren Sie es und legen Sie los!
### Schritt 3: Selenium installieren und konfigurieren
Installieren Sie Selenium in einer aktivierten virtuellen Umgebung mit diesem Befehl:
```none
pip install -U selenium
```
Importieren Sie Selenium in `scraper.py` und erstellen Sie ein `WebDriver` -Objekt:
```none
from selenium import webdriver
from selenium.webdriver.chrome.service import Service
# Initialisieren einer Chrome-Webtreiberinstanz
driver = webdriver.Chrome(service=Service())
```
Der obige Code initialisiert eine [`WebDriver-Instanz`](https://selenium-python.readthedocs.io/api.html#module-selenium.webdriver.chrome.webdriver) zur Steuerung einer Chrome-Instanz. Beachten Sie, dass Alibaba einige Anti-Scraping-Maßnahmen eingerichtet hat, die Headless-Browser blockieren können.
Daher sollten Sie das Flag [`--headless`](https://developer.chrome.com/docs/chromium/headless) nicht setzen. Als alternative Lösung sollten Sie [Playwright Stealth](/blog/how-tos/avoid-bot-detection-with-playwright-stealth) in Betracht ziehen.
Denken Sie daran, den Webtreiber als letzte Zeile Ihres Scrapers zu schließen:
```none
driver.quit()
```
Großartig! Sie sind nun vollständig konfiguriert, um mit dem Scraping von Alibaba zu beginnen.
### Schritt 4: Verbindung zur Zielseite herstellen
Verwenden Sie die vom Selenium `WebDriver` -Objekt bereitgestellte [`get()`](https://selenium-python.readthedocs.io/api.html#selenium.webdriver.remote.webdriver.WebDriver.get) -Methode, um die gewünschte Seite aufzurufen:
```none
url = "https://www.alibaba.com/trade/search?spm=a2700.product_home_newuser.home_new_user_first_screen_fy23_pc_search_bar.keydown__Enter&tab=all&SearchText=laptop"
driver.get(url)
```
Die Datei `scraper.py` enthält nun folgende Codezeilen:
```none
from selenium import webdriver
from selenium.webdriver.chrome.service import Service
# Initialisieren einer Chrome-Webtreiberinstanz
driver = webdriver.Chrome(service=Service())
# die URL der Zielseite
url = "https://www.alibaba.com/trade/search?spm=a2700.product_home_newuser.home_new_user_first_screen_fy23_pc_search_bar.keydown__Enter&tab=all&SearchText=laptop"
# Verbindung zur Zielseite herstellen
driver.get(url)
# Scraping-Logik...
# Browser schließen
driver.quit()
```
Setzen Sie einen Debugging-Haltepunkt in die letzte Zeile und starten Sie das Skript mit dem Debugger. Folgendes sollte nun angezeigt werden:
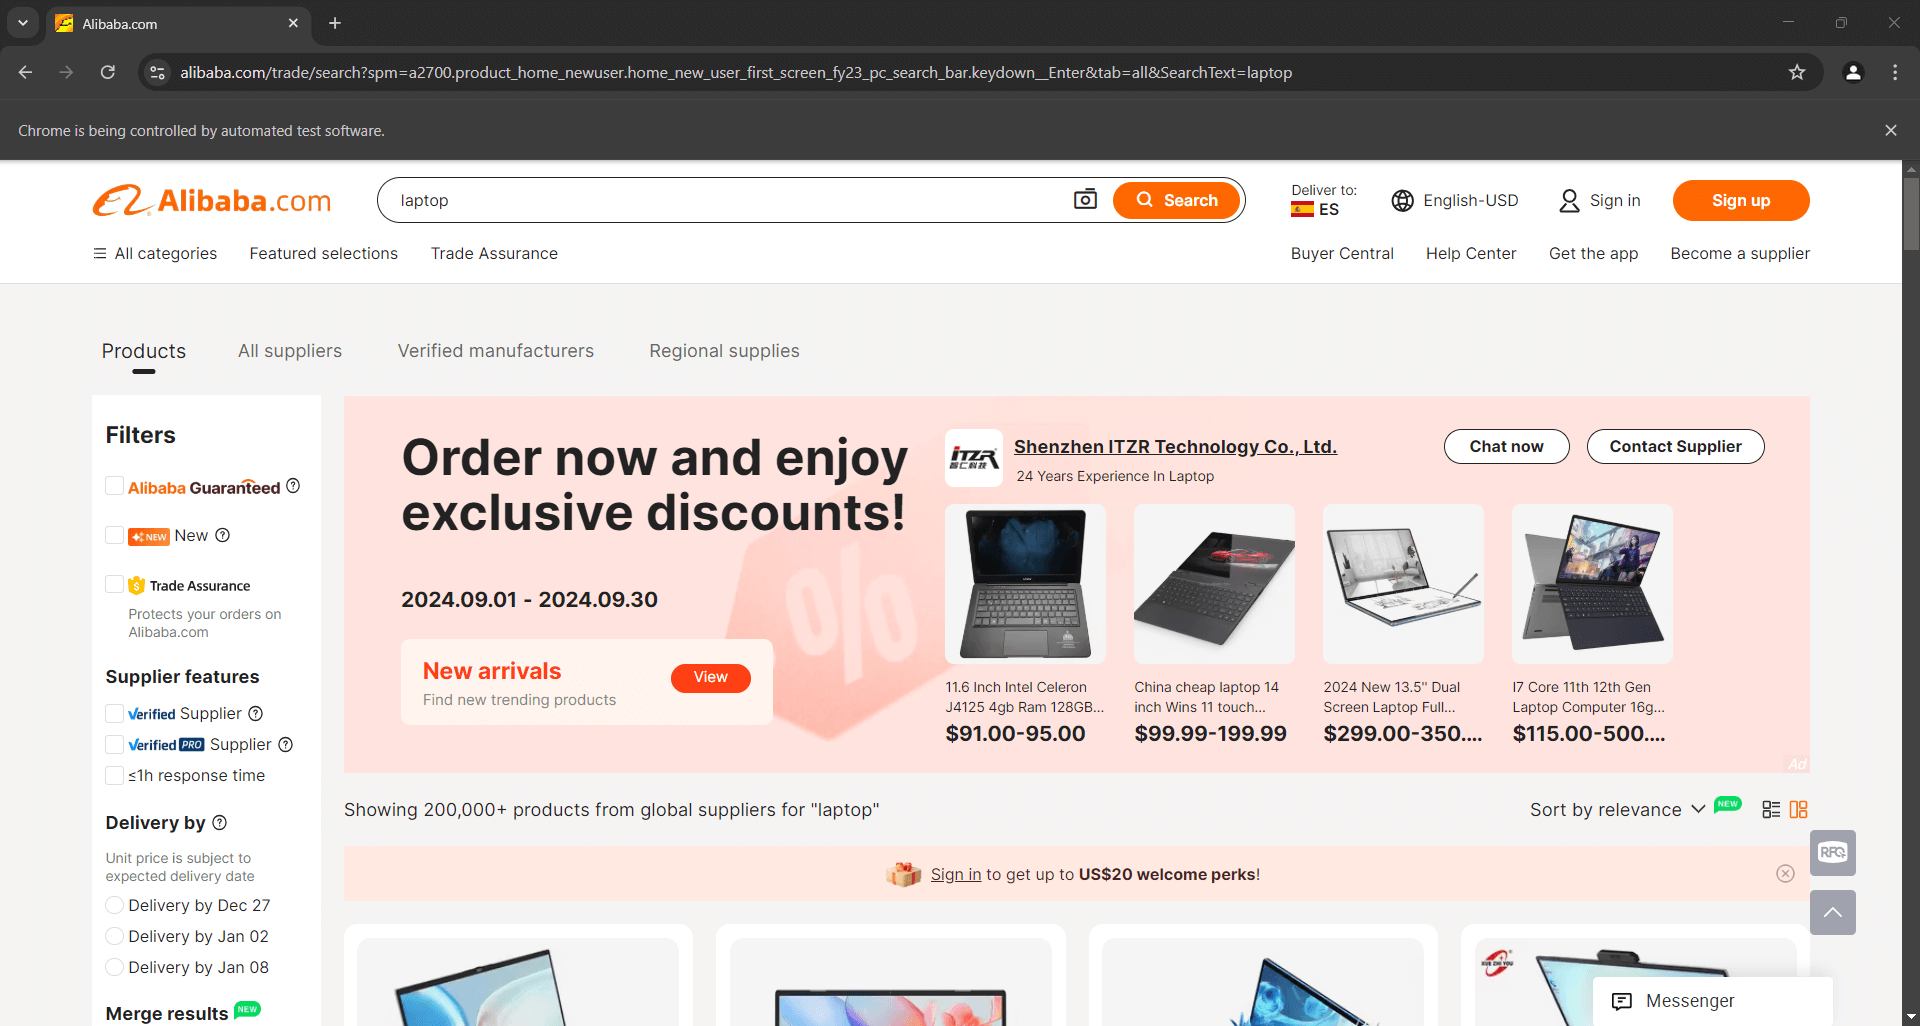Die Meldung „Chrome wird von einer automatisierten Testsoftware gesteuert“ bestätigt, dass Selenium Chrome wie erwartet steuert. Gut gemacht!
### Schritt 5: Wählen Sie die Produktelemente aus
Da die Alibaba-Produktseite mehrere Produkte enthält, müssen Sie zunächst eine Datenstruktur initialisieren, um die gescraped Daten zu speichern. Ein Array eignet sich perfekt für diesen Zweck:
```none
products = []
```
Untersuchen Sie als Nächstes die HTML-Elemente der Produkte auf der Seite, um zu verstehen:
1. Wie Sie sie auswählen können
2. Welche Daten sie enthalten
3. Wie man diese Daten extrahiert
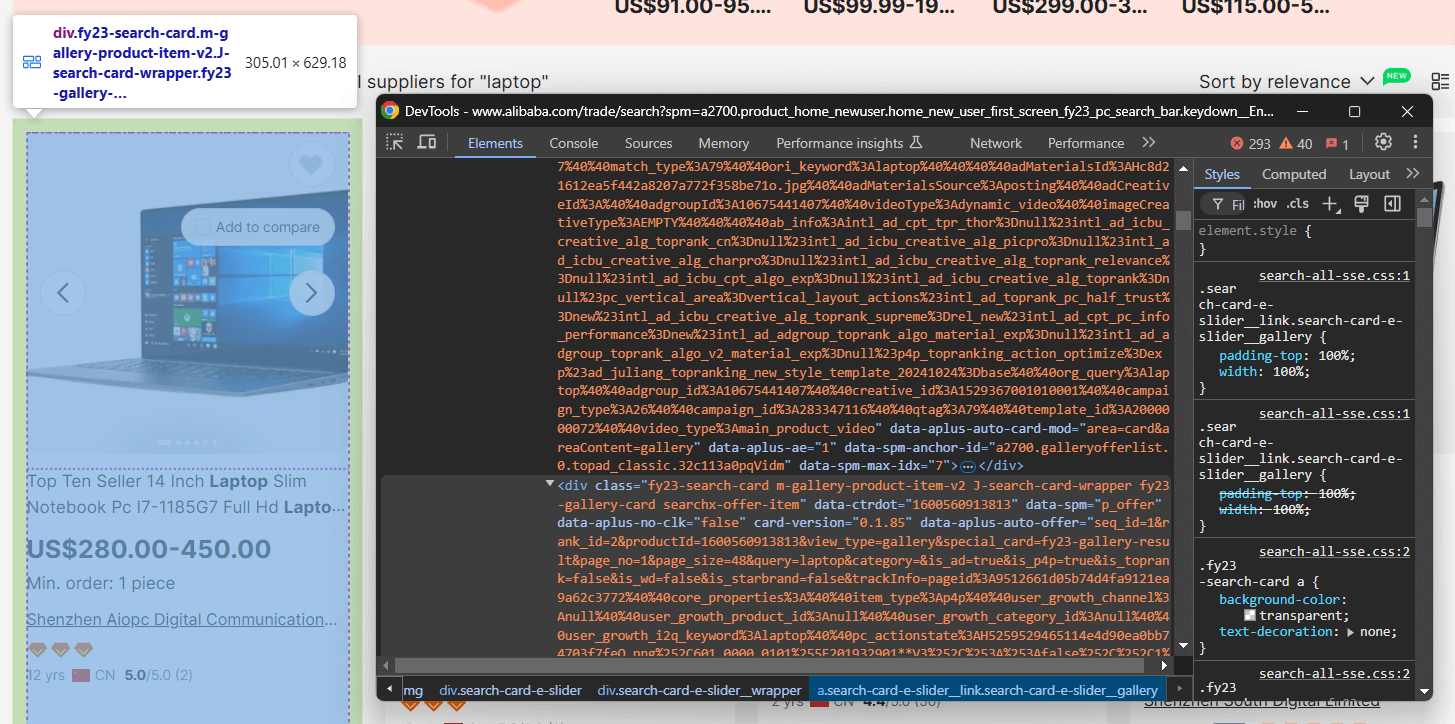Hier sehen Sie, dass jedes Produktelement ein `.m-gallery-product-item-v2` -Knoten ist.
Verwenden Sie Selenium, um alle Produktelemente auszuwählen:
```none
product_elements = driver.find_elements(By.CSS_SELECTOR, ".m-gallery-product-item-v2")
```
`find_elements()` wendet die angegebene Selektorstrategie an, um Elemente auf der Seite abzurufen. Im obigen Fall handelt es sich bei der Selektorstrategie um einen [CSS-Selektor](https://developer.mozilla.org/en-US/docs/Web/CSS/CSS_selectors).
Vergessen Sie nicht, `By` zu importieren:
```none
from selenium.webdriver.common.by import By
```
Durchlaufen Sie die ausgewählten Elemente und bereiten Sie sich darauf vor, Daten aus jedem einzelnen Element zu extrahieren:
```none
for product_element in product_elements:
# Daten aus jedem Produktelement extrahieren
```
Großartig! Sie sind dem erfolgreichen Scraping von Alibaba einen Schritt näher gekommen.
### Schritt 6: Extrahieren Sie die Produktelemente
Untersuchen Sie ein Produktelement, um seine HTML-Struktur zu verstehen:
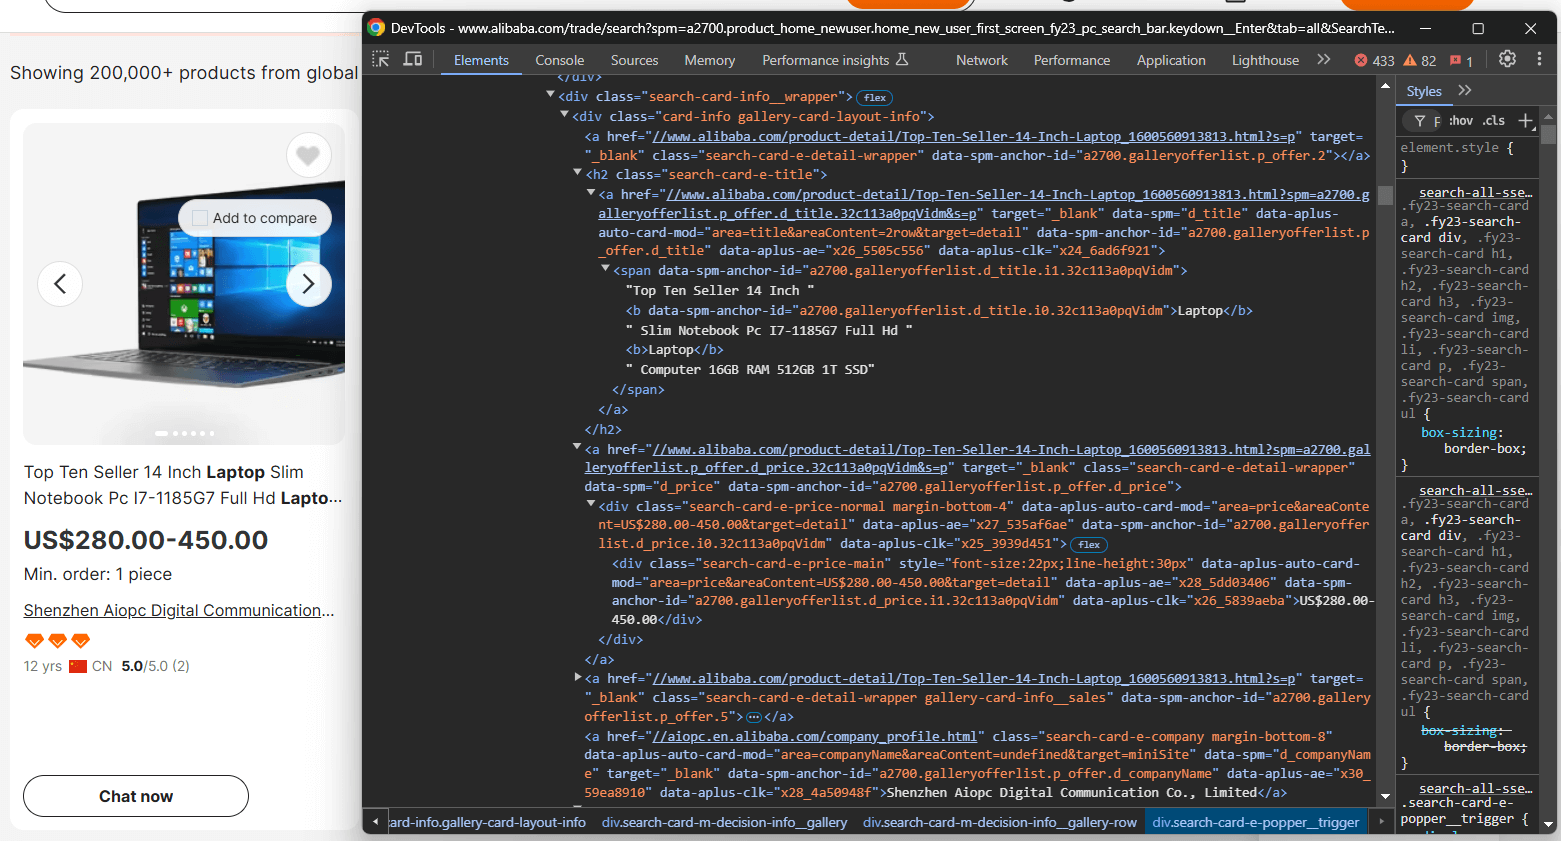Hier sehen Sie, dass Sie Folgendes extrahieren können:
- Das Produktbild aus `.search-card-e-slider__img`
- Die Produktbeschreibung aus `.search-card-e-title`
- Die Produktpreisspanne aus `.search-card-e-price-main`
- Das Unternehmen/den Hersteller aus `.search-card-e-company`
Übersetzen Sie diese Informationen in der `for` -Schleife in eine Scraping-Logik:
```none
img_element = product_element.find_element(By.CSS_SELECTOR,".search-card-e-slider__img")
img = img_element.get_attribute("src")
description_element = product_element.find_element(By.CSS_SELECTOR,".search-card-e-title")
description = description_element.text.strip()
price_element = product_element.find_element(By.CSS_SELECTOR,".search-card-e-price-main")
price = price_element.text.strip()
company_element = product_element.find_element(By.CSS_SELECTOR,".search-card-e-company")
company = company_element.text.strip()
```
`find_element()` ruft das einzige Element ab, das dem angegebenen CSS-Selektor entspricht. Anschließend können Sie mit dem `Textattribut` auf dessen Textinhalt zugreifen. Um den Wert des HTML-Attributs eines Knotens zu erhalten, verwenden Sie die Methode `get_attribute()`.
Verwenden Sie die gescrapten Daten, um ein Produktwörterbuch zu füllen und es zum Array `„products”` hinzuzufügen:
```none
product = {
"img": img,
"description": description,
"price": price,
"company": company
}
products.append(product)
```
Fantastisch! Die Logik zur Datenextraktion aus Alibaba ist fertig.
### Schritt 7: Exportieren Sie die gescrapten Daten in eine CSV-Datei
Derzeit sind Ihre gescraped Daten im Array `„products”` gespeichert. Um sie zugänglich zu machen und mit anderen teilen zu können, müssen Sie sie in ein für Menschen lesbares Format wie eine CSV-Datei exportieren.
Verwenden Sie den folgenden Code, um eine CSV-Datei mit den gescrapten Daten zu erstellen und zu füllen:
```none
csv_file_name = "products.csv"
with open(csv_file_name, mode="w", newline="", encoding="utf-8") as csv_file:
writer = csv.DictWriter(csv_file, fieldnames=["image", "description", "price", "company"])
# Header-Zeile schreiben
writer.writeheader()
# Produktdatenzeilen schreiben
for product in products:
writer.writerow(product)
```
Vergessen Sie nicht, [`csv`](https://docs.python.org/3/library/csv.html) aus der Python-Standardbibliothek zu importieren:
```none
import csv
```
Wow! Ihr Aliaba-Scraper ist fertig.
### Schritt 8: Alles zusammenfügen
Nachfolgend finden Sie den endgültigen Code Ihres Alibaba-Scraping-Skripts:
```none
from selenium import webdriver
from selenium.webdriver.chrome.service import Service
from selenium.webdriver.common.by import By
import csv
# Initialisieren Sie eine Chrome-Webtreiberinstanz.
driver = webdriver.Chrome(service=Service())
# die URL der Zielseite
url = "https://www.alibaba.com/trade/search?spm=a2700.product_home_newuser.home_new_user_first_screen_fy23_pc_search_bar.keydown__Enter&tab=all&SearchText=laptop"
# Verbindung zur Zielseite herstellen
driver.get(url)
# Speicherort für die gesammelten Daten
products = []
# Alle Produktelemente auf der Seite auswählen
product_elements = driver.find_elements(By.CSS_SELECTOR, ".m-gallery-product-item-v2")
# Produktknoten durchlaufen und Daten daraus sammeln
for product_element in product_elements:
# Produktdetails extrahieren
img_element = product_element.find_element(By.CSS_SELECTOR,".search-card-e-slider__img")
img = img_element.get_attribute("src")
description_element = product_element.find_element(By.CSS_SELECTOR,".search-card-e-title")
description = description_element.text.strip()
price_element = product_element.find_element(By.CSS_SELECTOR,".search-card-e-price-main")
price = price_element.text.strip()
company_element = product_element.find_element(By.CSS_SELECTOR,".search-card-e-company")
company = company_element.text.strip()
# Erstellen Sie ein Produktwörterbuch mit den
# gescrapten Daten.
product = {
"img": img,
"description": description,
"price": price,
"company": company
}
# Füge die Produktdaten zum Array hinzu
products.append(product)
# Definiere den Namen der CSV-Ausgabedatei
csv_file_name = "products.csv"
# Öffne die Datei im Schreibmodus und erstelle einen CSV-Writer
with open(csv_file_name, mode="w", newline="", encoding="utf-8") as csv_file:
writer = csv.DictWriter(csv_file, fieldnames=["img", "description", "price", "company"])
# Header-Zeile schreiben
writer.writeheader()
# Produktdatenzeilen schreiben
for product in products:
writer.writerow(product)
# Browser schließen
driver.quit()
```
Mit nur etwas mehr als 60 Zeilen Code haben Sie gerade einen Alibaba-Scraper in Python erstellt!
Starten Sie den Scraper mit dem folgenden Befehl:
```none
python3 script.py
```
Oder unter Windows:
```none
python script.py
```
Eine Datei namens `products.csv` wird im Ordner Ihres Projekts angezeigt. Öffnen Sie sie und Sie sehen:
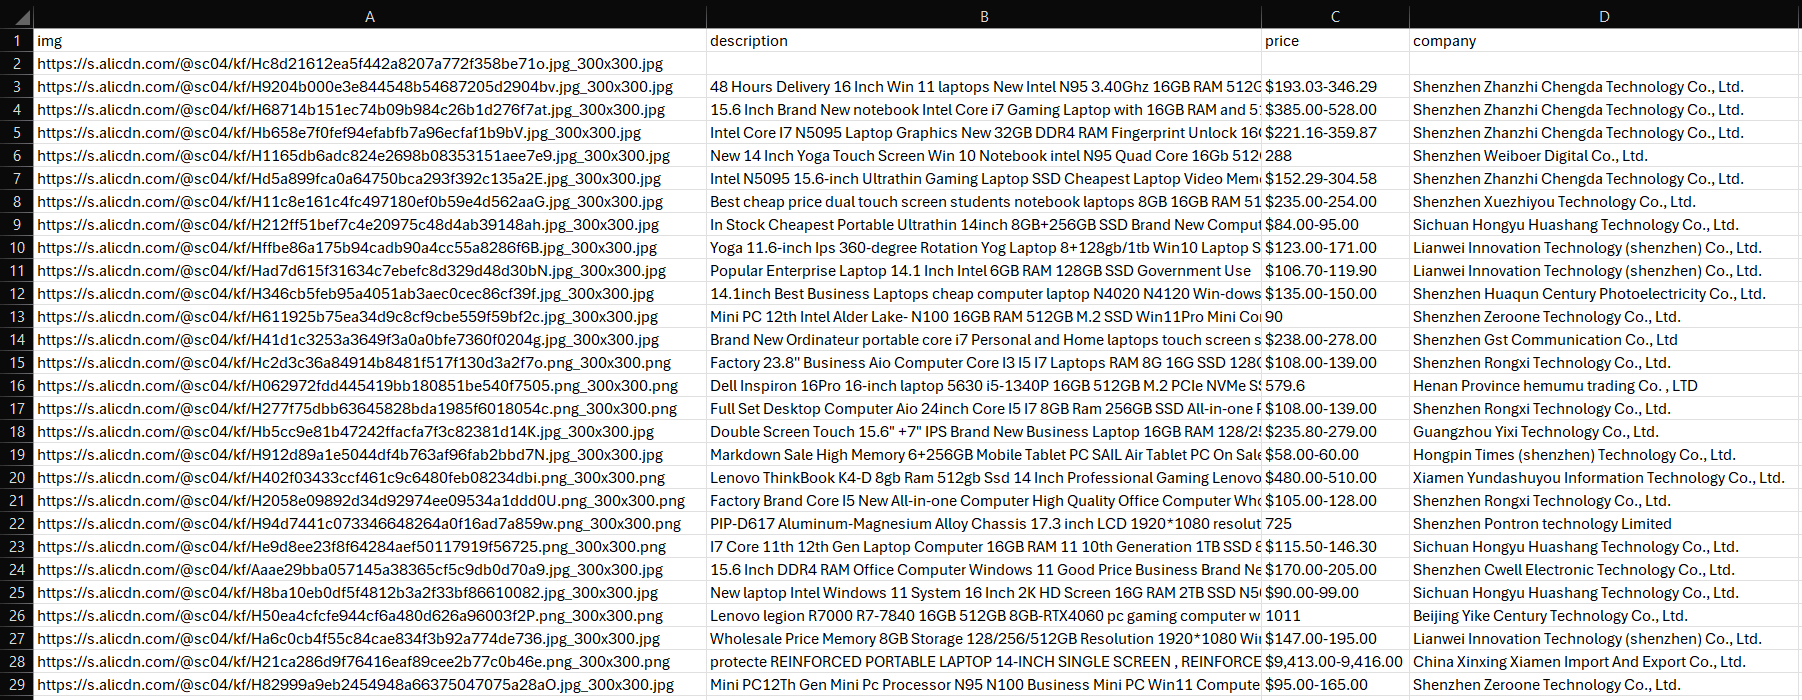Et voilà! Mission erfüllt. Die nächsten Schritte? Paginierung bearbeiten, Skript bereitstellen, Ausführung automatisieren und für optimale Leistung weiter optimieren!
## Fazit
In dieser Schritt-für-Schritt-Anleitung haben Sie gelernt, was ein Alibaba-Scraper ist und welche Arten von Daten er abrufen kann. Außerdem haben Sie gesehen, wie Sie mit weniger als 100 Zeilen Code ein Python-Skript erstellen können, um Alibaba-Produkte zu scrapen.
Das Problem ist, dass das Scraping von Alibaba mit Herausforderungen verbunden ist. Die Plattform setzt strenge Anti-Bot-Maßnahmen ein und verwendet Interaktionen wie Paginierung, die den Scraping-Prozess komplexer machen. Die Erstellung einer skalierbaren und effektiven Alibaba-Scraping-Lösung kann sehr anspruchsvoll sein.
Mit unserer [Alibaba Scraper API](/products/web-scraper/alibaba) können Sie diese Herausforderungen vergessen! Mit dieser speziellen Lösung können Sie Daten von der Zielwebsite durch einfache API-Aufrufe abrufen – ohne das Risiko, blockiert zu werden.
Wenn Web-Scraping nicht Ihr bevorzugter Ansatz ist, Sie aber dennoch an Produktdaten interessiert sind, entdecken Sie unsere gebrauchsfertigen [Alibaba-Datensätze](/products/datasets/alibaba)!
Erstellen Sie noch heute ein kostenloses Bright Data-Konto, um unsere Scraper-APIs auszuprobieren oder unsere Datensätze zu erkunden.
Vertrieb kontaktierenGratis testen
Inhaltsverzeichnis
Dedicated Scraper APIs & No-Code Scrapers
Over 1000 scrapers for all popular domains. Simplify your web scraping.
[See pricing](/pricing/web-scraper "See pricing")
Just want data? Skip scraping.
Hundreds of ready-to-use datasets from all popular domains.
[See pricing](/pricing/datasets "See pricing")
[ ](https://news.ycombinator.com/submitlink?t=Wie+man+Alibaba+mit+Python+im+Jahr+2026+scrapt&u=https://brightdata.de/blog/web-data-de/how-to-scrape-alibaba) [ ](https://www.linkedin.com/shareArticle?mini=true&title=Wie+man+Alibaba+mit+Python+im+Jahr+2026+scrapt&url=https://brightdata.de/blog/web-data-de/how-to-scrape-alibaba) [ ](http://www.reddit.com/submit?title=Wie+man+Alibaba+mit+Python+im+Jahr+2026+scrapt&url=https://brightdata.de/blog/web-data-de/how-to-scrape-alibaba)
## Das könnte Sie auch interessieren
[  ](https://brightdata.de/blog/ai/openhuman-with-bright-data "Produktionsreifer Web-Zugriff in OpenHuman über die Bright Data CLI")
[AI

Antonello Zanini
Technical Writer
### Produktionsreifer Web-Zugriff in OpenHuman über die Bright Data CLI
Integrieren Sie die Bright Data CLI mit OpenHuman, um produktionsreifen Web-Zugriff und Datenerhebung für KI-Agenten zu ermöglichen.
09-Sep-2026
12 min lesen
](https://brightdata.de/blog/ai/openhuman-with-bright-data)
[  ](https://brightdata.de/blog/web-data-de/multimodal-web-scraping-with-minimax "Multimodales Web-Scraping mit MiniMax")
[Web Data

Antonello Zanini
Technical Writer
### Multimodales Web-Scraping mit MiniMax
Kombinieren Sie Bright Data Web Unlocker mit MiniMax M3 Vision, um strukturierte Daten aus Bildern und Webseiten-Screenshots zu extrahieren.
09-Sep-2026
4 min lesen
](https://brightdata.de/blog/web-data-de/multimodal-web-scraping-with-minimax)
[  ](https://brightdata.de/blog/ai/best-cli-tools-for-codex "Die 10 besten CLI-Tools für Codex im Jahr 2026 – Getestet & Bewertet")
[AI

Daniel Shashko
Web Data & AI Expert
### Die 10 besten CLI-Tools für Codex im Jahr 2026 – Getestet & Bewertet
Die 10 CLI-Tools, die Codex schneller und leistungsfähiger machen, beginnend mit dem Bright Data CLI für echten Web-Zugriff aus der Sandbox heraus.
06-Sep-2026
20 min lesen
](https://brightdata.de/blog/ai/best-cli-tools-for-codex)