---
title: "Leitfaden zur Verwendung eines Proxys mit Python Requests"
slug: proxy-with-python-requests
date: 2023-06-18T05:49:47+00:00
modified: 2026-08-26T21:02:30+00:00
permalink: https://brightdata.de/blog/proxys-101/proxy-with-python-requests
type: blog
---
[ Blog ](https://brightdata.de/blog "Blog") / [Proxy 101](https://brightdata.de/blog/proxys-101)
[Proxy 101](https://brightdata.de/blog/proxys-101)
# Leitfaden zur Verwendung eines Proxys mit Python Requests
Leitfaden zur Verwendung eines Proxys mit Python Requests für Web-Scraping und warum dies bei der Arbeit an einem Web-Scraping-Projekt hilfreich sein kann.
11 min lesen
[  ](https://brightdata.com/blog/authors/davis-david)
[Davis David
](https://brightdata.com/blog/authors/davis-david)
Proxys sind IP-Adressen eines Servers, der in Ihrem Auftrag eine Verbindung zum Internet herstellt. Anstatt Ihre Anfragen direkt an Websites zu übermitteln, leiten Proxys diese über einen Server weiter, wodurch Ihre ursprüngliche IP-Adresse und Ihr Standort verborgen bleiben. Dies schützt Ihre Privatsphäre, verhindert Tracking und vermeidet Sperren. Proxys verschlüsseln außerdem Ihre Daten für zusätzliche Sicherheit.
In diesem Artikel erfahren Sie, wie Sie Proxys mit Python Requests verwenden, insbesondere für [Web-Scraping](/blog/how-tos/what-is-web-scraping). Beim Web-Scraping werden Daten von Websites extrahiert, aber viele Seiten haben Einschränkungen. Proxys helfen dabei, [diese zu umgehen](/blog/proxy-101/how-to-bypass-an-ip-ban), indem sie Ihre IP und Ihren Standort ändern und es Websites erschweren, Sie zu erkennen und zu blockieren. Sie können auch mehrere Proxys verwenden, um Anfragen zu verteilen und den Prozess zu beschleunigen.
Als Nächstes erfahren Sie, wie Sie einen Proxy in Ihrem Projekt mithilfe des Requests Python-Pakets implementieren.
## So verwenden Sie einen Proxy mit einer Python-Anfrage
Um einen Proxy mit einer Python-Anfrage zu verwenden, müssen Sie ein neues Python-Projekt auf Ihrem Computer einrichten, um die Python-Skripte für Web-Scraping zu schreiben und auszuführen. Erstellen Sie ein Verzeichnis (*z. B.* `web_scrape_project`), in dem Sie Ihre Quellcode-Dateien speichern.
Alle Codes für dieses Tutorial sind in diesem GitHub-Repository verfügbar.
## Pakete installieren
Nachdem Sie Ihr Verzeichnis erstellt haben, müssen Sie die folgenden Python-Pakete installieren, um Anfragen an die Web-Seite zu senden und die Links zu sammeln:
- Bright Datas Web-Seite
## Bestandteile einer Proxy-IP-Adresse
Bevor Sie einen Proxy verwenden, sollten Sie dessen Bestandteile verstehen. Im Folgenden werden die drei primären Bestandteile eines Proxy-Servers beschrieben:
1. **Protokoll** zeigt die Art der Inhalte an, auf die Sie im Internet zugreifen können. Die häufigsten Protokolle sind HTTP und HTTPS.
2. **Adresse** zeigt an, wo sich der Proxy-Server befindet. Die Adresse kann eine IP (*z. B.* `192.167.0.1`) oder ein DNS-Hostname (*z. B.* `proxyprovider.com`) sein.
3. **Port** wird verwendet, um den Traffic zum richtigen Serverprozess zu leiten, wenn mehrere Dienste auf einem einzelnen Computer laufen (*z. B.* Portnummer `2000`).
Mit allen drei Bestandteilen würde eine Proxy-IP-Adresse so aussehen: `192.167.0.1:2000` oder `proxyprovider.com:2000`.
## So legen Sie Proxys direkt in Requests fest
Es gibt mehrere Möglichkeiten, Proxys in Python Requests festzulegen. In diesem Artikel werden drei verschiedene Szenarien betrachtet. Im ersten Beispiel erfahren Sie, wie Sie Proxys direkt im Requests-Modul festlegen.
Zunächst müssen Sie die Pakete Requests und Beautiful Soup in Ihrer Python-Datei für Web-Scraping importieren. Erstellen Sie dann ein Verzeichnis namens `proxies`, das Proxy-Server-Informationen enthält, um Ihre IP-Adresse beim Scrapen der Web-Seite zu verbergen. Hier müssen Sie sowohl die HTTP- als auch die HTTPS-Verbindungen zur Proxy-URL definieren.
Sie müssen auch die Python-Variable definieren, um die URL der Web-Seite festzulegen, von der Sie die Daten scrapen möchten. Für dieses Tutorial lautet die URL [https://brightdata.com/](/)
Als Nächstes müssen Sie eine GET-Anfrage an die Web-Seite mit der `request.get()`-Methode senden. Die Methode nimmt zwei Argumente entgegen: die URL der Website und Proxys. Die Antwort der Web-Seite wird dann in der `response`-Variable gespeichert.
Um die Links zu sammeln, verwenden Sie das Beautiful Soup-Paket, um den HTML-Inhalt der Web-Seite zu parsen, indem Sie `response.content` und `html.parser` als Argumente an die `BeautifulSoup()`-Methode übergeben.
Verwenden Sie dann die `find_all()`-Methode mit `a` als Argument, um alle Links auf der Web-Seite zu finden. Extrahieren Sie schließlich das `href`-Attribut jedes Links mit der `get()`-Methode.
Im Folgenden finden Sie den vollständigen Quellcode zum direkten Festlegen von Proxys in Requests:
```none
# import packages.
import requests
from bs4 import BeautifulSoup
# Define proxies to use.
proxies = {
'http': 'http://proxyprovider.com:2000',
'https': 'http://proxyprovider.com:2000',
}
# Define a link to the web page.
url = "https://brightdata.com/"
# Send a GET request to the website.
response = requests.get(url, proxies=proxies)
# Use BeautifulSoup to parse the HTML content of the website.
soup = BeautifulSoup(response.content, "html.parser")
# Find all the links on the website.
links = soup.find_all("a")
# Print all the links.
for link in links:
print(link.get("href"))
```
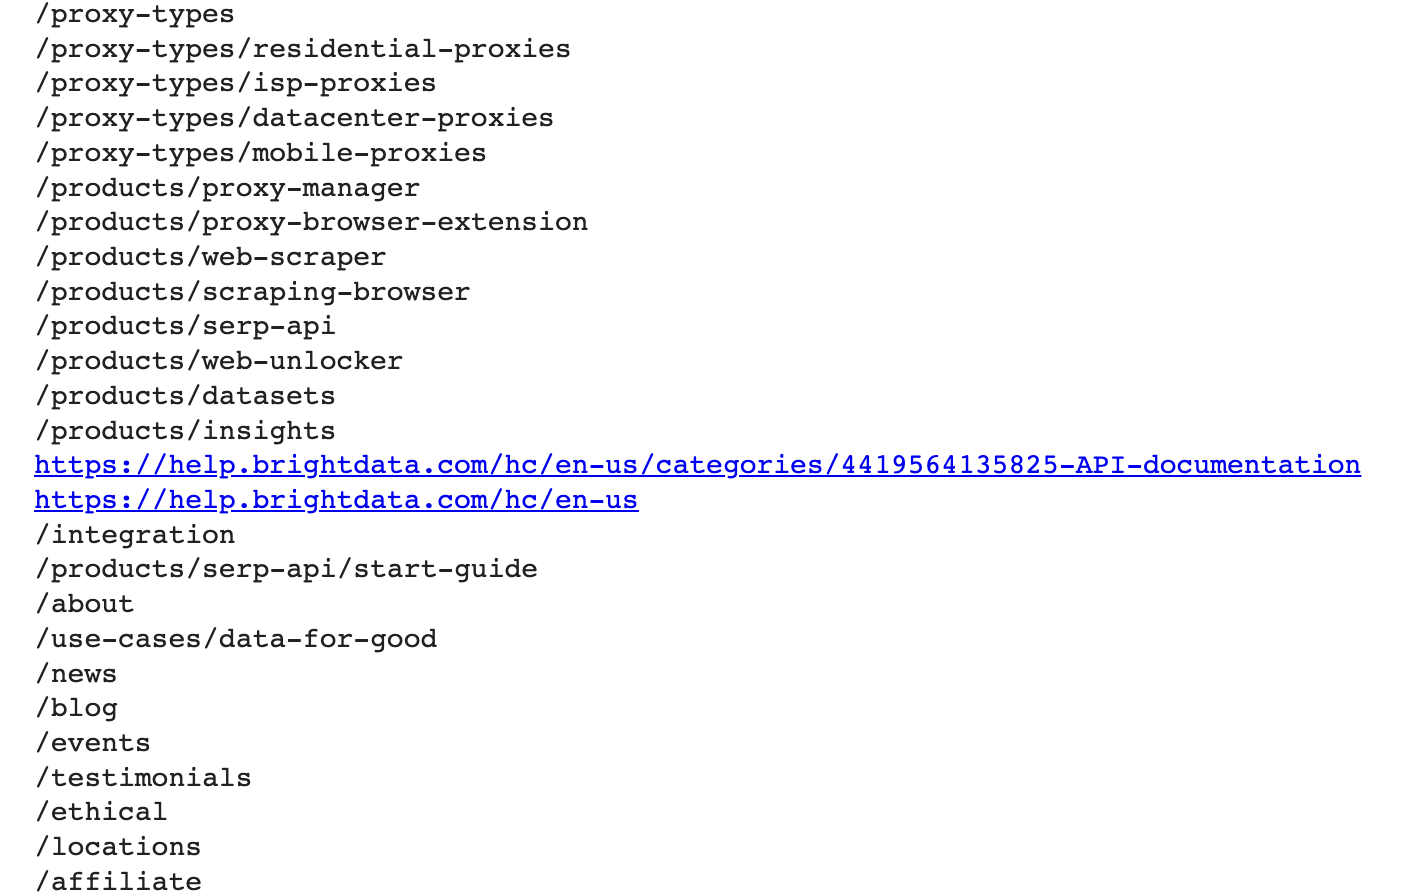
Wenn Sie diesen Codeblock ausführen, sendet er eine Anfrage an die definierte Web-Seite über die Proxy-IP-Adresse und gibt dann die Antwort zurück, die alle Links zu dieser Web-Seite enthält:
## So legen Sie Proxys über Umgebungsvariablen fest
Manchmal müssen Sie denselben Proxy für alle Ihre Anfragen an verschiedene Web-Seiten verwenden. In diesem Fall ist es sinnvoll, Umgebungsvariablen für Ihren Proxy festzulegen.
Um die Umgebungsvariablen für den Proxy verfügbar zu machen, wenn Sie Skripte in der Shell ausführen, führen Sie den folgenden Befehl in Ihrem Terminal aus:
```none
export HTTP_PROXY='http://proxyprovider.com:2000'
export HTTPS_PROXY='https://proxyprovider.com:2000'
```
Hier legt die `HTTP_PROXY`-Variable den Proxy-Server für HTTP-Anfragen fest, und die `HTTPS_PROXY`-Variable legt den Proxy-Server für HTTPS-Anfragen fest.
An diesem Punkt enthält Ihr Python-Code nur wenige Codezeilen und verwendet die Umgebungsvariablen, wenn Sie eine Anfrage an die Web-Seite stellen:
```none
# import packages.
import requests
from bs4 import BeautifulSoup
# Define a link to the web page.
url = "https://brightdata.com/"
# Send a GET request to the website.
response = requests.get(url)
# Use BeautifulSoup to parse the HTML content of the website.
soup = BeautifulSoup(response.content, "html.parser")
# Find all the links on the website.
links = soup.find_all("a")
# Print all the links.
for link in links:
print(link.get("href"))
```
## So rotieren Sie Proxys mit einer benutzerdefinierten Methode und einem Array von Proxys
Das Rotieren von Proxys ist entscheidend, da Websites häufig den Zugriff von Bots und Scrapern sperren oder einschränken, wenn sie eine große Anzahl von Anfragen von derselben IP-Adresse erhalten. In diesem Fall können Websites böswillige Scraping-Aktivitäten vermuten und entsprechende Maßnahmen ergreifen, um den Zugriff zu sperren oder einzuschränken.
Indem Sie durch verschiedene Proxy-IP-Adressen rotieren, können Sie vermeiden, erkannt zu werden, als mehrere organische Nutzer erscheinen und die meisten Anti-Scraping-Maßnahmen auf der Website umgehen.
Um Proxys zu rotieren, müssen Sie einige Python-Bibliotheken importieren: Requests, Beautiful Soup und Random.
Erstellen Sie dann eine Liste von Proxys, die während des Rotationsprozesses verwendet werden sollen. Diese Liste muss die URLs der Proxy-Server in folgendem Format enthalten: http://proxyserver.com:port:
```none
# List of proxies
proxies = [
"http://proxyprovider1.com:2010", "http://proxyprovider1.com:2020",
"http://proxyprovider1.com:2030", "http://proxyprovider2.com:2040",
"http://proxyprovider2.com:2050", "http://proxyprovider2.com:2060",
"http://proxyprovider3.com:2070", "http://proxyprovider3.com:2080",
"http://proxyprovider3.com:2090"
]
```
Erstellen Sie dann eine benutzerdefinierte Methode namens `get_proxy()`. Diese Methode wählt zufällig einen Proxy aus der Proxy-Liste mit der `random.choice()`-Methode aus und gibt den ausgewählten Proxy im Wörterbuchformat zurück (sowohl HTTP- als auch HTTPS-Schlüssel). Sie verwenden diese Methode, wenn Sie eine neue Anfrage senden:
```none
# Custom method to rotate proxies
def get_proxy():
# Choose a random proxy from the list
proxy = random.choice(proxies)
# Return a dictionary with the proxy for both http and https protocols
return {'http': proxy, 'https': proxy}
```
Nachdem Sie die `get_proxy()`-Methode erstellt haben, müssen Sie eine Schleife erstellen, die eine bestimmte Anzahl von GET-Anfragen mit den rotierten Proxys sendet. Bei jeder Anfrage verwendet die `get()`-Methode einen zufällig ausgewählten Proxy, der durch die `get_proxy()`-Methode angegeben wird.
Dann müssen Sie die Links aus dem HTML-Inhalt der Web-Seite mit dem Beautiful Soup-Paket sammeln, wie im ersten Beispiel erläutert.
Schließlich fängt der Python-Code alle Ausnahmen ab, die während des Anfrageprozesses auftreten, und gibt die Fehlermeldung in der Konsole aus.
Hier ist der vollständige Quellcode für dieses Beispiel:
```none
# import packages
import requests
from bs4 import BeautifulSoup
import random
# List of proxies
proxies = [
"http://proxyprovider1.com:2010", "http://proxyprovider1.com:2020",
"http://proxyprovider1.com:2030", "http://proxyprovider2.com:2040",
"http://proxyprovider2.com:2050", "http://proxyprovider2.com:2060",
"http://proxyprovider3.com:2070", "http://proxyprovider3.com:2080",
"http://proxyprovider3.com:2090"
]
# Custom method to rotate proxies
def get_proxy():
# Choose a random proxy from the list
proxy = random.choice(proxies)
# Return a dictionary with the proxy for both http and https protocols
return {'http': proxy, 'https': proxy}
# Send requests using rotated proxies
for i in range(10):
# Set the URL to scrape
url = 'https://brightdata.com/'
try:
# Send a GET request with a randomly chosen proxy
response = requests.get(url, proxies=get_proxy())
# Use BeautifulSoup to parse the HTML content of the website.
soup = BeautifulSoup(response.content, "html.parser")
# Find all the links on the website.
links = soup.find_all("a")
# Print all the links.
for link in links:
print(link.get("href"))
except requests.exceptions.RequestException as e:
# Handle any exceptions that may occur during the request
print(e)
```
## Verwendung des Bright Data Proxy-Dienstes mit Python
Wenn Sie einen zuverlässigen, schnellen und stabilen Proxy für Ihre Web-Scraping-Aufgaben suchen, sind Sie bei Bright Data genau richtig – einer Web-Dateninfrastruktur, die [verschiedene Arten von Proxys](/proxy-types) für eine breite Palette von Anwendungsfällen anbietet.
Bright Data verfügt über ein großes Netzwerk von mehr als 400M+ monthly [Residential-Proxy-IPs](/proxy-types/residential-proxies) und mehr als 770.000 [Datacenter-Proxys](/proxy-types/datacenter-proxies), die zuverlässige und schnelle Proxy-Lösungen ermöglichen. Die Proxy-Angebote sind darauf ausgelegt, Ihnen dabei zu helfen, die Herausforderungen von Web-Scraping, Anzeigenüberprüfung und anderen Online-Aktivitäten zu bewältigen, die eine anonyme und effiziente Web-Datenerfassung erfordern.
[Die Integration von Bright Datas Proxys](/integration) in Ihre Python Requests ist einfach. Verwenden Sie beispielsweise die Datacenter-Proxys, um eine Anfrage an die in den vorherigen Beispielen verwendete URL zu senden.
Falls Sie noch kein Konto haben, registrieren Sie sich für eine kostenlose Bright Data-Testversion und fügen Sie dann Ihre Daten hinzu, um Ihr Konto zu registrieren.
Befolgen Sie anschließend diese Schritte, um Ihren ersten Proxy zu erstellen:
Klicken Sie auf der Willkommensseite auf **Proxy-Produkt anzeigen**, um die verschiedenen von Bright Data angebotenen Proxy-Typen zu sehen:
Wählen Sie **Datacenter-Proxys**, um einen neuen Proxy zu erstellen, und fügen Sie auf der folgenden Seite Ihre Daten hinzu und speichern Sie diese:
Sobald Ihr Proxy erstellt ist, können Sie die wichtigen Parameter (*z. B.* Host, Port, Benutzername und Passwort) einsehen, um damit zu beginnen, darauf zuzugreifen und es zu verwenden:
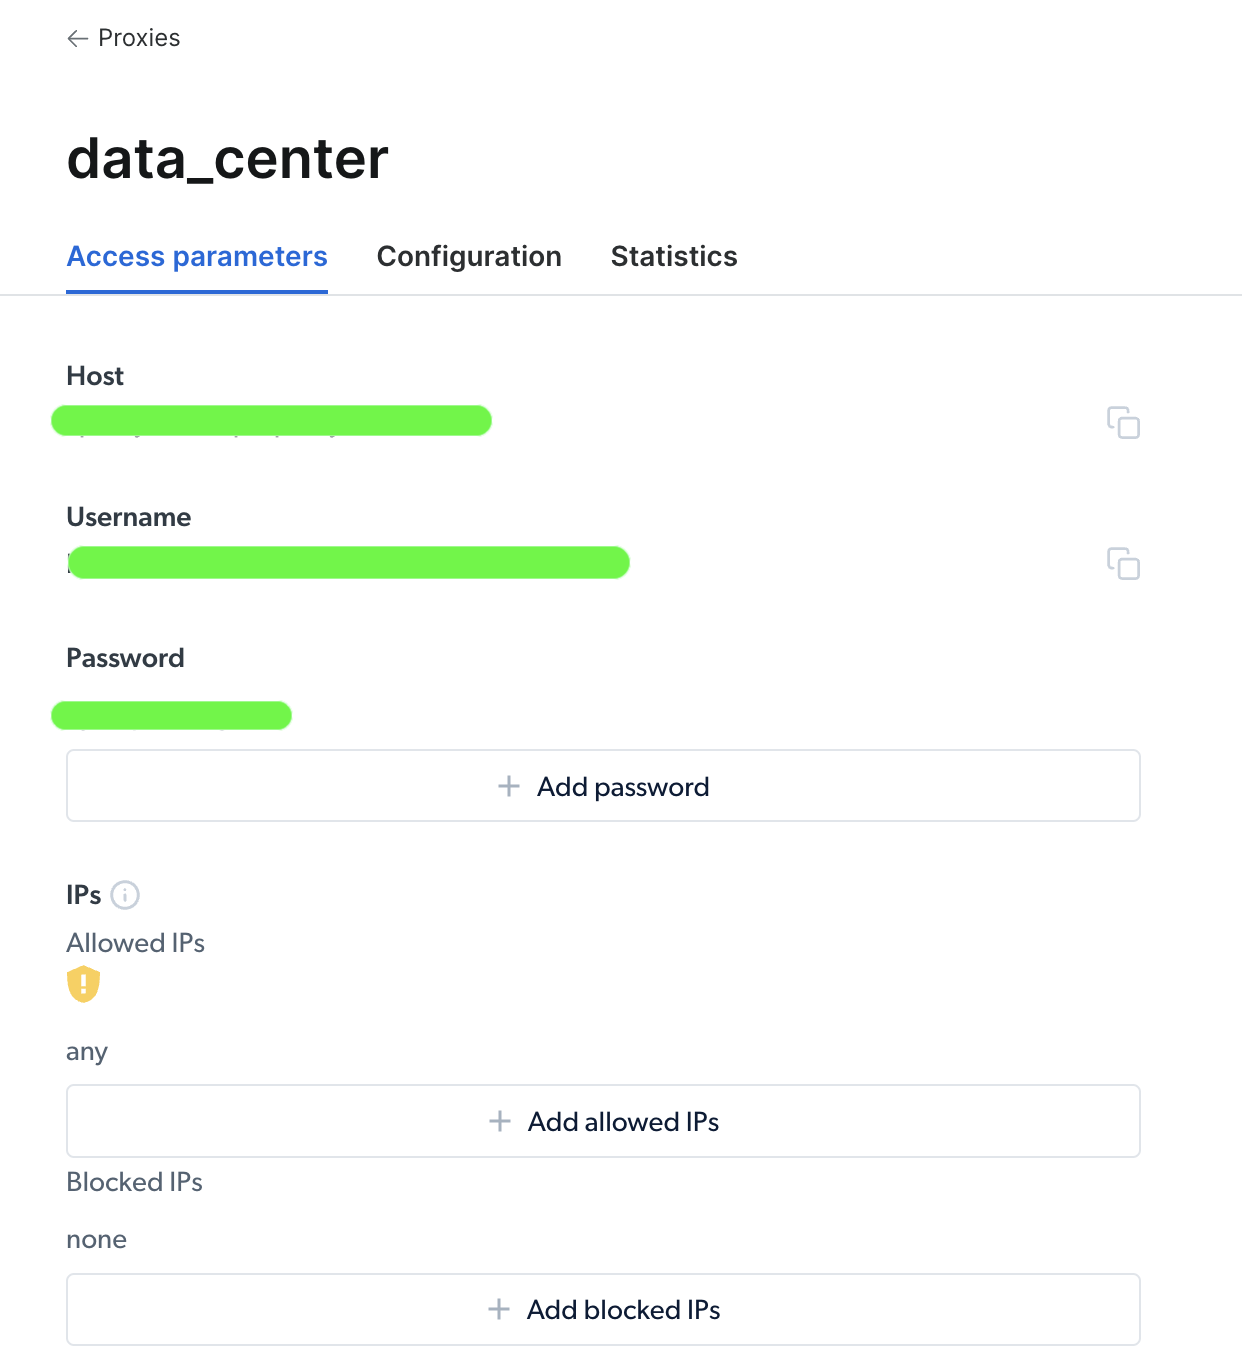Sobald Sie auf Ihren Proxy zugegriffen haben, können Sie die Parameterinformationen verwenden, um Ihre Proxy-URL zu konfigurieren und eine Anfrage mit dem Requests Python-Paket zu senden. Das Format der Proxy-URL lautet `username-(session-id)-password@host:port`.
> **Hinweis:** Die `session-id` ist eine zufällige Zahl, die mit einem Python-Paket namens `random` erstellt wird.
Im Folgenden sehen Sie, wie Ihr Code-Beispiel aussehen würde, um Ihren Proxy von Bright Data in einer Python-Anfrage festzulegen:
```none
import requests
from bs4 import BeautifulSoup
import random
# Define parameters provided by Brightdata
host = 'brd.superproxy.io'
port = 33335
username = 'username'
password = 'password'
session_id = random.random()
# format your proxy
proxy_url = ('http://{}-session-{}:{}@{}:{}'.format(username, session_id,
password, host, port))
# define your proxies in dictionary
proxies = {'http': proxy_url, 'https': proxy_url}
# Send a GET request to the website
url = "https://brightdata.com/"
response = requests.get(url, proxies=proxies)
# Use BeautifulSoup to parse the HTML content of the website
soup = BeautifulSoup(response.content, "html.parser")
# Find all the links on the website
links = soup.find_all("a")
# Print all the links
for link in links:
print(link.get("href"))
```
Hier importieren Sie die Pakete und definieren die Variablen für Proxy-Host, Port, Benutzername, Passwort und session\_id. Dann erstellen Sie ein `proxies`-Wörterbuch mit den `http`– und `https`-Schlüsseln und den Proxy-Anmeldedaten. Schließlich übergeben Sie den `proxies`-Parameter an die `requests.get()`-Funktion, um die HTTP-Anfrage zu stellen und die Links von der URL zu sammeln.
Und das war’s! Sie haben gerade eine erfolgreiche Anfrage mit Bright Datas [Proxy-Dienst](/proxy-types) gestellt.
## Fazit
In diesem Artikel haben Sie erfahren, warum Sie Proxys benötigen, sowie die verschiedenen Möglichkeiten, wie Sie diese verwenden können, um eine Anfrage an eine Web-Seite mit dem Requests Python-Paket zu senden.
Mit Bright Datas Web-Infrastruktur erhalten Sie zuverlässige Proxys für Ihr Projekt, die jedes Land oder jede Stadt der Welt abdecken. Sie bieten mehrere Möglichkeiten, die benötigten Daten über verschiedene Proxy-Typen und Web-Scraping-Tools zu erhalten, die Ihren spezifischen Anforderungen entsprechen.
Ob Sie Marktforschungsdaten sammeln, Online-Bewertungen überwachen oder Konkurrenzpreise verfolgen möchten – Bright Data verfügt über die Ressourcen, die Sie benötigen, um die Aufgabe schnell und effizient zu erledigen.
Gratis testen[Starte mit Google](# "Start free with Google")
Inhaltsverzeichnis
400M+ Residential Proxies
**Get 50% off** on residential proxies for 6 months! Use code **RESIGB50**.
[See pricing](/pricing/proxy-network/residential-proxies "See pricing")
1.3M+ Datacenter Proxies
Pay only for the IP, starting from $0.90.
[See pricing](/pricing/proxy-network/datacenter-proxies "See pricing")
[ ](https://news.ycombinator.com/submitlink?t=Leitfaden+zur+Verwendung+eines+Proxys+mit+Python+Requests&u=https://brightdata.de/blog/proxys-101/proxy-with-python-requests) [ ](https://www.linkedin.com/shareArticle?mini=true&title=Leitfaden+zur+Verwendung+eines+Proxys+mit+Python+Requests&url=https://brightdata.de/blog/proxys-101/proxy-with-python-requests) [ ](http://www.reddit.com/submit?title=Leitfaden+zur+Verwendung+eines+Proxys+mit+Python+Requests&url=https://brightdata.de/blog/proxys-101/proxy-with-python-requests)
## Das könnte Sie auch interessieren
[  ](https://brightdata.de/blog/proxys-101/python-proxy-server "Was ist ein Python Proxy-Server?")
[Proxy 101

Antonello Zanini
Technical Writer
### Was ist ein Python Proxy-Server?
Der Python-Proxy-Server ermöglicht das Routing von HTTP/S-Anfragen über ein riesiges Netzwerk von IP-Adressen per Python-Code. Er unterstützt Funktionen wie beispielsweise IP-Rotation, Sitzungspersistenz und Geotargeting.
24-Dec-2023
13 min lesen
](https://brightdata.de/blog/proxys-101/python-proxy-server)
[  ](https://brightdata.de/blog/wie/python-ip-rotation "Wie man Proxys verwendet, um IP-Adressen in Python zu rotieren")
[How Tos

Sooter Saalu
### Wie man Proxys verwendet, um IP-Adressen in Python zu rotieren
Erfahren Sie, wie Sie Proxys in Python für die IP-Rotation beim Web-Scraping einsetzen, wo Sie zuverlässige Proxys finden und wie Sie Website-Sperren vermeiden.
07-Sep-2023
7 min lesen
](https://brightdata.de/blog/wie/python-ip-rotation)
[  ](https://brightdata.de/blog/wie/curl-with-python "Anleitung zur Verwendung von cURL mit Python")
[How Tos

Roel Peters
### Anleitung zur Verwendung von cURL mit Python
In diesem Artikel erfahren Sie, wie Python und cURL zusammen verwendet werden können, um GET-, POST- und PUT-Anfragen zu automatisieren und um Dateien und Websites herunterzuladen.
13-Apr-2023
13 min lesen
](https://brightdata.de/blog/wie/curl-with-python)